-
 “让云无处不在,让智能无所不及,共建智能世界云底座”。12月20日,华为云计算技术有限公司贵安园区暨华为全球培训中心盛大开园,华为云的三个班级——“华为云人工智能高研班”、“华为云云服务工程师培训班”、“华为云人工智能师资培训班”亦同期开班。 国家提出“东数西算”工程,旨在把握数字经济加速发展战略机遇期,构建算力新格局。华为公司高级副总裁、华为云CEO、消费者云服务总裁张平安表示:华为将云数据中心落户贵安,将华为云业务全球总部建立在贵安,就是要全面支持贵州“在实施数字经济战略上抢新机”,将贵州打造成数字经济高地。同时,华为将进一步促进贵州IT人才培养,并希望与贵州共建“贵州数字经济创新中心”,推动各产业协同创新,促进本地高质量人才的培育孵化,以技术赋能企业,以产教融合培养数字经济技术型、实用型人才。(华为云CEO张平安先生开园致辞) 华为云开展的此次培训正是面向数字化转型人才培养需求的一次积极探索。贵州的大数据产业发展具有得天独厚的优势,贵安华为云数据中心又是华为云全球规模最大的数据中心核心节点,在云的数据中心,学习和使用云服务将为学员带来更为直观的体验。因此,我们将培训的主题定为云计算、人工智能与大数据,参培的学员也均为云贵渝地区与大数据相关的政府、企业高层及院校教师。 云贵渝地区的大数据分管部门领导、关联产业及高校代表共聚华为云人工智能高研班,与华为云大数据、人工智能资深专家就“大数据思维与技术应用”及“人工智能的趋势与应用”两个主题进行了学习与研讨,致力于推动贵州产业数字化进程与数字人才框架的搭建。(华为云计算公司副总裁王海杰先生致辞) 华为云计算公司副总裁王海杰先生为“华为云人工智能高研班”发表开班致辞时表示:“随着我们进入‘万物互联’时代,大数据、人工智能和云计算对于贵州数字化发展、智能化发展发挥着至关重要的作用。在国家、贵州省政府以及贵阳市政府的大力支持下,华为云计算技术有限公司贵安园区未来将会构建全球最领先的数据中心,为助力贵州乃至整个西部地区数字经济发展和本地技术型、应用型人才的培育孵化打下坚实基础。”同时,他对首场高研班培训也寄予了殷切希望:“华为云人工智能高研班作为培训中心首个开班的培训班级,特别邀请AI、大数据与云计算专家全面赋能,带领大家充分了解技术发展趋势与行业应用格局,将华为在数字转型实践上的精华奉献出来,与诸位共享共融。”(高研班学员积极参与课程互动) 除高研班外, 华为云的两个技术培训班“华为云云服务工程师培训”、“华为云人工智能师资培训”也紧随其后,依次开班。 “华为云云服务工程师培训”聚焦计算、存储、网络等常用的云服务,完整展现了未来云计算高端人才的能力图谱。课程以“云计算是什么”为切入点,逐步延伸至华为云上常见的云服务,以理论讲解与云上实践结合的方式,使学员熟悉与掌握计算、存储、网络服务的基本概念、架构、功能及应用,并简单了解数据库、安全、CDN及EI企业智能服务的基本知识。“华为云人工智能师资培训”则在详尽地讲解神经网络基础知识后,带领学员基于ModelArts一站式AI开发平台完成动物叫声分类、花卉识别与云宝检测应用的初级开发,寓教于乐,使其沉浸式地感受普惠AI的魅力。 华为云贵州云业务部总经理吕河先生为两个技术培训班发表开班致辞时表示,“希望通过这次培训,能更好地推动人工智能技术结合本地特色在本地的落地,能更好地携手企业及高校联合为AI的技术研发、人才培养与储备提供坚实力量”。(技术培训班学员认真学习听讲) 学员们也纷纷表示本次培训使其受益匪浅。来自贵州的学员王先生表示,“通过这次学习增强了自身为产业发展服务的能力,体验了华为云在数字人才培育上的专业度,也对贵州未来数字经济的发展充满信心”。参加人工智能师资培训的张老师认为,“这次学习让我了解了大数据和云计算相关的前沿知识和技术,更明确地感受到人工智能将更好地服务于人们的生活,推动时代进步。也相信本次培训为推动人工智能技术在贵州本地的落地以及 AI人才的培养与储备提供了坚实力量,起到了积极的作用”。 未来,华为云开发者学堂将继续致力于数字人才的培养,并与各个高校、行业客户、伙伴一起构建数字知识平台,为全球华为云客户打造一站式的“学练训考”学习平台,推动各产业创新,促进高质量数字人才的培育孵化。云聚未来,共建数字人才生态。让云无处不在,让智能无所不及,共建智能世界云底座! 学以致用,云世界大有可为!更多华为云培训服务精彩内容,请关注华为云开发者学堂。(https://edu.huaweicloud.com)
-
 关闭学校、关闭工作场所、取消公共活动、限制人群聚集、公共交通管制、居家生活建议、限制国内流动、限制国际旅行…… 到底哪项政策防疫效果更好?钟南山团队与腾讯的联合研究发现了其中的 Top 3。日前,钟南山院士团队与腾讯公司披露了一项利用大数据与人工智能技术,定量评估不同公共防控政策对新冠疫情控制效果的研究。研究团队开发了一种新的反事实推理模型框架,通过引入隐含交互因子项,最大程度排除了随时间变化的混杂因素的影响,对包含 145 个国家和地区、8 种公共防控政策的动态数据,进行更加准确,且符合真实世界运转的量化分析。研究结果表明,更快、更精准地实施疫情防控,才能有效遏制新冠肺炎疫情的发展。这也是新冠防控领域首次引入该技术进行研究。这项研究成果已在国际著名医学期刊 Value in Health(《健康价值》)刊出,题为《Quantifying the Effect of Public Activity Intervention Policies on COVID-19 Pandemic Containment Using Epidemiologic Data From 145 Countries》。论文链接:https://www.sciencedirect.com/science/article/pii/S1098301521017940据了解,广州呼吸健康研究院院长何建行和腾讯健康副总裁吴文达为该论文共同通讯作者,钟南山院士为指导作者,广州呼吸健康研究院的梁文华教授、杨子峰教授、曾志奇博士,以及腾讯天衍实验室的孙继超博士、郑冶枫博士为这项新研究的共同第一作者。这也是继去年 2 月,钟南山院士团队与腾讯公司共同成立大数据及人工智能联合实验室,双方在抗击新冠肺炎疫情上的最新研究成果。此前,双方还联合研发了新冠重症 AI 预测系统,有助于合理地为新冠患者进行早期分诊。
-
 完成本实验贴任务视为支持 AI发展需要更多的前沿技术还是需要与更多的行业结合?反方观点√反方观点:与更多行业结合活动时间:2021年12月23日~2022年1月16日 参与方式:1、按照demo操作实验 》点击查看实验demo《2、按照要求生成实验结果截图,反馈到此活动贴 特别说明:请务必完成年终活动报名:点击报名请务必按照以下格式要求进行回帖,否则无法计算奖励:1、华为云账号:xxx(即右上角的字母数字组合ID)2、任务截图:注意事项:1、请务必使用个人账号参与活动(IAM、企业账号等账号参与无效)2、 本次活动规则详见:https://bbs.huaweicloud.com/forum/thread-174300-1-1.html参与博文写作,还能另外获奖喔点击了解
-
完成本实验贴任务视为支持 AI发展需要更多的前沿技术还是需要与更多的行业结合?正方观点√正方观点:需要更多的前沿技术活动时间:2021年12月23日~2022年1月16日 参与方式:1、按照demo操作实验 》点击查看实验demo《2、按照要求生成实验结果截图,反馈到此活动贴 特别说明:请务必完成年终活动报名:点击报名请务必按照以下格式要求进行回帖,否则无法计算奖励:1、华为云账号:xxx(即右上角的字母数字组合ID)2、任务截图:注意事项:1、请务必使用个人账号参与活动(IAM、企业账号等账号参与无效)2、 本次活动规则详见:https://bbs.huaweicloud.com/forum/thread-174300-1-1.html参与博文写作,还能另外获奖喔点击了解
-
 年底活动力推:“调用领豪礼”,冲啊!调用量!活动说明:12月调用量达标即可联系小助手领取奖品,赶紧看看你是否达标~活动时间:即日起-12月31日【活动规格】:1、调用新增破千万,最高可获得价值10000元礼品2、调用新增破百万,最高可获得价值1000元礼品3、调用新增破万,可获得围巾/背包/玩偶或其他等价值礼品。大家可根据自己业务量冲刺不同档位!【活动注意事项】:1、图引擎服务/自然语言处理/视频内容审核/语音交互服务-实时语音识别/语音交互服务-录音文件识别 不参与此活动2、不可与其他活动同时参与3、根据API服务不同,各档位获得礼品价值不同,细则详情可联系小助手4、较上月相比,增长量大的企业用户可单独添加小助手询问相关激励
-
 从懂AI,到懂行Leslie编者按Leslie,中国HCS交付与服务部AI使能团队负责人,2019年5月进入华为,2020年获得中国区优秀新人称号。2021年A带领I使能团队,负责全国AI业务发展及能力建设。 2019年5月份,从港中文电子信息工程毕业后,我进入了华为,成为专业服务部AI使能团队的一份子。彼时,华为的AI产品方兴未艾,项目不多,兜兜转转做了几个大数据的项目,才迎来了第一个AI项目——某地市的TrafficGo项目。 作为现场交付的人员,需要经常和客户交流智慧岛的出行特征分析,交通供给总量,路口-路段-区域的承载力等各种市内交通的特点,而作为新人如何短时间内能让客户认可我们方案的价值以及如何能和客户同频交流是我遇到的最大挑战。 客户不太关注技术实现,更倾向对场景的要求,例如重要单位、重要场所周边的交通路况优化。这里面很多路口信息化设施缺失或不足,如何最小代价发挥我们算法的优势,这个需要好好研究,比如能否从算法上适配这种情况。另外,一块区域给你控制了,和周边没有控制的区域是什么关系?有没有缓进缓出或缓进快出的策略?是否放车快了把周边一些路口堵死? 这样的问题,当时的我根本都招架不住,很多次只能跟客户说,“这个问题,我回去和家里确认一下,会尽快给出方案。”转头便厚着脸皮,一次一次地问研发、问SA、翻看了几大本牛津词典那么厚的交通行业论文集,有时客户也会变成我的老师。就这样啃了几个月,才逐步构建起了我对交通行业的业务知识,能够从容一些地跟客户对话,真正地理解客户的场景痛点,并给出方案。 TrafficGo的项目,我趟过了很多坑,熬了很多个夜,被拒绝了不下百次,拉了无数个电话会议。后来我发现,其他项目压力再大,我都能扛过去。也许像跟领导聊天时他提到的那样:“五岳归来不看山,黄山归来不看岳。”非常幸运,我的成长被组织看见,被评为了地区部优秀新人。 21年下半年由于组织调整,我的TL转战公有云,而我接过接力棒,带领团队10个人在HCS继续拓展和交付。这对我而言,也是一次全新的挑战。 从小白到带领一个团队,我在交付这条路上,也不知不觉走了2年多。有一天中午午休,和同事喝咖啡,她问我,进华为以来,我变化最大的三点是什么?我当时脑子里蹦出了2点。 最先蹦出来的是,就是做交付以后,我对数字化架构有了更宏观的理解,更多地站在架构的角度去思考问题,而不是局限在问题本身。 举个例子,在做TrafficGO的标准化方案时,我们的第一步标准动作,是将路口视频结构化处理,标注关键信息,例如什么时间点,出现了什么车,先哪个方向转弯,时速多少等等。然后,我们会将结构化的数据上载到TrafficGo的算法模型中,然后通过训练及调优,设置出策略,再将策略下放到信号机中,自动调节红绿灯亮灭时间。 初入项目时,我投入了大量精力在前期的视频结构化处理上,也非常在意问题和告警的出现。随着对行业理解的深入,我发现如果站在整个架构的层面,就不难发现其实当前很多摄像头已经存储了结构化的数据,经过校验之后,可以打通网闸,直接对接到平台上用于模型训练。这样不仅节省了交付团队很多的时间,也减低了交警们协调外场的工作量。一旦站在了更高的维度看问题,低维度的问题就不再是问题了。 另外一点,我的项目管理能力也得到很大的提升。作为AI专业服务工程师,尤其在智慧政务这种集成项目中,我们往往还身兼数职:补充大PM的盲区,承担EI领域的项目管理;SA不在现场时,充当SA解答客户关于方案设计的问题。其中,由于TrafficGo由华为和4-5家ISV联合,而TrafficGo项目往往属于直签,需要由华为兜底。因此我的工作中很大部分需要去识别项目过程中的风险,推动ISV或者华为的同事完成问题闭环。这不仅需要风险识别能力,更需要项目管理能力。项目管理能力的提升,也使我在带领团队更有底气和更从容了。 作为跟AI解决方案一起成长起来的工程师,最后想谈谈我对AI专业服务的价值的看法。 AI专业服务的价值,在于端到端的交付,真正实现AI赋能行业。2019年前后,公司单独卖Model Arts平台,客户并不懂怎么用好;单卖算法,只能解决客户部分核心的问题,无法解决全局的问题。 如果说算力是电厂,真正能让用户享受到电厂的科技红利是电器,而真正能让用户享受到算力带来的好处的,是应用。而AI专业服务是连接算力到应用的最后一公里。 而这最后一公里要打通,非常吃行业知识。还是以交通智能体为例,很多三四线城市的交警客户,对交通优化一直处于感性的认识中,优化方式也仅限于让某个方向的绿灯多放行几秒。但是我们和客户交流过程中,都会基于现阶段的数据进行客观分析,例如某个区域早高峰从东向西方向的车流量多,而晚高峰则相反。有些路口通过分析已达到饱和,通过配时优化已无法显著提高通行效率,那我们可能建议交警修改标志标线进行优化。许昌的在试点过程中,选取了两条市区内的主干道(16个路口)进行优化,优化前后对比相同距离通行时间缩短了26%左右,这对客户是个很满意的优化结果。 除了交通智能体,我们还有政务智能体、配煤配料智能体、供暖智能体等近20个行业的解决方案,只有真正触达行业客户的痛点,才有可能以AI的手段解决问题、创造价值。 未来,我也希望在团队内部构建算法的能力。我们在一个个的项目中,深耕行业,掌握大量一手行业数据,相比研发,我们在算法打造上也许能更贴近客户的需求。我希望自己成为那个懂AI,更懂行的工程师。
-
人工智能帮助发现系外行星上的分子,甚至有一天可能会发现新的物理定律你知道地球的大气是由什么组成的吗?你可能记得它是氧气,也可能是氮气。借助 Google 的一点帮助,您可以轻松得出更精确的答案:78% 的氮气、21% 的氧气和 1% 的氩气。大气可以表明行星的性质,以及它们是否可以承载生命。然而,当谈到外大气层——太阳系外行星的大气层——的组成时,答案是未知的。由于系外行星如此遥远,已证明探测它们的大气层极其困难。研究表明,人工智能 (AI) 可能是探索它们的最佳选择——但前提是能够证明这些算法以可靠、科学的方式思考,而不是欺骗系统。来自伦敦大学的研究人员提出了一些通用评估方法,可以应用于任何训练有素的 AI 模型。特别是,他们训练了三种不同的流行深度神经网络(DNN)架构来从系外行星光谱中检索大气参数,并表明这三种架构都实现了良好的预测性能。同时研究人员对 DNN 的预测进行了广泛的分析,这可以给定仪器和模型的大气参数的可信度限制。执行基于扰动的敏感性分析,以确定检索结果对频谱的哪些特征最敏感。该团队得出结论,对于不同的分子,DNN 预测最敏感的波长范围确实与其特征吸收区域一致。该方法有助于改进 DNN 的评估并为其预测提供可解释性。该研究以「Peeking inside the Black Box: Interpreting Deep-learning Models for Exoplanet Atmospheric Retrievals」为题,于 2021 年 10 月 13 日发布在《The Astronomical Journal》。天文学家通常利用凌日方法来研究系外行星,这涉及测量当行星从恒星前面经过时恒星发出的光的倾角。如果行星表面存在大气,它可以吸收少量恒星的光。通过在不同波长(光的颜色)下观察这一事件,可以在吸收的星光中看到分子的指纹,在光谱中形成可识别的图案。如果恒星与太阳相似,则木星大小行星的大气产生的典型信号只会使恒星光减少约 0.01%。地球大小的行星产生的信号要低 10-100 倍。这有点像从飞机上发现地面上猫咪的眼睛颜色。未来,詹姆斯·韦伯太空望远镜(JWST)和 The Ariel Space Mission 这两个探测器都将从太空轨道上调查系外行星,它们可以获取数千个系外大气层的高质量光谱。但是,由于大气层的复杂性,对单个凌日行星的分析可能需要数天甚至数周才能完成。科学家们试图训练人工智能来预测大气中各种化学物质的丰度。为了证明人工智能的可靠性,科学家研究了人工智能的思考模式。窥视黑匣子内部如果无法理解,就不能采用理论与工具。也许人工智能中的一个「小故障」,可能会得出在系外行星发现了生命的结论。人工智能在解释它们发现方面很糟糕。即使是人工智能专家也很难确定是什么原因导致网络提供给定的解释。这种劣势阻碍了人工智能技术在天文学领域的应用。研究人员开发了一种方法,可以一瞥人工智能的决策过程。该方法非常直观。假设 AI 必须确认图像是否包含猫。它大概会通过发现某些特征来做到这一点,例如皮毛或脸型。为了了解它所引用的特征和顺序,可以模糊猫的图像的一部分,看看它是否仍然可以识别出它是一只猫。这正是科学家通过「扰动」或改变光谱区域为系外行星探测 AI 所做的训练。通过观察人工智能对系外行星分子丰度的预测在每个区域被修改时是如何变化的(比如说大气中的水),研究人员开始构建人工智能如何思考的「图片」,比如它用来决定大气中的水含量的光谱区域。结果发现训练有素的人工智能在很大程度上依赖于物理现象,例如独特的光谱指纹——就像天文学家一样。事实上,在学习方面,AI 和高中生并没有太大的不同——它会尽量避开艰难的道路(一步步解析),寻找各种捷径(套用公式),获取答案。如果人工智能基于记住它遇到的每一个频谱来做出预测,那将是非常不可取的。这一发现提供了第一种偷窥所谓「人工智能黑匣子」的方法,让研究人员能够评估人工智能所学到的东西。借助这些工具,研究人员现在不仅可以使用 AI 来加速对外部大气的分析,而且还可以验证他们的 AI 是否使用了众所周知的自然法则。也就是说,现在说完全了解人工智能还为时过早。下一步是精确计算每个概念的重要性,以及如何将其处理为决策。这个前景对人工智能专家来说是令人兴奋的。AI 令人难以置信的学习能力源于它从数据中学习「表示」或模式的能力——这种技术类似于物理学家如何发现自然定律。论文链接:https://iopscience.iop.org/article/10.3847/1538-3881/ac1744/meta相关报道:https://phys.org/news/2021-12-ai-reliably-molecules-exoplanets-day.html转发自:https://www.jiqizhixin.com/
-
 # 使用强化学习内置环境 这里通过官方教程简单介绍使用AI Gallery中预置的强化学习算法训练内置环境CartPole示例。gogogo! #### 环境介绍 CartPole,车杆游戏,游戏画面如[图1]所示。游戏中,黑色的方块是一个小车,小车在一维无阻力轨道上运动。小车上连接一根活动杆,杆会左右摇摆。为保证游戏持续进行,小车需要左右移动保持杆子竖直。当小车的移动位置超出游戏界面所示范围或者杆子倾斜角度大于15°,游戏结束。游戏全过程可以理解为AI智能体与环境之间的互动,可以将复杂的因素抽象成以下三个变量。 1. 可采取的动作:左移、右移。 2. 获得奖励规则:左移或右移小车之后游戏没有结束,reward值会+1。 3. 目的:使用强化学习训练一个智能体,玩CartPole游戏,尽可能多获得奖励。 **图1** CartPole游戏画面  #### 进入AI Gallery订阅强化学习算法 ModelArts预置的强化学习算法(名为“强化学习预置算法”)发布在AI Gallery中。您可以前往AI Gallery,订阅此模型,然后同步至ModelArts中。 1. 在ModelArts管理控制台中,在左侧菜单栏中选择“AI Gallery”,进入AI Gallery。 2. 在AI Gallery中,选择“算法”页签,在搜索框中输入“强化学习预置算法”,查找对应的算法。 3. 单击算法名称进入算法详情页,单击右侧的“订阅”,根据界面提示完成算法订阅。 此算法由ModelArts官方提供,目前免费开放。订阅算法完成后,页面的“订阅”按钮显示为“已订阅”。 4. 单击详情页的“前往控制台”,此时弹出“选择云服务区域”对话框,选择对应的区域,然后再单击“确定”, 页面将自动跳转至ModelArts的“算法管理>我的订阅”中同步对应的算法。 **图2** 选择云服务区域  5. 在ModelArts管理控制台的算法管理页面,算法将自动同步至ModelArts中。 未同步的算法,无法直接用于创建训练作业,因此从AI Gallery订阅完成后,需在ModelArts管理控制台执行同步操作。同步成功后,下方界面中的“创建训练作业”按钮可用,且状态变更为“就绪”。 **图3** 同步算法  #### 使用订阅算法创建训练作业 算法订阅成功后,算法将呈现在“算法管理>我的订阅”中,您可以使用订阅的“强化学习预置算法”算法创建训练作业,获得模型。 1. 进入“算法管理>我的订阅”页面,选择订阅的“强化学习预置算法”算法,单击左侧的小三角展开算法,在版本列表中,单击“创建训练作业”。 **图4** 创建训练作业  2. 在创建训练作业页面,参考如下说明填写关键参数。 - “算法来源”:系统默认选择步骤[1](https://support.huaweicloud.com/bestpractice-modelarts/modelarts_10_0033.html#modelarts_10_0033__li15495195512168)订阅的算法,请勿随意修改。 - “训练输入”:由于本场景选择内置环境,无需数据输入。此处请选择一个OBS空目录。 - “训练输出”:选择一个OBS空目录存储训练输出的模型。 - “调优参数”:系统默认的环境ID为“CartPole-v0”,即我们想要训练的环境,无需修改。由于本示例使用的是内置环境,“use\_preset\_env”参数需设置为“True”。其他参数在本示例中建议采用默认值。 - “资源池”:建议选择CPU规格的资源池,例如“modelarts.vm.train.cpu.8u”规格。 **图5** 训练作业参数  **图6** 调优参数配置  3. 参数填写完成后,单击“下一步”,根据界面提示完成训练作业创建。 4. 进入“训练管理>训练作业”页面,等待训练作业完成。 训练作业运行需要几分钟时间,请耐心等待。根据经验,此样例在5分钟左右完成训练。 当训练作业的状态变更为“运行成功”时,表示已运行结束。您可以单击训练作业名称,进入详情页面,了解训练作业的“配置信息”、“日志”、“资源占用情况”等信息。您也可以在配置的“训练输出位置”对应的OBS目录下获得训练生成的模型。 #### 导入模型 1. 在ModelArts管理控制台,选择“模型管理 > 模型”。 2. 在模型列表页面,单击“导入”。进入导入模型页面,参考如下说明填写关键参数。 “元模型来源”:选择“从训练中选择”。然后在“选择训练作业”右侧下拉框中选择上一步创建的训练作业。 **图7** 从训练中选择模型  3. 模型导入参数填写完成后,单击“立即创建”。页面自动跳转至模型列表页面,等待模型导入结果。 当模型的状态变为“正常”时,表示模型导入成功。 **图8** 模型导入成功  #### 部署为在线服务 模型导入成功后,可将此模型部署为在线服务,部署完成后即可在ModelArts管理控制台进行预测。 1. 在模型列表中,单击操作列的“部署 > 在线服务”。 **图9** 部署模型  2. 在部署页面,参考如下说明填写关键参数。 “资源池”:选择“公共资源池”。 “选择模型及配置”:“模型”及“版本”会自动选择前面导入的模型。“计算节点规格”,在下拉框中选择CPU或GPU,本示例选择CPU资源进行部署。计算节点个数,需设置为“1”,目前仅支持单机部署,只能设置为“1”,不可修改。 其他参数可使用默认值。 **图10** 部署模型参数  3. 参数设置完成后,单击“下一步”,根据界面提示,完成在线服务的部署。 您可以进入“在线服务”列表页面,等待服务部署结束,当服务状态变为“运行中”时,表示服务部署成功。 4. 在线服务部署完成后,您可以单击服务名称进入服务详情页。 - **访问服务**:了解“调用指南”,获取“API接口地址”,了解“输入参数”和“输出参数”,可通过postman或使用curl命令发送请求,[访问在线服务](https://support.huaweicloud.com/engineers-modelarts/modelarts_23_0063.html)。 **图11** 调用指南  **预测**:单击“预测”页签,输入相应的参数或代码,单击“预测”即可看到运行结果,具体格式及要求参考算法说明文档。给出一组可用于推理预测的标准示例数据及格式,如下所示: {"seq\_lens": \[0\],"is\_training": "False","observations": \[\[0.02160617659181513,0.022702596137138,\-0.026817784180154104,0.04523499832683836\]\]} 说明: 在线部署推理仅为单步预测,如果想实现完整的游戏推理,需要使用训练保存的模型或调用在线服务API的方式,编写相应的推理程序。 **图12 **预测结果  到这里全过程结束
-
-
-
-
 作为区块链行业Web3.0 时代的引领者,DFINITY的愿景是打造全球第一个区块链计算机- Internet Computer。基础设施的商业突破不是从C端开始,而是需要越来越多的开发者建设公链生态。因此,在今年5月完成主网上线之后,DFINITY投入更多的精力在全球寻找开发者。11月15日,DFINITY与IAF联合官宣第一次举办亚洲黑客松比赛,社区反响强烈,数十支队伍参与报名。为了帮助大家更好学习Internet Computer 开发,DFINITY联合巴比特、链节点、DoraHacks先后组织了线下线上技术分享会和连续两周线上WorkShop,邀请DFINITY生态中最优秀的生态建设者深入讲解了DFINITY的开发、技术架构和已开发Demo展示。目前,大部分开发者对DFINITY技术有了初步掌握,已经迫不及待在Internet Computer上开发自己的Demo。今天,DFINITY黑客松的赛题正式公布,包括主赛题和副赛题。由DFINITY命题的主赛题,开发者需要基于Internet Computer,围绕DeFi、Dapp、NFT、Game、Social等赛道,为赋能 DFINITY生态繁荣,构建数字化和智能化的未来世界贡献创新方案。副赛题围绕进一步完善Internet Computer工具。黑客松裁判员队伍由线上线下两部分组成,线上由 D创始人兼首席科学家Dominic Williams、CTO Jan Camenisch 、以及核心技术工程师Paul Liu 亲自领衔评审项目代码以及项目创意,线下由SNZ Holding、Hashkey Capital、分布式资本、A&T Capital、原语里弄、万向区块链、Anmi Capital等社区及投资机构裁判评估黑客松现场Demoday表现。本次大赛设置了六个奖项,参赛队伍作品通过评委打分后,将决出一二三等奖以及特色奖项赢得总计高达$65K奖金。本次黑客松是打响DFINITY生态大爆炸的第一枪,明年,还有声势更为浩大的2022 DFINITY Supernova全球黑客松,我们期待更多DFINITY技术爱好者的加入!!一起来Hacking!一、黑客松日程:11月15日 开启报名12月07日 公布IC挑战题目12月07-13日 参赛队伍提交初审材料12月14日 公布初审结果12月17-18日 上海黑客松 Hacking ,截止提交Demo12月19日 上海线下Demo day二、奖项设置:一等奖:$8,000+$5,000 Grant 1位二等奖:$8,000 2位三等奖:$4,000 3位最佳新秀潜力奖:$3,000 2位最受社区喜爱奖:$3,000 1位机构赞助Bounty奖项:$3,000 5位三、黑客松赛题:[主赛题]:在IC上建立一个 开放式金融(DeFi) 项目在IC上建立一个 数字收藏品(NFT) 项目在IC上建立一个 去中心化应用(Dapp) 项目在IC上建立一个 游戏(Game) 项目在IC上建立一个 社交(Social) 项目[副赛题](机构赞助Bounty奖项):题目1. 在EVM 里面运行的程序,验证 ICP certification 的签名- 目的是在 EVM 合约里验证 ICP 上的交易- https://github.com/witnet/bls-solidity BLS 256 only- https://github.com/alita-moore/BLS12-381-Huff- ICP Certification 需要 BLS12-381 -https://sdk.dfinity.org/docs/interface-spec/index.html#certification题目2. Motoko library-https://github.com/dfinity -签名验证的算法,比如 ed25519,secp256k1-Candid-Protobuf题目3. Motoko FFI in Wasm-跨语言调用,比如 motoko 调用 C 或者 Rust 函数题目4. 在浏览器里面运行Motoko Wasm-方便前端和后端共享代码题目5. Cycle 余额提醒-当 canister 的 cycle 不足时,发邮件提醒 (可以用 DMail )-获取 cycle 余额可以用 https://github.com/ninegua/ic-blackhole-需要用 heartbeat题目6. 给 Asset canister 添加功能-支持 Cache-Control-支持 /sha256/xxxxxxxxx 路径,通过 sha256 直接获取 asset-大文件分段增量断点续传 chunk-based sync四、裁判队伍:裁判(Online):Dominic Williams | DFINITY 创始人兼首席科学家Jan Camenisch | DFINITY CTOPaul Liu | DFINITY 核心技术工程师裁判(Offline):Neo Liang | SNZ CTO肖晓 | HashKey Capital投资总监Kobby | 分布式资本投资经理于隽 | A&T Capital 创始人沙漏时间 | 原语里弄发起人郝玉琨 | 上海万向区块链股份公司高级总监Punk | Anmi Capital 创始人五、DemoDay作品要求:• 有完整项目概述,包括项目如何利用Internet Computer为用户提供价值(可以是包含在 Github 的 README 中,也可以是单独的文档)• 有公开可用存储库的链接(例如Github)• 项目已部署并已在互联网计算机的主网上线• 项目具有后端Canister逻辑(在 Motoko 或 Rust 中)• 项目有一个可正常操作的用户界面(即除后端代码之外,还需要拥有前端界面)额外加分项:• 如果项目与互联网计算机身份认证机制(例如互联网身份、Plug钱包、Stoic 钱包等,或者您也可以创建他们自己的身份认证方法)集成,在裁判评审时,则可以获得额外加分六、评选规则:一、二、三等奖a.每个参赛团队派出一位代表, 线上或线下结合进行演讲分享b.评委根据作品完整度、技术难度、创新性、商业价值等多维度进行打分(比赛鼓励新的项目与创意,活动举办期间的工作量将作为项目评审的重要标准之一)c.根据评委评分得出最终排名最佳新秀潜力奖:$3,000 2位在项目评审中,由大学生组建的队伍可以参选。根据项目展示评委打分,获得前两名的高校队伍可获得最佳新秀潜力奖最受社区喜爱奖:$3,000 1位-参赛队伍在推特平台上转发活动海报,并文字介绍自己的项目简介与亮点,根据”转发量+点赞量”作为评判指标-参赛队伍需要在12月18日18点 现场提交相关截图,用于统计转发和点赞-参赛队伍推特平台”转发量+点赞量“排名第一且入围DemoDay团队可获得“最受社区喜爱奖”-社区投票环节严禁女巫攻击和诱导性投票,一经发现立刻取消参赛资格机构赞助Bounty奖项:$3,000 5位-参赛队伍参赛主题须符合某一个机构赞助Bounty赛题要求七、比赛注意事项:【如果你还没报名黑客松比赛】11月15日-12月13日,还未报名黑客松的点击下方报名链接报名·黑客松报名链接【已报名队伍,12月13日前提交初审材料】12月13日12:00前,参赛队长请提交项目初审材料与完整团队信息12月14日,主办方会根据提交的初审材料通知入围队伍参加线下DemoDay·初审材料提交:【初审资料】Warpspeed 2021 DFINITY×IAF黑客松-本次活动的最终解释权归DFINITY所有。
-
集成式开发环境IDEhttps://www.huaweicloud.com/product/modelarts/ide.html云原生Notebook服务,快速接入分享案例内容,让AI探索&教学更简单。在ModelArts Studio中统一管理AI开发全流程,提升开发效率,并记录模型构建实验全流程。本地IDE+ModelArts插件远程开发能力,运行环境自定义,云上云下,无缝协同。关键特性ModelArts CodeLab云原生Notebook服务,案例内容秒级接入与分享Serverless化实例管理,资源自动回收免费算力 + 规格按需切换ModelArts StudioAI开发全流程统一管理提升开发效率构建AI应用工作流加速模型迭代记录模型构建实验全流程,提高模型可靠性支持机器学习,深度学习,强化学习,决策优化ModelArts Studio extension for PyCharm and VScode本地IDE+ModelArts插件远程开发能力。贴近开发人员使用习惯云上开发环境,包含AI计算资源,云上存储,预制AI引擎运行环境自定义将开发环境直接保存成为镜像,供训练、推理使用
-
 >摘要:遥感影像,作为地球自拍照,能够从更广阔的视角,为人们提供更多维度的辅助信息,来帮助人类感知自然资源、农林水利、交通灾害等多领域信息。本文分享自华为云社区[《AI+云原生,把卫星遥感虐的死去活来》](https://bbs.huaweicloud.com/blogs/296183?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content),作者:tsjsdbd。 # AI牛啊,云原生牛啊,所以1+1>2? 遥感影像,作为地球自拍照,能够从更广阔的视角,为人们提供更多维度的辅助信息,来帮助人类感知自然资源、农林水利、交通灾害等多领域信息。 AI技术,可以在很多领域超过人类,关键是它是自动的,省时又省力。可显著提升遥感影像解译的工作效率,对各类地物元素进行自动化的检测,例如建筑物,河道,道路,农作物等。能为智慧城市发展&治理提供决策依据。 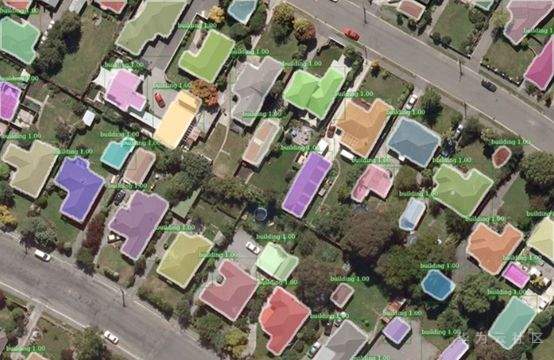 云原生技术,近年来可谓是一片火热。易构建,可重复,无依赖等优势,无论从哪个角度看都与AI算法天生一对。所以大家也可以看到,各领域的AI场景,大都是将AI推理算法运行在Docker容器里面的。 AI+云原生这么6,那么强强联手后,地物分类、目标提取、变化检测等高性能AI解译不就手到擒来?我们也是这么认为的,所以基于AI+Kubernetes云原生,构建了支持遥感影像AI处理的空天地平台。 不过理想是好的,过程却跟西天取经一般,九九八十一难,最终修成正果。 # 业务场景介绍 遇到问题的业务场景叫影像融合(Pansharpen),也就是对地球自拍照进行“多镜头合作美颜”功能。(可以理解成:手机的多个摄像头,同时拍照,合并成一张高清彩色大图)。 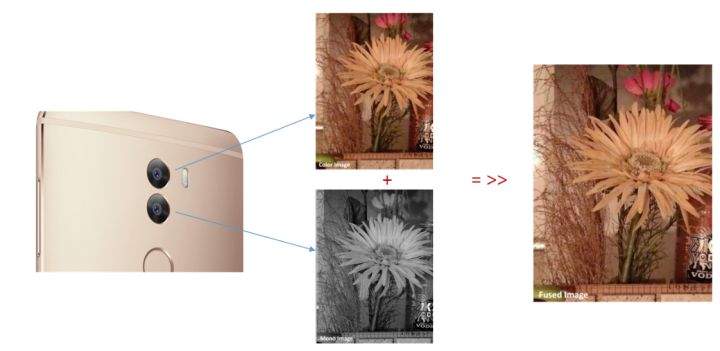 所以业务简单总结就是:读取2张图片,生成1张新的图片。该功能我们放在一个容器里面执行,每张融合后的结果图片大约5GB。 问题的关键是,一个批次业务量需要处理的是3000多张卫星影像,所以每批任务只需要同时运行完成3000多个容器就OK啦。云原生YYDS! # 业务架构图示 为了帮助理解,这里分解使用云原生架构实现该业务场景的逻辑图如下: 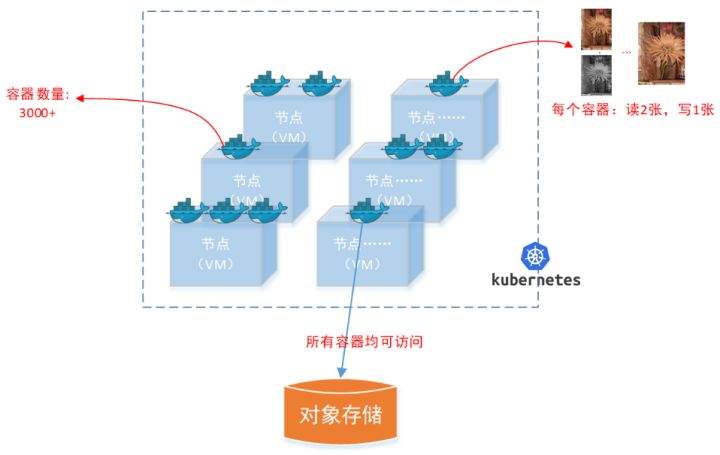 在云上,原始数据,以及结果数据,一定是要存放在对象存储桶里面的。因为这个数据量,只有对象存储的价格是合适的。(对象存储,1毛钱/GB。文件存储则需要3毛钱/GB) 因为容器之间是互相独立无影响的,每个容器只需要处理自己的那幅影像就行。例如1号容器处理 1.tif影像;2号容器处理2.tif影像;一次类推。 所以管理程序,只需要投递对应数量的容器(3000+),并监控每个容器是否成功执行完毕就行(此处为简化说明,实际业务场景是一个pipeline处理流程)。那么,需求已经按照云原生理想的状态分解,咱们开始起(tang)飞(keng)吧~ 注:以下描述的问题,是经过梳理后呈现的,实际问题出现时是互相穿插错综复杂的。 # K8s死掉了 当作业投递后,不多久系统就显示作业纷纷失败。查看日志报调用K8s接口失败,再一看,K8s的Master都已经挂了。。。 K8s-Master处理过程,总结版: 1. 发现Master挂是因为CPU爆了 2. 所以扩容Master节点(此次重复N次); 3. 性能优化:扩容集群节点数量; 4. 性能优化:容器分批投放; 5. 性能优化:查询容器执行进度,少用ListPod接口; 详细版: 看监控Master节点的CPU已经爆掉了,所以最简单粗暴的想法就是给Master扩容呀,嘎嘎的扩。于是从4U8G * 3 一路扩容一路测试一路失败,扩到了32U64G * 3。可以发现CPU还是爆满。看来简单的扩容是行不通了。 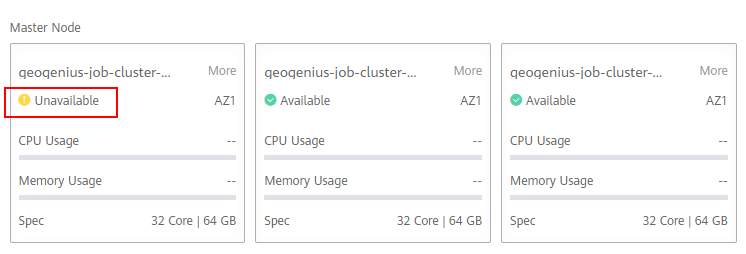 3000多个容器,投给K8s后,大量的容器都处于Pending状态(集群整体资源不够,所以容器都在排队呢)。而正在Pending的Pod,K8s的Scheduler会不停的轮训,去判断能否有资源可以给它安排上。所以这也会给Scheduler巨大的CPU压力。扩容集群节点数量,可以减少排队的Pod数量。 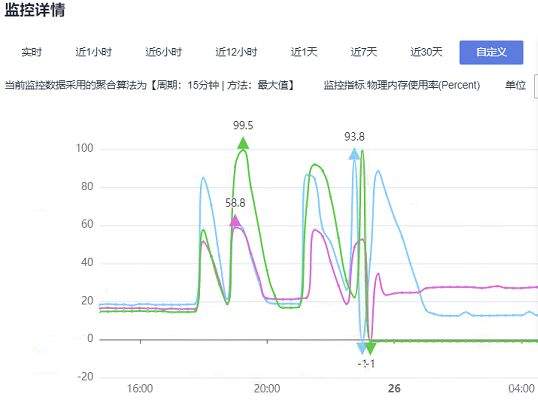 另外,既然排队的太多,不如就把容器分批投递给K8s吧。于是开始分批次投递任务,想着别一次把K8s压垮了。每次投递数量,减少到1千,然后到500,再到100。 同时,查询Pod进度的时候,避免使用ListPod接口,改为直接查询具体的Pod信息。因为List接口,在K8s内部的处理会列出所有Pod信息,处理压力也很大。 这一套组合拳下来,Master节点终于不挂了。不过,一头问题按下去了,另一头问题就冒出来了。 # 容器跑一半,挂了 虽然Master不挂了,但是当投递1~2批次作业后,容器又纷纷失败。 容器挂掉的处理过程,总结版: 1. 发现容器挂掉是被eviction驱逐了; 2. Eviction驱逐,发现原因是节点报Disk Pressure(存储容量满了); 3. 于是扩容节点存储容量; 4. 延长驱逐容器(主动kill容器)前的容忍时间; 详细版: (注:以下问题是定位梳理后,按顺序呈现给大家。但其实出问题的时候,顺序没有这么友好) 容器执行失败,首先想到的是先看看容器里面脚本执行的日志呗:结果报日志找不到~  于是查询Pod信息,从event事件中发现有些容器是被Eviction驱逐干掉了。同时也可以看到,驱逐的原因是 DiskPressure(即节点的存储满了)。 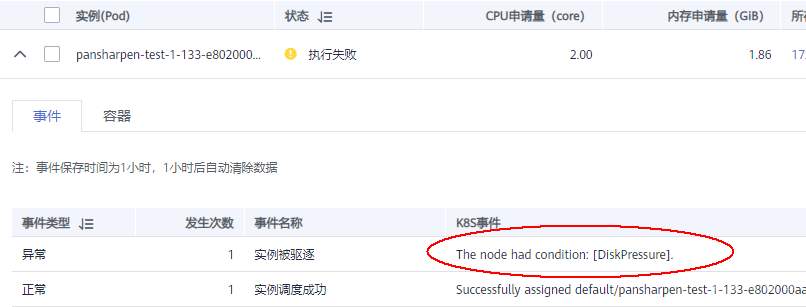 当Disk Pressure发生后,节点被打上了驱逐标签,随后启动主动驱逐容器的逻辑:  由于节点进入Eviction驱逐状态,节点上面的容器,如果在5分钟后,还没有运行完,就被Kubelet主动杀死了。(因为K8s想通过干掉容器来腾出更多资源,从而尽快退出Eviction状态)。 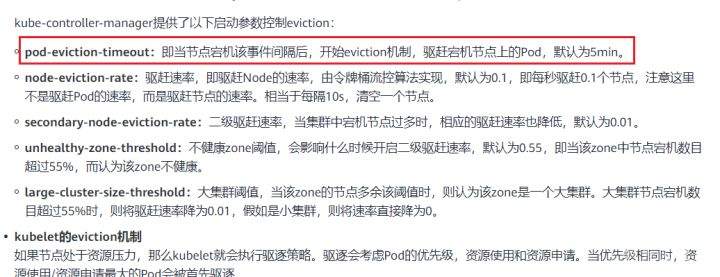 这里我们假设每个容器的正常运行时间为1~2个小时,那么不应该一发生驱动就马上杀死容器(因为已经执行到一半的容器,杀掉重新执行是有成本浪费的)。我们期望应该尽量等待所有容器都运行结束才动手。所以这个 pod-eviction-timeout 容忍时间,应该设置为24小时(大于每个容器的平均执行时间)。 Disk Pressure的直接原因就是本地盘容量不够了。所以得进行节点存储扩容,有2个选择:1)使用云存储EVS(给节点挂载云存储)。 2)扩容本地盘(节点自带本地存储的VM)。 由于云存储(EVS)的带宽实在太低了,350MB/s。一个节点咱们能同时跑30多个容器,带宽完全满足不了。最终选择使用 i3类型的VM。这种VM自带本地存储。并且将8块NVMe盘,组成Raid0,带宽还能x8。 # 对象存储写入失败 容器执行继续纷纷失败。 容器往对象存储写入失败处理过程,总结版: 1. 不直接写入,而是先写到本地,然后cp过去。 2. 将普通对象桶,改为支持文件语义的并行文件桶。 详细版: 查看日志发现,脚本在生成新的影像时,往存储中写入时出错: 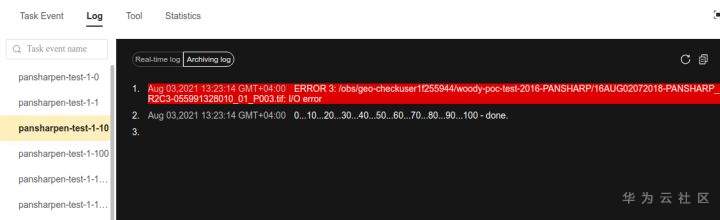 我们整集群是500核的规模,同时运行的容器数量大概在250个(每个2u2g)。这么多的容器同时往1个对象存储桶里面并发追加写入。这个应该是导致该IO问题的原因。 对象存储协议s3fs,本身并不适合大文件的追加写入。因为它对文件的操作都是整体的,即使你往一个文件追加写入1字节,也会导致整个文件重新写一遍。 最终这里改为:先往本地生成目标影像文件,然后脚本的最后,再拷贝到对象存储上。相当于增加一个临时存储中转一下。 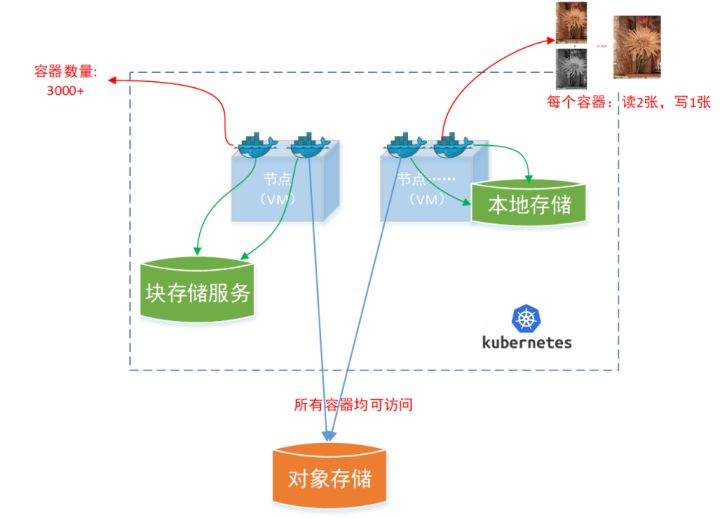 在临时中转存储选择中,2种本地存储都试过: 1)块存储带宽太低,350MB/s影响整体作业速度。2)可以选择带本地存储的VM,多块本地存储组成Raid阵列,带宽速度都杠杠滴。 同时,华为云在对象存储协议上也有一个扩展,使其支持追加写入这种的POSIX语义,称为并行文件桶。后续将普通的对象桶,都改为了文件语义桶。以此来支撑大规模的并发追加写入文件的操作。 # K8s计算节点挂了 So,继续跑任务。但是这容器作业,执行又纷纷失败鸟~ 计算节点挂掉,定位梳理后,总结版: 1. 计算节点挂掉,是因为好久没上报K8s心跳了。 2. 没上报心跳,是因为kubelet(K8s节点的agent)过得不太好(死掉了)。 3. 是因为Kubelet的资源被容器抢光了(由于不想容器经常oom kill,并未设置limit限制) 4. 为了保护kubelet,所有容器全都设置好limit。 详细版,直接从各类奇葩乱象等问题入手: - 容器启动失败,报超时错误。 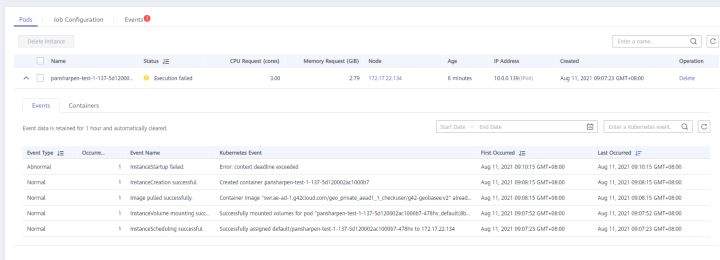 - 然后,什么PVC共享存储挂载失败: 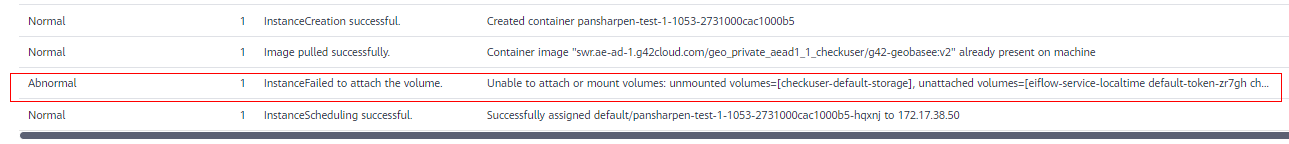 - 或者,又有些容器无法正常结束(删不掉)。 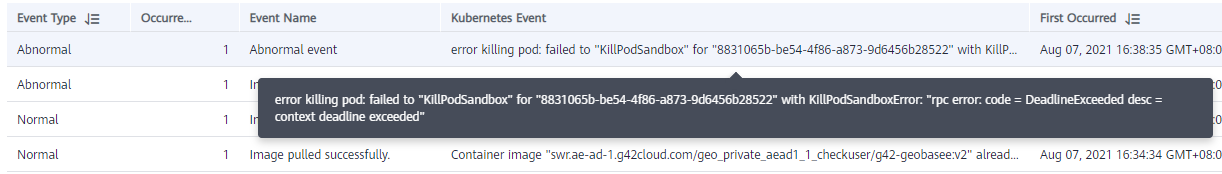 - 查询节点Kubelet日志,可以看到充满了各种超时错误: 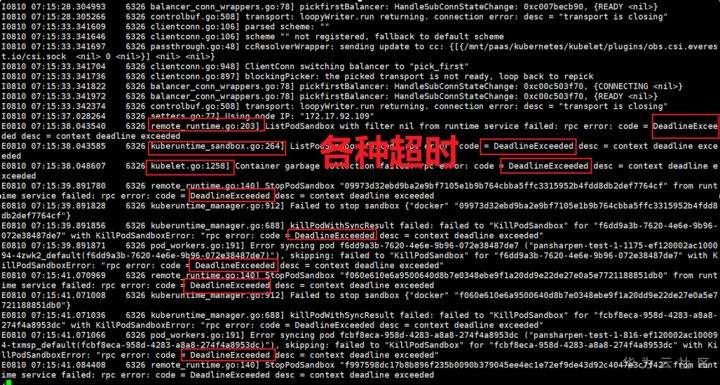 啊,这么多的底层容器超时,一开始感觉的Docker的Daemon进程挂了,通过重启Docker服务来试图修复问题。 后面继续定位发现,K8s集群显示,好多计算节点Unavailable了(节点都死掉啦)。 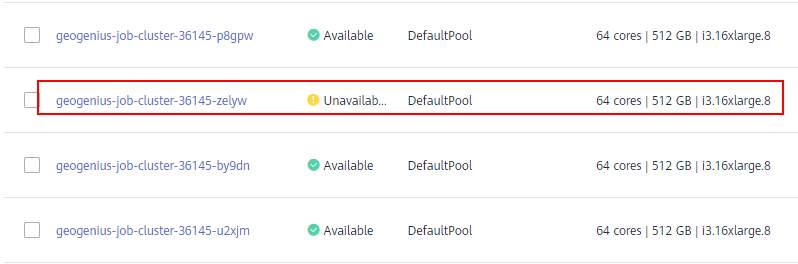 继续分析节点不可用(Unavailable),可以发现是Kubelet好久没有给Master上报心跳了,所以Master认为节点挂了。说明不仅仅是Docker的Daemon受影响,节点的Kubelet也有受影响。 那什么情况会导致Kubelet,Docker这些主机进程都不正常呢?这个就要提到Kubernetes在调度容器时,所设计的Request和Limit这2个概念了。 Request是K8s用来调度容器到空闲计算节点上的。而Limit则会传递给Docker用于限制容器资源上限(触发上限容易被oom killer 杀掉)。前期我们为了防止作业被杀死,仅为容器设置了Request,没有设置Limit。也就是每个容器实际可以超出请求的资源量,去抢占额外的主机资源。大量容器并发时,主机资源会受影响。 考虑到虽然不杀死作业,对用户挺友好,但是平台自己受不了也不是个事。于是给所有的容器都加上了Limit限制,防止容器超限使用资源,强制用户进程运行在容器Limit资源之内,超过就Kill它。以此来确保主机进程(如Docker,Kubelet等),一定是有足够的运行资源的。 # K8s计算节点,又挂了 于是,继续跑任务。不少作业执行又双叒失败鸟~ 节点又挂了,总结版: 1. 分析日志,这次挂是因为PLEG(Pod Lifecycle Event Generator)失败。 2. PLEG异常是因为节点上面存留的历史容器太多(>500个),查询用时太久超时了。 3. 及时清理已经运行结束的容器(即使跑完的容器,还是会占用节点存储资源)。 4. 容器接口各种超时(cpu+memory是有limit保护,但是io还是会被抢占)。 5. 提升系统磁盘的io性能,防止Docker容器接口(如list等)超时。 详细版: 现象还是节点Unavailable了,查看Kubelet日志搜索心跳情况,发现有PLEG is not healthy 的错误: 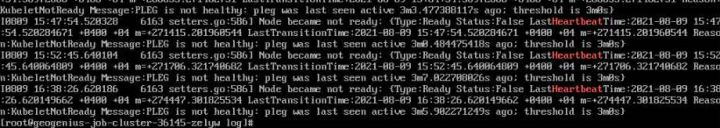 于是搜索PLEG相关的Kubelet日志,发现该错误还挺多: 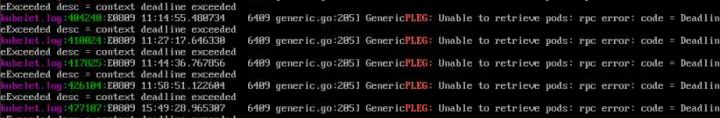 这个错误,是因为kubelet去list当前节点所有容器(包括已经运行结束的容器)时,超时了。看了代码:https://github.com/kubernetes/kubernetes/blob/master/pkg/kubelet/pleg/generic.go#L203 kubelet判断超时的时间,3分钟的长度是写死的。所以当pod数量越多,这个超时概率越大。很多场景案例表明,节点上的累计容器数量到达500以上,容易出现PLEG问题。(此处也说明K8s可以更加Flexible一点,超时时长应该动态调整)。 缓解措施就是及时的清理已经运行完毕的容器。但是运行结束的容器一旦清理,容器记录以及容器日志也会被清理,所以需要有相应的功能来弥补这些问题(比如日志采集系统等)。 List所有容器接口,除了容器数量多,IO慢的话,也会导致超时。 这时,从后台可以看到,在投递作业期间,大量并发容器同时运行时,云硬盘的写入带宽被大量占用: 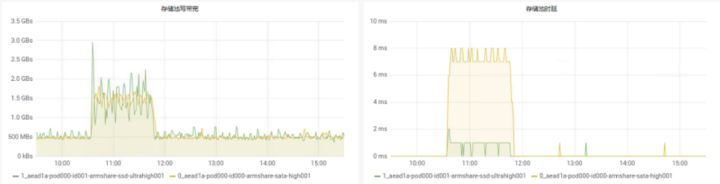 对存储池的冲击也很大: 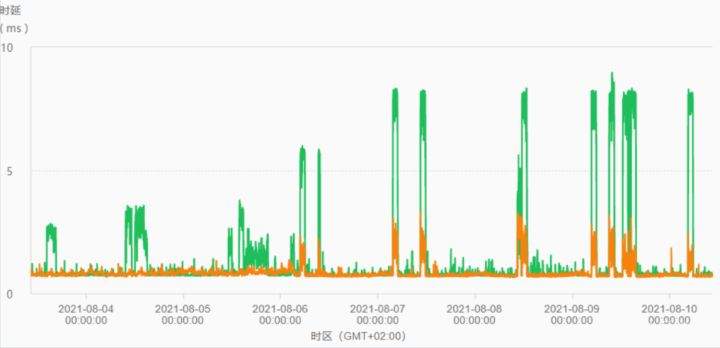 这也导致了IO性能变很差,也会一定程度影响list容器接口超时,从而导致PLEG错误。 该问题的解决措施:尽量使用的带本地高速盘的VM,并且将多块数据盘组成Raid阵列,提高读写带宽。 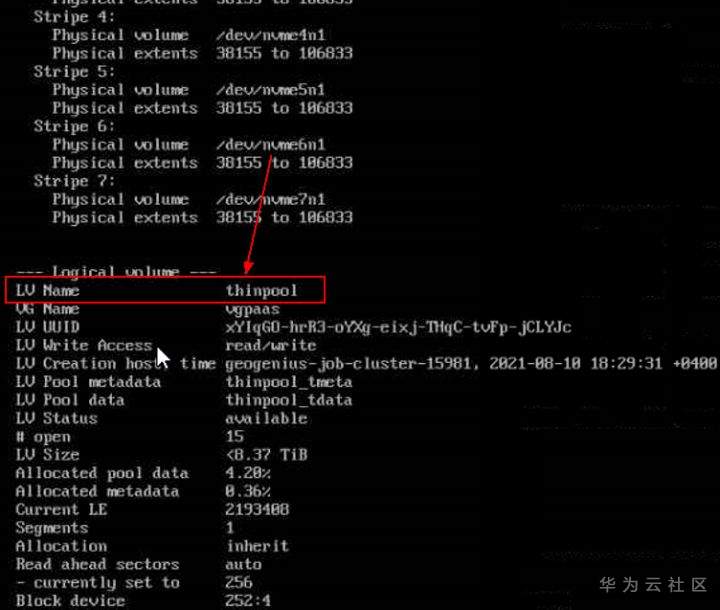 这样,该VM作为K8s的节点,节点上的容器都直接读写本地盘,io性能较好。(跟大数据集群的节点用法一样了,强依赖本地shuffle~)。 在这多条措施实施后,后续多批次的作业都可以平稳的运行完。
-
通过参加华为云HCIA-Cloud Service职业认证训练营的学习,可以学习到更过的云知识,企业上云除了基础的计算服务、存储服务、网络服务的需求之外,有时候还需要其他服务,如数据库类服务、安全类服务、CDN服务、EI企业智能类服务等。这些服务具备云服务按需、易维护的优点,能在一定程度上减少用户侧投资和运维的压力。了解数据库类服务、安全类服务、CDN服务、EI企业智能类服务。其中ModelArts是面向开发者的一站式AI开发平台,为机器学习与深度学习提供海量数据预处理及半自动化标注、大规模分布式Training、自动化模型生成,及端-边-云模型按需部署能力,帮助用户快速创建和部署模型,管理全周期AI工作流。ModelArts是面向开发者的一站式AI开发平台,为机器学习与深度学习提供海量数据预处理及半自动化标注、大规模分布式Training、自动化模型生成,及端-边-云模型按需部署能力,帮助用户快速创建和部署模型,管理全周期AI工作流。
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签