-

-
-
-
 作为区块链行业Web3.0 时代的引领者,DFINITY的愿景是打造全球第一个区块链计算机- Internet Computer。基础设施的商业突破不是从C端开始,而是需要越来越多的开发者建设公链生态。因此,在今年5月完成主网上线之后,DFINITY投入更多的精力在全球寻找开发者。11月15日,DFINITY与IAF联合官宣第一次举办亚洲黑客松比赛,社区反响强烈,数十支队伍参与报名。为了帮助大家更好学习Internet Computer 开发,DFINITY联合巴比特、链节点、DoraHacks先后组织了线下线上技术分享会和连续两周线上WorkShop,邀请DFINITY生态中最优秀的生态建设者深入讲解了DFINITY的开发、技术架构和已开发Demo展示。目前,大部分开发者对DFINITY技术有了初步掌握,已经迫不及待在Internet Computer上开发自己的Demo。今天,DFINITY黑客松的赛题正式公布,包括主赛题和副赛题。由DFINITY命题的主赛题,开发者需要基于Internet Computer,围绕DeFi、Dapp、NFT、Game、Social等赛道,为赋能 DFINITY生态繁荣,构建数字化和智能化的未来世界贡献创新方案。副赛题围绕进一步完善Internet Computer工具。黑客松裁判员队伍由线上线下两部分组成,线上由 D创始人兼首席科学家Dominic Williams、CTO Jan Camenisch 、以及核心技术工程师Paul Liu 亲自领衔评审项目代码以及项目创意,线下由SNZ Holding、Hashkey Capital、分布式资本、A&T Capital、原语里弄、万向区块链、Anmi Capital等社区及投资机构裁判评估黑客松现场Demoday表现。本次大赛设置了六个奖项,参赛队伍作品通过评委打分后,将决出一二三等奖以及特色奖项赢得总计高达$65K奖金。本次黑客松是打响DFINITY生态大爆炸的第一枪,明年,还有声势更为浩大的2022 DFINITY Supernova全球黑客松,我们期待更多DFINITY技术爱好者的加入!!一起来Hacking!一、黑客松日程:11月15日 开启报名12月07日 公布IC挑战题目12月07-13日 参赛队伍提交初审材料12月14日 公布初审结果12月17-18日 上海黑客松 Hacking ,截止提交Demo12月19日 上海线下Demo day二、奖项设置:一等奖:$8,000+$5,000 Grant 1位二等奖:$8,000 2位三等奖:$4,000 3位最佳新秀潜力奖:$3,000 2位最受社区喜爱奖:$3,000 1位机构赞助Bounty奖项:$3,000 5位三、黑客松赛题:[主赛题]:在IC上建立一个 开放式金融(DeFi) 项目在IC上建立一个 数字收藏品(NFT) 项目在IC上建立一个 去中心化应用(Dapp) 项目在IC上建立一个 游戏(Game) 项目在IC上建立一个 社交(Social) 项目[副赛题](机构赞助Bounty奖项):题目1. 在EVM 里面运行的程序,验证 ICP certification 的签名- 目的是在 EVM 合约里验证 ICP 上的交易- https://github.com/witnet/bls-solidity BLS 256 only- https://github.com/alita-moore/BLS12-381-Huff- ICP Certification 需要 BLS12-381 -https://sdk.dfinity.org/docs/interface-spec/index.html#certification题目2. Motoko library-https://github.com/dfinity -签名验证的算法,比如 ed25519,secp256k1-Candid-Protobuf题目3. Motoko FFI in Wasm-跨语言调用,比如 motoko 调用 C 或者 Rust 函数题目4. 在浏览器里面运行Motoko Wasm-方便前端和后端共享代码题目5. Cycle 余额提醒-当 canister 的 cycle 不足时,发邮件提醒 (可以用 DMail )-获取 cycle 余额可以用 https://github.com/ninegua/ic-blackhole-需要用 heartbeat题目6. 给 Asset canister 添加功能-支持 Cache-Control-支持 /sha256/xxxxxxxxx 路径,通过 sha256 直接获取 asset-大文件分段增量断点续传 chunk-based sync四、裁判队伍:裁判(Online):Dominic Williams | DFINITY 创始人兼首席科学家Jan Camenisch | DFINITY CTOPaul Liu | DFINITY 核心技术工程师裁判(Offline):Neo Liang | SNZ CTO肖晓 | HashKey Capital投资总监Kobby | 分布式资本投资经理于隽 | A&T Capital 创始人沙漏时间 | 原语里弄发起人郝玉琨 | 上海万向区块链股份公司高级总监Punk | Anmi Capital 创始人五、DemoDay作品要求:• 有完整项目概述,包括项目如何利用Internet Computer为用户提供价值(可以是包含在 Github 的 README 中,也可以是单独的文档)• 有公开可用存储库的链接(例如Github)• 项目已部署并已在互联网计算机的主网上线• 项目具有后端Canister逻辑(在 Motoko 或 Rust 中)• 项目有一个可正常操作的用户界面(即除后端代码之外,还需要拥有前端界面)额外加分项:• 如果项目与互联网计算机身份认证机制(例如互联网身份、Plug钱包、Stoic 钱包等,或者您也可以创建他们自己的身份认证方法)集成,在裁判评审时,则可以获得额外加分六、评选规则:一、二、三等奖a.每个参赛团队派出一位代表, 线上或线下结合进行演讲分享b.评委根据作品完整度、技术难度、创新性、商业价值等多维度进行打分(比赛鼓励新的项目与创意,活动举办期间的工作量将作为项目评审的重要标准之一)c.根据评委评分得出最终排名最佳新秀潜力奖:$3,000 2位在项目评审中,由大学生组建的队伍可以参选。根据项目展示评委打分,获得前两名的高校队伍可获得最佳新秀潜力奖最受社区喜爱奖:$3,000 1位-参赛队伍在推特平台上转发活动海报,并文字介绍自己的项目简介与亮点,根据”转发量+点赞量”作为评判指标-参赛队伍需要在12月18日18点 现场提交相关截图,用于统计转发和点赞-参赛队伍推特平台”转发量+点赞量“排名第一且入围DemoDay团队可获得“最受社区喜爱奖”-社区投票环节严禁女巫攻击和诱导性投票,一经发现立刻取消参赛资格机构赞助Bounty奖项:$3,000 5位-参赛队伍参赛主题须符合某一个机构赞助Bounty赛题要求七、比赛注意事项:【如果你还没报名黑客松比赛】11月15日-12月13日,还未报名黑客松的点击下方报名链接报名·黑客松报名链接【已报名队伍,12月13日前提交初审材料】12月13日12:00前,参赛队长请提交项目初审材料与完整团队信息12月14日,主办方会根据提交的初审材料通知入围队伍参加线下DemoDay·初审材料提交:【初审资料】Warpspeed 2021 DFINITY×IAF黑客松-本次活动的最终解释权归DFINITY所有。
-
 集成式开发环境IDEhttps://www.huaweicloud.com/product/modelarts/ide.html云原生Notebook服务,快速接入分享案例内容,让AI探索&教学更简单。在ModelArts Studio中统一管理AI开发全流程,提升开发效率,并记录模型构建实验全流程。本地IDE+ModelArts插件远程开发能力,运行环境自定义,云上云下,无缝协同。关键特性ModelArts CodeLab云原生Notebook服务,案例内容秒级接入与分享Serverless化实例管理,资源自动回收免费算力 + 规格按需切换ModelArts StudioAI开发全流程统一管理提升开发效率构建AI应用工作流加速模型迭代记录模型构建实验全流程,提高模型可靠性支持机器学习,深度学习,强化学习,决策优化ModelArts Studio extension for PyCharm and VScode本地IDE+ModelArts插件远程开发能力。贴近开发人员使用习惯云上开发环境,包含AI计算资源,云上存储,预制AI引擎运行环境自定义将开发环境直接保存成为镜像,供训练、推理使用
-
 >摘要:遥感影像,作为地球自拍照,能够从更广阔的视角,为人们提供更多维度的辅助信息,来帮助人类感知自然资源、农林水利、交通灾害等多领域信息。本文分享自华为云社区[《AI+云原生,把卫星遥感虐的死去活来》](https://bbs.huaweicloud.com/blogs/296183?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content),作者:tsjsdbd。 # AI牛啊,云原生牛啊,所以1+1>2? 遥感影像,作为地球自拍照,能够从更广阔的视角,为人们提供更多维度的辅助信息,来帮助人类感知自然资源、农林水利、交通灾害等多领域信息。 AI技术,可以在很多领域超过人类,关键是它是自动的,省时又省力。可显著提升遥感影像解译的工作效率,对各类地物元素进行自动化的检测,例如建筑物,河道,道路,农作物等。能为智慧城市发展&治理提供决策依据。 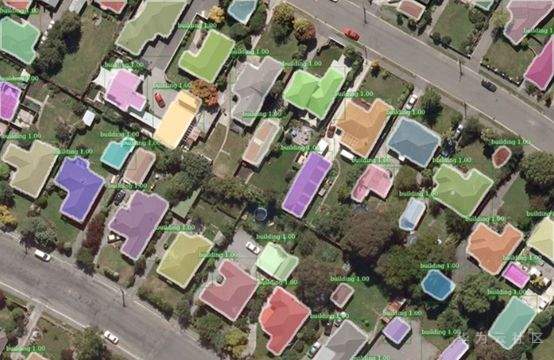 云原生技术,近年来可谓是一片火热。易构建,可重复,无依赖等优势,无论从哪个角度看都与AI算法天生一对。所以大家也可以看到,各领域的AI场景,大都是将AI推理算法运行在Docker容器里面的。 AI+云原生这么6,那么强强联手后,地物分类、目标提取、变化检测等高性能AI解译不就手到擒来?我们也是这么认为的,所以基于AI+Kubernetes云原生,构建了支持遥感影像AI处理的空天地平台。 不过理想是好的,过程却跟西天取经一般,九九八十一难,最终修成正果。 # 业务场景介绍 遇到问题的业务场景叫影像融合(Pansharpen),也就是对地球自拍照进行“多镜头合作美颜”功能。(可以理解成:手机的多个摄像头,同时拍照,合并成一张高清彩色大图)。 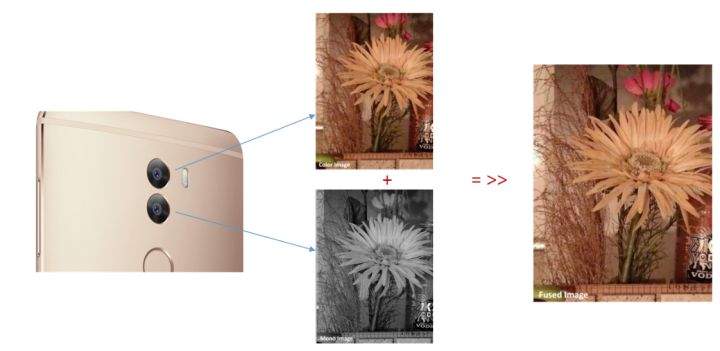 所以业务简单总结就是:读取2张图片,生成1张新的图片。该功能我们放在一个容器里面执行,每张融合后的结果图片大约5GB。 问题的关键是,一个批次业务量需要处理的是3000多张卫星影像,所以每批任务只需要同时运行完成3000多个容器就OK啦。云原生YYDS! # 业务架构图示 为了帮助理解,这里分解使用云原生架构实现该业务场景的逻辑图如下: 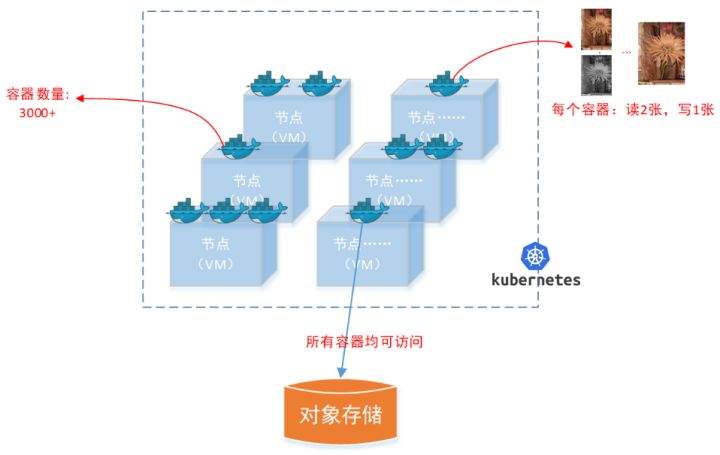 在云上,原始数据,以及结果数据,一定是要存放在对象存储桶里面的。因为这个数据量,只有对象存储的价格是合适的。(对象存储,1毛钱/GB。文件存储则需要3毛钱/GB) 因为容器之间是互相独立无影响的,每个容器只需要处理自己的那幅影像就行。例如1号容器处理 1.tif影像;2号容器处理2.tif影像;一次类推。 所以管理程序,只需要投递对应数量的容器(3000+),并监控每个容器是否成功执行完毕就行(此处为简化说明,实际业务场景是一个pipeline处理流程)。那么,需求已经按照云原生理想的状态分解,咱们开始起(tang)飞(keng)吧~ 注:以下描述的问题,是经过梳理后呈现的,实际问题出现时是互相穿插错综复杂的。 # K8s死掉了 当作业投递后,不多久系统就显示作业纷纷失败。查看日志报调用K8s接口失败,再一看,K8s的Master都已经挂了。。。 K8s-Master处理过程,总结版: 1. 发现Master挂是因为CPU爆了 2. 所以扩容Master节点(此次重复N次); 3. 性能优化:扩容集群节点数量; 4. 性能优化:容器分批投放; 5. 性能优化:查询容器执行进度,少用ListPod接口; 详细版: 看监控Master节点的CPU已经爆掉了,所以最简单粗暴的想法就是给Master扩容呀,嘎嘎的扩。于是从4U8G * 3 一路扩容一路测试一路失败,扩到了32U64G * 3。可以发现CPU还是爆满。看来简单的扩容是行不通了。 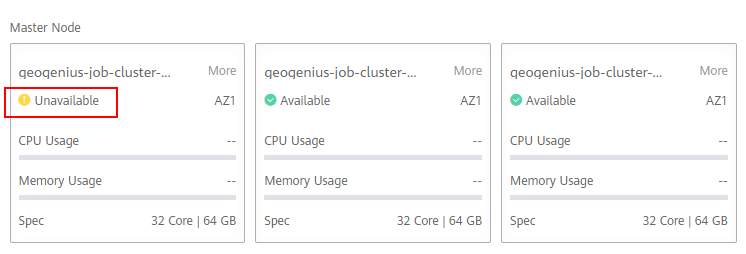 3000多个容器,投给K8s后,大量的容器都处于Pending状态(集群整体资源不够,所以容器都在排队呢)。而正在Pending的Pod,K8s的Scheduler会不停的轮训,去判断能否有资源可以给它安排上。所以这也会给Scheduler巨大的CPU压力。扩容集群节点数量,可以减少排队的Pod数量。 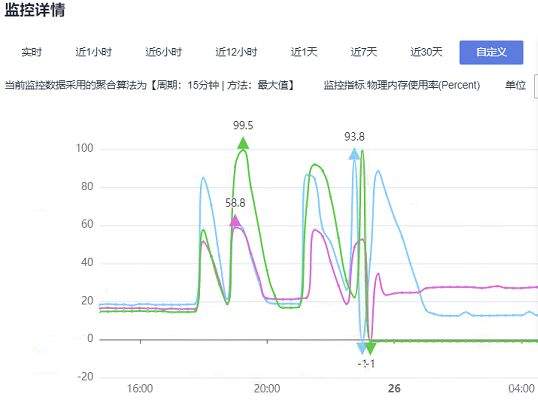 另外,既然排队的太多,不如就把容器分批投递给K8s吧。于是开始分批次投递任务,想着别一次把K8s压垮了。每次投递数量,减少到1千,然后到500,再到100。 同时,查询Pod进度的时候,避免使用ListPod接口,改为直接查询具体的Pod信息。因为List接口,在K8s内部的处理会列出所有Pod信息,处理压力也很大。 这一套组合拳下来,Master节点终于不挂了。不过,一头问题按下去了,另一头问题就冒出来了。 # 容器跑一半,挂了 虽然Master不挂了,但是当投递1~2批次作业后,容器又纷纷失败。 容器挂掉的处理过程,总结版: 1. 发现容器挂掉是被eviction驱逐了; 2. Eviction驱逐,发现原因是节点报Disk Pressure(存储容量满了); 3. 于是扩容节点存储容量; 4. 延长驱逐容器(主动kill容器)前的容忍时间; 详细版: (注:以下问题是定位梳理后,按顺序呈现给大家。但其实出问题的时候,顺序没有这么友好) 容器执行失败,首先想到的是先看看容器里面脚本执行的日志呗:结果报日志找不到~  于是查询Pod信息,从event事件中发现有些容器是被Eviction驱逐干掉了。同时也可以看到,驱逐的原因是 DiskPressure(即节点的存储满了)。 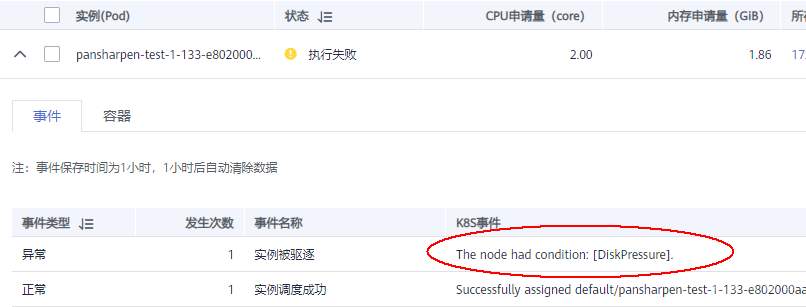 当Disk Pressure发生后,节点被打上了驱逐标签,随后启动主动驱逐容器的逻辑:  由于节点进入Eviction驱逐状态,节点上面的容器,如果在5分钟后,还没有运行完,就被Kubelet主动杀死了。(因为K8s想通过干掉容器来腾出更多资源,从而尽快退出Eviction状态)。 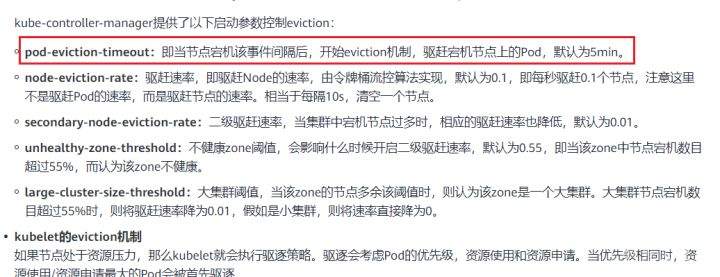 这里我们假设每个容器的正常运行时间为1~2个小时,那么不应该一发生驱动就马上杀死容器(因为已经执行到一半的容器,杀掉重新执行是有成本浪费的)。我们期望应该尽量等待所有容器都运行结束才动手。所以这个 pod-eviction-timeout 容忍时间,应该设置为24小时(大于每个容器的平均执行时间)。 Disk Pressure的直接原因就是本地盘容量不够了。所以得进行节点存储扩容,有2个选择:1)使用云存储EVS(给节点挂载云存储)。 2)扩容本地盘(节点自带本地存储的VM)。 由于云存储(EVS)的带宽实在太低了,350MB/s。一个节点咱们能同时跑30多个容器,带宽完全满足不了。最终选择使用 i3类型的VM。这种VM自带本地存储。并且将8块NVMe盘,组成Raid0,带宽还能x8。 # 对象存储写入失败 容器执行继续纷纷失败。 容器往对象存储写入失败处理过程,总结版: 1. 不直接写入,而是先写到本地,然后cp过去。 2. 将普通对象桶,改为支持文件语义的并行文件桶。 详细版: 查看日志发现,脚本在生成新的影像时,往存储中写入时出错: 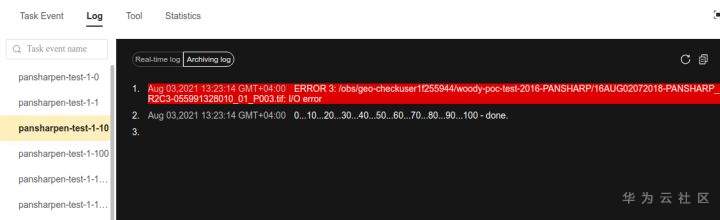 我们整集群是500核的规模,同时运行的容器数量大概在250个(每个2u2g)。这么多的容器同时往1个对象存储桶里面并发追加写入。这个应该是导致该IO问题的原因。 对象存储协议s3fs,本身并不适合大文件的追加写入。因为它对文件的操作都是整体的,即使你往一个文件追加写入1字节,也会导致整个文件重新写一遍。 最终这里改为:先往本地生成目标影像文件,然后脚本的最后,再拷贝到对象存储上。相当于增加一个临时存储中转一下。 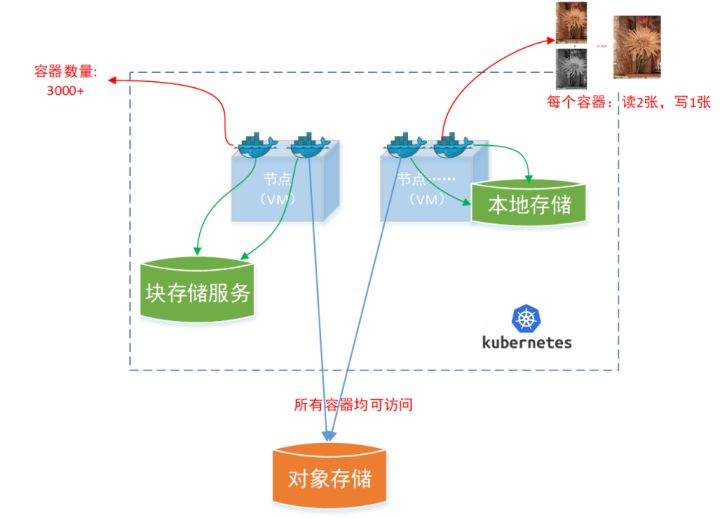 在临时中转存储选择中,2种本地存储都试过: 1)块存储带宽太低,350MB/s影响整体作业速度。2)可以选择带本地存储的VM,多块本地存储组成Raid阵列,带宽速度都杠杠滴。 同时,华为云在对象存储协议上也有一个扩展,使其支持追加写入这种的POSIX语义,称为并行文件桶。后续将普通的对象桶,都改为了文件语义桶。以此来支撑大规模的并发追加写入文件的操作。 # K8s计算节点挂了 So,继续跑任务。但是这容器作业,执行又纷纷失败鸟~ 计算节点挂掉,定位梳理后,总结版: 1. 计算节点挂掉,是因为好久没上报K8s心跳了。 2. 没上报心跳,是因为kubelet(K8s节点的agent)过得不太好(死掉了)。 3. 是因为Kubelet的资源被容器抢光了(由于不想容器经常oom kill,并未设置limit限制) 4. 为了保护kubelet,所有容器全都设置好limit。 详细版,直接从各类奇葩乱象等问题入手: - 容器启动失败,报超时错误。 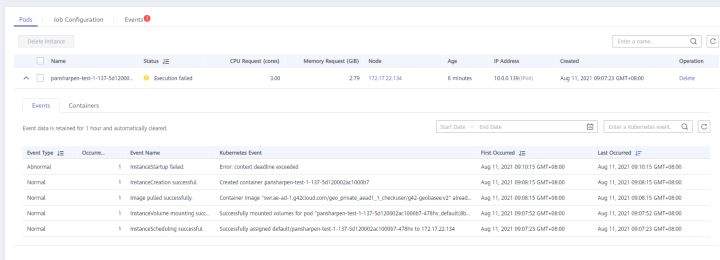 - 然后,什么PVC共享存储挂载失败: 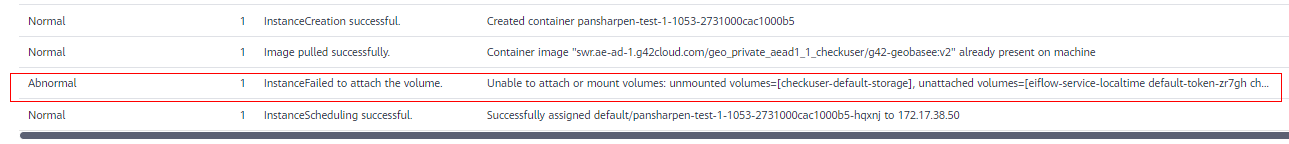 - 或者,又有些容器无法正常结束(删不掉)。 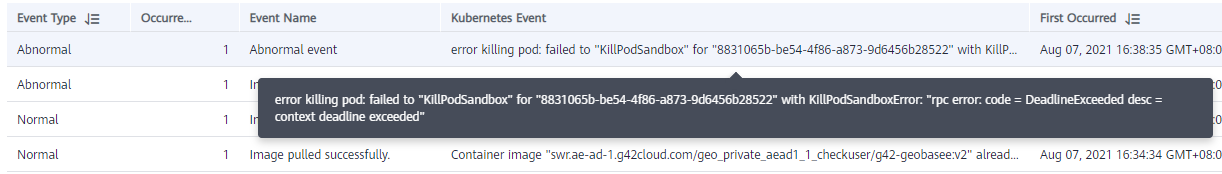 - 查询节点Kubelet日志,可以看到充满了各种超时错误: 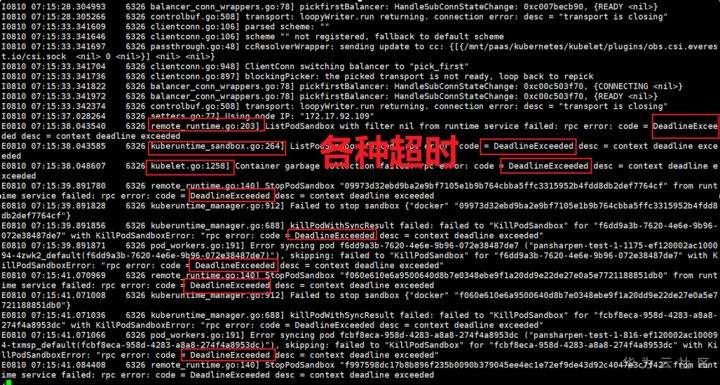 啊,这么多的底层容器超时,一开始感觉的Docker的Daemon进程挂了,通过重启Docker服务来试图修复问题。 后面继续定位发现,K8s集群显示,好多计算节点Unavailable了(节点都死掉啦)。 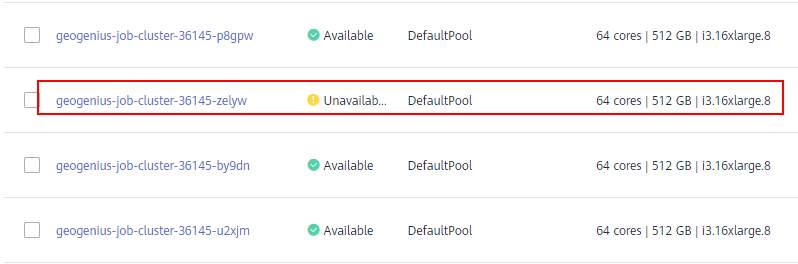 继续分析节点不可用(Unavailable),可以发现是Kubelet好久没有给Master上报心跳了,所以Master认为节点挂了。说明不仅仅是Docker的Daemon受影响,节点的Kubelet也有受影响。 那什么情况会导致Kubelet,Docker这些主机进程都不正常呢?这个就要提到Kubernetes在调度容器时,所设计的Request和Limit这2个概念了。 Request是K8s用来调度容器到空闲计算节点上的。而Limit则会传递给Docker用于限制容器资源上限(触发上限容易被oom killer 杀掉)。前期我们为了防止作业被杀死,仅为容器设置了Request,没有设置Limit。也就是每个容器实际可以超出请求的资源量,去抢占额外的主机资源。大量容器并发时,主机资源会受影响。 考虑到虽然不杀死作业,对用户挺友好,但是平台自己受不了也不是个事。于是给所有的容器都加上了Limit限制,防止容器超限使用资源,强制用户进程运行在容器Limit资源之内,超过就Kill它。以此来确保主机进程(如Docker,Kubelet等),一定是有足够的运行资源的。 # K8s计算节点,又挂了 于是,继续跑任务。不少作业执行又双叒失败鸟~ 节点又挂了,总结版: 1. 分析日志,这次挂是因为PLEG(Pod Lifecycle Event Generator)失败。 2. PLEG异常是因为节点上面存留的历史容器太多(>500个),查询用时太久超时了。 3. 及时清理已经运行结束的容器(即使跑完的容器,还是会占用节点存储资源)。 4. 容器接口各种超时(cpu+memory是有limit保护,但是io还是会被抢占)。 5. 提升系统磁盘的io性能,防止Docker容器接口(如list等)超时。 详细版: 现象还是节点Unavailable了,查看Kubelet日志搜索心跳情况,发现有PLEG is not healthy 的错误: 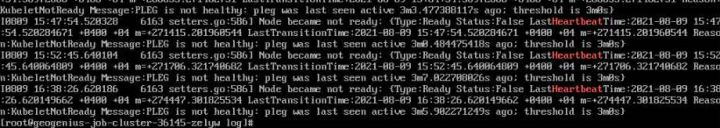 于是搜索PLEG相关的Kubelet日志,发现该错误还挺多: 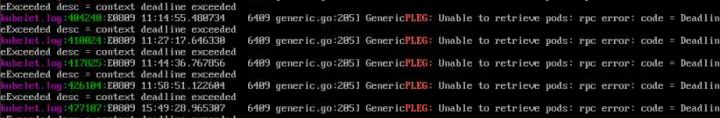 这个错误,是因为kubelet去list当前节点所有容器(包括已经运行结束的容器)时,超时了。看了代码:https://github.com/kubernetes/kubernetes/blob/master/pkg/kubelet/pleg/generic.go#L203 kubelet判断超时的时间,3分钟的长度是写死的。所以当pod数量越多,这个超时概率越大。很多场景案例表明,节点上的累计容器数量到达500以上,容易出现PLEG问题。(此处也说明K8s可以更加Flexible一点,超时时长应该动态调整)。 缓解措施就是及时的清理已经运行完毕的容器。但是运行结束的容器一旦清理,容器记录以及容器日志也会被清理,所以需要有相应的功能来弥补这些问题(比如日志采集系统等)。 List所有容器接口,除了容器数量多,IO慢的话,也会导致超时。 这时,从后台可以看到,在投递作业期间,大量并发容器同时运行时,云硬盘的写入带宽被大量占用: 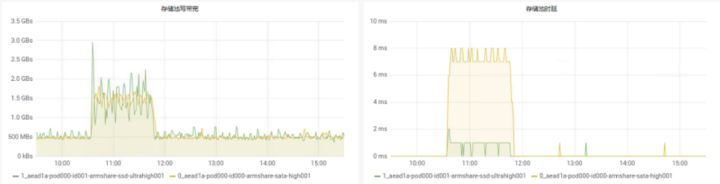 对存储池的冲击也很大: 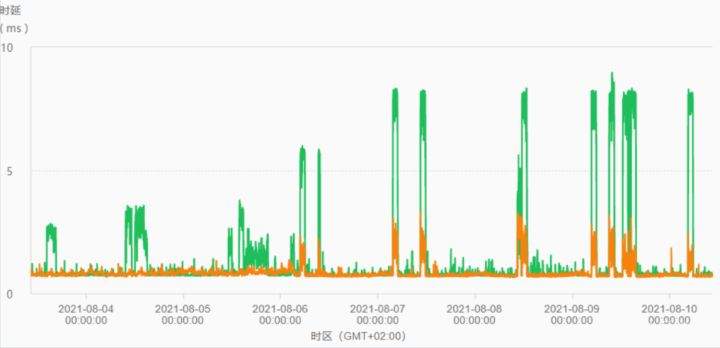 这也导致了IO性能变很差,也会一定程度影响list容器接口超时,从而导致PLEG错误。 该问题的解决措施:尽量使用的带本地高速盘的VM,并且将多块数据盘组成Raid阵列,提高读写带宽。 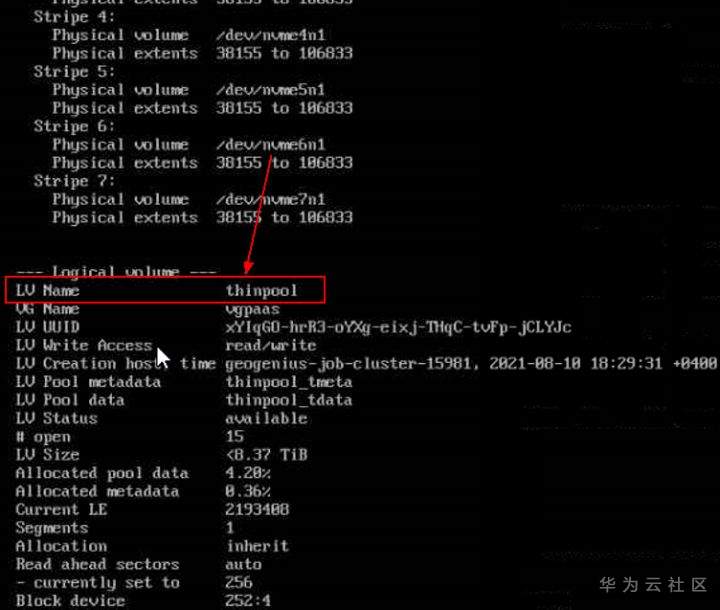 这样,该VM作为K8s的节点,节点上的容器都直接读写本地盘,io性能较好。(跟大数据集群的节点用法一样了,强依赖本地shuffle~)。 在这多条措施实施后,后续多批次的作业都可以平稳的运行完。
-
通过参加华为云HCIA-Cloud Service职业认证训练营的学习,可以学习到更过的云知识,企业上云除了基础的计算服务、存储服务、网络服务的需求之外,有时候还需要其他服务,如数据库类服务、安全类服务、CDN服务、EI企业智能类服务等。这些服务具备云服务按需、易维护的优点,能在一定程度上减少用户侧投资和运维的压力。了解数据库类服务、安全类服务、CDN服务、EI企业智能类服务。其中ModelArts是面向开发者的一站式AI开发平台,为机器学习与深度学习提供海量数据预处理及半自动化标注、大规模分布式Training、自动化模型生成,及端-边-云模型按需部署能力,帮助用户快速创建和部署模型,管理全周期AI工作流。ModelArts是面向开发者的一站式AI开发平台,为机器学习与深度学习提供海量数据预处理及半自动化标注、大规模分布式Training、自动化模型生成,及端-边-云模型按需部署能力,帮助用户快速创建和部署模型,管理全周期AI工作流。
-
 给你个AI语音合成接口,你会玩出什么花样?语音合成,是一种将文本转换成逼真语音的服务。可实时访问和调用API获取语音合成结果,将输入的文字合成为音频。支持音色选择、自定义音量、语速,为企业和个人提供个性化的发音服务即日起至2021年12月31日,体验还有好礼赢取哦奖项&玩法奖励说明简图:如何将文字转语音编码?1.1、点链接>>>访问API Explorer的AI语音合成接口(注意:要登录自己的账号哦,没有账号请注册账号):1.2、在Body里面输入相应参数,点击调试。(将调试成功后的截图(需要漏出账号部分信息)发本论坛评论区,即可获得抽华为自拍杆资格)如何将语音编码转成音频文件?2.1 复制1.2 调试成功的响应体2.2 点开链接>>>访问华为云AI合成音频模板2.3 点击预览代码2.4 用CloudIDE打开2.5 进入CloudIDE双击json文件2.6 将复制2.1复制的响应体粘贴到json文件预置的空数组中(提示:若要拼凑多个转语音编码,可生成多个语音编码的响应体,复制到数组中,用逗号隔开)2.7 点击运行2.8 到Explorer下,选择mp3文件,右键,选择download,即可下载生成音频文件来听啦(也可以将合成的音频文件通过插入音视频的方式分享到评论区来参与评奖哦)以上就是功能用法简略版的介绍了,花样玩法欢迎各位小伙伴大开脑洞,把你的想法或成果分享到本帖评论区,有机会赢迷你音箱或手环哦,也可以参照更详细版的指导手册下方附活动交流&答疑群码,欢迎进群交流~附则:论坛活动通用规则 1)请务必使用个人账号参与活动(IAM、企业账号等账号参与无效)。2)严禁灌水,严禁带有色情、政治、宗教、推广、外链广告内容,严禁抄袭、复制他人内容,一经发现,取消中奖资格。3)请确保您邀请的用户为真实有效的用户,如发现存在恶意注册、恶意邀请等行为(“恶意”是指为获取奖励资格而异常注册账号等破坏活动公平性的行为),我们将取消相关人员获奖资格。同时,将对该账号进行禁言禁止参与社区活动3个月的处罚,行为严重的将对账号进行永久封号。4)获奖用户需在华为云进行实名认证,同一身份信息只能获奖一次。5)对于严重违反活动规则的用户,将纳入社区失信黑名单,取消获奖资格,并做封号处理。6)所有参加本活动的用户,均视为认可并同意遵守《华为云用户协议》《华为云社区运营机制》。其他未尽事宜请参考:1、华为云社区常规活动规则:https://bbs.huaweicloud.com/forum/thread-5766-1-1.html2、所有参加社区活动的开发者用户,均视为认可并同意遵守《华为云开发者用户协议》,包括以援引方式纳入《华为云开发者用户协议》的《可接受的使用政策》、《法律声明》、《隐私政策声明》、相关服务等级协议(SLA),以及华为云服务网站规定的其他协议和政策(统称为“云服务协议”)的约束。云服务协议链接的网址:http://www.huaweicloud.com/declaration/sa_cua.html如您不同意以上活动规则及相关条款,请勿参加论坛相关活动。
-
 人工智能已成为引领新一轮科技革命和产业变革的重要驱动力量和战略性技术。本文采用无监督聚类、复杂网络结构洞和突发检测算法对人工智能高水平会议论文进行深度挖掘分析,梳理人工智能领域的关键技术,全面刻画人工智能领域整体技术结构,洞悉关键技术分布和研发态势,明确人工智能领域代表性国家与机构。研究发现:人工智能领域共包含14个大类、132项热点技术,主要分布在机器学习、自然语言处理、计算机视觉和机器人等子领域,如一眼模仿学习、智能自动问答、光度立体视觉、多传感器融合等;共性技术则主要分布在机器学习子领域,分类、回归、搜索等基础算法以及优化理论方法等共性技术为其他子领域研究实践奠定坚实基础;新兴技术主要集中在深度学习方面,生成对抗网络和注意力机制是其中的典型代表,此外还包括强化学习、自主代理和多代理系统等。在人工智能领域代表性国家与机构方面,美国在各热点技术大类下的发文量均位居全球首位,中国整体仅次于美国,但在强化学习、机器人、智能多代理系统研究方面发文量排名相对靠后;国内机构中,中国科学院在多个热点技术大类下的发文量均位居全球前列。 人工智能是指研究、开发用于模拟、延伸和扩展人的智能的理论、方法、技术及应用系统的一门技术科学。这一概念自1956年被提出后,已历经半个多世纪的发展和演变。21世纪初,随着大数据、高性能计算和深度学习技术的快速迭代和进步,人工智能进入新一轮的发展热潮,其强大的赋能性对经济发展、社会进步、国际政治经济格局等具有重大且深远的影响,已成为引领新一轮科技革命和产业变革的重要驱动力量,是推动人类进入智能时代的核心和重要抓手。 发展热潮之下,全球主要国家积极在人工智能领域深耕布局,国际竞争日益激烈。2017年7月,我国发布《新一代人工智能发展规划》,明确将人工智能作为国家未来重要发展战略,并确定中国人工智能发展“三步走”战略目标,到2030年实现人工智能理论、技术与应用总体达到世界领先水平,成为世界主要人工智能创新中心;2018年3月,法国总统宣布启动15亿欧元的人工智能计划,将在法国建设一个国际级的研发中心,完善数据领域政策,培养法国在人工智能领域的人才,并对技术革新的伦理和规制问题进行反思,以推动法国跻身人工智能领域的领军者行列;2018年4月,欧盟委员会计划2018—2020 年在人工智能领域投资240亿美元;2018年11月,德国联邦内阁通过人工智能国家战略,计划2025年前在联邦层面投入30亿欧元,旨在人工智能领域新增100名教授席位并资助扩建人工智能研发中心;2019年2月,美国总统特朗普签署行政令,启动“美国人工智能倡议”,该倡议提出研发、资源调配、政策、人力资源培养和准备、国际合作五项发展重点领域,以维护美国人工智能领导力。 与此同时,人工智能产业蓬勃发展,全球产业界纷纷调整发展战略,人工智能创新创业如火如荼。2017年,谷歌和微软陆续将企业发展战略和愿景转向人工智能;百度也于2017年将公司使命更改为“用科技让复杂的世界更简单”,希望百度从全球最大的中文搜索引擎彻底转型人工智能科技公司;自2013年以来,全球和中国人工智能行业投融资规模都呈上涨趋势,2017年全球投融资总规模达395亿美元。 人工智能作为一门综合和高度复杂的技术科学,其发展离不开底层多类型关键技术的研发突破和支撑。厘清人工智能领域的关键技术,把握技术现状和发展趋势,将为国家前瞻性战略布局、企业研发重心调整、科研机构和研究人员合理选题提供重要情报参考。2019年3月,李总理在政府工作报告中再次提及人工智能产业的发展,提出要“深化大数据、人工智能等研发应用”。相较于2017年的“加快人工智能等技术研发和转化”和2018年的“加强新一代人工智能研发应用”,“深化”一词不仅反映出我国人工智能发展呈现层层递进和逐步深入的良好态势,也体现了热潮之后我国政府对人工智能的持续重视和未来发展展望。我们应牢牢把握人工智能关键技术和发展方向,明确中国人工智能发展的短板领域和技术,切实响应国家需求,推进人工智能各项战略规划的快速稳健实施,加快人工智能专业型人才和通用型人才培养,构建体系化队伍,加大对人工智能学术及产业力量的扶持力度,培育并打造人工智能发展的中流砥柱,以期人工智能强大的赋能性为经济社会发展注入新的动能。因此,本文以人工智能领域高水平会议论文为分析对象,采用无监督聚类方法、复杂网络结构洞理论和突发词检测算法开展深度挖掘分析,梳理人工智能领域的热点技术、共性技术和新兴技术,以期全面了解人工智能领域整体技术结构,洞悉关键技术分布和研发态势,明确人工智能领域代表性国家与机构。 **1 数据来源与研究方法** **1.1 数据来源** 科技论文记载了科学研究和技术研发活动的大量高价值信息,反映了科技成果诞生的初始状态,是关键技术挖掘的重要数据资源。而在计算机领域,高质量会议论文在学界有着较高的关注度和认可度,同时,相对于期刊论文,会议论文的时效性更好,一定程度上代表着该领域最新、最热的研究内容,本文综合专家咨询意见及数据的可获得性,以中国计算机协会推荐的人工智能领域高水平国际学术会议(A类和B类,共19种)为基础数据源(表1),利用Scopus数据库检索并下载题录数据,包括发表年、标题、关键词、摘要等,时间跨度为2015—2018年,检索时间为2019年1月22日,共18956篇论文,作为人工智能领域关键技术分析挖掘的数据基础。 **1.2 研究方法** 1.2.1 关键技术概念界定 对科技论文内容进行深度挖掘,旨在梳理发现人工智能领域的关键技术,具体包括热点技术、共性技术和新兴技术三类。本文对三类关键技术的概念界定如下: **1)热点技术:**某学科领域内,近年来受到科研人员广泛关注并已产出相应研究成果的主要研究方向和技术主题,反映了学科领域的研发现状和技术结构全貌; **2)共性技术:**对学科领域内其他研究方向和技术主题产生广泛影响、其研究成果可供参考借鉴和分享使用的一类技术,反映了学科领域的重要研发基础和技术前沿,是学科领域内的“思想源泉”或“集大成者”; **3)新兴技术:**某学科领域内,最新出现且短时间内受到广泛关注的研究方向和技术主题,反映了学科领域内具有重要潜在影响的新近研究热点。 1.2.2 研究思路与方法 本文采用无监督聚类方法、复杂网络结构洞理论以及突发检测算法开展人工智能领域关键技术挖掘分析,研究思路如图1所示。 具体研究过程及方法包括: **1)基于K-means++聚类的热点技术挖掘分析** 本文基于python语言,利用NLTK包对会议论文文本数据(标题、摘要和关键词)进行预处理,包括分词、词性标注、词干提取、词性还原、停用词过滤等,利用TF-IDF方法对文本进行向量化表示,采用K-means++算法对数据进行聚类,对各个聚类簇进行解读和调研,形成人工智能领域的热点技术。 **2)基于复杂网络结构洞理论的共性技术挖掘分析** 结构洞理论形容非冗余的联系,指在社会网络中的某个或某些个体与部分个体发生直接联系,但与其他个体不发生直接联系的现象,从网络整体看好像网络结构中出现了洞穴(图2)。结构洞能够为其占据者获取“信息利益”和“控制利益”提供机会,Raider 的实证研究表明:结构洞占据者的位置对信息控制、识别以及交易起着重要的作用。近年来,已有相关学者利用结构洞理论开展共性技术或基础技术的识别,如江娴、叶春蕾、王海龙等。结构洞反映了节点对网络资源的控制能力,占据结构洞的节点能够获取来自多方面的非重复性信息,反映在学科领域研究上,占据结构洞的研究方向更有可能是“思想源泉”或“集大成者”,即领域共性技术,可对学科领域内其他研究方向产生广泛影响。 本文以K-means++聚类得到的热点技术聚类簇为节点,计算聚类簇质心向量间的相似性,以此作为节点间连接和权重的依据,构建网络。基于复杂网络结构洞理论,计算网络中各节点的限制度指标,以此反映节点在网络中运用结构洞的能力。节点的限制度指标值越小,代表节点拥有的结构洞越多,运用结构洞的能力越强,所占据的“信息利益”和“控制利益”越大,以此识别人工智能领域的共性技术。 **3)基于Burst Detection算法的新兴技术挖掘分析** 本文以清洗后的会议论文关键词为分析数据,采用Sci2 tool工具的Burst Detection算法探测最新出现且短时间内受到广泛关注的新兴技术。 **2 人工智能领域关键技术分析** 2.1 人工智能热点技术 人工智能领域的热点技术代表近年来的主要研究方向和技术主题,反映出人工智能领域的技术结构全貌。结合轮廓系数的计算结果,确定聚类簇数量K=140时,具有较好的聚类效果。经人工判读,140个聚类簇中共有132个有效类和8个混杂类。以132个有效类作为节点构建网络,并进行可视化和模块划分,最终形成14项技术大类(图3及表2)。中国和美国在14项技术大类下发文量的全球排名,以及各技术大类的Top5优势机构列举如表3。 机器学习子领域的技术大类包含机器学习算法及应用、强化学习算法、近似及优化算法和规划问题共4项。其中,热点技术主要包括回归、聚类、分类、近似、估计和优化等基础算法的改进研究;迁移学习、多核学习和多视图学习等新型学习方法;策略网络和时间差分学习等强化学习基本方法;机器人及多代理系统计划、路径规划等问题研究;机器学习算法在事件检测、位置识别和社交网络分析中的应用以及强化学习在智能决策中的应用研究。在上述4项技术大类中,美国发文量均居全球首位,中国在机器学习算法及应用、近似及优化算法和规划问题研究方面仅次于美国,但强化学习研究发文量居全球第5位,相对靠后。国内机构在机器学习算法及应用、规划问题研究方面表现较为突出,中国科学院、清华大学和北京大学的发文量位居全球前列。 自然语言处理子领域的技术大类包含自然语言处理技术和自动问答技术共2项。其中,热点技术主要包括特征提取、语义分类、词嵌入、主题模型、关系抽取与分类、知识图谱、注意力模型和长短期记忆模型等基础技术研究,还包括智能自动问答、机器翻译、情感分析、推荐系统等应用研究。在上述2项技术大类中,美国发文量均居全球首位,中国紧随其后。中国科学院在这2项技术大类的发文量均居全球前列,清华大学和北京大学也表现不俗。 计算机视觉子领域的技术大类包含图像处理技术、视频处理技术、图像匹配技术、视觉跟踪技术和对象检测技术共5项。其中,热点技术主要包括视频图像分割、对齐、检测、识别及跟踪所涉及的核心技术研究;三维重建、光度立体视觉、相机校准、行人再识别、人脸对齐与关键点检测等应用研究。在上述5项技术大类中,也都是美国发文量居全球首位,中国紧随其后。中国科学院在图像匹配和视觉跟踪技术上的发文量均居全球首位,在图像处理和视频处理技术上也位居全球前列,此外,浙江大学、大连理工大学和清华大学也表现不俗。 机器人子领域的热点技术主要包括机械手、抓握、行走、感知和驱动等智能控制技术研究,同时还包括外骨骼机器人、服务机器人和机器人传感器等硬件基础和软件优化研究。此外,人工智能领域的热点技术还包括智能多代理系统,以及众包、拍卖、市场定价、能源管理和隐私保护等相关问题的研究。在上述技术大类中,美国发文量均居全球首位,中国在机器人和智能多代理系统研究方面发文量居全球第7位,相对靠后。同时,国内机构在上述技术大类下的发文量均未能进入全球Top5。 2.2 人工智能共性技术 人工智能领域的共性技术可对其他研究方向和技术主题产生广泛影响,反映出人工智能领域的重要研发基础和技术前沿。以人工智能领域热点技术分布网络(图3)为对象,计算网络中各节点的限制度指标并升序排列,取Top20的热点技术作为人工智能领域的共性技术(表4)。 机器学习子领域占据15项共性技术,包括推理、特征选择与特征学习、图论、分类、搜索、回归等基础算法研究,以及约束优化、网络优化、最优化理论、损失函数及优化等机器学习算法优化方法探索,还包括序列学习、树学习、长短期记忆模型、多示例学习等新型学习方法实践,此外,也涉及到机器学习算法在生存预测、人机关系推断、药物不良反应预测方面的应用研究。由此可见,机器学习方法强大的赋能性推动了人工智能技术和应用的发展升级,各类机器学习共性技术为其他子领域研究实践奠定了坚实的方法和算法基础。 计算机视觉子领域占据3项共性技术,包括位置识别和图像对齐所涉及的核心技术研究,此外,还包括多标签对象识别、人脸识别、纹理识别、零次动作识别等机器视觉识别技术的研究和应用实践。机器人子领域中,传感器技术及应用作为一种共性技术,对于机器人的智能控制起到非常重要的作用,使其拥有类人的感知功能和反应能力,其中,分布式传感器网络、多传感器融合以及嵌入式微流体应变传感器等新型传感器是当下的技术研发前沿。 2.3 人工智能新兴技术 人工智能领域的新兴技术代表最新出现且短时间内受到广泛关注的研究方向和技术主题,反映出人工智能领域内具有重要潜在影响的新近研究热点。以会议论文关键词为分析数据,采用Sci2 tool工具的Burst Detection算法计算各个关键词的突发指标,根据突发权重和突发等级降序排列,选取最高突发等级且尚未进入突发稳定状态的Top15关键词作为人工智能领域的新兴技术。 在人工智能领域的新兴技术中,深度学习技术出现频率最高,包括深度神经网络、对抗网络、对抗学习、注意力机制、深度卷积神经网络、长短期记忆网络等。其中,生成对抗网络和注意力机制近年来的研究热度快速上升,已成为深度学习非常重要的模型和工具,前者可用于真实数据的建模与生成,如图像、视频、自然语言和音乐等,后者则在图像处理、语音识别和自然语言处理方面有广泛应用。此外,强化学习、案例推理和演化算法等机器学习方法,图像增强、信号编码等计算机视觉技术,以及自主代理和多代理系统等均为人工智能领域的新兴技术。 **3 结论** 基于人工智能高水平会议论文数据,利用无监督聚类、复杂网络结构洞理论和突发检测算法,从热点技术、共性技术和新兴技术三个方面挖掘分析人工智能领域的关键技术。根据上述分析结果可知: 人工智能领域共包含14个大类、132项热点技术,其中,机器学习子领域的热点技术主要包括基础算法的优化改进和实践应用,以及迁移学习、强化学习、多核学习和多视图学习等新型学习方法的研究探索等;自然语言处理子领域的热点技术主要包括特征提取、语义分类、词嵌入等基础技术和模型研究,以及智能自动问答、机器翻译等应用研究;计算机视觉子领域的热点技术主要包括视频图像分割、对齐、检测等所涉及的核心技术研究,以及三维重建、光度立体视觉、行人再识别等应用研究;机器人子领域的热点技术主要包括机械手、抓握、行走、感知和驱动等智能控制技术研究,以及外骨骼机器人和机器人传感器等硬件基础和软件优化研究。 人工智能领域的共性技术主要分布在机器学习、计算机视觉和机器人子领域,其中,机器学习方法强大的赋能性推动了人工智能技术和应用的发展升级,各类机器学习共性技术为其他领域研究实践奠定了坚实的方法和算法基础。 人工智能领域的新兴技术主要集中在深度学习方面,生成对抗网络和注意力机制是其中的典型代表,此外,新兴技术还包括强化学习、自主代理和多代理系统等。 人工智能作为一门基础研发和实践应用并重的技术科学,其热点技术既包含机器学习基础算法的改进优化,也涵盖自然语言处理、计算机视觉和机器人等通讯、感知和行动层面的应用研究。而通过热点技术遴选得到的共性技术则赋能了人工智能基础研发和实践应用进步,机器学习基础算法在不断进化的同时,也为相关研究方向提供了新思路、新方法和新手段,同样,机器视觉核心技术和传感器技术在也分别在计算机视觉和机器人领域起到至关重要的作用。热点技术和共性技术旨在揭示人工智能领域的技术全貌及核心技术方向,而新兴技术则从关键词层面细粒度揭示突发的技术研究内容,深度学习中的生成对抗网络和注意力机制作为人工智能新兴技术的典型代表,具有广泛的实践应用场景,对人工智能发展具有重要的潜在影响。 人工智能已成为全球重点关注的研究和发展领域,国际竞争日益激烈。美国在人工智能领域各热点技术大类下的发文量均位居全球首位,且遥遥领先于其他国家。中国在机器学习、自然语言处理、计算机视觉等多个技术大类下的发文量仅次于美国,但在强化学习、机器人、智能多代理系统研究方面发文量排名相对靠后,与美国、德国、法国、日本和英国等国家存在一定差距。此外,中国科学院在多个技术大类下的发文量均位居全球前列,清华大学、北京大学、浙江大学和大连理工大学也表现不俗,但与卡内基梅隆大学、微软研究院、麻省理工学院等美国著名高校和企业存在不小差距。
-
【活动背景】本次活动立足华为AI+技术与应用,面向广大高校师生提供全栈全场景 AI 技术技能在线培训,围绕技术创新和产业发展,助力高校多层次培养应用型人才,为产业发展输入新鲜动力。【活动时间】2021年12月7日-12月16日【参与方式】完成直播学习或实验后在本活动帖下方留言,上传学习笔记或实验成果截图,完成课后作业打卡也可以在此帖下与同学们进行问题讨论哦(〃'▽'〃)~
爱学习爱生活999
发表于2021-11-27 16:36:45
2021-11-27 16:36:45
最后回复
GoodStudy111111
2021-12-19 22:16:14
9780 217
-
>【摘要】 本文的主要目的是带想用ModelArts的同学过遍ModelArts的基础功能并部署属于你自己的模型在云上,并且能够本地通过python代码调API的方式在线推理【本文以tensorflow 1.13为例】。本文分享自华为云社区《[手把手教你用ModelArts模型部署上线&在线推理](https://bbs.huaweicloud.com/blogs/313145)》, 作者:苏道。 ## 前言 ModelArts是面向开发者的一站式AI开发平台,为机器学习与深度学习提供海量数据预处理及半自动化标注、大规模分布式Training、自动化模型生成,及端-边-云模型按需部署能力,帮助用户快速创建和部署模型,管理全周期AI工作流。 **本文的主要目的是带想用ModelArts的同学过遍ModelArts的基础功能并部署属于你自己的模型在云上,并且能够本地通过python代码调API的方式在线推理【本文以tensorflow 1.13为例】。** ## 模型部署阶段 ### 1、模型格式要求 因为模型部署在云上需要在AI框架[tf/pytorch/mxnet]上再套一个serving框架,本文主要利用tensorflow框架,上层的serving框架会对tensorflow的saved model形式比较亲和[推理比较快],所以需要把模型先转成saved model格式的模型,可能的路线是**pb--->saved model / ckpt --->saved model /h5--->saved model**,具体转法同学们可以参考网上的教程~ 最终生成的saved model文件树如下:  variables目录里如下:  值得注意的是,saved model.pb文件只包含了图,不包含权重,权重全部存在了variables目录下,如果同学们转换出来variables里面是空的,pb文件很大,是有问题的,应该是转换代码的问题。 ### 2、配置文件编写 **config.json:** 如下是一个简单的config.json文件的内容,runtime 参数定义运行的ai引擎、和推理的环境,reques参数定义当通过request调用这个api时的格式,需要是form-data还是其他,传的是图片file还是string,response定义了推理完模型后返回给请求的格式,dependency是额外需要的一些依赖环境的配置。 具体的其他场景怎么编写可以参考官网文档:[模型配置文件编写说明_AI开发平台ModelArts_推理部署_推理规范说明_模型包规范_华为云 (huaweicloud.com)](https://support.huaweicloud.com/inference-modelarts/inference-modelarts-0056.html) ``` { "model_type": "TensorFlow", "model_algorithm": "test-resnet", "runtime":"tf1.13-python3.6-cpu", "apis": [{ "protocol": "http", "url": "/", "method": "post", "request": { "Content-type": "multipart/form-data", "data": { "type": "object", "properties": { "sentence": { "type": "string" } } } }, "response": { "Content-type": "applicaton/json", "data": { "type": "object", "properties": { } } } }] "dependencies": [{ "installer": "pip", "packages": [{ "restraint": "EXACT", "package_version": "1.1.5", "package_name": "pandas" }, ``` ### 2、customize_service.py编写 这部分主要是定义模型的数据前处理、后处理和推理的接口,以及返回什么内容应该怎么写,下模板是一个无需前后处理,返回QPS和推理结果、时间的例子,更详细的说明可以参考官方文档:[模型推理代码编写说明_AI开发平台ModelArts_推理部署_推理规范说明_模型包规范_华为云 (huaweicloud.com)](https://support.huaweicloud.com/inference-modelarts/inference-modelarts-0057.html) ```py import logging import threading import numpy as np import os import pandas as pd import tensorflow as tf # 导入tensorflow from PIL import Image from model_service.tfserving_model_service import TfServingBaseService from config import * import time logger = logging.getLogger() logger.setLevel(logging.INFO) class mnist_service(TfServingBaseService): def __init__(self, model_name, model_path): self.ctx = None self.use_time = 0 def _preprocess(self, data): return data def _inference(self, data): print('ready to infer') time_list = [] start_time = time.time() predict_result = self.sess.run(self.model_outputs, feed_dict=self.model_inputs) time_list.append(time.time() - start_time) use_time = np.mean(time_list) result = {} result['output'] = predict_result.tolist() result['aver_use_time'] = use_time result['QPS'] = 1 / use_time return result def _postprocess(self, data): return data ``` ### 3、打包上传OBS 将上述文件按如下图打包到一个文件夹里:  上传OBS:  ### 4、模型部署 选择ModelArts里的模型管理---模型  然后在‘’我的模型‘’里选择‘’导入‘’,然后再模型创建界面中的‘**元模型来源**’选择从**OBS**导入,如下图,除了红框需要选择外,其他配置是读取config.json文件自动配置的,然后点击创建即可完成模型部署:  然后等到模型创建成功: ## 模型上线阶段 选择部署上线---在线服务---部署  选择把模型在什么样的资源下上线[gpu/cpu],选择刚才部署上去的模型,和版本号(如果多次部署的话),即可创建成功  等待在线服务部署完成会出现,**‘运行中’,便是成功上线了**: ## 本地调用在线服务 这一节来演示如何用本地调用在线服务。 ### 1、获取token 想要在本地远程推理,首先需要获取token,因为请求的时候会验证token,因为不能谁都乱用你的在线服务对吧。获取token的在线方法: https://apiexplorer.developer.huaweicloud.com/apiexplorer/debug?product=IAM&api=KeystoneCreateUserTokenByPassword 具体填写方法: 1、region 选择在线服务上线的区域 2、methods选择password 3、domain name、name、password从右上角个人信息那里的“我的凭证”里,domain name就是账户名, name就是IAM用户名,密码就是账号密码 4、scope 里只需要填写project name即可,如果是在北京4就填写"cn-north-4",其他就填写其他 具体的官网教程:https://support.huaweicloud.com/api-modelarts/modelarts_03_0004.html   获取的token结果是下图箭头的部分,很长,我们把这个token值存为本地txt文件里【token有效期只有24h】: ### 2、本地代码编写 先在下一个官网代码demo包:https://obs.cn-north-1.myhuaweicloud.com/apig-sdk/ApiGateway-python-sdk.zip 来源于官方:https://support.huaweicloud.com/inference-modelarts/inference-modelarts-0024.html#inference-modelarts-0024__zh-cn_topic_0283244602_section8151659179 打开demo包,文件结构如下图,主要修改main.py文件:  将main.py修改成如下,其中,token.txt是刚才获取token后写在txt文件的那个文件,url地址从在线服务中的API接口地址来,一般是长这个样子:https://xxxxxxxxxxxxx.apig.cn-north-4.huaweicloudapis.com/v1/infers/aaaa-fccc7-dddd-eeee-xxxxx的形式,如下图,请求采用post方法: ```python # coding=utf-8 import requests from apig_sdk import signer if __name__ == '__main__': with open('token.txt', 'r') as token_file: token = token_file.readline() X_Auth_Token = token[:-1] headers = {"content-type": "application/json", 'X-Auth-Token': X_Auth_Token} url = "https://xxxxxxxxxxxxx.apig.cn-north-4.huaweicloudapis.com/v1/infers/aaaa-fccc7-dddd-eeee-xxxxx" r = requests.request("POST", url, data=json_data_dumps, headers=headers, verify=False) resp = requests.request(r.method, r.scheme + "://" + r.host + r.uri, headers=r.headers, data=r.body) print(resp.status_code, resp.reason) print(resp.content) ```  接着运行代码即可~。如果打印的status code =200那么说明请求没问题,值得注意的是,请求的数据需要是json的格式。
-
1、 智能缺陷检测由于人眼无法看清快速移动的目标,对微小目标分辨能力弱,而且人眼疲劳后漏检率会提高,这些都使得人工检测费时费力。而智能缺陷检测机器人则克服了这些困难,高速工业相机能够在动态检测的情况下极大降低误报率,还可根据产品检测需求调整检测精度,提高检测效率。同时可配合自动化生产线,实现自动检测、自动处理,降低次品率,减少人工成本,使得生产效率显著提升。2、 智能识别分拣对于工厂来说,分拣速度慢意味着生产出的产品会在产线上积压,造成生产线流转不顺畅,拉低生产效率。目前人工分拣速度慢,尤其是体积小、颜色形状多的产品更是分拣难度大,很容易造成分拣失误,但如果使用智能分拣机器人则可以大大提高分拣速度。智能分拣机器人可以通过摄像头对分拣物品进行识别,再通过分析得出该物品应放置的区域,最后通过机械臂或产线配合将产品送至相应的位置。该机器人的在线识别速度一般都高于生产速度,分拣失误率低,不易造成产品在产线上积压。3 、智能尺寸检测传统的产品尺寸检测由于人员使用量具熟练程度的不同,量具使用不熟练或是人员疲劳会造成检测速度变慢,延缓生产进度,而且人工测量误差较大。但智能尺寸检测机器人可以24小时持续检测,检测速度快,测量误差小。4 、智能视觉引导视觉机器人想要成功接收各项指令并完成相应的动作,也像人一样需要大脑的调配。智能装备研发的视觉引导系统就是这样一个“大脑”,它通过自主软件控制系统来下达指令,工业相机进行目标产品信息捕捉,再通过多轴机械臂进行操作,整个过程流畅自然。4.1 管桩自动领域:管桩自动装配机器人 该设备用于水泥管桩行业的头尾板自动装配采用视觉获取笼筋墩头的空间角度位置,配合四轴矫正专机完成墩头的自动撑开,最后通过机械臂实现头尾板的装配4.2 检测领域:检测中心检测机器人 检测系统由六轴机器人、自动上料装置、自动扫码装置、测径仪、测宽仪、三点测弯机构、拉力机、安全防护系统等组成。机器人系统实现样品检测自动化、无人化、数据自动上传与处理功能,提了检测准确性、真实性,降低人工成本、提高检测效率。
-
这个库我在PC机交叉编译环境和Ascend安装路径下找到了,请问直接拷贝进去就可以了吗,是否可以整体拷贝,如何操作
-
据俄罗斯卫星通讯社sputniknews报道, 电气电子工程师学会(IEEE)进行的一项《技术对2022年及以后的影响》专家调查的数据显示,云计算将成为2022年最重要的技术。60%的受访者将云计算称为2022年最重要的技术。同时,专家们在最重要的技术中还指出有人工智能和机器学习(51%)、5G(46%)、增强现实(31%)、区块链(28%)、远程会议(25%)、物联网(25%)、机器人技术(23%)、预测性人工智能、边缘计算(15%)、生物识别(15%)、量子计算(15%)、3D打印(12%)。 66%的专家认为,近1-5年人工智能将是所有工业领域进步的主要推动力。根据该调查结果显示,很多公司现已使用增强现实技术以实现数据可视化(63%)、举行3D虚拟会议(51%)、员工培训(49%)、在销售中引入游戏元素(游戏化)(35%)。很多受访者认为,2022年引入5G通讯将有重要意义,5G通讯将广泛应用于包括远程手术(24%)在内的远程医疗、远程教育(14%)、日常通讯(15%)、工业制造/装配(13%)、交通(7%)。调查期间,对来自美国、中国、英国、印度和巴西大型公司担任领导职位的350名专家进行了调查。
-
 01 ▎华为RPA白皮书正式发布Forrester正式发布《华为RPA白皮书》,为处在数字化转型中的企业提供有效的RPA总体经济的价值分析。通过访谈4家华为WeAutomate的客户,整合分析得出,企业引入WeAutomate后的投资回报率可达116%,净现值达1018万元。 02 ▎WeAutomate RPA 3.0正式发布华为RPA首席架构师吕茂林对华为RPA WeAutomate 3.0版本进行深度解读。新增CV自动化、GDE Link移动端小程序、资产可信与交易、CSM运营、人机协作、Chatbot、机器人健康体检等特性。同时发布“政小助”解决方案。 03 ▎“政小助”产品设计方法论及效果分享立足于政务场景而生成的政务智能报告助手可一键生成图文并茂的政务报告,具有千人千面的特点。通过内置报告资产模板,快速配置各类政府报告,提供极简工作体验。 04 ▎客户发言:鞍钢财务“数字员工”案例分享通过引入华为RPA和AI技术,鞍钢集团快速构建电子会计档案归档标准流程体系,优化重构通用费用报支业务流程,实现集团账表归档、智能报销自动化。 05 ▎客户发言:瑞金医院财务自动化案例分享医院的院区多、发票量巨大,导致发票验真、入库流程操作耗时长且费时。应用华为RPA+AI开发的“瑞财小智”机器人可实现发票验真、入库自动化,优化发票入库流程,进而推动智慧医疗建设。 06 ▎客户发言:上飞院飞机结构设计自动化实践分享引入华为RPA+AI这位“英雄数字员工9527”,可操作结构数模对比、关键数据自动化分析等工作,促进简化协调环节,提高处理效率,解放人力资源。 07 ▎伙伴发言:普华永道基于RPA深化应用可能面临的挑战,分析了支持RPA应用的基础要素,为企业发展数字化员工提供而有效的支撑。 08 ▎伙伴发言:富璟科技立足于企业财务场景,指出引入华为RPA+AI可促进企业交易模式、运作模式、组织模式、治理模式等方面的业务创新,进而成为财务智能自动化转型的利器。 09 ▎伙伴发言:上海德成通过展开论述“财务数据中台案例”及“苏小助”数字助手案例,深入解读华为RPA在财务、政务领域带来的数字化转型效益。
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签