-
 1. 根据产品文档安装Flink客户端; 2. 将sql-client-defaults.yaml(见附件)放入/opt/client/Flink/flink/conf中 3. 将jaas.conf 放入/opt/client/Flink/flink/conf中 ``` Client { com.sun.security.auth.module.Krb5LoginModule required useKeyTab=false useTicketCache=true debug=false; }; ``` 4. 添加sql-client.sh中添加在JVM_ARGS参数: JVM_ARGS="-Djava.security.auth.login.config=/opt/client/Flink/flink/conf/jaas.conf $JVM_ARGS" 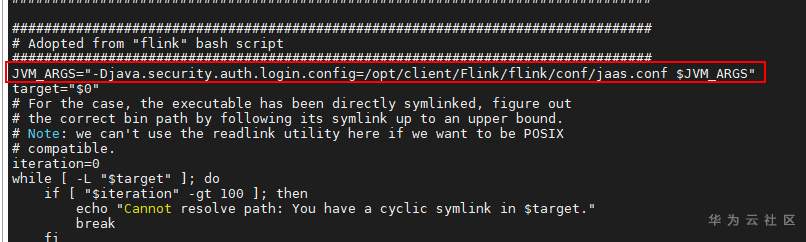
-
 连接器负责与客户端的建立连接、获取权限、维持和管理连接。用户建立连接之后,即使被管理员更改了权限,也不会影响已经存在连接的权限。必须使用新的连接才会生效。客户端如果太长时间没动静,连接器就会自动将它断开。这个时间是由参数 wait_timeout控制的,默认值是8小时。长连接与短连接长连接: 连接成功后,如果客户端有持续的请求则一直使用同一个连接。短连接:执行完几次数据库操作就断开连接,下次执行操作重新建立连接。长连接的问题使用长连接可能会导致内存占用过多,会被内存强行杀掉,从现象看就是MySQL异常重启了解决方案定期断开连接。执行mysql_reset_connection重新初始化连接资源。(这个过程不需要重新做权限验证,但是连接会恢复到刚刚创建完的状态)查询缓存MySQL拿到查询请求之后,会先去查询缓存中查看。查询缓存以key-value的形式存储,key是查询的语句,value是查询的结果。如果查询命中缓存,就可以直接返回结果,这个效率很高。没有命中缓存,就会往后执行。大多数情况下,不建议使用查询缓存,因为缓存的命中率很低,因为只要有对一个表进行更新,那么这个表上的所有查询缓存都会被清空。除非你的业务是一张静态表,只做查询不做更改,或者很长时间才更改一次,这样就比较适合。设置不使用查询缓存:将query_cache_type设置成DEMAND。显示指定使用查询缓存 select SQL_CACHE * from T where ID=101分析器对SQL语句进行词法、语法分析。优化器优化器是在表里面有多个索引的时候,决定使用哪个索引。或者在一个语句有多表关联(join)的时候,决定各个表的连接顺序。执行器开始执行的时候,要先判断一下你对这个表有没有执行查询的权限,如果没有,就会返回没有权限的错误。(在工程实现上,如果命中查询缓存,会在查询缓存返回结果的时候,做权限验证。查询也会在优化器之前调用precheck 验证权限)。如果有权限,就打开表继续执行。打开表的时候,执行器就会根据表的引擎定义,去使用这个引擎提供的接口。
-
 【功能模块】SQL,建表【操作步骤&问题现象】1、使用gsql显示正常edw_prd=> insert into test values(1,'2021-10-11 00:00:01.22222');INSERT 0 1edw_prd=> select * from test; a | b---+--------------------------- 1 | 2021-10-11 00:00:01.22222(1 row)edw_prd=> insert into test values(1,'2021-10-11 00:00:01.222228888');INSERT 0 1edw_prd=> select * from test; a | b---+---------------------------- 1 | 2021-10-11 00:00:01.22222 1 | 2021-10-11 00:00:01.222229(2 rows)2、版本 8.1.1【截图信息】【日志信息】(可选,上传日志内容或者附件)
-
 【摘要】 华为云沃土认证,方案分享,人大金仓-KingbaseES金仓数据库管理系统本文分享自华为云社区《【沃土认证--方案分享】人大金仓-KingbaseES金仓数据库管理系统 》,作者DTSEDeveloper公司简介: 北京人大金仓信息技术股份有限公司(以下简称“人大金仓”)是具有自主知识产权的国产数据管理软件与服务提供商。人大金仓由中国人民大学一批最早在国内开展数据库教学、科研、开发的专家于1999年发起创立,先后承担了国家“863”、“核高基”等重大专项,研发出了具有国际先进水平的大型通用数据库产品。数字化时代,人大金仓将继续立足自主研发创新,以人工智能、云计算、大数据、物联网等新兴技术需求为牵引,面向党政军及各级企业级市场,坚持“以客户为中心”企业宗旨,不断打造满足客户需求的新型数据管理和分析平台及行业解决方案,让数据创造价值,用技术驱动未来,助力我国信息化建设更好更快发展。方案概述:1)方案概述及价值KingbaseES金仓数据库管理系统(下文简称:KingbaseES)是北京人大金仓信息技术股份有限公司研发的,具有自主知识产权的通用数据库产品。KingbaseES汇集了人大金仓在数据库领域近二十年的技术积累,包括公司在国家“核高基”重大专项数据库课题的研究成果,是唯一入选国家自主创新产品目录的数据库产品,已广泛适用于电子政务、军工、电力、金融、电信、教育及交通等行业,是国家级、省部级项目中应用最广泛的国产数据库产品。2)解决方案架构图近日,人大金仓联合中原鲲鹏生态创新中心获得鲲鹏Validated认证。在中原鲲鹏生态创新中心技术研发部门的帮助下,人大金仓投入最少人力实现了基于openEuler 20.03LTS操作系统、鲲鹏基础技术架构的全栈移植、调优,并实现性能显著提升,在1000仓TPCC测试中,KingbaseES性能最高提升32.86%。通过鲲鹏BoostKit优化后,KingbaseES更加贴合企业级应用的业务和技术需求,为电子政务、军工、电力、金融、电信、教育及交通等各领域提供可靠稳定的数据库支撑。应用案例1)背景与挑战随着万物互联的时代到来,数据总量也将呈现爆发式增长。如何存储和处理海量数据也将成为一个亟需解决的问题,这必将带来新一轮的数据库系统底层技术的变革。提到商业化数据库就不得提传统四大厂商Oracle、IBM、Microsoft、SAP,他们的关系型数据库曾经一度占据了商业数据库市场超90%的市场规模。但近年来数据类型的多样性发展,也催生了一系列其他类型的数据库,对传统商业数据进行替代或者部分替代,比如在银行领域开始尝试对一些非核心业务使用开源或者国产解决方案。国产化数据库面临着复杂应用如何移植、性能如何保障、高可用如何保证、领导如何抉择等一系列严峻的挑战。2)客户痛点适配调试复杂: 用户在国产平台服务器、操作系统、数据库软件多版本适配复杂,适配问题多的情景。稳定性、用户体验: 高并发、大数据量场景下系统运行不稳定的问题,平台组合性能不足,造成的用户业务响应慢,高并发支撑不足的情景。集成交付: 项目中标后,用户迁移适配问题多,难交付、周期长、验收难的问题。数据库替换成本高: 虽然有基础软件“国产自主可控”的政策推动,但国内大型银行、运营商等核心交易、计费系统长期依赖于Oracle、IBM等数据库系统。对于大型企业而言,核心系统是其业务的命脉,而数据库又是其中的基石,数据库本身的稳定性和安全性优先于一切,因此对他们而言,核心系统的完全替代并非易事。3)解决方案优势与价值1 性能升级 全面提速: 多CPU环境并行处理数据,读写分离集群,只读性能线性增长,数据加载优化技术,基于代价模型的查询优化,用户并发数达到“万”级。2 应用迁移、简单高效: 使用向导式数据迁移工具、实现无损、快速数据迁移,提供兼容Oracle 97%的语法,数据迁移平滑、成本更低,支持DB2、SQL Server、Sybase、MySQL、文本文件、Excel文件等数据源中的数据。3 系统扩展 能力超强: 提供数据类型、函数的自定义机制,方便用户进一步实现功能上的扩展,支持访问多种外部数据类型、异构数据库,整合多种数据资源进行计算。4 关注用户 体验更佳: UI界面全新设计,QL编程智能交互:语法高亮、自动联想补全,智能格式化,图形向导式集群部署,部署在鼠标点击间即可完成了解更多:伙伴官网https://kes.kingbase.com.cn伙伴联系方式sales@kingbase.com.cn友情链接:开发者技术支持社区:https://bbs.huaweicloud.com/forum/forumdisplay-fid-1175-orderby-lastpost.html博客主页专区:https://bbs.huaweicloud.com/community/usersnew/id_1612437390514409技术支持提单平台:https://support.developer.huaweicloud.com/feedback/#/
-
 用户相关1.新建用户创建普通用户,并制定密码CREATE USER ke WITH admin identified by 'ke@123';赋予所有表的操作权限grant SELECT,INSERT,UPDATE,DELETE on all tables in schema public to ke;赋予所有序列的操作权限GRANT USAGE, SELECT ON ALL SEQUENCES IN SCHEMA public TO ke;2.查看用户表select * from pg_user;3.切换用户\c - username 数据库相关1.创建数据库CREATE DATABASE dbname;2.查看已有数据库\l3.切换数据库\c database_name 表相关1.创建表2.查看所有表\d3.查看表结构\d table_name
-
 1.1 openGauss执行算子汇总openGauss的算子按类型可分为四类:控制算子、连接算子、扫描算子和物化算子。下面汇总了当前(openGauss2.0.0)已有的算子。算子文件类型AggnodeAgg.cpp物化算子AppendnodeAppend.cpp控制算子BitmapAndnodeBitmapAnd.cpp控制算子BitmapHeapscannodeBitmapHeapscan.cpp扫描算子BitmapIndexscannodeBitmapIndexscan.cpp扫描算子BitmapOrnodeBitmapOr.cpp控制算子CtescannodeCtescan.cpp扫描算子ForeignscannodeForeignscan.cpp扫描算子FunctionscannodeFunctionscan.cpp扫描算子GroupnodeGroup.cpp物化算子HashnodeHash.cpp物化算子HashjoinnodeHashjoin.cpp连接算子IndexonlyscannodeIndexonlyscan.cpp扫描算子IndexscannodeIndexscan.cpp扫描算子LimitnodeLimit.cpp物化算子LockRowsnodeLockRows.cpp控制算子MaterialnodeMaterial.cpp物化算子MergeAppendnodeMergeAppend.cpp控制算子MergejoinnodeMergejoin.cpp连接算子ModifyTablenodeModifyTable.cpp控制算子NestloopnodeNestloop.cpp连接算子PartIteratornodePartIterator.cpp连接算子RecursiveunionnodeRecursiveunion.cpp控制算子ResultnodeResult.cpp控制算子SamplescannodeSamplescan.cpp扫描算子SeqscannodeSeqscan.cpp扫描算子SetOpnodeSetOp.cpp物化算子SortnodeSort.cpp物化算子StubnodeStub.cpp控制算子SubplannodeSubplan.cpp控制算子SubqueryscannodeSubqueryscan.cpp扫描算子TidscannodeTidscan.cpp扫描算子UniquenodeUnique.cpp物化算子ValuesscannodeValuesscan.cpp扫描算子WindowAggnodeWindowAgg.cpp物化算子WorktablescannodeWorktablescan.cpp扫描算子ExtensiblenodeExtensible.cpp用于扩展算子1.2 PG新增算子汇总下面列出PG(14devel)相比于openGauss多了哪些算子。算子文件类型CustomnodeCustom.cGathernodeGather.cGatherMergenodeGatherMerge.cIncrementalSortnodeIncrementalSort.cNamedtuplestorescannodeNamedtuplestorescan.cProjectSetnodeProjectSet.cTableFuncscannodeTableFuncscan.cTidrangescannodeTidrangescan.c1.1表格中的算子Extensible类似于PG的算子Custom,其作用是允许插件向数据库增加新的扫描类型。主要分为三步:首先,在路径规划期间生成插件增加的扫描路径(ExtensiblePath);然后,如果优化器选择该路径作为最优路径,那么需要生成对应的计划(ExtensiblePlan);最后,必须提供执行该计划的能力(ExtensiblePlanState)。下面以TidRangeScan为示例,演示如何使用Extensible通过插件化的方式为openGauss新增一个执行算子。2.1 功能介绍openGauss中堆表由一个个page组成,每个page包含若干个tuple。tid是tuple的寻址地址,由两个字段组成:(pageid,itemid),pageid代表第几个数据块,itemid代表这个page内的第几条记录。例如tid=(10,1)表示第11个数据块中的第一条记录(pageid从0开始,itemid从1开始)。PostgreSQL 14 devel新增了算子TidRangeScan,可以直接通过tid来范围访问某个page的全部数据。(带来的好处:如果需要更新一张表所有数据时,可以开启多个会话并行去更新不同的page,提高效率。)本次展示将该特性通过插件的方式移植到openGauss,插件化的增加一个执行算子。2.2 使用说明tidrangescan插件定义了一个bool类型的guc参数:enable_tidrangescan,控制优化器对tidrangescan扫描算子的使用,on表示使用,off表示不使用。2.3 插件边界本小节主要列举调用了哪些内核接口,当内核演进过程中修改了这些接口,有可能会影响插件的使用。接口名文件模块ExecInitExprexecQual.cpp优化层clauselist_selectivityclausesel.cpp优化层cost_qual_evalcostsize.cpp优化层get_tablespace_page_costsspccache.cpp优化层get_baserel_parampathinforelnode.cpp优化层add_pathpathnode.cpp优化层extract_actual_clausesrestrictinfo.cpp优化层heap_getnextheapam.cpp执行层ExecClearTupleexecTuples.cpp执行层ExecStoreTupleexecTuples.cpp执行层ExecScanReScanexecScan.cpp执行层heap_beginscanheapam.cpp执行层heap_rescanheapam.cpp执行层ExecScanexecScan.cpp执行层heap_endscanheapam.cpp执行层make_ands_explicitclauses.cpp执行层deparse_context_for_planstateruleutils.cpp执行层deparse_expressionruleutils.cpp执行层ExplainPropertyTextexplain.cpp执行层2.4 设计实现本节提到的hook在第3章《hook点总述》会做详细说明。附社区PR:https://gitee.com/opengauss/Plugin/pulls/12.4.1 插件开发通用流程2.4.1.1 Makefile在openGauss源码的contrib目录下新建开发插件的目录,这里为tidrangescan。在该目录下新建Makefile文件。# contrib/tidrangescan/Makefile MODULES = tidrangescan # 模块名 EXTENSION = tidrangescan # 扩展的名称 REGRESS = tidrangescan # 回归测试 REGRESS_OPTS = --dlpath=$(top_builddir)/src/test/regress -c 0 -d 1 --single_node # 回归测试相关的选项 DATA = tidrangescan--1.0.sql # 插件安装的SQL文件 override CPPFLAGS :=$(filter-out -fPIE, $(CPPFLAGS)) –fPIC # fPIC选项 # 以下是openGauss构建插件相关的命令,保留即可 ifdef USE_PGXS PG_CONFIG = pg_config PGXS := $(shell $(PG_CONFIG) --pgxs) include $(PGXS) else subdir = contrib/tidrangescan top_builddir = ../.. include $(top_builddir)/src/Makefile.global include $(top_srcdir)/contrib/contrib-global.mk endif2.4.1.2 control文件新建控制文件,这里为tidrangescan.control。内容如下:# tidrangescan extension comment = 'example implementation for custom-scan-provider interface' default_version = '1.0' # 与Makefile里DATA属性的sql文件名的版本保持一致 module_pathname = '$libdir/tidrangescan' relocatable = true 2.4.1.3 sql文件sql文件命名格式为extensionName–version.sql,*version*即为上述版本号,这里为tidrangescan--1.0.sql。在这里编写所需的函数。-- complain if script is sourced in psql, rather than via CREATE EXTENSION \echo Use "CREATE EXTENSION tidrangescan" to load this file. \quit CREATE FUNCTION pg_catalog.tidrangescan_invoke() RETURNS VOID AS '$libdir/tidrangescan','tidrangescan_invoke' LANGUAGE C STRICT;2.4.1.4 回归测试用例创建sql和expected目录,分别存放测试用例的sql脚本和预期输出,例如这里为tidrangescan.sql和tidrangescan.out。2.4.1.5 源文件及插件目录总览创建插件的头文件和cpp文件,这是实现插件的核心,下文主要介绍该插件代码层的设计与实现。至此插件总体目录概览如下。2.4.2 优化器2.4.2.1 添加路径将set_rel_pathlist_hook赋值为SetTidRangeScanPath,该函数解析扫描表的查询条件,当存在tid范围查询时调用add_path添加ExtensiblePath,计算代价,并将创建计划的接口tidrangescan_path_methods存入path中。static void SetTidRangeScanPath(PlannerInfo *root, RelOptInfo *baserel, Index rtindex, RangeTblEntry *rte) { ... tidrangequals = TidRangeQualFromRestrictInfoList(baserel->baserestrictinfo, baserel); ... if (tidrangequals != NIL) { cpath = (ExtensiblePath*)palloc0(sizeof(ExtensiblePath)); cpath->path.type = T_ExtensiblePath; cpath->path.pathtype = T_ExtensiblePlan; cpath->path.parent = baserel; cpath->extensible_private = tidrangequals; cpath->methods = &tidrangescan_path_methods; cost_tidrangescan(&cpath->path, root, baserel, tidrangequals, cpath->path.param_info); add_path(root, baserel, &cpath->path); } } static ExtensiblePathMethods tidrangescan_path_methods = { "tidrangescan", /* ExtensibleName */ PlanTidRangeScanPath, /* PlanExtensiblePath */ };2.4.2.2 创建计划上述的tidrangescan_path_methods定义了创建计划函数PlanTidRangeScanPath,根据最优路径生成计划ExtensiblePlan,同时将创建计划状态节点接口tidrangescan_scan_methods存入plan。static Plan *PlanTidRangeScanPath(PlannerInfo *root, RelOptInfo *rel, ExtensiblePath *best_path, List *tlist, List *clauses, List *custom_plans) { ExtensiblePlan *node = makeNode(ExtensiblePlan); Plan *plan = &node->scan.plan; List *tidrangequals = best_path->extensible_private; ... node->extensible_exprs = tidrangequals; node->scan.plan.startup_cost = best_path->path.startup_cost; node->scan.plan.total_cost = best_path->path.total_cost; node->scan.plan.plan_rows = best_path->path.rows; node->scan.plan.plan_width = rel->width; node->methods = &tidrangescan_scan_methods; return plan; } static ExtensiblePlanMethods tidrangescan_scan_methods = { "tidrangescan", /* ExtensibleName */ CreateTidRangeScanState, /* CreateExtensiblePlanState */ };2.4.3 执行器2.4.3.1 创建计划状态节点上述的tidrangescan_scan_methods定义了创建PlanState函数CreateTidRangeScanState,根据传入的plan返回PlanState,同样将后续执行器执行的若干方法结构体tidrangescan_exec_methods存入PlanState。Node *CreateTidRangeScanState(ExtensiblePlan *custom_plan) { TidRangeScanState *tidrangestate; /* * create state structure */ tidrangestate = (TidRangeScanState*)palloc0(sizeof(TidRangeScanState)); NodeSetTag(tidrangestate, T_ExtensiblePlanState); tidrangestate->css.methods = &tidrangescan_exec_methods; /* * mark scan as not in progress, and TID range as not computed yet */ tidrangestate->trss_inScan = false; return (Node*)&tidrangestate->css; } static ExtensibleExecMethods tidrangescan_exec_methods = { "tidrangescan", /* ExtensibleName */ BeginTidRangeScan, /* BeginExtensiblePlan */ ExecTidRangeScan, /* ExecExtensiblePlan */ EndTidRangeScan, /* EndExtensiblePlan */ ExecReScanTidRangeScan, /* ReScanExtensiblePlan */ ExplainTidRangeScan /* ExplainExtensiblePlan */ };2.4.3.2 执行层hooktidrangescan_exec_methods定义了五个接口,分别是执行层各个阶段的主函数:BeginTidRangeScan、ExecTidRangeScan、EndTidRangeScan、ExecReScanTidRangeScan、ExplainTidRangeScan。static void BeginTidRangeScanScan(ExtensiblePlanState *node, EState *estate, int eflags) { TidRangeScanState *ctss = (TidRangeScanState *) node; ExtensiblePlan *cscan = (ExtensiblePlan *) node->ss.ps.plan; ctss->css.ss.ss_currentScanDesc = NULL; /* no table scan here */ /* * initialize child expressions */ ctss->css.ss.ps.qual = (List*)ExecInitExpr((Expr*)cscan->scan.plan.qual, (PlanState *)ctss); TidExprListCreate(ctss); } static TupleTableSlot * ExecTidRangeScan(ExtensiblePlanState *pstate) { return ExecScan(&pstate->ss, (ExecScanAccessMtd) TidRangeNext, (ExecScanRecheckMtd) TidRangeRecheck); } static void EndTidRangeScan(ExtensiblePlanState *node) { TableScanDesc scan = node->ss.ss_currentScanDesc; if (scan != NULL) heap_endscan(scan); /* * Free the exprcontext */ ExecFreeExprContext(&node->ss.ps); /* * clear out tuple table slots */ if (node->ss.ps.ps_ResultTupleSlot) ExecClearTuple(node->ss.ps.ps_ResultTupleSlot); ExecClearTuple(node->ss.ss_ScanTupleSlot); } static void ExecReScanTidRangeScan(ExtensiblePlanState *node) { /* mark scan as not in progress, and tid range list as not computed yet */ ((TidRangeScanState*)node)->trss_inScan = false; /* * We must wait until TidRangeNext before calling table_rescan_tidrange. */ ExecScanReScan(&node->ss); } static void ExplainTidRangeScan(ExtensiblePlanState *node, List *ancestors, ExplainState *es) { TidRangeScanState *ctss = (TidRangeScanState *) node; ExtensiblePlan *cscan = (ExtensiblePlan *) ctss->css.ss.ps.plan; /* logic copied from show_qual and show_expression */ if (cscan->extensible_exprs) { bool useprefix = es->verbose; Node *qual; List *context; char *exprstr; /* Convert AND list to explicit AND */ qual = (Node *) make_ands_explicit(cscan->extensible_exprs); /* Set up deparsing context */ context = deparse_context_for_planstate((Node*)ctss, ancestors, es->rtable); /* Deparse the expression */ exprstr = deparse_expression(qual, context, useprefix, false); /* And add to es->str */ ExplainPropertyText("tid range quals", exprstr, es); } }2.4.4 改造点2.4.4.1 无法调用内核static函数在移植过程中,受限于插件实现的方式,无法调用内核的static函数,需要拷贝到插件侧或者对原有的代码作改造。执行层获取单个tuple阶段,PG在heapam.c中定义了一个函数heap_getnextslot_tidrange,其中调用了static函数heapgettup_pagemode和heapgettup。在将heap_getnextslot_tidrange搬到openGauss插件时,由于无法调用这两个static函数,需要将其改为调用heap_getnext,通过heap_getnext访问heapgettup_pagemode和heapgettup。3.1 优化器3.1.1 添加路径通常用来产生ExtensiblePath对象,并使用add_path把它们加入到rel中。插入位置所在的函数:set_rel_pathlisttypedef void (*set_rel_pathlist_hook_type) (PlannerInfo *root, RelOptInfo *rel, Index rti, RangeTblEntry *rte); extern THR_LOCAL PGDLLIMPORT set_rel_pathlist_hook_type set_rel_pathlist_hook;ExtensiblePath定义如下。typedef struct ExtensiblePath { Path path; uint32 flags; /* mask of EXTENSIBLEPATH_* flags */ List* extensible_paths; /* list of child Path nodes, if any */ List* extensible_private; const struct ExtensiblePathMethods* methods; } ExtensiblePath;flags是一个标识,如果该自定义的路径支持反向扫描,则它应该包括EXTENSIBLEPATH_SUPPORT_BACKWARD_SCAN,如果支持标记和恢复则包括EXTENSIBLEPATH_SUPPORT_MARK_RESTORE。extensible_paths是这个自定义路径节点的子Path节点列表extensible_private可用来存储该自定义路径的私有数据。methods必须包含根据该路径生成计划的方法。ExtensiblePathMethods结构如下,主要实现PlanExtensiblePath。typedef struct ExtensiblePathMethods { const char* ExtensibleName; /* Convert Path to a Plan */ struct Plan* (*PlanExtensiblePath)(PlannerInfo* root, RelOptInfo* rel, struct ExtensiblePath* best_path, List* tlist, List* clauses, List* extensible_plans); } ExtensiblePathMethods;3.1.2 添加连接路径提供连接路径,同样创建ExtensiblePath路径。插入位置所在的函数:add_paths_to_joinreltypedef void (*set_join_pathlist_hook_type) (PlannerInfo *root, RelOptInfo *joinrel, RelOptInfo *outerrel, RelOptInfo *innerrel, JoinType jointype, SpecialJoinInfo *sjinfo, Relids param_source_rels, SemiAntiJoinFactors *semifactors, List *restrictlist); extern THR_LOCAL PGDLLIMPORT set_join_pathlist_hook_type set_join_pathlist_hook;3.1.3 创建计划调用上述ExtensiblePath中的methods定义的接口PlanExtensiblePath,将自定义路径转换为一个完整的计划,返回ExtensiblePlan。插入位置所在的函数:create_scan_plan->create_extensible_plantypedef struct ExtensiblePlan { Scan scan; uint32 flags; /* mask of EXTENSIBLEPATH_* flags, see relation.h */ List* extensible_plans; /* list of Plan nodes, if any */ List* extensible_exprs; /* expressions that extensible code may evaluate */ List* extensible_private; /* private data for extensible code */ List* extensible_plan_tlist; /* optional tlist describing scan * tuple */ Bitmapset* extensible_relids; /* RTIs generated by this scan */ ExtensiblePlanMethods* methods; } ExtensiblePlan;和ExtensiblePath一样,flags同样是一个标识。extensible_plans可以用来存放子Plan节点extensible_exprs用来存储需要由setrefs.cpp和subselect.cpp修整的表达式树。extensible_private用来存储只有该自定义算子使用的私有数据。extensible_plan_tlist描述目标列extensible_relids为该扫描节点要处理的关系集合methods必须包含生成该计划对应的计划节点PlanState的方法。ExtensiblePlanMethods结构如下,主要实现CreateExtensiblePlanState。typedef struct ExtensiblePlanMethods { char* ExtensibleName; /* Create execution state (ExtensiblePlanState) from a ExtensiblePlan plan node */ Node* (*CreateExtensiblePlanState)(struct ExtensiblePlan* cscan); } ExtensiblePlanMethods;3.2 执行器3.2.1 创建计划状态节点调用上述ExtensiblePlanMethods中的methods定义的接口CreateExtensiblePlanState,为这个ExtensiblePlan分配一个ExtensiblePlanState。插入位置所在的函数:ExecInitNodeByType->ExecInitExtensiblePlantypedef struct ExtensiblePlanState { ScanState ss; uint32 flags; /* mask of EXTENSIBLEPATH_* flags, see relation.h */ List* extensible_ps; /* list of child PlanState nodes, if any */ const ExtensibleExecMethods* methods; } ExtensiblePlanState;flags含义同ExtensiblePath和ExtensiblePlan一样extensible_ps为该计划节点的子节点。methods为包含多个执行所需接口的结构体ExtensibleExecMethods,在下文做具体介绍。3.2.2 执行层hook上面CustomScanState的成员CustomExecMethods定义了几个hook点typedef struct ExtensibleExecMethods { const char* ExtensibleName; /* Executor methods: mark/restore are optional, the rest are required */ void (*BeginExtensiblePlan)(struct ExtensiblePlanState* node, EState* estate, int eflags); TupleTableSlot* (*ExecExtensiblePlan)(struct ExtensiblePlanState* node); void (*EndExtensiblePlan)(struct ExtensiblePlanState* node); void (*ReScanExtensiblePlan)(struct ExtensiblePlanState* node); void (*ExplainExtensiblePlan)(struct ExtensiblePlanState* node, List* ancestors, struct ExplainState* es); } ExtensibleExecMethods;1) BeginExtensiblePlan完成所提供的ExtensiblePlanState的初始化。标准的域已经被ExecInitExtensiblePlan初始化,但是任何私有的域应该在这里被初始化。插入位置所在的函数:ExecInitNodeByType->ExecInitExtensiblePlan2) ExecExtensiblePlan执行扫描,取下一个扫描元组,如果还有任何元组剩余,它应该用当前扫描方向的下一个元组填充ps_ResultTupleSlot,并且接着返回该元组槽。如果没有,则用NULL填充或者返回一个空槽。插入位置所在的函数:ExecProcNode->ExecProcNodeByType3) EndExtensiblePlan清除任何与ExtensiblePlanState相关的私有数据。这个方法是必需的,但是如果没有相关的数据或者相关数据将被自动清除,则它不需要做任何事情。插入位置所在的函数:ExecEndNodeByType->ExecEndExtensiblePlan4) ReScanExtensiblePlan把当前扫描倒回到开始处,并且准备重新扫描该关系。插入位置所在的函数:ExecReScan->ExecReScanByType5) ExplainExtensiblePlan为一个自定义扫描计划节点的EXPLAIN输出额外的信息。这个回调函数是可选的。即使没有这个回调函数,被存储在`ScanState中的公共的数据(例如目标列表和扫描关系)也将被显示,但是该回调函数允许显示额外的信息(例如私有状态)。插入位置所在的函数:ExplainNode->show_pushdown_qual
-
 本文目录No1. 请谈一下 Hive 的特点No2. Hive 底层与数据库交互原理?No3. Hive 的 HSQL 转换为 MapReduce 的过程?No4. Hive 的两张表关联,使用 MapReduce 怎么实现?No5. 请说明 hive 中 Sort By,Order By,Cluster By,Distrbute By 各代表什么意思?No6. 写出 hive 中 split、coalesce 及 collect_list 函数的用法(可举例)?No7. Hive 有哪些方式保存元数据,各有哪些特点?No.8 内部表和外部表的区别,以及各自的使用场景No9. Hive 中的压缩格式 TextFile、SequenceFile、RCfile 、ORCfile 各有什么区别 ?TextFileSequenceFileRCFileORCFileNo10. 所有的 Hive 任务都会有 MapReduce 的执行吗?No11. Hive 的函数:UDF、UDAF、UDTF 的区别?No12. 说说对 Hive 桶表的理解?No13. Hive 表关联查询,如何解决数据倾斜的问题?No14. 了解过 Hive 的哪些窗口函数No.15 小文件是如何产生的,解决方案No.16 Tez 引擎优点1. 请谈一下 Hive 的特点 hive 是基于 Hadoop 的一个数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并提供完整的 sql 查询功能,可以将 sql 语句转换为MapReduce 任务进行运行。 其优点是学习成本低,可以通过类 SQL 语句快速实现简单的 MapReduce 统计,不必开发专门的 MapReduce 应用,十分适合数据仓库的统计分析,但是 Hive 不支持实时查询。 2. Hive 底层与数据库交互原理? 由于 Hive 的元数据可能要面临不断地更新、修改和读取操作,所以它显然不适合使用 Hadoop 文件系统进行存储。 目前 Hive 将元数据存储在 RDBMS 中,比如存储在 MySQL、Derby 中。元数据信息包括:存在的表、表的列、权限和更多的其他信息。3. Hive 的 HSQL 转换为 MapReduce 的过程? HiveSQL -> AST(抽象语法树) -> QB(查询块) -> OperatorTree(操作树)-> 优化后的操作树 -> mapreduce 任务树 -> 优化后的 mapreduce 任务树 过程描述如下: SQL Parser:Antlr 定义 SQL 的语法规则,完成 SQL 词法,语法解析,将 SQL 转化为抽象语法树 AST Tree; Semantic Analyzer:遍历 AST Tree,抽象出查询的基本组成单元 QueryBlock; Logical plan:遍历 QueryBlock,翻译为执行操作树 OperatorTree; Logical plan optimizer: 逻辑层优化器进行 OperatorTree 变换,合并不必要的 ReduceSinkOperator,减少 shuffle 数据量; Physical plan:遍历 OperatorTree,翻译为 MapReduce 任务; Logical plan optimizer:物理层优化器进行 MapReduce 任务的变换,生成最终的执行计划;4. Hive 的两张表关联,使用 MapReduce 怎么实现? 如果其中有一张表为小表,直接使用 map 端 join 的方式(map 端加载小表)进行聚合。 如果两张都是大表,例如分别是客户表和订单表 。那么采用联合 key,联合 key 的第一个组成部分是 join on 中的公共字段,第二部分是一个 flag,0 代表表 A,1 代表表 B,由此让 Reduce 区分客户信息和订单信息;在 Mapper 中同时处理两张表的信息,将 join on 公共字段相同的数据划分到同一个分区中,进而传递到一个 Reduce 中,然后在 Reduce 中实现聚合。5. 请说明 hive 中 Sort By,Order By,Cluster By,Distrbute By 各代表什么意思? order by:会对输入做全局排序,因此只有一个 reducer(多个 reducer 无法保证全局有序)。只有一个 reducer,会导致当输入规模较大时,需要较长的计算时间 。 sort by:分区内有序,不是全局排序,其在数据进入 reducer 前完成排序 distribute by:按照指定的字段对数据进行划分输出到不同的 reduce 中 ,结合 sory by 使用 cluster by:当Distribute by和Sorts by字段相同时,可以使用Cluster by方式。Cluster by除了具有Distribute by的功能外还兼具Sort by的功能。但是排序只能是升序排序,不能指定排序规则为ASC或者DESC。6. 写出 hive 中 split、coalesce 及 collect_list 函数的用法(可举例)? split 将字符串转化为数组,即:split('a,b,c,d' , ',') ==> ["a","b","c","d"] coalesce(T v1, T v2, …) 返回参数中的第一个非空值;如果所有值都为 NULL,那么返回 NULL。 collect_list 列出该字段所有的值,不去重 => select collect_list(id) from table7. Hive 有哪些方式保存元数据,各有哪些特点? Hive 支持三种不同的元存储服务器,分别为:内嵌式元存储服务器、本地元存储服务器、远程元存储服务器,每种存储方式使用不同的配置参数 。 内嵌式元存储主要用于单元测试,在该模式下每次只有一个进程可以连接到元存储,Derby 是内嵌式元存储的默认数据库 。 在本地模式下,每个 Hive 客户端都会打开到数据存储的连接并在该连接上请求 SQL 查询 。 在远程模式下,所有的 Hive 客户端都将打开一个到元数据服务器的连接,该服务器依次查询元数据,元数据服务器和客户端之间使用 Thrift 协议通信 。8. 内部表和外部表的区别,以及各自的使用场景内部表 如果 Hive 中没有特别指定,则默认创建的表都是管理表,也称内部表。由Hive负责管理表中的数据,管理表不共享数据。删除管理表时,会删除管理表中的数据和元数据信息 。外部表 当一份数据需要被共享时,可以创建一个外部表指向这份数据 。 删除该表并不会删除掉原始数据,删除的是表的元数据。这样外部表相对来说更加安全些,数据组织也更加灵活,方便共享源数据 。当表结构或者分区数发生变化时,需要进行一步修复的操作。9. Hive 中的压缩格式 TextFile、SequenceFile、RCfile 、ORCfile 各有什么区别 ?TextFile 默认格式,存储方式为行存储,数据不做压缩,磁盘开销大,数据解析开销大。可结合 Gzip、Bzip2 使用(系统自动检查,执行查询时自动解压),但使用 这种方式,压缩后的文件不支持 split,Hive 不会对数据进行切分,从而无法对数据进行并行操作。并且在反序列化过程中,必须逐个字符判断是不是分隔符和行结束符,因此反序列化开销会比 SequenceFile 高几十倍 。SequenceFile SequenceFile 是 Hadoop API 提供的一种二进制文件支持,存储方式为行存储,其具有使用方便、可分割、可压缩的特点。 SequenceFile 支持三种压缩选择:NONE,RECORD,BLOCK。Record 压缩率低,一般建议使用 BLOCK 压缩。 优势是文件和 hadoop api 中的 MapFile 是相互兼容的 。RCFile 存储方式:数据按行分块,每块按列存储。结合了行存储和列存储的优点: 首先,RCFile 保证同一行的数据位于同一节点,因此元组重构的开销很低 ; 其次,像列存储一样,RCFile 能够利用列维度的数据压缩,并且能跳过不必要的列读取;ORCFile 存储方式:数据按行分块 每块按照列存储。 压缩快、快速列存取。 效率比 rcfile 高,是 rcfile 的改良版本。总结: 相比 TEXTFILE 和 SEQUENCEFILE,RCFILE 由于列式存储方式,数据加载时性能消耗较大,但是具有较好的压缩比和查询响应。 数据仓库的特点是一次写入、多次读取,因此,整体来看,RCFILE 相比其余两种格式具有较明显的优势。10. 所有的 Hive 任务都会有 MapReduce 的执行吗? 不是,从 Hive0.10.0 版本开始,对于简单的不需要聚合的类似 SELECT from LIMIT n 语句,不需要起 MapReduce job,直接通过 Fetch task 获取数据。 11. Hive 的函数:UDF、UDAF、UDTF 的区别? UDF:单行进入,单行输出 UDAF:多行进入,单行输出 UDTF:单行输入,多行输出12. 说说对 Hive 桶表的理解? 桶表是对数据进行哈希取值,然后放到不同文件中存储 。 数据加载到桶表时,会对字段取 hash 值,然后与桶的数量取模。把数据放到对应的文件中。物理上,每个桶就是表(或分区)目录里的一个文件,一个作业产生的桶(输出文件)和 reduce 任务个数相同 。 桶表专门用于抽样查询,是很专业性的,不是日常用来存储数据的表,需要抽样查询时,才创建和使用桶表。13. Hive 表关联查询,如何解决数据倾斜的问题?定位原因: map 输出数据按 key Hash 的分配到 reduce 中,由于 key 分布不均匀、业务数据本身的特点、建表时考虑不周、某些 SQL 语句本身就有数据倾斜等原因造成的 reduce 上的数据量差异过大。如何避免: 对于 key 为空产生的数据倾斜,可以对其赋予一个随机值解决方案:(1)参数调节: hive.map.aggr = true hive.groupby.skewindata=true 有数据倾斜的时候进行负载均衡,当选项设定位 true,生成的查询计划会有两个 MR Job。第一个 MR Job 中,Map 的输出结果集合会随机分布到 Reduce 中,每个 Reduce 做部分聚合操作,并输出结果,这样处理的结果是相同的 Group By Key 有可能被分发到不同的 Reduce 中,从而达到负载均衡的目的; 第二个 MR Job 再根据预处理的数据结果按照 Group By Key 分布到 Reduce 中(这个过程可以保证相同的 Group By Key 被分布到同一个 Reduce 中),最后完成最终的聚合操作(2)SQL语句调节: ① 选用 join key 分布最均匀的表作为驱动表。做好列裁剪和 filter 操作,以达到两表做 join 的时候,数据量相对变小的效果。 ② 大小表 Join:使用 map join 让小的维度表(1000 条以下的记录条数)先进内存。在map 端完成 reduce。 ③ 大表 Join 大表:把空值的 key 变成一个字符串加上随机数,把倾斜的数据分到不同的 reduce 上,由于 null 值关联不上,处理后并不影响最终结果。 ④ count distinct 大量相同特殊值:count distinct 时,将值为空的情况单独处理,如果是计算 count distinct, 可以不用处理,直接过滤,在最后结果中加 1。如果还有其他计算,需要进行 group by,可以先将值为空的记录单独处理,再和其他计算结果进行 union。14. 了解过 Hive 的哪些窗口函数1)Rank (1)RANK() 排序相同时会重复,总数不会变 (2)DENSE_RANK() 排序相同时会重复,总数会减少 (3)ROW_NUMBER() 会根据顺序计算2) OVER() 指定分析函数工作的数据窗口大小,这个数据窗口大小可能会随着行的变而 变化 (1)CURRENT ROW:当前行 (2) n PRECEDING:往前 n 行数据 (3) n FOLLOWING:往后 n 行数据 (4) UNBOUNDED :起 点 , UNBOUNDED PRECEDING 表 示 从 前 面 的 起 点 , UNBOUNDED FOLLOWING 表示到后面的终点 (5) LAG(col,n) :往前第 n 行数据 (6) LEAD(col,n):往后第 n 行数据 (7) NTILE(n):把有序分区中的行分发到指定数据的组中,各个组有编号,编号从 1 开始,对于每一行,NTILE 返回此行所属的组的编号。注意:n 必须为 int 类型。15. 小文件是如何产生的,解决方案 定位原因: (1)动态分区插入数据,产生大量的小文件,从而导致 map 数量剧增; (2)reduce 数量越多,小文件也越多(reduce 的个数和输出文件是对应的) (3)数据源本身就包含大量的小文件。 解决方案: (1)在 Map 执行前合并小文件,减少 Map 数: CombineHiveInputFormat 具有对小文件 进行合并的功能(系统默认的格式)。HiveInputFormat 没有对小文件合并功能。 (2)merge SET hive.merge.mapfiles = true; -- 默认 true,在 map-only 任务结束时合并 小文件 SET hive.merge.mapredfiles = true; -- 默认 false,在 map-reduce 任务结 束时合并小文件 SET hive.merge.size.per.task = 268435456; -- 默认 256M SET hive.merge.smallfiles.avgsize = 16777216; -- 当输出文件的平均大小 小于 16m 该值时,启动一个独立的 map-reduce 任务进行文件 merge(3)开启 JVM 重用 set mapreduce.job.jvm.numtasks=1016. Tez 引擎优点 Tez 可以将多个有依赖的作业转换为一个作业,这样只需写一次 HDFS,且中间节点较少,从而大大提升作业的计算性能。 Mr/tez/spark 区别: Mr 引擎:多 job 串联,基于磁盘,落盘的地方比较多。虽然慢,但一定能跑出结果。一般处理,周、月、年指标 。 Spark 引擎:虽然在 Shuffle 过程中也落盘,但是并不是所有算子都需要 Shuffle,尤其 是多算子过程,中间过程不落盘 DAG 有向无环图。兼顾了可靠性和效率。一般处理天指标。 Tez 引擎:完全基于内存。注意:如果数据量特别大,慎重使用。容易 OOM。一般用于快速出结果,数据量比较小的场景。文章转载自大数据梦想家公众号 https://mp.weixin.qq.com/s/nmJHXobhhNfk9YSDfHGE3g免责声明:转载文章版权归原作者所有。如涉及作品内容、版权等问题,请及时联系文章编辑!
-
1.全密态数据库特性简介全密态数据库意在解决数据全生命周期的隐私保护问题,使得系统无论在何种业务场景和环境下,数据在传输、运算以及存储的各个环节始终都处于密文状态。当数据拥有者在客户端完成数据加密并发送给服务端后,在攻击者借助系统脆弱点窃取用户数据的状态下仍然无法获得有效的价值信息,从而起到保护数据隐私的能力。2.全密态数据库的客户价值由于整个业务数据流在数据处理过程中都是以密文形态存在,通过全密态数据库,可以实现:保护数据在云上全生命周期的隐私安全,无论数据处于何种状态,攻击者都无法从数据库服务端获取有效信息。帮助云服务提供商获取第三方信任,无论是企业服务场景下的业务管理员、运维管理员,还是消费者云业务下的应用开发者,用户通过将密钥掌握在自己手上,使得高权限用户无法获取数据有效信息。让云数据库服务借助全密态能力更好的遵守个人隐私保护方面的法律法规。3.全密态数据库的使用全密态数据库目前支持两种连接方式:gsql连接和jdbc连接。本章将从四个步骤详细介绍两种连接方式下,数据库的使用流程。3.1连接全密态数据库GSQL连接数据库执行以下命令打开密态开关:gsql -p PORT –d postgres -r –C参数说明:-p端口号,-d数据库名称 –C是打开密态开关。JDBC支持密态数据库相关操作,需要设置enable_ce=13.2创建用户密钥全密态数据库有两种密钥,即客户端主密钥CMK和数据加密密钥CEK。CMK用于加密CEK,CEK用于加密用户数据。在创建密钥之前,首先要使用gs_ktool工具创建密钥ID,此ID用于创建客户端主密钥CMK:openGauss=# \! gs_ktool -g密钥创建的顺序和依赖依次为:创建密钥IDà创建CMKà创建CEK。GSQL环境下创建CMK和CEK【创建CMK】CREATE CLIENT MASTER KEY client_master_key_name WITH (KEY_STORE = key_store_name, KEY_PATH = "key_path_value", ALGORITHM = algorithm_type);参数说明:• client_master_key_name该参数作为密钥对象名,在同一命名空间下,需满足命名唯一性约束。取值范围:字符串,需符合标识符的命名规范。• KEY_STORE独立管理密钥的工具/服务。目前,仅支持由GaussDB Kenel提供的密钥管理工具gs_ktool,以及由华为云提供的在线密钥管理服务huawei_kms。取值范围为:gs_ktool,huawei_kms。• KEY_PATH用于指定密钥管理工具/服务中的一个密钥。通过KEY_STORE和KEY_PATH参数可唯一确定一个密钥实体。当KEY_STORE = gs_ktool时,取值范围为:gs_ktool/KEY_ID;当KEY_STORE = huawei_kms时,取值范围为:36字节的密钥ID。• ALGORITHM用于指定该密钥实体将用于何种加密算法。当KEY_STORE = gs_ktool时,取值范围为:AES_256_CBC,SM4;当KEY_STORE = huawei_kms时,取值为:AES_256。【创建CEK】CREATE COLUMN ENCRYPTION KEY column_encryption_key_name WITH(CLIENT_MASTER_KEY = client_master_key_name, ALGORITHM = algorithm_type, ENCRYPTED_VALUE = encrypted_value);参数说明:• column_encryption_key_name该参数作为密钥对象名,在同一命名空间下,需满足命名唯一性约束。取值范围:字符串,要符合标识符的命名规范。• CLIENT_MASTER_KEY指定用于加密本CEK的CMK,取值为:CMK对象名,该CMK对象由CREATE CLIENT MASTER KEY语法创建。• ALGORITHM指定该CEK将用于何种加密算法,取值范围为:AEAD_AES_256_CBC_HMAC_SHA256、AEAD_AES_128_CBC_HMAC_SHA256和SM4_SM3;• ENCRYPTED_VALUE(可选项)该值为用户指定的密钥口令,密钥口令长度范围为28 ~ 256位,28位派生出来的密钥安全强度满足AES128,若用户需要用AES256,密钥口令的长度需要39位,如果不指定,则会自动生成256比特的密钥。说明:由于SM2、SM3、SM4等算法属于中国国家密码标准算法,为规避法律风险,需配套使用。即如果将CEK用于SM4_SM3算法,则仅能使用SM4算法来对该CEK进行加密。【示例:GSQL环境下】--(1)使用密钥管理工具gs_ktool创建密钥,该工具会返回新生成的密钥的ID [cmd] gs_ktool -g -- (2) 使用特权账户,创建一个普通用户alice。 openGauss=# CREATE USER alice PASSWORD '********'; -- (3)使用普通用户alice的账户,连接密态数据库,并执行本语法 gsql -p 57101 postgres -U alice -r -C -- 创建客户端加密主密钥(CMK)对象 openGauss=> CREATE CLIENT MASTER KEY alice_cmk WITH ( KEY_STORE = gs_ktool , KEY_PATH = "gs_ktool/1" , ALGORITHM = AES_256_CBC); -- 创建客户端列加密密钥(CEK)对象 openGauss=> CREATE COLUMN ENCRYPTION KEY a_cek WITH VALUES (CLIENT_MASTER_KEY = a_cmk, ALGORITHM = AEAD_AES_256_CBC_HMAC_SHA256); openGauss=> CREATE COLUMN ENCRYPTION KEY another_cek WITH VALUES (CLIENT_MASTER_KEY = a_cmk, ALGORITHM = SM4_SM3);JDBC环境下创建CMK和CEK// 创建客户端主密钥 Connection conn = DriverManager.getConnection("url","user","password"); Statement stmt = conn.createStatement(); int rc = stmt.executeUpdate("CREATE CLIENT MASTER KEY ImgCMK1 WITH ( KEY_STORE = gs_ktool , KEY_PATH = \"gs_ktool/1\" , ALGORITHM = AES_256_CBC);"); // 创建列加密密钥 int rc2 = stmt.executeUpdate("CREATE COLUMN ENCRYPTION KEY ImgCEK1 WITH VALUES (CLIENT_MASTER_KEY = ImgCMK1, ALGORITHM = AEAD_AES_256_CBC_HMAC_SHA256);");3.3创建加密表在创建了客户端主密钥CMK和数据加密密钥CEK之后,就可以使用CEK创建加密表了。加密表的创建支持对加密列进行随机加密和确定性加密两种· 123··方式。1.GSQL连接环境下创建加密表【示例】openGauss=# CREATE TABLE creditcard_info (id_number int, name text encrypted with (column_encryption_key = ImgCEK, encryption_type = DETERMINISTIC), credit_card varchar(19) encrypted with (column_encryption_key = ImgCEK1, encryption_type = DETERMINISTIC));参数说明ENCRYPTION_TYPE为ENCRYPTED WITH约束中的加密类型,encryption_type_value的值为[ DETERMINISTIC | RANDOMIZED ]。2.JDBC环境下创建加密表int rc3 = stmt.executeUpdate("CREATE TABLE creditcard_info (id_number int, name varchar(50) encrypted with (column_encryption_key = ImgCEK1, encryption_type = DETERMINISTIC),credit_card varchar(19) encrypted with (column_encryption_key = ImgCEK1, encryption_type = DETERMINISTIC));");3.4向加密表插入数据并进行查询创建了加密表以后,可以在密态数据库模式下(连接参数-C)向加密表中插入数据、查看数据。当使用普通环境(关掉连接参数-C)时,是无法对加密表进行操作的,查看加密表时也只能看到密文数据。1. GSQL环境下向加密表插入数据并查看openGauss=# INSERT INTO creditcard_info VALUES (1,'joe','6217986500001288393'); INSERT 0 1 openGauss=# INSERT INTO creditcard_info VALUES (2, 'joy','6219985678349800033'); INSERT 0 1 openGauss=# select * from creditcard_info where name = 'joe'; id_number | name | credit_card -----------+------+--------------------- 1 | joe | 6217986500001288393 (1 row)注意:使用非密态客户端查看该加密表数据时是密文openGauss=# select id_number,name from creditcard_info; id_number | name -----------+------------------------------------------- 1 | \x011aefabd754ded0a536a96664790622487c4d36 2 | \x011aefabd76853108eb406c0f90e7c773b71648f (2 rows)2. JDBC环境下向加密表插入数据并查看// 插入数据 int rc4 = stmt.executeUpdate("INSERT INTO creditcard_info VALUES (1,'joe','6217986500001288393');"); // 查询加密表 ResultSet rs = null; rs = stmt.executeQuery("select * from creditcard_info where name = 'joe';"); // 关闭语句对象 stmt.close();上述我们列出的是全密态数据库特性的基本使用方法,更全面的使用介绍,可以参考官方文档中的对应章节。但对于普通用户来说,上述介绍的功能足以保证日常工作的顺利开展。后续,全密态数据库也会沿着更加易用、更高的性能进行演进,也欢迎大家持续关注!
-
>摘要:GaussDB首要的任务是解决华为的业务连续性的需求,同时也是要确保使用GaussDB的客户的业务能够连续,所以我们坚持战略投入,坚持从每一行代码,坚持从生态开始来构建整个数据库体系。本文分享自华为云社区《华为云GaussDB:发挥生态优势,培养应用型DBA》,作者:GaussDB数据库。 # 导读: 随着5G互联网时代的来临,各行各业对于数据库的依赖程度也在逐步提高。由于国内在数据库行业的发展起步较晚,数据库的市场份额长期被Oracle,微软等美国公司所控制.但是伴随着国内IT技术栈的不断演进,去“IOE”已经由一个企业的目标,变成了整个行业的目标,也就是说我国必须使信息系统数据,运行在自研系统之上,以防止数据丢失造成的一系列严重后果。而近两年从国际形势来看,去IOE已经成为了国产数据库发展的必经之路。 很高兴看到的是如今国产数据库已逐步形成了百花齐放的格局,此次邀请了华为云数据库业务负责人苏光牛先生来和网友们一起交流关于未来国产数据库的发展。同时我们也征集了一些与国产数据库相关的社会讨论度较高、网友较为关心的问题,希望从数据库产品负责人的角度给大众一些更深层次的独到见解。  华为云数据库业务负责人苏光牛 负责华为云数据库业务的战略制定与发展,数据库云服务产品与解决方案研发、运营、运维和交付等。 # —以下为采访全文— **Q:介绍下贵公司的数据库产品及优势,以及主要的目标用户是谁?** **苏光牛**:华为数据库GaussDB首先定位是云数据库,其次,定位为分布式数据库,云和分布式的结合是数据库的未来。GaussDB首要的任务是解决华为的业务连续性需求,能不受任何约束地使用数据库,所以从一开始就思考如何完全的自主可控,从每一行代码、从生态,从电信的可靠、可用及性能等要求出发,再和云技术相结合,打造企业级分布式数据库。 **在当前的形势下**,GaussDB上述定位更加符合金融、泛政府、电信、能源、交通、医疗、物流等重要行业的需求,真正能帮助客户实现数字化转型。 GaussDB是一个产品系列,在整体架构设计上,**体现了多模的设计理念**。具体包括: - 关系型数据库: 1. 基于openGauss生态的分布式数据库GaussDB(foropenGauss),是自主生态的分布式数据库 2. 基于MySQL生态的分布式数据库GaussDB(forMySQL),我们100%兼容MySQL,让更多的客户可以无缝迁移上来,同时,这也是分布式数据库,不再是单机的主备的MySQL - 非关系型NoSQL数据库: - 基于文档的分布式数据库GaussDB(forMongo),100%兼容Mongo的接口,解决了开源的协议风险,用3副本解决9副本的可靠性 - 基于时序协议的分布式数据库GaussDB(forInflux),分布式方案解决了开源只有主备的容量问题 - 基于宽表Cassandra的GaussDB(forCassandra),解决了Java的GC抖动的严重问题,数据强一致 - 基于KV接口的GaussDB(forRedis),当前100%兼容Redis,未来可以兼容更多的KV协议,数据强一致,超大容量10T+,解决了开源主备脱节等问题 此外,还有一些重要的组件,如:数据迁移——DRS(DataReplicationService);应用结构的转换——UGO(DatabaseandApplicationMigrationUGO)(愚公移山);分布式数据库中间件——DDM(DistributedDatabaseMiddleware),中间件这一层完全自主开发,让整体具备分布式分库分表>能力,满足需要MySQL生态但对可信要求不高的客户的诉求。 华为云GaussDB全栈产品以及解决方案,目的是让客户:选型安心(自主生态,开源生态,NoSQL,分布式统一的架构,性能卓越)、迁移放心(从数据的在线迁移到应用的结构转换,让迁移的担忧不复存在)、生态无忧(无论基于开源的生态,还是对自主生态的要求,都能满足)。 **Q:贵司的数据库目前取得了哪些成绩** **苏光牛**:GaussDB汇聚全球资源,依托分布在全球7大区域的研究所、约2000+数据库/数据仓库/大数据的高级内核引擎、算法、性能等专家与专业人才,持续战略投入10多年: 1. 市场份额:金融政企市场,GaussDB本地部署(也即:HCS的方案)取得国产数据库第一的市场份额(来源:2020下半年IDC中国关系型数据库软件市场数据跟踪报告);同时,全球DBMS市场份额进入了前十名(来源:GartnerMarketShareAnalysis:DatabaseManagementSystems,Worldwide,2020) 2. 标杆客户:已在1500+金融政企与泛互联网标杆大客户取得规模商用,以金融业为例,GaussDB已经和工商银行、建设银行、招商银行、邮政储蓄银行、农业银行、交通银行、中信银行、光大银行、民生银行、华夏银行、中原银行、永安保险、众惠财产相互保险社、安心保险、海通证券等大量头部银行、保险和证券客户展开广泛合作。 3. 学术研究:华为先后在SIGMOD、VLDB、ICDE三大顶级国际学术会议上发表数据库论文36篇。尤其在AI-Native方向,2021年新入选SIGMOD国际顶级会议的《LearnedCardinalityEstimationforSimilarityQueries》创新地提出了模型分割和数据分割解决方法来解决DNN训练难题。 4. 高校生态:与教育部联合建设“智能基座”基地,GaussDB已与72所国内双一流高校建立合作关系,同时在教育部“新工科”项目的54所高校中开设GaussDB数据库课程。在高职、专科院校,通过实践实训培养面向社会的应用型人才。开课之外,华为数据库每年定期开展师资培训,联合多所顶尖高校教授出版GaussDB数据库教材、教辅,持续完善GaussDB数据库的人才培养体系! 除此之外,GaussDB数据库每年举办数据库性能挑战大赛,设置实习生计划和优才招聘计划,提供华为和行业伙伴实习机会。从理论教学、动手实验、大赛历练、职业认证、人才招聘全流程支持,长期培养和输送GaussDB人才! 1. 开发者生态:华为将GaussDB的核心能力贡献出来,形成openGauss的开源版本和openGauss的生态,当前有1700+开发者参与openGauss开源项目,20000+社区用户,来自全球74个国家506个城市的29万的下载量,10家厂商发行了基于openGauss开源内核的自主品牌商业数据库产品,民生银行、中国电信等43家头部企业加入社区。 以华为云开发者社区为基础,提供39个GaussDB技术课程,发布和更新GaussDB初级、中级培训认证;和国内10+数据库以及开发者社区建立合作关系,积极支持和参与线上线下技术活动,和业界共同繁荣数据库社区,累计赋能15万以上开发者。 1. 合作伙伴生态:数据库产业的发展离不开上下游生态伙伴的支持,经过测试和认证,华为云GaussDB已和100+伙伴的产品形成联合解决方案,并推荐到华为云严选商城,共享市场机会,涵盖: a)生态工具伙伴:迪思杰、英方、数见、航天壹进制、鼎甲等异构数据同步工具、数据库灾备工具 b)金融、政府等行业解决方案伙伴:例如神码融信、长亮科技等 c)咨询服务类伙伴:海量数据、云和恩墨等 d)SaaS伙伴:金蝶、用友、甄云、泛微、致远互联等; e)基础设施伙伴:如麒麟OS和统信OS **Q:贵司的数据库产品未来有什么规划,或者重点突破的方向** **苏光牛**:未来,华为云数据库将在以下几个方面持续投入和布局: - 做好数据库生态:数据库要跟随华为云进入千行百业,离不开数据库生态的建设。除了构建openGauss自主可控的生态外,我们也积极拥抱并完全兼容业界主流的如关系型的MySQL、PostgreSQL及非关系型的Mongo、Redis、Cassandra和InfluxDB等生态。在伙伴生态建设上,认证多家ISV作为我们的伙伴,提供迁移、容灾等数据库上云解决方案,为更多的客户提供服务。 - 促进联合创新:金融行业是对数据库稳定可靠、性能等各方面要求极为苛刻的典型行业,有上亿用户和高并发海量交易等丰富的应用场景,华为和工行等头部客户坚持长期联创,通过这些不可多得的严苛而丰富的场景和应用,帮助GaussDB数据库快速孵化提升能力,也帮助这些企业完成数字化的转型等任务。 - 服务华为自身业务:华为GaussDB系列数据库已经规模承载了华为终端云服务和内部流程IT的业务,华为这2个业务有着苛刻的要求。GaussDB帮助了华为自身这种既有传统业务又有新型业务实现了数字化转型,这是一个非常好的范本。 - 核心竞争力打造: 1. 多Region多活:支持全球化企业数据就近访问,全球多活容灾,数据多点写入; 2. 软硬协同:全面支持多样化算力,具备从算力到服务器、存储、操作系统、数据库的E2E研发能力,发挥数据库软硬协同、性能调优的独特优势; 3. 企业级分布式能力:交易型的数据容量从M到G,再到T,几十T,决定了分布式数据库是大势所趋,华为云数据库着力面向分布式场景打造极致的可靠性和扩展性; 4. 数据安全与可信:随着各行各业对数据安全和隐私保护的重视,GaussDB会通过全密态数据库为客户消除数据泄露的风险。 5. AI-Native:上万台服务器,数据库数千个实例,100+T的数据,海量节点规模下的数据的高效管理是必须面对的难题。华为致力于打造具备自感知,自恢复,自优化等能力的云数据库,实现高度自治,降低数据库运维成本 **Q:针对数据库行业,您认同“得DBA者得天下”这句话?** **苏光牛**:本质上这句话的含义是:**得生态者得天下**。DBA是可以培养的,一个好的生态更容易培养出DBA,所以生态才是最重要的。当前的大环境形势,给了数据库及生态机会,我们要打造一个开放的、易学习易上手的生态,例如:openGauss,我们从2020.6.30开始开源,从每一行代码开始来打造,同时尽可能兼容一个生态,这样就让大家更容易学习。 目前国内有10家ISV已经基于openGauss打造了自己的数据库,我相信越来越多企业和个人会感受到openGauss在生态上的优势。 **Q:对于新手来说在学习GaussDB数据库方面有没有什么好的学习建议** **苏光牛**:GaussDB推出了一系列学习资料,帮助大家从零开始学习和使用GaussDB,主要包括: - **GaussDB的入门**:注册华为云,进入华为云学院,在“学习路径”中找到“[数据库学习路径](https://education.huaweicloud.com/programs/6d767c5a-8932-4616-ae37-43e13a332910/about)“;同时,申请GaussDB实例进行调测,与实战相结合,熟悉云数据库方案设计与调优; - **GaussDB精品课**:进入华为云学院,在“在线课程”中找到“[数据库](https://edu.huaweicloud.com/courses)“,这里有内核专家精心录制的视频,每期围绕1个主题内容,详解1个业务难题。 -** GaussDB慕课**:登录中国大学MOOC网,由东北师范大学李雁翎教授团队与GaussDB专家团队联合开发,[《数据库原理 GaussDB云数据库》](https://bbs.huaweicloud.com/forum/thread-154280-1-1.html#)已上线; - **培训认证**:华为云同步推出了GaussDB初级以及高级课程以及认证,进入华为云学院,选择“[职业认证](https://edu.huaweicloud.com/training)”。 - 同时也建议大家下载openGauss,购买《openGauss数据库核心技术》结合代码深入理解数据库内核,为社区做贡献,提升自己的影响力,成为大咖。 华为云数据库产品团队不断推出新的线上学习课程,举办数据库训练营、挑战赛等,请大家关注微信公众号“GaussDB数据库”获取最新活动信息。 **Q:目前国内外对于数据库开源都有不同的意见。一些国产数据库也逐步进行了开源,那开源到底好不好?以及开源是否能带来直观的收益。** **苏光牛**:数据库是讲究生态的产业,生态需要耐心持续的投入。华为积极参与和推进产业生态,2020年6月30日,华为开源openGauss,与合作伙伴、高校以及开发者共建开源生态,鼓励有能力的合作伙伴发展基于openGauss的自有品牌数据库产品,为上层应用提供更多数据库选择,和业界共同繁荣数据库产业生态。 GaussDB(foropenGauss)是华为基于openGauss的生态和部分内核增强了分布式能力的商业版本,通过华为云和华为云Stack(HCS),满足政企客户对分布式数据库的高性能、高可靠、高安全的需求。 开源对数据库生态的帮助,整体来讲,是正向的积极的。但是开源需要真的开源,需要安全的开源和合规的开源,开源涉及大量第三方依赖包括专利的优化和调整,而不是代码放开就是开源;所以从这个意义上来讲,开源也要负责任,开源不是终点,更不是被迫的应对措施,开源需要帮助更多的伙伴能真正的用起来。 同时,华为也积极拥抱并兼容和支持业界主流的生态如MySQL、PostgreSQL及非关系型数据库Mongo、Redis等生态,我们会把这些软件生态和华为的分布式存储、软硬件协同起来,让客户既能获得生态的好处,又能获得更高的性能、可靠性,这才是我们认为的真正符合客户需要的数据库产品。 **Q:您认为数据库国产化目前的难点是什么,或者说国产数据库发展的主要瓶颈有哪些?** **苏光牛**:当前数据库产业的核心难点之一是人才,实际上芯片、操作系统和数据库这些根技术上都缺乏人才,其中一个原因也是因为一直以来普遍都更加关注应用开发,例如:很多大学生主要学习JAVA等高级开发语言作为未来的职业的主要语言,但这些根技术普遍还是C语言,这些系统级的软件需要C语言的精深的掌握,仅仅是这一条就让很多人不选择系统级的软件开发岗位;同时,这些根技术的入门台阶很高,学习了JAVA语言开发一个APP可能24小时就可以了,但数据库不行,特别是内核的开发可能需要半年,甚至更长的时间,这会让更多人即使进入后也会打退堂鼓;最后,长期以来交易数据库很重要,是IT系统的核心的核心,但数据库实际的营收却并不高,这里面有复杂的因素,但确实让很多企业望而却步,因为收益可能是未来的可能是隐形的,加上人才难以获得,很多企业就难以长期坚持下去。 GaussDB从发展初期开始,对人才培养和获取就基于全球多个区域进行布局,同时长期坚持战略投入,解决上述2个因素带来的不利影响。 **Q:聊聊您对国产数据库未来的展望和寄语。** **苏光牛**:在当前的大环境下,给中国的数据库带来了机遇,所以整体来讲,对数据库从业者来讲是一个好事。我们知道数据库的大体的理论框架和架构实际上经过了40年的发展,基本上是比较成熟的,核心挑战是工程化的难度,所以这是考验耐力和恒心的时刻,长期坚持战略投入是最基础的保障;同时当前的开源软件为开发数据库内核提供了原型式的范本,但这个直接拿来做一些简单的增强就希望成为“企业级”的数据库,实际上有很大的差距,本着为客户着想,其实需要做很多的工作;最后,国产数据库做到自主可控,每个企业每个人对自主可控的理解都可能不太一样,比如说:通过某个开源软件+一个中间件,到底算不算自主可控,到底算不算分布式数据库,这可能仁者见仁智者见智,不过,本着为服务的企业负责任的态度,我们要保证自己的业务连续(坚持做数据库,10年100年还做数据库),同时也要为客户负责,任何情况下,自己开发的软件符合安全和合规的要求,客户的业务才能连续。 GaussDB首要的任务是解决华为的业务连续性的需求,同时也是要确保使用GaussDB的客户的业务能够连续,所以我们坚持战略投入,坚持从每一行代码,坚持从生态开始来构建整个数据库体系。
-
 如果我们需要完全的复制MySQL的数据表,包括表的结构,索引,默认值等。 如果仅仅使用CREATE TABLE ... SELECT 命令,是无法实现的。本章节将为大家介绍如何完整的复制MySQL数据表,步骤如下:使用 SHOW CREATE TABLE 命令获取创建数据表(CREATE TABLE) 语句,该语句包含了原数据表的结构,索引等。复制以下命令显示的SQL语句,修改数据表名,并执行SQL语句,通过以上命令 将完全的复制数据表结构。如果你想复制表的内容,你就可以使用 INSERT INTO ... SELECT 语句来实现。实例尝试以下实例来复制表 tutorials_tbl 。步骤一:获取数据表的完整结构。mysql> SHOW CREATE TABLE tutorials_tbl \G; *************************** 1. row *************************** Table: tutorials_tbl Create Table: CREATE TABLE `tutorials_tbl` ( `tutorial_id` int(11) NOT NULL auto_increment, `tutorial_title` varchar(100) NOT NULL default '', `tutorial_author` varchar(40) NOT NULL default '', `submission_date` date default NULL, PRIMARY KEY (`tutorial_id`), UNIQUE KEY `AUTHOR_INDEX` (`tutorial_author`) ) TYPE=MyISAM 1 row in set (0.00 sec) ERROR: No query specified步骤二:修改SQL语句的数据表名,并执行SQL语句。mysql> CREATE TABLE `clone_tbl` ( -> `tutorial_id` int(11) NOT NULL auto_increment, -> `tutorial_title` varchar(100) NOT NULL default '', -> `tutorial_author` varchar(40) NOT NULL default '', -> `submission_date` date default NULL, -> PRIMARY KEY (`tutorial_id`), -> UNIQUE KEY `AUTHOR_INDEX` (`tutorial_author`) -> ) TYPE=MyISAM; Query OK, 0 rows affected (1.80 sec)步骤三:执行完第二步骤后,你将在数据库中创建新的克隆表 clone_tbl。 如果你想拷贝数据表的数据你可以使用 INSERT INTO... SELECT 语句来实现。mysql> INSERT INTO clone_tbl (tutorial_id, -> tutorial_title, -> tutorial_author, -> submission_date) -> SELECT tutorial_id,tutorial_title, -> tutorial_author,submission_date -> FROM tutorials_tbl; Query OK, 3 rows affected (0.07 sec) Records: 3 Duplicates: 0 Warnings: 0参考文章:http://www.manongjc.com/mysql/mysql_clone_tables.html
-
 【功能模块】GaussDB DWS 查询报错【操作步骤&问题现象】1、执行查询2、报错信息:ERROR : failed on assertion in agg-plan.cpp line 1495 · invalid target distribution information or its bms-data nodeids is null. 【截图信息】【日志信息】(可选,上传日志内容或者附件)ERROR : failed on assertion in agg-plan.cpp line 1495 · invalid target distribution information or its bms-data nodeids is null.
-
转载:https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=156102&fromuid=102209结合项目实践板块总体发帖内容,从如下几个角度进行了整理和汇总,方便大家查阅与检索。后续如有精品将持续进行更新~分类整理如下:序号主题分类应用场景标题访问链接1迁移系列Oracle语法迁移【Oracle语法迁移】存储过程中table%Rowtype语法改写https://bbs.huaweicloud.com/forum/thread-132423-1-1.html2【Oracle语法迁移】pivot语法https://bbs.huaweicloud.com/forum/thread-123046-1-1.html3【Oracle语法迁移】Max/Min...keep语法https://bbs.huaweicloud.com/forum/thread-123044-1-1.html4【Oracle语法迁移】Rownum语法迁移案例https://bbs.huaweicloud.com/forum/thread-114322-1-1.html5【Oracle语法迁移】connect_by_root语法迁移案例https://bbs.huaweicloud.com/forum/thread-114317-1-1.html6【Oracle语法迁移】order siblings by语法迁移案例https://bbs.huaweicloud.com/forum/thread-114312-1-1.html7【Oracle语法迁移】sys_connect_by_path语法迁移案例https://bbs.huaweicloud.com/forum/thread-114307-1-1.html8【Oracle语法迁移】单表递归语法迁移案例https://bbs.huaweicloud.com/forum/thread-114304-1-1.html9Gauss DB(DWS)迁移系列-Oracle 函数转换差异(四)https://bbs.huaweicloud.com/forum/thread-122099-1-1.html10Gauss DB(DWS)迁移系列-Oracle 函数转换差异(二)https://bbs.huaweicloud.com/forum/thread-122098-1-1.html11Gauss DB(DWS)迁移系列-Oracle 函数转换差异(一)https://bbs.huaweicloud.com/forum/thread-122097-1-1.html12Gauss DB(DWS)迁移系列-Oracle 数据类型差异https://bbs.huaweicloud.com/forum/thread-122096-1-1.html13oracle列转行unpivot函数语法转换https://bbs.huaweicloud.com/forum/thread-133591-1-1.html14Oracle 分析函数 keep改造方案https://bbs.huaweicloud.com/forum/thread-122150-1-1.html15Oralce in相关子查询中包含distinct Gauss适配改造https://bbs.huaweicloud.com/forum/thread-122146-1-1.html16Oralce listagg/stragg/WM_CONCAT 迁移改造方案https://bbs.huaweicloud.com/forum/thread-122145-1-1.html17oracle 递归改造案例https://bbs.huaweicloud.com/forum/thread-122143-1-1.html18Oracle package 在gauss中的替换方法https://bbs.huaweicloud.com/forum/thread-122103-1-1.html19gauss与oracle存储过程差异和改写方法https://bbs.huaweicloud.com/forum/thread-122102-1-1.html20GaussDB和Oracle DDL的差异和替换示例https://bbs.huaweicloud.com/forum/thread-122101-1-1.html21Gauss 和 Oracle DML的差异和规避方案https://bbs.huaweicloud.com/forum/thread-122100-1-1.html22[项目实践-迁移系列] Gauss DB(DWS)迁移系列-Oracle迁移分析函数https://bbs.huaweicloud.com/forum/thread-122095-1-1.html23ORACLE 触发器在GaussDB(DWS)上的实现https://bbs.huaweicloud.com/forum/thread-117970-1-1.html24oracle CONNECT_BY_ROOT,CONNECT_BY_ISLEAF等在GaussDB(DWS)实现https://bbs.huaweicloud.com/forum/thread-117964-1-1.html25TD语法迁移【Teradata语法迁移】VOLATILE表语法迁移改写https://bbs.huaweicloud.com/forum/thread-117690-1-1.html26【Teradata语法迁移】Teradata set语法迁移案例https://bbs.huaweicloud.com/forum/thread-117686-1-1.html27Gauss DB(DWS)迁移系列-TD迁移DDL差异-分区定义设置Partition by https://bbs.huaweicloud.com/forum/thread-117993-1-1.html28Gauss DB(DWS)迁移系列-TD迁移DDL差异-字段字符集设置Character set Latinhttps://bbs.huaweicloud.com/forum/thread-117990-1-1.html29Gauss DB(DWS)迁移系列-TD迁移DDL差异-字段多值压缩属性compresshttps://bbs.huaweicloud.com/forum/thread-117989-1-1.html30Gauss DB(DWS)迁移系列-TD迁移DDL差异-字段数据格式化显式属性formathttps://bbs.huaweicloud.com/forum/thread-117988-1-1.html31Gauss DB(DWS)迁移系列-TD迁移DDL差异-视图迁移差异https://bbs.huaweicloud.com/forum/thread-117985-1-1.html32Gauss DB(DWS)迁移系列-TD迁移DDL差异-大小写敏感CASESPECIFIC/NOT CASESPECIFIChttps://bbs.huaweicloud.com/forum/thread-117982-1-1.html33Gauss DB(DWS)迁移系列-TD迁移DDL差异-行列存存储格式https://bbs.huaweicloud.com/forum/thread-117981-1-1.html34Gauss DB(DWS)迁移系列-TD迁移DDL差异-是否允许重复记录Set/MultiSethttps://bbs.huaweicloud.com/forum/thread-117955-1-1.html35Gauss DB(DWS)迁移系列-TD迁移DDL差异-可变临时表Volatilehttps://bbs.huaweicloud.com/forum/thread-117952-1-1.html36Gauss DB(DWS)迁移系列-TD的日期类型和数值型互转操作差异https://bbs.huaweicloud.com/forum/thread-117946-1-1.html37Gauss DB(DWS)迁移系列-Teradata迁移PIVOT/UNPIVOT 语法转换对照https://bbs.huaweicloud.com/forum/thread-113049-1-1.html38TD常用字典视图在GaussDB(DWS)上实现https://bbs.huaweicloud.com/forum/thread-117977-1-1.html39Gauss DB(DWS)迁移系列-TD迁移函数之next函数https://bbs.huaweicloud.com/forum/thread-114003-1-1.html40MySQL语法迁移【MySQL语法迁移】str_to_date()迁移https://bbs.huaweicloud.com/forum/thread-136679-1-1.html41【MySQL语法迁移】date_format()语法迁移https://bbs.huaweicloud.com/forum/thread-136677-1-1.html42【MySQL语法迁移】分页查询https://bbs.huaweicloud.com/forum/thread-136674-1-1.html43【MySQL语法迁移】double类型迁移https://bbs.huaweicloud.com/forum/thread-136673-1-1.html44【MySQL语法迁移】AUTO_INCREMENT自增列迁移https://bbs.huaweicloud.com/forum/thread-136672-1-1.html45【MySQL语法迁移】Datetime类型https://bbs.huaweicloud.com/forum/thread-136671-1-1.html46【MySQL语法迁移】表注释迁移https://bbs.huaweicloud.com/forum/thread-136669-1-1.html47【MySQL语法迁移】列注释迁移https://bbs.huaweicloud.com/forum/thread-136668-1-1.html48GaussDB(DWS)实践系列-MySQL->GaussDB(DWS)常用语法对照表https://bbs.huaweicloud.com/forum/thread-146647-1-1.html49ADB for mysql 【INSERT [IGNORE] INTO table_name】迁移 DWS 改写方法https://bbs.huaweicloud.com/forum/thread-111391-1-1.html50对接系列ETL对接GaussDB(DWS)与Kettle对接指导https://bbs.huaweicloud.com/forum/thread-104549-1-1.html51Informatica10.2与GaussDB A对接https://bbs.huaweicloud.com/forum/thread-119448-1-1.html52GaussDB(DWS)与OGG对接https://bbs.huaweicloud.com/forum/thread-102196-1-1.html53驱动对接JDBC 对接 GaussDB(DWS)的数据库连接问题https://bbs.huaweicloud.com/forum/thread-101725-1-1.html54DWS perl通过ODBC连接GaussDB(DWS)https://bbs.huaweicloud.com/forum/thread-119608-1-1.html55AIX服务器安装psql工具连接GaussDB DWShttps://bbs.huaweicloud.com/forum/thread-119444-1-1.html56使用Python连接GaussDB(DWS)https://bbs.huaweicloud.com/forum/thread-119609-1-1.html57BI报表DWS使用.net驱动对接powerBIhttps://bbs.huaweicloud.com/forum/thread-133293-1-1.html58DWS Power BI对接指导https://bbs.huaweicloud.com/forum/thread-120839-1-1.html59GAUSSDB(DWS)对接OBIEE指导https://bbs.huaweicloud.com/forum/thread-102193-1-1.html60Cognos11.0.12 对接GaussDB Ahttps://bbs.huaweicloud.com/forum/thread-119437-1-1.html61Gauss DB(DWS)对接系列-BI工具BIP对接https://bbs.huaweicloud.com/forum/thread-109303-1-1.html62跨源访问使用DWS访问存算分离的MRS集群的数据https://bbs.huaweicloud.com/forum/thread-117770-1-1.html63【融合对接】DWS和Hadoop互联互通--读取hdfs数据和将数据写入hdfshttps://bbs.huaweicloud.com/forum/thread-113331-1-1.html64DWS对接DLI Flink实现实时数据接入https://bbs.huaweicloud.com/forum/thread-124688-1-1.html65Gauss DB(DWS) DWS与OBS数据互导https://bbs.huaweicloud.com/forum/thread-119433-1-1.html66实践系列性能优化解决表过多导致的 PGXC_GET_STAT_ALL_TABLES 查询慢问题https://bbs.huaweicloud.com/forum/thread-101196-1-1.html67DWS内存参数调优https://bbs.huaweicloud.com/forum/thread-99652-1-1.html68GaussDB(DWS) 【低效SQL分析案例】https://bbs.huaweicloud.com/forum/thread-131969-1-1.html69GaussDB(DWS)实践系列-行级访问策略优化实践https://bbs.huaweicloud.com/forum/thread-130766-1-1.html70DWS 多表关联创建PCK提升性能https://bbs.huaweicloud.com/forum/thread-119538-1-1.html71GaussDB(DWS)实践系列-性能优化最佳实践https://bbs.huaweicloud.com/forum/thread-118241-1-1.html72DWS 泰山服务器未做配置加固影响性能的问题https://bbs.huaweicloud.com/forum/thread-110780-1-1.html73DWS 参数设置不合理导致作业下盘影响性能的问题https://bbs.huaweicloud.com/forum/thread-110776-1-1.html74DWS 统计信息不准触发nestloop导致查询语句执行缓慢https://bbs.huaweicloud.com/forum/thread-110543-1-1.html75DWS SQL语句中in常量优化https://bbs.huaweicloud.com/forum/thread-110535-1-1.html76DWS 语句中not in触发NestLoop导致SQL执行慢的问题https://bbs.huaweicloud.com/forum/thread-110506-1-1.html77DWS语句不下推问题分析https://bbs.huaweicloud.com/forum/thread-110436-1-1.html78Gauss 子查询性能调优https://bbs.huaweicloud.com/forum/thread-122147-1-1.html79GaussDB 中实现current_user下推的方法https://bbs.huaweicloud.com/forum/thread-122131-1-1.html80应用技巧GaussDB的递归https://bbs.huaweicloud.com/forum/thread-101514-1-1.html81行转列的一个函数https://bbs.huaweicloud.com/forum/thread-100204-1-1.html82通过sql查询获取表字段详细信息https://bbs.huaweicloud.com/forum/thread-133428-1-1.html83通过sql查询快速获取分区表的的分区键https://bbs.huaweicloud.com/forum/thread-133424-1-1.html84处理执行sql文件时,某个sql语句报错,需要继续执行其余sql,直至所有sql执行完毕。https://bbs.huaweicloud.com/forum/thread-132498-1-1.html85GaussDB(DWS) 【查询包含某个字段的所有表清单方法】https://bbs.huaweicloud.com/forum/thread-131778-1-1.html86GaussDB(DWS) 【多值列场景的处理方法】https://bbs.huaweicloud.com/forum/thread-131777-1-1.html87GaussDB(DWS) 【并发测试脚本】https://bbs.huaweicloud.com/forum/thread-131776-1-1.html88GaussDB(DWS) 【常用对象赋权方法】https://bbs.huaweicloud.com/forum/thread-131775-1-1.html89GaussDB(DWS) 【角色权限相关视图使用方法】https://bbs.huaweicloud.com/forum/thread-131774-1-1.html90GaussDB(DWS) 【查询对象所有权限属性的两种方法】https://bbs.huaweicloud.com/forum/thread-131772-1-1.html91GaussDB(DWS)【用SQL方式查询所有带主键的表的主键字段方法】https://bbs.huaweicloud.com/forum/thread-131771-1-1.html92GaussDB(DWS)【通过SQL方式查询分区表的的分区字段方法】https://bbs.huaweicloud.com/forum/thread-131770-1-1.html93GaussDB(DWS)【查找视图依赖的表对象方法】https://bbs.huaweicloud.com/forum/thread-131377-1-1.html94GaussDB(DWS)实践系列-低效业务脚本检测指导https://bbs.huaweicloud.com/forum/thread-151360-1-1.html95GaussDB(DWS)实践系列-函数实现JSON类型解析https://bbs.huaweicloud.com/forum/thread-151349-1-1.html96GaussDB(DWS)实践系列-RoaringBitmap替换方案https://bbs.huaweicloud.com/forum/thread-151119-1-1.html97GaussDB(DWS)实践系列-List行转列函数实现https://bbs.huaweicloud.com/forum/thread-148308-1-1.html98GaussDB(DWS)实践系列-分区表TTL管理实现https://bbs.huaweicloud.com/forum/thread-147907-1-1.html99GaussDB(DWS)实践系列-日常硬件巡检指导https://bbs.huaweicloud.com/forum/thread-146654-1-1.html100【实践系列】GaussDB(DWS)存储过程中实现作业执行过程日志记录方法https://bbs.huaweicloud.com/forum/thread-124684-1-1.html101GaussDB(DWS)倾斜表查询实践https://bbs.huaweicloud.com/forum/thread-127754-1-1.html102DWS 局部聚簇(Partial Cluster Key)选取规则https://bbs.huaweicloud.com/forum/thread-112478-1-1.html103DWS 开发过程中SQL编写建议https://bbs.huaweicloud.com/forum/thread-112471-1-1.html104数据仓库,数据脱敏、and,or,in处置方案https://bbs.huaweicloud.com/forum/thread-99866-1-1.html
-
 openGauss相比于其他开源数据库主要有以下几个主要特点:高性能提供了面向多核架构的并发控制技术结合鲲鹏硬件优化,在两路鲲鹏下TPCC Benchmark达成性能150万tpmc。针对当前硬件多核numa的架构趋势, 在内核关键结构上采用了Numa-Aware的数据结构。提供Sql-bypass智能快速引擎、融合引擎技术。高可用支持主备同步、异步和级联备机多种部署模式。数据页CRC校验,损坏数据页通过备机自动修复。备机并行恢复,10秒内可升主提供服务。高安全支持全密态计算、访问控制、加密认证、数据库审计和动态数据脱敏等安全特性,提供全方位端到端的数据安全保护。易运维基于AI的智能参数调优和索引推荐,提供AI自动参数推荐。慢SQL诊断,多维性能自监控视图,实时掌控系统的性能表现。提供在线自学习的SQL时间预测。全开放采用木兰宽松许可证协议,允许对代码自由修改、使用和引用。数据库内核能力全开放。提供丰富的伙伴认证,培训体系和高校课程。
-
 在开发过程中,开发者常遇到SQL连接数超限、SQL查询时间过长、SQL查询阻塞等问题,您可以通过PG_STAT_ACTIVITY视图来分析和定位SQL问题,以下展示常用的一些定位思路。表1 部分PG_STAT_ACTIVITY字段名称类型描述usenamename登录该后端的用户名。client_addrinet连接到该后端的客户端的IP地址。 如果此字段是null,则表示通过服务器机器上UNIX套接字连接客户端或者这是内部进程,如autovacuum。application_nametext连接到该后端的应用名。statetext后端当前总体状态。可能值是:active:后台正在执行查询。idle:后台正在等待新的客户端命令。idle in transaction:后端在事务中,但事务中没有语句在执行。idle in transaction (aborted):后端在事务中,但事务中有语句执行失败。fastpath function call:后端正在执行一个fast-path函数。disabled:如果后端禁用track_activities,则报告此状态。普通用户只能查看到自己帐户所对应的会话状态。即其他帐户的state信息为空。waitingboolean如果后端当前正等待锁则为true。enqueuetext语句当前排队状态。可能值是:waiting in queue:表示语句在排队中。waiting in global queue:表示语句在全局排队中。waiting in respool queue:表示语句在资源池排队中。waiting in ccn queue:表示作业在CCN排队中。空:表示语句正在运行。pidbigint后端线程ID。查看连接信息通过以下SQL就能确认当前的连接用户、连接地址、连接应用、状态、是否等待锁、排队状态以及线程id。SELECT usename,client_addr,application_name,state,waiting,enqueue,pid FROM PG_STAT_ACTIVITY WHERE DATNAME='数据库名称';回显如下usename | client_addr | application_name | state | waiting | enqueue | pid ---------+---------------+------------------+--------+---------+---------+----------------- leo | 192.168.0.133 | gsql | idle | f | | 139666091022080 dbadmin | 192.168.0.133 | gsql | active | f | | 139666212681472 joe | 192.168.0.133 | | idle | f | | 139665671489280 (3 rows)中止某个会话连接(仅系统管理员有权限)SELECT PG_TERMINATE_BACKEND(pid);查看SQL运行信息获取当前用户执行SQL信息:SELECT usename,state,query FROM PG_STAT_ACTIVITY WHERE DATNAME='数据库名称';回显如下,如果state为active,则query列表示当前执行的SQL语句,其他情况则表示为上一个查询语句。usename | state | query ---------+--------+--------------------------------------------------------------------------- leo | idle | select * from joe.mytable; dbadmin | active | SELECT usename,state,query FROM PG_STAT_ACTIVITY WHERE DATNAME='gaussdb'; joe | idle | GRANT SELECT ON TABLE mytable to leo; (3 rows)查看当前正在运行(非idle)的SQL信息:SELECT datname,usename,query FROM PG_STAT_ACTIVITY WHERE state != 'idle' ;查看耗时较长的语句查看当前运行中的耗时较长的SQL语句SELECT current_timestamp - query_start as runtime, datname, usename, query FROM PG_STAT_ACTIVITY WHERE state != 'idle' order by 1 desc;查询会返回按执行时间长短从大到小排列的查询语句列表。第一条结果就是当前系统中执行时间最长的查询语句。runtime | datname | usename | query -----------------+----------+---------+----------------------------------------------------------------------------------------------------------------------------------------- 00:04:47.054958 | gaussdb | leo | insert into mytable1 select generate_series(1, 10000000); 00:00:01.72789 | gaussdb | dbadmin | SELECT current_timestamp - query_start as runtime, datname, usename, query FROM PG_STAT_ACTIVITY WHERE state != 'idle' order by 1 desc; (2 rows)若当前系统较为繁忙,可以通过限制current_timestamp - query_start大于某一阈值来查看执行时间超过此阈值的查询语句。SELECT query from PG_STAT_ACTIVITY WHERE current_timestamp - query_start > 2;查看处于阻塞状态的语句查看当前处于阻塞状态的查询语句:SELECT pid, datname, usename, state, query FROM PG_STAT_ACTIVITY WHERE state <> 'idle' and waiting=true;执行以下语句结束到阻塞的SQL会话。SELECT PG_TERMINATE_BACKEND(pid);大部分场景下,阻塞是因为系统内部锁而导致的,waiting字段才显示为true,此阻塞可在视图pg_stat_activity中体现。在一些少数场景下,例如写文件、定时器等情况的查询阻塞,不会在视图pg_stat_activity中体现。查看阻塞的查询语句及阻塞查询的表、模式信息SELECT w.query as waiting_query, w.pid as w_pid, w.usename as w_user, l.query as locking_query, l.pid as l_pid, l.usename as l_user, t.schemaname || '.' || t.relname as tablename from pg_stat_activity w join pg_locks l1 on w.pid = l1.pid and not l1.granted join pg_locks l2 on l1.relation = l2.relation and l2.granted join pg_stat_activity l on l2.pid = l.pid join pg_stat_user_tables t on l1.relation = t.relid where w.waiting;该查询返回会话ID、用户信息、查询状态,以及导致阻塞的表、模式信息。查询到阻塞的表及模式信息后请根据会话ID结束会话。SELECT PG_TERMINATE_BACKEND(pid);想要了解更多华为云数据仓库GaussDB(DWS),请猛戳!!!
-
 xMySQL,SQL语句操作查询或者写入的时候,用字符串可以完成,但是用数字的字段提示需要一个数字,不是字符串。报错信息:database.execute [执行sql语句] [NOK] (RobotValueError) exception details: line:200 execute error %d format: a number is required, not str正确sql 语句:select * from test_db.t_rpa where person_count=%s;正确SQL 参数: [11]错误SQL语句:select * from test_db.t_rpa where person_count=%d;正确SQL 参数: [11]原因分析:在普通的数据库操作中,%d表示数字,%s表示字符串;但是对于MySQL比较特殊,这个地方无论什么类型,都需要使用%s。解决方法:将写入或者查询数据库语句的变量在SQL中都使用%s占位。不要使用其他的占位符。
We are WeAutomate
发表于2021-10-26 18:07:32
2021-10-26 18:07:32
最后回复
We are WeAutomate
2021-10-26 18:07:32
1711 0
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签