-
 上期我们介绍了openGauss数据库操作系统参数检查、健康状态检查,本期继续介绍数据库性能检查。3.数据库性能检查3.1 实验介绍3.1.1 关于本实验openGauss 不仅提供了gs_checkperf工具来帮助用户了解openGauss的负载情况。本实验主要是通过gs_checkperf工具来检查openGauss数据库性能以及通过EXPLAIN来进行SQL语句优化。3.1.2 实验目的掌握gs_checkperf工具的基本使用3.2 通过gs_checkperf工具来检查数据库性能说明:gs_checkperf可以对以下级别进行检查:openGauss级别(主机CPU占用率、Gauss CPU占用率、I/O使用情况等)节点级别(CPU使用情况、内存使用情况、I/O使用情况)会话/进程级别(CPU使用情况、内存使用情况、I/O使用情况)SSD性能(写入、读取性能)其中检查SSD性能要用root用户执行,检查openGauss性能要用openGauss安装用户执行本实验为检查openGauss性能。步骤 1 用root用户登录装有openGauss数据库服务的操作系统然后用 su - omm命令切换至omm用户环境,登录后信息如下。Welcome to 4.19.90-2003.4.0.0036.oe1.aarch64 System information as of time: Tue Jul 21 09:21:11 CST 2020 System load: 0.01 Processes: 109 Memory used: 6.7% Swap used: 0.0% Usage On: 15% IP address: 192.168.0.96 Users online: 1 [root@ecs-e1b3 ~]# su - omm Last login: Fri Jul 10 19:05:39 CST 2020 on pts/0 Welcome to 4.19.90-2003.4.0.0036.oe1.aarch64 System information as of time: Tue Jul 21 09:21:25 CST 2020 System load: 0.01 Processes: 111 Memory used: 7.0% Swap used: 0.0% Usage On: 15% IP address: 192.168.0.96 Users online: 1 [omm@ecs-e1b3 ~]$步骤 2 先启动数据库服务,再用gs_checkperf检查下,再使用gsql客户端以管理员用户身份连接postgres数据库,假设端口号为26000。先启动数据库服务。[omm@ecs-e1b3 ~]$ gs_om -t start; Starting cluster. ========================================= ========================================= Successfully started. 用gs_checkperf检查下。 [omm@ecs-e1b3 ~]$ gs_checkperf Cluster statistics information: Host CPU busy time ratio : .72 % MPPDB CPU time % in busy time : .33 % Shared Buffer Hit ratio : 97.33 % In-memory sort ratio : 0 Physical Reads : 466 Physical Writes : 175 DB size : 47 MB Total Physical writes : 175 Active SQL count : 3 Session count : 4确认openGauss数据库服务是否正常。[omm@ecs-e1b3 ~]$ gs_om -t status; ---------------------------------------------------------------------- cluster_state : Unavailable redistributing : No ----------------------------------------------------------------------cluster_state : Normal 表示已启动,可以正常使用。如果状态为Unavailable表示不可用为了实验继续进行,请先启动数据库服务。启动数据库服务(如果数据库服务是正常的,此步骤可以不执行)。[omm@ecs-e1b3 ~]$ gs_om -t start; Starting cluster. ========================================= ========================================= Successfully started.然后连接postgres数据库。[omm@ecs-e1b3 ~]$ gsql -d postgres -p 26000 -r gsql ((openGauss 1.1.0 build 38a9312a) compiled at 2020-05-27 14:57:08 commit 472 last mr 549 ) Non-SSL connection (SSL connection is recommended when requiring high-security) Type "help" for help. postgres=#步骤 3 对PMK模式下的表进行统计信息收集。postgres=# **yze pmk.pmk_configuration; **YZE postgres=# **yze pmk.pmk_meta_data; **YZE postgres=# **yze pmk.pmk_snapshot; **YZE postgres=# **yze pmk.pmk_snapshot_datanode_stat; **YZE postgres=#说明:gs_checkperf工具的监控信息依赖于pmk模式下的表的数据,如果pmk模式下的表未执行**yze操作,则可能导致gs_checkperf工具执行失败。步骤 4 执行简要性能检查。用 \q 先退出postgres数据库,然后在操作系统用户 omm 环境下去执行gs_checkperf检查工具,具体如下:postgres=# postgres=# \q [omm@ecs-e1b3 ~]$ gs_checkperf Cluster statistics information: Host CPU busy time ratio : 1.66 % -----主机CPU占用率 MPPDB CPU time % in busy time : 2.51 % ----Gauss CPU占用率 Shared Buffer Hit ratio : 99.14 % ----共享内存命中率 In-memory sort ratio : 0 ---内存中排序比率 Physical Reads : 504 ---物理读次数 Physical Writes : 162 ---物理写次数 DB size : 57 MB ---DB大小 Total Physical writes : 162 ---总物理写次数 Active SQL count : 4 ---当前SQL执行数 Session count : 5 ---Session数量步骤 5 执行详细性能检查。[omm@ecs-e1b3 ~]$ gs_checkperf --detail Cluster statistics information: Host CPU usage rate: Host total CPU time : 45719980.000 Jiffies Host CPU busy time : 761060.000 Jiffies Host CPU iowait time : 6640.000 Jiffies Host CPU busy time ratio : 1.66 % Host CPU iowait time ratio : .01 % MPPDB CPU usage rate: MPPDB CPU time % in busy time : 5.12 % MPPDB CPU time % in total time : .09 % Shared buffer hit rate: Shared Buffer Reads : 1057 Shared Buffer Hits : 139798 Shared Buffer Hit ratio : 99.25 % In memory sort rate: In-memory sort count : 0 In-disk sort count : 0 In-memory sort ratio : 0 I/O usage: Number of files : 106 Physical Reads : 584 Physical Writes : 362 Read Time : 5794 ms Write Time : 4046 ms Disk usage: DB size : 57 MB Total Physical writes : 362 Average Physical write : 89471.08 Maximum Physical write : 362 Activity statistics: Active SQL count : 4 Session count : 5 Node statistics information: dn_6001: MPPDB CPU Time : 38960 Jiffies Host CPU Busy Time : 761060 Jiffies Host CPU Total Time : 45719980 Jiffies MPPDB CPU Time % in Busy Time : 5.12 % MPPDB CPU Time % in Total Time : .09 % Physical memory : 7144341504 Bytes DB Memory usage : 14922285056 Bytes Shared buffer size : 1073741824 Bytes Shared buffer hit ratio : 99.25 % Sorts in memory : 0 Sorts in disk : 0 In-memory sort ratio : 0 Number of files : 106 Physical Reads : 584 Physical Writes : 362 Read Time : 5794 Write Time : 4046 Session statistics information(Top 10): Session CPU statistics: 1 dn_6001-postgres-omm: Session CPU time : 2 Database CPU time : 39020 Session CPU time % : .01 % …………… Session Memory statistics: 1 dn_6001-postgres-omm: Buffer Reads : 1309 Shared Buffer Hit ratio : 93.03 In Memory sorts : 0 In Disk sorts : 0 In Memory sorts ratio : 0 Total Memory Size : 7433136 Used Memory Size : 6443268 ……………….. Session IO statistics: 1 dn_6001-postgres-omm: Physical Reads : 98 Read Time : 1069 2 dn_6001-postgres-omm: Physical Reads : 13 Read Time : 173 ………......... [omm@ecs-e1b3 ~]$gs_checkperf 检查实验结束。3.3 通过EXPLAIN进行SQL语句优化说明:使用explain能显示SQL语句的执行计划;执行计划将显示SQL语句所引用的表会采用什么样的扫描方式,如:简单的顺序扫描、索引扫描等。如果引用了多个表,执行计划还会显示用到的JOIN算法;执行计划的最关键的部分是语句的预计执行开销,这是计划生成器估算执行该语句将花费多长的时间;若指定了**YZE选项,则该语句模拟执行并形成最优的执行计划(并非真正执行),然后根据实际的运行结果显示统计数据,包括每个计划节点内时间总开销(毫秒为单位)和实际返回的总行数。这对于判断计划生成器的估计是否接近现实非常有用。步骤 1 用root用户登录装有openGauss数据库服务的操作系统然后用 su - omm命令切换至omm用户环境,登录后信息如下。Welcome to 4.19.90-2003.4.0.0036.oe1.aarch64 System information as of time: Tue Jul 21 09:21:11 CST 2020 System load: 0.01 Processes: 109 Memory used: 6.7% Swap used: 0.0% Usage On: 15% IP address: 192.168.0.96 Users online: 1 [root@ecs-e1b3 ~]# su - omm Last login: Fri Jul 10 19:05:39 CST 2020 on pts/0 Welcome to 4.19.90-2003.4.0.0036.oe1.aarch64 System information as of time: Tue Jul 21 09:21:25 CST 2020 System load: 0.01 Processes: 111 Memory used: 7.0% Swap used: 0.0% Usage On: 15% IP address: 192.168.0.96 Users online: 1 [omm@ecs-e1b3 ~]$步骤 2 先启动数据库服务,然后使用gsql客户端以管理员用户身份连接postgres数据库,假设端口号为26000。启动数据库服务。[omm@ecs-e1b3 ~]$ gs_om -t start; Starting cluster. ========================================= ========================================= Successfully started.然后连接postgres数据库。[omm@ecs-e1b3 ~]$ gsql -d postgres -p 26000 -r gsql ((openGauss 1.1.0 build 38a9312a) compiled at 2020-05-27 14:56:08 commit 472 last mr 549 ) Non-SSL connection (SSL connection is recommended when requiring high-security) Type "help" for help. postgres=#步骤 3 创建student表。postgres=# CREATE TABLE student ( std_id INT NOT NULL, std_name VARCHAR(20) NOT NULL, std_** VARCHAR(6), std_birth DATE, std_in DATE NOT NULL, std_address VARCHAR(100) ); CREATE TABLE步骤 4 表数据插入。INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (1,'张一','男','1993-01-01','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (2,'张二','男','1993-01-02','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (3,'张三','男','1993-01-03','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (4,'张四','男','1993-01-04','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (5,'张五','男','1993-01-05','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (6,'张六','男','1993-01-06','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (7,'张七','男','1993-01-07','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (8,'张八','男','1993-01-08','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (9,'张九','男','1993-01-09','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (10,'李一','男','1993-01-10','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (11,'李二','男','1993-01-11','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (12,'李三','男','1993-01-12','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (13,'李四','男','1993-01-13','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (14,'李五','男','1993-01-14','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (15,'李六','男','1993-01-15','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (16,'李七','男','1993-01-16','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (17,'李八','男','1993-01-17','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (18,'李九','男','1993-01-18','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (19,'王一','男','1993-01-19','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (20,'王二','男','1993-01-20','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (21,'王三','男','1993-01-21','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (22,'王四','男','1993-01-22','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (23,'王五','男','1993-01-23','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (24,'王六','男','1993-01-24','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (25,'王七','男','1993-01-25','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (26,'王八','男','1993-01-26','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (27,'王九','男','1993-01-27','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (28,'钱一','男','1993-01-28','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (29,'钱二','男','1993-01-29','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (30,'钱三','男','1993-01-30','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (31,'钱四','男','1993-02-01','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (32,'钱五','男','1993-02-02','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (33,'钱六','男','1993-02-03','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (34,'钱七','男','1993-02-04','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (35,'钱八','男','1993-02-05','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (36,'钱九','男','1993-02-06','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (37,'吴一','男','1993-02-07','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (38,'吴二','男','1993-02-08','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (39,'吴三','男','1993-02-09','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (40,'吴四','男','1993-02-10','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (41,'吴五','男','1993-02-11','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (42,'吴六','男','1993-02-12','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (43,'吴七','男','1993-02-13','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (44,'吴八','男','1993-02-14','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (45,'吴九','男','1993-02-15','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (46,'柳一','男','1993-02-16','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (47,'柳二','男','1993-02-17','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (48,'柳三','男','1993-02-18','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (49,'柳四','男','1993-02-19','2011-09-01','江苏省南京市雨花台区'); INSERT INTO student(std_id,std_name,std_**,std_birth,std_in,std_address) VALUES (50,'柳五','男','1993-02-20','2011-09-01','江苏省南京市雨花台区');步骤 5 数据查询统计。postgres=# select count(*) from student; count ------- 50 (1 row) postgres=# select * from student order by std_id; std_id | std_name | std_** | std_birth | std_in | std_address --------+----------+---------+---------------------+---------------------+---------------------- 1 | 张一 | 男 | 1993-01-01 00:00:00 | 2011-09-01 00:00:00 | 江苏省南京市雨花台区 2 | 张二 | 男 | 1993-01-02 00:00:00 | 2011-09-01 00:00:00 | 江苏省南京市雨花台区 3 | 张三 | 男 | 1993-01-03 00:00:00 | 2011-09-01 00:00:00 | 江苏省南京市雨花台区 4 | 张四 | 男 | 1993-01-04 00:00:00 | 2011-09-01 00:00:00 | 江苏省南京市雨花台区 ……………..步骤 6 查看表信息。postgres=# \d student Table "public.student" Column | Type | Modifiers -------------+--------------------------------+----------- std_id | integer | not null std_name | character varying(20) | not null std_** | character varying(6) | std_birth | timestamp(0) without time zone | std_in | timestamp(0) without time zone | not null std_address | character varying(100) |步骤 7 收集表的统计信息。postgres=# **YZE VERBOSE student; INFO: **yzing "public.student"(dn_6001 pid=48036) INFO: **YZE INFO : "student": scanned 1 of 1 pages, containing 50 live rows and 0 dead rows; 50 rows in sample, 50 estimated total rows(dn_6001 pid=48036) **YZE使用**YZE VERBOSE语句更新统计信息,会同时输出表的相关信息。步骤 8 查看语句的执行计划。postgres=# explain select * from student where std_id=30; QUERY PLAN -------------------------------------------------------- Seq Scan on student (cost=0.00..1.62 rows=1 width=62) Filter: (std_id = 30) (2 rows) Seq Scan on student 表示使用的是全表扫描。步骤 9 给表添加主键。postgres=# alter table student add primary key (std_id); NOTICE: ALTER TABLE / ADD PRIMARY KEY will create implicit index "student_pkey" for table "student" ALTER TABLE步骤 10 再次查看表信息。确定主键是否建好。postgres=# \d student Table "public.student" Column | Type | Modifiers -------------+--------------------------------+----------- std_id | integer | not null std_name | character varying(20) | not null std_** | character varying(6) | std_birth | timestamp(0) without time zone | std_in | timestamp(0) without time zone | not null std_address | character varying(100) | Indexes: "student_pkey" PRIMARY KEY, btree (std_id) TABLESPACE pg_defaultstudent_pkey 为主键名称。步骤 11通过hint来优化语句扫描方式。通过加hint来使查询语句进行索引扫描。postgres=# explain select /*+indexscan(student student_pkey)*/ * from student where std_id=30; QUERY PLAN ---------------------------------------------------------------------- [Bypass] Index Scan using student_pkey on student (cost=0.00..8.27 rows=1 width=62) Index Cond: (std_id = 30) (3 rows) postgres=#Index Scan using student_pkey on student 表示语句通过student表上的主键索引student_pkey进行了索引扫描。步骤 12退出数据库postgres=# \qEXPLAIN进行SQL优化实验结束。
-
 1 Hang问题基础知识GaussDB for DWS 为分布式数据库,通常由于单节点亚健康、系统资源紧张或查询本身的计划等问题,造成系统疑似发生Hang。Hang问题的产生原因由很多种,比如,死锁等待、日志同步等待、事务超时、通信故障、数据溢出发生死循环等等,更为常见的是由于执行慢、中间结果集倾斜而导致的疑似Hang。掌握Hang问题的基本定位方法对于大集群环境下快速找准疑似阻塞点,修复故障环境或优化执行性能是至关重要的。1.1 常用视图目前,GaussDB for DWS对外提供诸多系统视图,可以用来辅助Hang问题的分析定位,常用视图及用法说明如下表所示。(☆代表常用程度) pgxc_stat_activity ☆☆☆查询当前集群所有DN实例上各个session的信息,重点关注正在执行(state状态为active)的SQL。我们一般首先分析pgxc_stat_activity中的内容,初步根据执行时间筛选出疑似query,然后使用此query的query_id和视图pgxc_thread_wait_status结合,获取此query集群级别的线程状态进行hang问题分析。 注:此视图需要以超级用户的身份来运行 在问题分析时,我们首先需要客户反馈的疑似hang的作业的信息,根据作业所在的databse、运行作业的用户身份、运行作业客户端以及运行作业所连接的实例CN名称初步筛选出问题SQL的运行信息,具体运行信息见附件中字段含义解释。比如疑似hang作业是以omm用户运行在postgres数据库连接到cn_5001实例上运行的,我们使用如下SQL进行作业状态查询 我们可以根据上述返回的结果,结合作业运行的客户端名称、客户端ip、作业query运行开始时间query_start进一步筛选出疑似hang作业。 【附:视图各字段含义】字段名称数据类型字段描述coornametext运行业务SQL的CN节点名称datidoid用户会话在后台连接到的数据库OID。datnamename用户会话在后台连接到的数据库名称。可以看到此语句实际在哪个数据库运行,来帮助区分是什么业务。pidbigint后台线程ID。即运行此SQL的线程的线程号,此线程号在pg_thread_wait_status/pg_locks等视图中也存在,可以用这个线程号来与这些视图进行关联。usesysidoid登录该后台的用户OID。usenamename登录该后台的用户名。执行此SQL的用户名,可以用来确认是什么用户调起的业务。application_nametext连接到该后台的应用名。应用名称,一般有三种:l gsql:此SQL是从gsql客户端发起l Data Studio:从Data Studio客户端发起的SQLl cn_50XX:代表从远端CN发送过来的SQL语句,一般出现在DDL、DCL、analyze、vacuum作业场景下l 其它:其它业务客户端发起的业务连接,如果应用程序未显式命名application_name,数据侧一般显式为unkonwnclient_addrinet连接到该后台的客户端的IP地址。 如果此字段是null,它表明通过服务器机器上UNIX套接字连接客户端或者这是内部进程(如autovacuum)。可以用来确定是从哪个机器发起的连接,进而帮助确认是什么业务发起的语句client_hostnametext客户端的主机名,这个字段是通过client_addr的反向DNS查找得到。这个字段只有在启动log_hostname且使用IP连接时才非空。client_portinteger客户端用于与后台通讯的TCP端口号,如果使用Unix套接字,则为-1。通过此字段圈定业务SQL发起客户端backend_starttimestamp with time zone该后台线程启动的时间,即当客户端连接到服务器的时间。xact_starttimestamp with time zone启动当前事务的时间,如果没有事务是活跃的,则为null。如果当前查询是首个事务,则这列等同于query_start列。如果启用了显式事务,即使用begin/start transaction等开启了一个事务,则此字段代表事务开始的时间。query_starttimestamp with time zone开始当前活跃SQL的开始时间, 如果state的值不是active,则这个值是上一个SQL的开始执行时间state_changetimestamp with time zone上次state字段值变化的时间。waitingboolean如果后台当前正等待锁则为true,否则为falseenqueuetext工作负载管理资源状态。· 语句当前的排队情况,包括:· Global::在全局队列中排队。 · Respool:在资源池队列中排队。 · CentralQueue:在中心协调节点(CCN)中排队。 · Transaction:语句处于一个事务块中排队。 · StoredProc : 语句处于一个存储过程中排队。 · None:未在排队。 · Forced None : 事务块语句或存储过程语句由于超出设定的等待时间而强制执行。上面这些状态表明了当前语句的排队情况,如果处在排队状态,语句是不在执行的,也不会占用系统资源。statetext该后台当前总体状态。状态值可能是如下的一种:· active:后台正在执行一个作业。 · idle:后台线程空闲,且不在一个事务块中。 · idle in transaction:后台线程空闲,且在事务块中· idle in transaction (aborted):后台线程空闲,且后台线程在事务块中有语句执行失败且没有执行rollback命令 · fastpath function call:后台正在执行一个fast-path函数。 · disabled:如果后台禁用track_activities,则报告这个状态。resource_poolname用户作业关联的资源池。query_idbigint查询语句的ID。当前语句的唯一标识,可以用此字段与pg_thread_wait_status关联。进一步进行问题分析定位querytext该后台的最新查询。如果state状态是active(活跃的),此字段显示当前正在执行的查询。所有其他情况表示上一个查询。语句默认仅显示1024字节。 pgxc_thread_wait_status ☆☆☆☆☆查询集群全局所有线程的层次调用关系及阻塞等待情况,通常在视图查询语句增加其他过滤条件(比如根据pgxc_stat_activity筛选出来的疑似hang的SQL的query_id),缩小关注排查范围。【附:视图各字段含义】字段名称数据类型字段含义描述node_nametext实例的名称。db_nametext数据库名称。thread_nametext线程名称。query_idbigint业务SQL的ID编号,同一条SQL对应的所有的执行线程的query_id是相同的,与pg_stat_activity中query_id一致tidbigint当前线程的线程号。与pgxc_stat_activity中的pid、pg_locks中的pid一致lwtidinteger当前线程的轻量级线程号。使用此线程号可以在所在节点上进行gstack获取此线程运行栈信息ptidintegerstreaming线程的父线程号tlevelintegerstreaming线程的层级。与执行计划的层级(id)相对应。smpidintegersmp执行模式下并行线程的并行编号。wait_statustext当前线程的等待状态。等待状态的详细信息请参见资料。一般常见的状态有:wait node:dn_xxxx_xxxx:表示在等待某个DNnone:表示正在执行,没有等待任何其他节点acquire lock :表示正在等待锁。这时需要到对应节点上查看pg_locks视图。 pg_thread_wait_status ☆☆☆☆单个实例上所有作业线程的层次调用关系及阻塞等待情况,在大集群复杂query问题定位时,视图pgxc_thread_wait_status返回的信息过多,会对问题定位形成一定干扰,这时可以在CN上通过execute direct on语法获取指定dn实例的作业线程信息。比如要获取dn_6001_dn_6002节点的作业线程调用信息 pgxc_comm_recv_stream ☆☆☆查询集群所有DN的通信库接收流状态,辅助通信层发生收发Hang的排查定位。pgxc_comm_send_stream ☆☆☆查询集群所有DN的通信库发送流状态,与pgxc_comm_recv_stream视图结合使用,来定位通信层的收发Hang问题。pgxc_prepared_xacts ☆☆查询集群中所有节点的启动事务信息,辅助事务超时场景下的Hang问题定位,通过查询该视图获取gxid,然后结合pgxc_xacts_iscommitted(gxid)可以获知事务是否提交。pgxc_running_xacts ☆☆查询集群中所有节点的运行事务信息。pg_locks ☆☆查询当前实例的锁状态,辅助死锁等待的Hang问题定位。名称类型引用描述locktypetext-被锁定对象的类型:relation,extend,page,tuple,transactionid,virtualxid,object,userlock,advisory。databaseoidPG_DATABASE.oid被锁定对象所在数据库的OID。· 如果被锁定的对象是共享对象,则OID为0。 · 如果是一个事务ID,则为NULL。relationoidPG_CLASS.oid表的OID,如果锁定的对象不是表,也不是表的一部分,则为NULL。锁等待一般都是等待表的锁,用relation做条件可以看到当前的表锁被谁持有。pageinteger-关系内部的页面编号,如果对象不是关系页或者不是行页,则为NULL。tuplesmallint-页面里边的行编号,如果对象不是行,则为NULL。virtualxidtext-事务的虚拟ID,如果对象不是一个虚拟事务ID,则为NULL。transactionidxid-事务的ID,如果对象不是一个事务ID,则为NULL。classidoidPG_CLASS.oid包含该对象的系统表的OID,如果对象不是普通的数据库对象,则为NULL。objidoid-对象在其系统表内的OID,如果对象不是普通数据库对象,则为NULL。objsubidsmallint-对于表的一个字段,这是字段编号;对于其他对象类型,这个字段是零;如果这个对象不是普通数据库对象,则为NULL。virtualtransactiontext-持有此锁或者在等待此锁的事务的虚拟ID。pidbigint-持有或者等待这个锁的服务器线程的逻辑ID。如果锁是被一个预备事务持有的,则为NULL。语句pid,可以看到这个pid是在等待哪几各锁,持有哪几各锁。modetext-这个线程持有的或者是期望的锁模式。grantedboolean-· 如果锁是持有锁,则为TRUE。 · 如果锁是等待锁,则为FALSE。表示锁被谁持有fastpathboolean-如果通过fast-path获得锁,则为TRUE;如果通过主要的锁表获得,则为FALSE。 pgxc_node ☆☆查询集群中所有实例节点信息,重点关注节点的node_name, node_port, node_id。除过上述常用视图,Hang问题定位过程需要根据实际场景,结合执行计划、gstack工具、系统日志等共同分析定位。1.2 简单示例比如在执行create table的时候疑似发生hang,那么我们可以执行以下操作定位问题1. 获取疑似hang的SQL的query_idselect * from pgxc_stat_activity where state = ‘active’ and lower(query) like ‘create table %’;2. 获取此作业的线程等待关系select * from pgxc_thread_wait_status where query_id = xx;xx:为上一步获取的疑似hang的SQL的query_id值 分析此query_id相关的线程的状态(字段wait_status),查看是否有acquire lock状态的线程,找到其node_name 和 tid字段3. 到对应的node_name上获取锁信息execute direct on (xx) ‘select * from pg_locks where pid = xxx’;--xx: 上一步获取的node_name字段的值--yy:上一步获取的tid字段值。获取等待加锁的表信息(字段relation)4.到对应的node_name上获取此表的持锁信息execute direct on (xx) ‘select * from pg_locks where relation = yy and granted = true’;--xx: 第二步获取的node_name字段的值--yy: 第三步获取的等待加锁字段的值获取持锁的线程(字段pid)5.获取持锁的作业信息select * from pgxc_stat_activity where pid=xx;--xx: 第四步获取持锁线程信息字段query的内容即为持锁线程信息,也是阻塞create table语句的作业信息 2 Hang问题分类客户侧感知的hang分为三种1. 真实hang一般是轻量级锁缺陷、执行链路环状或者死循环执行。这种场景下作业永远无法执行完2. 执行慢:业务执行慢,远远超出客户的预期,客户侧产生hang的认知效果。这种问题最终需要通过调优解决3. 锁等待:因抢占不到锁资源,导致作业排队等待加锁。这种场景的表现是要么作业执行时间边长,要么等待一段时间(一般为20min)之后报锁超时的失败信息 根据以往的经验,局点常见的hang问题有以下几种3 Hang问题定位方法及解决措施3.1 基本步骤Step1. cm_ctl query查询集群当前状态,确保集群状态正常;Step2. gsql连接数据库,执行select * from pgxc_stat_activity,查询目标查询的query_id,有时候可以增加where state = ‘active’筛选活跃SQL;Step3. 执行select * from pgxc_thread_wait_status where query_id = xxx,查询集群全局与之关联的所有线程的层次调用关系及阻塞等待情况。自上而下,逐层分析,确定疑似阻塞节点及线程信息,甚至,可以绘制线程等待关系图,更加直观地分析当前Hang问题的根因。除此,可结合执行计划或gstack查看线程堆栈,进一步佐证定位结论。Step4. 如果Step3仍无定论,则针对其他常见Hang场景(目前以锁等待和通信收发等待最为常见),结合2.1节相应视图,进一步分析定位:a) 锁等待:从Step3的查询结果分析线程等待关系,如果阻塞线程状态为acquire lock,则进一步执行select * from pg_locks where pid = xxx查询阻塞线程的加锁情况;b) 通信层数据收发成环:从Step3的查询结果分析线程等待关系,如果阻塞线程状态一直为flush data: wait quota,则可能是通信层收发过程hang死,继续执行select * from pgxc_comm_send_stream和select * from pgxc_comm_recv_stream,可以根据Step3的查询结果增加where条件限定node_name、remote_name、query_id、pn_id(即plevel),进一步排查wait quota的根因是否是发送端或接收端数据流异常或者通信问题等。
-
-
 ## 多次计算时的防泄露难题 联邦多方计算场景,一方对于另一方的运行中数据是无法感知的, 通过MPC算法或者TEE安全硬件, 可以保证数据计算过程中的安全性。  但是当计算完成后,得到的结果中却包含了潜在的安全风险。 假设某机构希望从政务数据库中,获取某省市所有市民的税收总和,进行各省市的实力分析和统计。这类计算请求正常来说是合理的,因为做过聚合之后, 各市民的实际税收金额就被合并掩盖了。 ```sql select sum(xxx) from ... ``` 但是当执行第二次统计作业时, 如果机构将交集中的某个人员进行剔除后, 发现税收的总和下降了x元,那么即可马上推断出该人员的税收, 而这个过程对于计算方、数据提供方是无法很好感知的。 ## 华为差分隐私解决方案 针对这种问题, 华为云tics服务联合德国慕尼黑可信技术实验室, 推出了基于多方sql作业的差分隐私算法应用, 对于大规模的聚合类计算,可以实现对内部个体的数据保护。 以下是官方在产品文档里已公布的差分隐私算法应用方式: 1. TICS数据联盟管理者在联盟管理中,选择打开“结果差分隐私”。  2. 联盟中的数据提供方进行数据集发布时,将敏感数值数据勾选为“敏感”的字段分类, 并进行发布。  以下是TICS产品文档中对字段分类的解释 >>* 唯一标识:指用于标识某个事物实体身份的字段。例如身份证、工号、公司代码等。勾选后,会通过一定的语法限制和运行期校验,保护数据集内的id总集,确保无法被恶意逆推。 >>* 敏感:指会参与统计、计算的敏感数据。例如薪水、纳税、用电量。勾选后,其他参与方只能使用敏感进行不可逆推的四则运算、聚合计算(sum/avg)、条件过滤(where)。TICS会保护唯一标识和敏感数据不被成对地明文泄露,**同时会对敏感数据的求和计算添加差分噪声,以保护敏感数据不被泄露**。 >>* 非敏感:指不参与数值分析,也和唯一身份无关的数据。例如等级、公司类型。 3. 发起方执行聚合类型的作业。 以统计各行业税收总和为例,sql可以如下 ```sql Select industry, sum(tax_bal), sum(electric_bal) from 数据提供方.tax a join 作业发起方.power_data b on a.id = b.id group by industry ``` 经过规则校验和审批后, 作业发起方通过平台安全计算,得到了如下的结果:  接着作业发起方再执行一个sql,这个sql中过滤掉了某个id,试图用差值去计算这个个体的税收值。 ```sql Select industry, sum(tax_bal), sum(electric_bal) from 数据提供方.tax a join 作业发起方.power_data b on a.id = b.id where a.id '123400558' group by industry ``` 123400558这个id对应个体属于互联网,实际税收值为274  那让我们看一下发起方第二次执行该作业时,会得到什么结果  **66539.583321490225131 - 66078.857559963717677 = -461** 可以看到并不会像使用者预期的那样得到实际的274差值,而是一个负数,总聚合结果有误差,但在可以接受的范围内。 从上面可以看到,tics成功通过差分隐私算法,保护了大数量统计情况下的个体数据安全。 *** 华为可信智能计算服务 TICS 官网链接: https://www.huaweicloud.com/product/tics.html 欢迎参与最新版的体验。 tics服务交流社区: https://bbs.huaweicloud.com/forum/forum-1348-1.html
-
 墨天轮2019年6月即推出了中国数据库流行度排行,排行榜中的数量也从50增加到194个,每月一日更新,同时发布上月的大事记以及排行榜解读文章,另外我们举办了各种类型与中国数据库相关的活动,见证了中国数据库近三年的蓬勃发展,也为数据库国产化贡献了一份力量。2021年度中国数据库魔力象限墨天轮参考 Gartner 的魔力象限模型,结合墨天轮数据库流行度排行表现,综合得出了2021年度中国数据库魔力象限。魔力象限(Gartner Magic Quadrant)由Gartner于2006年推出,该模型是对某一特定企业级 IT 技术市场的研究总结。墨天轮选取2021年年度平均分排行前40的数据库产品,通过2021年平均分、最新得分、三方评测(TPC-C、TPC-DS、TPC-H、大数据产品能力以及电信行业能力)、生态(社区平台、高校合作、培训认证、开放文档、代码开源、介质下载)以及论文和专利数量综合评定,同时参考了该数据库在 Gartner 全球云数据库魔力象限的表现以及 IDC 全球数据库市场份额报告。最后将数据汇总到两个维度上 — Ability to Execute(执行层面,即当前产品、服务、销售等表现)和 Completeness of Vision (战略层面,即未来愿景的清晰完整性),根据各家供应商们的表现,将其划分入如下四个象限中,分别为:领导者、远见者、挑战者和特定领域者。领导者象限领导者象限代表当前数据库产品及服务能力强,市场销售表现好,客户满意度较高,同时有清晰完整的未来战略。该象限中有7个数据库:● TiDBTiDB 是 PingCAP 公司研发的开源分布式关系型数据库,是一款同时支持在线事务处理与在线分析处理(HTAP)的融合型分布式数据库产品,具备水平扩容或者缩容、金融级高可用、实时 HTAP、云原生的分布式数据库、兼容 MySQL 5.7 协议和 MySQL 生态等重要特性。TiDB技术创新能力处于世界领先水平,每年会进行超过 40% 的代码更新,在GitHub上获得逾3万颗星,已应用于全球超过 2000 家头部企业。● OceanBase蚂蚁集团 OceanBase 连续 8 年稳定支撑双 11,创新推出“三地五中心”城市级容灾新标准,是全球唯一在 TPC-C 和 TPC-H 测试上都刷新了世界纪录的国产原生分布式数据库,具备高可用、高扩展、高兼容、易管理、部署灵活、高性价比等特点,已助力 200+ 行业客户实现核心系统升级。在区域性的银行、保险、证券及基金公司中,OceanBase市场占比达到行业第一。来自非金融类客户的营收占比已达到OceanBase总营收的35%,且在快速增长中。● PolarDB阿里云 PolarDB 是全球范围内业界首个实现了存储、内存及计算三层解耦的云原生数据库,为用户提供具备极致弹性、海量存储、高性能、低成本的数据库服务。PolarDB目前兼容三种数据库引擎:MySQL、PostgreSQL、高度兼容Oracle语法。计算能力最高可扩展至1000核以上,存储容量最高可达 100T。PolarDB已经全面应用于天猫双11的交易、买家、卖家以及物流等系统,刷新了数据库处理峰值记录,高达1.4亿TPS。● 达梦达梦数据库源代码100%自主研发,特别是 DM8,是国内第一款实现数据共享存储集群的数据库,支持超大规模并发事务处理和事务-分析混合型业务处理,动态分配计算资源,降低成本。达梦数据库系列产品及解决方案现已服务于国内外用户数十万家,装机产品累计近百万套,已在金融、电力、民航、通信、审计、公安、铁路、电子政务、应急救援等50多个关乎国计民生的行业领域取得广泛应用。● GaussDB华为 Gauss 数据库是全球首款企业级 AI-Native 分布式数据库,将AI能力植入到数据库内核的架构和算法中,使其具备一定的自运维、自管理、自调优、故障自诊断和自愈的能力。Gauss 数据库异构计算支持X86、ARM、GPU、NPU,支持行存储和列存储,可增加节点实现存储、查询及加载性能的线性扩展,集群最大可扩展至 2048 个节点,支撑 PB 级数据管理能力。GaussDB已在1500+金融政企与泛互联网大客户取得规模商用。● openGaussopenGauss 是华为推出的一款企业级开源关系型数据库。在主备模式下60%满负载故障切换时间10秒以内;利用 AI 进行智能参数调优和索引推荐,可减少 85% 的传统索引,且索引的推荐准确率达 90%;支持全密态计算;结合鲲鹏硬件优化,1000wh数据量可跑到150万tmpC,相对业界主流产品的性能超过50%。openGauss全球下载量超50万,超过2500名开发者参与技术贡献,诸多合作伙伴基于openGauss打造商业发行版。● TDSQLTDSQL 是腾讯云企业级分布式数据库,旗下涵盖金融级分布式、云原生、分析型等多引擎融合的完整数据库产品体系,提供业界领先的金融级高可用、计算存储分离、数据仓库、企业级安全等能力,同时具备智能运维平台、Serverless版本等完善的产品服务体系 。TDSQL已被3000多家来自金融、公共服务和电信垂直行业的客户采用,中国十大银行中的六家都应用了该产品,在金融行业的核心系统国产化替换场景中表现抢眼。挑战者象限挑战者象限代表产品及服务能力较强,经营状况良好,有一定的市场占有率,拥有强大的企业生存能力和财务稳定性,并表现出强大的客户支持。该象限中有2个数据库:● Gbase南大通用 GBase 系列 主要包括分布式分析型数据库 GBase 8a、交易型数据库 GBase 8s、分布式交易型数据库 GBase 8c,以及目录型数据库 GBase 8d。目前已在金融、电信、政企、安全等关键领域得到规模化应用,服务范围覆盖全国 32 个省级行政区域,建立节点超过 30000 个,管理数据总量超过 300PB。● 人大金仓人大金仓 KingbaseES 搭载高内聚、低耦合的可扩展内核架构,支持大数据分析,单机单表支持140TB级大数据量存储;具备自动发现问题、诊断问题、异常发生的自愈以避免业务中断;具有良好的容灾恢复能力,支持双机热备功能。金仓数据库广泛服务于电子政务、国防军工、能源、金融、电信等千行百业,累计装机部署近100万套。远见者象限远见者象限表示数据库市场有着深刻的市场理解和强大的技术路线图,虽然当前的市场份额相对较少,但是作为长期主义者,他们对未来有十足的把握和信心。该象限中有2个数据库:● AnalyticDBAnalyticDB是阿里云自主研发的云原生数据仓库,采用存储计算分离+多副本架构,支持最大5000节点规模的弹性扩容,对复杂SQL查询速度比传统的关系型数据库快10倍以上。AnalyticDB高度兼容MySQL、PostgreSQL,Oracle应用迁移成本低,可对万亿级别的数据进行实时的多维度分析透视,极大地提升了企业挖掘数据价值效率。● SequoiaDBSequoiaDB (巨杉)作为一款金融级分布式数据库,多数据中心间容灾可做到 RPO = 0,RTO < 15秒。SequoiaDB 基于湖仓一体架构,能支撑联机交易和联机分析的场景,支持ACID事务一致性。在面向在线系统提供业务流程中,提供声纹指纹、人脸识别、音视频交互等联机处理的支持;更可以基于AI及机器学习,对非结构化的数据进行治理,实现与其他重要系统的交互。特定领域者象限特定领域者表示通过提供高度专业化的产品在某些场景下有独特的优势,能够高效解决特定问题,如客户明确产品及功能的使用定位,采用特定领域者产品也是一种好的选择。该象限中有8个数据库:● 神舟通用神通数据库是企业级大规模并行处理分布式关系型数据库,具备高兼容、高可靠、高安全、异地容灾等特点。神通数据库获得公安部国家安全四级的高安全等级认证,在长五火箭发射、“天问一号”探火、“天和”核心舱等任务中都有应用。神通数据库不仅成功应用于国防军工、航天等关键行业,也在政府、金融、电信、网安、能源等领域全面开花。● GoldenDB中兴通讯 GoldenDB 是一款具有银行基因的金融级分布式数据库产品,从架构层面保证事务强一致和数据高可靠,并可根据业务需要实现在线扩容,支持金融行业已有业务升级及创新业务快速部署的需求。GoldenDB 产品已覆盖国有大行、股份制银行、农信联社、城商行及农商行全系列银行。● TcaplusDBTcaplusDB 是腾讯专为游戏设计的分布式 NoSQL 数据库。结合内存和 SSD 高速磁盘,针对游戏业务的开发、运营需求,TcaplusDB 支持全区全服、分区分服的业务模式,为游戏业务爆发增长和长尾运维提供不停服扩缩容、自动合服等功能。TcaplusDB已应用于《王者荣耀》、《天涯明月刀手游》、《QQ飞车》等数百款腾讯游戏。● GoldilocksGoldilocks 是科蓝软件拥有完整自主知识产权的分布式内存数据库,具有极强的高并发、高吞吐量、低延时的性能优势,支持在线横向扩展、收缩的能力,能够满足大数据处理的多样化业务需求,适用于金融、电信等对实时性要求较为严格要求的场景。● UXDBUXDB(优炫数据库)具备支持多种数据类型、在线弹性扩容、高可用性、高性能、高安全性、数据即服务等核心能力;可应用于高频联机系统、地理信息、数据仓库、商业智能等多业务场景;产品已完成与多数芯片、操作系统、应用软件厂家适配,支持众多应用软件的稳健运行;满足我国政府、军工、金融、能源、制造、医疗等各行业产业升级需求。● TDengineTDengine 是涛思数据专为物联网、车联网、工业互联网、IT运维等设计和优化的时序数据库。除核心的快10倍以上的时序数据库功能外,还提供缓存、数据订阅、流式计算等功能,最大程度减少研发和运维的复杂度,且核心代码,包括集群功能全部开源。● MogDBMogDB 是云和恩墨基于基于华为openGauss内核推出的企业发行版。相较于MySQL,MogDB主备之间的数据一致性更容易得到保障。同时,MogDB可以提供SQL兼容性分析、性能压测对比分析、极限数据恢复等管理组件,帮助企业级用户方便高效地使用openGauss,减轻运维压力。目前,MogDB已应用在民生银行、哈尔滨银行、渤海财险、合众人寿等多个金融行业客户的核心或关键业务系统上。● EsgynDBEsgynDB(易鲸捷) 是一款企业级融合型分布式数据库。融合OLTP与OLAP能力,支持结构化与非结构化数据统一存储。相较于传统数据库,EsgynDB 的实时分析特性与分布式架构更能支撑5G时代的物联网、人工智能、智能制造、区块链等新兴技术对于实时海量数据的融合管理需求。以上象限仅供参考,具体市场请根据各自项目需求进行选型及测试验证。中国数据库的黄金年代国产化背景从2019年开始,中美贸易战常态化,华为等多家中国企业列入“实体清单”,同时芯片等多项技术及设备被列上“管制清单”,数据库、中间件、操作系统三大基础软件也在“卡脖子”之列,过去一直被美国巨头占据。结合国内数据产业的迅猛发展,数据库作为与之最紧密的软件成为国内企业争相突破的技术,追求自主创新、安全可控。中国数据库主要分为以下三类:以达梦、人大金仓、南大通用、神舟通用四大传统数据库厂商,在政务、能源等行业保持较高的市场占有率;阿里、华为、腾讯、中兴等头部科技企业,首先自有场景的数据库替换,然后通过公有云对外通过提供服务,近几年又从云上数据库并下沉到私有云平台的市场;最后就是PingCAP、易鲸捷、瀚高、巨杉等独立创业公司,通过分布式等技术在金融行业占据了半壁江山。通过数据库发展源流图发现,当前中国数据库多数是从MySQL以及PostgreSQL演讲而来,然后在兼容性、易用性进行了大量改造,同事通过降低国外商业数据库迁移的成本,使得中国数据库慢慢发展起来,开源数据库已经成为中国数据库突破实现突围、发展自主可控产品的主要途径。从2020年6月,华为建立openGauss开源社区,并于2021年3月发布第一个Release版本;2021年5月,阿里云宣布对外开放关系型数据库PolarDB for PostgreSQL源代码,同年6月,蚂蚁集团宣布开源OceanBase。2022年1月11日中国软件行业协会发布《中国软件根技术发展白皮书(基础软件册)》,表明当前国内已经开始着手构建自己的基础软件根技术。同时,我们注意到2020年我国高校和企业在 VLDB、ICDE 和 SIGMOD 数据库三大顶会上贡献占比为23.81%,也反映出目前中国数据库在技术创新上有了不错的成绩。近三年中国数据库大事记2019年-发展元年2019年8月28日,腾讯云一次推出五大数据库新品,包括数据库智能管家DBBrain、云原生数据库CynosDB正式商业化、数据库TBase启动公测、灾备服务DBS启动邀测、Redis混合存储版启动邀测。2019年10月2日,OceanBase打破数据库基准性能测试(TPC-C)的世界纪录,其tpmC值超过6000万,排名第一。2019年10月27日,采用中兴GoldenDB的中信银行信用卡中心核心业务系统上线运行。2020年-百家争鸣2020年6月30日,华为openGauss终于正式亮相,源代码开放、社区成立。2020年10月19日,易鲸捷数据库4.2亿中标贵阳银行核心业务系统中国数据库应用项目,创造了中国数据库的单一采购项目记录。2020年11月17日,PingCAP 完成 D 轮 2.7 亿美元融资,创造全球数据库历史新的里程碑。2021年-百花齐放2021年2月24日,华为云正式发布云数据库GaussDB(for openGauss)全网商用。2021年6月1日,蚂蚁集团自研数据库OceanBase宣布开源,开放近300万行源代码。2021年12月17日,Gartner 2021 云数据库管理系统魔力象限已经出炉。阿里云再次进入领导者象限,华为云进入特定领域者象限(NICHE PLAYERS),是国内入选的仅有两家企业。资本不断注入2019年开始资本大量进入中国数据库行业,其中2021年更是井喷式爆发,融资次数达到了20多次,融资额度超过30亿人民币。时间公司名称轮次金额2021年12月16日人大金仓战略融资近2亿人民币2021年12月9日智臾科技B轮1亿人民币2021年12月6日创邻科技A++轮过亿人民币2021年11月29日四维纵横A轮1亿元2021年11月19日拜贝思云计算科技天使轮300万美元2021年9月28日聚云位智B轮近亿人民币2021年8月25日偶数科技B+轮2亿人民币2021年7月20日PingCAPE轮数亿美元2021年7月12日睿帆科技A轮5000万人民币2021年7月8日人大金仓战略融资近亿人民币2021年6月22日中科知道天使轮1200万人民币2020年6月17日聚云位智A+轮未披露2021年5月24日涛思数据B轮4700万美元2021年5月9日易鲸捷战略投资5769万人民币2021年3月16日青云科技IPO上市7.644亿人民币2021年2月26日天云融创战略投资未披露2021年2月10日爱可生B轮近亿人民币2021年2月1日创邻科技A+轮数千万人民币2021年1月21日新炬网络IPO上市5.59亿人民币2021年1月18日智臾科技A轮数千万人民币数据库相关的上市公司有:优炫软件、科蓝软件、海量数据、东方国信、创意信息、金山云、青云科技,另外据悉有几家数据库厂商正处于上市前冲刺阶段。基础软件的投入成本和研发周期都非常长,在资本注入后,其中大部分都投入到研发中,只有数据库产品稳定、高效、安全,同时方便迁移和管理,替换原有市场也就变得非常容易,那么国内新增市场也就自然会优先采购中国数据库。政策持续利好当前中国数据库应用主要集中在金融、电信、政务、制造、互联网等行业,这离不开国家各种政策的引导,尤其是金融行业,人民银行等机构多次发文要求核心场景技术和产品自主可控,同时由于金融行业的高要求,也成了中国数据库的试炼场,经过近几年的高速发展和场景磨炼,已经有了非常成熟的金融行业案例。2021年12月12日,为应对新形势新挑战,把握数字化发展新机遇,拓展经济发展新空间,推动我国数字经济健康发展,依据《中华人民共和国国民经济和社会发展第十四个五年规划和2035年远景目标纲要》,支持具有自主核心技术的开源社区、开源平台、开源项目发展,推动创新资源共建共享,促进创新模式开放化演进。2022年1月16日出版的第2期《求是》杂志发表中共中央总书记的重要文章《不断做强做优做大我国数字经济》。文章指出要全面推进产业化、规模化应用,培育具有国际影响力的大型软件企业,重点突破关键软件,推动软件产业做大做强,提升关键软件技术创新和供给能力。市场足够大据IDC预测,2021全年中国关系型数据库软件市场规模为27.5亿美元,到2025年将达到76.7亿美元,未来5年市场年复合增长率(CAGR)为30.4%。据信通院预测,中国数据库市场总规模将达到688亿元,市场年复合增长率(CAGR)为23.4%,假如出现传统头部企业占据70%的市场,那就是480亿的营收。以上两个预测数据库行业市场规模年复合增长率都超过20%,属于高新赛道,一定会有更多的“玩家”加入,让技术、产品、生态、服务等都会得到快速发展。中国数据库未来发展趋势数据库私有云平台Gartner预测到2023年,全球数据库市场中75%的数据库将完成到云平台的迁移,公有云数据库的增速也将放缓,而下一个争夺的市场主要为数据库私有云平台,以云的方式部署在客户私有环境中,这样既享受了云的便捷,也打消了对公有云数据安全、可靠性等疑虑。开源生态建设2021年1月至今,在 DB-Engines 上开源数据库流行度超过商业数据库,开源生态建设既是帮助企业商业布局的利器,也是促进技术发展和推广的重要手段,国内以PingCAP、openGauss等数据库为例,通过开源生态的建设,大大提升了品牌的影响力,未来阿里、腾讯等越来越多的厂商会加大开源生态的建设。分布式分布式数据库成为解决传统数据库瓶颈的主要手段。分布式数据库可以帮助企业应对海量数据和高增长的问题,在数据增大时可以平滑的水平扩展,解决了过去系统数据增大时需要人工进行分库分表的复杂和高风险的工作。HTAPHTAP数据库即需要同时支持OLTP和OLAP场景,在报表实时性要求不断提升,HTAP数据库通过对计算、存储架构的调整省去数据同步的过程,在同一套数据库中完成交易和报表的请求。AI随着数据量的不断暴增,减轻人力维护成本以及避免故障,通过引入AI,让数据库自动驾驶,如自动调优、自诊断、自愈、自组装等,最终实现对管理员透明,只需提供简单API即可,在保证稳定和性能的情况下,让易用性达到极致。文章来源:https://www.modb.pro/db/240097
-
分类问题链接开发应用DataWarehouseServiceDWS管控面信息咨询https://bbs.huaweicloud.com/forum/thread-139300-1-1.htmlGaussDBA集群的license容量如果已满,对集群正常使用有哪些影响?https://bbs.huaweicloud.com/forum/thread-140004-1-1.htmlGaussDB(DWS)8.1.1集群从8.0升级到8.1.1后部分参数变化咨询https://bbs.huaweicloud.com/forum/thread-153723-1-1.html【高斯产品】【逻辑集群功能】逻辑集群之间的访问是如何的,重分布又是如何做的?https://bbs.huaweicloud.com/forum/thread-127448-1-1.htmlGaussBDA8.0.0.0GaussBD集群是否支持内存列式存储https://bbs.huaweicloud.com/forum/thread-106210-1-1.html【GaussDB逻辑集群】【功能】逻辑集群的最终目的是?https://bbs.huaweicloud.com/forum/thread-110577-1-1.htmlgaussdb8.0.0.1里面有没有对比两个表数据是否相同的函数或方法https://bbs.huaweicloud.com/forum/thread-162177-1-1.html【DWS产品】DWS查询DN上残留的会话显示业务SQL运行了7849days(21年)https://bbs.huaweicloud.com/forum/thread-142870-1-1.html【DWS产品】【限流】statement_timeout限制的语句包含idleintransaction状态的SQL?https://bbs.huaweicloud.com/forum/thread-155574-1-1.html【DWS产品】【负载管理功能】CCN是如何知道SQL是复杂作业还是简单作业?https://bbs.huaweicloud.com/forum/thread-133275-1-1.html性能调优【DWS产品】TOPSQL过程pg_catalog.pgxc_get_wlm_session_info_bytime查询慢问题https://bbs.huaweicloud.com/forum/thread-166410-1-1.htmlgaussDBrow_numberWindowAgg算子不下推,导致性能非常差,如何解决?https://bbs.huaweicloud.com/forum/thread-167610-1-1.html【DWS产品】【重分布功能】DWS集群中因Stream导致数据移动是否通过内部专用网络而非业务网?https://bbs.huaweicloud.com/forum/thread-123298-1-1.htmlcreatetableasselect语句导致数据倾斜https://bbs.huaweicloud.com/forum/thread-128394-1-1.htmlGaussDBA使用roach备份恢复性能调优,roach命令buffer-block-size应如何使用呢?https://bbs.huaweicloud.com/forum/thread-129660-1-1.html【GaussDB产品】【执行计划】关于执行计划顺序问题https://bbs.huaweicloud.com/forum/thread-112180-1-1.html【GaussDB产品】【更新功能】百万级数据与亿级别数据更新https://bbs.huaweicloud.com/forum/thread-112501-1-1.htmlTPC-DS并行执行调优https://bbs.huaweicloud.com/forum/thread-101855-1-1.html【DWS产品】【重分布功能】DWS集群中因Stream导致数据移动是否通过内部专用网络而非业务网?https://bbs.huaweicloud.com/forum/thread-123298-1-1.html运维管理GaussDBA8.0.0.1版本集群是否有方式或方法可以判断笛卡尔积sql?https://bbs.huaweicloud.com/forum/thread-140515-1-1.html【DWS产品】【GS_CLEAN功能】CN中会话已断开但DN中仍然存在的问题如何有效规避?https://bbs.huaweicloud.com/forum/thread-135481-1-1.htmlsession_timeout杀掉空闲连接调用的是哪个语句https://bbs.huaweicloud.com/forum/thread-133684-1-1.html【GaussdbA】表是支持创建离散Partitionhttps://bbs.huaweicloud.com/forum/thread-126346-1-1.html【高斯产品】【列存储功能】重分布(Redistribute)的时候内存中是行存还是列存?https://bbs.huaweicloud.com/forum/thread-127498-1-1.htmlpg_hba.conf文件怎么配置一段iphttps://bbs.huaweicloud.com/forum/thread-101332-1-1.htmlSQLmysql迁移到gaussdb语法咨询https://bbs.huaweicloud.com/forum/thread-133328-1-1.html执行sql报错https://bbs.huaweicloud.com/forum/thread-137366-1-1.html【GaussDB产品】【SQL语句兼容性】是否支持createtableasselectorderby语句https://bbs.huaweicloud.com/forum/thread-123446-1-1.htmlGaussDB(DWS)在建表中分区键varchar字段怎么实现自动分区https://bbs.huaweicloud.com/forum/thread-114963-1-1.html数据迁移工具DSC问题https://bbs.huaweicloud.com/forum/thread-101519-1-1.html【SQL优化器功能】CBO选择不同join方式的算法是什么https://bbs.huaweicloud.com/forum/thread-101633-1-1.html环境搭建求救!GaussDB200单机部署使用fusioninsightmanager搭建集群时找不到主机https://bbs.huaweicloud.com/forum/thread-130139-1-1.html【GaussDB产品】【添加CN功能】GaussDBcn实例添加逻辑https://bbs.huaweicloud.com/forum/thread-110758-1-1.html【GaussDB200产品】【LLD规划配置功能】LLD配置规划工具-集群参数配置CMS和GTM互为主备的要求问题https://bbs.huaweicloud.com/forum/thread-113220-1-1.html【GaussDB200产品】【搭建功能】集群安装最小内存、cpu、硬盘要求https://bbs.huaweicloud.com/forum/thread-113869-1-1.html其他问题【DWS产品】【TIMEZone参数】线下GuassDB和云上DWS为什么要设置不同默认timezone?https://bbs.huaweicloud.com/forum/thread-131373-1-1.html【DWS8.0.1产品】DWS的元数据怎么存放,数据存储到硬盘上怎么存放https://bbs.huaweicloud.com/forum/thread-113234-1-1.html比如限制一个用户只能看表的前十行结果,该用户select*就只能查询出十条。可以实现么https://bbs.huaweicloud.com/forum/thread-122237-1-1.html【GaussDB200产品】【负载均衡功能】GaussDB200cn节点是否支持F5做负载均衡https://bbs.huaweicloud.com/forum/thread-103819-1-1.html【GaussDB(DWS)】explainperformance下盘相关名词具体意思https://bbs.huaweicloud.com/forum/thread-107681-1-1.html【GaussDBA产品】【数据实时同步功能】Oracle数据库与GaussDB200的实时同步问题https://bbs.huaweicloud.com/forum/thread-107695-1-1.htmlGaussDB产品】【SQL语句兼容性】是否支持createtableasselectorderby语句https://bbs.huaweicloud.com/forum/thread-123446-1-1.html
-
 2021年9月2日上午10:00,举行华为云AI论文精读会2021第十五期:M-SQL一种将自然语言转换为SQL语句的多任务表示学习方法。本期邀请到的嘉宾是:潘名扬,哈尔滨工业大学社会计算与信息检索研究中心研究生,研究方向为自然语言处理、Text to SQL。本次论文精读的领域是NLP领域,感兴趣的小伙伴点击下方的链接一起观看学习吧~华为云AI论文精读会致力于让更多人低门槛使用经典算法,助力AI开发者基于ModelArts,实现高效率论文复现和挑战!本期视频:https://res-static.hc-cdn.cn/cloudbu-site/china/zh-cn/competition/1630461308414000818.mp4算法链接:https://marketplace.huaweicloud.com/markets/aihub/modelhub/detail/?id=4d1c0887-8ef0-4133-bd02-c4d69255377a华为云AI论文精读会2021·论文算法实战赛报名地址:https://competition.huaweicloud.com/information/1000041393/introduction
-
互联网红利不再,相比 2010 年,现在的市场上显得太过平静,已经太久没有出现关于『风口』的故事。但在表面的岁月静好之下,却是底层的暗流涌动。其中,数据库就是『底层暗流涌动』的典型场景之一,作为支撑数字经济的最关键基础设施,这两年数据库市场中一直都在上演着一浪高过一浪的竞争。在亚马逊公司看来,数据库也被他们视作为下一个战场。“The real battle will be in databases”,2016 年,外媒在讲述亚马逊公司积极努力用自研数据库产品取代 Oracle 曾如此写道。一、数据库行业迈入深水区据信通院统计,2020 年,全球数据库市场规模达到 671 亿美元,中国数据库市场规模约为 240.9 亿元,占比约 5.2%,市场空间广阔。预期到 2025 年市场规模达 688 亿元人民币,年复合增长率 24.3%。其中,国产数据库厂商的市场份额有进一步提升的趋势。国产数据库市场的形式似乎一片大好。伴随数字化转型步入“深水区”,企业的业务需求迭代迅速,数据量和并发访问量呈指数级增长,传统关系型数据库遇到捉襟见肘的扩展能力、大数据处理性能低等挑战。数据对于企业的重要性越来越高,企业对于以数据库为核心的专业服务需求也愈发迫切。另外,在移动互联网迅速席卷全国各个领域以及开源产业的发展,直播带货等新应用场景不断涌现,既需要处理联机交易,又要对客户数据进行实时画像,还要求数据库在双十一支持快速扩缩容等云原生特性,企业翘首以待新型数据库来满足不同的数据场景应用需求。 数据库行业下的『绿林军』,正一步步通过市场上的表现被转化为『正规军』。其中不乏深耕国产数据库多年的传统数据库厂商,也不乏出生在云上的云原生数据库,更有专注于业务敏捷的分布式数据库、图数据库、时序数据库….数据库在传统关系型流派的基础上迅速裂变,进入百花齐放、百家争鸣的时代。而国产数据库,正是处于这一『漩涡』之中。 可以说,在光鲜亮丽的中国互联网背后,正是一个个底层数据库支撑起了这一组繁荣。 但光鲜的表面,却遮盖不住底层日趋复杂、低效的问题。在一个个专业化的数据库细分服务领域下,即便用户对于数据库的可选择性越来越高,但各个场景之间的壁垒、管理,却出现了一些难题。因为不同类型的数据库在能力层面上,都存在着不同的限制与不足。业务层面上看,传统关系型数据库在面对企业业务数据量激增情况下存在水平扩展问题,而 NOSQL 非关系型数据库无法处理交易类数据及复杂的业务逻辑。技术角度看,一方面数据应用的变化倒逼数据库具备更大数据存储容量、更多数据计算模型、更快数据业务响应能力,整体技术发展进入后关系型阶段,架构设计逐渐分布式化、模型构建逐渐场景化。另一方面,人工智能、新型硬件、区块链等关联技术的创新正在催生新型数据库设计模式,传统数据库功能边界正被逐渐突破。也正因如此,由于企业数据库技术体系庞杂,各个数据库之间间隙明显,管理困难,尤其是数据库在企业中的角色向来都是成本中心,控制成本、提高效能,是企业对底层数据库的长期不变的诉求。因此在多方位的作用下,企业需要服务提供商能够提供横向主流数据库产品和纵向多版本技术服务覆盖能力,以面对来自无感解决用户侧多元化需求以及抽离行业侧共性问题并形成解决方案的诉求。 在此情况下,对于数据的利用和底层架构的转型,就显得尤为迫切。想办法提升数据库的灵活性与扩展性,打造组件化数据库,或许是一种可行的方式。 二、数据的核心是连接:以 Database Plus 的形式在数据库之上构建全新的连接关系 Database Plus,一种分布式数据库系统的设计理念。通过在碎片化的同构或异构数据库之上搭建使用和交互的标准层和生态层,叠加扩展更多计算能力,使得所有应用和数据库之间的交互面向 Database Plus 构建的标准层,从而屏蔽数据库碎片化对上层业务带来的差异化影响。 近年来,『去 O』已经成为许多企业衡量自身后台架构演进进程的一条重要指标。究其本质,这是在有意减少对于某种商业数据库的依赖。但从另一个角度看,被替代的数据库可以是 Oracle,自然也可以是其它另一款商业数据库。追求多元化、『因地制宜』发挥数据库最大效能,以便于企业在未来底层数据库的选择中能够拥有更大的自由度。 但是这种改变并非只是字面意义上的变更,更在于变更数据库之后所带来的短时间内一系列成本的上升,迁移成本、时间成本、学习成本等等,企业在转型过程中往往会带来更大的阵痛感。为降低这种阵痛感,如果不对数据库本身做变更,而是在其上层提供额外增值服务,也许就会实现传统关系型数据库向云、实时计算等场景的平稳过渡。 (1)铸造 Database Plus 生态 基于此,Apache ShardingSphere 于业界首次提出了 Database Plus 理念,标志着 ApacheShardingSphere 不满足于自身数据库中间件工具型的定位,开始向着平台和生态去转型。DatabasePlus 理念的践行,使 Apache ShardingSphere 不但屏蔽了各个数据库之间的底层细节,也弥补了分布式数据库各分片之间的差异。具体来看,通过对数据库协议、SQL 方言以及数据库存储的灵活适配,快速连接应用与异构数据库,让开发者最终无需关注SQL 方言的差异化,专注业务研发。 Apache ShardingSphere 在这层数据库的生态之上,通过将数据库作为最终的存储节点,在接入端满足各种各样的数据库协议、SQL 方言以及数据库落盘对接等,进而在这层存储节点之上面向数据库应用架构提供各类增量能力。因此,用户可以将 Database Plus 视作一个“数据库网关”,可获取数据库的访问流量,提供流量重定向(数据分片、读写分离、影子库)、流量变形(数据加密、数据脱敏)、流量鉴权(安全、审计、权限)、流量治理(熔断、限流)以及流量分析(服务质量分析、可观察性)等透明化功能,这些增强功能使得ShardingSphere 成了数据库产品的最强伴侣,用户无需为如何统一管理各个数据库而发愁,主流的鉴权、治理功能完成都可通过 DistSQL 这一 SQL 标准的扩展来完成。 (2)灵活的部署模式 随着分布式数据库在近些年来的逐步成熟,其天然具备 Proxy 一层。不过由于支持异构语言的 Proxy 模式被一再证明性能瓶颈之后,基于特定开发语言的 Proxyless 模式重新回到了工程师的视野之中。无侵入的异构语言友好性,和针对于特定语言的高性能的权衡,成为了分布式数据库架构选型的核心问题之一。 Apache ShardingSphere作为一款由多接入端共同组成的生态圈,通过混合使用 ShardingSphere-JDBC (Proxyless 模式) 和 ShardingSphere-Proxy (Proxy 模式) 这两种部署模式,用户可以在 Apache ShardingSphere 生态内采用同一治理中心统一配置分片策略,进而能够灵活搭建适用于各种场景的应用系统,使得架构师能够更加自由地调整适合于当前业务的最佳系统架构。 三、生态的核心是包容:需要一个更包容、更开放的生态 一场自我颠覆式的代码重构,一场直达终端工程师体验的广义『再造』,一个深耕场景的数据时代。 在 Database Plus 理念的加持下,Apache ShardingSphere 进行了大胆的革新,重构了过去原有的技术架构,开始向着可插拔生态迈进。前段时间 Apache ShardingSphere 5.0.0 版本正式上线,正式开启了以可插拔架构为核心的全新阶段,实现了由过去数据分片单一应用场景到现在复杂应用环境下综合数据治理的身份转变与能力提升。在新版本下,Apache ShardingSphere 具备了更多新特性,并拥有了更加成熟的数据解决方案。 随着本次更新对可插拔架构体系的完善,标志着 ApacheShardingSphere 在分布式数据库生态领域的探索进入到一个全新阶段。以可插拔架构开路,以DistSQL 架桥,Apache ShardingSphere 正在面向开发者打造一个更加包容、更加开放的 Database Plus 数据应用新生态。 (1)可插拔架构 放开限制,给用户更多的选择和自由。 作为 Database Plus 生态的重要组成部分,Apache ShardingSphere 可插拔架构通过追求各个模块之间相互独立和互无感知,凭借高灵活度、可插拔及可扩展的内核,以叠加的方式将各种功能组合使用。目前,Apache ShardingSphere 已支持数据分片、读写分离、数据加密、影子库、数据库发现等功能通过插件的方式植入,进一步提升了对于 SQL 方言的支持度。 诚如上文所言,越来越多的细分业务领域,让不同数据库之间逐渐产生了『隔膜』。随着 Apache ShardingSphere 在 5.0.0 正式版中逐渐完成对于内核层、功能层与生态层这三层可插拔架构的构建,最终呈现出松耦合结构的状态,在数据库与业务之间形成一层中间可插拔的灵活架构,使所有功能都能够被叠加使用,用户可根据自身需要来自定义这层可插拔架构以及数据库服务。 (2)DistSQL:赋能技术人员,就是在赋能业务与数据库 ApacheShardingSphere 在标准 SQL 能力之外提供了一套分布式 SQL,用户可以像使用数据库一样使用标准的 SQL 来管理分布式数据库服务。 作为 Apache ShardingSphere 在分布式架构体系下的重要支撑部分,DistSQL 在传统数据库上层构建,让开发者在实际应用中能够以标准的 SQL 来管理分布式数据库服务,打破中间件与数据库之间的界限,从而将分布式数据库各分片之间的鸿沟给填平。 为改善 Apache ShardingSphere 配置复杂、操作繁琐的问题,DistSQL 以自身独特的语言特性,在数据库之上提供统一的资源和规则定义语言,进而降低用户使用 Apache ShardingSphere 面向繁琐配置的操作门槛。不夸张的说,DistSQL已经成为 Apache ShardingSphere 从面向开发人员的框架和中间件转变为面向运维人员的基础设施产品不可或缺的能力。 (3)活跃的开源社区:项目生存与发展的基石在 2021 年 Apache 基金会年度报告中,Apache ShardingSphere 的代码提交数量位列前十,占整个基金会代码提交数量的 1.6%;从2021年 1 月 1 号的 208 名贡献者,到 2022 年 1 月 1 号的 340 名贡献者,一年内增加了 100+ 贡献者;Apache ShardingSphere 社区举办了首届线上 Meetup,吸引了近万名开发者观看线上直播;Apache ShradingSphere 海外声音渐多,案例被 MySQL 官方收录; ……一系列的数字和案例场景表明,Apache ShardingSphere 正在被推向更广的应用平台以及更深的技术场景,且已经成为了国内开源社区的靶心,吸纳了大量开源爱好者的参与和贡献。如此一来,Apache ShardingSphere 基于 Database Plus 理念,形成了自己独立的可插拔功能性基座,成了新时代灵活的“数据库操作系统”,通过自研标准化的 DistSQL 交互语言,在数据库上层构建起了能够从容应对 SQL 创建、修改、删除分布式数据库表、加密数据库表及提供分布式调度管理能力等管控平台。 另外,Apache ShardingSphere 通过统一的上层接口,让用户对接 MySQL、PostgreSQL、Oracle、SQL Server 等各类型数据库,并提供接口让开发者自主拓展开发,通过可插拔体系帮助大家建立分片、加密、迁移、治理、影子库、读写分离、高可用及不断增强的数据能力,借助数据库与应用之间的这个缓冲带,“搭个台子”帮助业界以最低成本打造一个良好的数据库生态。 四、业务的核心是场景:这是一个深入云上的业务数据时代 随着业务场景的演变,数据库架构也在不断地演进。从单节点架构到共享存储架构,再到分布式数据库、云原生数据库等,一个让人关注的变革已然发生:在数字化时代,数据的产生速度极快,存在不均衡现象,不上云的传统数据库越来越难以适应新的场景。根据权威咨询机构 IDC 预测,到 2022 年,75%的数据库将被部署或迁移至云平台。 在产业数字化转型时代下,技术架构向云原生演进是不可逆的时代潮流,但从目前的进展来看,大多数互联网巨头的应用层基本都已经完成了微服务或者服务网络的改造,但是数据面却还处在相当碎片化的情况。 因此,Apache ShardingSphere 背后的商业化公司 SphereEx 推出 SphereEx Mesh 概念。在 Database Plus 的基础上,让用户定制化自身数据库运行所需要的最小运行环境,从而利用 Mesh 的设计思想构建有弹性可扩展的数据库集群,为用户提供便捷的数据应用连接服务,帮助用户更好地释放云上数据价值。 近日,SphereEx CTO 潘娟荣获“AWS Hero”称号,这是亚洲地区在数据库领域屈指可数的获奖者,SphereEx 云上理念得到了 AWS 的认可。据了解,未来 SphereEx 将会和亚马逊云科技保持紧密的合作关系,共同为 Apache ShardingSphere 打造公有云上的部署形式,为用户提供更加强大的公有云能力,为企业应用打造更加成熟的云上环境,帮助企业在下一代云上“数据库之战”中抢占先机。 五、持续做有价值的事 任何一家创业公司,所面对行业一定是要有改变的内驱力,所研发的产品一定要兼具实用性和趋势性,在数据库领域下尤为如此。随着数据库行业的发展,其正逐渐成为当下数字时代的中坚力量。毫无疑问,Apache ShardingSphere 和它背后的创业公司 SphereEx 目前在走的是一条创新的路、艰难的路。但越难,这件事情的门槛就越高,在生存下来之后距离突破和爆发的临界点就越近。 目前,以开源项目 ApacheShardingSphere 为基础的商业化公司 SphereEx,在商业化的道路上动作频频。1 月 4 日,SphereEx 宣布完成近千万美元的 Pre-A 轮融资,在公司成立半年的时间内快速完成两轮融资,足以见到资本对数据库赛道、对 ShardingSphere 社区以及 SphereEx 商业化道路的认可。 同时,SphereEx 已经开始迈出了商业化的第一步。为进一步降低 Apache ShardingSphere 在部署方面的复杂性,SphereEx 针对性研发了一款用于一键部署及管理 ShardingSphere-Proxy 集群的命令行工具--SphereEx Boot,并已于日前发布。此次 SphereEx-Boot V0.1.0 版本发布,既是 SphereEx 对 Apache ShardingSphere 周边生态的补充,也是对 SphereEx商业化布局的一次初步验证和探索。 在数据库的市场下,每一个场景和每一位工程师都在诱惑着数据库厂商加速迭代变化,SphereEx 和 Apache ShardingSphere 正走在这样的路上。面对来自业务场景及工程师的双重推动,在数据库上层构建一套完整的数据治理生态,并以这层生态为踏板,实现传统关系型数据库向数字化新需求的平稳过渡,相信将是未来企业转型以及实现数字化的一条『必经之路』。 文章来源:CSDN
-
 漏洞名称 : WordPress SQL注入漏洞组件名称 : WordPress影响范围:3.7.37<= WordPress <=5.8.2漏洞类型:SQL注入利用条件:1、用户认证:不需要用户认证2、前置条件:非默认配置3、触发方式:远程综合评价:<综合评定利用难度>:未知。<综合评定威胁等级>:高危,能造成 SQL 注入。漏洞分析:1、组件介绍WordPress 是基于 PHP 语言开发的博客平台,可以用于在支持 PHP 和 MySQL 数据库的服务器上架设网站,也可当做一个内容管理系统(CMS)。2、漏洞描述近日,监测到一则 WordPress 组件存在 SQL 注入漏洞的信息,漏洞编号:CVE-2022-21661,漏洞威胁等级:高危。该漏洞是由于 WP_Query 类中存在特定缺陷,攻击者可利用该漏洞在未授权的情况下,构造恶意数据执行 SQL 注入攻击,最终造成服务器敏感性信息泄露等。影响范围:全球有数百万 WordPress 资产,可能受漏洞影响的资产广泛分布于世界各地,主要集中在美国、德国、法国等国家。目前受影响的 WordPress 版本: 3.7.37<= WordPress <=5.8.2解决方案:1、如何检测组件版本登陆进入控制台,在控制台首页的概述中可查看到 Wordpress 版本。2、官方修复建议当前官方已发布最新版本,建议受影响的用户及时更新升级到最新版本。链接如下:https://wordpress.org/download/参考链接:https://wordpress.org/news/2022/01/wordpress-5-8-3-security-release/
-
【功能模块】【操作步骤&问题现象】在Teradata中,可以使用with来达到小计的效果,示例SELECT Last_Name ,First_Name ,Dept_no ,SalaryFROM Employee_tableWITH SUM(Salary);结果在高斯里面如何达到同样的效果?【截图信息】【日志信息】(可选,上传日志内容或者附件)
-
奎钩粲粲光华动,群玉森森气象新。国产数据库行业在经历了2021年的躬行实践之后,产品、服务、生态等取得了蓬勃发展。从2022年1月份的国产数据库流行度排行榜上,我们可以看到,相较于去年12月份,榜单上又增加了新成员。目前,共有194家数据库参与排名。排行榜前十五名的数据库中,80%的产品流行度分数实现上涨,但总体排名未发生变化。下面,我们来看看各数据库产品分数的具体涨跌情况。2022年1月排行榜Top15PingCAP的TiDB依然稳居榜首。1月份,TiDB分数略微下跌7.57,总分611.97。相较于去年1月份,总分上涨了72.69,涨幅为13.5%。实际上,从2020年1月到2022年1月的两年时间里,TiDB都稳坐流行度排行榜头把交椅。回顾过去的一年,TiDB技术创新能力有目共睹。TiDB5.0版本,计算效能和并发能力大幅提升。截止2021年底,TiDB在最能体现企业技术研发能力的GitHub上获得逾3万颗星。此外,TiDB社区建设成绩斐然。共有418个公司/组织参与到了TiDB的研发中,Asktug社区网站注册用户超过13,000人,互助问答帖子数量约13,000篇,问题解决率达到95%。12月份,TiDB和TiDB Cloud均正式登陆AWS Marketplace。PingCAP联合创始人兼CTO黄东旭在2021数据技术嘉年华上表示客户在使用云服务的过程中面临众多挑战,TiDB Cloud以云原生的方式将 TiDB 服务化,让云上用户轻松获得 TiDB 能力的解决方案。TiDB自2020年1月跃居榜首并从当年6月起分数飙升,独占鳌头至今位于榜单第二名的openGauss自2020年11月首次跻身十强以来,排名不断上升。特别是从去年6月份以来,产品流行度分数保持快速增长,现已连续两个月占据榜眼之位。2022年1月,openGauss分数大幅上涨49.55,是分数增长最多的数据库,总分达到538.84的历史新高,年度涨幅高达187.2%(2021年1月分数为187.61)。本月,openGauss分数增长主要有以下几个原因:第一,2021年12月28日,openGauss Summit 2021在北京线上线下同步举办,openGauss开源社区理事会和技术委员会升级,openGauss社区分委会正式成立,社区建设开启新篇章。第二,月增千篇技术文章推动流行度提升。12月份,Gauss松鼠会联合墨天轮社区、openGauss社区共同推出《每日一练:openGauss在线实训课程》【21天学习打卡活动】。活动共吸引357位学习者积极参与,123位学习者通过结业考试,一个月内共收到2593篇作业文章,影响广泛。 第三,openGauss被正式纳入全国计算机等级考试,通过以考促学,为国家数字经济发展做好人才培养和储备。openGauss自入榜以来分数一路高歌猛进达梦本月分数增长31.08,总分519.31,位于榜单第三位。过去一年中,达梦的排名相对稳定地保持在前四。12月份达梦亮相PKS安全先进计算2021生态大会、中国能源企业信息化大会、第二十三届中国国际高新技术成果交易会等,高曝光度提升了其流行度。OceanBase在上月扭转分数下降趋势后,本月分数再次上涨47.20,增长幅度仅次于openGauss,总分为485.01,比2021年同期高47.85,同比增长11%,位于榜单第四位。近期,ITPUB & IT168 联合出品的《国产分布式数据库选型及满意度调查报告》显示OceanBase 获得双料第一:在金融行业的产品选择和使用上,OceanBase 最受欢迎;在国产分布式数据库用户满意度上,OceanBase 荣登第一。OceanBase金融领域 TOP 200的客户服务比例已高达四分之一,市场表现良好。同时,OceanBase12月份在平台建设上的表现比较亮眼。OceanBase举办的第一届技术征文大赛吸引了众多技术爱好者发布文章,他们在为期一个月的赛程中,发表了多篇相关文章,40余篇通过初审,提升了OceanBase流行度。此外,基于现有评分规则,通过官方新的评测对分数增长的作用也很大,OceanBase 社区版V3.1.1 近期通过了工信部电子标准院《信息技术 开源 开源项目评估模型参考架构》测评,成为首批通过成熟度评估的四个项目之一,开源产品化应用能力得到官方认可。排行榜Top5趋势比较12月份,华为云GaussDB(for MySQL)数据库和GaussDB(for openGauss)数据库凭借卓越的产品特性,通过了中国信通院关系型云数据库基础能力评测,数据库能力建设获得认可,推动GaussDB分数上涨35.41,总分388.31,位于榜单第五。腾讯云TDSQL本月分数上涨18.35,总分345.72,位于榜单第六。《国产分布式数据库选型及满意度调查报告》中,在产品技术及服务能力上,腾讯云TDSQL排名第一,表明了其出众的产品实力。PolarDB本月分数下跌34.94,是分数下降最多的数据库,总分为287.86,但依然位于榜单第七位。排名第八的南大通用GBase本月分数上涨27.62,总分284.33,与前者的差距已缩小到3.53分,如果继续保持增长势头,2月份,赶超PolarDB的可能性很大。PolarDB和GBase恐将在下月就位次产生一番较量人大金仓KingBase本月分数继续增长22.91,总分达到237.98,排名第九位。一方面人大金仓参加2021网络安全与信息化论坛暨信创生态高端论坛、第38届CCF中国数据库学术会议等,持续加强生态建设和技术研究。另一方面,12月份人大金仓再获太极股份近2亿元增资,并承办2021中国数据库产业峰会暨数据库创新成果发布会,市场和行业影响力不断提升。其实,从2021年全年来看,人大金仓的表现都很稳,流行度分数一直保持上涨,这种稳步分数积累会随着时间推移发挥出作用。人大金仓近一年来的得分稳步提升位于第十位的数据库是AnalyticDB,分数下跌18.24,总分161.45;中兴通讯GoldenDB分数下跌14.49,总分122.06,位于榜单第11位。巨杉数据库SequoiaDB、腾讯云TcaplusDB和易鲸捷数据库EsgynDB分数略有上涨,分别位于榜单第12-14位。神舟通用分数下降6.58,位于榜单第15位。此外,柏睿数据RapidsDB排名较上个月上升11位,进入20强,目前排名第19位。云和恩墨MogDB、OushuDB、MatrixDB、DolphinDB首次跻身30强,未来表现值得关注。下面我们来梳理一下重点国产数据库在12月份的表现。PingCAP获评 《金融电子化》2021金融业新技术应用创新突出贡献奖2021年,PingCAP在产品升级、社区建设、应用实践等多个领域取得了长足发展。PingCAP与AWS、GCP等建立了深度合作伙伴关系,数据库产品TiDB已经应用在2000多家企业当中。12月份,PingCAP获评 《金融电子化》2021 金融业新技术应用创新突出贡献奖,获奖项目 “ TiDB NewSQL 分布式数据库应用创新试点项目” 成功将国产开源分布式数据架构应用于浦发银行的网贷核算批处理业务以及用户中心两个业务场景,并在项目落地的过程中自研了一系列工具和平台。同时,为链接更广泛的生态,PingCAP自12月9日起,正式开启TiDB Hackathon 2021,通过内核、工具、生态、「∞」四大赛道,聚合数据库开发者、使用者、数据库上下游生态参与者、围绕 TiDB 探索无限可能。TiDB在团队和社区的共同努力下保持技术领先,持续推动解决方案落地,并不断释放开源的力量,与更多优秀的伙伴合作,打造一个更健壮的TiDB产品生态链。openGauss Summit 2021成功举办,嘉宾就国产数据库生态建设建言献策2021年12月28日,openGauss Summit 2021在北京线上线下同步举办。本次大会旨在与产业界通过技术创新、生态构建、商业推广、开源建设和人才发展等方面的合作,共同推动数据库产业发展。大会现场,openGauss开源社区理事会和技术委员会升级,openGauss社区分委会正式成立,推动数据库的基础研究、技术创新和人才培养。此外,12月份消息称,2022年全国计算机等级考试新增《二级openGauss数据库程序设计》,此次考试科目上的调整是对未来人才培养规划的一次尝试,有利于共同构筑起数字基础设施的统一生态。openGauss始终秉承共建、共享、共治的理念,与企业、伙伴、开发者,共同建设最具创新力的数据库开源社区,联合多方力量,推动国产数据库发展。OceanBase 通过工信部电子标准院首批开源项目成熟度评估近日,工信部电子标准院基于《信息技术 开源 开源项目评估模型参考架构》标准,对国内外众多开源项目进行了多维度全方位评估,并正式公布了评估结果。OceanBase 社区版V3.1.1 作为首批项目参与了《信息技术 开源 开源项目评估模型参考架构》测评,并成为首批通过成熟度评估的四个项目之一。另外,ITPUB & IT168 联合出品的《国产分布式数据库选型及满意度调查报告》表明,在金融行业的产品选择和使用上,OceanBase 最受欢迎;在国产分布式数据库用户满意度上,OceanBase 荣登第一。OceanBase 具有丰富的金融级内部实践与商用实践,商用案例覆盖国有大行、城商行、农商行、证券及保险行业,并且与其它开源数据库相比,在功能和性能上具备技术领先性的优势。作为一个开放的社区,OceanBase积极邀请技术爱好者参与社区建设。通过社区文章、技术交流活动、清晰的准则等,帮助不同背景的参与者参与 OceanBase 社区建设,致力于打造一个成熟的自治社区。人大金仓再获太极股份近2亿元增资,加快行业布局12月份,人大金仓再次获得太极股份近2亿元增资,太极股份将收购人大金仓少数股东股权,持股比例从33.28%上升至51%。太极股份先后于2011年、2017年、2020年三次战略投资人大金仓,持续增资逐步成为控股股东。未来,人大金仓在太极股份的资金支持下,抓住自主可控产业机遇,强化研发创新能力,加快产品研发和迭代升级,提升产品竞争力,扩大市场份额,完善全国各区域的销售和技术服务体系建设,进一步强化公司在信创领域的市场地位,加速关键人才引进与培养、生态建设及解决方案打造、加快行业布局。小结踔厉奋发、笃行不怠。新的一年里,国产数据库行业需要抓住市场机遇,不断进行技术创新、人才培养、生态建设。正如盖国强老师在2021数据技术嘉年华主论坛的开场致辞中所讲,相信2022年将成为国产数据库的耕获菑畬之年。文章来源:https://www.modb.pro/db/232909
-
不同的编程语言会对我们的求职产生相当大的影响,但是目前哪种编程语言最受公司欢迎呢?Emsi Burning Glass收集并分析了数百万个招聘信息,以下是出现得最多的编程语言:图来源于Emsi Burning Glass如图所示, SQL 位居榜首,可见各大公司在招聘时往往倾向于能够熟练使用SQL的技术人员。比起Python、Java 和JavaScript等编程语言,SQL并非使用最广泛的语言。但是,之所以各大公司要求精通SQL,原因在于它能够用于管理和查询关系数据库,是数据操作的基础。Java位列第二位。最近推出的Java 17在性能上大幅度提高,同时稳定性和安全性也在不断升级。该语言为众多软件后端提供支持,其中包括Android应用程序和大数据分析等等。Burning Glass表示,这也是Java 开发人员工资较高的关键原因之一。第三名编程语言为Python。Python一直是一种非常流行的编程语言,如今逐步用于数据科学、机器学习和其他高度专业化的领域。开发者调查分析公司 SlashData表示,Python的全球开发者社区人数大约有1130万,并且仍在持续增长。文章来源:https://blog.csdn.net/csdndevelopers/article/details/122316758
-
【功能模块】能否通过设置某项参数来达到自动检测执行计划中的cost 或者 是否产生笛卡尔积 来决定 该条SQL是否执行?【操作步骤&问题现象】1、在CN的SQL语句的优化阶段,能否根据设定的参数直接决定该条SQL语句是否能够执行【截图信息】【日志信息】(可选,上传日志内容或者附件)
-
 # 华为FusionInsight MRS实战 - 使用Flink SQL-Client连接hive ## 介绍 在之前的文章我们了解到如何使用华为Flink Server界面通过Flink SQL将数据写入hive。详细内容请参考如下连接。 [《华为FusionInsight MRS实战 - FlinkSQL从kafka写入hive》](https://bbs.huaweicloud.com/forum/thread-173950-1-1.html) 本文介绍如何使用Flink SQL-Client方式连接hive,并写入数据 ## 前提条件 首先需要了解以下三点内容。 1. 如何配置Flink客户端。 参考:[《华为FusionInsight MRS Flink客户端配置》](https://bbs.huaweicloud.com/forum/thread-175741-1-1.html) 2. 如何配置Flink SQL Client。参考:[《华为FusionInsight MRS Flink SQL-Client客户端配置》](https://bbs.huaweicloud.com/forum/thread-176103-1-1.html) 3. 如何使用Flink SQL Client。参考:[《华为FusionInsight MRS实战 - Flink增强特性之可视化开发平台FlinkSever开发学习》](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=161992) ## 操作步骤 - 因为将写入hive表,需要开启flink的checkpoint功能,需要手动在客户端配置文件`/opt/92_client/hadoopclient/Flink/flink/conf/flink-conf.yaml`添加如下内容 ``` execution.checkpointing.interval: 15000 state.backend: filesystem state.checkpoints.dir: hdfs:///flink/checkpoints ```  - 使用命令启动flink session `./bin/yarn-session.sh -t conf/`  - 使用命令登录flink sql client客户端 `./sql-client.sh embedded -d ./../conf/sql-client-defaults.yaml` 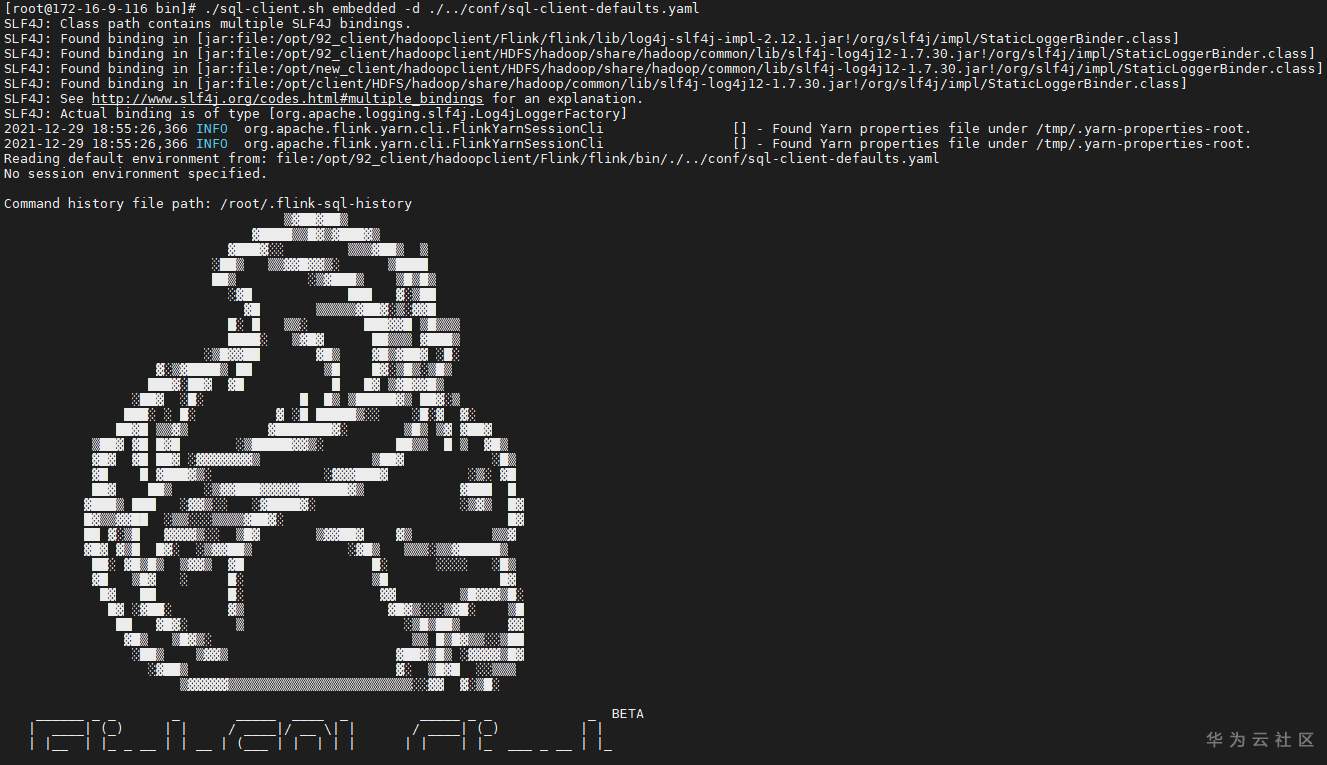 - 创建hive目的表 ``` use catalog myhive; SET table.sql-dialect=hive; CREATE TABLE IF NOT EXISTS hive_dialect_tbl ( `id` int , `name` string , `age` int ) ROW FORMAT DELIMITED FIELDS TERMINATED BY ','; ```  - 创建数据源表 ``` SET table.sql-dialect=default; CREATE TABLE datagen ( `id` int , `name` string , `age` int ) WITH ( 'connector' = 'datagen', 'rows-per-second'='1' ); ``` 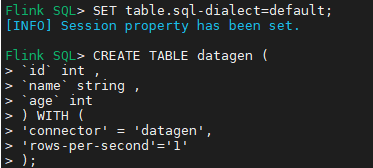 - 在sql client创建数据写入 `INSERT INTO hive_dialect_tbl SELECT * FROM datagen;` - sql client端查看结果 ``` set execution.result-mode=tableau; select * from hive_dialect_tbl; ``` 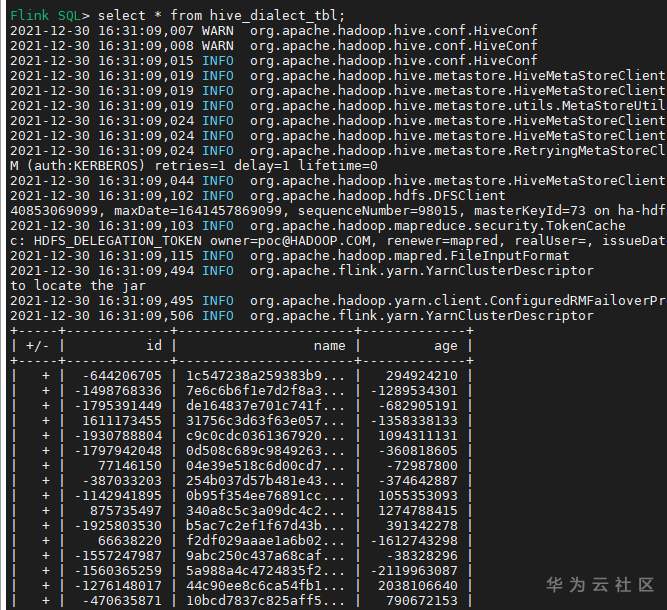 - hive端查看数据 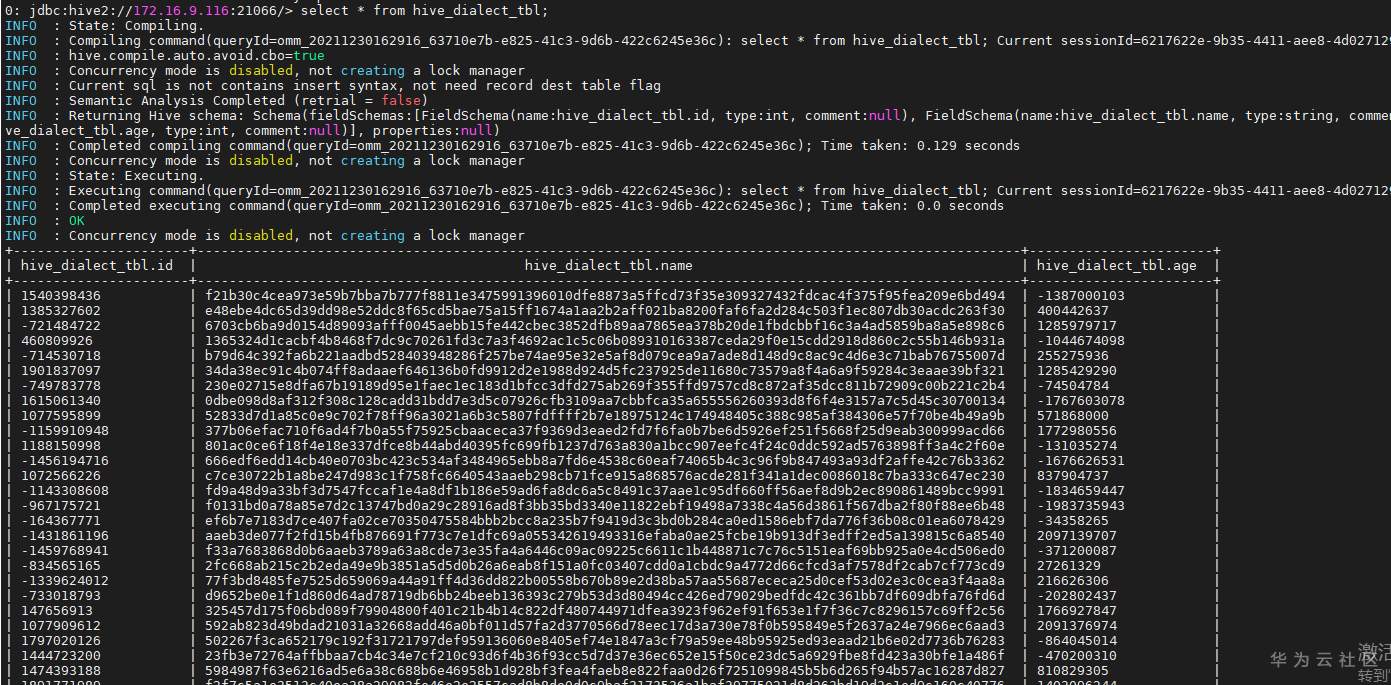
-
设置了max_active_statements=10单个CN的普通用户的任务数超过10个,就会进入等待队列,如果前10个任务一直都在执行,执行时间很长。别的任务都在等待队列中,在等待队列的任务中的任务,多久数据库会杀掉?哪个参数控制的?
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签