-
 天我们来讨论一下关于云运维的话题越来越多政企客户们开始从推动“云优先”向关注“云效能”转变:云平台运维要赋予IT更好的能力帮助业务更高效运营更好地满足IT信息化决策的需求那么,云运维到底难在哪?王强 IT运维工程师王强 IT运维工程师:“干了十多年的IT运维工作,以前都是以基础设施作为维护对象,现在业务全面上云之后,容器、大数据、人工智能等新技术和多云运维面临的挑战扑面而来,我们经常打趣说,运维从“机械时代”跳跃到“智能时代”了。”●痛点1:复杂的云平台架构对平台运维人员能力提出更高的要求。张升 业务开发工程师张升 业务开发工程师:“新业务上线,软件升级和配置变更必不可少。此类升级变更任务对操作可靠性要求极高,一旦出错往往会带来系统性业务可用性风险,经营损失不可估量。”●痛点2:多元化的业务应用带来快速的平台软件迭代和更高的系统风险。Peter Lee CIOPeter Lee CIO:“上云之后,配备多领域的高级别运维专家是必要的,可以对平台建设及业务规划给出更科学合理的建议;同时我们运维部门希望引入自动化、在线化、移动化的运维工具,然而这些都需要高昂的投资,这让我们望而却步。”●痛点3:专业运维人员配置和大量自动化能力开发,使得运维成本飙升。丁力波 能源信息建设规划架构师丁力波 能源信息建设规划架构师:“作为一家超过10万人的企业,我们在20多个城市部署有分支机构,业务规模及支撑系统部署存在差异,各分支自有的运维人员技能和经验参差不齐,如何把多分支的运维工作统一管理起来,实现有效的协同,这不是一道简单的命题。”●痛点4:大规模多分支机构的差异化业务场景,大大增加了全局统一运维的复杂度。华为云Stack提供三种云平台运维模式解决政企客户的运维挑战:选择一省心省力的远程托管运维无须自建云运维能力,华为一站式运维服务,客户聚焦业务应用,省心无忧。远程托管运维,客户最省心省力,无需花精力建设和管理自有运维团队,将平台可靠性设计、可用性保障等运维工作托付华为远程运维中心,即可从繁琐的基础维护工作中释放出来,从而可以聚焦到政企自身服务和业务创新等核心经营事务。优点:1、远程运维团队经验丰富,监控到告警后快速响应,远程登录云平台,快速分析问题,并提供最优处理方案;2、华为200+运维专家团队,覆盖IaaS、PaaS、大数据、人工智能、安全等10+类云产品技能,单局点问题经验可以快速复制应用于同类问题解决;3、华为运维团队致力于集中化运维工具平台开发创新,采用运维数据底座+DevOps的敏捷工具开发,将加速客户云平台运维智能化进程。选择二按需服务的远程协助运维本地+远程协助的两级运维体系,提供快捷、高效、安全的运维服务。在客户负责整体云平台运维管理职责,但自身运维团队只具备基础运维能力的情况下,华为可派驻驻场团队承担必要的云服务运维工作,通过安全专线与华为远程运维中心建立连接,把涉及主动预防、高阶云服务操作等技术要求高的维护工作交给华为。华为将定期和不定期(重大事件)向客户汇报提供的服务交付成果。优点:1、简化客户现场运维难度,高阶云服务专家集中远程中心,把复杂技术问题留给华为,降低对客户现场人力数量和能力的要求;2、高阶服务专家按需介入,重大故障/问题快速修复,缩短故障闭环时间;3、专家在线支持版本迭代升级,季度开展深度巡检、有效降低升级风险。选择三行业云技术服务中心华为专业运维能力下沉至行业云技术服务中心,行业专网保障数据安全,应急连线加持紧急恢复。行业云技术服务中心,适应于行业一片云或大规模行业局点需构建专属运维团队和能力的场景。华为可提供专业运维能力下沉支持,如运维专家培养、运维工具使用、运维体系及流程建设等。优点:1、随行业云平台建设,适配客户业务场景,帮助客户快速构建基础云服务/高阶云服务运维团队,及高效运维流程体系;2、在行业云技术服务中心部署远端运维工具平台,实现对分支机构的可监控、可维护、可管理,为业务快速决策、指标分析提供重要参考;3、运维工具平台和所有运维操作数据流都在行业内网,可以供行业云运维中心实时查阅,运维全局统一管理。▎华为云Stack运维解决方案五大关键能力关键能力一:基于业界及华为最佳实践,形成一整套运维管理体系华为长期参与国家ITSS组织运维标准制定讨论,同时遵循ITIL、ISO20000、ISO27001等国际通用的标准要求,形成一整套标准化、数字化、智能化的运维管理体系。关键能力二:专家服务队伍汇聚从解决方案设计、交付、云服务运维各领域的专家,在运维中心拥有5年以上的资深专家近200名,持有ITIL、PMP、HCIE相关的认证。关键能力三:技术支持中心(TSC)平台:它拥有业界领先的运维工具体系,致力于集中化、自动化和数字化运维,助力客户快速使用云服务,聚焦业务创新。全场景覆盖:高效标准的流程与工具,覆盖智能监控、故障处理、服务变更、主动运维;运维自动化:运维操作自动化和基于运维大数据的智能化,提升运维效率;主动运维:AIOps(Artificial Intelligence for IT Operations),异常事件发现,故障预测、深度巡检;云梯接入网关:网络反向建连,消除监听端口,通信矩阵极致收编,通信可审计,可控易控。关键能力四:完善的集中运维安全管理机制,保障运维安全华为云(西安)运维中心已经通过了国家网络安全认证,遵守国内外法律法规约束,以及客户自身对安全管理的要求,在数据安全、IT安全、人员安全、物理安全、作业可信五个方面提供可信、可控、透明的运维服务。关键能力五:华为全球交付与运维服务能力华为云全球技术服务体系将华为30多年的运维能力加以沉淀,以华为云自研工具平台为底座,集结500+原厂运维服务工程师和30000+严选合作伙伴工程师,共同打造“1+3+N”的华为云全球交付与运维能力。(1+3+N:即1个西安运维中心核心节点,罗马尼亚、马来西亚、墨西哥3个海外节点, 以及N个客户现场运维中心。)▎华为云(西安)运维中心华为云构建“1+3+N”全球技术服务体系,让用户聚焦创新,安心上云用云。坐落在西安的华为云运维中心为客户提供包括托管运维、远程协助和行业云技术服务在内的三大运维服务模式,同时以自动化工具、“远程+现场”两级安全运维体系、资深专家和海量行业经验等能力为政企客户智能运维保驾护航。华为云(西安)运维中心核心节点将承载华为云中国区全部政企客户集中运维业务,同时也是全球技术服能力孵化中心和政企客户云运维体验中心。预计到2025年,华为云(西安)运维中心将接入超过1000个节点,服务25万多台设备。华为云Stack运维解决方案,聚焦支撑业务云化转型、优化运维成本、保障平台安全可靠,使客户聚焦业务上云,享受平滑安全的用云体验。链接:https://bbs.huaweicloud.com/blogs/353712
-
 本文分享自华为云社区《[GaussDB(DWS) SQL进阶之PLSQL(二)-游标](https://bbs.huaweicloud.com/blogs/330535?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=ei&utm_content=content)》,作者: xxxsql123 。 # 前言 游标是一种数据处理方法,提供了在查询结果集中进行逐行遍历浏览数据的方法,也可以将游标当做上下文区域的句柄或者指针,借助游标对指定位置的数据进行查询与处理,本章我们主要聚焦于GaussDB(DWS)存储过程中的游标使用。 # 显式游标 显示游标主要用于处理存储过程中的查询结果集是游标常用的用法,具体分为如下几个步骤: # Step 1 定义游标: ## 静态游标定义: 即定义一个游标名以及与其相对应的SELECT语句 语法图:  示例如下: ``` --在存储过程的DECLARE中声明游标定义 CURSOR C1 IS SELECT section_name, place_id FROM hr.sections WHERE section_id = 50; CURSOR C2(sect_id INTEGER) IS SELECT section_name, place_id FROM hr.sections WHERE section_id = sect_id; ``` ## 动态游标定义: 即ref游标,可以通过静态的SQL语句在合适的时候动态的打开游标。先定义ref游标类型,后面通过open for动态绑定SELECT语句 语法图:  示例如下: ``` --在存储过程的DECLARE中声明游标定义 TYPE CURSOR_TYPE IS REF CURSOR; ``` 同时GaussDB(DWS)做了Oracle兼容,支持sys_refcursor动态游标类型,函数或存储过程可以通过sys_refcursor参数传入或传出游标结果集合,函数也可以通过返回sys_refcursor来返回游标结果集合。 语法图:  示例如下: ``` --在存储过程的DECLARE中声明游标定义 C1 SYS_REFCURSOR; ``` # Step 2 打开游标: ## 静态游标打开: 即执行游标对应的SELECT语句,将结果集放入工作区,将游标的指针指向工作区的起始位置。 语法图:  示例如下: ``` --在存储过程的BODY中打开游标 OPEN C1; OPEN C2(10); ``` ## 动态游标打开: 通过OPEN FOR语句打开动态游标,通过USING对SELECT语句进行动态绑定。 语法图:  示例如下: ``` --在存储过程的BODY中打开游标 SQL_STR := 'SELECT section_name, place_id FROM hr.sections WHERE section_id = :DEPT_NO;'; OPEN C3 FOR SQL_STR USING 50; ``` # Step 3 提取游标数据: 即提取游标指针指向的数据 语法图:  示例: ``` --在存储过程的BODY中执行 FETCH C3 INTO DEPT_NAME, DEPT_LOC; ``` # Step 4 循环处理游标数据: 提取数据后可以基于存储过程的语句灵活发挥 例如,给工资低于3000的员工增加500块钱工资 ``` --在存储过程的BODY中执行 LOOP FETCH C INTO V_EMPNO, V_SAL; EXIT WHEN C%NOTFOUND; IF V_SAL=3000 THEN UPDATE hr.staffs_t1 SET salary =salary + 500 WHERE staff_id = V_EMPNO; END IF; END LOOP; ``` # Step 5 关闭游标: 在处理完游标的数据后,应及时释放游标,以便释放游标所占用系统资源,游标关闭后工作区将变成无效,不能再使用FETCH语句获取其中数据。关闭后的游标可以使用OPEN语句重新打开。 语法图:  ``` --在存储过程的BODY中执行 CLOSE C1;--关闭游标 ``` # 游标属性 我们可以通过游标的属性来了解当前游标的状态。下面将介绍4中游标属性: ※ %FOUND布尔型属性:当最近一次读记录时成功返回,则值为TRUE。 ※ %NOTFOUND布尔型属性:与%FOUND相反。 ※ %ISOPEN布尔型属性:当游标已打开时返回TRUE。 ※ %ROWCOUNT数值型属性:返回已从游标中读取的记录数。 示例: ``` OPEN C1;--打开游标 LOOP --通过游标取值 FETCH C1 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C1%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C1;--关闭游标 ``` 接下来我们将结合前面所学习的知识,在存储过程运用显示游标。 数据准备: ``` CREATE SCHEMA hr; SET CURRENT_SCHEMA = 'hr'; DROP TABLE IF EXISTS sections; CREATE TABLE sections(section_id INT, section_name VARCHAR(100), place_id NUMBER(4)) DISTRIBUTE BY HASH(section_id); INSERT INTO sections VALUES (1, 'section_name1', 1),(2, 'section_name2', 2),(3, 'section_name3', 3); ``` 显示游标使用示例: ``` --游标参数的传递方法。 CREATE OR REPLACE PROCEDURE cursor_proc1() AS DECLARE DEPT_NAME VARCHAR(100); DEPT_LOC NUMBER(4); --定义游标 CURSOR C1 IS SELECT section_name, place_id FROM hr.sections WHERE section_id = 50; CURSOR C2(sect_id INTEGER) IS SELECT section_name, place_id FROM hr.sections WHERE section_id = sect_id; TYPE CURSOR_TYPE IS REF CURSOR; C3 CURSOR_TYPE; SQL_STR VARCHAR(100); BEGIN OPEN C1;--打开游标 LOOP --通过游标取值 FETCH C1 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C1%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C1;--关闭游标 OPEN C2(10); LOOP FETCH C2 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C2%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C2; SQL_STR := 'SELECT section_name, place_id FROM hr.sections WHERE section_id = :DEPT_NO;'; OPEN C3 FOR SQL_STR USING 50; LOOP FETCH C3 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C3%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C3; END; / CALL cursor_proc1(); DROP PROCEDURE cursor_proc1; ``` 执行结果: ``` postgres=# CALL cursor_proc1(); section_name3---3 section_name1---1 section_name2---2 section_name1---1 section_name2---2 section_name3---3 section_name1---1 section_name2---2 section_name3---3 cursor_proc1 -------------- (1 row) ``` SYS_REFCURSOR游标示例: ``` --SYS_REFCURSOR类型做为函数参数 CREATE OR REPLACE PROCEDURE proc_sys_ref(O OUT SYS_REFCURSOR) IS C1 SYS_REFCURSOR; BEGIN OPEN C1 FOR SELECT section_ID FROM HR.sections ORDER BY section_ID; O := C1; END; / DECLARE C1 SYS_REFCURSOR; TEMP NUMBER(4); BEGIN proc_sys_ref(C1); LOOP FETCH C1 INTO TEMP; DBMS_OUTPUT.PUT_LINE(C1%ROWCOUNT); EXIT WHEN C1%NOTFOUND; END LOOP; END; / --删除存储过程 DROP PROCEDURE proc_sys_ref; ``` 执行结果: ``` postgres=# DECLARE postgres-# C1 SYS_REFCURSOR; postgres-# TEMP NUMBER(4); postgres-# BEGIN postgres$# proc_sys_ref(C1); postgres$# LOOP postgres$# FETCH C1 INTO TEMP; postgres$# DBMS_OUTPUT.PUT_LINE(C1%ROWCOUNT); postgres$# EXIT WHEN C1%NOTFOUND; postgres$# END LOOP; postgres$# END; postgres$# / 1 2 3 3 ANONYMOUS BLOCK EXECUTE ``` # 隐式游标 对于非SELECT语句,例如UPDATE,DELETE操作,系统会自动的未这些操作设置游标,这些有系统隐含创建的游标即隐式游标。隐式游标的定义,打开,取值,关闭操作均有系统自动的完成,无需用户进行处理,用户只能通过隐式游标的相关属性完成相应的操作。 隐式游标属性: ※ SQL%FOUND布尔型属性:当最近一次读记录时成功返回,则值为TRUE。 ※ SQL%NOTFOUND布尔型属性:与%FOUND相反。 ※ SQL%ROWCOUNT数值型属性:返回已从游标中读取得记录数。 ※ SQL%ISOPEN布尔型属性:取值总是FALSE。SQL语句执行完毕立即关闭隐式游标。 隐式游标示例如下: ``` --删除EMP表中某部门的所有员工,如果该部门中已没有员工,则在DEPT表中删除该部门。 CREATE TABLE hr.staffs_t1 AS TABLE hr.staffs; CREATE TABLE hr.sections_t1 AS TABLE hr.sections; CREATE OR REPLACE PROCEDURE proc_cursor3() AS DECLARE V_DEPTNO NUMBER(4) := 100; BEGIN DELETE FROM hr.staffs WHERE section_ID = V_DEPTNO; --根据游标状态做进一步处理 IF SQL%NOTFOUND THEN DELETE FROM hr.sections_t1 WHERE section_ID = V_DEPTNO; END IF; END; / CALL proc_cursor3(); --删除存储过程和临时表 DROP PROCEDURE proc_cursor3; DROP TABLE hr.staffs_t1; DROP TABLE hr.sections_t1; ``` 以上就是在GuassDB(DWS)的存储过程中游标的基本使用。 # 总结 GuassDB(DWS)的游标使用在postgresql的基础上做了对Oracle的语法兼容,存储过程中的游标功能对于原来依赖Oracle的系统可以平滑的迁移。同时由于GuassDB(DWS)是分布式架构,和postgresql本身以及GuassDB(DWS)的单机模式上游标的行为细节上会略有不同,例如事务中的DECLARE CURSOR由于分布式和单机的实现差异导致在pg_cursors视图查询结果差异等。
-
 活动说明:欢迎参与评论区留言互动,活动结束我们将选取5位高赞的留言赠送精美礼物一份。活动话题:说说你理解的数据治理平台需要包含哪些功能,可以解决哪些业务卡点?活动时间: 2022年5月23日-2022年6月30日奖励说明:活动小助手将会用心查看参与活动的用户评论,选取5位高赞的留言赠送蓝牙鼠标一份解锁问卷答案:下列哪个大数据服务可以提供数据调度、数据建模、数据治理、数据分析等能力?答案:B.DGC分析:数据湖治理中心(DGC)是数据全生命周期一站式开发运营平台,提供数据集成、数据开发、数据治理、数据服务、数据可视化等功能,支持行业知识库智能化建设,支持大数据存储、大数据计算分析引擎等数据底座,帮助企业客户快速构建数据运营能力。官网:https://www.huaweicloud.com/product/dayu.html知识大比拼,你答对了吗?《智能数据湖》微信公众号:ei-datalake大数据免费资源领取:https://activity.huaweicloud.com/Date-free.html
-
 2022年3月,openEuler 22.03 LTS版本ISO安装包仓库及LTS官方软件仓库均上线openGauss2.1.0版本安装包,提供RPM一键安装openGauss的能力,提高用户易用性。openEuler 22.03 LTS版本中涉及的openGauss安装包及其依赖仓库如下:https://gitee.com/src-openeuler/opengauss-serverhttps://gitee.com/src-openeuler/opengauss-dcfopenGauss是一款开源的关系型数据库,采用客户端/服务器、单进程多线程架构,支持单机和一主多备部署方式,备机只读,支持双机高可用和读扩展。openGauss相比于其他开源数据库主要有以下几个主要特点:高性能提供了面向多核架构的并发控制技术结合鲲鹏硬件优化,在两路鲲鹏下TPCC Benchmark达成性能150万tpmc。针对当前硬件多核numa的架构趋势, 在内核关键结构上采用了Numa-Aware的数据结构。提供Sql-bypass智能快速引擎、融合引擎技术。高可用支持主备同步、异步和级联备机多种部署模式。数据页CRC校验,损坏数据页通过备机自动修复。备机并行恢复,10秒内可升主提供服务。高安全支持全密态计算、访问控制、加密认证、数据库审计和动态数据脱敏等安全特性,提供全方位端到端的数据安全保护。易运维基于AI的智能参数调优和索引推荐,提供AI自动参数推荐。慢SQL诊断,多维性能自监控视图,实时掌控系统的性能表现。提供在线自学习的SQL时间预测。全开放采用木兰宽松许可证协议,允许对代码自由修改、使用和引用。数据库内核能力全开放。提供丰富的伙伴认证,培训体系和高校课程。#openEuler 22.03 LTS ISO镜像安装操作系统时,安装引导界面的选择软件包里面勾选上openGauss Server,在安装完成操作系统后,默认安装上openGauss数据库并启动单机数据库进程。openGauss社区与openEuler社区作为两个开源开放的社区,通过相互协作和融合,使得openGauss进入openEuler 22.03 LTS ISO镜像,同时为openEuler 22.03 LTS官方仓库提供openGauss软件包,极大地提高了openGauss用户易用性;同时,也为使用openEuler 22.03 LTS ISO及其他镜像源的用户带来了便利。#查看cpu相关信息 lscpu du -sh * #openGauss官网 https://opengauss.org/zh/#UKUI~(希望早点支持UKUI3.0版本) UKUI是麒麟软件团队历经多年打造的一款Linux 桌面,主要基于 GTK 和 QT开发。与其它UI界面相比,UKUI更加注重易用性和敏捷度,各元件相依性小,可以不依赖其它套件而独自运行,给用户带来亲切和高效的使用体验。UKUI支持x86_64和aarch64两种架构。 #下载 openEuler21.03及以上 镜像并安装系统。https://repo.openeuler.org/openEuler-21.09/ sudo dnf update #安装UKUI sudo dnf install ukui -y #在确认正常安装后,重启reboot systemctl set-default graphical.target#DDE DDE是统信软件团队研发的一款功能强大的桌面环境。包含数十款功能强大的桌面应用,是真正意义上的自主自研桌面产品 #更新软件源 sudo dnf update #安装DDE sudo dnf install dde -y #设置以图形界面的方式启动 sudo systemctl set-default graphical.target #重启 sudo reboot #dde桌面无法使用root账号登陆 dde内置了openeuler用户,密码为openeuler#安装opengauss2.1.0,(aarch64/x86_64) yum list opengauss* yum -y install opengauss 或dnf install opengauss -y#启动,自启 systemctl start opengauss systemctl status opengauss systemctl enable opengauss#登录数据库 su - opengauss gsql -d postgres -r参考来源:openGauss公众号 https://mp.weixin.qq.com/s/sh6GIhTV2V2aaxuZQDoozg
-
本文分享自华为云社区《从零开发大数据SQL引擎》,作者:JavaEdge 。 学习大数据技术的核心原理,掌握一些高效的思考和思维方式,构建自己的技术知识体系。 明白了原理,有时甚至不需要学习,顺着原理就可以推导出各种实现细节。 各种知识表象看杂乱无章,若只是学习繁杂知识点,固然自己的知识面是有限的,并且遇到问题的应变能力也很难提高。所以有些高手看起来似乎无所不知,不论谈论起什么技术,都能头头是道,其实并不是他们学习、掌握了所有技术,而是他们是在谈到这个问题时,才开始进行推导,并迅速得出结论。 高手不一定要很资深、经验丰富,把握住技术的核心本质,掌握快速分析推导的能力,能迅速将自己的知识技能推到陌生领域,就是高手。 本系列专注大数据开发需要关注的问题及解决方案。跳出繁杂知识表象,掌握核心原理和思维方式,进而融会贯通各种技术,再通过各种实践训练,成为终极高手。 # 大数据仓库Hive 作为一个成功的大数据仓库,它将SQL语句转换成MapReduce执行过程,并把大数据应用的门槛下降到普通数据分析师和工程师就可以很快上手的地步。 但Hive也有问题,由于它使用自定义Hive QL,对熟悉Oracle等传统数据仓库的分析师有上手难度。特别是很多企业使用传统数据仓库进行数据分析已久,沉淀大量SQL语句,非常庞大也非常复杂。某银行的一条统计报表SQL足足两张A4纸,光是完全理解可能就要花很长时间,再转化成Hive QL更费力,还不说可能引入bug。 开发一款能支持标准数据库SQL的大数据仓库引擎,让那些在Oracle上运行良好的SQL可以直接运行在Hadoop上,而不需要重写成Hive QL。 # Hive处理过程 1. 将输入的Hive QL经过语法解析器转换成Hive抽象语法树(Hive AST) 2. 将Hive AST经过语义分析器转换成MapReduce执行计划 3. 将生成的MapReduce执行计划和Hive执行函数代码提交到Hadoop执行 可见,最简单的,对第一步改造即可。考虑替换Hive语法解析器:能将标准SQL转换成Hive语义分析器能处理的Hive抽象语法树,即红框代替黑框 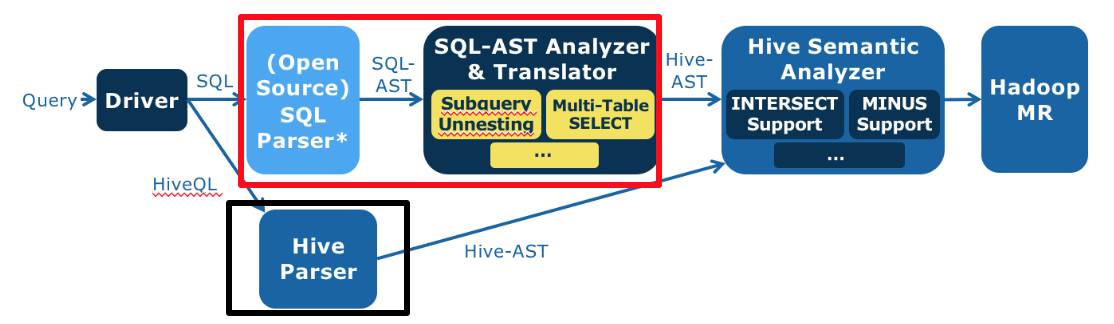 红框内:浅蓝色是个开源的SQL语法解析器,将标准SQL解析成标准SQL抽象语法树(SQL AST),后面深蓝色定制开发的SQL抽象语法树分析与转换器,将SQL AST转换成Hive AST。 那么关键问题就来了: # 标准SQL V.S Hive QL - 语法表达方式,Hive QL语法和标准SQL语法略有不同 - Hive QL支持的语法元素比标准SQL要少很多,比如,数据仓库领域主要的测试集TPC-H所有的SQL语句,Hive都不支持。尤其是Hive不支持复杂嵌套子查询,而数据仓库分析中嵌套子查询几乎无处不在。如下SQL,where条件existes里包含了另一条SQL: ```mysql select o_orderpriority, count(*) as order_count from orders where o_orderdate >= date '[DATE]' and o_orderdate date '[DATE]' + interval '3' month and exists (select * from lineitem where l_orderkey = o_orderkey and l_commitdate l_receiptdate) group by o_orderpriority order by o_orderpriority; ``` 开发支持标准SQL语法的SQL引擎难点,就是**消除复杂嵌套子查询掉**,即让where里不包含select。 SQL理论基础是关系代数,主要操作仅包括:并、差、积、选择、投影。而一个嵌套子查询可等价转换成一个连接(join)操作,如: ```mysql select s_grade from staff where s_city not in ( select p_city from proj where s_empname = p_pname ) ``` 这是个在where条件里嵌套了not in子查询的SQL语句,它可以用left outer join和left semi join进行等价转换,示例如下,这是Panthera自动转换完成得到的等价SQL。这条SQL语句不再包含嵌套子查询, ```mysql select panthera_10.panthera_1 as s_grade from (select panthera_1, panthera_4, panthera_6, s_empname, s_city from (select s_grade as panthera_1, s_city as panthera_4, s_empname as panthera_6, s_empname as s_empname, s_city as s_city from staff) panthera_14 left outer join (select panthera_16.panthera_7 as panthera_7, panthera_16.panthera_8 as panthera_8, panthera_16.panthera_9 as panthera_9, panthera_16.panthera_12 as panthera_12, panthera_16.panthera_13 as panthera_13 from (select panthera_0.panthera_1 as panthera_7, panthera_0.panthera_4 as panthera_8, panthera_0.panthera_6 as panthera_9, panthera_0.s_empname as panthera_12, panthera_0.s_city as panthera_13 from (select s_grade as panthera_1, s_city as panthera_4, s_empname as panthera_6, s_empname, s_city from staff) panthera_0 left semi join (select p_city as panthera_3, p_pname as panthera_5 from proj) panthera_2 on (panthera_0.panthera_4 = panthera_2.panthera_3) and (panthera_0.panthera_6 = panthera_2.panthera_5) where true) panthera_16 group by panthera_16.panthera_7, panthera_16.panthera_8, panthera_16.panthera_9, panthera_16.panthera_12, panthera_16.panthera_13) panthera_15 on ((((panthera_14.panthera_1 => panthera_15.panthera_7) and (panthera_14.panthera_4 => panthera_15.panthera_8)) and (panthera_14.panthera_6 => panthera_15.panthera_9)) and (panthera_14.s_empname => panthera_15.panthera_12)) and (panthera_14.s_city => panthera_15.panthera_13) where ((((panthera_15.panthera_7 is null) and (panthera_15.panthera_8 is null)) and (panthera_15.panthera_9 is null)) and (panthera_15.panthera_12 is null)) and (panthera_15.panthera_13 is null)) panthera_10 ; ``` 通过可视化工具将上面两条SQL的语法树展示出来,是这样的。  这是原始的SQL抽象语法树。  这是等价转换后的抽象语法树,内容太多被压缩的无法看清,不过你可以感受一下(笑)。 那么,在程序设计上如何实现这样复杂的语法转换呢?当时Panthera项目组合使用了几种经典的设计模式,每个语法点被封装到一个类里去处理,每个类通常不过几十行代码,这样整个程序非常简单、清爽。如果在测试过程中遇到不支持的语法点,只需为这个语法点新增加一个类即可,团队协作与代码维护非常容易。 使用装饰模式的语法等价转换类的构造,Panthera每增加一种新的语法转换能力,只需要开发一个新的Transformer类,然后添加到下面的构造函数代码里即可。 private static SqlASTTransformer tf = new RedundantSelectGroupItemTransformer( new DistinctTransformer( new GroupElementNormalizeTransformer( new PrepareQueryInfoTransformer( new OrderByTransformer( new OrderByFunctionTransformer( new MinusIntersectTransformer( new PrepareQueryInfoTransformer( new UnionTransformer( new Leftsemi2LeftJoinTransformer( new CountAsteriskPositionTransformer( new FilterInwardTransformer( //use leftJoin method to handle not exists for correlated new CrossJoinTransformer( new PrepareQueryInfoTransformer( new SubQUnnestTransformer( new PrepareFilterBlockTransformer( new PrepareQueryInfoTransformer( new TopLevelUnionTransformer( new FilterBlockAdjustTransformer( new PrepareFilterBlockTransformer( new ExpandAsteriskTransformer( new PrepareQueryInfoTransformer( new CrossJoinTransformer( new PrepareQueryInfoTransformer( new ConditionStructTransformer( new MultipleTableSelectTransformer( new WhereConditionOptimizationTransformer( new PrepareQueryInfoTransformer( new InTransformer( new TopLevelUnionTransformer( new MinusIntersectTransformer( new NaturalJoinTransformer( new OrderByNotInSelectListTransformer( new RowNumTransformer( new BetweenTransformer( new UsingTransformer( new SchemaDotTableTransformer( new NothingTransformer()))))))))))))))))))))))))))))))))))))); 而在具体的Transformer类中,则使用组合模式对抽象语法树AST进行遍历,以下为Between语法节点的遍历。我们看到使用组合模式进行树的遍历不需要用递归算法,因为递归的特性已经隐藏在树的结构里面了。 @Override protected void transform(CommonTree tree, TranslateContext context) throws SqlXlateException { tf.transformAST(tree, context); trans(tree, context); } void trans(CommonTree tree, TranslateContext context) { // deep firstly for (int i = 0; i tree.getChildCount(); i++) { trans((CommonTree) (tree.getChild(i)), context); } if (tree.getType() == PantheraExpParser.SQL92_RESERVED_BETWEEN) { transBetween(false, tree, context); } if (tree.getType() == PantheraExpParser.NOT_BETWEEN) { transBetween(true, tree, context); } } 将等价转换后的抽象语法树AST再进一步转换成Hive格式的抽象语法树,就可以交给Hive的语义分析器去处理了,从而也就实现了对标准SQL的支持。 当时Facebook为证明Hive对数据仓库的支持,手工将TPC-H的测试SQL转换成Hive QL,将这些手工Hive QL和Panthera进行对比测试,两者性能各有所长,总体上不相上下,说明Panthera自动进行语法分析和转换的效率还行。 Panthera(ASE)和Facebook手工Hive QL对比测试:  标准SQL语法集的语法点很多,007进行各种关系代数等价变形,也不可能适配所有标准SQL语法。 # SQL注入 常见的Web攻击手段,如下图所示,攻击者在HTTP请求中注入恶意SQL命令(drop table users;),服务器用请求参数构造数据库SQL命令时,恶意SQL被一起构造,并在数据库中执行。  但JDBC的PrepareStatement可阻止SQL注入攻击,MyBatis之类的ORM框架也可以阻止SQL注入,请从数据库引擎的工作机制解释PrepareStatement和MyBatis的防注入攻击的原理。
-
 本文是avro解析的demo,当前FlinkSQL仅适用于简单的avro数据解析,复杂嵌套avro数据暂时不支持。本文主要解析Apache Avro数据的相关内容,感兴趣的朋友一起看看吧摘要:本文将演示如果序列化生成avro数据,并使用FlinkSQL进行解析。 Avro官方文档所写,http://avro.apache.org/docs/current/index.html.Avro简介avro是一个数据序列化系统提供了:• 丰富的数据结构• 紧凑的,快速的,二进制的数据格式• 一种文件格式,用于存储持久化数据• 远程过程调用系统(RPC)• 和动态语言的简单交互。并不需要为数据文件读写产生代码,也不需要使用或实现RPC协议。代码生成是一种优化方式,但是只对于静态语言有意义。技术背景随着互联网高速的发展,云计算、大数据、人工智能AI、物联网等前沿技术已然成为当今时代主流的高新技术,诸如电商网站、人脸识别、无人驾驶、智能家居、智慧城市等等,不仅方面方便了人们的衣食住行,背后更是时时刻刻有大量的数据在经过各种各样的系统平台的采集、清晰、分析,而保证数据的低时延、高吞吐、安全性就显得尤为重要,Apache Avro本身通过Schema的方式序列化后进行二进制传输,一方面保证了数据的高速传输,另一方面保证了数据安全性,avro当前在各个行业的应用越来越广泛,如何对avro数据进行处理解析应用就格外重要,本文将演示如果序列化生成avro数据,并使用FlinkSQL进行解析。本文是avro解析的demo,当前FlinkSQL仅适用于简单的avro数据解析,复杂嵌套avro数据暂时不支持。场景介绍本文主要介绍以下三个重点内容:• 如何序列化生成Avro数据• 如何反序列化解析Avro数据• 如何使用FlinkSQL解析Avro数据前提条件• 了解avro是什么,可参考apache avro官网快速入门指南• 了解avro应用场景操作步骤1、新建avro maven工程项目,配置pom依赖pom文件内容如下:1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950515253<?xml version="1.0" encoding="UTF-8"?><project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.huawei.bigdata</groupId> <artifactId>avrodemo</artifactId> <version>1.0-SNAPSHOT</version> <dependencies> <dependency> <groupId>org.apache.avro</groupId> <artifactId>avro</artifactId> <version>1.8.1</version> </dependency> <dependency> <groupId>junit</groupId> <artifactId>junit</artifactId> <version>4.12</version> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.apache.avro</groupId> <artifactId>avro-maven-plugin</artifactId> <version>1.8.1</version> <executions> <execution> <phase>generate-sources</phase> <goals> <goal>schema</goal> </goals> <configuration> <sourceDirectory>${project.basedir}/src/main/avro/</sourceDirectory> <outputDirectory>${project.basedir}/src/main/java/</outputDirectory> </configuration> </execution> </executions> </plugin> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-compiler-plugin</artifactId> <configuration> <source>1.6</source> <target>1.6</target> </configuration> </plugin> </plugins> </build> </project>注意:以上pom文件配置了自动生成类的路径,即${project.basedir}/src/main/avro/和${project.basedir}/src/main/java/,这样配置之后,在执行mvn命令的时候,这个插件就会自动将此目录下的avsc schema生成类文件,并放到后者这个目录下。如果没有生成avro目录,手动创建一下即可。2、定义schema使用JSON为Avro定义schema。schema由基本类型(null,boolean, int, long, float, double, bytes 和string)和复杂类型(record, enum, array, map, union, 和fixed)组成。例如,以下定义一个user的schema,在main目录下创建一个avro目录,然后在avro目录下新建文件 user.avsc :123456789{"namespace": "lancoo.ecbdc.pre", "type": "record", "name": "User", "fields": [ {"name": "name", "type": "string"}, {"name": "favorite_number", "type": ["int", "null"]}, {"name": "favorite_color", "type": ["string", "null"]} ]}3、编译schema点击maven projects项目的compile进行编译,会自动在创建namespace路径和User类代码4、序列化创建TestUser类,用于序列化生成数据1234567891011121314151617181920212223User user1 = new User();user1.setName("Alyssa");user1.setFavoriteNumber(256);// Leave favorite col or null // Alternate constructorUser user2 = new User("Ben", 7, "red"); // Construct via builderUser user3 = User.newBuilder() .setName("Charlie") .setFavoriteColor("blue") .setFavoriteNumber(null) .build(); // Serialize user1, user2 and user3 to diskDatumWriter<User> userDatumWriter = new SpecificDatumWriter<User>(User.class);DataFileWriter<User> dataFileWriter = new DataFileWriter<User>(userDatumWriter);dataFileWriter.create(user1.getSchema(), new File("user_generic.avro"));dataFileWriter.append(user1);dataFileWriter.append(user2);dataFileWriter.append(user3);dataFileWriter.close();执行序列化程序后,会在项目的同级目录下生成avro数据user_generic.avro内容如下:Objavro.schema{"type":"record","name":"User","namespace":"lancoo.ecbdc.pre","fields":[{"name":"name","type":"string"},{"name":"favorite_number","type":["int","null"]},{"name":"favorite_color","type":["string","null"]}]}5、反序列化通过反序列化代码解析avro数据1234567891011// Deserialize Users from diskDatumReader<User> userDatumReader = new SpecificDatumReader<User>(User.class);DataFileReader<User> dataFileReader = new DataFileReader<User>(new File("user_generic.avro"), userDatumReader);User user = null;while (dataFileReader.hasNext()) { // Reuse user object by passing it to next(). This saves us from // allocating and garbage collecting many objects for files with // many items. user = dataFileReader.next(user); System.out.println(user);}执行反序列化代码解析user_generic.avroavro数据解析成功。6、将user_generic.avro上传至hdfs路径12hdfs dfs -mkdir -p /tmp/lztest/hdfs dfs -put user_generic.avro /tmp/lztest/7、配置flinkserver准备avro jar包将flink-sql-avro-*.jar、flink-sql-avro-confluent-registry-*.jar放入flinkserver lib,将下面的命令在所有flinkserver节点执行123cp /opt/huawei/Bigdata/FusionInsight_Flink_8.1.2/install/FusionInsight-Flink-1.12.2/flink/opt/flink-sql-avro*.jar /opt/huawei/Bigdata/FusionInsight_Flink_8.1.3/install/FusionInsight-Flink-1.12.2/flink/libchmod 500 flink-sql-avro*.jarchown omm:wheel flink-sql-avro*.jar同时重启FlinkServer实例,重启完成后查看avro包是否被上传hdfs dfs -ls /FusionInsight_FlinkServer/8.1.2-312005/lib8、编写FlinkSQL1234567891011121314151617181920212223242526CREATE TABLE testHdfs( name String, favorite_number int, favorite_color String) WITH( 'connector' = 'filesystem', 'path' = 'hdfs:///tmp/lztest/user_generic.avro', 'format' = 'avro');CREATE TABLE KafkaTable ( name String, favorite_number int, favorite_color String) WITH ( 'connector' = 'kafka', 'topic' = 'testavro', 'properties.bootstrap.servers' = '96.10.2.1:21005', 'properties.group.id' = 'testGroup', 'scan.startup.mode' = 'latest-offset', 'format' = 'avro');insert into KafkaTableselect *from testHdfs;保存提交任务9、查看对应topic中是否有数据FlinkSQL解析avro数据成功。转载自https://www.jb51.net/article/233454.htm
-
## EI企业智能2022年4月高热贴合集 以下是EI企业智能板块在2022年4月份的高热贴的合集。从合集中基本可以看出,本月DWS板块的热度是相对比较高的。 ## 数仓GaussDB(DWS) dws-分区表,可以根据字段值分区吗:https://bbs.huaweicloud.com/forum/thread-185029-1-1.html GAUSSDB200 怎么样通过系统表批量查看所有的表是行存储、还是例存储方式?:https://bbs.huaweicloud.com/forum/thread-185026-1-1.html GaussDB A 8.0.0.1线下版本,100+节点时,其中50+节点为扩容时加入,使用一段时间后存在原本节点和扩容节点存在:https://bbs.huaweicloud.com/forum/thread-184869-1-1.html There is no hash distributable column:https://bbs.huaweicloud.com/forum/thread-184799-1-1.html 【DWS】【登录认证】如何实现免密登录?:https://bbs.huaweicloud.com/forum/thread-184822-1-1.html gds建立外表固定字段长度含中文字符报错: https://bbs.huaweicloud.com/forum/thread-185940-1-1.html copy query 与copy table 语法执行效率问题:https://bbs.huaweicloud.com/forum/thread-185667-1-1.html 高斯数据库select和drop某个表报错:https://bbs.huaweicloud.com/forum/thread-185310-1-1.html like '%XXX%' 这种条件的语句如何优化性能:https://bbs.huaweicloud.com/forum/thread-185581-1-1.html GaussDB DWS对磁盘数量的要求:https://bbs.huaweicloud.com/forum/thread-186188-1-1.html GaussDB A 800版本,使用连接池疑问:https://bbs.huaweicloud.com/forum/thread-186100-1-1.html spark 读hive 写gaussdb 问题求助:https://bbs.huaweicloud.com/forum/thread-186137-1-1.html 【GaussDB DWS】请问有没有适用于Euler-aarch64系统的GaussDB性能测试工具?:https://bbs.huaweicloud.com/forum/thread-186136-1-1.html ## ModelArts 【ModelArts产品】【训练管理功能】无法解决error: unrecognized arguments:https://bbs.huaweicloud.com/forum/thread-184768-1-1.html 用ModelArts预训练完Bert后,想进行网络评估,为什么无法找到评估数据集? https://bbs.huaweicloud.com/forum/thread-185981-1-1.html 使用官方的bert源码,运行报错run task error: https://bbs.huaweicloud.com/forum/thread-185786-1-1.html 【vscode插件】链接实例后打不开:https://bbs.huaweicloud.com/forum/thread-185729-1-1.html 【npu_convert_dropout】无法导入npu_convert_dropout:https://bbs.huaweicloud.com/forum/thread-185424-1-1.html ## MRS 【MRS产品】【hive功能】报错 return code 2 from org.apache.hadoop.hive.ql:https://bbs.huaweicloud.com/forum/thread-184739-1-1.html 华为云mrs中habse如何按照时间戳查询habse数据并抽取到关系数据库中?:https://bbs.huaweicloud.com/forum/thread-184891-1-1.html ## 自然语言处理 【知识图谱】【产品文档】文档中“创建信息抽取模型”中“准备数据”问题:https://bbs.huaweicloud.com/forum/thread-185008-1-1.html 【知识图谱】【模型】MRC-BM中Dataset数据创建和修改问题:https://bbs.huaweicloud.com/forum/thread-185846-1-1.html ## 数据湖处理中心DGC 数据开发-hive脚本页面如何使用变量:https://bbs.huaweicloud.com/forum/thread-184952-1-1.html 【DGC产品】【规范设计功能】拉链表和镜像表一类应该放在哪一层:https://bbs.huaweicloud.com/forum/thread-184669-1-1.html 请问怎么把乌兰一数据同步到乌兰二零三中,环境防火墙是否可以打通:https://bbs.huaweicloud.com/forum/thread-184511-1-1.html 作业开发-restClient模块如何操作MRS的es索引:https://bbs.huaweicloud.com/forum/thread-185459-1-1.html ## DIS DIS添加转储MRS任务时填写HDFS路径显示无效的: https://bbs.huaweicloud.com/forum/thread-185767-1-1.html ## FusionInsight kafka接口调用样例中,创建机机账号测试时,身份认证报错:https://bbs.huaweicloud.com/forum/thread-185886-1-1.html FI产品 使用idea本地调式spark sql 如何配置:https://bbs.huaweicloud.com/forum/thread-185621-1-1.html 【mrs产品】【hive功能】springboot启动可以登录zk,hive连接执行语句报错:https://bbs.huaweicloud.com/forum/thread-185497-1-1.html 【Spark】【提交任务】提交Spark任务时,报错找不到主类:https://bbs.huaweicloud.com/forum/thread-186395-1-1.html
-
本文分享自华为云社区《[GaussDB(DWS) 时间域函数](https://bbs.huaweicloud.com/blogs/317197?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=ei&utm_content=content)》,作者: 积少成多。 # 1. 什么是时间域函数,有哪些? 时间域函数是指数据库内获时间戳每部分值的函数。现有的时间域函数包括: 1) quarter函数:获取季度 2) hour函数:获取小时数 3) minute函数:获取分钟数 4) second函数:获取秒数 5) microsecond函数:获取微秒数。 # 2. 时间域函数参数的解析 时间域函数的入参类型有四种,包括: 1) date类型 2) timestamp/timestamptz类型 3) time/timetz类型 4) text类型。text类型的输入会根据输入格式转换为对应的date、timestamp/timestamptz或time类型。  时间域函数入参支持类型表 参数解析支持时区设置,当输入参数含时区时,结果会转换为当前时区。以下用例中,数据库的默认时区为+08:00时区。  # 3. 结果展示  # 4.总结 时间域函数是为获取时间戳各部分值而增加的函数。支持对text类型入参的的解析,使text类型入参进行隐式转换,解析成为对应时间戳类型获取目标值,更贴近实际场景。 **想了解GuassDB(DWS)更多信息,欢迎微信搜索“GaussDB DWS”关注微信公众号,和您分享最新最全的PB级数仓黑科技,后台还可获取众多学习资料哦~**
-
了解鲲鹏BoostKit大数据机器学习算法,更多详情可参见鲲鹏文档中心:https://www.hikunpeng.com/document/detail/zh/kunpengbds/appAccelFeatures/algorithmaccelf_ml
-
本文分享自华为云社区《[Hive执行原理](https://bbs.huaweicloud.com/blogs/348195?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content)》,作者: JavaEdge 。 MapReduce简化了大数据编程的难度,使得大数据计算不再是高不可攀的技术圣殿,普通工程师也能使用MapReduce开发大数据程序。但是对于经常需要进行大数据计算的人,比如从事研究商业智能(BI)的数据分析师来说,他们通常使用SQL进行大数据分析和统计,MapReduce编程还是有一定的门槛。而且如果每次统计和分析都开发相应的MapReduce程序,成本也确实太高了。 有没有更简单的办法,可以直接将SQL运行在大数据平台? 先看如何用MapReduce实现SQL数据分析。 # MapReduce实现SQL的原理 常见的一条SQL分析语句,MapReduce如何编程实现? ```mysql ` SELECT pageid, age, count(1) FROM pv_users GROUP BY pageid, age;` ``` 统计分析语句,统计不同年龄用户访问不同网页的兴趣偏好,具体数据输入和执行结果:  - 左边,要分析的数据表 - 右边,分析结果 把左表相同的行求和,即得右表,类似WordCount计算。该SQL的MapReduce的计算过程,按MapReduce编程模型 - map函数的输入K和V,主要看V V就是左表中每行的数据,如1, 25> - map函数的输出就是以输入的V作为K,V统一设为1 比如1, 25>, 1> map函数的输出经shuffle后,相同的K及其对应的V被放在一起组成一个,作为输入交给reduce函数处理。比如2, 25>, 1>被map函数输出两次,那么到了reduce这里,就变成输入2, 25>, 1, 1>>,这里的K是2, 25>,V集合是1, 1>。 在reduce函数内部,V集合里所有的数字被相加,然后输出。所以reduce的输出就是2, 25>, 2>  如此,一条SQL就被MapReduce计算好了。 在数据仓库中,SQL是最常用的分析工具,既然一条SQL可以通过MapReduce程序实现,那有无工具能自动将SQL生成MapReduce代码?这样数据分析师只要输入SQL,即可自动生成MapReduce可执行的代码,然后提交Hadoop执行。这就是Hadoop大数据仓库Hive。 # Hive架构 Hive能直接处理我们输入的SQL(Hive SQL语法和数据库标准SQL略不同),调用MapReduce计算框架完成数据分析操作。  通过Hive Client(Hive的命令行工具,JDBC等)向Hive提交SQL命令: - 若为DDL,Hive会通过执行引擎Driver将数据表的信息记录在Metastore元数据组件,该组件通常用一个关系数据库实现,记录表名、字段名、字段类型、关联HDFS文件路径等这些数据库的元信息 - 若为DQL,Driver就会将该语句提交给自己的编译器Compiler进行语法分析、语法解析、语法优化等一系列操作,最后生成一个MapReduce执行计划。然后根据执行计划生成一个MapReduce的作业,提交给Hadoop MapReduce计算框架处理。 对一个简单的SQL命令: ```mysql SELECT * FROM status_updates WHERE status LIKE ‘michael jackson’; ``` 其对应的Hive执行计划:  Hive内部预置了很多函数,Hive执行计划就是根据SQL语句生成这些函数的DAG(有向无环图),然后封装进MapReduce的map、reduce函数。该案例中的map函数调用了三个Hive内置函数TableScanOperator、FilterOperator、FileOutputOperator,就完成了map计算,而且无需reduce函数。 # Hive如何实现join操作 除了简单的聚合(group by)、过滤(where),Hive还能执行连接(join on)操作。 pv_users表的数据在实际中无法直接得到,因为pageid数据来自用户访问日志,每个用户进行一次页面浏览,就会生成一条访问记录,保存在page_view表中。而age年龄信息则记录在用户表user。  这两张表都有一个相同的字段userid,据该字段可连接两张表,生成前面例子的pv_users表: ```mysql SELECT pv.pageid, u.age FROM page_view pv JOIN user u ON (pv.userid = u.userid); ``` 该SQL命令也能转化为MapReduce计算,连接过程如下:  join的MapReduce计算过程和前面的group by稍有不同,因为join涉及两张表,来自两个文件(夹),所以需要在map输出的时候进行标记,比如来自第一张表的输出Value就记录为1, X>,这里的1表示数据来自第一张表。这样经过shuffle以后,相同的Key被输入到同一个reduce函数,就可以根据表的标记对Value数据求笛卡尔积,用第一张表的每条记录和第二张表的每条记录连接,输出就是join的结果。 所以打开Hive源码,看join相关代码,会看到一个两层for循环,对来自两张表的记录进行连接操作。 # 总结 开发无需经常编写MapReduce程序,因为网站最主要的大数据处理就是SQL分析,因此Hive在大数据应用很重要。 随Hive普及,我们对在Hadoop上执行SQL的需求越强,对大数据SQL的应用场景也多样化起来,于是又开发了各种大数据SQL引擎。 Cloudera开发了Impala,运行在HDFS上的MPP架构的SQL引擎。和MapReduce启动Map和Reduce两种执行进程,将计算过程分成两个阶段进行计算不同,Impala在所有DataNode服务器上部署相同的Impalad进程,多个Impalad进程相互协作,共同完成SQL计算。在一些统计场景中,Impala可做到ms级计算速度。 后来Spark诞生,也推出自己的SQL引擎Shark,即Spark SQL,将SQL语句解析成Spark的执行计划,在Spark上执行。由于Spark比MapReduce快很多,Spark SQL也相应比Hive快很多,并且随着Spark的普及,Spark SQL也逐渐被人们接受。后来Hive推出了Hive on Spark,将Hive的执行计划转换成Spark的计算模型。 我们还希望在NoSQL执行SQL,毕竟SQL发展几十年,积累庞大用户,很多人习惯用SQL解决问题。于是Saleforce推出了Phoenix,一个执行在HBase上的SQL引擎。 这些SQL引擎只支持类SQL语法,并不能像数据库那样支持标准SQL,特别是数据仓库领域几乎必然会用到嵌套查询SQL:在where条件里面嵌套select子查询,但几乎所有的大数据SQL引擎都不支持。然而习惯于传统数据库的使用者希望大数据也能支持标准SQL。 回到Hive。Hive本身的技术架构其实并没有什么创新,数据库相关的技术和架构已经非常成熟,只要将这些技术架构应用到MapReduce上就得到了Hadoop大数据仓库Hive。但是想到将两种技术嫁接到一起,却是极具创新性的,通过嫁接产生出的Hive极大降低大数据的应用门槛,也使Hadoop得到普及。 >参考 - https://learning.oreilly.com/library/view/hadoop-the-definitive/9781491901687/ch17.html#TheMetastore
-
1.说明 正常在提交任务时,Hive都是提交在yarn上面。启动local模式的目的就是让hive的任务不运行在yarn上面,直接当前的服务器执行任务。2.优点当我们对Hive的源码进行Debug,且代码需要Debug到每个task内部时,如果任务是执行在yarn模式的话,那么是无法打断点的,需要进入local模式才能打断点3.MR当引擎为MR时,需要修改以下参数,可以修改配置文件hive-site.xml,也可以通过set来生效3.1 hive-site.xml<property> <name>hive.exec.mode.local.auto</name> <value>true</value> </property> <property> <name>hive.exec.mode.local.auto.inputbytes.max</name> <value>134217728</value> </property> <property> <name>hive.exec.mode.local.auto.input.files.max</name> <value>10</value> </property>3.2 set模式# 是否开启local模式 set hive.exec.mode.local.auto=true; # 输入最大数据量,默认128MB set hive.exec.mode.local.auto.inputbytes.max=134217728; # 最大任务数 set hive.exec.mode.local.auto.input.files.max=10;4.Tez当引擎为MR时,需要修改tez的配置文件tez-site.xml,如果通过set来执行将不生效4.1 tez-site.xml<property> <name>tez.local.mode</name> <value>true</value> </property> <property> <name>tez.grouping.split-count</name> <value>1</value> </property>说明:tez.grouping.split-count和上面的hive.exec.mode.local.auto.input.files.max类似
-
4月14日,“2022分布式存储线上峰会”成功举行。本次峰会由百易传媒(DOIT)与厦门大学信息学院联合主办,中国计算机学会信息存储专委会、中国计算机行业协会信息存储与安全专委会、武汉光电国家研究中心协办,吸引了近50万观众参与直播和互动交流。不久前,中共中央、国务院在“关于加快建设全国统一大市场的意见”中提到:加快培育数据要素市场,建立健全数据安全、权利保护、跨境传输管理、交易流通、开放共享、安全认证等基础制度和标准规范,深入开展数据资源调查,推动数据资源开发利用。数据要素市场的提出,为分布式存储和数据存储市场带来重要发展机遇。中国计算机学会信息存储专委会主任委员、清华大学计算机科学与技术系教授、厦门大学信息学院院长舒继武在峰会开幕致词中表示:“从技术形态来看,分布式存储在可扩展性、灵活性等方面的优势更适合解决数据要素市场发展过程中所面临的数据存储与管理问题。”主流厂商积极参与,分布式存储市场快速增长云计算、5G、物联网、人工智能等新技术的快速应用,以及传统产业的数字化转型加速,带来海量数据的规模化聚集;IDC预计,未来五年软件定义存储市场的复合增长率将达到23.4%,到2025年分布式存储的市场空间将达到325亿美元。层出不穷的数据形态、不断变化的部署环境、随时出现的安全隐患等,都对存储技术发展提出了新的要求。分布式存储凭借高安全性、可靠性、可用性以及易于扩展等特性得到了快速发展,“十四五”规划更是将超大规模分布式存储技术创新列在数字经济重点产业云计算专项的首要位置,大批优秀的分布式存储供应商争相发力这一赛道。当天的峰会上,英特尔数据中心与人工智能事业部副总裁、英特尔傲腾事业部总经理David Tuhy探讨了如何通过基础设施现代化来帮助客户实现云原生数字化转型;浪潮信息存储产品线分布式存储总经理姜乐果在主题演讲中指出,数据要素是数字经济发展核心引擎,浪潮信息是聚焦于智慧计算战略,面向智慧时代与算力、算法、数据、网络四大支柱持续构筑数字信息的基础设施;新华三集团存储产品线副总经理兼首席产品经理关天舒指出,分布式存储必须拥有极致的性能表现和极智的管理体验,新华三正以极速和智能重塑下一代分布式存储;中国电信集团有限公司云计算首席专家江峰在峰会上表示,中国电信天翼云正致力于以创新的手段减少用户不必要的投资,降低数据中心能耗,推进“双碳”国家战略。据悉,峰会还设置了分布式存储技术应用和混合云数据管理两个分论坛。分布式存储论坛上,联想凌拓资深产品经理吴静介绍了联想凌拓面向海量的非结构化数据打造全自研分布式存储及与本地硬件、芯片、操作系统和存储软件全面国产化的历程;宏杉科技产品部副总工程师谢勇介绍了宏杉MOFS分布式存储系统针对用户的业务需求提供文件、对象、大数据方面差异化的存储资源服务;深信服存储产品线副总经理田皓野表示,深信服存储始终秉持“敬畏数据、充分实践”理念,以更好的方案应对客户业务发展对存储技术架构变化带来的挑战,共同创造数据宏图;在房地产行业创造了多个信息化第一的上海锐通管理咨询有限公司总经理、房地产CIO联盟秘书长罗艳兵分析了企业数字化建设过程中遇到种种困惑,引导企业有效整合和运用内外资源快速转型突围,最终实现数据价值的最大化。此外,来自中国移动云、中国建设银行、腾讯云、阿里云智能、戴尔科技集团合作伙伴荣联科技等企业代表分别就分布式存储技术创新、分布式存储的应用、云原生与SDS、混合云与数据管理等热点话题展开讨论。把脉分布式存储市场,峰会两大研究成果发布本次峰会的亮点之一是《2022分布式存储市场调研报告》的同期发布。该报告从市场、应用和实践的维度,对分布式存储产品技术应用中的热点问题进行了深入解读,分析和预测了分布式存储市场规模。报告对坊间关于分布式存储基本概念的认识误区进行了纠偏,厘清了分布式存储与集中式存储、软件定义存储、云存储等其他相关技术的关系,并对分布式存储的发展趋势、重要特性、市场规模、参与角色、选型应用、场景及成效进行深度阐述,可以说,这篇调研报告对分布式存储概念与分类进行了“重新定义”。与此同时,“2022分布式存储企业图鉴”也于峰会当天正式发布。图鉴集中展示了分布式存储赛道上的50余家代表厂商,吸引了存储专家和企业IT用户的广泛关注。见证分布式存储产业五年变迁,驱动中国数据要素快速发展从2018年开始,分布式存储峰会已经先后在北京、深圳、上海等地连续成功举办了四届,峰会见证了分布式存储产业五年的快速发展。百易传媒(DOIT)持续跟踪分布式存储产业技术发展和行业应用趋势,与业内领军企业携手,将分布式存储领域最新的技术发展趋势和典型行业应用实践呈现给广大用户,推动各行业数字化转型进程。“计算和网络性能的提升,闪存性能的不断突破,为分布式存储的创新奠定了基础,分布式存储系统在性能、可管理性等方面也在不断进步。全球范围内,包括中国市场诞生了多家主打分布式存储技术的创新企业,而且呈现良好的发展态势。”舒继武教授最后呼吁:“让我们携手共同努力,为中国数据要素市场的发展贡献力量!“来源:IT168
-
 1. 数字经济和数字化转型1.1. 数字经济成为未来竞争的主战场数字经济是未来世界经济竞争格局的战略高地。国家十四五规划与 2035远景目标纲要已发布,其中数字中国建设对未来中国数字化转型及其数字中国建设的一系列重大方针政策都做出了相关的规定。1.2. 疫情加速数字经济的发展1.3. 数字化使企业的工作流程更加高效敏捷1.4. 数字化转型的核心价值1.5. 数字技术全面融入社会交往和日常生活在国家十四五规划里,对数字社会建设做出了一系列重要部署。比如数字技术全面融入社会交往和日常生活,提供智慧便捷的公共服务,促进公共服务和社会运行方式创新,建设新型智慧城市,构建国民美好数字生活新图景,推进全民美好数字生活等,这在一定意义上为未来的数字社会建设指明了方向。未来的趋势是通过数字化转型,数字驱动生活方式的变革。趋势一:社会数字化将在未来五年进一步上升。目前我国的数字化普及率刚刚超过 70%,与发达国家还有一定差距、存在较大提升空间;趋势二:民生相关的医疗、教育、社保、养老、就业等数字化水平将大幅提高;趋势三:数字孪生技术与城市的结合,智慧城市建设将得到快速发展;趋势四:数据经济时代,数字消费者对数字化转型将产生更大的影响。2. 新技术对行业应用场景的影响2.1. 2021年Gartner数字商务技术成熟度据 Gartner发布的 2021年数字商务技术成熟度曲线,虚拟客户助理、数字钱包、可视化配置、客户身份和访问管理等数字商务技术已到了稳步爬升期,并有望在 2年内到达生产成熟期。数字体验平台、客户主数据管理、产品主数据管理等技术,也将在 2-5年内到达生产成熟期。2.2. ICT技术与经济社会深度融合2.3. 5G技术在各行业的应用场景2.4. 大数据技术在各行业中应用的深度和广度从应用的功能和成效来看,大数据技术应用的价值主要体现在降本增效、精准营销、决策支持三个方面,其应用的深度和广度,在不同行业呈现不同的侧重点。2.5. 人工智能技术中重点领域应用场景从产业链来看人工智能产业链主要有三个核心层:基础层、技术层及应用层。计算机能力和平台的发展,是人工智能技术和应用实现的基础,计算机视觉、语音识别、自然语言处理、机器学习、大数据服务等技术的实现,是人工智能应用落地的保障。从应用层看人工智能产业主要有智慧城市、智慧生产、智慧生活三大类应用领域,在制造业、电力电网、交通运输三大行业已形成规模应用,主要落地应用有以下十大场景:无人驾驶汽车、人脸识别、机器翻译、声纹识别、智能客服机器人、智能外呼机器人、智能音箱、个性化推荐、医学图像处理、图像搜索等。3. 企业数字化转型通过数字化转型,实现跨层级、跨地域、跨系统、跨部门、跨业务的协同管理,打造组件化、松耦合的中台能力,将数字技术与企业需求相融合,释放数字化转型的真正价值。3.1. 企业数字化阶段企业数字化阶段,可以划分成以下四个阶段:基础信息化应用数字化全面系统化智慧生态化数字化转型各阶段的基本特征和典型应用3.2. 数字化实施策略企业在实施数字化阶段的过程中,可以基于以下实施策略:3.2.1. 基于单个业务场景基于单个业务场景数字化为启动点的方法,以点带面,逐步实施,反复迭代,最终带动企业的整体转型。通过单点突破 -> 局部扩散 —> 复制推广 -> 全面融合 —> 优化创新的路径,推动研发、产品、装备、生产、管理、服务等业务场景数字化、网络化、智能化转型,逐步搭建和完善企业内部数字化管理平台。3.2.2. 基于新技术的应用场景基于工业互联网,通过人工智能、5G、物联网、云计算、大数据、数字孪生、精益制造等数字技术创新应用手段,建设具有“柔性化、智能化、数字化”特征的智能工厂。3.2.3. 基于供应链协同服务场景基于资源对接、协同生产等供应链协同模式新业态,打造行业供应链协同服务平台,推动行业上下游分散资源的有效汇聚与广泛共享。3.3. 数字化转型场景落地线路图企业数字化转型场景企业数字化转型场景指的是在特定时间、空间/地点、人物对象,以生产经营活动为中心使用各类数字化手段,将业务活动的各动作,按照相关的关联关系,完成特定的业务流程,面向生产经营活动中特定的活动问题对应的解决方案构成的相关过程,构建起的碎片化流程及流程对象构成的各类关系。围绕场景的转变所带来的价值,逐步汇集转变中需要的技术、平台、运营、组织管理的需求,通过迭代的方式,逐步的完成数字化的转型。场景要素数字化首先将场景的基本信息进行收集及结构化,即填写背景及目标,深入总结场景建设的背景、痛点问题和建设的目标,通过场景要素的构成性描述场景企业可以深入的了解在特定的时间空间、组织角色、场景活动及其相关的应用、设备、信息等多维度的相关信息。通过场景描述澄清场景对应的需求及场景活动等细节将围绕场景活动及产生相应的数字应用、机器设备、数据信息、数字技术等场景对象的协作关系完整表述出来。数字化场景是不断迭代的,随着新技术、新设备不断涌现,新技术和原有场景可以多次形成新的组合,从而不断向全感知、全联接、全智能的数字化场景发展,所以场景要素是迭代优化的基础,需要完成全面的场景要素清单。场景资源数字化将场景涉及的平台、场景节点等通过数字化的手段进行相关的系统平台支撑的方式承载相关功能及其相关流程,通过数字化智能化系统的建设、业务能力承载。将各场景节点相关的标准业务服务、场景节点业务流程进行自动化、智能化的能力升级、从而将传统由不同的业务角色及其相关组织中的人完成的业务动作转变成部分或全部由自动化、数字化、智能化的系统承载完成。并将相关的业务流程中设计的标准动作以系统功能点的形式落地到对应应用系统建设过程中。完成对应的系统建设后形成对应的标准化应用服务。场景设备数字化将场景涉及的设备、基础设施等通过数据自豪的手段进行相关的设备互通互联建设,通过将设备进行数字孪生的建设,进行设备及基础设施的数字化改造升级及现实世界的数字化同构模型的建设。3.3.1. 数字化转型场景建设五步设计法步骤一: 场景的价值按照场景价值发现法,通过各类调研发现企业场景现状与问题、将相关场景下的业务需求进行需求分析。并针对各类需求制定对应的转型目标。步骤二:场景的技术创新将场景涉及的业务流程进行业务融合新型技术的创新设计,将对应的场景进行技术改造和业务升级形成创新场景。步骤三:场景的生态通过场景生态构建以场景为核心的多维度、供需能力结合的场景生态供给侧与需求侧的拉通,形成特色的生态解决能力提供场景服务。步骤四:场景的长效机制将场景设计建设成效及其未来的运营机制进行相关设计,通过场景运营建立场景的长效培育机制,解决场景相关能力上线后的目标效果评估、目标场景的迭代等相关问题。形成场景能力的长效运营使场景节点目标更好的得到能力升级及产品迭代。步骤五:场景的组织建设将场景涉及的角色、组织、平台装备等一系列相关方进行组织变革、平台能力中心建设设计。形成场景能力建设完成后的组织文化保障,更好的通过组织能力长效服务及建设相关场景能力。3.4. 企业数字化转型场景案例3.4.1. 智能制造数字化转型及重要场景路线图智能制造行业数字化发展路线总结为管理数字化、生产数字化、生产智能化、产业数字化四个阶段总路线,数字化文化和能力的培养贯穿整个数字化发展进程,在每个阶段具有代表性的重点场景.3.4.2. 能源行业数字化转型及重要场景路线图能源行业数字化发展路线总结为业务数字化、数据资产化、海外赋能、数字化生态四个阶段路线,数字化文化和能力的培养贯穿整个数字化发展进程,在每个阶段具有代表性的重点场景。4. 参考华为:数字化转型,从战略到执行华为:华为行业数字化转型方法论白皮书2019[中央企业数字化发展研究院:2021年国有企业数字化转型场景示范和线路图研究白皮书]http://siab.org.cn/2021/12/28/guoqishuzihuazhuanxing/
-
本文分享自华为云社区《[CN与业务并发度的关系-业务并发度不够?CN来帮忙](https://bbs.huaweicloud.com/blogs/342917?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=ei&utm_content=content)》,作者:闻鲜生 。 # 一、CN的作用是什么? CN全称协调节点(Coordinator Node)。是和用户关系最密切也是DWS内部非常重要的一个组件,它负责提供外部应用接口、优化全局执行计划、向Datanode分发执行计划,以及汇总、处理执行结果。 集群中,CN有多个并且CN的角色是对等的(执行DML语句时连接到任何一个CN都可以得到一致的结果)。只需要在CN和应用程序之间增加一个负载均衡器,使得CN对应用是透明的。DWS通过CCN(Control Coordinator Node)负责集群内的资源全局负载控制,以实现自适应的动态负载管理。CM在第一次集群启动时,通过集群部署形式,选择编号最小的CN作为CCN。若CCN故障之后,由CM选择新的CCN进行替换。 ## 一次简单的查询流程如下所示: 1. 用户通过应用程序发出查询本地数据的SQL请求到Coordinator。 2. Coordinator接收用户的SQL请求,分配服务进程,向GTM请求分配全局事务信息。 3. GTM接收到Coordinator的请求,返回全局事务信息给Coordinator。 4. Coordinator根据数据分布信息以及系统元信息,解析SQL为查询计划树,从查询计划树中提取可以发送到Datanode的执行步骤,封装成SQL语句或者子执行计划树,发送到Datanode执行。 5. Datanode接收到读取任务后,查询具体Storage上的本地数据块。 6. Datanode任务执行后,将执行结果返回给Coordinator。 7. Coordinator将查询结果通过应用程序返回给用户。  # 二、CN与业务并发度的关系 CN是外部应用的接口,CN的并发能力直接决定了业务的并发度。单CN的并发能力受如下几个参数控制: max_connections: 允许和数据库连接的最大并发连接数。此参数会影响集群的并发能力。CN节点默认值为800,DN节点默认值为5000。 max_active_statements:设置全局的最大并发数量。此参数只应用到CN,且针对一个CN上的执行作业。默认值60。 CN的max_connections和max_active_statements参数支持用户根据业务并发度诉求修改,详细操作流程如下图: 点击集群详情的“参数修改”页面,搜索需要修改的参数,会显示对应参数和当前值,参数值框里面输入修改值,点击“保存”按钮保存配置。“是否重启集群”栏显示“是”的参数说明需要重启集群生效,请寻找业务空闲期修改。  # 三、CN不够怎么办? 单CN的并发能力会受到硬件资源和拓扑结构的限制,不能无限制调大。DWS是分布式架构集群,此时就要考虑横向扩展,增加更多的CN来提升业务并发度,充分利用分布式架构的优势。 ## o 下发集群时配置更多的CN CN数量在下发DWS集群时可以配置。默认值3个,最少2个,最多不超过“节点数量”,如果节点数量大于20,则CN数量最多可配置20个。如下图所示,在“创建数据仓库集群”的购买页面的“高级配置”选择“自定义”,“CN部署量”即为CN的初始部署数量。  ## o 下发集群后在线添加CN 集群下发后,如果由于业务并发度高导致CN不够用,可以在线添加CN,具体操作如下图所示。增加CN耗时与用户表数量有关,大概10分钟左右,增加CN过程中间有一段时间会锁集群,阻塞DDL语句执行。   # 四、如何做到多个CN负载均衡? 如果集群部署了多个CN,但是怎么做到CN的负载均衡,保证业务并发度和性能最大化呢?DWS提供了弹性负载均衡(Elastic Load Balance,简称ELB)服务。弹性负载均衡可以通过流量分发扩展应用系统对外的服务能力,同时通过消除单点故障提升应用系统的可用性。 - **ELB的配置原理介绍**  - **ELB的绑定方法**  # 五、CN故障了怎么办? 由于DWS的CN角色是对等的,同时对外提供服务,因此必须保证其元数据的强一致性,因此外部应用连接任一个CN执行涉及元数据变更的操作(如DDL,DCL)必须分发到所有的CN同时完成。 如果单个CN故障,会影响所有CN的DDL和DCL操作。目前DWS提供了两个解决方案: **自动剔除CN** 如果集群绑定了弹性负载均衡(ELB),则会自动打开自动剔除CN功能,DWS CM周期性检测CN的状态,如果发现CN连续故障600s,则会立即从整个集群剔除该故障CN,保证其余CN的业务不受到影响。再配合弹性负载均衡服务,会自动把发送到故障CN的作业转发到其他正常CN。 **删除cn介绍** 如果发现集群部分CN故障,或存在亚健康状态,可以选择手动删除故障CN,具体操作流程如下。手动删除CN耗时固定,1分钟左右。   总结:希望通过此文,让你能够对CN作用,CN运维操作,业务并发度有进一步的了解!
-
1.说明在官网下载的最新的Apache Tez在适配Hadoop3.0以上的版本时会存在一些问题,这边打算自己编译安装来适配2.下载tez github源码下载https://github.com/apache/tez/或者可以直接使用wget命令下载wget https://github.com/apache/tez/archive/rel/release-0.10.0.tar.gz --no-check-certificate3.编译tar -zxvf release-0.10.0.tar.gz解压之后的目录:修改pom.xml的hadoop版本修改适配自己版本的hadoop添加配置可用的Maven仓库源 <repositories> <repository> <id>huaweimaven</id> <name>huawei maven</name> <url>https://mirrors.huaweicloud.com/repository/maven/</url> </repository> </repositories>选择不编译tez-ui模块 不影响功能,编译比较耗时间编译命令:mvn clean install -DskipTests4.安装选择/usr/local作为tez的安装目录将编译好的tez包上传到/usr/local目录上mv tez-0.10.0.tar.gz /usr/local tar -zxvf tez-0.10.0.tar.gz ln -s tez-0.10.0 /usr/local/tez上传tez.tar.gz到hdfs在hdfs上创建目录hdfs dfs -mkdir -p /apps/tez hdfs dfs -put tez.tar.gz /apps/tez新增tez-site.xmlcd /usr/local/tez/conf vim tez-site.xml<?xml version="1.0" encoding="UTF-8"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <configuration> <property> <name>tez.lib.uris</name> <value>${fs.defaultFS}/apps/tez/tez.tar.gz</value> </property> <property> <name>tez.use.cluster.hadoop-libs</name> <value>false</value> </property> <property> <name>tez.history.logging.service.class</name> <value>org.apache.tez.dag.history.logging.ats.ATSHistoryLoggingService</value> </property> </configuration>修改hadoop-env.sh所有节点都需要替换cd /usr/local/hadoop/etc/hadoop vim hadoop-env.shexport TEZ_CONF_DIR=/usr/local/tez/conf/tez-site.xml export TEZ_JARS=/usr/local/tez export HADOOP_CLASSPATH=${HADOOP_CLASSPATH}:${TEZ_CONF_DIR}:${TEZ_JARS}/*:${TEZ_JARS}/lib/*修改yarn-site.xml所有节点都需要替换cd /usr/local/hadoop/etc/hadoop vim yarn-site.xml<property> <name>yarn.timeline-service.enabled</name> <value>true</value> </property> <property> <name>yarn.timeline-service.hostname</name> <value>server1</value> </property> <property> <name>yarn.timeline-service.http-cross-origin.enabled</name> <value>true</value> </property> <property> <name>yarn.resourcemanager.system-metrics-publisher.enabled</name> <value>true</value> </property> <property> <name>yarn.timeline-service.generic-application-history.enabled</name> <value>true</value> </property> <property> <name>yarn.timeline-service.address</name>cd <value>server1:10200</value> </property> <property> <name>yarn.timeline-service.webapp.address</name> <value>server1:8188</value> </property> <property> <name>yarn.timeline-service.webapp.https.address</name> <value>server1:8190</value> </property> <property> <name>yarn.timeline-service.leveldb-timeline-store.path</name> <value>${hadoop.tmp.dir}/yarn/timeline</value> <description>Store file name for leveldb timeline store.</description> </property> <property> <name>yarn.timeline-service.ttl-ms</name> <value>604800000</value> <description>Time to live for timeline store data in milliseconds.</description> </property> <property> <name>yarn.timeline-service.bind-host</name> <value>0.0.0.0</value> </property>
yd_264646152
发表于2022-03-29 15:12:29
2022-03-29 15:12:29
最后回复
yd_264646152
2022-03-29 15:12:29
1155 0
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签