-
 >摘要:Kubernetes 很多看起来比较“繁琐”的设计的主要目的,都是希望为开发者提供更多的“可扩展性”,给使用者带来更多的“稳定性”和“安全感”。本文分享自华为云社区《[如何在 Kubernetes 集群中搭建一个复杂的 MySQL 数据库?](https://bbs.huaweicloud.com/blogs/302931?utm_source=zhihu&utm_medium=bbs-ex&utm_campaign=other&utm_content=content)》,作者:zuozewei 。 # 前言 实际生产环境中,为了稳定和高可用,运维团队一般不会把 MySQL 数据库部署在 Kubernetes 集群中,一般是用云厂商的数据库或者自己在高性能机器(如裸金属服务器)上搭建。 但是,对于测试开发环境,我们完全可以把 MySQL 部署到各自的 Kubernetes 集群中,非常有助于提升运维效率,而且还有助于Kubernetes 使用的经验积累。 # 简易部署 如下所示,我们仅需设置 root 用户密码(环境变量 MYSQL_ROOT_PASSWORD), 便可轻松的使用 MySQL 官方镜像构建一个 MySQL 数据库。 apiVersion: extensions/v1beta1 kind: Deployment metadata: labels: app: mysql-min name: mysql-min spec: replicas: 1 selector: matchLabels: app: mysql-min template: metadata: labels: app: mysql-min spec: containers: - image: centos/mysql-57-centos7:latest name: mysql-min imagePullPolicy: IfNotPresent env: - name: MYSQL_ROOT_PASSWORD value: admin@123 创建一 Service 以便集群内外均可访问数据库,其中集群外需通过 nodePort 设置的 30336 端口访问。 apiVersion: v1 kind: Service metadata: labels: app: mysql-min release: mysql-min name: mysql-min namespace: default spec: ports: - name: mysql port: 3306 protocol: TCP nodePort: 30336 targetPort: mysql selector: app: mysql-min #目前sessionAffinity可以提供"None""ClientIP"两种设定: #None: 以round robin的方式轮询下面的Pods。 #ClientIP: 以client ip的方式固定request到同一台机器。 sessionAffinity: None type: NodePort #status: # loadBalancer: {} 接着,访问数据库并验证其运行正常: # kubectl get pod # 当前Pod名称 NAME READY STATUS RESTARTS AGE mysql-min-5b5668c448-t44ml 1/1 Running 0 3h # 通过本机访问 # kubectl exec -it mysql-min-5b5668c448-t44ml -- mysql -uroot -padmin@123 mysql> select 1; +---+ | 1 | +---+ | 1 | +---+ # 集群内部通过mysql service访问: # kubectl exec -it mysql-min-5b5668c448-t44ml -- mysql -uroot -padmin@123 -hmysql mysql> select now(); +---------------------+ | now() | +---------------------+ | 2021-03-13 07:19:14 | +---------------------+ # 集群外部,可通过任何一个 K8S 节点访问数据库: # mysql -uroot -padmin@123 -hworker-1 -P30336 mysql> show databases; +--------------------+ | Database | +--------------------+ | information_schema | | mysql | | performance_schema | | sys | +--------------------+ # 扩展部署 ## 持久化存储 若要确保 MySQL 重启后数据仍然存在,我们需为其配置可持久化存储,我这里的实验环境使用的是 Local Persistent Volume,也就是说,我希望 Kubernetes 能够直接使用宿主机上的本地磁盘目录,而不依赖于远程存储服务,来提供“持久化”的容器 Volume。这样做的好处很明显,由于这个 Volume 直接使用的是本地磁盘,尤其是 SSD 盘,它的读写性能相比于大多数远程存储来说,要好得多。这个需求对本地物理服务器部署的私有 Kubernetes 集群来说,非常常见。 值得指出的是其次,相比于正常的 PV,一旦这些节点宕机且不能恢复时,本地存储 Volume 的数据就可能丢失。这就要求使用 其的应用必须具备数据备份和恢复的能力,允许你把这些数据定时备份在其他位置。 不难想象, Local Persistent Volume 的设计,主要面临两个难点。 **第一个难点在于:如何把本地磁盘抽象成 PV。** 可能你会说,Local Persistent Volume 不就等同于 hostPath 加 NodeAffinity 吗? 比如,一个 Pod 可以声明使用类型为 Local 的 PV,而这个 PV 其实就是一个 hostPath 类型的 Volume。如果这个 hostPath 对应的目录,已经在节点 A 上被事先创建好了。那么,我只需要再给这个 Pod 加上一个 nodeAffinity=nodeA,不就可以使用这个 Volume 了吗? 事实上,你绝不应该把一个宿主机上的目录当作 PV 使用。这是因为,这种本地目录的存储行为完全不可控,它所在的磁盘随时都可能被应用写满,甚至造成整个宿主机宕机。而且,不同的本地目录之间也缺乏哪怕最基础的 I/O 隔离机制。 所以,一个 本地存储 Volume 对应的存储介质,一定是一块额外挂载在宿主机的磁盘或者块设备(“额外”的意思是,它不应该是宿主机根目录所使用的主硬盘)。这个原则,我们可以称为“**一个 PV 一块盘**”。 **第二个难点在于:调度器如何保证 Pod 始终能被正确地调度到它所请求的本地 Volume 所在的节点上呢?** 造成这个问题的原因在于,对于常规的 PV 来说,Kubernetes 都是先调度 Pod 到某个节点上,然后,再通过“两阶段处理”来“持久化”这台机器上的 Volume 目录,进而完成 Volume 目录与容器的绑定挂载。 可是,对于 Local PV 来说,节点上可供使用的磁盘(或者块设备),必须是运维人员提前准备好的。它们在不同节点上的挂载情况可以完全不同,甚至有的节点可以没这种磁盘。 所以,这时候,调度器就必须能够知道所有节点与 Local Persistent Volume 对应的磁盘的关联关系,然后根据这个信息来调度 Pod。 这个原则,我们可以称为“在调度的时候考虑 Volume 分布”。在 Kubernetes 的调度器里,有一个叫作 VolumeBindingChecker 的过滤条件专门负责这个事情。在 Kubernetes v1.11 中,这个过滤条件已经默认开启了。 基于上述讲述,在开始使用 Local Persistent Volume 之前,你首先需要在集群里配置好磁盘或者块设备。在公有云上,这个操作等同于给虚拟机额外挂载一个磁盘,比如 GCE 的 Local SSD 类型的磁盘就是一个典型例子。 而在我们部署的私有环境中,你有两种办法来完成这个步骤。 - 第一种,当然就是给你的宿主机挂载并格式化一个可用的本地磁盘,这也是最常规的操作; - 第二种,对于实验环境,你其实可以在宿主机上挂载几个 RAM Disk(内存盘)来模拟本地磁盘。 接下来,我会使用第二种方法,在我们之前部署的 Kubernetes 集群上进行实践。首先,在名叫 node-1 的宿主机上创建一个挂载点,比如 /mnt/disks;然后,用几个 RAM Disk 来模拟本地磁盘,如下所示: # 在node-1上执行 $ mkdir /mnt/disks $ for vol in vol1 vol2 vol3; do mkdir /mnt/disks/$vol mount -t tmpfs $vol /mnt/disks/$vol done 需要注意的是,如果你希望其他节点也能支持 Local Persistent Volume 的话,那就需要为它们也执行上述操作,并且确保这些磁盘的名字(vol1、vol2 等)都不重复。接下来,我们就可以为这些本地磁盘定义对应的 PV 了,如下所示: apiVersion: v1 kind: PersistentVolume metadata: name: mysql-min-pv-local namespace: default spec: capacity: storage: 5Gi volumeMode: Filesystem accessModes: - ReadWriteOnce storageClassName: "mysql-min-storageclass-local" persistentVolumeReclaimPolicy: Retain #表示使用本地存储 local: path: /mnt/disks/vol1 #使用local pv时必须定义nodeAffinity,Kubernetes Scheduler需要使用PV的nodeAffinity描述信息来保证Pod能够调度到有对应local volume的Node上。 #创建local PV之前,你需要先保证有对应的storageClass已经创建。 nodeAffinity: required: nodeSelectorTerms: - matchExpressions: - key: kubernetes.io/hostname operator: In values: # pod 需要分不到的主机名,这台主机上开启了 local-pv 资源。 - node-1 可以看到,这个 PV 的定义里:local 字段,指定了它是一个 Local Persistent Volume;而 path 字段,指定的正是这个 PV 对应的本地磁盘的路径,即:/mnt/disks/vol1。 当然了,这也就意味着如果 Pod 要想使用这个 PV,那它就必须运行在 node-1 上。所以,在这个 PV 的定义里,需要有一个 nodeAffinity 字段指定 node-1 这个节点的名字。这样,调度器在调度 Pod 的时候,就能够知道一个 PV 与节点的对应关系,从而做出正确的选择。这正是 Kubernetes 实现“在调度的时候就考虑 Volume 分布”的主要方法。 接下来要创建一个 StorageClass 来描述这个 PV,如下所示: kind: StorageClass apiVersion: storage.k8s.io/v1 metadata: name: mysql-min-storageclass-local #指定存储类的供应者,比如aws, nfs等,具体取值参考官方说明。 #存储类有一个供应者的参数域,此参数域决定PV使用什么存储卷插件。参数必需进行设置 #由于demo中使用的是本地存储,所以这里写kubernetes.io/no-provisioner. provisioner: kubernetes.io/no-provisioner #volumeBindingMode 参数将延迟PVC绑定,直到 pod 被调度。 volumeBindingMode: WaitForFirstConsumer 这个 StorageClass 的名字,叫作 local-storage。需要注意的是,在它的 provisioner 字段,我们指定的是 no-provisioner。这是因为 Local Persistent Volume 目前尚不支持 Dynamic Provisioning,所以它没办法在用户创建 PVC 的时候,就自动创建出对应的 PV。也就是说,我们前面创建 PV 的操作,是不可以省略的。 与此同时,这个 StorageClass 还定义了一个 volumeBindingMode=WaitForFirstConsumer 的属性。它是 Local Persistent Volume 里一个非常重要的特性,即:延迟绑定。 >通过这个延迟绑定机制,原本实时发生的 PVC 和 PV 的绑定过程,就被延迟到了 Pod 第一次调度的时候在调度器中进行,从而保证了这个绑定结果不会影响 Pod 的正常调度。 接下来,我们只需要定义一个非常普通的 PVC,就可以让 Pod 使用到上面定义好的 Local Persistent Volume 了,如下所示: apiVersion: v1 items: - apiVersion: v1 kind: PersistentVolumeClaim metadata: #当启用PVC 保护 alpha 功能时,如果用户删除了一个 pod 正在使用的 PVC,则该 PVC 不会被立即删除。PVC 的删除将被推迟,直到 PVC 不再被任何 pod 使用。 #可以看到,当 PVC 的状态为 Teminatiing 时,PVC 受到保护,Finalizers 列表中包含 kubernetes.io/pvc-protection: finalizers: - kubernetes.io/pvc-protection labels: app: mysql-min release: mysql-min name: mysql-min namespace: default spec: #PV 的访问模式(accessModes)有三种: #ReadWriteOnce(RWO):是最基本的方式,可读可写,但只支持被单个 Pod 挂载。 #ReadOnlyMany(ROX):可以以只读的方式被多个 Pod 挂载。 #ReadWriteMany(RWX):这种存储可以以读写的方式被多个 Pod 共享。 accessModes: - ReadWriteOnce resources: requests: storage: 10Gi storageClassName: mysql-min-storageclass-local #表示使用本地磁盘,实际生产中一般都使用nfs。 volumeMode: Filesystem volumeName: mysql-min-pv-local # status: # accessModes: # - ReadWriteOnce # capacity: # storage: 1Gi kind: List 可以看到,这个 PVC 没有任何特别的地方。唯一需要注意的是,它声明的 storageClassName 是 mysql-min-storageclass-local。所以,将来 Kubernetes 的 Volume Controller 看到这个 PVC 的时候,不会为它进行绑定操作。 最后,我们创建 Local Persistent Volume 资源文件: kubectl apply -f mysql-min-pv-local.yaml kubectl apply -f mysql-min-storageclass-local.yaml kubectl apply -f mysql-min-pvc.yaml 而后,调整 Deploy 并挂载卷: spec: containers: - image: centos/mysql-57-centos7:latest ... volumeMounts: - name: data mountPath: /var/lib/mysql volumes: - name: data persistentVolumeClaim: claimName: mysql-min ## 自定义配置文件 通过创建 configmap 并挂载到容器中,我们可自定义 MySQL 配置文件。如下所示,名为 mysql-config 的 cm 包含一个 my.cnf 文件: apiVersion: v1 kind: ConfigMap metadata: name: mysql-config data: my.cnf: | [mysqld] default_storage_engine=innodb skip_external_locking lower_case_table_names=1 skip_host_cache skip_name_resolve max_connections=2000 innodb_buffer_pool_size=8589934592 init_connect='SET collation_connection = utf8_unicode_ci' init_connect='SET NAMES utf8' character-set-server=utf8 collation-server=utf8_unicode_ci skip-character-set-client-handshake query_cache_type=0 innodb_flush_log_at_trx_commit = 0 sync_binlog = 0 query_cache_size = 104857600 slow_query_log =1 slow_query_log_file=/var/lib/mysql/slow-query.log log-error=/var/lib/mysql/mysql.err long_query_time = 0.02 table_open_cache_instances=16 table_open_cache = 6000 skip-grant-tables sql_mode=STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_AUTO_CREATE_USER,NO_ENGINE_SUBSTITUTION 将 configmap 挂载到容器内: spec: containers: - image: centos/mysql-57-centos7:latest volumeMounts: - name: mysql-config mountPath: /etc/my.cnf.d/my.cnf subPath: my.cnf volumes: - name: mysql-config - name: mysql-config configMap: name: mysql-config ## 设置容器时区 最傻瓜也最方便的处理方式,设置宿主机时区和时间文件与容器的映射。 spec: containers: - image: centos/mysql-57-centos7:latest volumeMounts: - name: localtime readOnly: true mountPath: /etc/localtime volumes: - name: localtime hostPath: type: File path: /etc/localtime ## 加密敏感数据 用户密码等敏感数据以 Secret 加密保存,而后被 Deployment 通过 volume 挂载或环境变量引用。如本例,我们创建root、user用户,将用户的密码加密保存: apiVersion: v1 data: #将mysql数据库的所有user的password配置到secret,统一管理 mysql-password: YWRtaW4= mysql-root-password: OVplTmswRGdoSA== kind: Secret metadata: labels: app: mysql-min release: mysql-min name: mysql-min namespace: default #Secret有三种类型: #Opaque:base64编码格式的Secret,用来存储密码、密钥等;但数据也通过base64 –decode解码得到原始数据,所有加密性很弱。 #kubernetes.io/dockerconfigjson:用来存储私有docker registry的认证信息。 #kubernetes.io/service-account-token: 用于被serviceaccount引用。serviceaccout创建时Kubernetes会默认创建对应的secret。Pod如果使用了serviceaccount,对应的secret会自动挂载到Pod目录/run/secrets/ kubernetes.io/serviceaccount中。 type: Opaque Secret 创建完成后,我们将用户明文密码从 Deployment 去除,采用环境变量方式引用 Secret 数据,参见如下 Yaml 修改: root 用户及 MYSQL_USER 用户,其密码均通过 secretKeyRef 从 secret 获取。 spec: containers: - image: centos/mysql-57-centos7:latest name: mysql-min imagePullPolicy: IfNotPresent env: #password存储在secret中 - name: MYSQL_ROOT_PASSWORD valueFrom: secretKeyRef: key: mysql-root-password name: mysql-min - name: MYSQL_PASSWORD valueFrom: secretKeyRef: key: mysql-password name: mysql-min - name: MYSQL_USER value: zuozewei ## 容器健康检查 K8S 镜像控制器可通过 livenessProbe 判断容器是否异常,进而决定是否重建容器;而 Service 服务可通过 readinessProbe 判断容器服务是否正常,从而确保服务可用性。 本例配置的 livenessProbe 与 readinessProbe 是一样的,即连续 3 次查询数据库失败,则定义为异常。对 livenessProbe 与readinessProbe 详细用法,不在本文的讨论范围内,可参考 K8S 官方文档: - Configure Liveness and Readiness Probes - Pod Lifecycle spec: containers: image: centos/mysql-57-centos7:latest #kubelet 使用 liveness probe(存活探针)来确定何时重启容器。例如,当应用程序处于运行状态但无法做进一步操作,liveness 探针将捕获到 deadlock,重启处于该状态下的容器,使应用程序在存在 bug 的情况下依然能够继续运行下去 livenessProbe: exec: command: - /bin/sh - "-c" - MYSQL_PWD="${MYSQL_ROOT_PASSWORD}" - mysql -h 127.0.0.1 -u root -e "SELECT 1" failureThreshold: 3 #探测成功后,最少连续探测失败多少次才被认定为失败。默认是 3。最小值是 1。 initialDelaySeconds: 30 #容器启动后第一次执行探测是需要等待多少秒。 periodSeconds: 10 #执行探测的频率。默认是10秒,最小1秒。 successThreshold: 1 #探测失败后,最少连续探测成功多少次才被认定为成功。默认是 1。对于 liveness 必须是 1。最小值是 1。 timeoutSeconds: 5 #探测超时时间。默认1秒,最小1秒。 #Kubelet 使用 readiness probe(就绪探针)来确定容器是否已经就绪可以接受流量。只有当 Pod 中的容器都处于就绪状态时 kubelet 才会认定该 Pod处于就绪状态。该信号的作用是控制哪些 Pod应该作为service的后端。如果 Pod 处于非就绪状态,那么它们将会被从 service 的 load balancer中移除。 readinessProbe: exec: command: - /bin/sh - "-c" - MYSQL_PWD="${MYSQL_ROOT_PASSWORD}" - mysql -h 127.0.0.1 -u root -e "SELECT 1" failureThreshold: 3 initialDelaySeconds: 5 periodSeconds: 10 successThreshold: 1 timeoutSeconds: 1 ## 容器初始化 容器的一些初始化操作显然适合通过 InitContainer 来完成,这里的 initContainer 是为了保证在 POD 启动前,PV盘 要先行绑定成功,同时为了避免 MySQL 数据库目录内的 lost+found 目录被误认为是数据库,初始化容器中将其删除; #Init 容器支持应用容器的全部字段和特性,包括资源限制、数据卷和安全设置。 然而,Init 容器对资源请求和限制的处理稍有不同,在下面 资源 处有说明。 而且 Init 容器不支持 Readiness Probe,因为它们必须在 Pod 就绪之前运行完成。 #如果为一个 Pod 指定了多个 Init 容器,那些容器会按顺序一次运行一个。 每个 Init 容器必须运行成功,下一个才能够运行。 当所有的 Init 容器运行完成时,Kubernetes 初始化 Pod 并像平常一样运行应用容器。 #mysql这里的initContainer是为了保证在POD启动前,PV盘要先行绑定成功。 initContainers: - command: - rm - -fr - /var/lib/mysql/lost+found image: busybox:1.29.3 imagePullPolicy: IfNotPresent name: remove-lost-found resources: {} terminationMessagePath: /dev/termination-log terminationMessagePolicy: File volumeMounts: - mountPath: /var/lib/mysql name: data restartPolicy: Always #scheduler 是 kubernetes 的调度器,主要的任务是把定义的 pod 分配到集群的节点上。 schedulerName: default-scheduler securityContext: {} #如果您的Pod通常需要超过30秒才能关闭,请确保增加优雅终止宽限期。可以通过在Pod YAML中设置terminationGracePeriodSeconds选项来实现. #如果容器在优雅终止宽限期后仍在运行,则会发送SIGKILL信号并强制删除。与此同时,所有的Kubernetes对象也会被清除。 terminationGracePeriodSeconds: 30 #定义数据卷PVC,与PV匹配。 volumes: - name: data persistentVolumeClaim: claimName: mysql-min - name: mysql-config configMap: name: mysql-config - name: localtime hostPath: type: File path: /etc/localtime **注:文本有限,故删减一部分,具体内容请参考原文。** # 小结 Kubernetes 很多看起来比较“繁琐”的设计的主要目的,都是希望为开发者提供更多的“可扩展性”,给使用者带来更多的“稳定性”和“安全感”。这两个能力的高低,是衡量开源基础设施项目水平的重要标准。 示例中揉合 Kubernetes 多项技术,构建了一个复杂且可做生产使用的单实例数据库。 本文源码: - blog-example/Kubernetes/k8s-mysql-pv-local at master · zuozewei/blog-example · GitHub # 参考资料: [1]:《深入剖析Kubernetes》
-
 1 背景石墨文档全部应用部署在Kubernetes上,每时每刻都会有大量的日志输出,我们之前主要使用SLS和ES作为日志存储。但是我们在使用这些组件的时候,发现了一些问题。成本问题:SLS个人觉得是一个非常优秀的产品,速度快,交互方便,但是SLS索引成本比较贵我们想减少SLS索引成本的时候,发现云厂商并不支持分析单个索引的成本,导致我们无法知道是哪些索引构建的不够合理ES使用的存储非常多,并且耗费大量的内存通用问题:如果业务是混合云架构,或者业务形态有SAAS和私有化两种方式,那么SLS并不能通用日志和链路,需要用两套云产品,不是很方便精确度问题:SLS存储的精度只能到秒,但我们实际日志精度到毫秒,如果日志里面有traceid,SLS中无法通过根据traceid信息,将日志根据毫秒时间做排序,不利于排查错误我们经过一番调研后,发现使用Clickhouse能够很好的解决以上问题,并且Clickhouse省存储空间,非常省钱,所以我们选择了Clickhouse方案存储日志。但当我们深入研究后,Clickhouse作为日志存储有许多落地的细节,但业界并没有很好阐述相关Clickhouse采集日志的整套流程,以及没有一款优秀的Clickhouse日志查询工具帮助分析日志,为此我们写了一套Clickhouse日志系统贡献给开源社区,并将Clickhouse的日志采集架构的经验做了总结。先上个Clickhouse日志查询界面,让大家感受下石墨最懂前端的后端程序员。2 架构原理图我们将日志系统分为四个部分:日志采集、日志传输、日志存储、日志管理。日志采集:LogCollector采用Daemonset方式部署,将宿主机日志目录挂载到LogCollector的容器内,LogCollector通过挂载的目录能够采集到应用日志、系统日志、K8S审计日志等日志传输:通过不同Logstore映射到Kafka中不同的Topic,将不同数据结构的日志做了分离日志存储:使用Clickhouse中的两种引擎数据表和物化视图日志管理:开源的Mogo系统,能够查询日志,设置日志索引,设置LogCollector配置,设置Clickhouse表,设置报警等以下我们按照这四大部分,阐述其中的架构原理3 日志采集3.1 采集方式Kubernetes容器内日志收集的方式通常有以下三种方案DaemonSet方式采集:在每个 node 节点上部署LogCollector,并将宿主机的目录挂载为容器的日志目录,LogCollector读取日志内容,采集到日志中心。网络方式采集:通过应用的日志 SDK,直接将日志内容采集到日志中心 。SideCar方式采集:在每个 pod 内部署LogCollector,LogCollector只读取这个 pod 内的日志内容,采集到日志中心。以下是三种采集方式的优缺点:DaemonSet方式 网络方式 SideCar方式采集日志类型 标准输出+文件 应用日志部署运维 一般,维护DaemonSet 低,维护配置文件日志分类存储 可通过容器/路径等映射 业务独立配置支持集群规模 取决于配置数 无限制适用场景 日志分类明确、功能较单一 性能要求极高的场景资源消耗 中 低我们主要采用DaemonSet方式和网络方式采集日志。DaemonSet方式用于ingress、应用日志的采集,网络方式用于大数据日志的采集。以下我们主要介绍下DeamonSet方式的采集方式。 3.2 日志输出从上面的介绍中可以看到,我们的DaemonSet会有两种方式采集日志类型,一种是标准输出,一种是文件。 引用元乙的描述:虽然使用 Stdout 打印日志是 Docker 官方推荐的方式,但大家需要注意:这个推荐是基于容器只作为简单应用的场景,实际的业务场景中我们还是建议大家尽可能使用文件的方式,主要的原因有以下几点:Stdout 性能问题,从应用输出 stdout 到服务端,中间会经过好几个流程(例如普遍使用的JSON LogDriver):应用 stdout -> DockerEngine -> LogDriver -> 序列化成 JSON -> 保存到文件 -> Agent 采集文件 -> 解析 JSON -> 上传服务端。整个流程相比文件的额外开销要多很多,在压测时,每秒 10 万行日志输出就会额外占用 DockerEngine 1 个 CPU 核;Stdout 不支持分类,即所有的输出都混在一个流中,无法像文件一样分类输出,通常一个应用中有 AccessLog、ErrorLog、InterfaceLog(调用外部接口的日志)、TraceLog 等,而这些日志的格式、用途不一,如果混在同一个流中将很难采集和分析;Stdout 只支持容器的主程序输出,如果是 daemon/fork 方式运行的程序将无法使用 stdout;文件的 Dump 方式支持各种策略,例如同步/异步写入、缓存大小、文件轮转策略、压缩策略、清除策略等,相对更加灵活。从这个描述中,我们可以看出在docker中输出文件在采集到日志中心是一个更好的实践。所有日志采集工具都支持采集文件日志方式,但是我们在配置日志采集规则的时候,发现开源的一些日志采集工具,例如fluentbit、filebeat在DaemonSet部署下采集文件日志是不支持追加例如pod、namespace、container_name、container_id等label信息,并且也无法通过这些label做些定制化的日志采集。agent类型 采集方式 daemonset部署 sidecar部署ilogtail 文件日志 能够追加label信息,能够根据label过滤采集 能够追加label信息,能够根据label过滤采集fluentbit 文件日志 无法追加label信息,无法根据label过滤采集 能够追加abel信息,能够根据label过滤采集filebeat 文件日志 无法追加label信息,无法根据label过滤采集 能够追加label信息,能够根据label过滤采集ilogtail 标准输出 能够追加label信息,能够根据label过滤采集 能够追加label信息,能够根据label过滤采集fluentbit 标准输出 能够追加label信息,能够根据label过滤采集 能够追加abel信息,能够根据label过滤采集filebeat 标准输出 能够追加label信息,能够根据label过滤采集 能够追加label信息,能够根据label过滤采集基于无法追加label信息的原因,我们暂时放弃了DeamonSet部署下文件日志采集方式,采用的是基于DeamonSet部署下标准输出的采集方式。 3.3 日志目录以下列举了日志目录的基本情况目录 描述 类型/var/log/containers 存放的是软链接,软链到/var/log/pods里的标准输出日志 标准输出/var/log/pods 存放标准输出日志 标准输出/var/log/kubernetes/ master存放Kubernetes 审计输出日志 标准输出/var/lib/docker/overlay2 存放应用日志文件信息 文件日志/var/run 获取docker.sock,用于docker通信 文件日志/var/lib/docker/containers 用于存储容器信息 两种都需要因为我们采集日志是使用的标准输出模式,所以根据上表我们的LogCollector只需要挂载/var/log,/var/lib/docker/containers两个目录。3.3.1 标准输出日志目录应用的标准输出日志存储在/var/log/containers目录下,文件名是按照K8S日志规范生成的。这里以nginx-ingress的日志作为一个示例。我们通过ls /var/log/containers/ | grep nginx-ingress指令,可以看到nginx-ingress的文件名。 nginx-ingress-controller-mt2wx_kube-system_nginx-ingress-controller-be3741043eca1621ec4415fd87546b1beb29480ac74ab1cdd9f52003cf4abf0a.log 我们参照K8S日志的规范:/var/log/containers/%{DATA:pod_name}_%{DATA:namespace}_%{GREEDYDATA:container_name}-%{DATA:container_id}.log。可以将nginx-ingress日志解析为:pod_name:nginx-ingress-controller-mt2wnamespace:kube-systemcontainer_name:nginx-ingress-controllercontainer_id:be3741043eca1621ec4415fd87546b1beb29480ac74ab1cdd9f52003cf4abf0a通过以上的日志解析信息,我们的LogCollector 就可以很方便的追加pod、namespace、container_name、container_id的信息。 3.3.2 容器信息目录应用的容器信息存储在/var/lib/docker/containers目录下,目录下的每一个文件夹为容器ID,我们可以通过cat config.v2.json获取应用的docker基本信息。3.4 LogCollector采集日志3.4.1 配置我们LogCollector采用的是fluent-bit,该工具是cncf旗下的,能够更好的与云原生相结合。通过Mogo系统可以选择Kubernetes集群,很方便的设置fluent-bit configmap的配置规则。3.4.2 数据结构fluent-bit的默认采集数据结构@timestamp字段:string or float,用于记录采集日志的时间log字段:string,用于记录日志的完整内容Clickhouse如果使用@timestamp的时候,因为里面有@特殊字符,会处理的有问题。所以我们在处理fluent-bit的采集数据结构,会做一些映射关系,并且规定双下划线为Mogo系统日志索引,避免和业务日志的索引冲突。_time_字段:string or float,用于记录采集日志的时间_log_字段:string,用于记录日志的完整内容例如你的日志记录的是{"id":1},那么实际fluent-bit采集的日志会是{"_time_":"2022-01-15...","_log_":"{\"id\":1}" 该日志结构会直接写入到kafka中,Mogo系统会根据这两个字段_time_、_log_设置clickhouse中的数据表。3.4.3 采集如果我们要采集ingress日志,我们需要在input配置里,设置ingress的日志目录,fluent-bit会把ingress日志采集到内存里。然后我们在filter配置里,将log改写为_log_ 然后我们在ouput配置里,将追加的日志采集时间设置为_time_,设置好日志写入的kafka borkers和kafka topics,那么fluent-bit里内存的日志就会写入到kafka中日志写入到Kafka中_log_需要为json,如果你的应用写入的日志不是json,那么你就需要根据fluent-bit的parser文档,调整你的日志写入的数据结构:https://docs.fluentbit.io/manual/pipeline/filters/parser4 日志传输Kafka主要用于日志传输。上文说到我们使用fluent-bit采集日志的默认数据结构,在下图kafka工具中我们可以看到日志采集的内容。 在日志采集过程中,会由于不用业务日志字段不一致,解析方式是不一样的。所以我们在日志传输阶段,需要将不同数据结构的日志,创建不同的Clickhouse表,映射到Kafka不同的Topic。这里以ingress为例,那么我们在Clickhouse中需要创建一个ingress_stdout_stream的Kafka引擎表,然后映射到Kafka的ingress-stdout Topic里。5 日志存储我们会使用三种表,用于存储一种业务类型的日志。Kafka引擎表:将数据从Kafka采集到Clickhouse的ingress_stdout_stream数据表中create table logger.ingress_stdout_stream( _source_ String, _pod_name_ String, _namespace_ String, _node_name_ String, _container_name_ String, _cluster_ String, _log_agent_ String, _node_ip_ String, _time_ Float64, _log_ String)engine = Kafka SETTINGS kafka_broker_list = 'kafka:9092', kafka_topic_list = 'ingress-stdout', kafka_group_name = 'logger_ingress_stdout', kafka_format = 'JSONEachRow', kafka_num_consumers = 1;物化视图:将数据从ingress_stdout_stream数据表读取出来,_log_根据Mogo配置的索引,提取字段在写入到ingress_stdout结果表里CREATE MATERIALIZED VIEW logger.ingress_stdout_view TO logger.ingress_stdout ASSELECT toDateTime(toInt64(_time_)) AS _time_second_,fromUnixTimestamp64Nano(toInt64(_time_*1000000000),'Asia/Shanghai') AS _time_nanosecond_, _pod_name_, _namespace_, _node_name_, _container_name_, _cluster_, _log_agent_, _node_ip_, _source_, _log_ AS _raw_log_,JSONExtractInt(_log_, 'status') AS status,JSONExtractString(_log_, 'url') AS url FROM logger.ingress_stdout_stream where 1=1;结果表:存储最终的数据create table logger.ingress_stdout( _time_second_ DateTime, _time_nanosecond_ DateTime64(9, 'Asia/Shanghai'), _source_ String, _cluster_ String, _log_agent_ String, _namespace_ String, _node_name_ String, _node_ip_ String, _container_name_ String, _pod_name_ String, _raw_log_ String, status Nullable(Int64), url Nullable(String),)engine = MergeTree PARTITION BY toYYYYMMDD(_time_second_)ORDER BY _time_second_TTL toDateTime(_time_second_) + INTERVAL 7 DAYSETTINGS index_granularity = 8192;6 总结流程日志会通过fluent-bit的规则采集到kafka,在这里我们会将日志采集到两个字段里_time_字段用于存储fluent-bit采集的时间_log_字段用于存放原始日志通过mogo,在clickhouse里设置了三个表app_stdout_stream: 将数据从Kafka采集到Clickhouse的Kafka引擎表app_stdout_view: 视图表用于存放mogo设置的索引规则app_stdout:根据app_stdout_view索引解析规则,消费app_stdout_stream里的数据,存放于app_stdout结果表中最后mogo的UI界面,根据app_stdout的数据,查询日志信息7 Mogo界面展示查询日志界面 设置日志采集配置界面以上文档描述是针对石墨Kubernetes的日志采集,想了解物理机采集日志方案的,可以在下文中找到《Mogo使用文档》的链接,运行docker-compose体验Mogo 全部流程,查询Clickhouse日志。限于篇幅有限,Mogo的日志报警功能,下次在讲解。
-
 大家好,我是鹤轩,上一期我们了解到计算故障注入的背景和现状,应该对故障注入有了一个初步的认识,本期我们一起来学习业界故障注入工具现状和混沌工程,在介绍故障注入工具之前,先一起来了解下什么是故障注入测试吧。一、故障注入测试: 故障注入是一种可靠性验证技术,通过受控实验向系统中刻意引入故障,并观察系统中存在故障时的行为。故障注入技术一般分为:基于硬件的故障注入、基于软件的故障注入以及基于仿真的故障注入。故障注入测试则是结合软件测试的特点,在保证评测准确性的前提下,利用故障注入技术解决容错机制导致的故障需求复杂、故障构造困难等问题,实现理想的故障注入测试方法在软件测试中的应用。 故障注入可分为软件故障注入、硬件故障注入和仿真故障注入。 硬件故障注入:硬件故障注入是模拟硬件在实际运行中发生的故障,例如实时的干扰、硬件芯片的随机失效等,使得计算机的某个硬件信号发生改变。硬件故障具体可分为如下几类:模拟量、离散量、数字量、电源等方面。例如在数字量方面,有存储器故障、通讯器故障等。硬件故障注入就是使用额外的硬件将故障注入到目标系统硬件中。硬件故障注入方式具有破坏性和不可控制性的缺点,因此硬件故障注入没有被广泛的使用。 软件故障注入:软件故障注入技术是根据软件的故障模式,通过改变软件的执行流程,或改变软件的操作数据等,使软件产生错误。软件故障注入包括动态故障注入和静态故障注入,动态故障注入是在运行的过程中进行故障注入的,而静态故障注入则是在运行程序之前将故障注入到程序中,然后再运行程序根据程序的运行结果来判定程序中是否存在故障。软件故障注入不需要昂贵的注入仪器,而且使用起来更为灵活。它的目标系统可能是应用程序,也可以是操作系统。软件注入的目标是在功能级别注入故障,与在物理层、逻辑层的注入达到一致的效果。仿真故障注入:仿真故障注入可以在不修改软件系统情况下,通过使用更加精准的故障模型来进行故障注入。并具有很好的时间粒度、良好的可控性和观察性。 与其它两种方法相比,软件故障注入有实现简单、灵活、花费少、工作量小、评 测范围大、对原系统无损害等特点,有广泛的应用前景。基于软件的故障注入,是通过软件方法,在机器指令可以访问到的范围内,通过修改硬件或软件的状态变量或数据来模拟故障的产生,加速系统的失效,修改内存数据,通过应用软件生成故障或者通过底层软件如操作系统生成故障。二、混沌工程简介: 混沌工程由Netflix提出,它是在分布式系统上进行实验的学科, 目的是建立对系统抵御生产环境中失控条件的能力以及信心。它的应用场景主要是针对云原生 (DevOps+持续交付+微服务+容器)相关的业务,发展史如下所示:混沌工程与传统测试之间的区别:混沌工程和传统测试(故障注入 FIT、故障测 试)在关注点和工具集上都有很大的重叠。比如,在Netflix的很多混沌工程实验研究的对象都是基于故障注入来引入的。混沌工程和这些传统测试方法的主要区别在于:混沌工程是发现新信息的实践过程,而故障注入则是对一个特定的条件、变量的验证方法。 为了更好的理解混沌工程,这里着重介绍一下Chaos Monkey。Chaos Monkey 通过关停一个或多个虚拟机来模拟Service实例的失效。Chaos Monkey的名字来源于其工作的方式:如同一只野生的、武装了的猴子,在数据中心释放后,造成的严重破坏。 Chaos Monkey 的原则:避免大多数失效的主要方式就是经常失效。失效一定会发生,并且无法避免。在大多数情况下,我们的应用设计要保证当服务的某个实例下线时仍能继续工作,但是在那些特殊的场景下,我们需要确保有人在值守,以便解决计算故障注入工具(DemonCAT)技术白书计算全栈故障注入工具(DemonCAT)简介问题,并从问题中进行经验学习。基于这个想法,Chaos Monkey仅会在工作时间内被使用,以保证能发现警告信息,并做出适当的回应。 故障演练也是一项遵循混沌工程实验原理的一项测试活动,提供丰富故障场景, 能够帮助分布式系统提升容错性和可恢复性;此外故障演练还建立了一套标准的演练 流程,包含准备阶段、执行阶段、检查阶段和恢复阶段。通过四阶段的流程,覆盖用户从计划到还原的完整演练过程,并通过可视化的方式清晰的呈现给用户。 三、业界故障注入工具业界内故障注入工具大致分为三类,涵盖了从硬件、OS、容器以及应用各个层级的故障注入能力: 与混沌工程相关的故障注入软件工具:业界内故障注入工具大部分与混沌工程相 结合。它的应用场景主要是针对云原生(DevOps+持续交付+微服务+容器)相关的业务,因此相应的故障注入能力主要集中在OS、容器与应用上面,这类工具通常带有chaos的标识。与硬件可靠性相关的故障注入软件工具:这一类主要硬件厂商通过软件修改硬件 状态,从而达到模拟硬件故障的目的,这类工具主要被用来测试硬件的可靠性,因此大多数不具备通用性,各大厂商也未开源相关工具。非系统性故障注入软件工具:除了上述两种系统性的工具之外,还存在一些开源 且比较优秀的零散工具,这些工具原本目的不是用来进行故障注入的,而是用来对某些特性做数据修改、性能压测等测试,它们在某些方面是可以被用来模拟故障注入的。下一期我们将一起来学习鲲鹏计算注入工具DemonCAT,可能会有小伙伴好奇DemonCAT实现的原则是什么呢,还会介绍故障注入的流程,一起来看看吧。
-
>摘要:云原生浪潮下,容器技术是串联起整个云原生世界的关键一环。本文分享自华为云社区[《左手自研,右手开源,技术揭秘华为云如何领跑容器市场》](https://bbs.huaweicloud.com/blogs/281793?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content),作者:华为云社区精选。  近日,IDC 发布的《PRC SDC Market Overview and Analysis, 2020H2/2020》报告显示,华为云**以24.3%的市场份额,斩获中国容器软件市场第一**。 下面,我们从技术角度分析,华为云为什么能领跑容器软件市场。 # 容器如何成为宠儿? 容器是什么? 从字面上看,这是一个用于盛放某种东西的器具,实际也是如此,容器技术可以将软件的程序代码和依赖项打包起来,让其与实际运行的环境隔离,哪里需要搬哪里,比如在数据中心、个人电脑上部署运行。 这个概念有点像老大哥虚拟机,但是两者的相似点仅仅在于:提供独立的环境运行软件。在[基因、容器和上帝](https://bbs.huaweicloud.com/blogs/114535) 中,作者从哲学化的视角谈了程序员创造的虚拟世界,也点出了两者的异曲同工之妙:Docker容器技术和VM虚拟机从技术原理上看,是完全不同的路线,连实现思路都不一样。但是,它们所达成的效果或者说是目标确是惊人的一致:即模拟一台看着像物理机一样的东西。 虽然如此,但两者内在逻辑差别很大。容器可以在操作系统级别进行虚拟化,一个操作系统内核上可以运行多个容器,而虚拟机只是硬件层面的虚拟化。相比较VM,容器更轻巧、启动速度更快、占用的内存微乎其微,[容器与Docker](https://bbs.huaweicloud.com/blogs/203431)详细对比了虚拟机和容器的优缺点。 随着用户对云端应用开发、部署和运维的效率愈加重视,间接促成了容器的盛行。 不过,容器在云服务领域“发光发热“离不开一个关键技术:**Docker**。  Docker是目前应用最多的容器引擎技术,它的logo是一只蓝色的鲸鱼驮着一堆小方块。开发者通过docker可以为任何应用创建容器:应用的流程、库和依赖,甚至整个操作系统的文件系统能被打包成一个简单的可移植的包,这个包就像是鲸鱼背上蓝色的小方块,它可以在任何运行Docker的机器上使用,从根本上解决了开发运行环境不一致的问题,让容器真正实现了一次构建,随处运行。 当应用程序被分解为多个小组件或服务,每个组件或服务都放置在一个容器中,每个容器可能还运行在不同的计算机中,此时就需要对容器进行有序的编排和管理。就像电脑上的操作系统,它可以管理所有应用程序,并规划哪个应用程序何时使用电脑的CPU和其他硬件资源。 脱胎于Google内部集群管理系统Borg的kubernetes逐渐成为业界标准,它可以通过API的方式将多个不同的计算机作为一个资源池进行管理,类似某种集群操作系统,管理整个集群中的容器化应用程序。[ Docker与Kubernetes的兴起](https://bbs.huaweicloud.com/blogs/138949)这篇文章就具体谈到了kubernetes(k8s)如何从三足鼎立的局面中PK掉其他两个对手,在混战中取得胜利。 至此,属于容器的黄金时代大幕正式拉开。 Gartner预测,到2023年,70%的组织将在生产中运行三个或更多容器化应用程序。容器、Kubernetes和微服务应用模式是企业IT创新和数字化转型的三大驱动力。 华为很早就投入了容器的怀抱中,由于一直使用虚拟机封装应用程序,每次启动虚拟机花费了大量的时间,这给管理及部署基于虚机应用程序的高成本和低效率带来了挑战。所以在2015年的时候,华为决定利用Kubernetes技术对自身IT系统进行容器化改造。华为在通过自身的容器化改造实践受益的同时,又将遇到的实际问题不断贡献给社区,与社区成员一同推动Kubernetes的发展。 2018年4月,华为云获得了CNCF基金会的顶级席位——CNCF技术监督委员会席位,全球共9席,华为是亚洲首家进入者。 同时,随着越来越多的企业业务选择容器化,在集群的规模、性能、实时监控与弹性扩缩容等方面都提出了新的要求,当开源社区方案难以解决这些问题的时候,就非常考验各大云服务供应商的技术能力。 # 万丈高楼平地起,建设好云原生基础设施 在[为什么说容器的崛起预示着云原生时代到来?](https://bbs.huaweicloud.com/blogs/200395)中,华为云云原生团队认为,各类现代化的应用都将会运行在K8s之上,不仅仅是当前以互联网App、WebService为代表的无状态应用,还有新型的诸如大数据、AI、分布式数据中间件等等有状态应用,以及边缘应用也将会普遍运行在K8s之上,K8s将完成对各类现有平台的归一化,成为一个统一的应用运行的基础平台。 华为云最早于2018年洞察到了这一技术趋势,在容器全栈产品中构建了Vessel云原生技术平台,主要包括了以**容器引擎iSula、容器网络Yangtse、容器存储Everest**为代表的面向统一资源层的云原生基础设施组件。  下面,我们将逐一为大家揭开华为云的容器技术面纱。 # 容器引擎iSula 基于docker和kubernetes,首先Docker并不是万能药,它在某些场景下也存在不足,比如: - 在资源敏感环境,或需要部署高密度容器节点时,容器对基础设施的资源占用会急剧升高; - 当大规模应用拉起或遇到突发流量时,并发速度可能成为瓶颈。 当主流的 Docker 等容器引擎在特定用例下力不从心时,一些针对某种用例进行过专门优化的容器引擎技术开始崛起。比如说,以 Kata Container 为代表的专门针对容器隔离性不够严格而设计的安全容器技术;以 iSula 为代表的针对资源受限的边缘计算和 IoT 环境设计的轻量级容器技术。 可以看出,iSula是与Docker相对的一种容器引擎,它一方面完全兼容现有容器生态,另一方面相比Docker内存占用下降68%、启动时间缩短35%。 比如相比Golang编写的Docker,iSula使用C/C++实现,具有轻、灵、巧、快的特点,不受硬件规格和架构的限制,底噪开销更小。在严苛的资源要求环境下,轻量模式下的 iSulad 本身占用资源极低( 15M) 。  2017 年,iSula 技术团队成功将 Kata Containers 集成到 iSula 容器平台,并于 18 年初应用于华为云容器服务,**推出基于iSulad 容器引擎和 Kata Containers 的商用容器服务——华为云容器实例 CCI(Cloud Container Instance),这也是业界首个 Serverless 架构的云容器服务**。 那么,基于iSulad 容器引擎和 Kata Containers 如何打造安全、高性能的CCI?且看 [基于 Kata Containers 与 iSulad 的云容器实践解析](https://bbs.huaweicloud.com/blogs/147030)进一步分析,文中提到真正的 Serverless 容器服务中,集群管理由云服务提供商承担,客户只需要关注每个应用的容器实例即可。在这种情况下,云服务提供商需要考虑如何在统一管理面下保证每个用户的安全。 CCI 服务所属的 Kubernetes 集群直接部署在裸金属服务器之上,底层是 Kata Containers,中间靠 iSula 容器平台连接。其中,依靠 Kata Containers 的强隔离特性,多个租户之间的容器运行环境强隔离,不同租户之间的容器不感知、不可见,做到在同一台裸金属服务器上混合部署而安全无虞。 安全之外,在算力方面,CCI基于iSula提供的GPU直通功能,可以直接在容器中使用各种GPU进行AI计算。再加上CCI无需购买和管理弹性服务器,可直接在华为云上运行容器和pod,也无需创建集群,管理master和work节点,非常适用于批量计算,高性能计算,突发扩容,以及CI/CD测试。 在此,华为云社区推荐一些有趣的案例,可以帮助大家快速上手CCI,比如[云容器实例CCI - 使用Tensorflow训练神经网络](https://support.huaweicloud.com/bestpractice-cci/cci_04_0008.html#toTop) 和[云容器实例CCI – 经典2048数字合成游戏部署指南](https://bbs.huaweicloud.com/forum/thread-17431-1-1.html) ,通过这些简单的实操和小游戏,能够对Serverless 架构的云容器服务有更直观的认识。 # 容器网络Yangtse 大家应该都看过某些明星导致社交媒体平台宕机的新闻,明星事件带来的突发流量触发业务扩容,以前是扩容虚拟机,速度慢还情有可原,现在大部分互联网平台都使用容器了,为什么扩容速度还是跟不上流量增长的节奏呢? 首先,Kubernetes本身并不负责网络通信,它提供了容器网络接口CNI负责具体的网络通信,开源的CNI插件非常多,像Flannel、Calico等。包括华为云容器引擎CCE也专门为Kubernetes定制了CNI插件,使得Kubernetes可以使用华为云VPC网络。 尽管如此,多个容器集群的网络通信(容器连接到其他容器、主机和外部网络的机制)始终是个复杂的问题。比如大规模节点管理场景下网络性能的瓶颈;网口发放速度如何匹配容器扩容速度等等。最终,对对底层虚拟化网络提出了**密度更高,规模更大,发放更快,调整更频繁**的要求。 容器网络Yangtse深度融合华为云虚拟私有云(VPC)原生网络能力,它采用的VPC-Native组网被称作ENI(Elastic Network Interface)模式,容器直接挂载具有VPC子网地址的ENI,具备完全VPC网络互通能力。容器实例可以在集群VPC网络和与之相连的其他VPC网络中进行原生路由,并且直接使用VPC原生的网络能力如 network policy、ELB、EIP、NAT等。换言之,就是容器地址属于VPC子网,容器独占对应的ENI网口,解决了容器的互通性问题。 而且Yangtse基于华为云擎天架构的软硬协同能力,会把治理和转发逻辑下沉到擎天卡上,实现容器网络主机资源0占用。数据显示,通过硬件直通方式及动态网络队列,网络整体性能提升40%,单容器PPS提升2倍;基于warm pool的能力,1-2秒内完成ENI的发放和网络端到端打通。 至于具体如何实现,大体上可以总结为三点: 1、warm pool 机制可以解决网络资源预热的问题。如果不做预热,容器网络端到端打通时间在一分钟以上,分钟级容器启动时间是不可接受的。 Warm pool机制在裸金属节点上预挂载一定数量ENI(用户可根据服务部署并发量自定义配置),容器随时调度到预热节点上都有即时可用的ENI网卡。经过warm pool的优化,容器网络端到端打通时间缩短为1s-2s。 2、得益于擎天架构的优势,裸金属容器还可以向虚拟机容器扩容,而在虚拟机容器上,容器网络Yangtse使用了Trunkport技术,结合ENI的优势,在保障性能的前提下,单台服务器理论上可为千容器同时提供直通网络能力。 3、当应用业务流量增长触发扩容时,如果ELB直接全量发放分摊的流量请求,海量请求会迅速压垮(overload)新扩的容器,造成扩容失败。 所以新扩容的后端实例需要“慢启动”的过程,但一个节点部署多个容器时,节点的二次分发让ELB无法感知到最终的后端容器,进而无法做到容器级别的流控,也难以保证稳态后的负载均衡。容器网络Yangtse实现了与华为云ELB v3独享型负载均衡实例的直通。 具体技术详解,可以阅读[华为云第二代裸金属容器技术系列:应对海量并发的网络黑科技](https://bbs.huaweicloud.com/blogs/194532) 。 目前,Yangtse已经为华为云CCE/CCI/IEF等容器服务提供了统一的容器网络方案,覆盖虚机、裸金属、Serverless和边缘节点等各种容器运行环境。 其中**最值得注意的是CCE,它是一种托管的Kubernetes服务,可进一步简化基于容器的应用程序部署和管理,深度整合华为云的计算、存储、网络和安全等技术构建高可用Kubernetes集群**。 在CCE中,用户可以直接使用华为云高性能的弹性云服务器、裸金属服务器、GPU加速云服务器等多种异构基础设施,也可以根据业务需要在云容器引擎中快速创建CCE集群、鲲鹏集群、CCE Turbo集群,并通过云容器引擎对创建的集群进行统一管理。 以今年在HDC重磅发布的云容器集群CCE Turbo为例,它主要针对企业大规模业务生产中的高性能、低成本诉求,在计算、网络和调度上全方位加速, [新一代容器解决方案:云容器引擎CCE Turbo集群](https://bbs.huaweicloud.com/blogs/198569)就总结了它在这三个方面的新突破。 >在计算加速方面,业界独家实现容器100%卸载,服务器资源和性能双零损耗。 >在网络加速方面,采用独创的容器直通网络,让两层网络变成一层,端到端连通时间缩短一半,有效支撑业务秒级扩容千容器。 >在调度加速方面,通过感知AI、大数据、WEB业务的不同特征,以及应用模型、网络拓扑等,实现业务混合部署、智能调度,还自动优化任务调度策略,实现1万容器/秒的大规模并发调度能力。 再就是容器存储Everest, 每个POD使用独立VF,读写时延降低50%;将Posix组件卸载,单进程节省30M内存;NAS卷直挂POD容器内,提高请求处理效率30%。 # “查漏补缺”Kuberentes,开源技术解决特殊场景难题 基础设施之外,华为云先后将Vessel的核心组件Volcano和KubeEdge开源,并贡献给云原生计算基金会CNCF,成为社区首个容器智能边缘项目和容器批量计算项目。 # Volcano——批量计算 当有更多的用户希望在Kubernetes上运行大数据、 AI和HPC应用,而它默认调度器又无法满足包括公平调度、优先级、队列等高级调度功能时,就需要一些新的技术解决方案登场了。 考虑到AI、大数据等业务的需求,华为云在Kubernetes调度上做了一个感知上层业务的调度——Volavano,它是基于Kubernetes构建的一个通用批量计算系统,[Volcano架构设计与原理解读](https://bbs.huaweicloud.com/blogs/239645)就Volcano产生的背景、架构设计与原理进行深度解读,用数据证明了Volavano为分布式训练、大数据、HPC场景带来了效率的提高。 [Volcano火山:容器与批量计算的碰撞](https://bbs.huaweicloud.com/blogs/205045)则从并行计算开始说起,详细解释了Volcano的调度框架、调度实现原理。作为调度系统,Volcano通过**作业级的调度**和**多种插件机制**来支持多种作业,其中作业级的调度支持以多种类型的作业为目标进行设计,比如基于时间的、跨队列的等等。Volcano的插件机制有效的支撑了针对不同场景算法的落地,从早期的gang-scheduling/co-scheduling,到后来各个级别的公平调度。  图:总体架构 在华为云今年刚推出的CCE Turbo容器集群中,就采取了多项Volcano关键调度技术,如基于共享资源视图的多调度器、决策复用、应用模型感知、数据位置亲和调度、网络拓扑调度等,从而实现1万容器/秒的大规模并发调度能力。 # KubeEdge——边缘计算 容器天然的轻量化和可移植性,非常适合边缘计算的场景。理想情况下,在边缘部署复杂的应用,Kubernetes 是个很好的选择,现实真相是要想在边缘部署 Kubernetes集群,各种问题层出。 比如很多设备边缘的资源规格有限,特别是 CPU 处理能力较弱,因此无法部署完整的 Kubernetes;Kubernetes 依赖 list/watch 机制,不支持离线运行,而边缘节点的离线又是常态,例如:设备休眠重启;边缘业务通常在私有网络中,无公网IP,云边跨越公网导致延迟高。 为了解决这些问题,KubeEdge应运而生。KubeEdge即Kube+Edge,顾名思义就是依托K8S的容器编排和调度能力,实现云边协同、计算下沉、海量设备的平滑接入。 其架构主要包含三部分,分别是云端、边缘侧和终端。云端负责应用和配置的下发,边缘侧则负责运行边缘应用和管理接入设备。 [KubeEdge架构解读:云原生的边缘计算平台](https://bbs.huaweicloud.com/blogs/241350)从KubeEdge架构设计理念、KubeEdge代码目录概览、KubeEdge集群部署三方面带大家认识KubeEdge。  关于KubeEdge和Volcano的更多技术硬实力体现和落地案例,可以阅读专题[【技术补给站】第5期:从架构和实践,剖析KubeEdge+Volcano技术硬实力](https://bbs.huaweicloud.com/blogs/240234),在此不再赘述。 # 解决多云容器集群管理,新秀Karmada崛起 批量计算和边缘计算的问题解决后,伴随云原生技术和市场的不断成熟,很多企业都是多云或者混合云的部署,一方面可以避免被单供应商锁定降低风险,另一方面也可以是出于成本的考量。 但是多集群同时也带来了巨大的复杂性,包括如何让应用面向多集群部署分发,并做到多集群之间灵活切换。在今年的HDC上,华为云宣布了**多云容器编排项目Karmada正式开源**,Karmada项目由华为、工商银行、小红书、中国一汽等8家企业联合发起,它可以构建无极可扩展的容器资源池,让开发者像使用单个K8s集群一样使用多云集群。 Karmada是一个 Kubernetes 管理系统,基于 [Kubernetes Federation v1](https://github.com/kubernetes-retired/federation) 和[ v2](https://github.com/kubernetes-sigs/kubefed) 开发,它可以跨多个 Kubernetes 集群和云运行云原生应用程序,直接使用 Kubernetes 原生 API 并提供高级调度功能,实现真正的开放式多云 Kubernetes。 [华为云MCP多云跨云的容器治理与实践](https://bbs.huaweicloud.com/blogs/281796)为我们梳理了Karmada项目诞生的前因后果,以及整个项目的核心价值,比如对K8s原生API兼容 、丰富的多集群调度支持、开箱即用等等。  Karmada的架构设计图 从架构图可以看到,整个控制面板可以分为四大块:提供原生API入口,存放用户yaml和Karmada资源对象的Karmda API Server,和配套存储ETCD;以及资源控制器Karmda Controller Manager、多集群调度器 Karmda Sheduler。其中,最关键的就是API Server,让用户既有的资源配置(yaml)可以借助K8s原生API进行部署。 综上,Karmada 旨在为多云和混合云场景下的多集群应用程序管理提供 turnkey 自动化,其关键功能包括集中式多云管理、高可用性、故障恢复和流量调度。 今年的HDC期间,在线教育平台VIPKID的后端研发高级专家分享了使用 Karmada实现从天到秒的跨云迁移实践。在剖析VIPKID的多场景云原生落地实践后,他对多集群管理提出了一些思考,如下图所示,理想的多集群管理方式是: - 集中管理,但要原生; - 应用在不同集群的差异化管理; - 集群故障自动转移。  对比了多家方案后,VIPKID选择了开源的方案 Karmada。作者表示Karmada的整个设计结构就是按原生k8s开发标准开发的,唯一差别之处是需要管理多个集群不同的 workload信息,所以改写了调度器和控制器,在它们下面对接了多个集群管理起来。这样最大的好处是看起来在控制一个集群,但最终的效果是在控制多个集群。 具体案例情况参见[Karmada | VIPKID在线教育平台从天到秒的跨云迁移实践](https://bbs.huaweicloud.com/blogs/281788),文章内有现场demo演示用Karmada实现多集群管理。 另一个经典案例是[工商银行多k8s集群管理及容灾实践](https://bbs.huaweicloud.com/blogs/281790)。工商银行的应用平台云容器规模超20万,业务容器占到55,000个左右,整体的一些核心业务都已入容器云内部,包括个人金融体系的账户,快捷支付、线上渠道等。当越来越多的核心业务应用入云之后,最大的挑战是容灾以及高可用。 但既有的运管平台并不能解决这些问题,比如没有整体的跨集群自动伸缩能力、集群对上层用户不透明、没有跨集群的自动调度和迁移等等。对此,他们根据业务场景调研了一些多集群管理平台,最终也选择了社区支持的开源项目Karmada。 Karmada以类k8s的形式部署,对他们来说,改造成本是比较小的,只需在上面部署一个管理集群即可。而且Karmada仅管理资源在集群间的调度,子集群内分配高度自治。在实践中,Karmada的资源调度、容灾、集群管理和资源管理的优势突出。 截止到现在,工行在测试环境中已经用Karmada对存量集群进行一些纳管,未来规划的关键的点是如何和整体云平台进行集成。 项目地址 :GitHub - karmada-io/karmada: Open, Multi-Cloud, Multi-Cluster Kubernetes Orchestration 总结 围绕Docker和kubernetes,华为云在技术层面做了诸多的优化和新的探索尝试,除此之外,华为云还有端到端的容器运维管理体系,涵盖资源编排、容器应用持续交付、应用生命周期管理、镜像安全扫描以及日常运维监控等。 云原生浪潮下,容器技术是串联起整个云原生世界的关键一环,它的市场之争,正是山雨欲来风满楼,想要占得高地,技术实力、开源生态、合作伙伴,缺一不可。
-
>摘要:CNCF(云原生计算基金会)正式接纳由华为云贡献的多云容器编排项目Karmada,迎来CNCF首个多云容器编排项目。 本文分享自华为云社区[《华为云开源的Karmada正式成为CNCF首个多云容器编排项目》](https://blog.csdn.net/devcloud/article/details/120566049?spm=1001.2014.3001.5501),作者:华为云开发者社区 北京时间9月15日,CNCF(云原生计算基金会)正式接纳由华为云贡献的多云容器编排项目Karmada(https://github.com/karmada-io/karmada),迎来CNCF首个多云容器编排项目。Karmada 项目的加入,将CNCF的云原生版图进一步扩展至分布式云领域。 华为云在技术上一直积极回馈社区,已开源了以智能边缘项目KubeEdge和批量计算项目Volcano为代表的一系列云原生项目。Karmada项目由华为云、工商银行、小红书、中国一汽等8家企业联合发起,沉淀了各企业在多云管理领域的丰富积累,为开发者提供详实有效的实践指导与帮助,使用Karmada,可以构建无极可扩展的容器资源池,让开发者像使用单个Kubernetes集群一样使用多云集群。 # Karmada介绍 随着企业业务的快速发展,多云也逐步成为数据中心建设的基础架构,多区域容灾与多活、大规模多集群管理、跨云弹性与迁移等场景推动云原生多云相关技术的快速发展。 然而,在实际的生产落地过程中,云原生的多云仍面临如下挑战: - 集群繁多的重复劳动:运维工程师需要应对繁琐的集群配置、不同云厂商集群间的管理差异以及碎片化的API访问入口等问题; - 业务过度分散的维护难题:应用在各集群的差异化配置繁琐;业务跨云访问以及集群间的应用同步难以管理; - 集群的边界限制:应用的可用性受限于集群;资源调度、弹性伸缩受限于集群; - 厂商绑定:业务部署的黏性问题,缺少自动化故障迁移;缺少中立的开源多云容器编排项目。 Karmada结合了华为云多云容器平台MCP以及Kubernetes Federation核心实践,并融入了众多新技术:包括Kubernetes原生API支持、多层级高可用部署、多集群自动故障迁移、多集群应用自动伸缩、多集群服务发现等,并且提供原生Kubernetes平滑演进路径,让基于Karmada的多云方案无缝融入云原生技术生态,为企业提供从单集群到多云架构的平滑演进方案。  Karmada项目全景 # 生态合作 Karmada项目由华为云、工商银行、浦发银行、小红书、VIPKID、趣头条、中国一汽和T3出行联合发起,于2021年4月25日在华为开发者大会(HDC.Cloud)2021上正式宣布开源。Karmada自开源以来受到了广泛的关注和支持,目前已有30+大型企业/机构/高校参与社区开发及贡献。 >Karmada项目源自华为云多云容器平台MCP,同时融入了工商银行、小红书、中国一汽等不同行业客户在多云管理方面的经验,可以为各企业提供详实有效的落地指导与帮助,企业通过Karmada构建跨云、跨数据中心的无极可扩展的应用资源池,可以像管理单个Kubernetes集群一样简单、便捷的管理不同云、不同数据中心里的集群与应用。——华为云CTO 张宇昕>在社区贡献方面,工商银行作为 Karmada项目的头部参与单位,结合工行多年来多容器集群管理的经验,已在集群生命周期管理、核心调度控制器等核心模块进行深度定制化的开发。后续,工行将持续参与Karmada 社区的开发和管理工作,计划在多集群自动调度、多集群自动伸缩等模块继续深入研究及贡献,反哺开源社区,持续扩大业界影响力。——工商银行软件开发中心专家 鲁金彪>集团型企业同时存在多个混合容器的复杂场景,跨多云技术架构的运维难题日益突出。华为Karmada作为多集群、多云及混合云的集中化、兼容原生Kubernetes API接口的管理架构,有效解决目前容器编排多集群、多环境无法集中式管理、安全隔离机制不健全等痛点。希望Karmada在加入CNCF后,通过社区的共同维护与贡献,不断壮大其功能。期待Karmada早日从CNCF毕业,反哺云原生生态。——一汽体系数字化部技术运营主任 王广>Karmada原生兼容Kubernetes API的能力,可以不加改造地对接现有Kubernetes生态。在落地实践过程中,我们使用Karmada对接了现有的GitOps生态,极大提高了应用跨集群部署的效率。 ——VIPKID运维总监 谷玉虎>Karmada提供丰富的多集群调度策略以及开箱即用的内置策略集,可以极大的简化两地三中心、异地容灾和同城双活架构下的系统复杂性,这对于金融行业至关重要。 ——浦发银行云转型处处长 吕炳刚 # 未来可期 目前,Karmada已在华为云多云容器平台(Multi-Cloud Container Platform,MCP)商用,提供分布式云解决方案,提供跨云的多集群统一管理、应用统一部署及流量分发等关键能力。 除MCP以外,Karmada已在数十家来自金融、互联网、教育等企业中落地。 此次CNCF正式将Karmada接纳为云原生领域首个多云容器编排项目,将极大促进Karmada上下游社区生态构建及合作,吸引广大云原生企业用户深度参与,Karmada将在多集群应用管理、服务治理、高可用部署等领域发挥越来越重要的作用,华为云也将在云原生领域持续耕耘、持续引领创新、繁荣生态,助力各行业走向快速智能发展之路。
-
>摘要:遥感影像,作为地球自拍照,能够从更广阔的视角,为人们提供更多维度的辅助信息,来帮助人类感知自然资源、农林水利、交通灾害等多领域信息。本文分享自华为云社区[《AI+云原生,把卫星遥感虐的死去活来》](https://bbs.huaweicloud.com/blogs/296183?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content),作者:tsjsdbd。 # AI牛啊,云原生牛啊,所以1+1>2? 遥感影像,作为地球自拍照,能够从更广阔的视角,为人们提供更多维度的辅助信息,来帮助人类感知自然资源、农林水利、交通灾害等多领域信息。 AI技术,可以在很多领域超过人类,关键是它是自动的,省时又省力。可显著提升遥感影像解译的工作效率,对各类地物元素进行自动化的检测,例如建筑物,河道,道路,农作物等。能为智慧城市发展&治理提供决策依据。 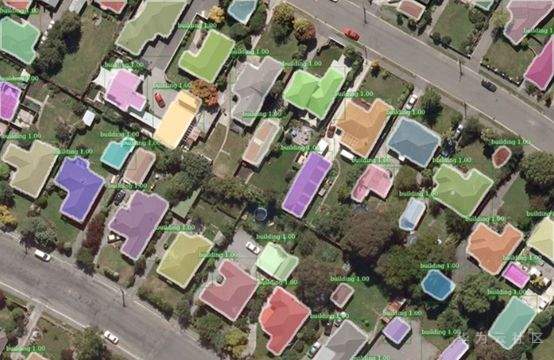 云原生技术,近年来可谓是一片火热。易构建,可重复,无依赖等优势,无论从哪个角度看都与AI算法天生一对。所以大家也可以看到,各领域的AI场景,大都是将AI推理算法运行在Docker容器里面的。 AI+云原生这么6,那么强强联手后,地物分类、目标提取、变化检测等高性能AI解译不就手到擒来?我们也是这么认为的,所以基于AI+Kubernetes云原生,构建了支持遥感影像AI处理的空天地平台。 不过理想是好的,过程却跟西天取经一般,九九八十一难,最终修成正果。 # 业务场景介绍 遇到问题的业务场景叫影像融合(Pansharpen),也就是对地球自拍照进行“多镜头合作美颜”功能。(可以理解成:手机的多个摄像头,同时拍照,合并成一张高清彩色大图)。 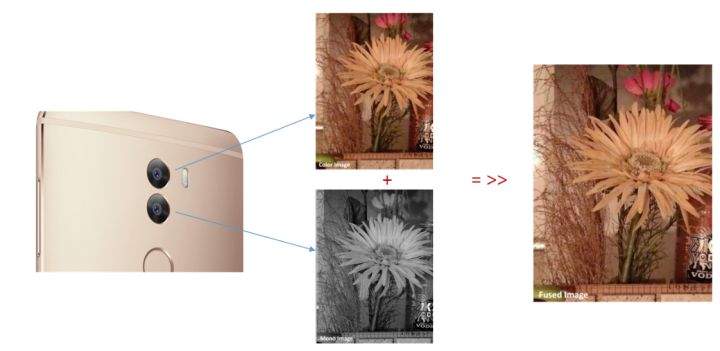 所以业务简单总结就是:读取2张图片,生成1张新的图片。该功能我们放在一个容器里面执行,每张融合后的结果图片大约5GB。 问题的关键是,一个批次业务量需要处理的是3000多张卫星影像,所以每批任务只需要同时运行完成3000多个容器就OK啦。云原生YYDS! # 业务架构图示 为了帮助理解,这里分解使用云原生架构实现该业务场景的逻辑图如下: 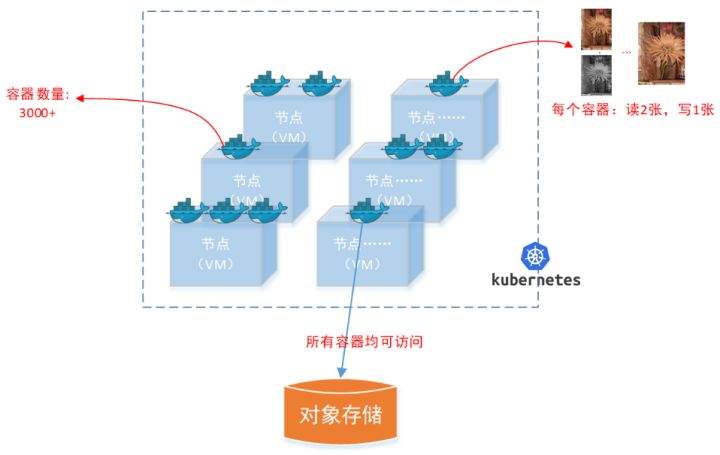 在云上,原始数据,以及结果数据,一定是要存放在对象存储桶里面的。因为这个数据量,只有对象存储的价格是合适的。(对象存储,1毛钱/GB。文件存储则需要3毛钱/GB) 因为容器之间是互相独立无影响的,每个容器只需要处理自己的那幅影像就行。例如1号容器处理 1.tif影像;2号容器处理2.tif影像;一次类推。 所以管理程序,只需要投递对应数量的容器(3000+),并监控每个容器是否成功执行完毕就行(此处为简化说明,实际业务场景是一个pipeline处理流程)。那么,需求已经按照云原生理想的状态分解,咱们开始起(tang)飞(keng)吧~ 注:以下描述的问题,是经过梳理后呈现的,实际问题出现时是互相穿插错综复杂的。 # K8s死掉了 当作业投递后,不多久系统就显示作业纷纷失败。查看日志报调用K8s接口失败,再一看,K8s的Master都已经挂了。。。 K8s-Master处理过程,总结版: 1. 发现Master挂是因为CPU爆了 2. 所以扩容Master节点(此次重复N次); 3. 性能优化:扩容集群节点数量; 4. 性能优化:容器分批投放; 5. 性能优化:查询容器执行进度,少用ListPod接口; 详细版: 看监控Master节点的CPU已经爆掉了,所以最简单粗暴的想法就是给Master扩容呀,嘎嘎的扩。于是从4U8G * 3 一路扩容一路测试一路失败,扩到了32U64G * 3。可以发现CPU还是爆满。看来简单的扩容是行不通了。 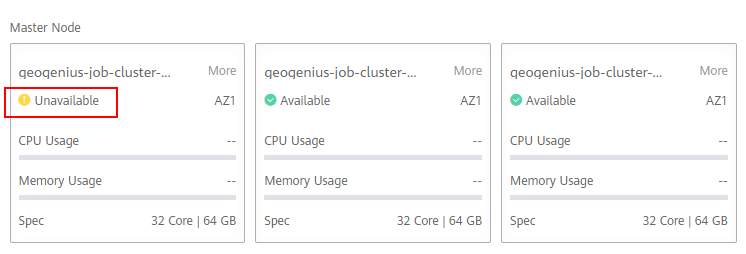 3000多个容器,投给K8s后,大量的容器都处于Pending状态(集群整体资源不够,所以容器都在排队呢)。而正在Pending的Pod,K8s的Scheduler会不停的轮训,去判断能否有资源可以给它安排上。所以这也会给Scheduler巨大的CPU压力。扩容集群节点数量,可以减少排队的Pod数量。 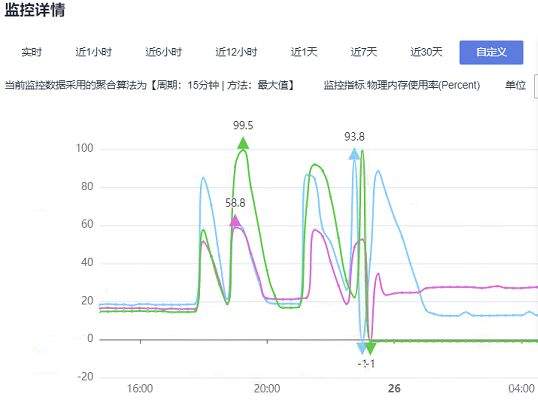 另外,既然排队的太多,不如就把容器分批投递给K8s吧。于是开始分批次投递任务,想着别一次把K8s压垮了。每次投递数量,减少到1千,然后到500,再到100。 同时,查询Pod进度的时候,避免使用ListPod接口,改为直接查询具体的Pod信息。因为List接口,在K8s内部的处理会列出所有Pod信息,处理压力也很大。 这一套组合拳下来,Master节点终于不挂了。不过,一头问题按下去了,另一头问题就冒出来了。 # 容器跑一半,挂了 虽然Master不挂了,但是当投递1~2批次作业后,容器又纷纷失败。 容器挂掉的处理过程,总结版: 1. 发现容器挂掉是被eviction驱逐了; 2. Eviction驱逐,发现原因是节点报Disk Pressure(存储容量满了); 3. 于是扩容节点存储容量; 4. 延长驱逐容器(主动kill容器)前的容忍时间; 详细版: (注:以下问题是定位梳理后,按顺序呈现给大家。但其实出问题的时候,顺序没有这么友好) 容器执行失败,首先想到的是先看看容器里面脚本执行的日志呗:结果报日志找不到~  于是查询Pod信息,从event事件中发现有些容器是被Eviction驱逐干掉了。同时也可以看到,驱逐的原因是 DiskPressure(即节点的存储满了)。 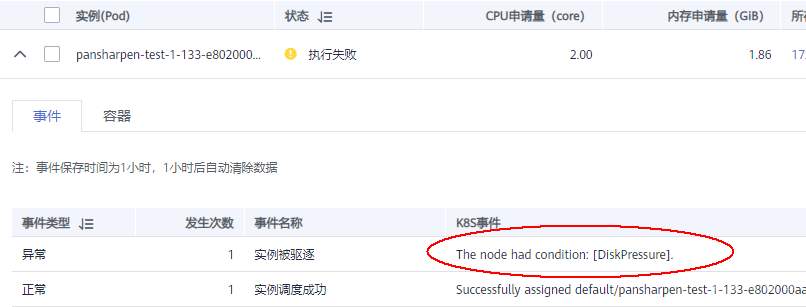 当Disk Pressure发生后,节点被打上了驱逐标签,随后启动主动驱逐容器的逻辑:  由于节点进入Eviction驱逐状态,节点上面的容器,如果在5分钟后,还没有运行完,就被Kubelet主动杀死了。(因为K8s想通过干掉容器来腾出更多资源,从而尽快退出Eviction状态)。 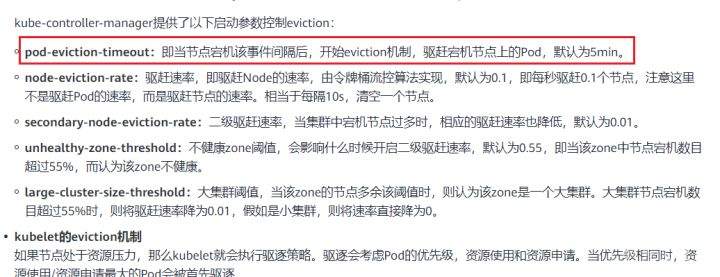 这里我们假设每个容器的正常运行时间为1~2个小时,那么不应该一发生驱动就马上杀死容器(因为已经执行到一半的容器,杀掉重新执行是有成本浪费的)。我们期望应该尽量等待所有容器都运行结束才动手。所以这个 pod-eviction-timeout 容忍时间,应该设置为24小时(大于每个容器的平均执行时间)。 Disk Pressure的直接原因就是本地盘容量不够了。所以得进行节点存储扩容,有2个选择:1)使用云存储EVS(给节点挂载云存储)。 2)扩容本地盘(节点自带本地存储的VM)。 由于云存储(EVS)的带宽实在太低了,350MB/s。一个节点咱们能同时跑30多个容器,带宽完全满足不了。最终选择使用 i3类型的VM。这种VM自带本地存储。并且将8块NVMe盘,组成Raid0,带宽还能x8。 # 对象存储写入失败 容器执行继续纷纷失败。 容器往对象存储写入失败处理过程,总结版: 1. 不直接写入,而是先写到本地,然后cp过去。 2. 将普通对象桶,改为支持文件语义的并行文件桶。 详细版: 查看日志发现,脚本在生成新的影像时,往存储中写入时出错: 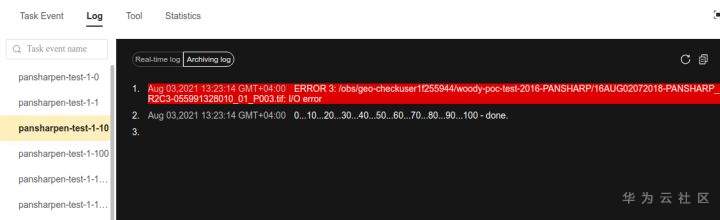 我们整集群是500核的规模,同时运行的容器数量大概在250个(每个2u2g)。这么多的容器同时往1个对象存储桶里面并发追加写入。这个应该是导致该IO问题的原因。 对象存储协议s3fs,本身并不适合大文件的追加写入。因为它对文件的操作都是整体的,即使你往一个文件追加写入1字节,也会导致整个文件重新写一遍。 最终这里改为:先往本地生成目标影像文件,然后脚本的最后,再拷贝到对象存储上。相当于增加一个临时存储中转一下。 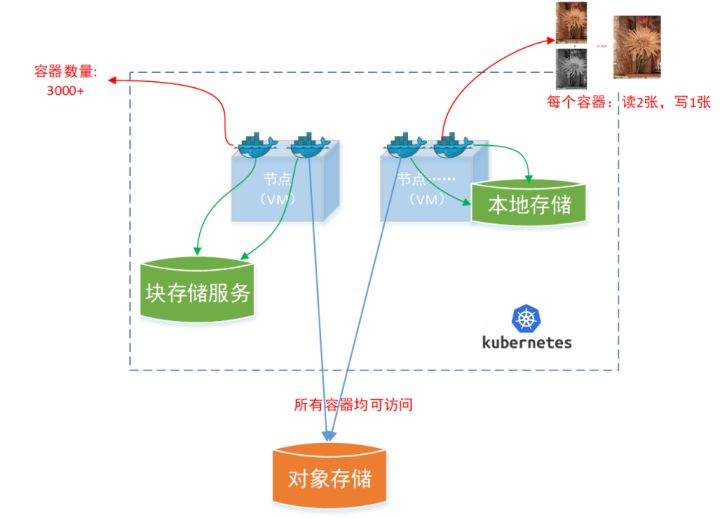 在临时中转存储选择中,2种本地存储都试过: 1)块存储带宽太低,350MB/s影响整体作业速度。2)可以选择带本地存储的VM,多块本地存储组成Raid阵列,带宽速度都杠杠滴。 同时,华为云在对象存储协议上也有一个扩展,使其支持追加写入这种的POSIX语义,称为并行文件桶。后续将普通的对象桶,都改为了文件语义桶。以此来支撑大规模的并发追加写入文件的操作。 # K8s计算节点挂了 So,继续跑任务。但是这容器作业,执行又纷纷失败鸟~ 计算节点挂掉,定位梳理后,总结版: 1. 计算节点挂掉,是因为好久没上报K8s心跳了。 2. 没上报心跳,是因为kubelet(K8s节点的agent)过得不太好(死掉了)。 3. 是因为Kubelet的资源被容器抢光了(由于不想容器经常oom kill,并未设置limit限制) 4. 为了保护kubelet,所有容器全都设置好limit。 详细版,直接从各类奇葩乱象等问题入手: - 容器启动失败,报超时错误。 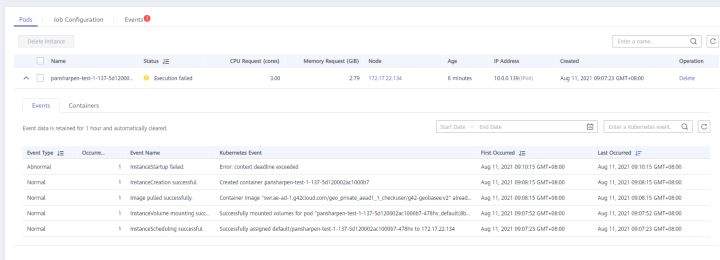 - 然后,什么PVC共享存储挂载失败: 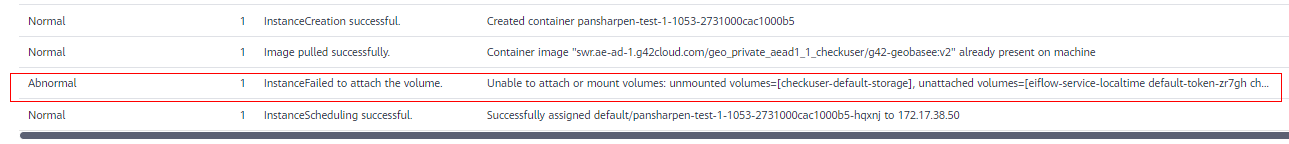 - 或者,又有些容器无法正常结束(删不掉)。 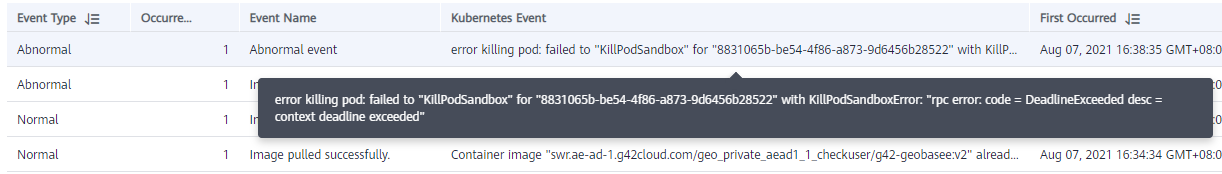 - 查询节点Kubelet日志,可以看到充满了各种超时错误: 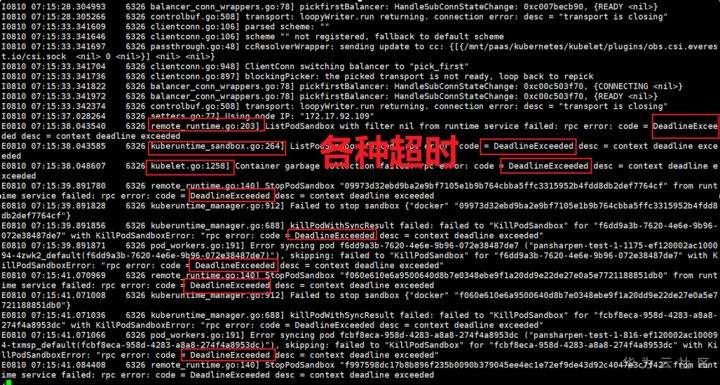 啊,这么多的底层容器超时,一开始感觉的Docker的Daemon进程挂了,通过重启Docker服务来试图修复问题。 后面继续定位发现,K8s集群显示,好多计算节点Unavailable了(节点都死掉啦)。 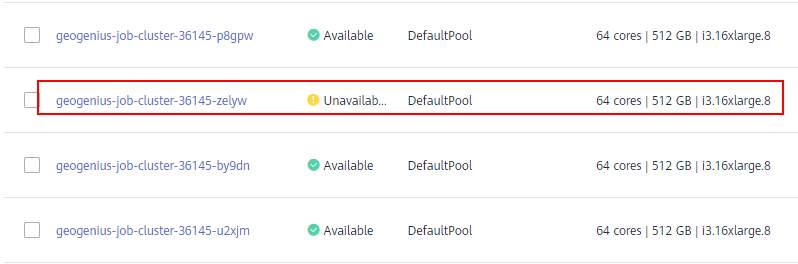 继续分析节点不可用(Unavailable),可以发现是Kubelet好久没有给Master上报心跳了,所以Master认为节点挂了。说明不仅仅是Docker的Daemon受影响,节点的Kubelet也有受影响。 那什么情况会导致Kubelet,Docker这些主机进程都不正常呢?这个就要提到Kubernetes在调度容器时,所设计的Request和Limit这2个概念了。 Request是K8s用来调度容器到空闲计算节点上的。而Limit则会传递给Docker用于限制容器资源上限(触发上限容易被oom killer 杀掉)。前期我们为了防止作业被杀死,仅为容器设置了Request,没有设置Limit。也就是每个容器实际可以超出请求的资源量,去抢占额外的主机资源。大量容器并发时,主机资源会受影响。 考虑到虽然不杀死作业,对用户挺友好,但是平台自己受不了也不是个事。于是给所有的容器都加上了Limit限制,防止容器超限使用资源,强制用户进程运行在容器Limit资源之内,超过就Kill它。以此来确保主机进程(如Docker,Kubelet等),一定是有足够的运行资源的。 # K8s计算节点,又挂了 于是,继续跑任务。不少作业执行又双叒失败鸟~ 节点又挂了,总结版: 1. 分析日志,这次挂是因为PLEG(Pod Lifecycle Event Generator)失败。 2. PLEG异常是因为节点上面存留的历史容器太多(>500个),查询用时太久超时了。 3. 及时清理已经运行结束的容器(即使跑完的容器,还是会占用节点存储资源)。 4. 容器接口各种超时(cpu+memory是有limit保护,但是io还是会被抢占)。 5. 提升系统磁盘的io性能,防止Docker容器接口(如list等)超时。 详细版: 现象还是节点Unavailable了,查看Kubelet日志搜索心跳情况,发现有PLEG is not healthy 的错误: 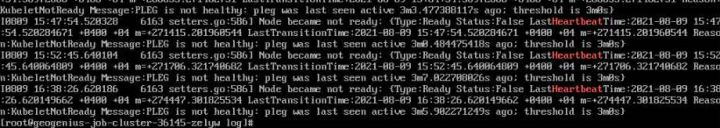 于是搜索PLEG相关的Kubelet日志,发现该错误还挺多: 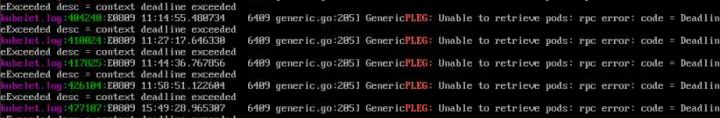 这个错误,是因为kubelet去list当前节点所有容器(包括已经运行结束的容器)时,超时了。看了代码:https://github.com/kubernetes/kubernetes/blob/master/pkg/kubelet/pleg/generic.go#L203 kubelet判断超时的时间,3分钟的长度是写死的。所以当pod数量越多,这个超时概率越大。很多场景案例表明,节点上的累计容器数量到达500以上,容易出现PLEG问题。(此处也说明K8s可以更加Flexible一点,超时时长应该动态调整)。 缓解措施就是及时的清理已经运行完毕的容器。但是运行结束的容器一旦清理,容器记录以及容器日志也会被清理,所以需要有相应的功能来弥补这些问题(比如日志采集系统等)。 List所有容器接口,除了容器数量多,IO慢的话,也会导致超时。 这时,从后台可以看到,在投递作业期间,大量并发容器同时运行时,云硬盘的写入带宽被大量占用: 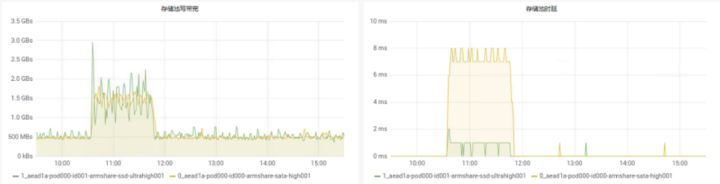 对存储池的冲击也很大: 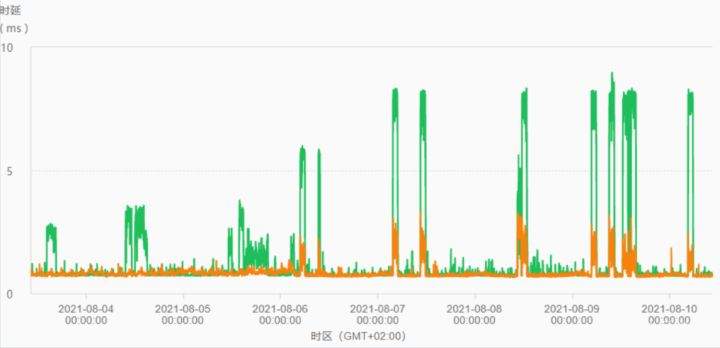 这也导致了IO性能变很差,也会一定程度影响list容器接口超时,从而导致PLEG错误。 该问题的解决措施:尽量使用的带本地高速盘的VM,并且将多块数据盘组成Raid阵列,提高读写带宽。 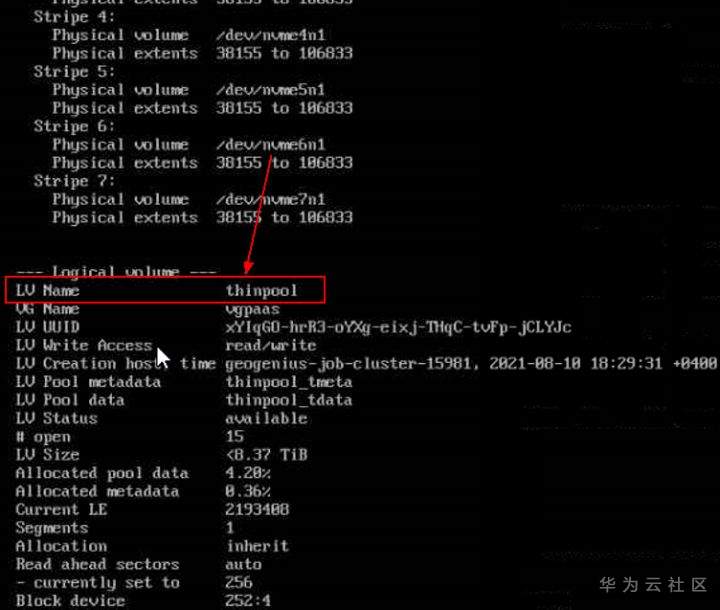 这样,该VM作为K8s的节点,节点上的容器都直接读写本地盘,io性能较好。(跟大数据集群的节点用法一样了,强依赖本地shuffle~)。 在这多条措施实施后,后续多批次的作业都可以平稳的运行完。
-
## 一、K8S是什么? ### 1.1 概述 K8S全名Kubernetes。因k与s之间有8个字符,故缩写为K8S。 K8S是一个可自动实施 Linux 容器管理的可移植、可扩展的开源平台,用于管理容器化的工作负载和服务,可促进声明式配置和自动化。 ## 二、为什么需要K8S? 要了解这个问题,需要回顾一下应用程序的部署方式。 ### 2.1 传统部署 传统部署直接在物理服务器上运行应用程序。存在缺陷: + 无法为服务器中的应用程序定义资源边界,导致资源分配出现问题(一个程序占用大部分资源,其它程序性能下降)。 + 若将应用程序运行在不同物理服务器上,一方面导致资源浪费,另一方面提高成本。 ### 2.2 虚拟化部署 虚拟化技术允许我们在单个的物理服务器上运行多个虚拟机(VM),应用程序在VM之间完全隔离。 每个VM是一个完整的计算机,在虚拟化硬件上运行包括自己的操作系统在内的所有组件。VM共享主机硬件资源。 但因为VM需要运行硬件虚拟副本和完整的操作系统副本,会占用大量的系统资源。 ### 2.3 容器部署 容器将应用程序软件代码和所需的所有组件打包在一起,使得容器内的用意可以在任何基础架构上一致的运行。 + **隔离性**:容器同样可以虚拟化基础计算机,应用程序可在不同容器间实现进程级隔离。 + **轻量性**:每个容器共享物理服务器的OS内核,二进制文件和库,但具有自己的文件系统、CPU、内存、进程空间等。这样的共享可以大大减少重现操作系统代码的需求。因此容器非常轻量,容量小且启动快。 + **可移植**:容器与基础架构分离,可以实现跨云和OS发行版本进行移植。 **K8S**即是在大规模服务器环境中,负责部署和管理容器组,用于解决容器的复制,扩展,健康,启动,负载均衡等问题。只需告诉 Kubernetes 您希望在哪里运行软件,该平台就会负责执行部署和管理容器所需的几乎一切工作。 ## 三、K8S有哪些组件? 我们会在一组用于**运行容器化应用**的节点计算机(Node)的上部署K8S,这一组节点计算机即称为K8S集群。正常运行的K8S集群包含以下组件。 ### 3.1 集群相关术语 + **控制平面(Control Plane):**控制 Kubernetes 节点的进程的集合。所有任务分配都来自于此。 + **节点(Node):**这些机器负责执行由控制平面分配的请求任务。 + **容器集(Pod):**部署到单个节点上且包含一个或多个容器的容器组。容器集是最小、最简单的 Kubernetes 对象。 + **服务(Service):**一种将运行于一组容器集上的应用开放为网络服务的方法。它将工作定义与容器集分离。 + **卷(Volume):**一个包含数据的目录,可供容器集内的容器访问。Kubernetes 卷与所在的容器集具有相同的生命周期。卷的生命周期要长于容器集内运行的所有容器的生命周期,并且在容器重新启动时会保留相应的数据。 + **命名空间(Namespace):**一个虚拟集群。命名空间允许 Kubernetes 管理同一物理集群中的多个集群(针对多个团队或项目)。 ### 3.2 控制平面组件 控制平面的组件对集群做出全局决策(比如调度),以及检测和响应集群事件。控制平面组件可以在集群中的任何节点上运行。 然而,为了简单起见,设置脚本通常会**在同一个计算机上启动所有控制平面组件, 并且不会在此计算机上运行用户容器**。 + **kube-apiserver**:该组件开放 Kubernetes API。API服务器是K8S控制平面的前端。 + **etcd**:etcd 是兼具一致性和高可用性的键值数据库,可以作为保存 Kubernetes 所有集群数据的后台数据库 + **kube-scheduler**:该组件负责监视新创建的、为指定运行节点(node)的Pods,并选择节点让Pod在上面运行。 + **kube-controller-manager**:运行控制器进程的控制平面组件。多中控制器被编译到一个可执行文件,并在一个进程中进行运行。 + **cloud-controller-manager**:云控制器管理器是指嵌入特定云的控制逻辑的 [控制平面](https://kubernetes.io/zh/docs/reference/glossary/?all=true#term-control-plane)组件。 云控制器管理器使得你可以将你的集群连接到云提供商的 API 之上, 并将与该云平台交互的组件同与你的集群交互的组件分离开来。 ### 3.3 Node组件 节点组件在每个节点上运行,维护运行的Pod并提供Kubernetes 运行环境。 + **Kubelet**:每个节点上运行的代理。它保证容器都运行在Pod中。 + **kube-proxy**:kube-proxy 是集群中每个节点上运行的网络代理, 实现 Kubernetes [服务(Service)](https://kubernetes.io/zh/docs/concepts/services-networking/service/) 概念的一部分。它维护节点上的网络规则。这些网络规则允许从集群内部或外部的网络会话与 Pod 进行网络通信。 ### 3.4 容器运行时 容器运行环境是负责运行容器的软件。支持包括像Docker,iSula以及任何实现k8s CRI的容器运行环境。 ### 3.5 其它可用插件 插件并非严格意义上的必须组件。仅列举以下常用的两种。 + **DNS:**几乎所有 Kubernetes 集群都应该有集群DNS。 + **Web界面**:Dashboard 是 Kubernetes 集群的通用的、基于 Web 的用户界面。
-
 当企业计划在公有云中运行工作负载时,需要选择合适的云计算提供商:必须比较不同云计算提供商提供的各种功能和定价,以确定是否最适合其工作负载。但是,如果采用了混合云解决方案,那么选择公有云平台来推动企业发展战略更具挑战性。这不仅需要比较公有云本身的核心特性,还需要比较它们提供的与混合云相关的服务。以下是企业在构建混合云解决方案策略时如何选择合适的云计算提供商的一些建议。公有云和混合云解决方案混合云的含义有点模糊,这使得在某些情况下很难确定什么是混合云。混合云中工作负载部署、管理和监控的集中程度可能会有所不同。然而,所有的混合云解决方案都有一个共同的核心特性:它们将公有云平台的服务与私有基础设施相结合。因此,公有云是混合云的必要组成部分。为混合云解决方案选择合适的公有云如果企业想构建混合云解决方案,那么第一步是决定使用哪个公有云平台,以交付有助于为混合云提供动力的公有云服务或基础设施。这是一个复杂的决定,因为在功能和定价等方面有许多考虑因素。企业不仅需要考虑云计算提供商的服务如何在其云平台中工作,还需要考虑它们如何与私有基础设施集成作为混合云战略的一部分。当企业选择混合云平台时,需要询问以下这些问题:(1)云计算供应商是否有官方的混合云框架?如今,许多云计算供应商都拥有专门设计用于帮助企业部署和管理混合云环境的框架。例如,亚马逊公司提供AWS Outposts和EKS Anywhere。谷歌公司提供Anthos。微软公司提供Azure Stack和Azure Hub。这些框架通常是构建混合云的最简单方法。但它们不一定是最具成本效益的,而且它们往往会将企业锁定在特定公有云平台的混合环境管理工具中。此外,其中一些框架需要使用特定的硬件,而不是允许企业使用其已经拥有的基础设施来构建混合云。出于这些原因,企业可能还希望查看可用于构建混合云环境的公有云平台,但不一定提供为此用例专门构建的框架。如果采用这种方式,可能最终会使用来自第三方供应商的管理工具,例如ServiceNow或ManageEngine。这些解决方案的集成将更加复杂,但它们更加与云计算无关,它们的成本也可能更低。(2)会使用Kubernetes吗?通过Kubernetes部署应用程序是构建混合云的一种简单方法。它允许企业使用Kubernetes来集中和标准化其部署和管理流程,而不管应用程序是由哪个基础设施(公有或私有)托管的。如果企业采用基于Kubernetes的混合云策略,那么在选择公有云平台时主要考虑该平台的Kubernetes服务提供哪些功能,以及该服务与第三方基础设施的集成程度。像Google Anthos这样的Kubernetes服务,谷歌公司推出的明确目标是允许Kubernetes与任何基础设施一起工作,可以说比AWS EKS等服务更适合混合云策略,后者目前与基础设施无关。(3)云计算支持哪些IaC工具?企业能够在混合云环境中使用与基础架构即代码(IaC)模板相同的基础设施,使得企业部署工作负载比在公有云平台上使用一组IaC模板,而在私有基础设施上使用另一组IaC模板更容易。大多数第三方IaC工具可用于任何公有云或内部部署环境。但是,来自公有云平台的原生IaC服务(如AWS CloudFormation)往往仅适用于公有云本身,如果企业采用混合云策略,这可能是一个限制。(4)云计算的IAM平台对混合云的支持程度如何?一般来说,公有云平台的身份和访问管理(IAM)框架设计为仅管理在这些云平台中运行的工作负载的访问。但有时也可以将IAM角色扩展到混合云环境中,从而简化访问管理。例如,企业可以使用AWS或Azure Active Directory来实现这一点。(5)考虑过出口费用吗?由于出口费用(云计算提供商对某些类型的数据移动收取的费用)可能是企业的云计算账单的主要部分,因此应该仔细评估其正在考虑的公有云平台的出口费用。需要特别注意的是,出口费用如何影响企业计划构建的混合架构。例如,如果使用虚拟私有云(VPC),需要评估将数据移入和移出虚拟私有云(VPC)的成本。(6)提供哪些网络服务?在虚拟私有云(VPC)方面,VPC和其他网络服务通常是将私有基础设施与公有云集成的重要组成部分。网络服务也往往高度复杂和微妙。例如Azure VPN网关和Azure Express Route都允许企业将私有基础设施与Azure公有云连接,但它们的连接方式略有不同。企业应该进行研究以确定每个公有云提供的网络服务类型,以及根据功能和价格最适合其混合云计划。结论任何公有云平台都可以作为混合云架构的一部分。但是,公有云在从出口费用和网络功能到混合云管理和Kubernetes服务等领域存在显著的差异。在企业决定哪种公有云平台最适合其混合云愿景时,需要评估所有这些方面。
-
 什么是多云和混合云伴随着Kubernetes和云原生的普及,高可用、高并发以及弹性突发等也成为很多应用程序的必备要求。而要实现这些功能,就需要应用程序不仅可以跨可用区和跨地区部署,还需要在云服务商容量不足或发生故障时自动切换到其他的云服务商或者混合云环境中去。并且,很多人也不希望把自己的所有服务都绑定到某一个云服务商中。多云和混合云就是指应用程序可以跨本地数据中心和多家云服务商混合部署,并可以按需在它们之间进行动态调度。多云和混合云的好处包括:解除云服务商锁定:不再单纯依赖于某一家云服务商或某个地域的数据中心可用性保障:不仅可以跨地区和跨地域,即使某个云服务商出现故障应用程序还可以继续在其他云服务商运行成本优化:可以根据云服务商的价格选择成本较低的方案,甚至是根据友商的成本去议价弹性突发保障:本地数据中心或云服务商容量不足时,还可以扩展到其他云服务商中去但是,多云和混合云的难点也很明显,最突出的结果问题是:跨云网络的打通跨云数据的一致性海量数据的访问延迟多云接口不一致带来的管理复杂度为了解决这些问题,在 Kubernetes 诞生之前,其实就有很多云管理平台专门解决云平台资源异构的问题。这些云管理平台解决了云资源的管理、成本的优化甚至是应用的 Devops 等各种问题,但一般并不负责实际管理应用的编排,所以在很多地方也被称之为多云 1.0。Kubernetes催生了多云2.0在 Kubernetes 和容器技术诞生之前,要实现多云和混合云是相当难的,需要针对每一个云服务商进行定制化开发。由于应用程序跟云服务商的接口绑定,所以也会导致迁移云服务商时需要从基础架构到应用程序都做相应的适配。这是很多人在上云时都会碰到的痛点,这可以通过云管理平台来解决。不过,目前的云管理平台更侧重于云资源的管理。虽然很多云管理平台也会提供应用的Deveops,但实际上只是把应用分发到不同的云平台上,并不负责应用程序的编排。比如,要想实现跨云的高可用和弹性突发,应用程序还是需要去调用不同云服务商的接口。有了Kubernetes 和容器之后,本地数据中心和云服务商的Kubernetes集群可以提供一致的接口,这样应用程序在大部分情况下就不需要跟具体的云服务商直接绑定了。如果只考虑Kubernetes集群,云管理平台也可以进一步简化为多云的Kubernetes集群管理,再借助于Kubernetes Operator模式,很多Kubernetes应用依赖的云资源可以抽象为相同的CRD。这就进一步解耦了应用和云服务商,被很多人称之为多云 2.0。说到Kubernetes的多云,最理想的是同一个Kubernetes集群横跨在多个不同的云平台上,通过同一个Kubernetes API去管理所有的应用。当然,由于云服务商差异、网络延迟、数据存储以及Kubernetes自身的规模限制等等,这种理想情况并不实用。所以,现在主流的方法都是在不同的地区以及不同的云服务商运行多个集群,再在这些集群之上打通多个集群的应用。比如,最简单的是在多个集群中部署服务的副本,再通过 Consul、Linkerd 或者 Global DNS 去为它们做负载均衡。
-
 Volcano是一个基于Kubernetes的云原生批量计算平台,也是CNCF的首个批量计算项目。Volcano 主要用于AI、大数据、基因、渲染等诸多高性能计算场景,对主流通用计算框架均有很好的支持。它提供高性能计算任务调度,异构设备管理,任务运行时管理等能力。本篇文章将从Volcano架构、Volcano核心概念及功能、Volcano Code Tour、平台组件安装部署等方面来带大家认识Volcano。 Volcano架构 1、Volcano全景Volcano是基于Kubernetes的高性能批量计算平台,目前支持几乎所有的主流计算框架,包括MindSpore、TensorFlow、Kubeflow、MPI、PyTorch、飞浆、Spark、HOROVOD 等。Volcano支持的部分计算框架 计算框架遇到的问题:1)1:1的operator部署运维复杂2)不同框架对作业管理、并行计算等要求不同3)计算密集高,资源需求波动大,需要高级调度能力 Volcano面向主流计算框架提供:1)统一容器基础设施,提高资源利用率2)通用作业管理、队列Fair-share, Gang, bin-pack等高级调度算法3)简化运维管理 2、Volcano整体架构Volcano利用声明式的CRD定义我们的API,主要有3个核心的API,Volcano Job、PodGroup、Queue。Volcano Job 是对高性能任务的通用定义,PodGroup提供了Job中Task的管理能力,Queue 为任务的分类提供了基础。Volcano的架构 Volcano 核心组件主要包含三个:Admission、ControllerManager、Scheduler 。Admission对Volcano CRD API提供校验能力;ControllerManager负责对Volcano CRD进行资源管理;Scheduler对任务提供丰富的调度能力。 3、Volcano工作流程从零开始运行Volcano作业:1)用户创建一个 Volcano 作业2)Volcano Admission 拦截作业的创建请求,并进行合法性校验3)Kubernetes 持久化存储 Volcano Job 到 ETCD4)ControllerManager 通过 List-Watch 机制观察到Job 资源的创建,创建任务(Pod)5)Scheduler 负责任务的调度,绑定 Node6)Kubelet Watch 到 Pod的创建,接管 Pod 的运行7)ControllerManager 监控所有任务的运行状态,保证所有的任务在期望的状态下运行 Volcano核心概念及功能1、Volcano核心概念1)Queue:Queue的概念源于 Yarn,它是Cluster 级别的资源对象,可为其声明资源配额,也可由多namespace 共享,并且提供 soft isolation2)PodGroup:PodGroup是任务的分组,它与 queue 绑定,占用队列的资源。它与 Volcano Job 是一对一的关系;也可为其声明 Scheduling 条件3)Volcano Job:它是批量计算作业的定义,支持定义作业所属队列、生命周期策略、所包含的任务模板以及持久卷等信息 2、作业管理插件 svc:提供不同类型任务之间互访能力env:任务索引,例如 Tensorflow Worker indexssh:ssh 秘钥对创建及挂载,主要供 MPI 作业使用 3、Scheduler架构Scheduler支持动态配置和加载。 4、核心调度算法1)Gang Scheduling2)Fair Share3)Preempt & Reclaim4)Reserve & Backfill5)Topology Aware Scheduling6)GPU Sharing Volcano Code Tourcmd目录是Volcano所有组件启动的入口;config 是Volcano的配置;defs 是安装时的配置;docs 是Volcano的设计文档;example 提供了简单的例子,hack 提供安装时的脚本;installer 提供安装的模板。 pkg 是最重要的目录,里面包含了 api、controller、scheduler 、webhook 等代码。test 提供了e2e测试用例, vendor是依赖库。 安装部署1、Volcano InstallVolcano安装部署有多种方式:若已存在K8S集群,建议通过 Helm方式安装部署,该方式支持自定义安装配置;开发者建议通过Development Yaml方式部署。 对于开发者,Volcano已内置一键式安装部署脚本,路径为 volcano. sh/volcano/hack/local-up-volcano. sh。运行该脚本时,默认会使用kind创建 Docker in Docker的模拟集群,并安装部署Volcano。 2、Volcano 组件正确安装部署后,将生成4个组件,分别为:Volcano-admission、Volcano-admission-init、Volcano-controllers、 Volcano-scheduler ,其中admission-init以作业的方式生成证书。
-
Helm应用包管理器,辅助管理 Kubernetes 应用程序,Helm Charts 定义、安装和升级复杂的 Kubernetes 应用程序。Helm是一个Kubernetes的包管理工具,就像Linux下的包管理器,如yum/apt等,可以很方便的将之前打包好的yaml文件部署到kubernetes上。Helm有两个重要概念:- helm:一个命令行客户端工具,主要用于Kubernetes应用chart的创建、打包、发布和管理。- Chart:应用描述,一系列用于描述 k8s 资源相关文件的集合。- Release:基于Chart的部署实体,一个 chart 被 Helm 运行后将会生成对应的一个 release;将在k8s中创建出真实运行的资源对象。 为什么需要Helm?K8S上的应用对象,都是由特定的资源描述组成,包括deployment、service等。都保存各自文件中或者集中写到一个配置文件。然后统一通过kubectl apply –f 部署。这种命令行部署的方式,只适合应用只由一个或几个这样的服务组成的简单应用,而对于一个复杂的应用,会有很多类似上面的资源描述文件,例如微服务架构应用,组成应用的服务可能多达十个,几十个。如果有更新或回滚应用的需求,可能要修改和维护所涉及的大量资源文件,而这种手动的组织和管理应用的方式就显得不足了。并且由于缺少对发布过的应用版本管理和控制,使Kubernetes上的应用维护和更新等面临诸多的挑战,主要面临以下问题:1. 如何将这些服务作为一个整体管理:如应用的快速迁移2. 这些资源文件如何高效复用:同一个应用稍做改动,部署另外一个应用上去。3. 不支持应用级别的版本管理:微服务面临的灰度发布helm可以很好的解决这些问题。
-
StatefulSet控制器用于部署有状态应用,满足一些有状态应用的需求,主要考虑三个方面问题: 1.Pod有序的部署、扩容、删除和停止 2.Pod分配一个稳定的且唯一的网络标识 3.Pod分配一个独享的存储稳定的网络标识:使用Headless Service(相比普通Service只是将spec.clusterIP定义为None)来维护Pod网络身份,会为每个Pod分配一个数字编号并且按照编号顺序部署。还需要在StatefulSet添加 serviceName: “xxx”字段指定StatefulSet控制器要使用这个Headless Service。稳定的网络标识主要体现在主机名和Pod A记录:主机名:<statefulset名称>-<编号> Pod DNS A记录:<statefulset名称-编号>.<service-name> .<namespace>.svc.cluster.local[root@k8s-node2 ~]# vi headless-service.yamlapiVersion: v1kind: Servicemetadata: name: headless-webspec: clusterIP: None selector: app: nginx type: ClusterIP ports: - protocol: TCP port: 80 targetPort: 9376[root@k8s-node2 ~]# vi head.yamlapiVersion: apps/v1kind: StatefulSetmetadata: name: webspec: serviceName: "headless-web" replicas: 3 selector: matchLabels: app: nginx template: metadata: labels: app: nginx spec: containers: - name: nginx image: nginx ports: - containerPort: 80 name: webkubectl apply -f headless-service.yamlkubectl apply -f head.yaml[root@k8s-node2 ~]# kubectl get podNAME READY STATUS RESTARTS AGEdns-test 1/1 Running 0 42mweb-0 1/1 Running 0 10mweb-1 1/1 Running 0 10mweb-2 1/1 Running 0 10m[root@k8s-node2 ~]# kubectl get svcNAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEheadless-web ClusterIP None <none> 80/TCP 22mkubernetes ClusterIP 10.96.0.1 <none> 443/TCP 5d3h[root@k8s-node2 ~]# 启用一个dns测试容器:kubectl run -i -t dns-test --image busybox:1.28.4 /bin/sh/ # nslookup headless-webServer: 10.96.0.10Address 1: 10.96.0.10 kube-dns.kube-system.svc.cluster.localName: headless-webAddress 1: 10.244.169.161 web-1.headless-web.default.svc.cluster.localAddress 2: 10.244.169.160 web-0.headless-web.default.svc.cluster.localAddress 3: 10.244.169.162 web-2.headless-web.default.svc.cluster.local
-
Kubernetes 安全框架主要由下面3个阶段进行控制,每一个阶段都支持插件方式,通过API Server配置来启用插件。1. Authentication(鉴权)2. Authorization(授权)3. Admission Control(准入控制)与通信行业常用的radius3A认证类似,也有鉴权、授权,不同的radius的第三个A是accounting统计。前两个A好理解,后面的准入控制难理解。为什么授权了之后还要有准入控制呢?个人理解,准入控制和授权是不同粒度的控制,授权的粒度更大,准入控制的更精细,就好像门锁和抽屉的锁。Adminssion Control实际上是一个准入控制器插件列表,发送到API Server的请求都需要经过这个列表中的每个准入控制器插件的检查,检查不通过,则拒绝请求。客户端要访问k8s集群API Server,一般需要证书、token或者用户名密码;如果是Pod访问,则需要ServiceAccount。前面是 例如kubectl 对 apiserver 的一个请求过程;后面是 Pod 中的业务逻辑与 apiserver 之间的交互。apiserver 收到访问请求后,就会开启访问控制流程。如果Authentication 认证阶段判定为不合法用户,那 apiserver 会返回一个 401 的状态码,并终止该请求;(跟volte的信令流程类似)如果用户合法的话,进入到访问控制的第二阶段鉴权,判断用户是否有权限进行请求中的操作。这个阶段是粗分类,只判定有权无权。如果无权,apiserver 会返回 403 的状态码,并终止该请求;如果用户有权,访问控制会进入更细化的控制阶段:AdmissionControl。在该阶段中 apiserver 的 admission controller 会判断请求是否是一个安全合规的请求。
-
部署kubernetes dashboard,首先下载yaml文件。以前安装软件下载庞大的安装包,k8s的环境(docker环境)慢慢习惯拽yaml文件,大象在跳舞~wget https://raw.githubusercontent.com/kubernetes/dashboard/v2.0.3/aio/deploy/recommended.yaml需要修改资源模式,增加 type: NodePortkind: ServiceapiVersion: v1metadata: labels: k8s-app: kubernetes-dashboard name: kubernetes-dashboard namespace: kubernetes-dashboardspec: type: NodePort ports: - port: 443 targetPort: 8443 nodePort: 30001 selector: k8s-app: kubernetes-dashboard type: NodePort---应用yaml文件:kubectl apply -f recommended.yaml[root@k8s-node2 ~]# kubectl get pod -n kubernetes-dashboard NAME READY STATUS RESTARTS AGEdashboard-metrics-scraper-7b9b99d599-p8l5s 1/1 Running 0 118skubernetes-dashboard-6d4799d74-g2cml 1/1 Running 0 118s[root@k8s-node2 ~]# kubectl get svc -n kubernetes-dashboardNAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEdashboard-metrics-scraper ClusterIP 10.101.25.179 <none> 8000/TCP 3m9skubernetes-dashboard NodePort 10.103.25.173 <none> 443:30001/TCP 3m9s通过EIP:30001访问dashboard。提示使用https访问。使用token的方式访问,首先需要创建一个用户,然后赋予其权限,绑定到用户的角色。[root@k8s-node2 ~]# kubectl create serviceaccount dashboard-admin -n kube-systemserviceaccount/dashboard-admin created[root@k8s-node2 ~]# kubectl create clusterrolebinding dashboard-admin --clusterrole=cluster-admin --serviceaccount=kube-system:dashboard-adminclusterrolebinding.rbac.authorization.k8s.io/dashboard-admin created查看生成的token:[root@k8s-node2 ~]# kubectl describe secrets -n kube-system $(kubectl -n kube-system get secret | awk '/dashboard-admin/{print $1}')Name: dashboard-admin-token-dwq7lNamespace: kube-systemLabels: <none>Annotations: kubernetes.io/service-account.name: dashboard-admin kubernetes.io/service-account.uid: fe5cc6bb-1316-4b08-ada2-5e17ec3603acType: kubernetes.io/service-account-tokenData====token: eyJhbGciOiJSUzI1NiIsImtpZCI6IndOZU5Rajl2LThFTH将token 复制到网页中
-
近日,国际权威咨询机构Forrester发布《The Forrester New WaveTM: Public Cloud Enterprise Container Platforms, Q3 2019》报告,报告显示:华为云容器进入"强劲表现者"象限,稳居全球容器产品TOP阵营,是客户使用容器混合云的最佳选择。社区贡献亚洲第一、全球第三华为云从2015年起就开始投入云原生产业,是云原生基金会(CNCF)的初创会员、白金会员,在Kubernetes社区的贡献一直稳居亚洲第一、全球第三,是全球首批Kubernetes认证服务提供商。同时,华为云在Kubernetes社区拥有10个Maintainer席位,并负责Kubernetes调度、集群联邦、网络、架构、安全等多个特性,是相关技术在社区的领导者。领先的云容器全栈解决方案基于华为多年在云原生领域的持续贡献与积累,华为云基于容器基础设施服务,打造了一套完整的云容器全栈解决方案,覆盖容器基础设施、容器运维管理和行业容器解决方案,为客户提供最优、最丰富的云容器服务选择。"华为云容器具备强大的安全和应用生命周期管理能力,安全能力覆盖面很广,CI/CD流水线及微服务使得云原生开发非常高效"——Forrester报告1、容器基础设施:包括Kubernetes容器(CCE)和Serverless容器(CCI),以及基于这两个基础服务衍生出的裸金属容器、GPU容器等。为用户提供最基本的容器集群、应用管理能力。2、容器运维管理:一套覆盖端到端的容器运维管理体系,涵盖资源编排、容器应用持续交付、应用生命周期管理、镜像安全扫描以及日常运维监控能力,通过这些工具,可以降低容器使用门槛,极大的提升传统IT向云原生转型的效率,以及云原生转型后的IT运维管理效率。3、行业解决方案:面向基因、AI、边缘等业务场景打造的解决方案,将云原生与业务场景融合,帮助客户业务快速实现云原生转型。目前华为云容器全栈服务已经在互联网、金融、资讯、基因、游戏、渲染等行业得到广泛应用。混合云容器最佳选择"华为云的多云管理平台(MCP)以及私有云服务(HCSO)可以在混合云场景下使用,如果企业在寻找(容器)混合云解决方案,那么华为云是最佳选择。"——Forrester报告2019年3月22日,在华为全球生态伙伴大会上,华为云发布了多云混合云解决方案,这是全球首个容器混合云解决方案,为客户提供容器集群及云原生应用的跨云管理能力,不但为客户解决了平台供应商锁定的问题,还可轻松对应跨云应用自动容灾、峰值流量智能分担、业务地域化策略运营的诉求,是一种更优的跨云解决方案。业界首发鲲鹏容器2019年7月23日,华为云发布鲲鹏Kubernetes容器和鲲鹏Severless容器,是目前业界首发支持华为鲲鹏平台的容器服务,支持X86和鲲鹏节点的混合管理,基于强大的应用生命周期管理能力,实现原有应用到鲲鹏平台的无感迁移,同时在性能较业界有极大提升,容器发放速度可达每秒1000个,领先业界10倍,服务请求转发效率领先业界50%,整体性价比提升30%。华为云将持续大力投入云原生领域,并坚持以客户为中心的服务理念,为客户提供领先的、贴合行业的技术和商业解决方案,更好的服务客户。
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签