-
 华为云鲲鹏openEuler 20.03安装kubesphere,之前已安装好kubernetes,现在在 Kubernetes 上最小化安装 KubeSphere,出现exec /shell-operator: exec format error,看样子,好像是下载了x86的文件?怎么解决[root@master01 ~]# kubectl apply -f https://github.com/kubesphere/ks-installer/releases/download/v3.2.1/cluster-configuration.yamlcustomresourcedefinition.apiextensions.k8s.io/clusterconfigurations.installer.kubesphere.io creatednamespace/kubesphere-system createdserviceaccount/ks-installer createdclusterrole.rbac.authorization.k8s.io/ks-installer createdclusterrolebinding.rbac.authorization.k8s.io/ks-installer createddeployment.apps/ks-installer created[root@master01 ~]# kubectl logs -n kubesphere-system $(kubectl get pod -n kubesphere-system -l app=ks-install -o jsonpath='{.items[0].metadata.name}') -fError from server (BadRequest): container "installer" in pod "ks-installer-85dcfff87d-c9jbv" is waiting to start: ContainerCreating[root@master01 ~]# kubectl logs -n kubesphere-system $(kubectl get pod -n kubesphere-system -l app=ks-install -o jsonpath='{.items[0].metadata.name}') -fexec /shell-operator: exec format error
-
华为云鲲鹏openEuler 20.03上,利用kubesphere安装kubernetes出错,之前在另一台服务器鲲鹏Euler OS上没有这个问题,如何解决?[root@master01 ~]# systemctl status etcd.service● etcd.service - etcdLoaded: loaded (/etc/systemd/system/etcd.service; disabled; vendor preset: disabled)Active: activating (auto-restart) (Result: exit-code) since Wed 2022-11-09 15:29:42 CST; 9s agoProcess: 50396 ExecStart=/usr/local/bin/etcd (code=exited, status=203/EXEC)Main PID: 50396 (code=exited, status=203/EXEC)[root@master01 ~]#[root@master01 ~]# journalctl -xe-- Defined-By: systemd-- Support: https://lists.freedesktop.org/mailman/listinfo/systemd-devel---- A start job for unit etcd.service has begun execution.---- The job identifier is 17028.Nov 09 15:31:04 master01 systemd[50452]: etcd.service: Failed to execute command: Exec format errorNov 09 15:31:04 master01 systemd[50452]: etcd.service: Failed at step EXEC spawning /usr/local/bin/etcd: Exec format error-- Subject: Process /usr/local/bin/etcd could not be executed-- Defined-By: systemd-- Support: https://lists.freedesktop.org/mailman/listinfo/systemd-devel---- The process /usr/local/bin/etcd could not be executed and failed.---- The error number returned by this process is ERRNO.Nov 09 15:31:04 master01 systemd[1]: etcd.service: Main process exited, code=exited, status=203/EXEC-- Subject: Unit process exited-- Defined-By: systemd-- Support: https://lists.freedesktop.org/mailman/listinfo/systemd-devel---- An ExecStart= process belonging to unit etcd.service has exited.---- The process' exit code is 'exited' and its exit status is 203.Nov 09 15:31:04 master01 systemd[1]: etcd.service: Failed with result 'exit-code'.-- Subject: Unit failed-- Defined-By: systemd-- Support: https://lists.freedesktop.org/mailman/listinfo/systemd-devel---- The unit etcd.service has entered the 'failed' state with result 'exit-code'.Nov 09 15:31:04 master01 systemd[1]: Failed to start etcd.-- Subject: A start job for unit etcd.service has failed-- Defined-By: systemd-- Support: https://lists.freedesktop.org/mailman/listinfo/systemd-devel---- A start job for unit etcd.service has finished with a failure.---- The job identifier is 17028 and the job result is failed.Nov 09 15:31:04 master01 audit[1]: SERVICE_START pid=1 uid=0 auid=4294967295 ses=4294967295 msg='unit=etcd comm="systemd" exe="/usr/lib/systemd/systemd>[root@master01 ~]#
-
是i↵我想知道,在华为云鲲鹏openEuler 20.03上部署的kubernetes,pull获取k8s.gcr.io/sig-storage/nfs-subdir-external-provisioner:v4.0.2,如何自动根据节点判断下载arm还是x86容器?如果是x86的,应该不能在arm上运行吧?
-
 1. 组件版本和配置策略1.1 主要组件版本组件版本发布时间kubernetesv1.23.32022-01-26etcdv3.5.22022-02-01cri-ov1.23.02021-12-18flannelv0.16.32022-01-29coredns1.9.02022-02-10cni-pluginsv1.0.12021-09-081.2 主要配置策略kube-apiserver:使用节点本地 nginx 4 层透明代理实现高可用;关闭非安全端口 8080 和匿名访问;在安全端口 5443 接收 https请求;严格的认证和授权策略 (x509、token、RBAC);开启 bootstrap token 认证,支持 kubeletTLS bootstrapping;使用 https 访问 kubelet、etcd,加密通信;kube-controller-manager:3 节点高可用; 关闭非安全端口,在安全端口 10257 接收 https 请求;使用 kubeconfig 访问 apiserver的安全端口;自动 approve kubelet 证书签名请求 (CSR),证书过期后自动轮转;各 controller 使用自己的ServiceAccount 访问 apiserver;kube-scheduler:3 节点高可用; 使用 kubeconfig 访问 apiserver 的安全端口;关闭非安全端口,在安全端口 10259 接收https 请求;kubelet:使用 kubeadm 动态创建 bootstrap token,而不是在 apiserver 中静态配置;使用 TLSbootstrap 机制自动生成 client 和 server 证书,过期后自动轮转;在 KubeletConfiguration类型的 JSON 文件配置主要参数;关闭只读端口,在安全端口 10250 接收 https请求,对请求进行认证和授权,拒绝匿名访问和非授权 访问;使用 kubeconfig 访问 apiserver 的安全端口;kube-proxy:使用 kubeconfig 访问 apiserver 的安全端口;在 KubeProxyConfiguration 类型的 JSON文件配置主要参数;使用 ipvs 代理模式;集群插件:DNS:使用功能、性能更好的 coredns;2. 初始化系统和全局变量2.1 集群规划master节点:节点名称IP地址k8s-master-1192.168.2.175k8s-master-2192.168.2.176k8s-master-3192.168.2.178node 节点:节点名称IP地址k8s-node-1192.168.2.185k8s-node-2192.168.2.187k8s-node-3192.168.3.62k8s-node-4192.168.3.70控制节点/配置生成节点:节点名称IP地址qist192.168.0.151工作目录: /opt三台机器混合部署本文档的 etcd、master 集群和 woker 集群。如果没有特殊说明,需要在所有节点上执行本文档的初始化操作。2.2 kubelet cri-o cgroupCgroup Driver:systemd kubeelt cri-o Cgroup 配置为systemd2.3 设置主机名hostnamectl set-hostname k8s-master-1 # 将 k8s-master-1 替换为当前主机名退出,重新登录 root 账号,可以看到主机名生效。2.4 添加节点信任关系本操作只需要在 qist 节点上进行,设置 root 账户可以无密码登录所有节点:ssh-keygen -t rsa ssh-copy-id root@192.168.2.175 ssh-copy-id root@192.168.2.176 ssh-copy-id root@192.168.2.177 ssh-copy-id root@192.168.2.185 ssh-copy-id root@192.168.2.187 ssh-copy-id root@192.168.3.62 ssh-copy-id root@192.168.3.702.5 安装依赖包yum install -y epel-release yum install -y chrony conntrack ipvsadm ipset jq iptables curl sysstat libseccomp wget socat gitkube-proxy 使用 ipvs 模式,ipvsadm 为 ipvs 的管理工具;etcd 集群各机器需要时间同步,chrony用于系统时间同步;2.6 关闭防火墙关闭防火墙,清理防火墙规则,设置默认转发策略:systemctl stop firewalld systemctl disable firewalld iptables -F && iptables -X && iptables -F -t nat && iptables -X -t nat2.7 关闭 swap 分区关闭 swap 分区,否则kubelet 会启动失败(可以设置 kubelet 启动参数 --fail-swap-on 为 false 关闭 swap检查):swapoff -a sed -i '/ swap / s/^\(.*\)$/#\1/g' /etc/fstab2.8 关闭 SELinux关闭 SELinux,否则 kubelet 挂载目录时可能报错 Permission denied :setenforce 0 sed -i 's/^SELINUX=.*/SELINUX=disabled/' /etc/selinux/config2.9 优化内核参数cat > /etc/sysctl.d/kubernetes.conf <关闭 tcp_tw_recycle,否则与 NAT 冲突,可能导致服务不通;内核低于4版本添加fs.may_detach_mounts=12.10 系统文件打开数cat>>/etc/security/limits.conf<centos7还需修改sed-i's/4096/655350/'/etc/security/limits.d/20-nproc.conf2.11 内核模块配置重启自动加载加载ipvs内核模块cat>/etc/modules-load.d/k8s-ipvs-modules.conf<加载netfilter等模块 内核4版本以下 nf_conntrack 替换 nf_conntrack_ipv4cat>/etc/modules-load.d/k8s-net-modules.conf<2.12 设置系统时区timedatectlset-timezoneAsia/Shanghai2.13 设置系统时钟同步systemctl enable chronyd systemctl start chronyd查看同步状态:timedatectl status输出:System clock synchronized: yes NTP service: active RTC in localTZ: noSystem clock synchronized: yes,表示时钟已同步;NTP service: active,表示开启了时钟同步服务;#将当前的UTC时间写入硬件时钟 timedatectlset-local-rtc0#重启依赖于系统时间的服务 systemctl restart rsyslog systemctl restart crond2.14 关闭无关的服务systemctl stop postfix && systemctl disable postfix2.15 创建相关目录创建目录:master 组件目录#k8s目录 mkdir -p /apps/k8s/{bin,log,conf,ssl,config} mkdir -p /apps/work/kubernetes/{manifests,kubelet} mkdir -p /var/lib/kubelet mkdir- p /usr/libexec/kubernetes/kubelet-plugins/volume/exec/ mkdir -p /apps/k8s/ssl/{etcd,k8s} #etcd目录 mkdir -p /apps/etcd/{bin,conf,data,ssl} #etcd data-dir目录 mkdir -p /apps/etcd/data/default.etcd #etcdwal-dir目录 mkdir -p /apps/etcd/data/default.etcd/walnode 节点目录mkdir -p /apps/k8s/{bin,log,conf,ssl} mkdir -p /apps/work/kubernetes/{manifests,kubelet} mkdir -p /var/lib/kubelet mkdir -p /usr/libexec/kubernetes/kubelet-plugins/volume/exec/cri-o 目录结构创建mkdir -p /apps/crio/{run,etc,keys} mkdir -p /apps/crio/containers/oci/hooks.d mkdir -p /etc/containers mkdir -p /var/lib/containers/storage mkdir -p /run/containers/storage mkdir -p /apps/crio/lib/containers/storage mkdir -p /apps/crio/run/containers/storage2.16 mount目录挂载挂载kubelet 跟cri-o数据目录最大兼容其它依赖组件例如csi插件cat>> /etc/fstab <验证挂载是否有误mount-a重启机器:sync reboot期待下次的分享,别忘了三连支持博主呀~ 我是 念舒_C.ying ,期待你的关注~💪💪💪
-
摘要:KubeEdge设备管理架构的设计实现,有效帮助用户处理设备数字孪生进程中遇到的场景。本文分享自华为云社区《KubeEdge:下一代云原生边缘设备管理标准DMI的设计与实现》。随着5G、AI、分布式云等技术的成熟发展,万物互联、数字孪生、算力泛在等理念不断推进,带来了很多行业业务的创新,越来越多的设备、应用运行在端侧,并产生大量的数据。如何更好地解耦业务应用开发和设备数据访问,为设备提供完整的生命周期数据管理,释放设备数据的价值?如何在保证集群可用性的同时,高效管理和传输设备数据,获得更为方便、灵活的数据访问方式?云原生边缘计算的方案选择可以帮助用户更好地应对这类问题。一、KubeEdge设备管理框架KubeEdge设备管理架构的设计实现,有效帮助用户处理设备数字孪生进程中遇到的场景。用户可以通过KubeEdge,将物理设备抽象成数字孪生,用云原生的方式对设备和数据进行管理。一、KubeEdge设备管理框架 图 1 KubeEdge设备管理架构设计KubeEdge设备管理架构设计如图1所示,具体流程如下:1. 用户调用Kubernetes API接口,创建Device CRD实例到KubeEdge2. KubeEdge云上组件CloudCore watch到Kubernetes中Device CRD实例创建消息3. 此时CloudCore会做两件事情,一方面CloudCore通过云边websocket通道下发Device Twin信息到EdgeCore,另一方面CloudCore会生成一份包含Device Profile信息的Configmap,该Configmap是以Node名称为索引,挂载到对应Mapper的Pod中的4. Mapper通过读取挂载的Configmap中的Device Profile信息,更新本地维护的Device list列表5. EdgeCore把接收到的Device Twin信息发送到指定的mqtt topic6. 该节点上的所有Mapper都会收到该Device Twin消息,并根据Device名称来匹配是否是自己维护的list中的Device7. Mapper根据Device Profile信息,通过对应的协议与设备建立连接8. Mapper通过mqtt topic上报设备状态和采集的数据Device Twin到EdgeCore9. EdgeCore通过云边websocket通道上报Device Twin数据到CloudCore10. CloudCore更新设备Device Twin数据到Kubernetes二、DMI框架设计 在此基础上,KubeEdge团队也对框架不断更新迭代。为帮助用户应对未来更大规模设备场景、更高的可用性需求、更灵活的功能支持以及更优的用户体验,KubeEdge 设计了更优化的设备管理框架——DMI。DMI整合设备管理接口,优化边缘计算场景下的设备管理能力,打造基于云原生技术的,覆盖设备管理、设备数据的设备数字孪生管理平台;同时定义了EdgeCore与Mapper之间统一的连接入口,并分别由EdgeCore和Mapper实现上行数据流和下行数据流的服务端和客户端,承载DMI具体功能。DMI框架设计中解耦了设备管理面与设备业务面数据,让Device CRD只承载设备本身的生命周期管理,而设备业务面数据则直接通过微服务的方式为数据消费者应用提供出来。在这样的架构下,设备就不再是单纯的数据源,而是一种云原生的设备微服务,设备数据消费应用的开发者就可以不再关心如何获取设备数据,而是以更云原生的方式来聚焦应用本身的业务逻辑开发。DMI框架还提供多种数据推送方式,让数据消费者可以更灵活地获取设备数据,用户体验更优。由于DMI的设备管理面与业务面数据分离的特点,业务面数据可以通过业务面通道更灵活地在云端或边端被处理,而管理面的云边通道中只会传输少量管理面信息,大大降低了云边通道拥塞的可能,提高了KubeEdge系统的可用性。另外,DMI提供了统一的设备管理相关接口,无论是设备应用开发者还是设备应用的使用者,都可以以更统一、更灵活、更标准化的方式来开展设备相关工作,不拘泥于具体形式,只要能够实现DMI接口,就能够享受KubeEdge边缘计算平台带来的云原生设备管理体验。▍2.1 DMI框架定位图 2 DMI 在 KubeEdge 架构中的定位DMI在KubeEdge架构中的定位如图2所示。DMI类似Kubernetes的CNI、CSI、CRI等接口,定义了一组EdgeCore与Mapper之间的内部API接口以及外部应用访问Mapper的统一的API接口。其中内部接口底层由gRPC结合UDS的方式来实现,外部API接口支持mqtt和REST两种接入方式。Mapper不论是何种承载、实现方式,只要实现了DMI中所定义的上行、下行数据接口,即可接入KubeEdge云原生边缘计算平台,使用云原生的方式对设备进行管理。▍2.2 DMI设备管理与数据管理DMI框架架构设计如图3所示,其中黄色线条为设备管理面数据流管理,蓝色部分为业务面数据流管理。在DMI的架构设计中,将设备的管理面数据与业务面数据进行分离。其中管理面数据主要包括设备的元数据、设备属性、配置、状态、生命周期等,其特点是相对比较稳定,创建后除状态上报外的信息更新较少,更贴近Pod类型资源所产生的数据,在保证用户可以通过云端Kubernetes API像访问Pod一样维护Device的生命周期的同时,尽量减少设备管理产生的额外数据传输开销。图 3 DMI设备管理与数据管理架构在DMI框架设计下,设备不再是单纯的数据源,而是被抽象为微服务,以云原生的方式为设备数据消费者提供数据服务。DMI框架下的设备数据访问支持多种场景,更加灵活。图3中列出了几种主要的数据访问方式,包括推数据和拉数据等,具体情况如下:1. 边缘侧应用通过REST Service访问设备数据2. 云侧应用通过REST Service访问设备数据3. Mapper通过配置REST目的地址,将数据推送到边缘侧应用4. Mapper通过配置REST目的地址,将数据推送到云侧应用5. Mapper通过配置目的地址,将数据推送到边缘侧数据库6. Mapper通过配置目的地址,将数据推送到mqtt broker7. 边缘侧应用通过mqtt broker topic订阅设备数据8. 云侧应用通过mqtt broker topic 订阅设备数据9. 边缘侧应用处理数据后将处理结果传上云▍2.3 DMI工作流程图 4 DMI设备管理工作流程示例在DMI框架下,设备管理工作的流程有一定的变化。如图4所示,在安装KubeEdge的时候,云端CloudCore会注册DeviceController组件用于监听Device和DeviceModel的CRD资源。DeviceController中存在两个模块,Downstream Controller和Upstream Controller,其中Downstream Controller用于监听云端的Device、DeviceModel事件,并通过Cloudhub下发至边缘,Upstream Controller用于接收从Cloudhub转发来的EdgeHub上报的Device状态和消息,并更新Kubernetes中的Device状态。在边缘侧,Mapper初始化的时候,需要调用DMI中的Mapper注册接口,将Mapper的相关信息注册至Device Manager,并接收接口返回的已下发至该节点的且协议匹配的设备信息。EdgeHub在接收到云端下发的设备消息时,会将其转发到DeviceManager组件,DeviceManager会根据该设备的协议选择对应的Mapper驱动程序,发送创建设备的请求,并且本地数据库也会存储该设备的信息,后续Mapper会将设备孪生消息转化为设备协议格式,跟实际的物理设备进行通信。三、DMI接口定义▍3.1 DMI 接口分类DMI接口实现了EdgeCore与Mapper之间的通信,支持REST和mqtt的通信方式,并以标准化的形式呈现,降低了Mapper开发、适配难度。在数据访问方面,DMI可以实现边缘侧和云侧的应用都可以通过REST Service的方式访问设备数据。图 5 DMI接口定义如图5所示,DMI有六类接口,Mapper管理是针对边缘侧各类设备协议驱动程序,Device管理和Device数据管理对管理面和业务面进行了数据拆分,Device升级管理和Device命令管理为具有升级和命令执行功能的设备提供相关的接口,Device事件管理可以监控Mapper及其纳管的各个设备的运行状态。▍3.2 DMI 接口定义示例图 6 DMI设备管理部分接口定义示例如图6所示,为DMI设备管理部分接口定义,v1版本以gRPC proto的方式定义,可使用make dmi命令创建对应的gRPC-go代码。 ▍3.3 DMI 设备相关 CRD 定义如图7所示,是DMI设备相关CRD定义,主要分为Device和DeviceModel。其中DeviceModel与设备型号是一一对应的关系,代表同一类设备型号的共有属性,主要包含设备产生数据属性Properties和设备支持命令属性Commands。Device为设备实例,与真实的物理设备为一对一的关系,每个DeviceModel可以对应统一型号的多个Device实例。Device类型资源主要包含设备型号对应关系信息、设备协议配置信息、设备部署节点信息、设备状态信息以及设备数据Property采集配置信息。图 7 DMI 设备相关 CRD 定义 四、发布计划 四、发布计划DMI发布计划分为三个版本,Alpha版本提供设备管理相关功能实现,以及提供一个支持DMI接口的Mapper Demo。Beta版本支持设备命令管理、设备升级管理以及设备数据管理的能力,此外还会对接第三方平台,并提供相关对接Demo。GA版本会对多平台、多协议进行对接支持,另外会把设备安全以及事件管理的功能补全。图 8 DMI发布计划目前 KubeEdge Device IoT SIG 专注于第一阶段的设备管理和 Mapper Demo 的开发工作。欢迎大家通过下方联系方式联系我们,一起参与到方案设计和特性开发的工作当中本文作者:华为云 赵然 ;DaoCloud 道客 王梓龙附:KubeEdge社区贡献和技术交流地址网站: https://kubeedge.ioGithub地址: cid:link_1地址: https://kubeedge.slack.com邮件列表: https://groups.google.com/forum/#!forum/kubeedge每周社区例会: https://zoom.us/j/4167237304Twitter: https://twitter.com/KubeEdge文档地址: https://docs.kubeedge.io/en/latest/
-
使用Kubesphere 安装kubernetes集群【摘要】 设置环境变量 [root@master01 ~]# export KKZONE=cn 下载kubeKey [root@master01 ~]# curl -sfL https://get-kk.kubesphere.io | VERSION=v1.2.1 sh - kk赋权 [root@master01 ~]# chmod ...设置环境变量[root@master01 ~]# export KKZONE=cn下载kubeKey[root@master01 ~]# curl -sfL https://get-kk.kubesphere.io | VERSION=v1.2.1 sh -kk赋权[root@master01 ~]# chmod +x kk生成config[root@master01 ~]# ./kk create config --with-kubernetes v1.21.5安装kubernetes[root@master01 ~]# ./kk create cluster -f config-sample.yaml+----------+------+------+---------+----------+-------+-------+-----------+----------+------------+-------------+------------------+--------------+| name | sudo | curl | openssl | ebtables | socat | ipset | conntrack | docker | nfs client | ceph client | glusterfs client | time |+----------+------+------+---------+----------+-------+-------+-----------+----------+------------+-------------+------------------+文章来源: blog.csdn.net,作者:隔壁老瓦,版权归原作者所有,如需转载,请联系作者。原文链接:blog.csdn.net/wxb880114/article/details/123303525
-
一.存储容器化存储作为基础组件,直接和本地盘打交道,所以我们一个要解决的事情就是如果Kubernetes 管理本地盘。kubernetes管理本地盘通过官方提供的local-static-provisioner自动生成LocalPersistentVolume管理磁盘。LocalPersistentVolume是Kubernetes提供的一种管理本地盘的资源。5.1 使用Statefulset管理存储容器通过statefulset 管理有状态的存储服务, 为每个pod分配一个单独的磁盘可以使用volumeClaimTemplates给每个pod生成唯一的pvc,具体规则{podName},事先准备好PVC 和 PV,通过Statefulset 我们就可以把我们的存储托管到云上了。另外借助daemonset,可以把我们gateway模块部署到每一个node上面。处理云存储的请求。5.2 存储容器化的收益1)降低运维成本基于Kubernetes和statfulset获得了滚动更新,灰度更新,健康检查,快速扩容等功能,只需要一组yaml文件就可以快速搭建一个集群,相比于传统写ansible脚本部署的方式复杂度大大降低。2)降低开发运维成本由于Kubernetes把存储抽象成StorageClass PersistentVolume PersistentVolumeClaim。我们可以通过他们管理我们的存储资源,基于Kubernetes lable的过滤功能,可以实现简单的关系查询,通过PVC与PV管理存储资源,减少管理端的开发。定位问题也能通过POD信息快速定位到问题机器和问题云盘。而且接入Kubernetes生态上的prometheus后,监控告警也能快速开发。3)隔离性增强docker限制cpu memory使用,减少进程之间资源互相干扰,进一步提升资源利用率。在做流媒体容器化过程中,各个系统 Portal 平台、中间件、ops 基础设施、监控等都做了相应的适配改造,改造后的架构矩阵如下图所示。1. Portal:流媒体 的 PaaS 平台入口,提供 CI/CD 能力、资源管理、自助运维、应用画像、应用授权(db 授权、支付授权、应用间授权)等功能。2.运维工具:提供应用的可观测性工具, 包括 watcher(监控和报警)、bistoury (Java 应用在线 Debug)、qtrace(tracing 系统)、loki/elk(提供实时日志/离线日志查看)。中间件:应用用到的所有中间件,mq、配置中心、分布式调度系统 qschedule、dubbo 、mysql sdk 等。3.虚拟化集群:底层的 K8s 和 OpenStack 集群。4.Noah:测试环境管理平台,支持应用 KVM/容器混合部署。一.CI/CD 流程改造主要改造点:应用画像: 把应用相关的运行时配置、白名单配置、发布参数等收敛到一起,为容器发布提供统一的声明式配置。授权系统: 应用所有的授权操作都通过一个入口进行,并实现自动化的授权。K8s 多集群方案: 通过调研对比,KubeSphere 对运维优化、压测评估后也满足我们对性能的要求,最终我们选取了 KubeSphere 作为多集群方案。二.中间件适配改造改造关注点:由于容器化后,IP 经常变化是常态,所以各个公共组件和中间件要适配和接受这种变化。Qmq组件改造点:Broker端加快过期数据的处理速度。原因:由于IP变化频繁,对于一个主题有几百个甚至上千个的IP订阅,会产生很多文件Qconfig/Qschedule组件改造点:按实例级别的推送、任务执行在容器场景下不建议使用 。原因:因为IP经常变化,在容器化场景下发布、pod驱逐等都会导致IP变化,按实例维度推送没有意义Dubbo组件改造点:更改上线下线逻辑,下线记录由永久节点改为临时节点。 原因:上下线机制加上频繁的IP变更会导致zookeeper上产生大量的过期数据Openresty改造点:监听多K8s集群的endpoint变更,并更新到upstream; KVM、容器server地址共存,支持KVM和容器混合部署;三应用平滑迁移方案设计为了帮助业务快速平滑地迁移到容器,制定了一些规范和自动化测试验证等操作来实现这个目标。1.容器化的前置条件: 应用无状态、不存在 post_offline hook(服务下线后执行的脚本)、check_url 中不存在预热操作。2.测试环境验证: 自动升级 SDK、自动迁移。我们会在编译阶段帮助业务自动升级和更改 pom 文件来完成 SDK 的升级,并在测试环境部署和验证,如果升级失败会通知用户并提示。3.线上验证: 第一步线上发布,但不接线上流量,然后通过自动化测试验证,验证通过后接入线上流量。4.线上 KVM 与容器混部署:保险起见,线上的容器和 KVM 会同时在线一段时间,等验证期过后再逐步下线 KVM。5.线上全量发布: 确认服务没问题后,下线 KVM。6.观察: 观察一段时间,如果没有问题则回收 KVM。
-
 【摘要】 Karmada已经实现了多集群场景下的Kubernetes资源(包括CRD)的分发以及管理。但当前多集群应用往往不是单一的资源形式,使用Helm对应用进行打包的使用场景也非常常见。借助Karmada原生API的支持能力,Karmada可以借助Flux轻松实现Helm应用的跨集群部署。本文分享自华为云社区《 使用Karmada实现Helm应用的跨集群部署【云原生开源】》,作者:华为云云原生开源团队。背景通过使用 Kubernetes 原生 API 并提供高级调度功能,Karmada已经实现了多集群场景下的Kubernetes资源(包括CRD)的分发以及管理。但当前多集群应用往往不是单一的资源形式,使用Helm对应用进行打包的使用场景也非常常见。借助Karmada原生API的支持能力,Karmada可以借助Flux轻松实现Helm应用的跨集群部署。部署Karmada要部署Karmada,你可以参考社区的安装文档(https://github.com/karmada-io/karmada/blob/master/docs/installation/installation.md)。如果想快速体验Karmada,我们建议通过hack/local-up-karmada.sh构建一个Karmada的开发环境。部署Flux在Karmada控制面中,你需要安装Flux的CRD,但不需要安装Flux控制器来调和基于CRD创建的CR对象,它们被视为资源模板,而不是特定的资源实例。基于Karmada的work API,它们将被封装为一个work对象下发给成员集群,最终由成员集群中的Flux控制器进行调和。kubectl apply -k github.com/fluxcd/flux2/manifests/crds?ref=main --kubeconfig ~/.kube/karmada.config在成员集群中,你可以基于以下命令安装完整的Flux组件。flux install --kubeconfig ~/.kube/members.config --context member1 flux install --kubeconfig ~/.kube/members.config --context member2你可以参考此处的文档(https://fluxcd.io/docs/installation/)来获得更详细的安装Flux的细节。提示:如果你想在你所有的集群上管理基于HelmRelease的应用,你需要在你的所有成员集群中安装Flux。Helm release分发准备工作就绪,下面将以一个podinfo的简单应用为例演示如何完成Helm chart分发。1.在 Karmada 控制平面中定义一个 Flux 的HelmRepository CR对象和一个 HelmRelease CR对象。它们将视作资源模板。apiVersion: source.toolkit.fluxcd.io/v1beta2 kind: HelmRepository metadata: name: podinfo spec: interval: 1m url: https://stefanprodan.github.io/podinfo---apiVersion: helm.toolkit.fluxcd.io/v2beta1 kind: HelmRelease metadata: name: podinfo spec: interval: 5m chart: spec: chart: podinfo version: 5.0.3 sourceRef: kind: HelmRepository name: podinfo2. 定义一个 Karmada的PropagationPolicy 对象将它们的资源实例下发到成员集群:apiVersion: policy.karmada.io/v1alpha1 kind: PropagationPolicy metadata: name: helm-repo spec: resourceSelectors: - apiVersion: source.toolkit.fluxcd.io/v1beta2 kind: HelmRepository name: podinfo placement: clusterAffinity: clusterNames: - member1 - member2---apiVersion: policy.karmada.io/v1alpha1 kind: PropagationPolicy metadata: name: helm-release spec: resourceSelectors: - apiVersion: helm.toolkit.fluxcd.io/v2beta1 kind: HelmRelease name: podinfo placement: clusterAffinity: clusterNames: - member1 - member2上述配置将会把Flux的资源对象下发到成员集群member1和member2中。3. 将上述对象提交给Karmada-apiserver:kubectl apply -f ../helm/ --kubeconfig ~/.kube/karmada.config你将会得到以下的输出结果:helmrelease.helm.toolkit.fluxcd.io/podinfo created helmrepository.source.toolkit.fluxcd.io/podinfo created propagationpolicy.policy.karmada.io/helm-release created propagationpolicy.policy.karmada.io/helm-repo created4. 切换至成员集群验证应用是否成功下发helm --kubeconfig ~/.kube/members.config --kube-context member1 list你将会得到以下的输出结果:基于 Karmada 的 PropagationPolicy,你可以灵活地将 Helm应用发布到你期望的集群。为特定集群定制 Helm 应用上述的示例显示了如何将同一个Helm应用分发到 Karmada 中的多个集群。此外,你还可以使用 Karmada 的 OverridePolicy 为特定集群定制Helm应用。例如,上述应用包括了一个Pod副本,如果你只想更改 member1集群中的应用所包含的Pod副本数,你可以参考以下的 OverridePolicy策略。1.定义一个Karmada的OverridePolicy对象。apiVersion: policy.karmada.io/v1alpha1 kind: OverridePolicy metadata: name: example-override namespace: default spec: resourceSelectors: - apiVersion: helm.toolkit.fluxcd.io/v2beta1 kind: HelmRelease name: podinfo overrideRules: - targetCluster: clusterNames: - member1 overriders: plaintext: - path: "/spec/values" operator: add value: replicaCount: 22. 将上述对象提交给Karmada-apiserver:kubectl apply -f example-override.yaml --kubeconfig ~/.kube/karmada.config你将会得到以下的输出结果:overridepolicy.policy.karmada.io/example-override created3. 在 Karmada 控制平面中应用上述策略后,你会发现 member1成员集群中的Pod实例数已变更为 2,但 member2 集群中的那些保持不变。kubectl --kubeconfig ~/.kube/members.config --context member1 get po你将会得到以下的输出结果:NAME READY STATUS RESTARTS AGE podinfo-68979685bc-6wz6s 1/1 Running 0 6m28s podinfo-68979685bc-dz9f6 1/1 Running 0 7m42s参考文档:https://github.com/karmada-io/karmada/blob/master/docs/working-with-flux.md附:Karmada社区技术交流地址添加Karmada社区助手微信k8s2222进入社区交流群,和Maintainer零距离。项目地址https://github.com/karmada-io/karmadaSlack地址:https://slack.cncf.io/
-
 本文来自微信公共号:分布式实验室。文章观点独特,比喻形象,分享给大家~本文论述了 Kubernetes 的核心价值是其通用、跨厂商和平台、可灵活扩展的声明式 API 框架, 而不是容器(虽然容器是它成功的基础);然后手动创建一个 API Extension(CRD), 通过测试和类比来对这一论述有一个更直观的理解。例子及测试基于 Kubernetes v1.21.0。— 1 —Kubernetes 的核心是其 API 框架而非容器 容器是基础时间回到 2013 年。当一条简单的 docker run postgre 命令就能运行起 Postgre 这样复杂的传统服务时,开发者在震惊之余犹如受到天启;以 Docker 为代表的实用容器技术的横空出世,也预示着一扇通往敏捷基础设施的大门即将打开。此后,一切都在往好的方向迅速发展:越来越多的开发者开始采用容器作为一种标准构建和运行方式。业界也意识到,很容易将这种封装方式引入计算集群,通过 Kubernetes 或 Mesos 这样的编排器来调度计算任务 —— 自此,容器便成为这些调度器最重要的 Workload 类型。但本文将要说明,容器并非 Kubernetes 最重要、最有价值的地方,Kubernetes 也并非仅仅是一个更广泛意义上的 Workload 调度器 —— 高效地调度不同类型的 Workload 只是 Kubernetes 提供的一种重要价值,但并不是它成功的原因。API 才是核心“等等 —— Kubernetes 只是一堆 API?”“不好意思,一直都是!”Kubernetes 的成功和价值在于,提供了一种标准的编程接口(API),可以用来编写和使用软件定义的基础设施服务(本文所说的“基础设施”,范围要大于 IaaS):Specification + Implementation 构成一个完整的 API 框架 —— 用于设计、实现和使用各种类型和规模的基础设施服务;这些 API 都基于相同的核心结构和语义:typed resources watched and reconciled by controllers (资源按类型划分,控制器**相应类型的资源,并将其实际 status 校准到 spec 里期望的状态)。为了进一步解释这一点,考虑下 Kubernetes 出现之前的场景。Kubernetes 之前:各自造轮子,封装厂商 API 差异Kubernetes 之前,基础设施基本上是各种不同 API、格式和语义的“云”服务组成的大杂烩:云厂商只提供了计算实例、块存储、虚拟网络和对象存储等基础构建模块,开发者需要像拼图一样将它们拼出一个相对完整的基础设施方案;对于其他云厂商,重复过程 1,因为各家的 API、结构和语义并不相同,甚至差异很大。虽然 Terraform 等工具的出现,提供了一种跨厂商的通用格式,但原始的结构和语义仍然是五花八门的,—— 针对 AWS 编写的 Terraform descriptor 是无法用到 Azure 的。Kubernetes 面世:标准化、跨厂商的 API、结构和语义现在再来看 Kubernetes 从一开始就提供的东西:描述各种资源需求的标准 API。例如:描述 Pod、Container 等计算需求的 API;描述 Service、Ingress 等虚拟网络功能的 API;描述 Volumes 之类的持久存储的 API;甚至还包括 Service Account 之类的服务身份的 API 等等。这些 API 是跨公有云/私有云和各家云厂商的,各云厂商会将 Kubernetes 结构和语义对接到它们各自的原生 API。因此我们可以说,Kubernetes 提供了一种管理软件定义基础设施(也就是云)的标准接口。或者说,Kubernetes 是一个针对云服务(Cloud Services)的标准 API 框架。Kubernetes API 扩展:CRD提供一套跨厂商的标准结构和语义来声明核心基础设施(Pod/Service/Volume/ServiceAccount/……), 是 Kubernetes 成功的基础。在此基础上,它又通过 CRD(Custom Resource Definition), 将这个结构扩展到任何/所有基础设施资源。CRD 在 1.7 引入,允许云厂商和开发者自己的服务复用 Kubernetes 的 spec/impl 编程框架。有了 CRD,用户不仅能声明 Kubernetes API 预定义的计算、存储、网络服务,还能声明数据库、task runner、消息总线、数字证书……任何云厂商能想到的东西!Operator Framework 以及 SIG API Machinery 等项目的出现,提供了方便地创建和管理这些 CRD 的工具,最小化用户工作量,最大程度实现标准化。例如,Crossplane 之类的项目,将厂商资源 RDS 数据库、SQS queue 资源映射到 Kubernetes API,就像核心 Kubernetes controller 一样用自己的 controller 来管理网卡、磁盘等自定义资源。Google、RedHat 等 Kubernetes 发行商也在它们的基础 Kubernetes 发行版中包含越来越多的自定义资源类型。小结我们说 Kubernetes 的核心是其 API 框架,但并不是说这套 API 框架就是完美的。事实上,后一点并不(非常)重要,因为 Kubernetes 模型已经成为一个事实标准:开发者理解它、大量工具主动与它对接、主流厂商也都已经原生支持它。用户认可度、互操作性 经常比其他方面更能决定一个产品能否成功。随着 Kubernetes 资源模型越来越广泛的传播,现在已经能够 用一组 Kubernetes 资源来描述一整个软件定义计算环境。就像用 docker run 可以启动单个程序一样,用 kubectl apply -f 就能部署和运行一个分布式应用, 而无需关心是在私有云还是公有云以及具体哪家云厂商上,Kubernetes 的 API 框架已经屏蔽了这些细节。因此,Kubernetes 并不是关于容器的,而是关于 API。— 2 —Kubernetes 的 API 类型 可以通过 GET/LIST/PUT/POST/DELETE 等 API 操作,来创建、查询、修改或删除集群中的资源。各 controller **到资源变化时,就会执行相应的 reconcile 逻辑,来使 status 与 spec 描述相符。标准 API(针对内置资源类型)Namespaced 类型,这种类型的资源是区分 namespace,也就是可以用 namespace 来隔离。大部分内置资源都是这种类型,包括:podsservicesnetworkpoliciesAPI 格式:格式:/api/{version}/namespaces/{namespace}/{resource}举例:/api/v1/namespaces/default/podsUn-namespaced 类型,这种类型的资源是全局的,不能用 namespace 隔离,例如:nodesclusterroles(clusterxxx 一般都是,表示它是 cluster-scoped 的资源)API 格式:格式:/api/{version}/{resource}举例:/api/v1/nodes扩展 API(apiextension)1、Namespaced 类型API 格式:格式:/apis/{apiGroup}/{apiVersion}/namespaces/{namespace}/{resource}举例:/apis/cilium.io/v2/namespaces/kube-system/ciliumnetworkpolicies2、Un-namespaced 类型CRD用户发现了 Kubernetes 的强大之后,希望将越来越多的东西(数据)放到 Kubernetes 里面, 像内置的 Pod、Service、NetworkPolicy 一样来管理,因此出现了两个东西:CRD:用来声明用户的自定义资源,例如它是 namespace-scope 还是 cluster-scope 的资源、有哪些字段等等,Kubernetes 会自动根据这个定义生成相应的 API;官方文档的例子[1], 后文也将给出一个更简单和具体的例子。CRD 是资源类型定义,具体的资源叫 CR。Operator 框架:“Operator” 在这里的字面意思是“承担运维任务的程序”, 它们的基本逻辑都是一样的:时刻盯着资源状态,一有变化马上作出反应(也就是 reconcile 逻辑)。这就是扩展 API 的(最主要)声明和使用方式。至此,我们讨论的都是一些比较抽象的东西,接下来通过一些例子和类比来更直观地理解一下。— 3 —直观类比:Kubernetes 是个数据库,CRD 是一张表,API 是 SQL 在本节中,我们将创建一个名为 fruit 的 CRD,它有 name/sweet/weight 三个字段, 完整 CRD 如下:apiVersion: apiextensions.k8s.io/v1kind: CustomResourceDefinitionmetadata: name: fruits.example.org # CRD 名字spec: conversion: strategy: None group: example.org # REST API: /apis/<group>/<version> names: kind: Fruit listKind: FruitList plural: fruits singular: fruit scope: Namespaced # Fruit 资源是区分 namespace 的 versions: - name: v1 # REST API: /apis/<group>/<version> schema: openAPIV3Schema: properties: spec: properties: comment: # 字段 1,表示备注 type: string sweet: # 字段 2,表示甜否 type: boolean weight: # 字段 3,表示重量 type: integer type: object type: object served: true # 启用这个版本的 API(v1) storage: true additionalPrinterColumns: # 可选项,配置了这些 printer columns 之后, - jsonPath: .spec.sweet # 命令行 k get <crd> <cr> 时,能够打印出下面这些字段, name: sweet # 否则,k8s 默认只打印 CRD 的 NAME 和 AGE type: boolean - jsonPath: .spec.weight name: weight type: integer - jsonPath: .spec.comment name: comment type: string后面会解释每个 section 都是什么意思。在此之前,先来做几个(直观而粗糙的)类比。Kubernetes 是个数据库像其他数据库技术一样,它有自己的持久存储引擎(etcd),以及构建在存储引擎之上的 一套 API 和语义。这些语义允许用户创建、读取、更新和删除(CURD)数据库中的数据。下面是一些概念对应关系:关系型数据库Kubernetes(as a database)说明DATABASEcluster一套 Kubernetes 集群就是一个 database 【注 1】TABLEKind每种资源类型对应一个表;分为内置类型和扩展类型 【注 2】COLUMNproperty表里面的列,可以是 string、boolean 等类型rowsresources表中的一个具体 record表中的一个具体 record【注 1】 如果只考虑 namespaced 资源的话,也可以说一个 namespace 对应一个 database。【注 2】 前面已经介绍过,内置 Kind:Job、Service、Deployment、Event、NetworkPolicy、Secret、ConfigMap 等等;扩展 Kind:各种 CRD,例如 CiliumNetworkPolicy。所以,和其他数据库一样,本质上 Kubernetes 所做的不过是以 schema 规定的格式来处理 records。另外,Kubernetes 的表都有自带文档:$ k explain fruitsKIND: FruitVERSION: example.org/v1DESCRIPTION: <empty>FIELDS: apiVersion <string> APIVersion defines the versioned schema of this representation of an object. Servers should convert recognized schemas to the latest internal value, and may reject unrecognized values. More info: https://git.k8s.io/community/contributors/devel/sig-architecture/api-conventions.md#resources kind <string> Kind is a string value representing the REST resource this object represents. Servers may infer this from the endpoint the client submits requests to. Cannot be updated. In CamelCase. More info: https://git.k8s.io/community/contributors/devel/sig-architecture/api-conventions.md#types-kinds metadata <Object> Standard object's metadata. More info: https://git.k8s.io/community/contributors/devel/sig-architecture/api-conventions.md#metadata spec <Object>另外,Kubernetes API 还有两大特色:极其可扩展:声明 CRD 就会自动创建 API;支持事件驱动。CRD 是一张表CRD 和内置的 Pod、Service、NetworkPolicy 一样,不过是数据库的一张表。例如,前面给出的 fruit CRD,有 name/sweet/weight 列,以及 “apple”、“banana” 等 entry。用户发现了 Kubernetes 的强大,希望将越来越多的东西(数据)放到 Kubernetes 里面来管理。数据类 型显然多种多样的,不可能全部内置到 Kubernetes 里。因此,一种方式就是允许用户创建自己的 “表”,设置自己的“列” —— 这正是 CRD 的由来。1、定义表结构(CRD spec)CRD(及 CR)描述格式可以是 YAML 或 JSON。CRD 的内容可以简单分为三部分:常规 Kubernetes metadata:每种 Kubernetes 资源都需要声明的字段,包括 apiVersion、kind、metadata.name 等。 apiVersion: apiextensions.k8s.io/v1 kind: CustomResourceDefinition metadata: name: fruits.example.org # CRD 名字Table-level 信息:例如表的名字,最好用小写,方便以后命令行操作; spec: conversion: strategy: None group: example.org # REST API: /apis/<group>/<version> names: kind: Fruit listKind: FruitList plural: fruits singular: fruit scope: Namespaced # Fruit 资源是区分 namespace 的Column-level 信息:列名及类型等等,遵循 OpenAPISpecification v3 规范。 versions: - name: v1 # REST API: /apis/<group>/<version> schema: openAPIV3Schema: properties: spec: properties: comment: # 字段 1,表示备注 type: string sweet: # 字段 2,表示甜否 type: boolean weight: # 字段 3,表示重量 type: integer type: object type: object served: true # 启用这个版本的 API(v1) storage: true additionalPrinterColumns: # 可选项,配置了这些 printer columns 之后, - jsonPath: .spec.sweet # 命令行 k get <crd> <cr> 时,能够打印出下面这些字段, name: sweet # 否则,k8s 默认只打印 CRD 的 NAME 和 AGE type: boolean - jsonPath: .spec.weight name: weight type: integer - jsonPath: .spec.comment name: comment type: string2、测试:CR 增删查改 vs. 数据库 SQL创建 CRD:这一步相当于 CREATE TABLE fruits ...;。 $ kubectl create -f fruits-crd.yaml customresourcedefinition.apiextensions.k8s.io/fruits.example.org created创建 CR:相当于 INSERT INTO fruits values(...);。apple-cr.yaml: apiVersion: example.org/v1 kind: Fruit metadata: name: apple spec: sweet: false weight: 100 comment: little bit rottenbanana-cr.yaml: apiVersion: example.org/v1 kind: Fruit metadata: name: banana spec: sweet: true weight: 80 comment: just bought创建: $ kubectl create -f apple-cr.yaml fruit.example.org/apple created $ kubectl create -f banana-cr.yaml fruit.example.org/banana created查询 CR:相当于 SELECT * FROM fruits ... ; 或 SELECT * FROM fruits WHERE name='apple';。 $ k get fruits.example.org # or kubectl get fruits NAME SWEET WEIGHT COMMENT apple false 100 little bit rotten banana true 80 just bought $ kubectl get fruits apple NAME SWEET WEIGHT COMMENT apple false 100 little bit rotten删除 CR:相当于 DELETE FROM fruits WHERE name='apple';。 $ kubectl delete fruit apple可以看到,CRD/CR 的操作都能对应到常规的数据库操作。API 是 SQL上一节我们是通过 kubectl 命令行来执行 CR 的增删查改,它其实只是一个外壳,内部 调用的是 Kubernetes 为这个 CRD 自动生成的 API —— 所以又回到了本文第一节论述的内容:Kubernetes 的核心是其 API 框架。只要在执行 kubectl 命令时指定一个足够大的 loglevel,就能看到背后的具体 API 请求。例如:$ kubectl create -v 10 -f apple-cr.yaml ... Request Body: {"apiVersion":"example.org/v1","kind":"Fruit",\"spec\":{\"comment\":\"little bit rotten\",\"sweet\":false,\"weight\":100}}\n"},"name":"apple","namespace":"default"},"spec":{"comment":"little bit rotten","sweet":false,"weight":100}} curl -k -v -XPOST 'https://127.0.0.1:6443/apis/example.org/v1/namespaces/default/fruits?fieldManager=kubectl-client-side-apply' POST https://127.0.0.1:6443/apis/example.org/v1/namespaces/default/fruits?fieldManager=kubectl-client-side-apply 201 Created in 25 milliseconds ...— 4 —其他 给 CR 打标签(label),根据 label 过滤和内置资源类型一样,Kubernetes 支持对 CR 打标签,然后根据标签做过滤:# 查看所有 frutis$ k get fruitsNAME SWEET WEIGHT COMMENTapple false 100 little bit rottenbanana true 80 just bought# 给 banana 打上一个特殊新标签$ k label fruits banana tastes-good=truefruit.example.org/banana labeled# 按标签筛选 CR$ k get fruits -l tastes-good=trueNAME SWEET WEIGHT COMMENTbanana true 80 just bought# 删除 label$ k label fruits banana tastes-good-fruit.example.org/banana labeledKubernetes API 与鉴权控制(RBAC)不管是内置 API,还是扩展 API,都能用 Kubernetes 强大的 RBAC 来做鉴权控制。关于如何使用 RBAC 网上已经有大量文档;但如果想了解其设计,可参考 Cracking Kubernetes RBAC Authorization Model[2], 它展示了如何从零开始设计出一个 RBAC 鉴权模型(假设 Kubernetes 里还没有)。相关链接:https://kubernetes.io/docs/tasks/extend-kubernetes/custom-resources/custom-resource-definitions/#create-a-customresourcedefinitionhttps://arthurchiao.art/blog/cracking-k8s-authz-rbac/参考链接:https://blog.joshgav.com/2021/12/16/kubernetes-isnt-about-containers.htmlhttps://github.com/gotopple/k8s-for-users-intro/blob/master/database.mdhttps://itnext.io/crd-is-just-a-table-in-kubernetes-13e15367bbe4原文阅读:https://mp.weixin.qq.com/s/MEhDJYg_lmjbPEdFFLdedg
-
本文分享自华为云社区《[解构HE2E中的Kubernetes技术应用](https://bbs.huaweicloud.com/blogs/352564?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=paas&utm_content=content)》,作者: 敏捷小智 。 在《[解构HE2E中的容器技术应用](https://bbs.huaweicloud.com/blogs/345979)》 一文当中,为大家分析了HE2E项目的代码仓库、编译构建、部署等各环节中对于容器技术的应用。今天,我们将从Kubernetes技术应用的角度解构[华为云 DevCloud HE2E DevOps实践](https://support.huaweicloud.com/bestpractice-devcloud/devcloud_practice_2000.html) 。 # 什么是Kubernetes? Kubernetes (也称K8S)是用于自动部署,扩展和管理容器化应用程序的开源系统。 # K8S与CCE 在上一篇文章中,大家已经了解了HE2E项目中通过Docker实现容器化部署,在该实践中通过此方式部署至ECS弹性云服务器中,并称之为ECS部署。在该实践中,提供了另外一套部署方式,将应用部署至CCE集群当中,即CCE部署,使用的工具即K8S。 总之,根据部署目标的不同,HE2E实践中分别介绍了ECS部署与CCE部署。根据部署采用的技术工具不同,也可以将这两种方式称为Docker部署与K8S部署。 # 为什么选择K8S 在正式的生产环境中,企业和团队往往会需要将应用部署至多个服务器主机,而CCE集群和K8S则共同为应用的部署、运行及管理提供了保障。相较而言,HE2E实践中介绍的ECS部署方式更倾向于开发、测试等环境下的单机部署。 # K8S的代码配置 回到项目本身,代码仓库中的./kompose/文件夹下有多个yaml文件。可以看出,每个服务都有两个配置文件(*-deployment.yaml与*-service.yaml)共同进行配置。 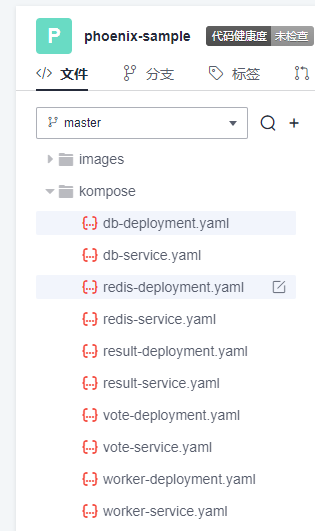 此处以db-deployment.yaml为例,对yaml配置仅作简短的介绍,帮助大家理解配置内容。随着集群版本和产品能力的更迭,也有很多配置信息将发生变化。所以在实践当中,需要调整 yaml 文件配置 。 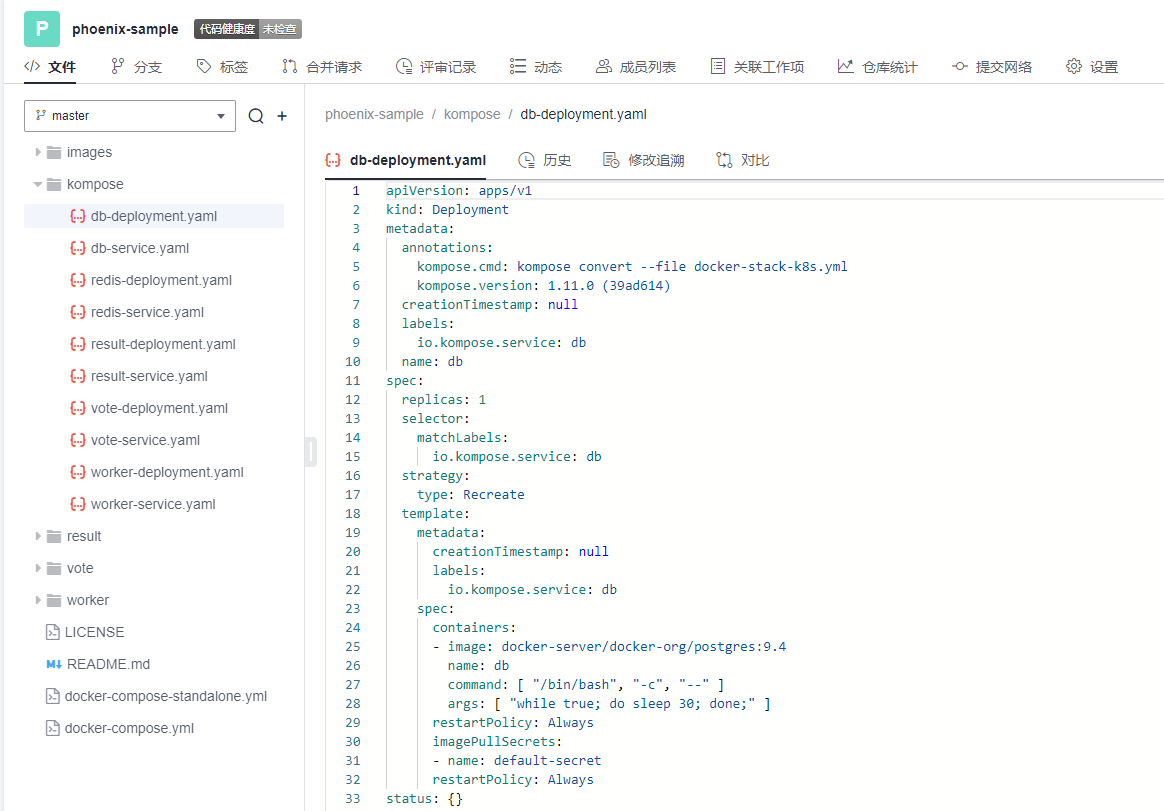 • apiVersion:此处值为apps/v1,这个版本号需要根据安装的K8S版本和资源类型进行变化。目前实践中对应v1.19版本的K8S集群。 • kind:此处创建的是Deployment,根据实际情况,此处资源类型可以是Pod、Job、Ingress、Service等。如:在*-service.yaml文件中,创建的资源类型则是Service。 • metadata:包含Deployment的一些meta信息。其中,annotations的含义是注解。 • spec:你所期望的该对象的状态。包括replicas、selector、containers等Kubernetes需要的参数。其中,containers定义了该deployment使用的镜像:docker-server/docker-org/postgres:9.4。在上篇文章中提到过,这里的docker-server、docker-org都会在构建任务中替换为实际镜像对应的镜像地址和组织。strategy、restartPolicy等字段共同构成了容器失败时重启的策略。 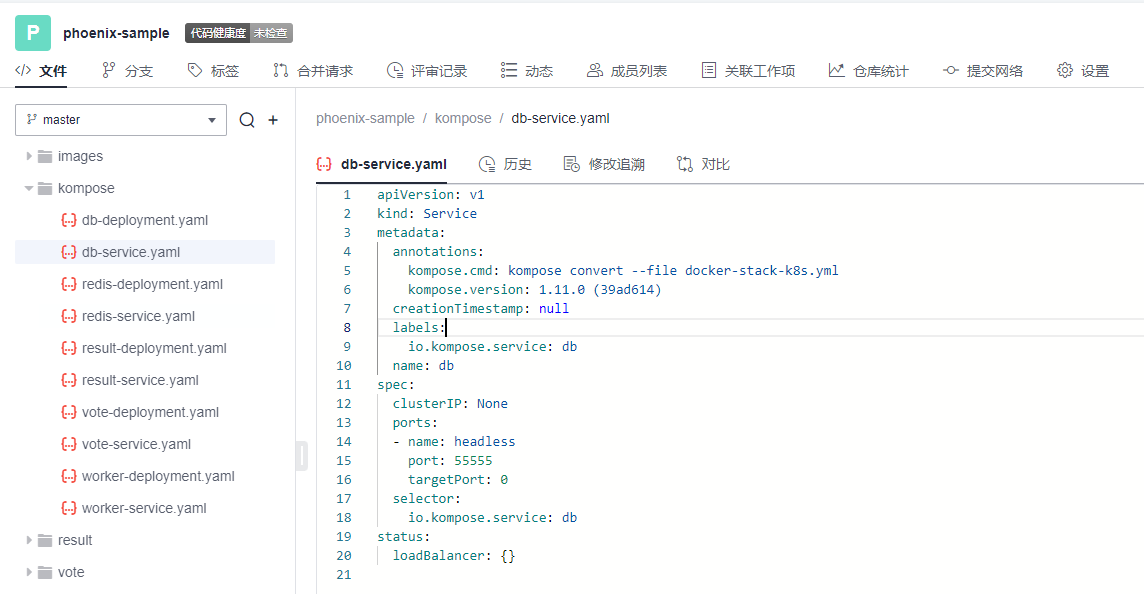 在*-service.yaml当中,主体内容与*-deployment.yaml相差也不算大,主要差异集中于spec这部分。*-service.yaml对应的spec主要是定义了集群内访问的方式,使各个服务之间可以互相访问。 可以看出,*-deployment.yaml 与*-service.yaml共同定义了一个服务*。*-deployment.yaml主要定义了该服务的镜像源,或者说工作负载是什么。而*-service.yaml则定义了该服务访问方式。 # K8S的部署配置 在编译构建环节,主体还是制作镜像上传到SWR镜像仓库,与上篇文章的没有区别。相关的配置文件也通过构建任务上传到软件发布库了,所以这里就不赘述了。 镜像、配置和集群资源都准备妥当以后,就是使用K8S部署的环节了。 # - 代理机配置 我们在HE2E实践中采用的是代理机的部署方式,将集群中的一个节点作为代理机进行授信、部署。所以在实践中我们从集群下载Kubectl配置文件并配置到节点主机当中(见《配置 Kubectl 》)。通过配置Kubectl的操作,我们就可以在节点主机上执行命令进而影响整个CCE集群。 # - CCE部署任务 HE2E实践中,phoenix-cd-cce是我们所需执行的部署任务。该任务将配置文件传输到目标主机,即代理机、集群节点。 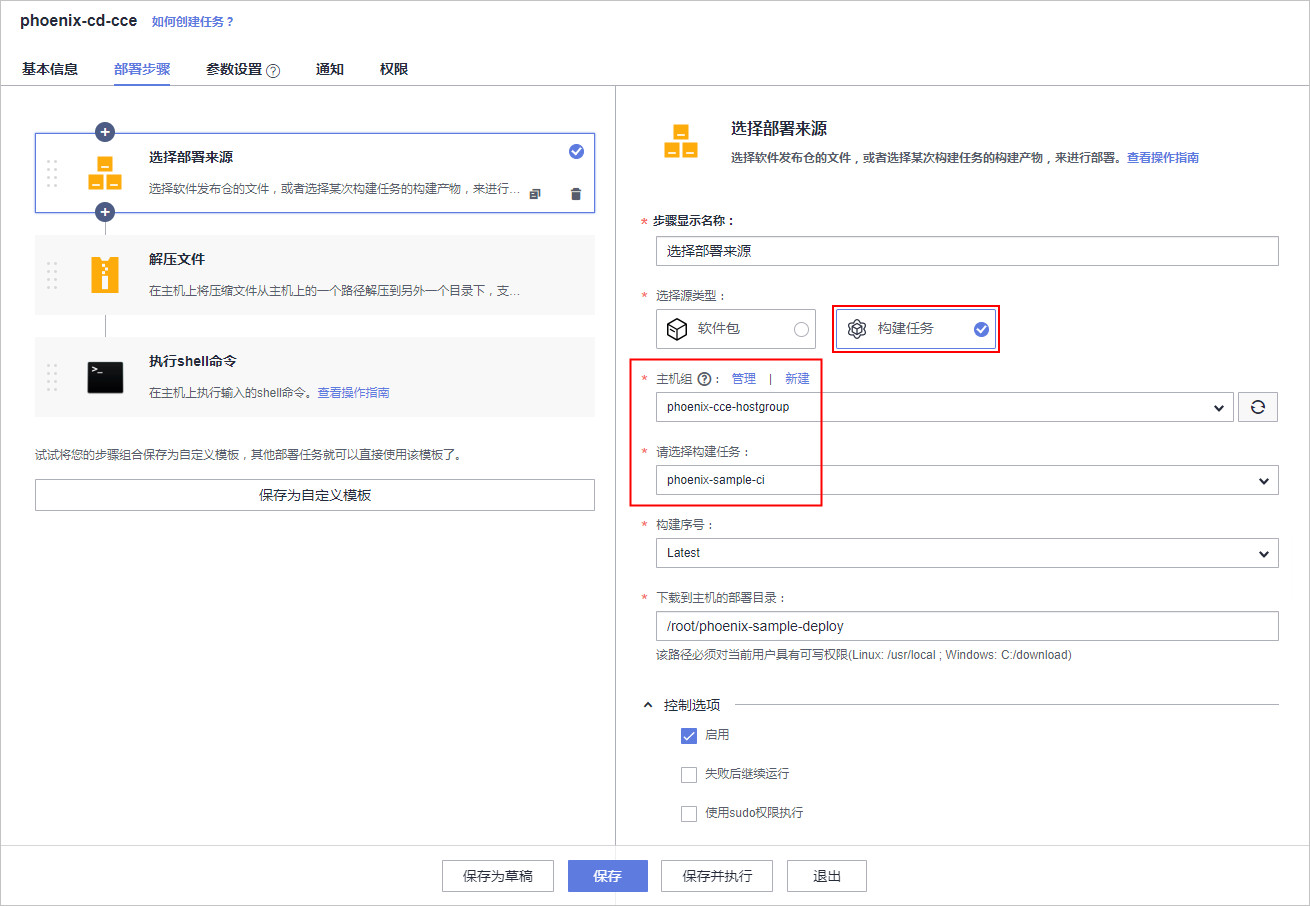 而后,通过执行shell命令启动Kubenetes。 kubectl delete secret regcred kubectl create secret docker-registry regcred --docker-server=${docker-server} --docker-username=${docker-username} --docker-password=${docker-password} --docker-email=***@***.cn kubectl delete -f /root/phoenix-sample-deploy/kompose/ kubectl apply -f /root/phoenix-sample-deploy/kompose/ • 这里先是删除原有的secret,这一步主要是为了防止由于使用临时登录命令变化而导致secret错误引发的任务执行失败。 • 接着,创建新的secret。包含docker-server、docker-username、docker-password等信息。 • 按配置文件(/root/phoenix-sample-deploy/kompose/)删除资源。 • 按配置文件(/root/phoenix-sample-deploy/kompose/)对资源进行配置。 成功执行该部署任务后,可以在CCE集群中看到五个工作负载已经处于“运行中”的状态。 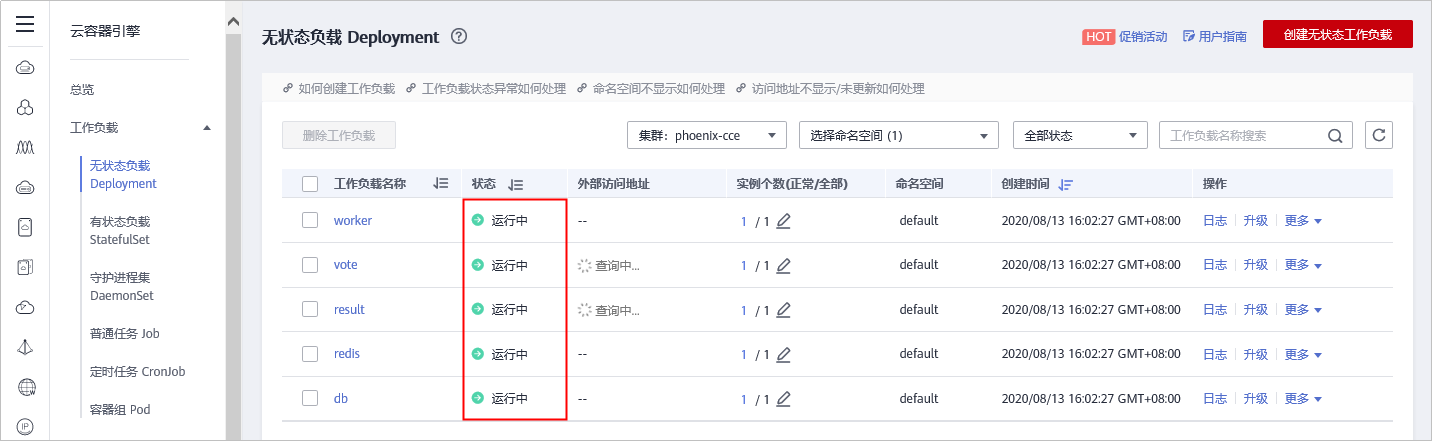 不过目前还需要设置“节点访问”才能正常访问。所以在后续实践中对工作负载vote和result手动添加访问方式。 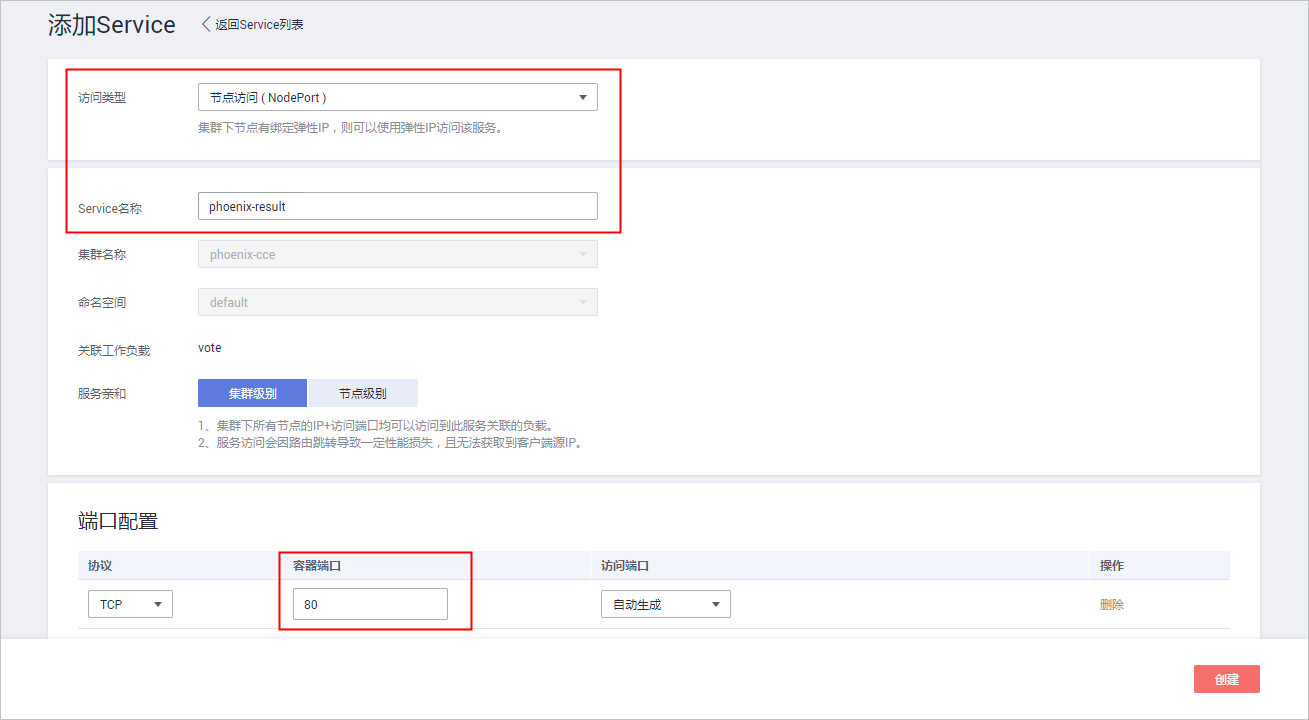 节点访问设置完毕后,即可访问项目的用户端与管理端了。 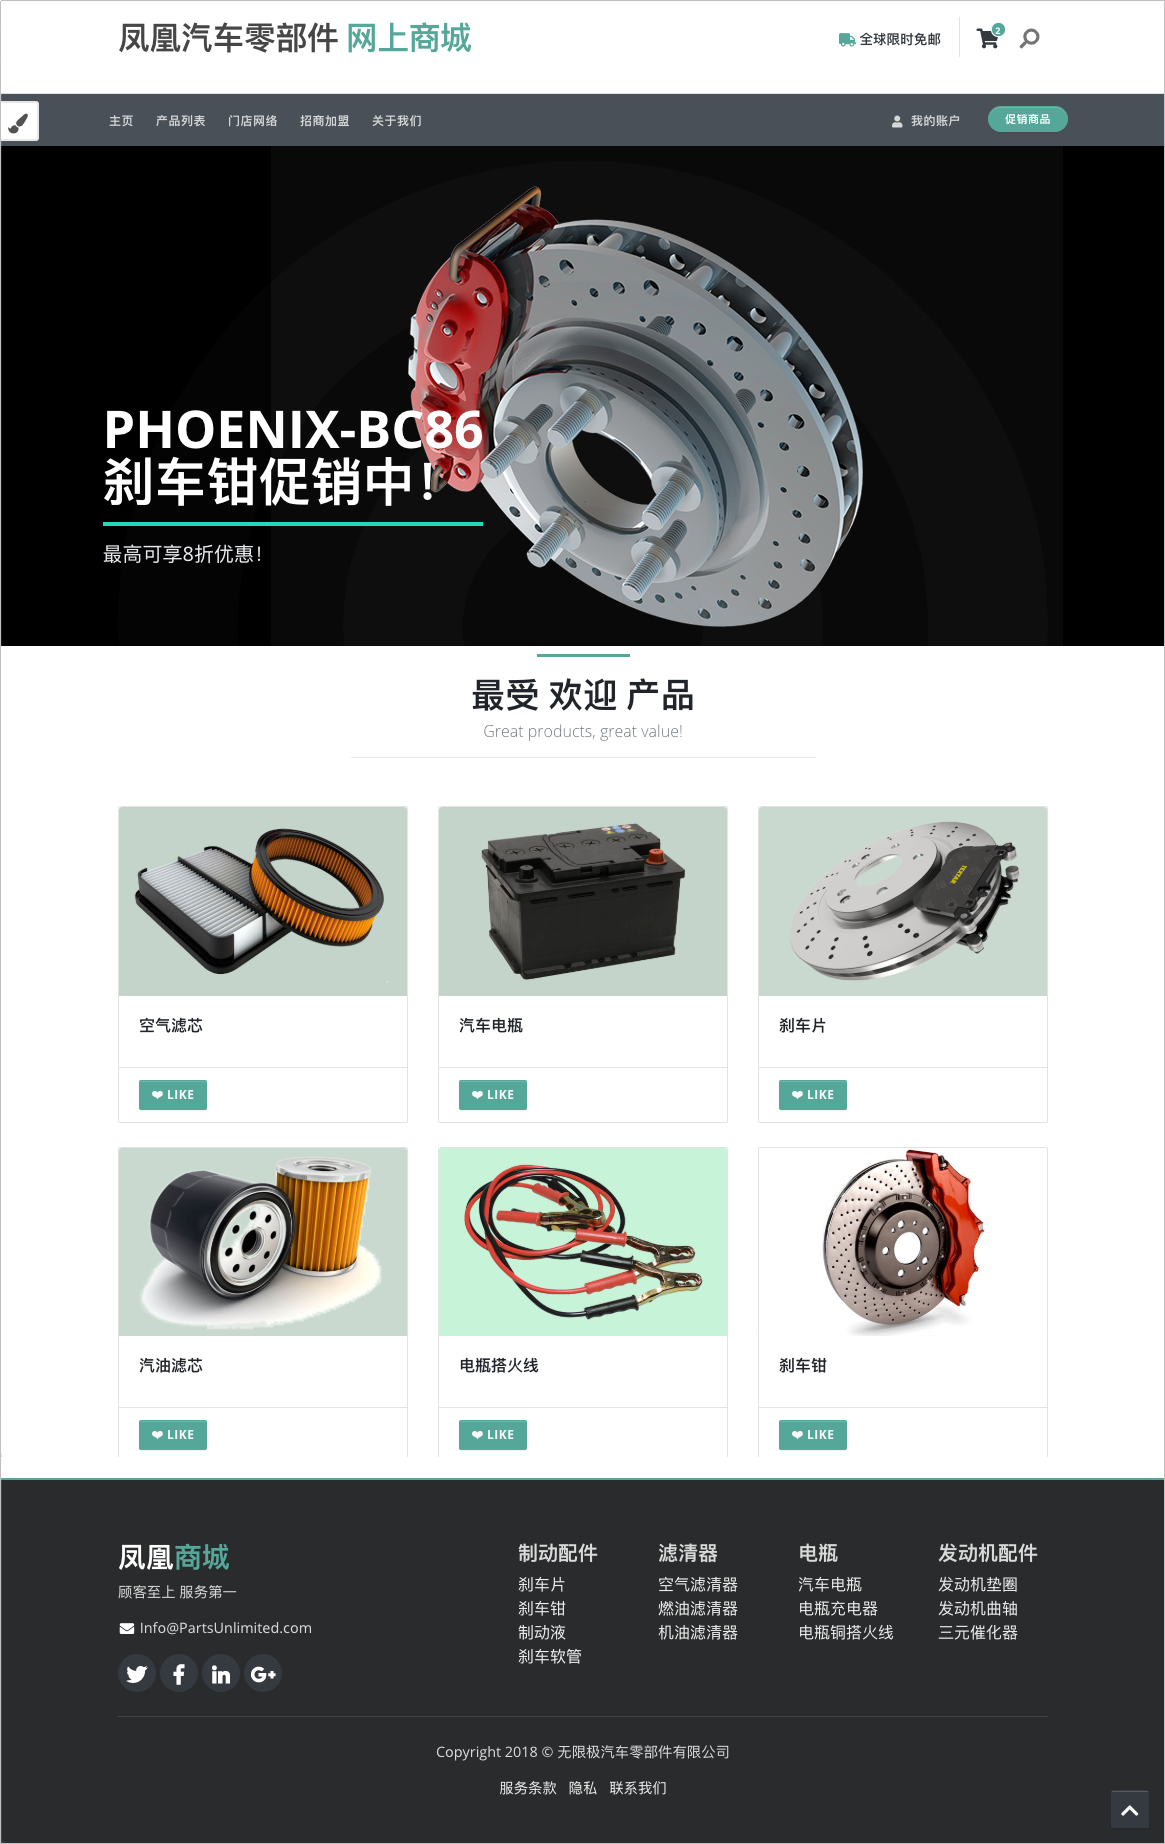 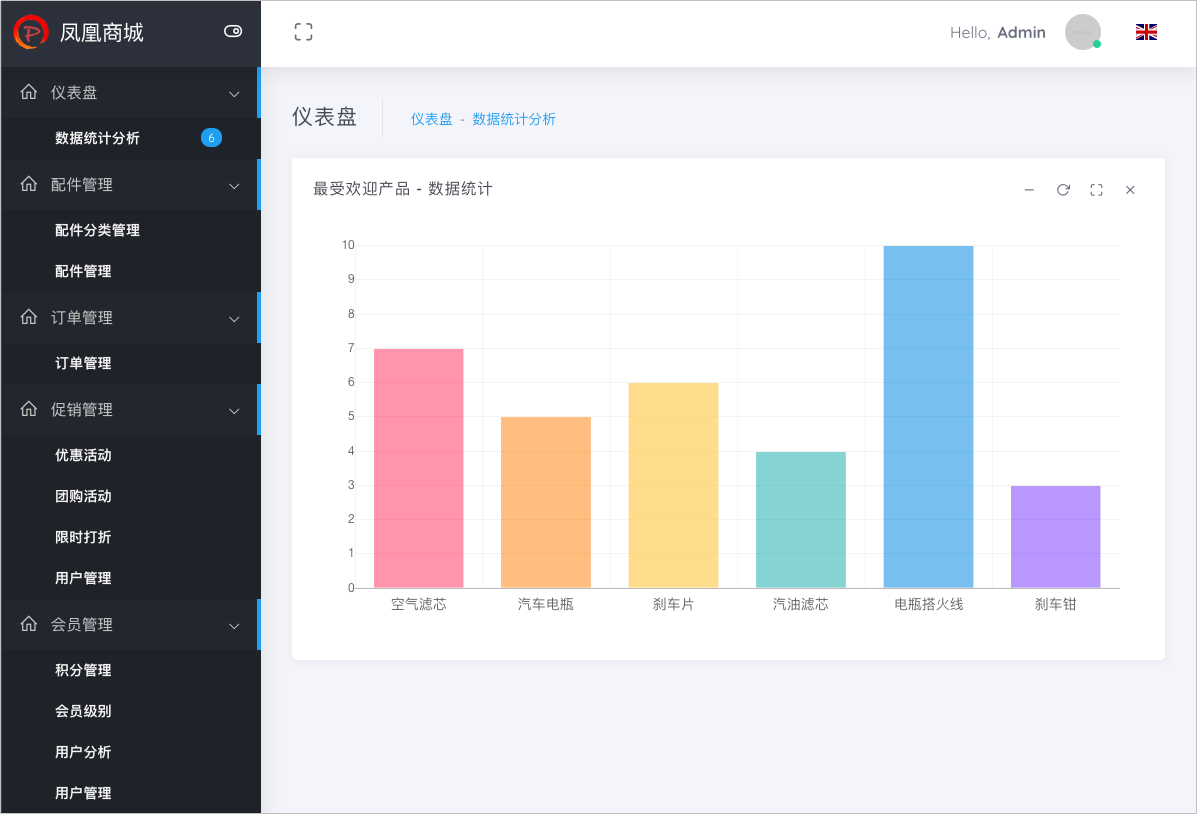 # K8S的模板部署方式 理论上,讲到现在,HE2E实践中的K8S部署就已经讲完了。但是,笔者猜到,肯定有很多人不喜欢这种通过代理机部署集群的方式。不过没关系,下面我就来介绍DevCloud当中的Kubernetes模板部署。 新建模板时,现在可以选择模板:Kubernetes部署。 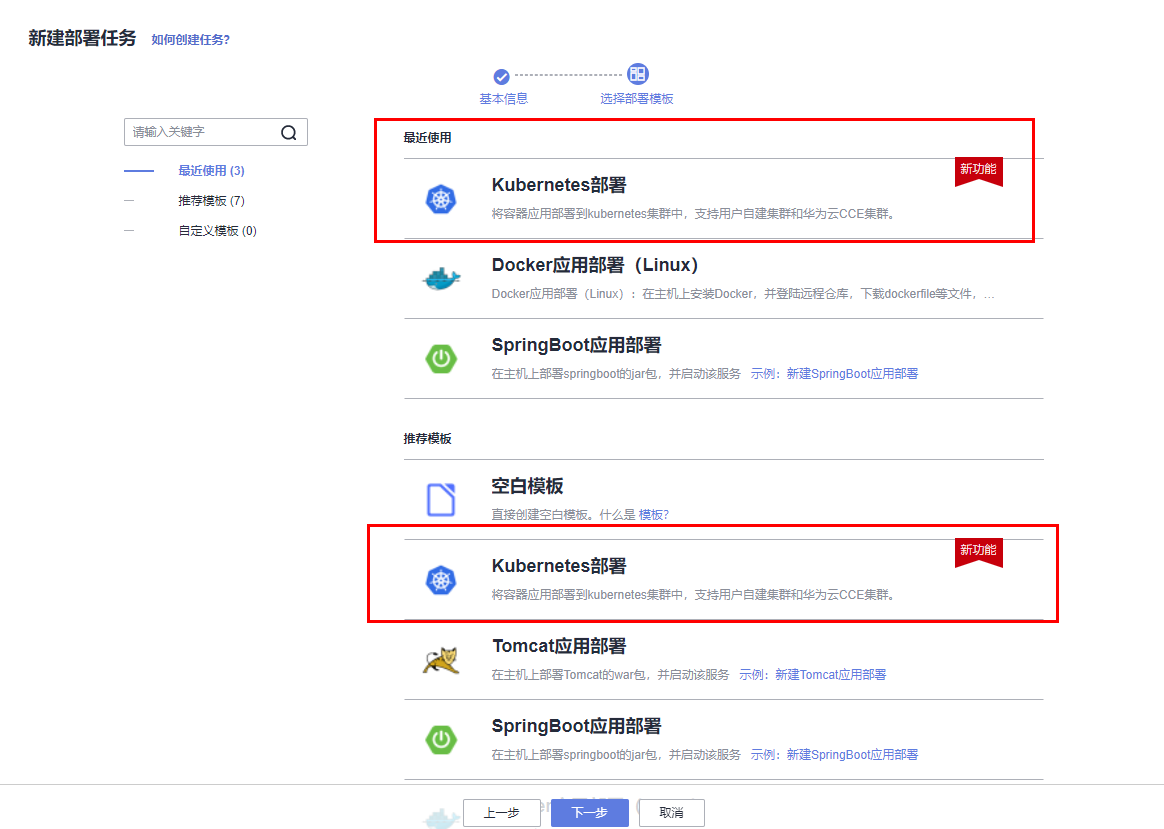 进入模板以后,可以选择集群类型、区域、命名空间、部署方式等信息。 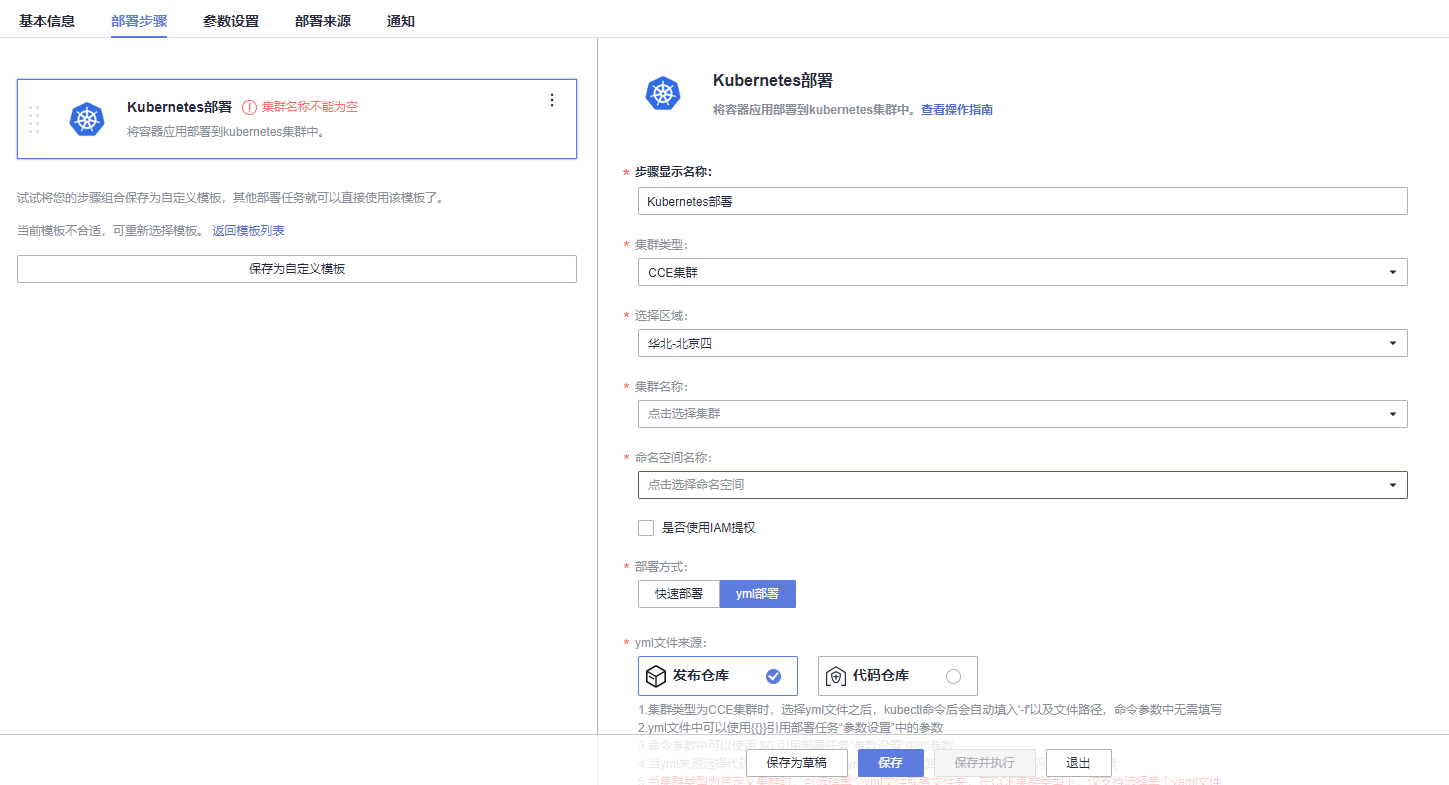 由于本项目通过10个yaml文件共同配置,所以需要添加相同的“Kubernetes部署”步骤共计10个,每个步骤都对应一个yaml文件。 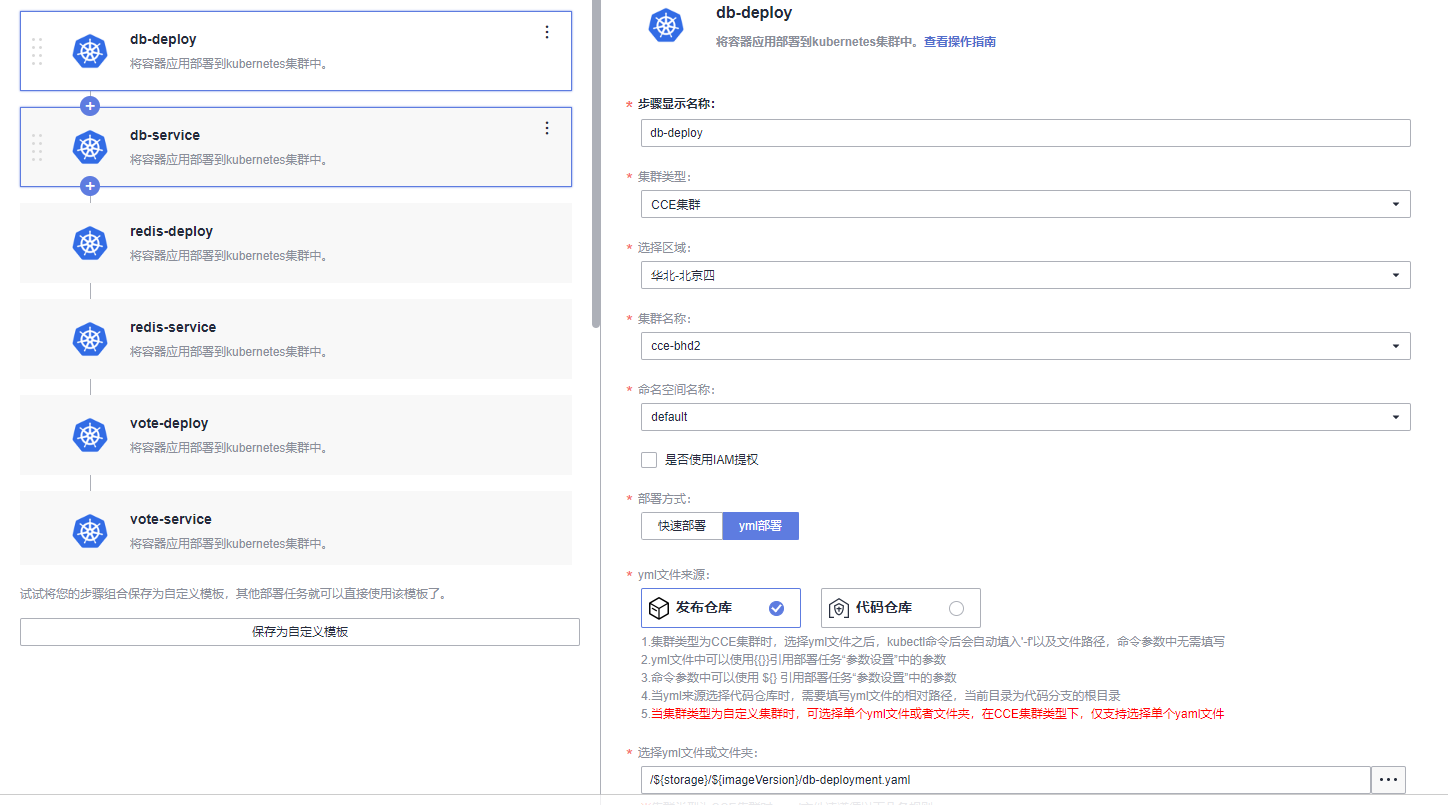 而由于我们在代码仓库中的配置并非我们最终部署时所需的配置(经过编译构建修改docker-server等参数),所以我们需要每个步骤都设置软件发布库中对应的yaml文件。此时,我们会发现,我们原本的构建任务是将所有yaml文件进行了打包压缩后才上传的,没有办法直接选中。所以,我们可以再次创建一个构建任务或者在原有构建任务上进行修改,以使软件发布库中存放有所有的yaml文件。 构建任务上传步骤的配置参考:(上传所有yaml文件而非打包后上传) 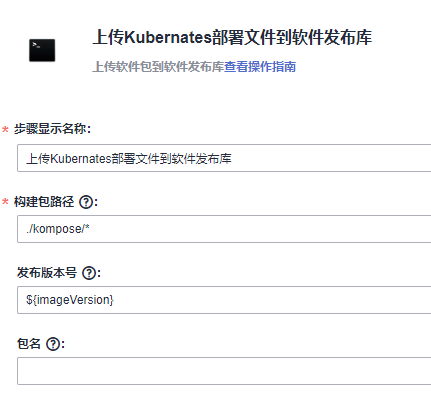 完成以上配置以后,执行Kubernetes部署模板任务,即可将服务部署至选定的CCE集群当中。此时再添加节点访问方式即可访问用户端与管理端。 当然,我们也可以将节点访问也写入yaml文件中,实现进一步的一键部署。这里就暂且留作一个小思考题,感兴趣的小伙伴可以自己尝试一下,将节点访问写入yaml当中。 # 结语 本篇文章一面介绍了HE2E实践中的CCE部署方式,一面又介绍了该实践中未提到的Kubernetes模板部署。两者的主要区别是“CCE部署”是通过代理机控制集群进行K8S部署;Kubernetes模板部署则是直接在集群中部署。此外,本文也对项目中关于K8S的配置进行了一定程度的解析。
-
第三章:云原生基础设施之Kubernetes学习笔记容器集群管理概述• 容器编排指自动化容器的部署、管理、扩展和联网,其价值: 灵活的资源管理及调度; 自动化部署及服务发现; 高效的监控及运维; 弹性扩展及高可用。• 从Borg到Kubernetes:起源于google内部Borg项目,于2015年7月22日迭代到v1.0并正式对外公布。• 2017年10月17日Docker宣布支持Kubernetes。Kubernetes核心架构与理念• 下图展现K8S的架构和工作流程• 基础的K8s集群通常包含一个Master节点和多个Node节点,每个节点可以是物理机也可以是虚拟机。• Master节点:提供的集群控制,对集群做出全局性决策Kube-apiserver:对外暴露K8s API,接收外部请求,写入etcd,可水平扩展;etcd:分布式数据存储组件,存储集群配置数据,提供数据备份Kube-controller-manager:控制器,执行集群级功能,例如复制组件,跟踪Node节点,处理节点故障等Kube-scheduler:负责任务调度,根据各种条件(如可用的资源、节点的亲和性等)将容器调度到Node上运行• Node节点:运行容器应用,根据Master的要求管理容器的生命周期Kubelet:接受Master指令,负责管理容器(Pod)Kube-proxy:应用组件间的访问代理,解决节点上应用的访问问题 Add-ons:插件,用于扩展K8s的功能Container runtime:容器运行时,如Docker,最主要的功能是下载镜像和运行容器。• 开放接口CRI、CNI、CSICRI:容器运行时的接口,提供计算能力CNI:容器网络接口,提供网络能力CSI:容器存储接口,提供存储能力• K8s工作流程• K8s核心概念:Pod:最小工作单元,每一个Pod包含一个或多个相关容器,K8s将其视为一个整体进行调度。引入Pod目的:扩展和实现生命周期管理。相同POD内的容器:使用相同的namespace空间,即有相同的IP地址和port,使用同一个localhost,volume可挂载到所有pod内的容器实现共享。但pod中每个容器的cpu和memory等资源通过其自身cgroup来做限制。Label:为资源打上标签,方便分类管理Namespace:在集群中对资源进行组织上的隔离。四个默认namespace:default、kube-public(公共访问区)、kube-system(系统资源区,如kubelet、kubeproxy等)、kube-node-lease。每个资源仅属于一个namespace,不同namespace中的资源命名可以相同;通过ResouceQuota做资源限制;全局资源不属于某一个namespaceConroller:控制器,K8S通过控制器管理PodService:定义Pod逻辑集合及访问策略,为Pod提供了负载均衡,通过label来选择Pod。Volume:管理Kubernetes存储,声明Pod中容器可以访问的文件目录,需挂载。Kubernetes应用编排与管理• Kubectl:K8s的命令行工具;指令式:kubectl [command] [TYPE] [NAME] [flags]声明式:kubectl apply –f [yaml文件名] .yaml文件的必选配置字段:apiVersion,kind,metadata,spec• YAML的语法规则Label的形式为key-value形式大小写敏感使用缩进表示层级关系,缩进使用空格而非tab,相同层级的元素左侧对齐在同一个yaml配置文件内可以同时定义多个资源• Kubernetes管理的对象类型总览:• 状态工作负载:Deployment、ReplicaSet• Deployment控制器下的每个Pod除了名称和IP地址不同,其余完全相同。Deployment可以根据需要同故宫Pod模板创建Pod或者删除任意一个Pod。• ReplicaSet,确定Deployment中Pod的副本数量• 从大到小的管理逻辑为:Deployment>ReplicaSet>Pod>容器• 创建Deployment指令式:kubectl create deployment deployment_name --image=image_name –replicas=number声明式:vi filename.yaml [注意,此处 kind: Deployment] Kubectl apply –f filename.yaml• 查看deployment创建情况:kubectl get deployment• 滚动更新:使用新的实例逐步更新Pod实例,零停机进行工作负载的更新。更新Deployement:kubectl edit deploy nginxkubectl set image deploy nginx nginx=nginx:1.9.1 kubectl apply -f nginx.yaml • 查看Deployment滚动更新情况/历史:kubectl rollout status deploy nginxkubectl rollout history deploy nginx• 回滚:kubectl rollout pause deploy nginxkubectl rollout resume deploy nginx• 有状态工作负载:StatefulSet:StatefulSet给每个Pod提供固定名称,Pod名称增加从0-N的固定后缀,Pod重新调度后Pod名称和HostName不变。StatefulSet通过Headless Service给每个Pod提供固定的访问域名。每个Pod有单独存储,StatefulSet通过创建固定标识的PVC保证Pod重新调度后还是能访问到相同的持久化数据。创建StatefulSet,yaml文件指定kind为StatefulSet,并指定volumeMounts• 守护进程工作负载:DaemonSetDaemonSet(守护进程集)在集群的每个节点上运行一个Pod,且保证只有一个Pod,适合系统层面的应用,例如日志收集、资源监控等Yaml文件创建DaemonSet时,kind选择DaemonSet,不需要规定replicas项。• Jobs:主要处理短暂的一次性任务,Job管理的Pod根据用户的设置把任务成功完成就自动退出(Pod自动删除),Jobs特点:保证指定数量Pod成功运行结束。支持并发执行。支持错误自动重试。支持暂停/恢复Jobs。• 创建JobsKind选择Job。Completions当前的任务需要执行的Pod数量。Parallelism表示最多有多少个并发执行的任务。RestartPolicy只能选择Never或OnFailure。BackoffLimit参数指定job失败后进行重试的次数。• CronJob:处理周期性或者重复性的任务,可使用Cron格式快速指定任务的调度时间,在yaml文件中kind选择CronJob,spec中的schedule: "* * * * *" 用来进行配置┌───────────── minute (0 - 59)│ ┌───────────── hour (0 - 23)│ │ ┌───────────── day of the month (1 - 31)│ │ │ ┌───────────── month (1 - 12)│ │ │ │ ┌───────────── day of the week (0 - 6) (Sunday to Saturday;│ │ │ │ │ 7 is also Sunday on some systems)│ │ │ │ ││ │ │ │ │* * * * * 如果您想要每个月的第一天里面每半个小时执行一次,那就可以设置为" 0,30 * 1 * * " 如果您想每个星期天的3am执行一次任务,那就可以设置为 "0 3 * * 0"。Kubernetes服务发布• Pod特征:有独立IP、扩缩容时数量会变更、故障时ReplicaSet会创建新的Pod• Service定义了访问逻辑上一组Pod的策略,有如下如所示3种类型• ClusterIP:提供一个集群内部的虚拟IP地址以供Pod访问(默认模式)• NodePort:在Node上打开一个端口以供外部访问• LoadBalance:通过外部的负载均衡器来访问。如果创建一个LoadBalancer,系统则会创建一个NodePort,NodePort则会创建ClusterIP。• Ingress:七层负载均衡,基于七层的HTTP和HTTPS协议进行转发Ingress资源:一组基于域名或URL把请求转发到指定Service实例的访问规则,是Kubernetes的一种资源对象,通过接口服务实现增、删、改、查的操作。Ingress Controller:请求转发的执行器,用以实时监控资源对象Ingress、Service、End-point、Secret(主要是TLS证书和Key)、Node、ConfigMap的变化,解析Ingress定义的规则并负责将请求转发到相应的后端Service。Ingress Controller在不同厂商之间的实现方式不同,根据负载均衡器种类的不同,可以将其分成ELB型和Nginx型。Kubernetes存储管理• Volume的核心是一个目录,用于Pod中的容器共享文件,与挂在它的Pod的生命周期相同。Pod不存在时,临时卷类型(emptyDir、ConfigMap、Secret等)中的数据会被销毁,持久化存储的卷(hostPath、PVC等)中的数据会保存。Volume不能独立创建,只能在Pod中定义。• emptyDir:一种简单的空目录,主要用于临时存储,适用于缓存空间,日志采集等场景。• ConfigMap:用于存储应用所需配置信息(key-value 形式)的资源类型,在被Pod引用前需单独定义。在Volume中引用ConfigMap:就是通过文件的方式直接将ConfigMap的每条数据填入Volume,每条数据是一个文件,键就是文件名,键值就是文件内容。• Secret:与ConfigMap类似,都是key-value键值对形式,使用方式也相同;Secret会加密存储,所以适用于存储敏感信息。只有Pod请求的Secret在其容器中才是可见的,一个Pod不能访问另一个Pod的Secret。• hostPath:能将主机节点文件系统上的文件或目录挂载到Pod中。适用于读取主机上的数据。永远不要使用HostPath存储跨Pod的数据。• PersistentVolume:PV描述的是持久化存储卷,主要定义的是一个持久化存储在宿主机上的目录,比如一个NFS的挂载目录。• PersistentVolumeClaim:PVC描述的是Pod所希望使用的持久化存储的属性,比如,Volume存储的大小、可读写权限等等。• StorageClass:存储类,简称SC,为管理员提供了描述存储 “类” 的方法,通过相应的存储插件(CSI)实现,可根据用户提出的PVC动态提供不同性质的PV。
-
 链接:https://bbs.huaweicloud.com/blogs/352564在《解构 H E2E 中的容器技术应用》 一文当中,为大家分析了HE2E项目的代码仓库、编译构建、部署等各环节中对于容器技术的应用。今天,我们将从Kubernetes技术应用的角度解构华为云 DevCloud HE2E D evOps 实践 。什么是Kubernetes?Kubernetes (也称K8S)是用于自动部署,扩展和管理容器化应用程序的开源系统。K8S与CCE在上一篇文章中,大家已经了解了HE2E项目中通过Docker实现容器化部署,在该实践中通过此方式部署至ECS弹性云服务器中,并称之为ECS部署。在该实践中,提供了另外一套部署方式,将应用部署至CCE集群当中,即CCE部署,使用的工具即K8S。总之,根据部署目标的不同,HE2E实践中分别介绍了ECS部署与CCE部署。根据部署采用的技术工具不同,也可以将这两种方式称为Docker部署与K8S部署。为什么选择K8S在正式的生产环境中,企业和团队往往会需要将应用部署至多个服务器主机,而CCE集群和K8S则共同为应用的部署、运行及管理提供了保障。相较而言,HE2E实践中介绍的ECS部署方式更倾向于开发、测试等环境下的单机部署。K8S的代码配置回到项目本身,代码仓库中的./kompose/文件夹下有多个yaml文件。可以看出,每个服务都有两个配置文件(*-deployment.yaml与*-service.yaml)共同进行配置。此处以db-deployment.yaml为例,对yaml配置仅作简短的介绍,帮助大家理解配置内容。随着集群版本和产品能力的更迭,也有很多配置信息将发生变化。所以在实践当中,需要调整 yaml 文件配置 。• apiVersion:此处值为apps/v1,这个版本号需要根据安装的K8S版本和资源类型进行变化。目前实践中对应v1.19版本的K8S集群。• kind:此处创建的是Deployment,根据实际情况,此处资源类型可以是Pod、Job、Ingress、Service等。如:在*-service.yaml文件中,创建的资源类型则是Service。• metadata:包含Deployment的一些meta信息。其中,annotations的含义是注解。• spec:你所期望的该对象的状态。包括replicas、selector、containers等Kubernetes需要的参数。其中,containers定义了该deployment使用的镜像:docker-server/docker-org/postgres:9.4。在上篇文章中提到过,这里的docker-server、docker-org都会在构建任务中替换为实际镜像对应的镜像地址和组织。strategy、restartPolicy等字段共同构成了容器失败时重启的策略。在*-service.yaml当中,主体内容与*-deployment.yaml相差也不算大,主要差异集中于spec这部分。*-service.yaml对应的spec主要是定义了集群内访问的方式,使各个服务之间可以互相访问。可以看出,*-deployment.yaml 与*-service.yaml共同定义了一个服务*。*-deployment.yaml主要定义了该服务的镜像源,或者说工作负载是什么。而*-service.yaml则定义了该服务访问方式。K8S的部署配置在编译构建环节,主体还是制作镜像上传到SWR镜像仓库,与上篇文章的没有区别。相关的配置文件也通过构建任务上传到软件发布库了,所以这里就不赘述了。镜像、配置和集群资源都准备妥当以后,就是使用K8S部署的环节了。代理机配置我们在HE2E实践中采用的是代理机的部署方式,将集群中的一个节点作为代理机进行授信、部署。所以在实践中我们从集群下载Kubectl配置文件并配置到节点主机当中(见《配置 Kubectl 》)。通过配置Kubectl的操作,我们就可以在节点主机上执行命令进而影响整个CCE集群。CCE部署任务HE2E实践中,phoenix-cd-cce是我们所需执行的部署任务。该任务将配置文件传输到目标主机,即代理机、集群节点。而后,通过执行shell命令启动Kubenetes。kubectl delete secret regcredkubectl create secret docker-registry regcred --docker-server=${docker-server} --docker-username=${docker-username} --docker-password=${docker-password} --docker-email=***@***.cn kubectl delete -f /root/phoenix-sample-deploy/kompose/kubectl apply -f /root/phoenix-sample-deploy/kompose/• 这里先是删除原有的secret,这一步主要是为了防止由于使用临时登录命令变化而导致secret错误引发的任务执行失败。• 接着,创建新的secret。包含docker-server、docker-username、docker-password等信息。• 按配置文件(/root/phoenix-sample-deploy/kompose/)删除资源。• 按配置文件(/root/phoenix-sample-deploy/kompose/)对资源进行配置。成功执行该部署任务后,可以在CCE集群中看到五个工作负载已经处于“运行中”的状态。不过目前还需要设置“节点访问”才能正常访问。所以在后续实践中对工作负载vote和result手动添加访问方式。节点访问设置完毕后,即可访问项目的用户端与管理端了。K8S的模板部署方式理论上,讲到现在,HE2E实践中的K8S部署就已经讲完了。但是,笔者猜到,肯定有很多人不喜欢这种通过代理机部署集群的方式。不过没关系,下面我就来介绍DevCloud当中的Kubernetes模板部署。新建模板时,现在可以选择模板:Kubernetes部署。进入模板以后,可以选择集群类型、区域、命名空间、部署方式等信息。由于本项目通过10个yaml文件共同配置,所以需要添加相同的“Kubernetes部署”步骤共计10个,每个步骤都对应一个yaml文件。而由于我们在代码仓库中的配置并非我们最终部署时所需的配置(经过编译构建修改docker-server等参数),所以我们需要每个步骤都设置软件发布库中对应的yaml文件。此时,我们会发现,我们原本的构建任务是将所有yaml文件进行了打包压缩后才上传的,没有办法直接选中。所以,我们可以再次创建一个构建任务或者在原有构建任务上进行修改,以使软件发布库中存放有所有的yaml文件。构建任务上传步骤的配置参考:(上传所有yaml文件而非打包后上传)完成以上配置以后,执行Kubernetes部署模板任务,即可将服务部署至选定的CCE集群当中。此时再添加节点访问方式即可访问用户端与管理端。当然,我们也可以将节点访问也写入yaml文件中,实现进一步的一键部署。这里就暂且留作一个小思考题,感兴趣的小伙伴可以自己尝试一下,将节点访问写入yaml当中。结语本篇文章一面介绍了HE2E实践中的CCE部署方式,一面又介绍了该实践中未提到的Kubernetes模板部署。两者的主要区别是“CCE部署”是通过代理机控制集群进行K8S部署;Kubernetes模板部署则是直接在集群中部署。此外,本文也对项目中关于K8S的配置进行了一定程度的解析。希望可以帮助小伙伴们理解K8S、HE2E,祝大家在技术成长的道路上越走越远。感谢小伙伴们的阅读。如果觉得还不错,不妨点个赞再走~此文由DevSecOps专家服务团队出品,前往 专家服务 ,获取更多DevSecOps工程方法、工具平台、最佳实践等干货。
-
一、创建Kubernetes集群1、创建集群1.1、登录CCE控制台https://console.huaweicloud.com/cce/1.2、创建CCE集群登录CCE控制台后会看见一个引导页面,请在CCE集群下单击“创建”按钮。1.3、配置集群参数参数说明如下:参数参数说明集群名称新建集群的名称。集群名称长度范围为4-128个字符,以小写字母开头,由小写字母、数字、中划线(-)组成,且不能以中划线(-)结尾。集群版本集群版本。建议选择最新的版本,对应Kubernetes社区基线版本。集群规模当前集群可以管理的最大Node节点规模。若选择50节点,表示当前集群最多可管理50个Node节点。高可用默认选择“是”。网络模型默认即可。虚拟私有云新建集群所在的虚拟私有云。若没有可选虚拟私有云,单击“新建虚拟私有云”进行创建,完成创建后单击刷新按钮。容器网段按默认配置即可。服务网段按默认配置即可。1.4、提交在右侧界面中会显示集群的资源清单,选择计费模式后,单击“提交”按钮,等待集群创建成功。创建成功后在集群管理下会显示一个运行中的集群,且集群节点数量为0。2、创建节点集群创建成功后,您还需要在集群中创建运行工作负载的节点。2.1、参数配置登录CCE控制台,单击创建的集群,进入集群控制台,在左侧菜单栏选择节点管理,单击右上角“创建节点”,在弹出的页面中配置节点的参数。参数说明如下:参数参数说明计算配置可用区默认即可。节点类型选择“虚拟机节点”。节点规格根据业务需求选择相应的节点规格。操作系统请选择节点对应的操作系统。节点名称自定义节点名称。登录方式支持密码和密钥对两种方式“密码”方式:用户名默认为“root”,请输入登录节点的密码,并确认密码。“密钥对”方式:在选项框中选择用于登录本节点的密钥对,并单击勾选确认信息。密钥对用于远程登录节点时的身份认证。若没有密钥对,可单击选项框右侧的“创建密钥对”来新建。存储配置系统盘按您的业务需求选择,缺省值为50GB。数据盘按您的业务需求选择,缺省值为100GB。网络配置虚拟私有云使用默认,即创建集群时选择的子网。节点子网选择节点所在的子网。2.2、规格确认在页面最下方选择节点的数量和计费模式,单击“下一步: 规格确认”。2.3、提交查看节点规格无误后,阅读页面上的使用说明,勾选“我已阅读并知晓上述使用说明”,单击“提交”按钮,等待节点创建成功,创建成功后在节点管理下会显示一个运行中的节点。二、镜像创建无状态工作负载(Nginx)1、前提条件您需要创建一个至少包含一个节点的集群,且该节点已绑定弹性公网IP,集群是运行工作负载的逻辑分组,包含一组云服务器资源,每台云服务器即集群中的一个节点。2、Nginx应用概述Nginx是一款轻量级的Web服务器,您可通过CCE快速搭建nginx web服务器。博主这里以选择“开源镜像中心”的方式创建应用为例,来创建一个Nginx工作负载。3、操作步骤3.1、镜像创建登录CCE控制台,单击集群进入集群控制台,在左侧菜单栏选择“工作负载”,单击右上角“镜像创建”。3.2、参数配置填写以下参数,其它保持默认。(1)基本参数配置参数参数说明负载类型选择无状态负载。负载名称nginx。实例数量设置为1。容器配置在基本信息中单击“选择镜像”,在弹出的窗口中选择“镜像中心”,并搜索“nginx”,选择nginx镜像。(2)服务配置单击服务配置下的加号,创建服务(Service),用于从外部访问负载,配置参数如下:参数参数说明Service名称输入应用发布的可被外部访问的名称,设置为:nginx。访问类型选择“负载均衡 ( LoadBalancer )”。服务亲和保持默认。负载均衡器如果已有负载均衡(ELB)实例,可以选择已有ELB,如果没有可单击“创建负载均衡器”,在ELB控制台创建一个公网类型负载均衡器。端口配置对外协议:TCP。服务端口:设置为8080,该端口号将映射到容器端口。容器端口:容器中应用启动监听的端口,nginx镜像请设置为80,其他应用容器端口和应用本身的端口一致。3.3、创建工作负载单击右下角“创建工作负载”,等待工作负载创建成功。创建成功后在无状态负载下会显示一个运行中的工作负载。4、访问Nginx(1)获取Nginx的外部访问地址单击Nginx工作负载名称,进入工作负载详情页。在访问方式页签下可以看到nginx的IP地址,其中负载均衡IP就是外部访问地址,如图所示:(2)在浏览器中输入“外部访问地址”,即可成功访问应用,如下图所示:【与云原生的故事】有奖征文火热进行中:https://bbs.huaweicloud.com/blogs/345260链接:https://bbs.huaweicloud.com/blogs/351622
-
 前文: Kubernetes的主要功能是容器编排,是指确保所有容器都按照计划运行在物理机或虚拟机上。这些容器在部署环境和集群配置的约束下被打包执行大量工作负载。此外,Kubernetes必须密切关注所有运行中的容器,替换运行中止,无响应或其他非正常状态的容器。 软件开发平台(DevCloud)是面向开发者提供的一站式云端DevOps平台,即开即用,随时随地在云端交付软件全生命周期,覆盖需求下发、代码提交、代码检查、代码编译、验证、部署、发布,打通软件交付的完整路径,提供软件研发流程的端到端支持,全面支撑落地DevOps。 本文着重介绍各位技术大咖在进行devcloud->部署->Kubernetes部署时,如何高效正确打通全流程参数化~ 废话不多说,下面开始手把手教学(*^▽^*)!! 首先我们介绍一下为什么要参数化~ 在敏捷开发,小步快跑的过程中,我们通过提交代码,执行各种各样的构建任务,编译打包镜像并上传到我们的华为云容器镜像服务SWR中,那么我们如何方便的管理我们的镜像呢?如果把镜像名称写成固定值,那么每次上传都会把旧版本覆盖掉,不利于我们的回滚和版本管理;而且我们的Kubernetes部署需要识别到yml文件的内容变动,部署后才会触发镜像更新!基于以上几点,参数化这个功能真是显得格外重要~ 下面我们开始图文并茂,直接上干货!持续集成嘛,提交代码的目的是为了打包编译,然后部署到目标集群,我们通过编译构建任务,新建步骤“制作镜像并推送到SWR仓库”,实现这个目的:我们试着构建一下~ 构建成功后,可以去容器镜像服务SWR里确认一下成果~!然后我们去部署服务里,新建kubernetes部署,按下图进行配置~同样~:我们在部署任务的参数设置中,也像构建那样,新建参数。接下来这步是重点哦,我们去代码仓库中的yml文件里,通过{{}}引用我们部署任务里的参数“version”下图是样例:接下来,我们通过流水线服务,把上述任务串起来~ 然后我们把流水线中的这个参数类型改为自增长,勾选"运行时设置",这样我们只需要首次执行流水线任务的时候给它赋予一个初始值,以后就会根据这个初始值进行自增长接下来,我们保存并执行一下这个流水线任务~(可以手动执行,也可以通过提交代码触发执行),然后静静的等待任务结束哎呦,部署成功了~我们看下执行参数是否成功取到了自增长的参数值。看起来没什么问题~ 因为我太菜~已经测试了4次OK!大功告成,最后我们去CCE集群的工作负载里检验一下最终成果!怎么样大咖们? 大家都学废,啊呸,大家都学会了嘛~ 请奔走相告~~
-
>摘要:为保证高速公路上门架系统的落地项目的成功落地,选择K8s和KubeEdge来进行整体的应用和边缘节点管理。本文分享自华为云社区《[如何使用Kubernetes管理中国高速公路上的10万边缘节点?](https://huaweicloud.blog.csdn.net/article/details/113683195)》,原文作者:技术火炬手。 # 一、项目背景 本项目是在高速公路ETC联网和推动取消省界收费站的大前提下,门架系统的落地,也就是要把门架部署在覆盖全国范围的高速公路上,收集车辆通行的牌示信息,以及相应的交易信息。 整体的情况是在边缘侧,即高速公路上会部署大量的门架和相应的控制器,相应的边缘终端,这些终端大概10万台,其上部署了相关的应用以收集相关信息。超过50万个应用部署到边缘节点,收集到信息后,通过收费专网向省中心以及路网中心上传对应的数据。 **本次项目的工作挑战主要有两个方面:** 将近10万台异构设备的管理,包括arm,x86等异构设备。 50余万个应用的生命周期管理 **为保证项目的成功落地,我们对整体架构做了选型,最终选择了K8s和KubeEdge来进行整体的应用和边缘节点管理。** # 二、为什么选择Kubernetes 在项目里,虽然说是部署在边缘侧的应用,但它的复杂程度已经和云上是类似的了,在边缘侧部署的应用已经是由很多个微服务组成的。所以Kubernetes对于支撑这种微服务化的、云原生化的应用部署和大规模管理的能力,同样也适用于这个项目在边缘侧的使用。 **具体来说,有一些典型的部署需求:** - 双机热备 - 多机多活互备 - 有关联的应用同节点部署以提升应用间交互效率 - 同一应用的不同实例跨节点部署以提升可用性 - 依据边缘节点的不同属性将应用部署于不同分组中 - 定义独立于节点的应用部署以及实现满足条件的新边缘节点上线后自动安装应用 **这些需求,用K8s的这些Deployment、Pod、ReplicaSet、DaemonSet等核心对象来表示,是非常适合的。所以我们就选择了Kubernetes。** 当然,还有一些重要的边缘侧特有的需求是原生的Kubernetes不具备的,但Kubernetes的架构是非常好的,易于扩展,灵活性很高,可以基于原生Kubernetes架构基础,根据边缘管理的特殊需求进行扩展。 # 三、为什么选择KubeEdge **一是业务自身的特点来决定的。** 这个业务的量非常大,涉及的边缘节点分布在全国各地,所以它的边缘侧是多硬件架构、多厂家的,我们需要异构的支持; 边缘工控机低至4核ARM SOC、1G可用内存,我们需要低资源占用的方案来管理边缘侧的节点;管理运维复杂,从路网中心到最终路段,分为6级管理层次,管理成本高,我们需要高集成度边缘的方案,让边缘足够简单,把出问题的概率降到最低,降低运维成本。 **二是从边缘环境的特点来看的。** 从网络的角度来看,网络分为部省、省站两层,多次转发,我们需要边缘接入具有高灵活性,可支持专线、代理、公网、有线和无线接入等多种方式;各地基础设施的建设不同,有些省份的网络带宽低至3M,我们需要边缘和云之间的管理带宽占用降到最低;有些高速公路上的网络条件是非常差的,经常出现断网的情况。我们需要边缘方案有离线自治的能力。 # 四、整体方案 接下来我会把整体方案打开成几层来分别介绍。 **应用部署** 首先是应用部署,就像我刚才说的,在边缘侧要部署的业务非常复杂,它是由多个微服务所构成的云原生化的架构。所以我们这些微服务以及中间件都容器化之后可以非常好的适应各种不同的异构操作系统,方便统一管理。 如下图所示,微服务架构分成前端和后端,前端主要把业务通过Deployment的方式部署到门架上,与后端之间是通过EdgeMesh实现的。通过这种服务发现的方式,实现微服务前后端业务的通信。而后端业务容器本身是无状态的,可以通过Deployment来部署。 后面的Redis包括MySql就可以通过Statefulset的方式来进行部署。通过这样的部署模型,我们可以很完美的进行封装和自动化管理高可用的边缘侧的整套业务系统。  但如果仅仅是用原生的K8s部署方式,并不能完全满足我们的需求,因为在项目里要部署的量非常大,左图的环境只是应用于一个收费站,而一个路段要管理几百上千个收费站,逐个部署成本过高。所以我们基于K8s之上又构建了一个任务工作流的引擎系统,把每一个部署微服务的步骤定义为一个job。用批量的方式大量、快速部署成百上千个同样的微服务系统和环境。  **大规模节点接入** 除了上面提到的挑战,在应对大规模节点接入的情况下也遇见过一些问题: 每个省有自己的管理权限,我们按K8s集群的配置配了多个K8s集群来进行管理,一个省对应一个K8s集群,然后在K8s之上通过统一的管理层处理复杂跨集群数据统计等操作,从中心侧管理每个省的边缘侧,这就是多集群的管理手段。 我们曾遇见一种现象,路网中心或省中心做网络升级等动作之后,网络有时候会出现问题,所有省的边缘节点,失去与K8s的连接,等网络恢复之后,又会发生所有节点同时连接中心侧的K8s集群,引起大量的并发连接,对中心侧的系统造成冲击,导致应用异常。为了应对这种情况,我们通过动态退避算法缓解节点同时接入所形成的流量冲击。 需要精简NodeStatus和PodStatus上报的信息。就前文所提到的,各地基础设施的建设不同,有些省份的网络带宽低至3M,所以我们需要减小状态信息的大小,降低上报流量的冲击,降低对网络的影响。 镜像仓库Mirror分级加速,有效降低了对网络的冲击,提高大批量部署的部署效率。 **边缘业务高可用** 接下来的是边缘业务高可用,按照原生K8s的升级状态,它会先删除旧版本Pod,再创建新Pod并在这个过程中去拉取新版本镜像。这种操作在公有云网络条件较好的情况下,是没太大问题的。但在边缘侧,这样就会造成业务长时间的中断,收费数据缺失。所以针对这一个流程,我们也是做了相应的升级和优化。 我们先把升级下载镜像的通知下发做预下载,下载成功之后再删除已有的旧Pod,启动新应用,优化了应用升级对服务中断的时间的影响,将业务升级时整体业务中断的时间从分钟级缩减到了10s内。 同时,考虑到边缘设备有主备部署的情况,而边缘侧又不像云上有ELB服务。我们又在边缘节点中容器化部署了Keepalived,通过VIP,为门架的摄像头等设备提供对应的K8s集群内的容器服务。 # 五、总结 当前基于KubeEdge的边缘管理系统管理着全国29个省、市 、自治区的将近100,000个边缘节点,超过500,000边缘应用的部署。支撑了高速公路门架业务的不断调整、更新,满足了每日3亿条以上的信息采集。 为日后车路协同、自动驾驶等创新业务的发展提供了良好的平台支撑。 K8s提供的通用部署和调度模型很适合部署大规模边缘应用。 单纯原生K8s不能满足边缘侧业务的所有需求,KubeEdge集成K8s云原生管理能力,同时对边缘业务部署和管理提供了很好的支持。
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签