-
 前言SQL程序语言有四种类型,对数据库的基本操作都属于这四类,它们分别为;数据定义语言(DDL)、数据查询语言(DQL)、数据操纵语言(DML)、数据控制语言(DCL)数据定义语言(DDL)DDL全称是Data Definition Language,即数据定义语言,定义语言就是定义关系模式、删除关系、修改关系模式以及创建数据库中的各种对象,比如表、聚簇、索引、视图、函数、存储过程和触发器等等。数据定义语言是由SQL语言集中负责数据结构定义与数据库对象定义的语言,并且由CREATE、ALTER、DROP和TRUNCATE四个语法组成。比如:--创建一个student表 create table student( id int identity(1,1) not null, name varchar(20) null, course varchar(20) null, grade numeric null )--student表增加一个年龄字段 alter table student add age int NULL--student表删除年龄字段,删除的字段前面需要加column,不然会报错,而添加字段不需要加column alter table student drop Column age --删除student表 drop table student --删除表的数据和表的结构 truncate table student -- 只是清空表的数据,,但并不删除表的结构,student表还在只是数据为空数据操纵语言(DML)数据操纵语言全程是Data Manipulation Language,主要是进行插入元组、删除元组、修改元组的操作。主要有insert、update、delete语法组成。--向student表中插入数据 --数据库插入数据 一次性插入多行多列 格式为INSERT INTO table (字段1, 字段2,字段3) VALUES (值1,值2,值3),(值1,值2,值3),...; INSERT INTO student (name, course,grade) VALUES ('张飞','语文',90),('刘备','数学',70),('关羽','历史',25),('张云','英语',13);--更新关羽的成绩 update student set grade='18' where name='关羽'--关羽因为历史成绩太低,要退学,所以删除关羽这个学生 delete from student where name='关羽'数据查询语言(DQL)数据查询语言全称是Data Query Language,所以是用来进行数据库中数据的查询的,即最常用的select语句--从student表中查询所有的数据 select * from student--从student表中查询姓名为张飞的学生 select * from student where name='张飞'数据控制语言(DCL)数据控制语言:Data Control Language。用来授权或回收访问数据库的某种特权,并控制数据库操纵事务发生的时间及效果,能够对数据库进行监视。比如常见的授权、取消授权、回滚、提交等等操作。1、创建用户语法结构:CREATE USER 用户名@地址 IDENTIFIED BY '密码'; --创建一个testuser用户,密码111111 create user testuser@localhost identified by '111111';2、给用户授权语法结构:GRANT 权限1, … , 权限n ON 数据库.对象 TO 用户名; --将test数据库中所有对象(表、视图、存储过程,触发器等。*表示所有对象)的create,alter,drop,insert,update,delete,select赋给testuser用户 grant create,alter,drop,insert,update,delete,select on test.* to testuser@localhost;3、撤销授权语法结构:REVOKE权限1, … , 权限n ON 数据库.对象 FORM 用户名; --将test数据库中所有对象的create,alter,drop权限撤销 revoke create,alter,drop on test.* to testuser@localhost;4、查看用户权限语法结构: SHOW GRANTS FOR 用户名; --查看testuser的用户权限 show grants for testuser@localhost;5、删除用户语法结构:DROP USER 用户名; --删除testuser用户 drop user testuser@localhost;6、修改用户密码语法结构:USE mysql; UPDATE USER SET PASSWORD=PASSWORD(‘密码’) WHERE User=’用户名’ and Host=’IP’; FLUSH PRIVILEGES; --将testuser的密码改为123456 update user set password=password('123456') where user='testuser' and host=’localhost’; FLUSH PRIVILEGES;结尾本文对SQL程序语言有四种操作语言做了一个简单的介绍和概括,对数据库的基本操作都属于这四类,它们分别为;数据定义语言(DDL)、数据查询语言(DQL)、数据操纵语言(DML)、数据控制语言(DCL) 。
-
 本文分享自华为云社区《[GaussDB(DWS) SQL进阶之PLSQL(二)-游标](https://bbs.huaweicloud.com/blogs/330535?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=ei&utm_content=content)》,作者: xxxsql123 。 # 前言 游标是一种数据处理方法,提供了在查询结果集中进行逐行遍历浏览数据的方法,也可以将游标当做上下文区域的句柄或者指针,借助游标对指定位置的数据进行查询与处理,本章我们主要聚焦于GaussDB(DWS)存储过程中的游标使用。 # 显式游标 显示游标主要用于处理存储过程中的查询结果集是游标常用的用法,具体分为如下几个步骤: # Step 1 定义游标: ## 静态游标定义: 即定义一个游标名以及与其相对应的SELECT语句 语法图:  示例如下: ``` --在存储过程的DECLARE中声明游标定义 CURSOR C1 IS SELECT section_name, place_id FROM hr.sections WHERE section_id = 50; CURSOR C2(sect_id INTEGER) IS SELECT section_name, place_id FROM hr.sections WHERE section_id = sect_id; ``` ## 动态游标定义: 即ref游标,可以通过静态的SQL语句在合适的时候动态的打开游标。先定义ref游标类型,后面通过open for动态绑定SELECT语句 语法图:  示例如下: ``` --在存储过程的DECLARE中声明游标定义 TYPE CURSOR_TYPE IS REF CURSOR; ``` 同时GaussDB(DWS)做了Oracle兼容,支持sys_refcursor动态游标类型,函数或存储过程可以通过sys_refcursor参数传入或传出游标结果集合,函数也可以通过返回sys_refcursor来返回游标结果集合。 语法图:  示例如下: ``` --在存储过程的DECLARE中声明游标定义 C1 SYS_REFCURSOR; ``` # Step 2 打开游标: ## 静态游标打开: 即执行游标对应的SELECT语句,将结果集放入工作区,将游标的指针指向工作区的起始位置。 语法图:  示例如下: ``` --在存储过程的BODY中打开游标 OPEN C1; OPEN C2(10); ``` ## 动态游标打开: 通过OPEN FOR语句打开动态游标,通过USING对SELECT语句进行动态绑定。 语法图:  示例如下: ``` --在存储过程的BODY中打开游标 SQL_STR := 'SELECT section_name, place_id FROM hr.sections WHERE section_id = :DEPT_NO;'; OPEN C3 FOR SQL_STR USING 50; ``` # Step 3 提取游标数据: 即提取游标指针指向的数据 语法图:  示例: ``` --在存储过程的BODY中执行 FETCH C3 INTO DEPT_NAME, DEPT_LOC; ``` # Step 4 循环处理游标数据: 提取数据后可以基于存储过程的语句灵活发挥 例如,给工资低于3000的员工增加500块钱工资 ``` --在存储过程的BODY中执行 LOOP FETCH C INTO V_EMPNO, V_SAL; EXIT WHEN C%NOTFOUND; IF V_SAL=3000 THEN UPDATE hr.staffs_t1 SET salary =salary + 500 WHERE staff_id = V_EMPNO; END IF; END LOOP; ``` # Step 5 关闭游标: 在处理完游标的数据后,应及时释放游标,以便释放游标所占用系统资源,游标关闭后工作区将变成无效,不能再使用FETCH语句获取其中数据。关闭后的游标可以使用OPEN语句重新打开。 语法图:  ``` --在存储过程的BODY中执行 CLOSE C1;--关闭游标 ``` # 游标属性 我们可以通过游标的属性来了解当前游标的状态。下面将介绍4中游标属性: ※ %FOUND布尔型属性:当最近一次读记录时成功返回,则值为TRUE。 ※ %NOTFOUND布尔型属性:与%FOUND相反。 ※ %ISOPEN布尔型属性:当游标已打开时返回TRUE。 ※ %ROWCOUNT数值型属性:返回已从游标中读取的记录数。 示例: ``` OPEN C1;--打开游标 LOOP --通过游标取值 FETCH C1 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C1%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C1;--关闭游标 ``` 接下来我们将结合前面所学习的知识,在存储过程运用显示游标。 数据准备: ``` CREATE SCHEMA hr; SET CURRENT_SCHEMA = 'hr'; DROP TABLE IF EXISTS sections; CREATE TABLE sections(section_id INT, section_name VARCHAR(100), place_id NUMBER(4)) DISTRIBUTE BY HASH(section_id); INSERT INTO sections VALUES (1, 'section_name1', 1),(2, 'section_name2', 2),(3, 'section_name3', 3); ``` 显示游标使用示例: ``` --游标参数的传递方法。 CREATE OR REPLACE PROCEDURE cursor_proc1() AS DECLARE DEPT_NAME VARCHAR(100); DEPT_LOC NUMBER(4); --定义游标 CURSOR C1 IS SELECT section_name, place_id FROM hr.sections WHERE section_id = 50; CURSOR C2(sect_id INTEGER) IS SELECT section_name, place_id FROM hr.sections WHERE section_id = sect_id; TYPE CURSOR_TYPE IS REF CURSOR; C3 CURSOR_TYPE; SQL_STR VARCHAR(100); BEGIN OPEN C1;--打开游标 LOOP --通过游标取值 FETCH C1 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C1%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C1;--关闭游标 OPEN C2(10); LOOP FETCH C2 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C2%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C2; SQL_STR := 'SELECT section_name, place_id FROM hr.sections WHERE section_id = :DEPT_NO;'; OPEN C3 FOR SQL_STR USING 50; LOOP FETCH C3 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C3%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C3; END; / CALL cursor_proc1(); DROP PROCEDURE cursor_proc1; ``` 执行结果: ``` postgres=# CALL cursor_proc1(); section_name3---3 section_name1---1 section_name2---2 section_name1---1 section_name2---2 section_name3---3 section_name1---1 section_name2---2 section_name3---3 cursor_proc1 -------------- (1 row) ``` SYS_REFCURSOR游标示例: ``` --SYS_REFCURSOR类型做为函数参数 CREATE OR REPLACE PROCEDURE proc_sys_ref(O OUT SYS_REFCURSOR) IS C1 SYS_REFCURSOR; BEGIN OPEN C1 FOR SELECT section_ID FROM HR.sections ORDER BY section_ID; O := C1; END; / DECLARE C1 SYS_REFCURSOR; TEMP NUMBER(4); BEGIN proc_sys_ref(C1); LOOP FETCH C1 INTO TEMP; DBMS_OUTPUT.PUT_LINE(C1%ROWCOUNT); EXIT WHEN C1%NOTFOUND; END LOOP; END; / --删除存储过程 DROP PROCEDURE proc_sys_ref; ``` 执行结果: ``` postgres=# DECLARE postgres-# C1 SYS_REFCURSOR; postgres-# TEMP NUMBER(4); postgres-# BEGIN postgres$# proc_sys_ref(C1); postgres$# LOOP postgres$# FETCH C1 INTO TEMP; postgres$# DBMS_OUTPUT.PUT_LINE(C1%ROWCOUNT); postgres$# EXIT WHEN C1%NOTFOUND; postgres$# END LOOP; postgres$# END; postgres$# / 1 2 3 3 ANONYMOUS BLOCK EXECUTE ``` # 隐式游标 对于非SELECT语句,例如UPDATE,DELETE操作,系统会自动的未这些操作设置游标,这些有系统隐含创建的游标即隐式游标。隐式游标的定义,打开,取值,关闭操作均有系统自动的完成,无需用户进行处理,用户只能通过隐式游标的相关属性完成相应的操作。 隐式游标属性: ※ SQL%FOUND布尔型属性:当最近一次读记录时成功返回,则值为TRUE。 ※ SQL%NOTFOUND布尔型属性:与%FOUND相反。 ※ SQL%ROWCOUNT数值型属性:返回已从游标中读取得记录数。 ※ SQL%ISOPEN布尔型属性:取值总是FALSE。SQL语句执行完毕立即关闭隐式游标。 隐式游标示例如下: ``` --删除EMP表中某部门的所有员工,如果该部门中已没有员工,则在DEPT表中删除该部门。 CREATE TABLE hr.staffs_t1 AS TABLE hr.staffs; CREATE TABLE hr.sections_t1 AS TABLE hr.sections; CREATE OR REPLACE PROCEDURE proc_cursor3() AS DECLARE V_DEPTNO NUMBER(4) := 100; BEGIN DELETE FROM hr.staffs WHERE section_ID = V_DEPTNO; --根据游标状态做进一步处理 IF SQL%NOTFOUND THEN DELETE FROM hr.sections_t1 WHERE section_ID = V_DEPTNO; END IF; END; / CALL proc_cursor3(); --删除存储过程和临时表 DROP PROCEDURE proc_cursor3; DROP TABLE hr.staffs_t1; DROP TABLE hr.sections_t1; ``` 以上就是在GuassDB(DWS)的存储过程中游标的基本使用。 # 总结 GuassDB(DWS)的游标使用在postgresql的基础上做了对Oracle的语法兼容,存储过程中的游标功能对于原来依赖Oracle的系统可以平滑的迁移。同时由于GuassDB(DWS)是分布式架构,和postgresql本身以及GuassDB(DWS)的单机模式上游标的行为细节上会略有不同,例如事务中的DECLARE CURSOR由于分布式和单机的实现差异导致在pg_cursors视图查询结果差异等。
-
【功能模块】 SQL功能【操作步骤&问题现象】1、编写SQL2、报错,见报错截图一补充说明,T1、T2、这2张表都有数据,且这2张表的数据都能关联上。再经过测试,发现T1表带上where条件就会报错(不带where条件能正常查询),见报错截图二【截图信息】报错截图一报错截图二【日志信息】(可选,上传日志内容或者附件)
-
 本文对SQL程序语言有四种操作语言做了一个简单的介绍和概括,对数据库的基本操作都属于这四类,它们分别为;数据定义语言(DDL)、数据查询语言(DQL)、数据操纵语言(DML)、数据控制语言(DCL) 。前言SQL程序语言有四种类型,对数据库的基本操作都属于这四类,它们分别为;数据定义语言(DDL)、数据查询语言(DQL)、数据操纵语言(DML)、数据控制语言(DCL)数据定义语言(DDL)DDL全称是Data Definition Language,即数据定义语言,定义语言就是定义关系模式、删除关系、修改关系模式以及创建数据库中的各种对象,比如表、聚簇、索引、视图、函数、存储过程和触发器等等。数据定义语言是由SQL语言集中负责数据结构定义与数据库对象定义的语言,并且由CREATE、ALTER、DROP和TRUNCATE四个语法组成。比如:--创建一个student表 create table student( id int identity(1,1) not null, name varchar(20) null, course varchar(20) null, grade numeric null ) --student表增加一个年龄字段 alter table student add age int NULL --student表删除年龄字段,删除的字段前面需要加column,不然会报错,而添加字段不需要加column alter table student drop Column age --删除student表 drop table student --删除表的数据和表的结构 truncate table student -- 只是清空表的数据,,但并不删除表的结构,student表还在只是数据为空数据操纵语言(DML)数据操纵语言全程是Data Manipulation Language,主要是进行插入元组、删除元组、修改元组的操作。主要有insert、update、delete语法组成。 --向student表中插入数据 --数据库插入数据 一次性插入多行多列 格式为INSERT INTO table (字段1, 字段2,字段3) VALUES (值1,值2,值3),(值1,值2,值3),...; INSERT INTO student (name, course,grade) VALUES ('张飞','语文',90),('刘备','数学',70),('关羽','历史',25),('张云','英语',13); --更新关羽的成绩 update student set grade='18' where name='关羽' --关羽因为历史成绩太低,要退学,所以删除关羽这个学生 delete from student where name='关羽'数据查询语言(DQL)数据查询语言全称是Data Query Language,所以是用来进行数据库中数据的查询的,即最常用的select语句。 --从student表中查询所有的数据 select * from student --从student表中查询姓名为张飞的学生 select * from student where name='张飞'数据控制语言(DCL)数据控制语言:Data Control Language。用来授权或回收访问数据库的某种特权,并控制数据库操纵事务发生的时间及效果,能够对数据库进行监视。比如常见的授权、取消授权、回滚、提交等等操作。1、创建用户语法结构:CREATE USER 用户名@地址 IDENTIFIED BY '密码'; --创建一个testuser用户,密码111111 create user testuser@localhost identified by '111111';2、给用户授权语法结构: GRANT 权限1, … , 权限n ON 数据库.对象 TO 用户名; --将test数据库中所有对象(表、视图、存储过程,触发器等。*表示所有对象)的create,alter,drop,insert,update,delete,select赋给testuser用户 grant create,alter,drop,insert,update,delete,select on test.* to testuser@localhost;3、撤销授权语法结构:REVOKE权限1, … , 权限n ON 数据库.对象 FORM 用户名; --将test数据库中所有对象的create,alter,drop权限撤销 revoke create,alter,drop on test.* to testuser@localhost;4、查看用户权限语法结构: SHOW GRANTS FOR 用户名; --查看testuser的用户权限 show grants for testuser@localhost;5、删除用户语法结构:DROP USER 用户名; --删除testuser用户 drop user testuser@localhost;6、修改用户密码语法结构:USE mysql; UPDATE USER SET PASSWORD=PASSWORD(‘密码’) WHERE User=’用户名’ and Host=’IP’; FLUSH PRIVILEGES; --将testuser的密码改为123456 update user set password=password('123456') where user='testuser' and host=’localhost’; FLUSH PRIVILEGES;结尾本文对SQL程序语言有四种操作语言做了一个简单的介绍和概括,对数据库的基本操作都属于这四类,它们分别为;数据定义语言(DDL)、数据查询语言(DQL)、数据操纵语言(DML)、数据控制语言(DCL) 。作者:江夏来源:https://www.51cto.com/article/709269.html
-
 平台SQL的where条件中的参数如果类型不匹配,会导致索引不生效。在完整的SQL语句前加上explain for可以查看SQL语句的执行计划,从而判断该SQL是否使用索引查询。例如,想要查看select id from PE_Person where name='abc'这条SQL语句的执行计划,那么可以在这条语句前面加上explain for,即执行 explain for select id from PE_Person where name='abc' 可以看到其执行计划。在索引字段上使用like进行模糊查询匹配,like操作符后的值的左边带有%时:例如,假设PE_Person对象模型中的name字段为索引字段。模糊查询PE_Person对象模型中的name字段中包含'bbb'的记录,其执行的SQL为select id from PE_Person where name like '%bbb%',是不使用索引而进行全表扫描匹配记录的。建议方案:如果知道了待搜索的name的精确值,则使用精确的=号查询,如select id from PE_Person where name='abbbc'。如果不知道的name的精确值,但是可以知道待搜索的name字段的前缀,则可以只使用右边的%左边精确填写,如select id from PE_Person where name like 'abbb%'。数据类型出现隐式转化如SQL语句中的where条件后的值,该字段上的数据类型为文本,但是查询的过程中传入的是数字,使得查询过程中出现了隐式转换,导致索引无效,从而全表扫描。查询应该保证查询条件的值应该与对象模型中的值的类型一致。例如,select id from PE_Person where name=123,但是name在模型对象中是字符串类型。应该改为select id from PE_Person where name='123'在索引列上使用 IS NULL 或 IS NOT NULL操作索引是不索引空值的,所以这样的操作不能使用索引,可以用其他的办法处理,例如:数字类型,判断大于0,字符串类型设置一个默认值,判断是否等于默认值即可。例如:explain for select name from de_devices where name is not null。使用or语句做SQL拼接例如:select id from PE_Person where id='0I05000000OFyd0pgSKO' or PersonName='张三'。对索引字段进行计算操作、字段上使用函数例如,PE_Person模型对象中的字段PersonName为索引字段,其中希望搜索条件满足PersonName为'abc'的记录。如果写为如下的两条SQL语句,会导致无法使用索引。select id from PE_Person where PersonName=lower('ABC') 或者 select id from PE_Person where lower(PersonName)='ABC'改进方案:可以将函数处理放置在执行SQL前执行,执行SQL时候则不用包含相关函数。例如以上的场景可以先将‘ABC’通过函数转换为'abc'再进行SQL语句查询:select id from PE_Person where PersonName='ABC'对索引字段使用<>符号进行SQL查询select name from PE_Person where id <> 'abc123'
-
如果模型中满足某条件的数据量很大,查询的SQL语句中带有order by,count过程非常缓慢。可结合自身业务场景考虑是否可以放弃。如果业务上的 order by,count 不能删除,可以通过以下的方案进行优化:涉及order by的优化一般情况下,一个接口只需要一个order by,并且是对lastModifiedDate进行倒序查询输出的。但是lastModifiedDate字段是频繁修改的字段,同时也是平台的对象模型中的必带字段,不适合建立索引,所以其为非索引字段。例如,假设业务场景为:查询人员的页面上展示人员按照修改时间倒序排列,此时,如果需要新增一个人员进入系统。此时,倒序排列最主要的目的应该是添加了一个人员,添加成功后可以看见自己添加的人员信息,保证自己的添加是成功的。这时候,可以通过调用addPerson接口添加人员,当addPerson调用添加成功后,不再调用queryPerson进行查询,而是在修改前的记录上进行view model的修改,从而实现页面数据变更的效果。此时,查询接口中即使不使用order by也可以满足添加了一条记录成功后,在页面最前面显示自己的那条记录。当页面再次刷新(即,再次调用queryPerson接口时,刚才添加的记录或许不会在当前页面展示),但是无条件查询毕竟是模糊查询,如果需要精确查询刚才添加的记录,可以精确输入一些过滤条件进行查询,则可以直接获取得到刚才添加的记录。涉及count的优化由于count查询严重影响查询体验,所以可以考虑分情况讨论是否需要查询count。count一般用于前端分页展示选择页数,来进行分页选择查询。count查询的优化方案,将脚本查询接口的count输出改为可选输出,然后通过入参控制是否输出,如果需要输出再查询count,否则不返回count。对于页面上调用脚本的查询接口时,先试探查询传入start=5000,limit=5001,首次查询先通过入参控制不查询count并且携带其他查询条件,如果返回记录不为空,则表示满足条件的记录大于5000条。如果能查出一条记录则表示记录超过5000,则后续的正常分页查询也不查询count,只将分页查询的返回分页数据展示到页面上,页面也不展示count。页面也只可以翻页到0~5000的记录,5000以上的无法看。如果查不到记录(表示满足条件的数量少于5000)。则可以正常返回count,将返回的count用于前端分页的总记录数量,此时返回的分页数据亦可以正常展示,用法与普通的分页查询用法一致。
-
多表的left join / right join关联查询性能较低,可以考虑等价替换为join的SQL语句或者是用逗号分隔各个表,然后用where条件替代on条件作为关联条件的方式,关联查询多表(目前也推荐用逗号分隔,where条件替代on条件的方式进行多表内连接查询)。例如对于同时符合以下设定的场景下:如果A表为主表,B为从表。其中,出参包含AB两个表的数据,查询的条件可能来源于A,B表。A表有记录,B表未必有记录。B表的code字段与A表的主键id字段关联。各个查询条件之间是AND关系。那么,查询SQL语句最直观地会写为:select A.id, B.id from A left join B on A.id=B.code where ……但是这样的SQL语句在宽表引擎下并非性能最佳, 可以等价替换为如下:如果查询条件来源于A和B两表,并且查询条件都是AND逻辑拼接。可以改为:select A.id, B.id from A, B where A.id=B.code and ……如果查询条件只来源于A表,可改为使用以下的两条SQL:select A.id from A where ……将以上查询获取得到的A表的id传入到下列B表的SQL,查询获取B表的出参。select B.id from B where B.code=?如果查询条件只来源于B表,可以改为使用以下的两条SQL:Select B.id, B.code from B where ……将以上查询获取得到的B表的code传入到下列A表的SQL,查询获取A表的出参。select A.id from A where A.id=?
-
通过 Entity Framework Core 可以在使用关系数据库时下降到原始 SQL 查询。 所需查询不能使用 LINQ 来表示时,可以使用原始 SQL 查询。 如果使用 LINQ 查询导致 SQL 查询效率低下,也可以使用原始 SQL 查询。 原始 SQL 查询可返回一般实体类型或者模型中的无键实体类型。基本原生 SQL 查询可使用 FromSqlRaw 扩展方法基于原始 SQL 查询开始 LINQ 查询。 FromSqlRaw 只能在直接位于 DbSet<> 上的查询根上使用。var blogs = context.Blogs .FromSqlRaw("SELECT * FROM dbo.Blogs") .ToList();原生 SQL 查询可用于执行存储过程。var blogs = context.Blogs .FromSqlRaw("EXECUTE dbo.GetMostPopularBlogs") .ToList();
-
此页详细介绍了特定于 SQL Server 提供程序的索引配置选项。群集聚集索引根据数据行的键值在表或视图中排序和存储这些数据行。 为表创建适当的聚集索引可以显著提高查询的速度,因为数据已经按最佳顺序进行布局。 每个表只能有一个聚集索引,因为数据行本身只能按一个顺序存储。 有关详细信息,请参阅有关聚集索引和非聚集索引的 SQL Server 文档。默认情况下,表的主键列由聚集索引隐式支持,所有其他索引为非聚集索引。可以按如下所示配置要聚集的索引或键:protected override void OnModelCreating(ModelBuilder modelBuilder){ modelBuilder.Entity<Blog>().HasIndex(b => b.PublishedOn).IsClustered();}填充因子提供索引填充因子选项是为了优化索引数据存储和性能。 有关详细信息,请参阅有关填充因子的 SQL Server 文档。可按如下所示配置索引的填充因子:protected override void OnModelCreating(ModelBuilder modelBuilder){ modelBuilder.Entity<Blog>().HasIndex(b => b.PublishedOn).HasFillFactor(10);}联机创建ONLINE 选项允许在创建索引期间并发用户访问基础表或聚集索引数据以及任何关联的非聚集索引,以便用户可以继续更新和查询基础数据。 当脱机执行数据定义语言 (DDL) 操作(例如,生成或重新生成聚集索引)时,这些操作对基础数据和关联索引持有排他锁。 有关详细信息,请参阅有关 ONLINE 索引选项的 SQL Server 文档。可以使用 ONLINE 选项配置索引,如下所示:protected override void OnModelCreating(ModelBuilder modelBuilder){ modelBuilder.Entity<Blog>().HasIndex(b => b.PublishedOn).IsCreatedOnline();}
-
批处理EF Core 通过在一次往返中自动将所有更新批处理在一起,帮助最大限度地减少往返。 考虑以下情况:var blog = context.Blogs.Single(b => b.Url == "http://someblog.microsoft.com");blog.Url = "http://someotherblog.microsoft.com";context.Add(new Blog { Url = "http://newblog1.microsoft.com" });context.Add(new Blog { Url = "http://newblog2.microsoft.com" });context.SaveChanges();上述操作从数据库加载博客,更改其 URL,然后添加两个新博客;若要应用此更改,将两个 SQL INSERT 语句和一个 UPDATE 语句发送到数据库。 在添加 Blog 实例时,不要一个一个 SaveChanges 地发送它们,而是在EF Core跟踪这些更改,在调用 时在单个往返中执行这些更改。EF 在一次往返中批处理的语句数量取决于所使用的数据库提供程序。 例如,性能分析表明,当涉及的语句少于 4 个时,批处理对于 SQL Server 的效率通常较低。 同样,对于 SQL Server,批处理的优势在大约 40 条语句后会降低,因此 EF Core 默认在单个批处理中最多只执行 42 条语句,并在单独的往返中执行额外的语句。用户也可以调整这些阈值以获得潜在的更高性能,但是在修改这些阈值之前要仔细地进行基准测试:protected override void OnConfiguring(DbContextOptionsBuilder optionsBuilder){ optionsBuilder.UseSqlServer( @"Server=(localdb)\mssqllocaldb;Database=Blogging;Trusted_Connection=True", o => o .MinBatchSize(1) .MaxBatchSize(100));}批量更新假设你想给所有员工加薪。 EF Core 中对此的典型实现如下所示:foreach (var employee in context.Employees){ employee.Salary += 1000;}context.SaveChanges();虽然这是完全有效的代码,但是让我们从性能的角度来分析一下它的作用:执行一次数据库往返,以加载所有相关员工;请注意,这会将员工的所有行数据带到客户端(即使只需要工资数据)。EF Core 的更改跟踪在加载实体时创建快照,然后将这些快照与实例进行比较,找出哪些属性发生了更改。执行第二次数据库往返以保存所有更改。 虽然由于批处理,所有更改都在一次往返中完成,但 EF Core 仍会为每个员工发送一条 UPDATE 语句,该语句必须由数据库执行。关系数据库还支持批量更新,因此可将上述内容重写为以下单个 SQL 语句:UPDATE [Employees] SET [Salary] = [Salary] + 1000;这在单次往返中执行整个操作,而无需加载任何实际数据或将这些数据发送到数据库,也无需使用 EF 的更改跟踪机制(这会增加额外的开销)。遗憾的是,EF 目前不提供用于执行批量更新的 API。 在引入这些项之前,可使用原始 SQL 来执行性能敏感的操作:context.Database.ExecuteSqlRaw("UPDATE [Employees] SET [Salary] = [Salary] + 1000");
-
高效查询是一个庞大的主题,涵盖的主题就像索引、相关实体加载策略以及许多其他主题一样广泛。 本部分详细介绍了一些用于更快地进行查询的常见主题以及用户通常会遇到的隐患。正确使用索引查询能否快速运行的主要决定因素是它是否在恰当的位置使用索引:数据库通常用于保存大量数据,而遍历整个表的查询往往是严重性能问题的根源。 索引问题不容易发现,因为给定的查询是否会使用索引并不是显而易见的发现索引问题的一个好方法是:先准确定位慢速查询,然后通过数据库的常用工具检查其查询计划。有关如何执行此操作的详细信息,请参阅性能诊断页。 查询计划表明查询是遍历整个表,还是使用索引。一般来说,在使用索引或诊断索引相关性能问题方面没有任何特殊的 EF 知识;索引方面的一般数据库知识与 EF 应用程序之间以及它与非 EF 应用程序之间有着一样的相关度。 下面列出了在使用索引时要记住的一些一般准则:索引能加快查询,但也会减缓更新,因为它们需要保持最新状态。 避免定义不需要的索引,并考虑使用索引筛选器将索引限制为行的子集,从而减少此开销。复合索引可加速筛选多列的查询,也可加速不筛选所有索引列的查询,具体取决于排序。 例如,列 A 和列 B 上的索引加快按 A 和 B 筛选的查询以及仅按 A 筛选的查询,但不加快仅按 B 筛选的查询。如果查询按表达式筛选列(例如 price / 2),则不能使用简单索引。 但是,你可以为表达式定义存储的持久化列,并对该列创建索引。 一些数据库还支持表达式索引,可以直接使用这些索引加快按任何表达式筛选的查询。不同数据库允许以各种不同的方式配置索引,在许多情况下,EF Core 提供程序都通过 Fluent API 公开这些索引。 例如,你可以通过 SQL Server 提供程序配置索引是否为聚集索引,或设置其填充因子。 参阅提供程序文档了解详细信息。只投影需要的属性EF Core 能非常轻松地查询出实体实例,然后将它们用于代码中。 但是,查询实体实例可能会频繁从数据库中拉取回超出所需的数据。限制结果集大小查询默认返回与筛选器匹配的所有行:返回的行数取决于数据库中的实际数据,因此不可能知道将从数据库中加载的数据量、结果占用的内存量以及处理这些结果时(例如,通过网络将它们发送到用户浏览器)将额外生成的负载量。 非常重要的一点是,测试数据库往往包含少量数据,所以测试时一切正常,但当查询开始基于实际数据运行并且返回了许多行时,会突然出现性能问题。高效分页分页是指在页面中检索结果,而不是一次性检索结果;这通常针对大型结果集完成,其中显示用户界面,允许用户导航到结果的下一页或上一页。 使用数据库实现分页的一种常见方法是使用Skip和Take运算符 (OFFSET和LIMITSQL) ;虽然这是一种直观的实现,但它也相当低效。 对于允许一次移动一页的分页 (,而不是跳转到任意页面) ,请考虑改用 键集分页 。在加载相关实体时避免笛卡尔爆炸如果典型博客有多篇相关文章,这些文章对应的行会复制博客的信息。 这种复制会导致所谓的“笛卡尔爆炸”问题发生。 随着加载更多的一对多关系,重复的数据量可能会增长,并对应用程序性能产生负面影响。借助 EF,可通过使用“拆分查询”来避免这种影响,这种查询通过单独的查询加载相关实体。 有关详细信息,请阅读有关拆分查询和单个查询的文档。尽可能预先加载相关实体建议在继续本部分之前,先阅读相关实体专用页面。处理相关实体时,我们通常会提前知晓需要加载什么:典型的示例是加载一组特定的博客以及它们的所有文章。 在这些情况下,最好的做法始终是使用预先加载,这样 EF 可以在一次往返中提取所有必需的数据。 通过 EF Core 5.0 中引入的经过筛选的包含功能,你能限制要加载的相关实体,同时使加载过程保持为预先加载,从而可在一次往返中执行在其他情况下,在获得相关实体的主体实体之前,我们可能不知道需要哪些相关实体。 例如,加载某个博客时,我们可能需要参考另外一个数据源(可能是某个 Web 服务),以便了解我们是否对该博客文章感兴趣。 在这些情况下,可以使用显式或延迟加载单独提取相关实体,并填充博客文章导航。 请注意,这些方法都不是预先的,因此需要对数据库执行额外的往返,这是速度减缓的根源;根据具体的场景,比起执行额外的往返并有选择性地只获取需要的文章,始终只加载所有文章可能更高效。注意延迟加载延迟加载看上去像是一种非常有用的数据库逻辑编写方法,因为 EF Core 会在代码访问相关实体时,从数据库中自动加载这些实体。 这避免了加载不需要的相关实体(就像显式加载一样),而且似乎使程序员不必一起处理相关实体。 不过,延迟加载特别容易产生不必要的额外往返,从而降低应用程序的速度。缓冲和流式处理缓冲指将所有查询结果加载到内存中,而流式处理意味着 EF 每次向应用程序提供一个结果,绝不让内存中包含整个结果集。 原则上,流式处理查询的内存要求是固定的:无论查询返回 1 行还是 1000 行,内存要求都相同。另一方面,返回的行数越多,缓冲查询需要的内存越多。 对于产生大型结果集的查询,这可能是一个重要的性能因素。EF 执行的内部缓冲在某些情况下,无论如何计算查询,EF 都会在内部自行缓冲结果集。 出现这种情况的两个场景是:重试执行策略已准备就绪时。 这样做是为了确保在以后重试查询时返回相同的结果。使用拆分查询时,将缓冲除最后一个查询的所有其他查询的结果集 -除非 MARS (多个活动结果集) 在SQL Server上启用。 这是因为通常无法同时激活多个查询结果集。请注意,除通过 LINQ 运算符引发的任何缓冲外,还会发生这种内部缓冲。 例如,如果在 ToList 查询上使用并且重试执行策略已到位,则结果集将加载到内存 中两次:一次由 EF 在内部加载,再加载一次 ToList。跟踪、非跟踪和标识解析建议在继续本部分之前,先阅读关于跟踪和非跟踪的专用页面。EF 默认跟踪实体实例,以便在调用时 SaveChanges 检测并保留这些实例的更改。 跟踪查询的另一个作用是:EF 检测是否已为你的数据加载了实例,并将自动返回跟踪的实例,而不是返回新实例。我们将这种做法称为标识解析。 从性能的角度来看,更改跟踪意味着:EF 在内部维护跟踪实例的字典。 加载新数据时,EF 会查阅字典,以了解是否已为该实体的键跟踪了实例(标识解析)。 加载查询结果时,字典维护和查找会花费一些时间。在将加载的实例交给应用程序之前,EF 截取该实例的快照,并在内部保存该快照。 调用时 SaveChanges ,会将应用程序的实例与快照进行比较,以发现要保留的更改。 快照占用更多内存,截取快照的过程本身需要时间;有时可以通过值比较器指定不同的、可能更高效的快照截取行为,或使用更改跟踪代理完全绕过快照截取过程(虽然这种做法本身也有一些缺点)。在不将更改保存回数据库的只读场景中,可通过使用非跟踪查询来避免上述开销。 但非跟踪查询不执行标识解析,所以由多个其他已加载的行引用的数据库行将被具体化为不同的实例。为了说明这一点,假设我们要从数据库中加载大量文章以及每篇文章引用的博客。 如果碰巧有 100 篇文章引用了同一个博客,则跟踪查询通过标识解析来检测这种情况,并且所有文章实例都将引用同一个删除了重复数据的博客实例。 而无跟踪查询会将相同的博客重复 100 次,我们必须相应地编写应用程序代码。最后,可以在不产生更改跟踪开销的情况下执行更新,方法是:利用无跟踪查询,再将返回的实例附加到上下文中,同时指定要进行的更改。 这种做法将更改跟踪的负担从 EF 转移到用户,我们只应在更改跟踪开销已通过分析或基准测试显示为不可接受时尝试这么做。使用原始 SQL在某些情况下,你的查询存在更优化的 SQL,而 EF 不能生成这种 SQL。 如果 SQL 构造是特定于不受支持的数据库的扩展,或者 EF 不转换为该构造,可能会发生这种情况。 在这些情况下,手动编写 SQL 可以显著提高性能,而 EF 支持通过多种方法来实现此目的。直接在查询中使用原始SQL,例如通过 FromSqlRaw. 借助 EF,你甚至可以通过常规 LINQ 查询基于原始 SQL 进行撰写,从而能够在原始 SQL 中仅表达查询的一部分。 只需要将原始 SQL 用于代码库中的一个查询时,这种方法很不错。定义用户定义的函数 (UDF),然后从查询中调用它。 请注意,从 5.0 版开始,EF 允许 UDF 返回完整的结果集,这些 UDF 被称为表值函数 (TVF)。还允许将 DbSet 映射到函数,使其看起来像另一个表。在查询中定义一个数据库视图并从中进行查询。 请注意,与函数不同,视图不能接受参数。异步编程一般情况下,为了使应用程序可缩放,请务必始终使用异步 API 而不是同步一个 (,例如 SaveChangesAsync ,而不是 SaveChanges) 。 同步 API 在数据库输入/输出 (I/O) 期间阻止线程,增加了对线程的需要和必须发生的线程上下文切换的次数。
-
Entity Framework Core 使用语言集成查询 (LINQ) 来查询数据库中的数据。 通过 LINQ 可使用 C#(或你选择的其他 .NET 语言)编写强类型查询。 它使用你派生得到的上下文和实体类来引用数据库对象。 EF Core 将 LINQ 查询的表示形式传递给数据库提供程序。 反过来,数据库提供程序将其转换为数据库特定的查询语言(例如,用于关系数据库的 SQL)。 即使结果中返回的实体已存在于上下文中,也始终对数据库执行查询。作为一般规则,Entity Framework Core 会尝试尽可能全面地评估服务器上的查询。 EF Core 将查询的一部分转换为可在客户端评估的参数。 系统将查询的其余部分(及生成的参数)提供给数据库提供程序,以确定要在服务器上评估的等效数据库查询。 EF Core 支持在顶级投影中进行部分客户端评估(基本上为最后一次调用 Select())。 如果查询中的顶级投影无法转换为服务器,EF Core 将从服务器中提取任何所需的数据,并在客户端上评估查询的其余部分。 如果 EF Core 在顶级投影之外的任何位置检测到不能转换为服务器的表达式,则会引发运行时异常。 请参阅查询工作原理,了解 EF Core 如何确定哪些表达式无法转换为服务器。顶级投影中的客户端评估在下面的示例中,一个辅助方法用于标准化从 SQL Server 数据库中返回的博客的 URL。 由于 SQL Server 提供程序不了解此方法的实现方式,因此无法将其转换为 SQL。 查询的所有其余部分是在数据库中评估的,但通过此方法传递返回的 URL 却是在客户端上完成。不支持的客户端评估尽管客户端评估非常有用,但有时会减弱性能。 请看以下查询,其中的 where 筛选器现已使用辅助方法。 由于数据库中不能应用筛选器,因此需要将所有数据提取到内存中,以便在客户端上应用筛选器。 根据服务器上的筛选器和数据量,客户端评估可能会减弱性能。 因此 Entity Framework Core 会阻止此类客户端评估,并引发运行时异常显式客户端评估在某些情况下,可能需要以显式方式强制进行客户端评估,如下所示由于数据量小,因此在进行客户端评估时才不会大幅减弱性能。所用的 LINQ 运算符不会进行任何服务器端转换。在这种情况下,通过调用 AsEnumerable 或 ToList 等方法(若为异步,则调用 AsAsyncEnumerable 或 ToListAsync),以显式方式选择进行客户端评估。 使用 AsEnumerable 将对结果进行流式传输,但使用 ToList 将通过创建列表来进行缓冲,因此也会占用额外的内存。 但如果枚举多次,则将结果存储到列表中可以带来更大的帮助,因为只有一个对数据库的查询。 根据具体的使用情况,你应该评估哪种方法更适合。客户端评估中潜在的内存泄漏由于查询转换和编译的开销高昂,因此 EF Core 会缓存已编译的查询计划。 缓存的委托在对顶级投影进行客户端评估时可能会使用客户端代码。 EF Core 为树型结构中客户端评估的部分生成参数,并通过替换参数值重用查询计划。 但表达式树中的某些常数无法转换为参数。 如果缓存的委托包含此类常数,则无法将这些对象垃圾回收,因为它们仍被引用。 如果此类对象包含 DbContext 或其中的其他服务,则会导致应用的内存使用量逐渐增多。 此行为通常是内存泄漏的标志。 只要遇到的常数为不能使用当前数据库提供程序映射的类型,EF Core 就会引发异常。 常见原因及其解决方案如下所示:使用实例方法:在客户端投影中使用实例方法时,表达式树包含实例的常数。 如果你的方法不使用该实例中的任何数据,请考虑将该方法设为静态方法。 如果需要方法主体中的实例数据,则将特定数据作为实参传递给方法。将常数实参传递给方法:这种情况通常是由于在客户端方法的实参中使用 this 引起的。 请考虑将实参拆分为多个标量实参,可由数据库提供程序进行映射。其他常数:如果在任何其他情况下都出现常数,则可以评估在处理过程中是否需要该常数。 如果必须具有常数,或者如果无法使用上述情况中的解决方案,则创建本地变量来存储值,并在查询中使用局部变量。 EF Core 会将局部变量转换为形参。
-
本文分享自华为云社区《从零开发大数据SQL引擎》,作者:JavaEdge 。 学习大数据技术的核心原理,掌握一些高效的思考和思维方式,构建自己的技术知识体系。 明白了原理,有时甚至不需要学习,顺着原理就可以推导出各种实现细节。 各种知识表象看杂乱无章,若只是学习繁杂知识点,固然自己的知识面是有限的,并且遇到问题的应变能力也很难提高。所以有些高手看起来似乎无所不知,不论谈论起什么技术,都能头头是道,其实并不是他们学习、掌握了所有技术,而是他们是在谈到这个问题时,才开始进行推导,并迅速得出结论。 高手不一定要很资深、经验丰富,把握住技术的核心本质,掌握快速分析推导的能力,能迅速将自己的知识技能推到陌生领域,就是高手。 本系列专注大数据开发需要关注的问题及解决方案。跳出繁杂知识表象,掌握核心原理和思维方式,进而融会贯通各种技术,再通过各种实践训练,成为终极高手。 # 大数据仓库Hive 作为一个成功的大数据仓库,它将SQL语句转换成MapReduce执行过程,并把大数据应用的门槛下降到普通数据分析师和工程师就可以很快上手的地步。 但Hive也有问题,由于它使用自定义Hive QL,对熟悉Oracle等传统数据仓库的分析师有上手难度。特别是很多企业使用传统数据仓库进行数据分析已久,沉淀大量SQL语句,非常庞大也非常复杂。某银行的一条统计报表SQL足足两张A4纸,光是完全理解可能就要花很长时间,再转化成Hive QL更费力,还不说可能引入bug。 开发一款能支持标准数据库SQL的大数据仓库引擎,让那些在Oracle上运行良好的SQL可以直接运行在Hadoop上,而不需要重写成Hive QL。 # Hive处理过程 1. 将输入的Hive QL经过语法解析器转换成Hive抽象语法树(Hive AST) 2. 将Hive AST经过语义分析器转换成MapReduce执行计划 3. 将生成的MapReduce执行计划和Hive执行函数代码提交到Hadoop执行 可见,最简单的,对第一步改造即可。考虑替换Hive语法解析器:能将标准SQL转换成Hive语义分析器能处理的Hive抽象语法树,即红框代替黑框 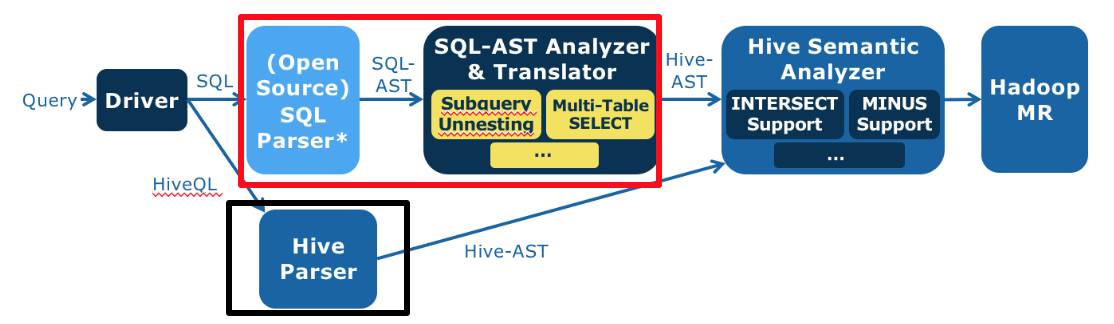 红框内:浅蓝色是个开源的SQL语法解析器,将标准SQL解析成标准SQL抽象语法树(SQL AST),后面深蓝色定制开发的SQL抽象语法树分析与转换器,将SQL AST转换成Hive AST。 那么关键问题就来了: # 标准SQL V.S Hive QL - 语法表达方式,Hive QL语法和标准SQL语法略有不同 - Hive QL支持的语法元素比标准SQL要少很多,比如,数据仓库领域主要的测试集TPC-H所有的SQL语句,Hive都不支持。尤其是Hive不支持复杂嵌套子查询,而数据仓库分析中嵌套子查询几乎无处不在。如下SQL,where条件existes里包含了另一条SQL: ```mysql select o_orderpriority, count(*) as order_count from orders where o_orderdate >= date '[DATE]' and o_orderdate date '[DATE]' + interval '3' month and exists (select * from lineitem where l_orderkey = o_orderkey and l_commitdate l_receiptdate) group by o_orderpriority order by o_orderpriority; ``` 开发支持标准SQL语法的SQL引擎难点,就是**消除复杂嵌套子查询掉**,即让where里不包含select。 SQL理论基础是关系代数,主要操作仅包括:并、差、积、选择、投影。而一个嵌套子查询可等价转换成一个连接(join)操作,如: ```mysql select s_grade from staff where s_city not in ( select p_city from proj where s_empname = p_pname ) ``` 这是个在where条件里嵌套了not in子查询的SQL语句,它可以用left outer join和left semi join进行等价转换,示例如下,这是Panthera自动转换完成得到的等价SQL。这条SQL语句不再包含嵌套子查询, ```mysql select panthera_10.panthera_1 as s_grade from (select panthera_1, panthera_4, panthera_6, s_empname, s_city from (select s_grade as panthera_1, s_city as panthera_4, s_empname as panthera_6, s_empname as s_empname, s_city as s_city from staff) panthera_14 left outer join (select panthera_16.panthera_7 as panthera_7, panthera_16.panthera_8 as panthera_8, panthera_16.panthera_9 as panthera_9, panthera_16.panthera_12 as panthera_12, panthera_16.panthera_13 as panthera_13 from (select panthera_0.panthera_1 as panthera_7, panthera_0.panthera_4 as panthera_8, panthera_0.panthera_6 as panthera_9, panthera_0.s_empname as panthera_12, panthera_0.s_city as panthera_13 from (select s_grade as panthera_1, s_city as panthera_4, s_empname as panthera_6, s_empname, s_city from staff) panthera_0 left semi join (select p_city as panthera_3, p_pname as panthera_5 from proj) panthera_2 on (panthera_0.panthera_4 = panthera_2.panthera_3) and (panthera_0.panthera_6 = panthera_2.panthera_5) where true) panthera_16 group by panthera_16.panthera_7, panthera_16.panthera_8, panthera_16.panthera_9, panthera_16.panthera_12, panthera_16.panthera_13) panthera_15 on ((((panthera_14.panthera_1 => panthera_15.panthera_7) and (panthera_14.panthera_4 => panthera_15.panthera_8)) and (panthera_14.panthera_6 => panthera_15.panthera_9)) and (panthera_14.s_empname => panthera_15.panthera_12)) and (panthera_14.s_city => panthera_15.panthera_13) where ((((panthera_15.panthera_7 is null) and (panthera_15.panthera_8 is null)) and (panthera_15.panthera_9 is null)) and (panthera_15.panthera_12 is null)) and (panthera_15.panthera_13 is null)) panthera_10 ; ``` 通过可视化工具将上面两条SQL的语法树展示出来,是这样的。  这是原始的SQL抽象语法树。  这是等价转换后的抽象语法树,内容太多被压缩的无法看清,不过你可以感受一下(笑)。 那么,在程序设计上如何实现这样复杂的语法转换呢?当时Panthera项目组合使用了几种经典的设计模式,每个语法点被封装到一个类里去处理,每个类通常不过几十行代码,这样整个程序非常简单、清爽。如果在测试过程中遇到不支持的语法点,只需为这个语法点新增加一个类即可,团队协作与代码维护非常容易。 使用装饰模式的语法等价转换类的构造,Panthera每增加一种新的语法转换能力,只需要开发一个新的Transformer类,然后添加到下面的构造函数代码里即可。 private static SqlASTTransformer tf = new RedundantSelectGroupItemTransformer( new DistinctTransformer( new GroupElementNormalizeTransformer( new PrepareQueryInfoTransformer( new OrderByTransformer( new OrderByFunctionTransformer( new MinusIntersectTransformer( new PrepareQueryInfoTransformer( new UnionTransformer( new Leftsemi2LeftJoinTransformer( new CountAsteriskPositionTransformer( new FilterInwardTransformer( //use leftJoin method to handle not exists for correlated new CrossJoinTransformer( new PrepareQueryInfoTransformer( new SubQUnnestTransformer( new PrepareFilterBlockTransformer( new PrepareQueryInfoTransformer( new TopLevelUnionTransformer( new FilterBlockAdjustTransformer( new PrepareFilterBlockTransformer( new ExpandAsteriskTransformer( new PrepareQueryInfoTransformer( new CrossJoinTransformer( new PrepareQueryInfoTransformer( new ConditionStructTransformer( new MultipleTableSelectTransformer( new WhereConditionOptimizationTransformer( new PrepareQueryInfoTransformer( new InTransformer( new TopLevelUnionTransformer( new MinusIntersectTransformer( new NaturalJoinTransformer( new OrderByNotInSelectListTransformer( new RowNumTransformer( new BetweenTransformer( new UsingTransformer( new SchemaDotTableTransformer( new NothingTransformer()))))))))))))))))))))))))))))))))))))); 而在具体的Transformer类中,则使用组合模式对抽象语法树AST进行遍历,以下为Between语法节点的遍历。我们看到使用组合模式进行树的遍历不需要用递归算法,因为递归的特性已经隐藏在树的结构里面了。 @Override protected void transform(CommonTree tree, TranslateContext context) throws SqlXlateException { tf.transformAST(tree, context); trans(tree, context); } void trans(CommonTree tree, TranslateContext context) { // deep firstly for (int i = 0; i tree.getChildCount(); i++) { trans((CommonTree) (tree.getChild(i)), context); } if (tree.getType() == PantheraExpParser.SQL92_RESERVED_BETWEEN) { transBetween(false, tree, context); } if (tree.getType() == PantheraExpParser.NOT_BETWEEN) { transBetween(true, tree, context); } } 将等价转换后的抽象语法树AST再进一步转换成Hive格式的抽象语法树,就可以交给Hive的语义分析器去处理了,从而也就实现了对标准SQL的支持。 当时Facebook为证明Hive对数据仓库的支持,手工将TPC-H的测试SQL转换成Hive QL,将这些手工Hive QL和Panthera进行对比测试,两者性能各有所长,总体上不相上下,说明Panthera自动进行语法分析和转换的效率还行。 Panthera(ASE)和Facebook手工Hive QL对比测试:  标准SQL语法集的语法点很多,007进行各种关系代数等价变形,也不可能适配所有标准SQL语法。 # SQL注入 常见的Web攻击手段,如下图所示,攻击者在HTTP请求中注入恶意SQL命令(drop table users;),服务器用请求参数构造数据库SQL命令时,恶意SQL被一起构造,并在数据库中执行。  但JDBC的PrepareStatement可阻止SQL注入攻击,MyBatis之类的ORM框架也可以阻止SQL注入,请从数据库引擎的工作机制解释PrepareStatement和MyBatis的防注入攻击的原理。
-
 本章节介绍如何在MariaDB中管理用户和访问权限。在数据库操作中,也是基础使用,必须学会。个人简介:大家好,我是 金鱼哥,CSDN运维领域新星创作者,华为云·云享专家个人资质:CCNA、HCNP、CSNA(网络分析师),软考初级、中级网络工程师、RHCSA、RHCE、RHCA、RHCI、ITIL格言:努力不一定成功,但要想成功就必须努力1. 在MariaDB中创建用户帐号默认情况下,MariaDB将其用户及其密码与本地系统的用户和密码分开。这意味着MariaDB数据库用户与服务器的Linux用户不同,即使用户帐户具有相同的名称,默认情况下,密码将分别跟踪。为了控制用户对数据库服务器的访问级别,必须在MariaDB中设置数据库用户,并授予他们对服务器及其数据执行操作的权限。可以使用MariaDB pam身份验证插件将系统用户帐户和密码集成为MariaDB数据库用户,本课程不涉及该配置。在大多数情况下,最好在数据库服务器上分别管理对数据库服务的访问和对shell提示符的访问创建新用户需要具备以下其中一个权限级别:MariaDB root用户。是一个被授予全局CREATE user权限的用户。是一个被授予mysql数据库的INSERT权限的用户。CREATE USER语句在mysql数据库的user表中创建一条新记录。这个用户没有特权。用户名指定为user_name@host_name。这使得可以创建具有相同名称、但根据源主机(即用户所连接的主机)具有不同特权的多个用户帐户。MariaDB [(none)]> CREATE USER mobius@localhost IDENTIFIED BY ‘redhat’ ;该帐户可以用来连接的用户名/主机名。该帐号的密码。注意:如果没有提供主机名,用户可从任何主机获得访问权限。目前,mobius帐户只能从本地主机连接,密码为redhat。密码在用户表中加密:MariaDB [mysql]> SELECT host,user,password FROM user WHERE user = 'mobius'; +-----------+--------+-------------------------------------------+ | host | user | password | +-----------+--------+-------------------------------------------+ | localhost | mobius | *84BB5DF4823DA319BBF86C99624479A198E6EEE9 | +-----------+--------+-------------------------------------------+ 1 row in set (0.00 sec)账户定义示例账户描述mobius用户mobius可以从任何主机连接。mobius@’%'用户mobius可以从任何主机连接。mobius@'localhost’用户mobius只能从Localhost连接。mobius@'192.168.1.5’用户mobius只能通过IP地址192.168.1.5进行连接。mobius@'192.168.1.%'用户mobius可以从属于该网络192.168.1.0/24的任何地址进行连接。mobius@'2001:db8:18:b51:c32:a21’用户mobius只能通过IP地址2001:db8:18:b51:C32: a21进行连接。2. 控制用户权限默认情况下,新帐户被授予最低权限。在不授予额外特权的情况下,mobius用户可以访问最小的帐户信息,但大多数其他操作都被拒绝。# 在下面的例子中,允许访问: [user@host ~]$ mysql -u mobius -p Enter password: redhat MariaDB [(none)]> SELECT USER(); +------------------+ | user() | +------------------+ | mobius@localhost | +------------------+ 1 row in set (0.000 sec) MariaDB [(none)]> SHOW DATABASES; +--------------------+ | Database | +--------------------+ | information_schema | +--------------------+ 1 row in set (0.000 sec) # 在下一个例子中,用户验证了身份,但是访问被拒绝了: [user@host ~]$ mysql -u mobius -p Enter password: redhat ...output omitted... MariaDB [(none)]> USE mysql; ERROR 1044 (42000): Access denied for user 'mobius'@'localhost' to database 'mysql' MariaDB [(none)]> CREATE DATABASE inventory; ERROR 1044 (42000): Access denied for user 'mobius'@'localhost' to database 'inventory'权限是用户在MariaDB中拥有的权限。它们决定了用户可以做什么,以及用户可以在MariaDB中看到什么。特权是按其详细范围组织的。全局权限(例如CREATE USER)用于管理MariaDB数据库服务器本身。数据库特权(如CREATE Database)用于在MariaDB服务器上创建数据库和使用数据库。表特权(比如CRUD命令)用于在特定数据库中创建表和操作数据。列特权用于授予类似于表的命令使用,但是在特定的列上(通常很少)。其他更细粒度的特权将在本节末尾引用的MariaDB文档中详细讨论。授予用户权限GRANT语句可用于向帐户授予权限。要授予权限,连接的用户必须具有GRANT OPTION,并且必须具有正在授予的GRANT OPTION权限。例如,mobius用户不能授予数据库表上的SELECT权限,除非他们已经拥有SELECT权限和grant OPTION表权限。# 在这个示例中,MariaDB根用户将CRUD权限授予inventory数据库中类别表上的mobius用户。 [user@host ~]$ mysql -u root -p Enter password: redhat ...output omitted... MariaDB [(none)]> USE inventory; ...output omitted... Database changed MariaDB [(inventory)]> GRANT SELECT, UPDATE, DELETE, INSERT -> ON inventory.category -> TO mobius@localhost ; Query OK, 0 rows affected (0.00 sec) MariaDB [(inventory)]> exit Bye # 然后你可以确认mobius用户的权限如下: [user@host ~]$ mysql -u mobius -p Enter password: redhat MariaDB [(none)]> USE inventory; MariaDB [(inventory)]> SELECT * FROM category; +----+------------+ | id | name | +----+------------+ | 1 | Networking | | 2 | Servers | | 3 | Ssd | +----+------------+ 3 rows in set (0.00 sec)GRANT操作的例子Grant描述GRANT SELECT ON database.table TO username@hostname将特定数据库中特定表的SELECT权限授予特定用户。GRANT SELECT ON database.* TO username@hostname将特定数据库中所有表的SELECT权限授予特定用户。GRANT SELECT ON *.* TO username@hostname将所有数据库中所有表的SELECT权限授予特定用户。GRANT CREATE, ALTER, DROP ON database.* to username@hostname将特定数据库中的CREATE、ALTER、DROP TABLES权限授予特定用户。GRANT ALL PRIVILEGES ON *.* to username@hostname将所有数据库的所有可用权限授予特定用户,有效地创建了一个超级用户,类似于root。撤销用户权限REVOKE语句从帐户中删除特权。连接的用户必须具有GRANT OPTION权限,并且具有正在被撤销的权限以撤销权限。MariaDB [(none)]> REVOKE SELECT, UPDATE, DELETE, INSERT-> ON inventory.category FROM mobius@localhost ;Query OK, 0 rows affected (0.00 sec)**重要:**在修改授权表之后运行FLUSH PRIVILEGES命令是一个好习惯。虽然MariaDB会注意到一些语句并自动加载,但是大多数撤销特权的语句都需要用FLUSH PRIVILEGES重新加载特权表才能生效。MariaDB [(none)]> FLUSH PRIVILEGES;显示用户权限可以验证哪些特权被授予给了用户。SHOW GRANTS FOR username; 提供了该用户的权限列表:MariaDB [(none)]> SHOW GRANTS FOR root@localhost; +---------------------------------------------------------------------+ | Grants for root@localhost | +---------------------------------------------------------------------+ | GRANT ALL PRIVILEGES ON *.* TO 'root'@'localhost' WITH GRANT OPTION | | GRANT PROXY ON ''@'' TO 'root'@'localhost' WITH GRANT OPTION | +---------------------------------------------------------------------+ 2 rows in set (0.00 sec)3. 删除用户帐号当您不再需要一个特定的用户帐户时,可以使用DROP USER从数据库中删除它。username应该使用与CREATE USER相同的’user’@'host’格式。MariaDB [(none)]> DROP USER mobius;Query OK, 0 rows affected (0.002 sec)重要:如果当前连接的帐户被删除,该帐户将直到连接关闭后才会被删除。如果该用户有一个活动的连接,当帐户被删除时,它不会自动关闭。4. 数据库访问的故障诊断下表总结了用户在身份验证和访问方面可能遇到的一些问题以及可能的原因。一些常见的数据库访问问题问题解决方案用户已被授予从任何主机连接的访问权限,但只能在数据库服务器上使用shell中的mysql命令进行连接。如果在/etc/my.cnf.d/mariadb-server.cnf中设置了skip-networking,请删除该指令并重新启动服务。用户可以连接localhost上的任何应用程序,但不能远程连接。确保/etc/my.cnf.d/mariadb-server.cnf中的bind-address配置是正确的, 确保可以访问数据库。确保user表中包含用户试图连接的主机的用户条目。用户可以连接,但不能看到除information_schema之外的任何数据库。确保用户已被授予访问其数据库的特权。当用户刚刚创建时,这是一个常见的问题,因为默认情况下创建的用户帐户具有最小的权限。该用户可以连接,但不能创建任何数据库。考虑为用户授予全局CREATE特权(这也授予DROP特权)。用户可以连接,但不能读写任何数据。为用户打算使用的数据库授予CRUD特权。5. 课本练习[student@workstation ~]$ lab database-users start创建用户与授权[student@servera ~]$ mysql -u root -p Enter password: redhat MariaDB [(none)]> CREATE USER john@localhost identified by 'john_password'; Query OK, 0 rows affected (0.000 sec) MariaDB [(none)]> CREATE USER steve@'%' identified by 'steve_password'; Query OK, 0 rows affected (0.000 sec) MariaDB [(none)]> GRANT INSERT, UPDATE, DELETE,SELECT on inventory.* to john@localhost; Query OK, 0 rows affected (0.000 sc) MariaDB [(none)]> GRANT SELECT on inventory.* to steve@'%'; Query OK, 0 rows affected (0.000 sec) MariaDB [(none)]> FLUSH PRIVILEGES; Query OK, 0 rows affected (0.000 sec) MariaDB [(none)]> exit Bye验证[student@servera ~]$ mysql -u john -p Enter password: john_password MariaDB [(none)]> MariaDB [(none)]> USE inventory; Database changed MariaDB [(inventory)]> SELECT * FROM category; +----+------------+ | id | name | +----+------------+ | 1 | Networking | | 2 | Servers | | 3 | Ssd | +----+------------+ 3 rows in set (0.00 sec) MariaDB [(inventory)]> INSERT INTO category(name) VALUES('Memory'); Query OK, 1 row affected (0.00 sec) MariaDB [(inventory)]> UPDATE category SET name='Solid State Drive' WHERE id = 3; Query OK, 1 row affected (0.01 sec) Rows matched: 1 Changed: 1 Warnings: 0 MariaDB [(inventory)]> SELECT * FROM category; +----+-------------------+ | id | name | +----+-------------------+ | 1 | Networking | | 2 | Servers | | 3 | Solid State Drive | | 5 | Memory | +----+-------------------+ 4 rows in set (0.000 sec) MariaDB [(inventory)]> DELETE FROM category WHERE name LIKE 'Memory'; Query OK, 1 row affected (0.01 sec) MariaDB [(inventory)]> exit Bye [student@serverb ~]$ mysql -u steve -h servera -p Enter password: steve_password MariaDB [(none)]> USE inventory; Database changed MariaDB [(inventory)]> SELECT * FROM category; +----+-------------------+ | id | name | +----+-------------------+ | 1 | Networking | | 2 | Servers | | 3 | Solid State Drive | +----+-------------------+ 3 rows in set (0.00 sec) MariaDB [(inventory)]> INSERT INTO category(name) VALUES('Memory'); ERROR 1142 (42000): INSERT command denied to user 'steve'@'serverb.example.com'for table 'category' MariaDB [(inventory)]> exit Bye完成实验[student@workstation ~]$ lab database-users finish总结介绍如何在MariaDB中创建账户。介绍如何管理MariaDB账户。介绍数据库访问的故障诊断。RHCA认证需要经历5门的学习与考试,还是需要花不少时间去学习与备考的,好好加油,可以噶。以上就是【金鱼哥】对 第七章 配置MariaDB SQL数据库–管理MariaDB用户和访问权限 的简述和讲解。希望能对看到此文章的小伙伴有所帮助。红帽认证专栏系列:RHCSA专栏:戏说 RHCSA 认证RHCE专栏:戏说 RHCE 认证此文章收录在RHCA专栏:RHCA 回忆录如果这篇【文章】有帮助到你,希望可以给【金鱼哥】点个赞,创作不易,相比官方的陈述,我更喜欢用【通俗易懂】的文笔去讲解每一个知识点。如果有对【运维技术】感兴趣,也欢迎关注❤️❤️❤️ 【金鱼哥】❤️❤️❤️,我将会给你带来巨大的【收获与惊喜】!链接:https://bbs.huaweicloud.com/blogs/351174
-
本章节介绍如何在MariaDB中创建和恢复备份。在数据库操作中,是非常重要的一个内容,必须学会。个人简介:大家好,我是 金鱼哥,CSDN运维领域新星创作者,华为云·云享专家个人资质:CCNA、HCNP、CSNA(网络分析师),软考初级、中级网络工程师、RHCSA、RHCE、RHCA、RHCI、ITIL格言:努力不一定成功,但要想成功就必须努力1. 创建MariaDB数据库备份有两种方式备份MariaDB:逻辑备份,将信息导出为文本文件,其中包含重建数据库所需的SQL命令。物理备份,它复制包含数据库内容的原始数据库目录和文件。每种备份都有其优缺点。逻辑备份特点通过查询数据库来检索数据库结构。逻辑备份具有高度可移植性,在某些情况下可以恢复到另一个数据库提供者(如PostgreSQL)。备份比较慢,因为服务器必须访问数据库信息并将其转换为逻辑格式。在服务器在线时执行。备份不包括日志或配置文件。物理备份特点由数据库目录和文件夹的原始副本组成。输出更紧凑。备份可以包括日志和配置文件。只能移植到其他具有类似硬件和软件的机器上。比逻辑备份更快。应在服务器脱机时执行,或在数据库中的所有表都被锁定时执行,以防止在备份期间发生更改。2. 执行逻辑备份使用mysqldump命令执行逻辑备份:[root@host ~]# mysqldump -u root -p inventory > /backup/inventory.dump 选择要备份的数据库 ------ 输出的备份文件注意:要在逻辑上备份所有数据库,请使用–all-databases选项:[root@host ~]# mysqldump -u root -p --all-databases > /backup/mariadb.dump这种类型的备份包括mysql数据库,其中包括所有user信息。逻辑备份的输出是一系列SQL语句。作为一个例子,下面是一个mysql数据库的转储代码片段:LOCK TABLES `user` WRITE; /*!40000 ALTER TABLE `user` DISABLE KEYS */; INSERT INTO `user` VALUES ('localhost','root','','Y','Y','Y','Y','Y','Y','Y','Y' ,'N','N','N','N','N','N','N','N','','','','',0,0,0,0,'',''),('localhost.localdomai n','','','N','N','N','N','N','N','N','N','N','N','N','N','N','N','N','N','N','N' ,'N','N','N','N','N','N','N','N','N','N','N','','','','',0,0,0,0,'',''),('localh ost','mobius','*84BB5DF4823DA319BBF86C99624479A198E6EEE9','N','N','N','N','N','N ','N','N','N','N','N','N','N','N','N','N','N','N','N','N','N','N','N','N','N','N ','N','N','N','','','','',0,0,0,0,'',''); /*!40000 ALTER TABLE `user` ENABLE KEYS */; UNLOCK TABLES;注意,mobius的加密密码很容易看到,所以要注意这种备份的存储。在逻辑备份期间,当从各个表中读取它们时,将对它们进行锁定和解锁。重要:运行mysqldump时连接的MariaDB用户必须有足够的权限查看数据库服务器上的数据库。当运行mysqldump时,连接的MariaDB用户至少需要SELECT权限用于转储表,SHOW VIEW权限用于转储视图,TRIGGER权限用于转储触发器。逻辑备份的有用选项选项描述--add-drop-table在每个CREATE TABLE语句之前添加一个DROP TABLE语句。--no-data只转储数据库结构,不转储内容。--lock-all-tables在复制完成之前,不能在数据库的任何位置插入新记录。这个选项对于确保备份完整性非常重要。--add-drop-database在每个CREATE DATABASE语句之前添加一个DROP DATABASE语句。3. 执行物理备份mariabackup工具是由AppStream存储库中的mariadb-backup包提供的。mariabackup工具对MariaDB服务器执行完全物理在线备份。确保安装了mariadb-backup包(安装mariadb-server包时默认安装):[root@host ~]# yum install mariadb-backup创建存放备份文件的目标目录。如果是全量备份,则目标目录必须为空。[root@host ~]# mkdir -p /var/mariadb/backup/执行备份:[root@host ~]# mariabackup --backup --target-dir /var/mariadb/backup/ --user root --password redhat [00] 2020-06-08 21:13:15 >> log scanned up to (1721365) [00] 2020-06-08 21:13:15 Executing UNLOCK TABLES [00] 2020-06-08 21:13:15 All tables unlocked [00] 2020-06-08 21:13:15 Copying ib_buffer_pool to /var/mariadb/backup/ ib_buffer_pool [00] 2020-06-08 21:13:15 ...done [00] 2020-06-08 21:13:15 Backup created in directory '/var/mariadb/backup/' [00] 2020-06-08 21:13:15 Writing backup-my.cnf [00] 2020-06-08 21:13:15 ...done [00] 2020-06-08 21:13:15 Writing xtrabackup_info [00] 2020-06-08 21:13:15 ...done [00] 2020-06-08 21:13:15 Redo log (from LSN 1721356 to 1721365) was copied. [00] 2020-06-08 21:13:15 completed OK! # 确认备份目录内容: [root@host ~]# ls -F /var/mariadb/backup/ aria_log.00000001 ib_buffer_pool inventory/ xtrabackup_checkpoints aria_log_control ibdata1 mysql/ xtrabackup_info backup-my.cnf ib_logfile0 performance_schema/注意:在命令行上会公开用户名和密码,另一种替代方法是在/etc/my.cnf.d目录中创建一个凭据文件,以存储执行备份的用户的身份验证信息。[root@host ~]# cat /etc/my.cnf.d/mariabackup.cnf [xtrabackup] user=root password=redhat使用MariaDB根用户执行备份的替代方法是在MariaDB中创建一个具有RELOAD、LOCK TABLES和REPLICATION CLIENT特权的用户。4. 恢复备份在还原备份时,它会用备份的内容覆盖数据库服务器的内容。如果数据库中的数据比备份中的数据更新,则会丢失数据。恢复逻辑备份使用mysql命令从备份文件执行逻辑恢复:[root@host ~]# mysql -u root -p inventory < /backup/mariadb.dump 选择要恢复的数据库 ----- 备份文件恢复物理备份使用mariabackup工具与以下选项之一执行从备份的物理恢复:--copy-back 保留原有备份文件。--move-back 将备份文件移动到数据目录下,然后删除原有的备份文件。# 确保mariadb服务已停止: [root@host ~]# systemctl stop mariadb # 确定数据目录的位置,并确保它为空: [root@host ~]# grep '^datadir' /etc/my.cnf.d/mariadb-server.cnf datadir=/var/lib/mysql [root@host ~]# rm -rf /var/lib/mysql/* # 使用mariabackup恢复备份文件: [root@host ~]# mariabackup --copy-back --target-dir=/var/mariadb/backup/ ..... [00] 2020-06-08 22:26:08 completed OK! # 确保数据文件的用户和组所有权设置为mysql: [root@host ~]# chown -R mysql:mysql /var/lib/mysql/ # 启动mariadb服务: [root@host ~]# systemctl start mariadb5. 课本练习[student@workstation ~]$ lab database-backups start明确库与表的内容[student@servera ~]$ mysql -u root -p Enter password: redhat MariaDB [(none)]> USE inventory; MariaDB [inventory]> SELECT * FROM product; +----+-------------------+---------+-------+-------------+-----------------+ | id | name | price | stock | id_category | id_manufacturer | +----+-------------------+---------+-------+-------------+-----------------+ | 1 | ThinkServer TS140 | 539.88 | 20 | 2 | 4 | | 2 | ThinkServer RD630 | 2379.14 | 20 | 2 | 4 | | 3 | RT-AC68U | 219.99 | 10 | 1 | 3 | | 4 | X110 64GB | 73.84 | 100 | 3 | 1 | +----+-------------------+---------+-------+-------------+-----------------+ 4 rows in set (0.000 sec) MariaDB [inventory]> exit Bye备份[student@servera ~]$ mysqldump -u root -p inventory > inventory-backup.sql Enter password: redhat [student@servera ~]$删除表里内容[student@servera ~]$ mysql -u root -p Enter password: redhat MariaDB [(none)]> USE inventory; MariaDB [(inventory)]> DELETE FROM product WHERE id=1; Query OK, 1 row affected (0.005 sec) MariaDB [inventory]> SELECT * FROM product; +----+-------------------+---------+-------+-------------+-----------------+ | id | name | price | stock | id_category | id_manufacturer | +----+-------------------+---------+-------+-------------+-----------------+ | 2 | ThinkServer RD630 | 2379.14 | 20 | 2 | 4 | | 3 | RT-AC68U | 219.99 | 10 | 1 | 3 | | 4 | X110 64GB | 73.84 | 100 | 3 | 1 | +----+-------------------+---------+-------+-------------+-----------------+ 3 rows in set (0.000 sec) MariaDB [inventory]> exit Bye恢复[student@servera ~]$ mysql -u root -p inventory < inventory-backup.sql Enter password: redhat查询并验证[student@servera ~]$ mysql -u root -p Enter password: redhat MariaDB [(none)]> USE inventory; Query OK, 1 row affected (0.005 sec) MariaDB [inventory]> SELECT * FROM product; +----+-------------------+---------+-------+-------------+-----------------+ | id | name | price | stock | id_category | id_manufacturer | +----+-------------------+---------+-------+-------------+-----------------+ | 1 | ThinkServer TS140 | 539.88 | 20 | 2 | 4 | | 2 | ThinkServer RD630 | 2379.14 | 20 | 2 | 4 | | 3 | RT-AC68U | 219.99 | 10 | 1 | 3 | | 4 | X110 64GB | 73.84 | 100 | 3 | 1 | +----+-------------------+---------+-------+-------------+-----------------+ 4 rows in set (0.000 sec) MariaDB [inventory]> exit Bye完成实验[student@workstation ~]$ lab database-backups finish总结介绍逻辑备份和物理备份。介绍如何在MariaDB中创建数据库备份,包括逻辑备份和物理备份。介绍如何在MariaDB恢复备份。RHCA认证需要经历5门的学习与考试,还是需要花不少时间去学习与备考的,好好加油,可以噶。以上就是【金鱼哥】对 第七章 配置MariaDB SQL数据库–创建和恢复MariaDB备份 的简述和讲解。希望能对看到此文章的小伙伴有所帮助。红帽认证专栏系列:RHCSA专栏:戏说 RHCSA 认证RHCE专栏:戏说 RHCE 认证此文章收录在RHCA专栏:RHCA 回忆录如果这篇【文章】有帮助到你,希望可以给【金鱼哥】点个赞,创作不易,相比官方的陈述,我更喜欢用【通俗易懂】的文笔去讲解每一个知识点。如果有对【运维技术】感兴趣,也欢迎关注❤️❤️❤️ 【金鱼哥】❤️❤️❤️,我将会给你带来巨大的【收获与惊喜】!connect:https://bbs.huaweicloud.com/blogs/351175
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签