-
 如果启动前不对linux内核做任何更改,那么redis启动会报出警告,共三个:如下图所示第一个警告:The TCP backlog setting of 511 cannot be enforced because /proc/sys/net/core/somaxconn is set to the lower value of 128.意思是:TCP backlog设置值,511没有成功,因为 /proc/sys/net/core/somaxconn这个设置的是更小的128.临时解决方法:(即下次启动还需要修改此值)echo 511 > /proc/sys/net/core/somaxconn永久解决方法:(即以后启动还需要修改此值)将其写入/etc/rc.local文件中。baklog参数实际控制的是已经3次握手成功的还在accept queue的大小。参考linux里的backlog详解 第二个警告:overcommit_memory is set to 0! Background save may fail under low memory condition. To fix this issue add 'vm.overcommit_memory = 1' to/etc/sysctl.conf and then reboot or run the command 'sysctl vm.overcommit_memory=1' for this to take effect.意思是:overcommit_memory参数设置为0!在内存不足的情况下,后台程序save可能失败。建议在文件 /etc/sysctl.conf 中将overcommit_memory修改为1。临时解决方法:echo "vm.overcommit_memory=1" > /etc/sysctl.conf永久解决方法:将其写入/etc/sysctl.conf文件中。参考:有关linux下redis overcommit_memory的问题 第三个警告:you have Transparent Huge Pages (THP) support enabled in your kernel. This will create latency and memory usage issues with Redis. To fix thisissue run the command 'echo never > /sys/kernel/mm/transparent_hugepage/enabled' as root, and add it to your /etc/rc.local in order to retain thesetting after a reboot. Redis must be restarted after THP is disabled.意思是:你使用的是透明大页,可能导致redis延迟和内存使用问题。执行 echo never > /sys/kernel/mm/transparent_hugepage/enabled 修复该问题。临时解决方法:echo never > /sys/kernel/mm/transparent_hugepage/enabled。永久解决方法:将其写入/etc/rc.local文件中。参考透明大页介绍 。到此这篇关于解决Redis启动警告问题的文章就介绍到这了转载自https://www.jb51.net/article/238574.htm
-
 最基础的概念,什么是幂等性?幂等性:提交多次的情况下,结果都一样。比如数据库查询,可称为天然幂等性,即查询多次结果都一样,无需人为去做幂等性操作。但是update table set value=value+1 where id=1,每次执行的结构都会发生变化,不是幂等。inter into table(id,name)values(1,‘name’),如id不是主键或者没有唯一索引,重复操作上面的业务,会插入多条数据,不具备幂等性;所以我们在什么情景下需要确保幂等性呢?用户多次点击保存按钮用户保存成功后,返回上一页再次保存微服务相互调用,由于网络原因,导致请求失败解决方案一、token机制:1、根据业务场景,判断哪些业务存在幂等性问题,在执行业务之前先获取token,将token缓存止redis中2、调用业务接口时,将token携带过去,一般放在请求头,作为Auth认证3、服务器判断token是否存在于redis中,存在表示第一次请求,然后删除token,继续执行业务4、如果不存在,则表示反复操作,不执行业务逻辑,直接返回重复标志!结束风险性:业务执行前删除还是后删除token?如果是执行后删除,在业务执行中,未删除token,用户又点了请求进来,那么则无法保障幂等性。如果是执行前删除,在分布式下,用户快速请求2次,这时2个请求同时到redis去获取token,对比成功,同时删除,同时执行业务,那么也无法保障幂等性。so:使用执行前删除,在分布式情况下,获取,对比,删除必须确保原子性,所以要加分布式锁。二、加锁1、数据库锁select * from table where … for update2、业务层面加分布式锁将获取、对比、删除作为一个原子性的操作加锁,处理完成后释放锁,确保串行操作。三、约束数据库唯一约束:通过主键、唯一索引,确保无法重复新增同一笔数据,这就能确保幂等性
-
 >摘要:随着业务需求的发展和功能的复杂度提升,往往反馈到研发设计和实现,就不那么简单了,怎么办呢?本文分享自华为云社区《[给面试加点硬菜:延迟任务场景,该如何提高吞吐量和时效性!](https://bbs.huaweicloud.com/blogs/330938?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content)》,作者: 小傅哥。 # 一、延迟任务场景 什么是延迟任务? 当我们的实际业务需求场景中,有一些活动开始前的状态变更、订单结算后的T+1对账、贷款单息费的产生,都是需要使用到延迟任务来进行触达。实际的操作一般会有 Quartz、Schedule 来对你的库表数据进行定时扫描和处理,当条件满足后做数据状态的变更或者产生新的数据插入到表中。 这样一个简单的需求就是延迟任务最初需求,如果需求前期内容较少、使用方不多,可能在实际开发中就只是一个单台机器直接对着表一顿轮训就完事了。但随着业务需求的发展和功能的复杂度提升,往往反馈到研发设计和实现,就不那么简单了,比如:你需要保障尽可能低延迟完成较大规模的数据量扫描处理,否则就像贷款单息费的产生,已经到了第二天用户还没看到自己的息费信息或者是还款后的重新对账,可能就这个时候就要产生客诉了。 那么,类似这样的场景该如何设计呢? # 二、延迟任务设计 通常的任务中心处理流程主要,主要是由定时任务扫描任务库表,把即将达到超时时间的任务信息扫描到处理队列(内存/MQ消息),再由业务系统进行处理任务,处理完成后更新库表中的任务状态。 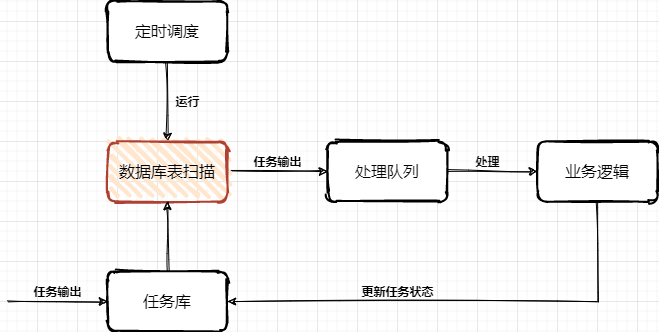 问题: 1. 海量数据规模较大的任务列表数据,在分库分表下该需要快速扫描。 2. 任务扫描服务与业务逻辑处理,耦合在一起,不具有通用性和复用性。 3. 细分任务体系有些是需要低延迟处理的,不能等待过长时间。 ## 1. 任务表方式 除了一些较小的状态变更场景,例如在各自业务的库表中,就包含了一个状态字段,这个字段一方面有程序逻辑处理变更的状态,也有到达指定到期时间后由任务服务自动变更处理的操作,一般这类功能,直接设计到自己的库表中即可。 那么还有一些较大也较为频繁使用的场景,如果都是在每个系统的各自所需的N多个表中,都添加这样的字段进行维护,就显得非常冗余了,也不那么易于维护。所以针对这样的场景就很适合做一个通用的任务延时系统,各业务系统把需要被延时执行的动作提交到延时系统中,再有延时系统在指定时间下进行回调,回调的动作可以是接口或者MQ消息进行触达。例如可以设计这样一个任务调度表: 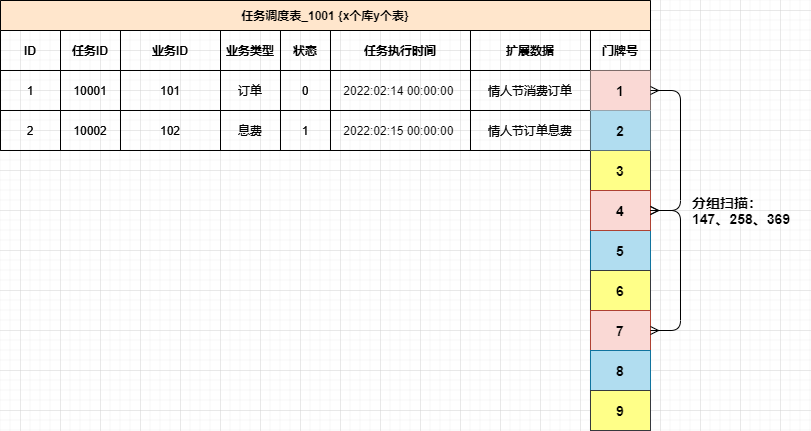 1. 抽取的任务调度表,主要是拿到什么任务,在什么时间发起动作,具体的动作处理仍交给业务工程处理。 2. 大批量的各自业务的任务进行集中处理,则需要设计一个分库分表,满足于后续业务体量的增长。 3. 门牌号设计,针对一张表的扫描,如果数据量较大,又不希望只是一个任务扫描一个表,可以多个任务扫描一个表,加到扫描的体量。这个时候就需要一个门牌号来隔离不同任务扫描的范围,避免扫描出重复的任务数据。 ## 2. 低延迟方式 低延迟处理方案,是在任务表方式的基础上,新增加的时间把控处理。它可以把即将到期的前一段时间的任务,放置到 Redis 集群队里中,在消费的时候再从队列中 pop 出来,这样可以更快的接近任务的处理时效,避免因为扫库间隔较大延迟任务执行。 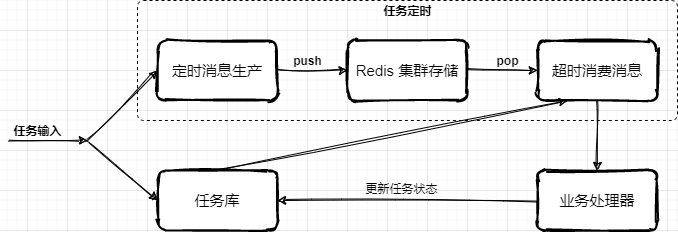 - 在接收业务系统提交进来的延迟任务时,按照执行时间的长短放置到任务库或者也同步到 Redis 集群中,一些执行时间较晚的任务则可以先放到任务库,再通过扫描的方式添加到超时任务执行队列中。 - 那么关于这块的设计核心在于 Redis 队列的使用,以及为了保证消费的可靠性需要引入二阶段消费、注册 ZK 注册中心至少保证一次消费的处理。本文重点主要放在 Redis 队列的设计,其他更多的逻辑处理,可以按照业务需求进行扩展和完善 # Redis 消费队列 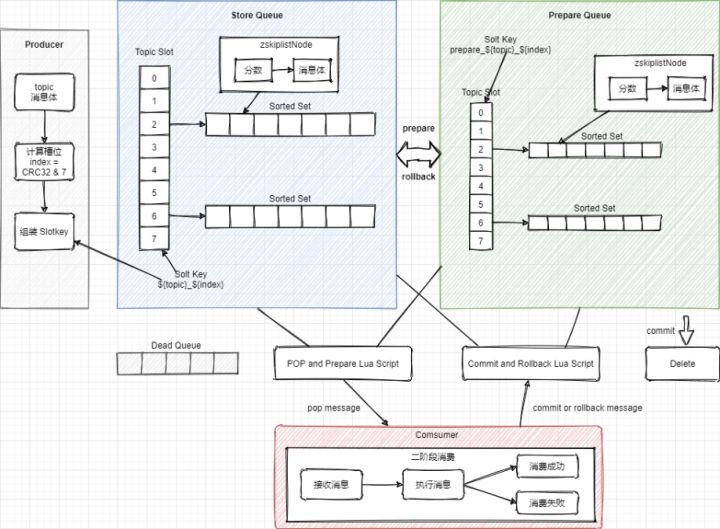 - 按照消息体计算对应数据所属的槽位 index = CRC32 & 7 - StoreQueue 采用 Slot 按照 SlotKey = #{topic}_#{index} 和 Sorted Set 的数据结构按执行任务分数排序,存放任务执行信息。定时消息将时间戳作为分数,消费时每次弹出分数小于当前时间戳的一个消息 - 为了保障每条消息至少可消费一次,消费者不是直接 pop 有序集合中的元素,而是将元素从 StoreQueue 移动到 PrepareQueue 并返回消息给消费者。消费成功后再从 PrepareQueue 从删除,如果消费失败则从PreapreQueue 重新移动到 StoreQueue,这样二阶段消费的方式进行处理。 ## 简单案例 @Test public void test_delay_queue() throws InterruptedException { RBlockingQueue blockingQueue = redissonClient.getBlockingQueue("TASK"); RDelayedQueue delayedQueue = redissonClient.getDelayedQueue(blockingQueue); new Thread(() -> { try { while (true){ Object take = blockingQueue.take(); System.out.println(take); Thread.sleep(10); } } catch (InterruptedException e) { e.printStackTrace(); } }).start(); int i = 0; while (true){ delayedQueue.offerAsync("测试" + ++i, 100L, TimeUnit.MILLISECONDS); Thread.sleep(1000L); } } ## 测试数据 2022-02-13 WARN 204760 --- [ Finalizer] i.l.c.resource.DefaultClientResources : io.lettuce.core.resource.DefaultClientResources was not shut down properly, shutdown() was not called before it's garbage-collected. Call shutdown() or shutdown(long,long,TimeUnit) 测试1 测试2 测试3 测试4 测试5 Process finished with exit code -1 - 源码:GitHub - fuzhengwei/TimeOutCenter: TimeOutCenter - 描述:使用 redisson 中的 DelayedQueue 作为消息队列,写入后等待消费时间进行 POP 消费。 # 三、总结 - 调度任务的使用在实际的场景中非常频繁,例如我们经常使用 xxl-job,也有一些大厂自研的分布式任务调度组件,这些可能原本都是很小很简单的功能,但经过抽象、整合、提炼,变成了一个个核心通用的中间件服务。 - 当我们在考虑使用任务调度的时候,无论哪种方式的设计和实现,都需要考虑这个功能使用时候的以为迭代和维护性,如果仅仅是一个非常小的场景,又没多少人使用的话,那么在自己机器上折腾就可以。过渡的设计和使用有时候也会把研发资源代入泥潭 - 其实各项技术的知识点,都像是一个个工具,刀枪棍棒斧钺钩,那能怎么结合各自的特点,把这些兵器用起来,才是一个程序员不断成长的过程。
-
 摘要:如何通过springboot来集成操作Redis。本文分享自华为云社区《SpringBoot连接Redis操作教程》,作者: 灰小猿。今天来和大家分享一个如何通过springboot来集成操作Redis。一、SpringBoot连接Redisspringboot连接Redis时需要在pom文件中导入所需的jar包依赖,依赖如下: <!-- 加入jedis依赖 --> <dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> <version>2.9.0</version> </dependency> (1)使用Jedis类直接连接Redis服务器在springboot环境下连接redis的方法有很多,首先最简单的就是直接通过jedis类来连接,jedis类就相当于是redis的客户端表示。连接方法如下: /** * redis连接测试01 */ @Test public void redisTest01() { //连接本地的 Redis 服务 Jedis jedis = new Jedis("localhost"); // 如果 Redis 服务设置了密码,需要用下面这行代码输入密码 // jedis.auth("123456"); System.out.println("连接成功"); //查看服务是否运行 System.out.println("服务正在运行: "+jedis.ping()); }运行后结果:通过这种方式进行连接时,springboot会自动的去本地寻找redis服务器进行连接,如果没有找到那么就会报错,如果你去阅读jedis的底层源码,你会发现Jedis类有多种构造方法,常用的几个是使用默认地址和端口//不传值,那么使用默认的127.0.0.1地址,6379端口就访问 public Jedis()使用指定地址和默认端口//只传入目的地址,那么使用指定的地址和默认的端口号去访问 public Jedis(String host)使用指定地址和端口//传入目的地址和端口号,那么使用指定的地址和端口号去访问 public Jedis(String host, int port)(2)通过配置文件进行连接在springboot中,当然是可以通过配置文件的形式来设置各种连接参数了,Redis也是一样的,在yml文件中进行如下配置:注意:这是没有使用连接池的,如果使用连接池,需要在下边增加配置,关于使用连接池的可以继续往下看。##redis配置信息 spring: redis: database: 0 #redis数据库索引,默认为0 host: 127.0.0.1 #redis服务器地址 port: 6379 #redis服务器连接端口 password: #redis服务器连接密码,默认为null timeout: 5000 #redis连接超时时间通过配置文件来进行配置之后,我们就可以使用springboot中的一个工具类来操作Redis的操作了,springboot会自动读取配置文件中的配置信息,然后通过该配置信息去连接Redis服务器,springboot中提供操作Redis的工具类有两个,分别是:StringRedisTemplate和RedisTemplate,StringRedisTemplate和RedisTemplate的区别如下在进行序列化时,RedisTemplate使用的是 JdkSerializationRedisSerializer,而StringRedisTemplate使用的是StringRedisSerializerStringRedisTemplate继承了RedisTemplate<String,String>,而RedisTemplate 定义为 RedisTemplate<K, V>,所有StringRedisTemplate就限定了K,V为String类型的相同处体现在他们对Redis的操作上,RedisTemplate和StringRedisSerializer都定义了五种对Redis的操作,分别对应这Redis中的五种数据类型。redisTemplate.opsForValue(); //操作字符串 redisTemplate.opsForHash(); //操作hash redisTemplate.opsForList(); //操作list redisTemplate.opsForSet(); //操作set redisTemplate.opsForZSet(); //操作有序set那么在使用的时候,这两个类应该如何选择呢?如果你的redis数据库里面本来存的是字符串数据,或者你要存取的数据就是字符串类型数据的时候,那么你就使用StringRedisTemplate即可,》但是如果你的数据是复杂的对象类型,而取出的时候又不想做任何的数据转换,直接从Redis里面取出一个对象,那么使用RedisTemplate是更好的选择。接下来我以StringRedisSerializer为例子,来给大家演示一下使用StringRedisSerializer操作Redis的方法, /** * springboot主从连接测试, * 使用springRedisTemplate操作 */ @Test public void redisTest06() { // 操作字符型 stringRedisTemplate.opsForValue().set("test06","Test06"); System.out.println(stringRedisTemplate.opsForValue().get("test06")); // 设置key的过期时间,30秒 stringRedisTemplate.expire("test06", 30 * 1000, TimeUnit.MILLISECONDS); // 根据key获取过期时间 Long test06ExpireTime = stringRedisTemplate.getExpire("test06"); System.out.println("根据key获取过期时间:" + test06ExpireTime); // 根据key获取过期时间,并且换算成指定单位 Long test06ExpireTimeToUnit = stringRedisTemplate.getExpire("test06", TimeUnit.SECONDS); System.out.println("根据key获取过期时间,并且换算成指定单位:" + test06ExpireTimeToUnit); // 检查key是否存在,返回布尔类型 Boolean test06IsExist = stringRedisTemplate.hasKey("test06"); System.out.println("检查key是否存在,返回布尔类型:" + test06IsExist); }在上面的操作中,有一点关于获取和设置key过期时间的操作,当时在操作的时候对其进行了一下探究,在这里分享给大家stringRedisTemplate中获取过期时间的getExpire()方法的说明如果最开始没有设置过期时间,那么就返回-1,数据在没有达到Redis数据最大限额的情况下会一直存在.如果设置了过期时间,但是数据还未过期,就返回剩余时间,如果到了过期时间,那么数据会被删除如果数据被删除或者不存在,那么就返回-2.
-
>摘要:9月8日,华为云GuassDB(for Redis)正式推出全新版本。新版本内核带来性能提升、无损升级、慢日志统计等多维度产品体验,同时推出Lua脚本和SSL连接加密两大重要功能,让业务设计更加灵活,公网访问更安全。本文分享自华为云社区《[华为云GuassDB(for Redis)发布全新版本,两大核心特性正式亮相](https://bbs.huaweicloud.com/forum/thread-153489-1-1.html?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=database&utm_content=content)》,作者:GaussDB 数据库。 9月8日,华为云GuassDB(for Redis)正式推出全新版本。新版本内核带来性能提升、无损升级、慢日志统计等多维度产品体验,同时推出Lua脚本和SSL连接加密两大重要功能,让业务设计更加灵活,公网访问更安全。  GaussDB(for Redis)是华为云推出的企业级分布式KV数据库,它完全兼容Redis协议,提供丰富的数据类型,同时基于云原生存储计算分离架构,在成本、可靠性等方面为企业带来全新价值,此番推出的两大功能特性更是为企业业务发展带来全新体验。 # Lua脚本功能:业务设计更灵活 GaussDB(for Redis)推出的Lua脚本功能,支持用户预设逻辑,组合执行多条命令,让业务设计更加灵活。使用方法上,GaussDB(for Redis)的Lua脚本功能与开源Redis保持完全兼容。用户可以将一组命令编入Lua脚本,交给GaussDB(for Redis)执行,从而实现原子操作的效果。 相比开源Redis Cluster,GaussDB(for Redis)的Lua脚本功能更为优秀: - **脚本执行不易引发请求阻塞**:这是由于GaussDB(for Redis)实例内部有着更细粒度的数据分片,同时每个分片都有多线程执行命令的能力。 - **消除“脚本复制”的副作用**:开源Redis主从脚本复制让时间模块、随机命令等功能受限,GaussDB(for Redis)内核采用全新实现,并无此类限制,业务设计更轻松。 - **强一致保障**:在高并发场景,GaussDB(for Redis)提供数据强一致保障,业务多点访问不会发生脏读。 根据以往经验,Lua脚本在一些业务场景起着关键作用,例如:**订单系统**要求用户余额不出现负数,库存系统要避免商品超卖……它们都需要使用Lua脚本来确保“查询+扣减”的原子性语义。GaussDB(for Redis)将Lua脚本与强一致特性结合,给业务设计带来极大灵活性。 # SSL连接加密功能:公网访问更安全 GaussDB(for Redis)提供的SSL连接加密功能,支持客户端使用SSL协议连接数据库,提升公网访问安全性。用户只需从华为云控制台下载证书,并使用支持SSL协议的客户端(例如Redis-cli 6.0),即可与实例建立安全可靠连接。 通过控制台,用户还可以随时开启或禁用SSL连接模式。当连接模式发生切换,旧连接会被断开以确保实例网络安全。  相比开源Redis 6.0 SSL,GaussDB(for Redis)保持兼容并带来以下优势: - **性能更好**:开启SSL后的性能损失更小,约15%;而开源Redis损失更多。 - **多线程完美兼容**:开启SSL不影响多线程并发能力,而开源Redis的SSL与多线程存在二选一冲突。 在一些场景中,业务有从公网甚至海外访问数据库的需求。此时,对于核心数据存储,全链路的安全保障尤为重要,新版GaussDB(for Redis)能够极大提升公网访问安全性。 # GuassDB(for Redis)核心价值 作为云原生KV数据库,GaussDB(for Redis)有着全面领先于开源Redis的能力: - **成本降低75%以上**:全量数据落盘,容量利用率高 - **高稳定性**:即使N-1节点故障,全量数据依旧可用 - **高可靠性**:数据三副本冗余存储,无丢失风险 - **强一致性**:强一致性保障,多点访问无脏读问题 - **强抗写能力**:全部节点可写,多线程设计 - **强扩展能力**:节点分钟级、容量秒级扩容 目前GaussDB(for Redis)已经凭借出色的产品实力在游戏系统、电商平台、推荐系统、社交媒体、物联网等众多企业级应用场景中发挥巨大作用。新推出的Lua脚本和SSL连接加密两大功能特性,更是为企业数字化转型注入了全新动力。想体验更多产品能力,[欢迎前往华为云官网](https://www.huaweicloud.com/product/gaussdbforredis.html)。
-
 一、背景 即时通讯(Instant Messaging,简称IM)是一个实时通信系统,允许两人或多人使用网络实时的传递文字消息、文件、语音与视频。微信、QQ等IM类产品在这个高度信息化的互联网时代已成为生活必备品,IM系统中最核心的部分是消息系统,消息系统中最核心的功能是消息的同步、存储和检索。消息同步:将消息完整的、快速的从发送方发送至接收方。消息同步系统最重要的衡量指标是消息传递的实时性、完整性、顺序性以及支撑的消息规模。消息存储:即消息的持久化,传统消息系统通常支持消息在接收端的本地存储,数据基本不具备可靠性。现代消息系统支持消息在云端存储,从而实现消息异地查询:账号可在任意客户端登陆查看所有历史消息。消息检索:消息一般是文本,所以支持全文检索也是必备的能力之一。传统消息系统通常来说基于本地存储的消息数据来构建索引,支持消息的本地检索。而现代消息系统支持消息的在线存储以及存储过程中构建索引,提供全面的消息检索功能。二、IM系统架构设计 上图为IM系统的应用场景,可用于聊天,游戏、智能客服等诸多行业。不同行业对IM系统的成本、性能、可靠性、时延等指标的需求是不同的,架构设计需要进行平衡。接下来将介绍IM系统架构设计所涉及到的一些基本概念。2.1 传统架构 vs 现代架构 传统架构先同步后存储。在线消息同步和离线消息缓存。服务端不会对消息进行持久化,无法支持消息异地查询。现代架构先存储后同步。划分消息存储库与消息同步库。消息存储库用于全量保存所有会话消息,主要用于支持消息异地查询。消息同步库,主要用于接收方的多端同步。提供消息全文检索能力。2.2 读扩散vs 写扩散 《2020微信数据报告》指出,截至2020年9月,微信月活跃用户数为10.825亿,日消息发送次数450亿次,日音视频呼叫成功次数4.1亿次。面临这么多的消息,如何保证消息传递的可靠性、一致性并且有效的降低服务器或者客户端的压力是十分具有技术挑战的。其中,采用何种读写模型对IM系统至关重要,这里介绍两种模型:读扩散和写扩散。 如上图所示,用户B与每个聊天的人(A1,A2,A3)都有一个信箱(一种数据结构的抽象,用于存储消息),B在查看聊天信息时需读取所有有新消息的信箱。IM系统里的读扩散通常是每两个相关联的人就有一个信箱。读扩散的优点:写操作(发消息)轻量,不管是单聊还是群聊,只需要往相应的信箱写一次即可。每一个信箱天然就是两个人的聊天记录,可以方便查看和搜索聊天记录。读扩散的缺点:读操作(读消息)很重,存在读放大效应。如上图,在写扩散中,用户(B1,B2,B3)都只从自己的信箱里读取消息,但写(发消息)的时候,对于单聊跟群聊处理如下:单聊:往自己的信箱跟对方的信箱都写一份消息;同时,如果需要查看两个人的聊天历史记录的话还需要再写一份。群聊:发信息时需要针对所有群成员的信箱都写一份消息。群聊使用的是写扩散模型,而写扩散很消耗资源,因此微信群有人数上限(目前是500)。写扩散优点:读操作很轻量,只需要读取自己的邮箱。可以很方便实现消息的多终端同步。写扩散缺点:写操作很重,尤其是对于群聊来说。2.3 推模式 vs 拉模式 vs 推拉结合模式 在IM系统中,消息的获取通常有三种模式:推模式(Push):新消息到达时由服务器主动推送给所有客户端;需要客户端和服务器建立长连接,实时性很高,对客户端来说只需要接收处理消息即可;缺点是服务端不知道客户端处理消息的能力,可能会导致数据积压。拉模式(Pull):由前端主动发起拉取消息的请求,为了保证消息的实时性,一般采用推模式,拉模式一般用于获取历史消息;因客户端拉取新消息的时间间隔不好预设,太短可能会导致大量的连接拉取不到数据,太长导致数据接收不及时。推拉结合模式:兼顾push和pull两种模式的优点。新消息来临时服务器会先推送一个新消息到达的通知给前端,前端接收到通知后就向服务器拉取消息。三、IM技术挑战 上图为IM系统的总体架构图,Client双方通信会经过Server转发来完成消息传递。其核心为消息存储库和消息同步库。这两种库对存储层的性能有极高的要求。支撑海量数据存储:对于消息存储库来说,如果需要消息永久存储,则随着时间的积累,数据规模会越来越大,需存储库支持容量无限扩展以应对日益增长的消息数据。低存储成本:消息数据具有明显的冷热特征,大部分查询集中在热数据,冷数据需要一个低成本的存储方式,否则随着时间的积累,数据量不断膨胀,存储成本会不断上升。数据生命周期管理:不管是对于消息数据的存储还是同步,数据都需要定义生命周期。存储库是用于在线存储消息数据本身,通常需要设定一个较长周期的保存时间。而同步库 是用于写扩散模式的在线或离线推送,通常设定一个较短的保存时间。极高的写入吞吐:绝大部分IM类场景,通常是采用写扩散模型,写扩散要求底层存储具备极高的写入吞吐能力,从而应对消息洪峰。低延迟的读:消息系统通常应用于在线场景,具备较高的实时性,读取延迟应尽可能低。四、高斯Redis在IM场景中的优势 IM系统的核心是存储层,其性能差异将直接影响IM系统的用户体验。目前存储层可选择的数据库产品有很多,如HBase、开源Redis等等。选择何种数据库,需根据业务规模、成本、性能等指标来进行综合选择。这里介绍一种NoSQL数据库:高斯Redis,在性能和规模上,可以满足IM系统对存储层的严格要求:海量数据存储、低存储成本、生命周期管理、写入吞吐大、读取时延低。4.1高斯Redis简介 高斯Redis是华为云数据库团队自主研发且兼容Redis5.0协议的云原生数据库,采用计算存储分离架构。存储侧使用自研的存储系统,容量无限扩展、强一致、高可靠。计算侧基于 LSM 存储引擎实现,通过将大量的随机写转换为顺序写,从而极大的提升了数据写入性能,同时也通过读缓存、bloom filter 等极大优化了读取性能。下图是高斯Redis在IM场景的优势介绍。4.2基于高斯Redis的IM应用案例: 下图是基于高斯Redis的IM系统模型图,这里我们使用stream作为基本数据结构。Redis stream不仅可以作为消息存储容器,还实现了生产者、消费者等基本模型,具有IM系统的基本功能,如消息订阅,分发、增加消费者等,用户可基于高斯Redis快速构建一套IM系统。创建一个群聊时,在Redis中对应地为该群聊创建一个stream队列。在发送消息时,每个用户都将消息按照时间顺序添加到stream队列中,保证了消息的有序性。stream是一个持久化的队列,可保证信息不丢失。五、总结 高斯Redis通过一系列技术创新实现了读写性能水平扩展,秒级扩容,低成本以及自动备份等功能, 可作为IM系统的存储层,其优异的读写性能和高级特性将会极大助力IM应用.同时,高斯Redis在开源Redis的基础之上,较好平衡了性能和成本,能够广泛应用在智慧医疗、流量削峰、计数器等领域。六、结束本文作者:华为云高斯Redis团队。杭州西安深圳简历投递:yuwenlong4@huawei.com更多技术文章,关注高斯Redis官方博客:https://bbs.huaweicloud.com/community/usersnew/id_1614151726110813七、参考资料1. 《GaussDB(for Redis)官方主页》https://www.huaweicloud.com/product/gaussdbforredis.html2. 《华为云GaussDB(for Redis)与自建开源Redis的成本对比》https://www.modb.pro/db/427393. 《华为云PB级数据库GaussDB(for Redis)揭秘第一期:Redis与存算分离》https://bbs.huaweicloud.com/blogs/2385844. 《华为云PB级数据库GaussDB(for Redis)揭秘第三期:一场由fork引发的超时,让我们重新探讨了Redis的抖动问题》https://bbs.huaweicloud.com/blogs/2456515. 《现代 IM 系统中的消息系统架构—架构篇》https://www.infoq.cn/article/ypb3y2lv-dsftrr5cguv
-
>摘要:我是一个Redis服务,最引以为傲的就是我的速度,我的 QPS 能达到10万级别。本文分享自华为云社区《[Redis:我是如何与客户端进行通信的](https://bbs.huaweicloud.com/blogs/327076?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content)》,作者: 码农参上 。 江湖上说,**天下武功,无坚不摧,唯快不破**,这句话简直是为我量身定制。 我是一个Redis服务,最引以为傲的就是我的速度,我的 QPS 能达到10万级别。 在我的手下有数不清的小弟,他们会时不时到我这来存放或者取走一些数据,我管他们叫做客户端,还给他们起了英文名叫 Redis-client。 有时候一个小弟会来的非常频繁,有时候一堆小弟会同时过来,但是,即使再多的小弟我也能管理的井井有条。 有一天,小弟们问我。  想当年,为了不让小弟们拖垮我傲人的速度,在设计和他们的通信协议时,我绞尽脑汁,制定了下面的三条原则: - 实现简单 - 针对计算机来说,解析速度快 - 针对人类来说,可读性强 为什么这么设计呢?先来看看一条指令发出的过程,首先在客户端需要对指令操作进行封装,使用网络进行传输,最后在服务端进行相应的解析、执行。 这一过程如果设计成一种非常复杂的协议,那么封装、解析、传输的过程都将非常耗时,无疑会降低我的速度。什么,你问我为什么要遵循最后一条规则?算是对于程序员们的馈赠吧,我真是太善良了。 我把创造出来的这种协议称为 RESP (REdis Serialization Protocol)协议,它工作在 TCP 协议的上层,作为我和客户端之间进行通讯的标准形式。 说到这,我已经有点迫不及待想让你们看看我设计出来的杰作了,但我好歹也是个大哥,得摆点架子,不能我主动拿来给你们看。 所以我建议你直接使用客户端发出一条向服务器的命令,然后取出这条命令对应的报文来直观的看一下。话虽如此,不过我已经被封装的很严实了,正常情况下你是看不到我内部进行通讯的具体报文的,所以,你可以伪装成一个Redis的服务端,来截获小弟们发给我的消息。 实现起来也很简单,我和小弟之间是基于 Socket 进行通讯,所以在本地先启动一个ServerSocket,用来监听Redis服务的6379端口: public static void server() throws IOException { ServerSocket serverSocket = new ServerSocket(6379); Socket socket = serverSocket.accept(); byte[] bytes = new byte[1024]; InputStream input = socket.getInputStream(); while(input.read(bytes)!=0){ System.out.println(new String(bytes)); } } 然后启动redis-cli客户端,发送一条命令: `set key1 value1` 这时,伪装的服务端就会收到报文了,在控制台打印了: *3 $3 set $4 key1 $6 value1 看到这里,隐隐约约看到了刚才输入的几个关键字,但是还有一些其他的字符,要怎么解释呢,是时候让我对协议报文中的格式进行一下揭秘了。 我对小弟们说了,对大哥说话的时候得按规矩来,这样吧,你们在请求的时候要遵循下面的规则: *参数数量> CRLF $参数1的字节长度> CRLF 参数1的数据> CRLF $参数2的字节长度> CRLF 参数2的数据> CRLF ... $参数N的字节长度> CRLF 参数N的数据> CRLF 首先解释一下每行末尾的CRLF,转换成程序语言就是\r\n,也就是回车加换行。看到这里,你也就能够明白为什么控制台打印出的指令是竖向排列了吧。 在命令的解析过程中,set、key1、value1会被认为是3个参数,因此参数数量为3,对应第一行的*3。 第一个参数set,长度为3对应$3;第二个参数key1,长度为4对应$4;第三个参数value1,长度为6对应$6。在每个参数长度的下一行对应真正的参数数据。 看到这,一条指令被转换为协议报文的过程是不是就很好理解了? 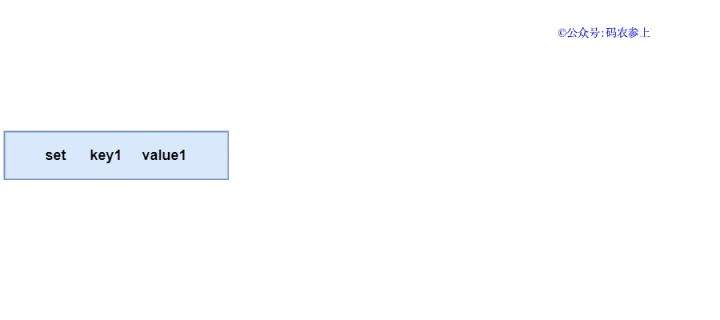 当小弟对我发送完请求后,作为大哥,我就要对小弟的请求进行**指令回复**了,而且我得根据回复内容进行一下分类,要不然小弟该搞不清我的指示了。 # 简单字符串 简单字符串回复只有一行回复,回复的内容以+作为开头,不允许换行,并以\r\n结束。有很多指令在执行成功后只会回复一个OK,使用的就是这种格式,能够有效的将传输、解析的开销降到最低。 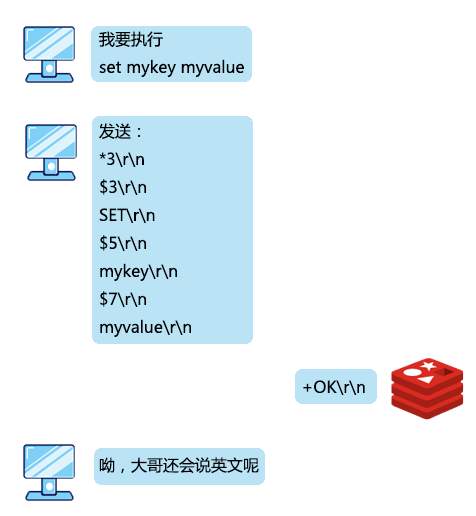 # 错误回复 在RESP协议中,错误回复可以当做简单字符串回复的变种形式,它们之间的格式也非常类似,区别只有第一个字符是以-作为开头,错误回复的内容通常是错误类型及对错误描述的字符串。 错误回复出现在一些异常的场景,例如当发送了错误的指令、操作数的数量不对时,都会进行错误回复。在客户端收到错误回复后,会将它与简单字符串回复进行区分,视为异常。 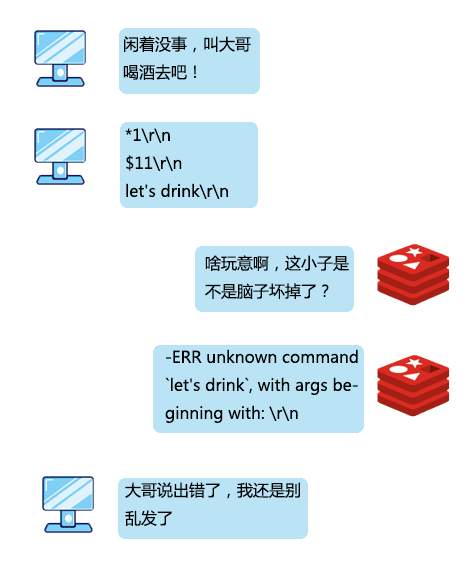 # 整数回复 整数回复的应用也非常广泛,它以:作为开头,以\r\n结束,用于返回一个整数。例如当执行incr后返回自增后的值,执行llen返回数组的长度,或者使用exists命令返回的0或1作为判断一个key是否存在的依据,这些都使用了整数回复。 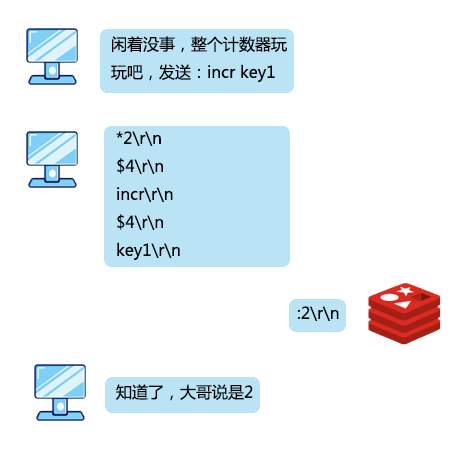 # 批量回复 批量回复,就是多行字符串的回复。它以$作为开头,后面是发送的字节长度,然后是\r\n,然后发送实际的数据,最终以\r\n结束。如果要回复的数据不存在,那么回复长度为-1。 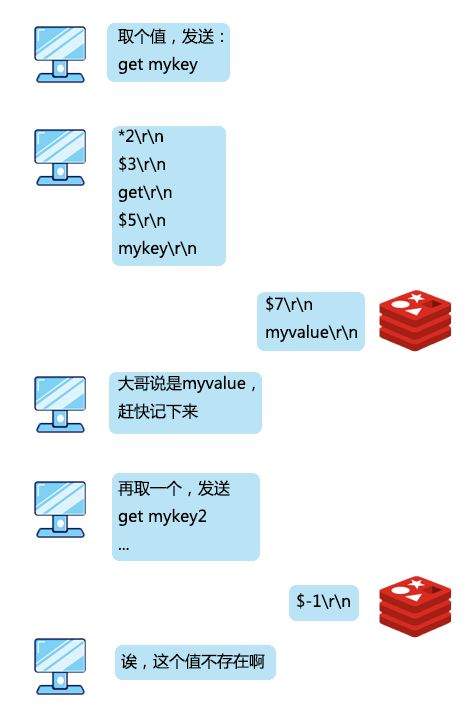 # 多条批量回复 当服务端要返回多个值时,例如返回一些元素的集合时,就会使用多条批量回复。它以*作为开头,后面是返回元素的个数,之后再跟随多个上面讲到过的批量回复。 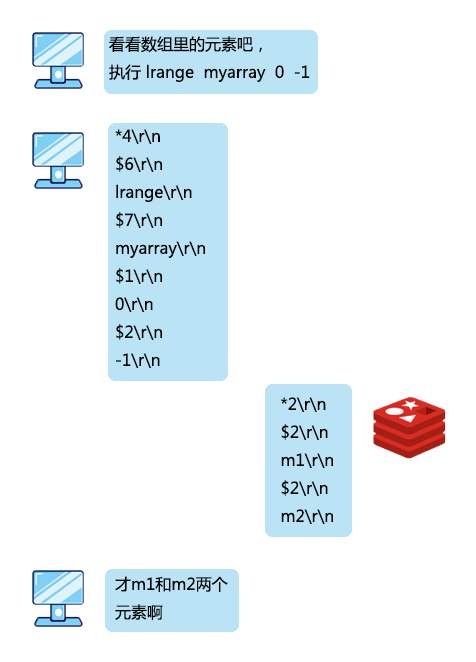 到这里,基本上我和小弟之间的通讯协议就介绍完了。刚才你尝试了伪装成一个服务端,这会再来试一试直接写一个客户端来直接和我进行交互吧。 private static void client() throws IOException { String CRLF="\r\n"; Socket socket=new Socket("localhost", 6379); try (OutputStream out = socket.getOutputStream()) { StringBuffer sb=new StringBuffer(); sb.append("*3").append(CRLF) .append("$3").append(CRLF).append("set").append(CRLF) .append("$4").append(CRLF).append("key1").append(CRLF) .append("$6").append(CRLF).append("value1").append(CRLF); out.write(sb.toString().getBytes()); out.flush(); try (InputStream inputStream = socket.getInputStream()) { byte[] buff = new byte[1024]; int len = inputStream.read(buff); if (len > 0) { String ret = new String(buff, 0, len); System.out.println("Recv:" + ret); } } } } 运行上面的代码,控制台输出: `Recv:+OK` 上面模仿了客户端发出set命令的过程,并收到了回复。依此类推,你也可以自己封装其他的命令,来实现一个自己的Redis客户端来和我进行通信。
-
最基础的概念,什么是幂等性?幂等性:提交多次的情况下,结果都一样。比如数据库查询,可称为天然幂等性,即查询多次结果都一样,无需人为去做幂等性操作。但是update table set value=value+1 where id=1,每次执行的结构都会发生变化,不是幂等。inter into table(id,name)values(1,‘name’),如id不是主键或者没有唯一索引,重复操作上面的业务,会插入多条数据,不具备幂等性;所以我们在什么情景下需要确保幂等性呢?用户多次点击保存按钮用户保存成功后,返回上一页再次保存微服务相互调用,由于网络原因,导致请求失败解决方案一、token机制:1、根据业务场景,判断哪些业务存在幂等性问题,在执行业务之前先获取token,将token缓存止redis中2、调用业务接口时,将token携带过去,一般放在请求头,作为Auth认证3、服务器判断token是否存在于redis中,存在表示第一次请求,然后删除token,继续执行业务4、如果不存在,则表示反复操作,不执行业务逻辑,直接返回重复标志!结束风险性:业务执行前删除还是后删除token?如果是执行后删除,在业务执行中,未删除token,用户又点了请求进来,那么则无法保障幂等性。如果是执行前删除,在分布式下,用户快速请求2次,这时2个请求同时到redis去获取token,对比成功,同时删除,同时执行业务,那么也无法保障幂等性。so:使用执行前删除,在分布式情况下,获取,对比,删除必须确保原子性,所以要加分布式锁。二、加锁1、数据库锁select * from table where … for update2、业务层面加分布式锁将获取、对比、删除作为一个原子性的操作加锁,处理完成后释放锁,确保串行操作。三、约束数据库唯一约束:通过主键、唯一索引,确保无法重复新增同一笔数据,这就能确保幂等性
-
 1 背景信息 ------------ 本文以服务构建器部署Redis为例,演示如何通过服务构建器自动化部署Redis集群服务。 ------------ 2 业务分析 ------------ 创建两个弹性云服务器,并在弹性云服务器中安装Redis键值对存储数据库集群。该集群拥有六个节点,三个主节点安装在主服务器,三个从节点安装在从服务器。Redis是一个开源(BSD许可),内存数据结构存储,可用作数据库,缓存和消息代理。  ------------ ## 3 准备 ### 3.1 镜像 CentOS 7.9 (x86_64)已预置gcc环境和expect环境,且成功安装Cloud-Init。 ### 3.2 软件包 请提前准备以下软件包。 | 软件包名称 | 说明 | |----|----| | redis-6.2.6.tar.gz | Redis的安装文件。 官网下载路径参考:https://download.redis.io/releases/redis-6.2.6.tar.gz ------------ ## 4 规划配置 ### 4.1 资源规划 网络规划如下: | 资源 | 具体操作 | |----|----| | 虚拟私有云 | 在虚拟私有云Console提前申请VPC和子网。 | ------------ 需要一台弹性云服务器安装Nginx,具体配置如下: | 资源 |推荐配置 | |----|----| | 内存 | 4G | | vCPUs | 2 | | 系统盘大小 | 20G | ------------ ### 4.2 模板设计 本次模板设计使用服务构建器图形化设计器,详细说明见下文。 - 模板设计  - 模板资源节点说明 | 节点名称 | 资源类型 | 作用 | |----|----|----| |CloudServer3uftf|HCS::ECS::CloudServer|Redis主节点服务器| |CloudServerazu|HCS::ECS::CloudServer|Redis从节点服务器| |SoftwareDeploymentm9jv|HCS::AutoOps::SoftwareDeployment|主节点Agent与脚本配置绑定| |SoftwareDeployment33d4b|HCS::AutoOps::SoftwareDeployment|从节点Agent与脚本配置绑定| |Agent5myc|HCS::AutoOps::Agent|主节点Agent| |Agent4wn65|HCS::AutoOps::Agent|从节点Agent| |Volume1j0p5|HCS::EVS::Volume|Redis主节点挂载的数据盘| |Volume2jous|HCS::EVS::Volume|Redis从节点挂载的数据盘| |SoftwareConfig1dip8|OS::Heat::SoftwareConfig|安装Redis主节点的脚本配置文件| |SoftwareConfig2c8fm|OS::Heat::SoftwareConfig|安装Redis从节点的脚本配置文件| ------------ - 模板参数节点说明 ------------ 服务器基本配置 | 参数Label | 参数名称 | 参数说明 | |----|----|----| | 可用分区 | availability_zone_ba4man | Redis服务器所在的可用分区 | | 镜像| image_utdqif | Redis服务器的系统镜像,需要指定已创建镜像的ID或名称。 | | 规格| flavor_3psdq6 | Redis服务器的系统规格的ID | | 系统盘大小| size_ge1xyv | Redis服务器的系统盘大小,以GB为单位。该值应大于或等于镜像的大小 | | 磁盘类型|volume_type_bijuat | Redis服务器数据盘对应的磁盘类型,需要与系统所提供的磁盘类型相匹配。磁盘类型枚举值:SATA:普通IO磁盘类型。SAS:高IO磁盘类型。SSD:超高IO磁盘类型 | | 主Redis服务器名称 |name_1dwipj | Redis主节点服务器名称 | | 从Redis服务器名称 |name_5gtfm6 | Redis从节点服务器名称 | ------------ 服务器网络配置 | 参数Label | 参数名称 | 参数说明 | |----|----|----| | 子网 | subnet_id_gea3wc | Redis服务器的网卡所属网络 | | 主节点1端口 | master_ip_port1_959nxa | 主节点1接受连接的指定端口 | | 主节点2端口 | master_ip_port2_6l6ip6 | 主节点2接受连接的指定端口 | | 主节点3端口 | master_ip_port3_nnhbqz | 主节点3接受连接的指定端口 | | 从节点1端口 | slave_ip_port1_a1ayi7 | 从节点1接受连接的指定端口 | | 从节点2端口 | slave_ip_port2_esajmx | 从节点2接受连接的指定端口 | | 从节点3端口 | slave_ip_port3_7mxshi | 从节点3接受连接的指定端口 | ------------ Agent配置 | 参数Label | 参数名称 | 参数说明 | |----|----|----| |Agent管理员密码|admin_pass_e2c513|服务器管理员的密码| |Agent管理员用户名|admin_user_po2bfq|服务器管理员的用户名| |脚本类型|type_4hsqsz|脚本文件的类型,仅支持python,shell| ------------ 数据盘配置 | 参数Label | 参数名称 | 参数说明 | |----|----|----| |数据盘类型|volume_type_r9n8yw|云硬盘类型的名称或者ID| |数据盘容量|size_1gr9a3|云硬盘的大小,单位GB| ------------ 软件配置 | 参数Label | 参数名称 | 参数说明 | |----|----|----| |Redis下载地址|redis_source_url_51dv0|Redis安装包的下载地址。(例如:http://[软件源云服务器私有IP]/packages/ redis-6.2.6.tar.gz)| |Redis安装路径|redis_install_path_ovhzzi|Redis安装路径(例如:/opt)| |Redis日志路径|redis_log_path_j3rr9b|Redis日志路径(例如:/opt/log)| |Redis数据路径|redis_data_path_8z9zt1|Redis数据路径(例如:/redis/data)| ------------ - 输出信息节点说明 | 输出信息 | 描述 | |----|----| |主节点IP地址|Redis主服务器的私有IP地址| |从节点IP地址|Redis从服务器的私有IP地址| ------------ ### 4.3 脚本设计 - Redis安装脚本 请参考附件中主Redis.sh和从Redis.sh脚本 ------------ - Redis主服务器安装脚本输入参数说明 | 参数Label | 参数名称 | 参数说明 | |----|----|----| |Redis下载地址|redis_source_url|Redis安装包的下载地址。(例如:http://[软件源云服务器私有IP]/packages/ redis-6.2.6.tar.gz)| |Redis安装路径|redis_install_path|Redis安装路径(例如:/opt)| |Redis日志路径|redis_log_path|Redis日志路径。(例如:/opt/log)| |Redis数据路径|redis_data_path|Redis数据路径。(例如:/redis/data)| |Redis主节点挂载的数据盘|master_data_disk|Redis主节点挂载的数据盘(例如:/dev/vdb)| |从节点IP地址|slave_ip_addr|Redis集群从节点服务器的IP地址| |主节点1端口|master_ip_port1|主节点1接受连接的指定端口(例如:7000)| |主节点2端口|master_ip_port2|主节点2接受连接的指定端口(例如:7001)| |主节点3端口|master_ip_port3|主节点3接受连接的指定端口(例如:7002)| |从节点1端口|slave_ip_port1|从节点1接受连接的指定端口(例如:7003)| |从节点2端口|slave_ip_port2|从节点2接受连接的指定端口(例如:7004)| |从节点3端口|slave_ip_port3|从节点3接受连接的指定端口(例如:7005)| ------------ - Redis从服务器安装脚本输入参数说明 | 参数Label | 参数名称 | 参数说明 | |----|----|----| |Redis下载地址|redis_source_url|Redis安装包的下载地址。(例如:http://[软件源云服务器私有IP]/packages/ redis-5.0.3.tar.gz)| |Redis安装路径|redis_install_path|Redis安装路径(例如:/home/redis)| |Redis日志路径|redis_log_path|Redis日志路径。(例如:/opt/log)| |Redis数据路径|redis_data_path|Redis数据路径。(例如:/redis/data)| |Redis从节点挂载的数据盘|slace_data_disk|Redis从节点挂载的数据盘(例如:/dev/vdb)| |从节点1端口|slave_ip_port1|Redis集群从节点1端口(例如:7003)| |从节点2端口|slave_ip_port2|Redis集群从节点2端口(例如:7004)| |从节点3端口|slave_ip_port3|Redis集群从节点3端口(例如:7005)| ------------ ## 5 申请服务 按照前期规划填写用户参数。  镜像应选择:CentOS-7-9-x86_64的操作系统,系统盘大小应大于镜像大小。 ------------  网卡应该和软件仓库在同一VPC下。弹性IP的外部网络要选EIP类型的外部网络。 ------------  Agent管理员的账号和密码为所选镜像的账号密码。 ------------   下载地址中的IP填写软件仓库的私有IP。 ------------ ## 6 服务调测 申请服务成功,资源栈详情页面如下:      ------------ 本示例通过脚本自动将Redis安装成功。远程登录redis主节点虚拟机,按如下步骤操作验证(redis从节点操作同理): 1) 进入redis安装目录,执行命令src/redis-cli -c -p 7000 -h 192.168.1.108【其中7000为redis的主节点1端口号,192.168.1.108是主服务器的IP地址】,再输入命令set key value放入一个键值对,再执行命令get key获取刚才的值; 2) 最后输入命令cluster nodes查看集群状态   ------------ 感谢大家观看,欢迎下方留言交流! ------------
-
## 1 背景信息 本文档以服务构建器部署Redis为例,演示如何通过服务构建器自动化部署Redis服务 。 ## 2 业务分析 弹性云服务器(ECS)中安装Redis,Redis是一个开源(BSD许可), 内存数据结构存储,可用作数据库,缓存和消息代理。  ### 3.1 镜像 CentOS 7.9 (x86_64)已预置gcc环境,且成功安装Cloud-Init。 ### 3.2 软件包 请提前准备以下软件包。 | 软件包名称 | 说明 | | ------------------ | ------------------------------------------------------------ | | redis-6.2.6.tar.gz | Redis的安装文件。 官网下载路径参考:https://download.redis.io/releases/redis-6.2.6.tar.gz | ## 4 规划配置 ### 4.1 资源规划 1. 网络规划 | 资源 | 具体操作 | | ---------- | -------------------------------------- | | 虚拟私有云 | 在虚拟私有云Console提前申请VPC和子网。 | 2. 弹性云服务器:需要一台弹性云服务器安装Redis,具体配置如下。 | 资源 | 推荐配置 | | ---------- | -------- | | 内存 | 4G | | vCPUs | 2 | | 系统盘大小 | 20G | ### 4.2 模板设计 本次模板设计使用服务构建器图形化设计器  #### 模板资源节点说明 | 节点名称 | 资源类型 | 作用 | | ---------------- | ------------------------ | ----------------------------------- | | CloudServer1d9k7 | HCS::ECS::CloudServer | Redis服务器 | | MultipartMime | OS::Heat::MultipartMime | 关联Redis虚拟机和SoftwareConfig资源 | | SoftwareConfig | OS::Heat::SoftwareConfig | 安装Redis脚本配置文件 | #### 模板参数节点说明 #### 服务器基础配置 | 参数Label | 参数名称 | 参数说明 | | ---------- | ------------------------ | ----------------------------- | | 可用分区 | availability_zone_kukenj | | | 镜像 | image_1mas5d | | | 规格 | flavor_3tw9c7 | 包括内存、CPU、磁盘类型等信息 | | 磁盘类型 | volume_type_i8k3xm | 云硬盘类型 | | 容量 | size_9z88cy | | | 服务器名称 | name_bm2leo | | #### 服务器网络配置 | 参数Label | 参数名称 | 参数说明 | | --------- | ---------------- | ------------------------------------------------------------ | | 子网 | subnet_id_7mzv95 | 弹性云服务器的网卡ID。需要指定vpc_id对应VPC下已创建的网络(network)的ID,UUID格式。 | #### Redis软件配置 | 参数Label | 参数名称 | 参数说明 | | ------------- | ------------------------- | ------------------------------------------------------------ | | Redis下载地址 | redis_source_url_i427qp | Redis安装包的下载地址。(例如:http://[软件源云服务器私有IP]/packages/ redis-5.0.3.tar.gz) | | Redis安装路径 | redis_install_path_x3sci5 | Redis安装路径 | #### 输出信息节点说明 | 输出信息 | 描述 | | ------------ | ----------------------- | | 服务器IP地址 | Redis服务器的私有IP地址 | | 默认端口号 | Redis数据库的默认端口号 | ### 4.3 脚本设计 1. 脚本内容 ```shell #!/bin/bash REDIS_SOURCE_URL=redis_source_url REDIS_INSTALL_PATH=redis_install_path # 默认值为/usr/local/redis REDIS_SOURCE_PATH=/opt LOG_PATH=/var/log/redis_install.log echo "Start to execute install redis script." >>${LOG_PATH} cd ${REDIS_SOURCE_PATH} #redis REDIS_PACKAGE_NAME=${REDIS_SOURCE_URL##*/} wget -qc ${REDIS_SOURCE_URL} -O ${REDIS_PACKAGE_NAME} echo "Download redis package success." >>${LOG_PATH} tar -zxvf ${REDIS_PACKAGE_NAME} rm ${REDIS_PACKAGE_NAME} REDIS_SRC_FOLDER=${REDIS_PACKAGE_NAME%.tar.gz} cd ${REDIS_SRC_FOLDER} echo "Start to execute make && make install to compile." >>${LOG_PATH} make >>${LOG_PATH} make install PREFIX=${REDIS_INSTALL_PATH} >>${LOG_PATH} echo "Compile success." >>${LOG_PATH} cp ${REDIS_SOURCE_PATH}/${REDIS_SRC_FOLDER}/redis.conf ${REDIS_SOURCE_PATH}/${REDIS_SRC_FOLDER}/redis.conf.bak echo "Start to post install config." >>${LOG_PATH} sed -i 's/daemonize no/daemonize yes/' ${REDIS_SOURCE_PATH}/${REDIS_SRC_FOLDER}/redis.conf sed -i 's/bind 127.0.0.1 -::1/# &/g' ${REDIS_SOURCE_PATH}/${REDIS_SRC_FOLDER}/redis.conf sed -i 's/protected-mode yes/protected-mode no/' ${REDIS_SOURCE_PATH}/${REDIS_SRC_FOLDER}/redis.conf echo "End post install config." >>${LOG_PATH} cp ${REDIS_SOURCE_PATH}/${REDIS_SRC_FOLDER}/redis.conf ${REDIS_INSTALL_PATH}/bin/ firewall-cmd --zone=public --add-port=6379/tcp --permanent firewall-cmd --reload echo "Start redis service." >>${LOG_PATH} cd ${REDIS_INSTALL_PATH}/bin nohup ./redis-server redis.conf 2>&1 & echo "Execute install redis script success." >>${LOG_PATH} ``` 2. 脚本输入参数说明 | 参数Label | 参数名称 | 参数说明 | | ------------- | ------------------ | ------------------------------------------------------------ | | Redis下载地址 | redis_source_url | Redis安装包的下载地址。(例如:http://[软件源云服务器私有IP]/packages/ redis-6.2.6.tar.gz) | | Redis安装路径 | redis_install_path | Redis安装路径(例如: /usr/local/redis ) | ## 5 申请资源栈  ## 6 服务调测 本示例通过脚本自动将Redis安装成功,可以看到redis服务正常。 
-
最基础的概念,什么是幂等性?幂等性:提交多次的情况下,结果都一样。比如数据库查询,可称为天然幂等性,即查询多次结果都一样,无需人为去做幂等性操作。但是update table set value=value+1 where id=1,每次执行的结构都会发生变化,不是幂等。inter into table(id,name)values(1,‘name’),如id不是主键或者没有唯一索引,重复操作上面的业务,会插入多条数据,不具备幂等性;所以我们在什么情景下需要确保幂等性呢?用户多次点击保存按钮用户保存成功后,返回上一页再次保存微服务相互调用,由于网络原因,导致请求失败解决方案一、token机制:1、根据业务场景,判断哪些业务存在幂等性问题,在执行业务之前先获取token,将token缓存止redis中2、调用业务接口时,将token携带过去,一般放在请求头,作为Auth认证3、服务器判断token是否存在于redis中,存在表示第一次请求,然后删除token,继续执行业务4、如果不存在,则表示反复操作,不执行业务逻辑,直接返回重复标志!结束风险性:业务执行前删除还是后删除token?如果是执行后删除,在业务执行中,未删除token,用户又点了请求进来,那么则无法保障幂等性。如果是执行前删除,在分布式下,用户快速请求2次,这时2个请求同时到redis去获取token,对比成功,同时删除,同时执行业务,那么也无法保障幂等性。so:使用执行前删除,在分布式情况下,获取,对比,删除必须确保原子性,所以要加分布式锁。二、加锁1、数据库锁select * from table where … for update2、业务层面加分布式锁将获取、对比、删除作为一个原子性的操作加锁,处理完成后释放锁,确保串行操作。三、约束数据库唯一约束:通过主键、唯一索引,确保无法重复新增同一笔数据,这就能确保幂等性
-
>摘要:高斯Redis即保留了开源Redis的能力,同时凭借其存算分离的架构,在成本、稳定性、可靠性、一致性等方面做出了新的突破,也更加适用于当下数据规模庞大的互联网业务。本文分享自华为云社区[《【大厂内参】第12期:技术架构+应用场景揭秘,为什么高斯Redis比开源香?》](https://bbs.huaweicloud.com/blogs/308547?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content),作者:华为云社区精选。 点的外卖总能让离店近的外卖小哥送来,双11秒杀结束后产品能立刻下架,12306火车票保证从来不超卖,微博下拉就能刷新出好友动态……这些日常碎片的背后都有着Redis的身影。 提起Redis,互联网从业者无人不知,无人不晓。毕竟,开源Redis作为一款经典的“缓存”产品,能支撑众多业务架构搭建,在游戏、电商、社交媒体等行业中发挥着重要的作用,广受开发者青睐。 然而近年来,随着各行业规模逐渐扩大,几乎只能依附于关系型数据库的传统“缓存”逐渐难以支撑上层业务,越来越力不从心。 一旦业务规模扩大后数据量逼近内存上线,开源Redis轻则发生重要数据逐出,重则导致节点OOM宕机。而且开源Redis为了访问快速,全部数据都保存在内存中,其独有的fork机制,更让平时的内存使用不得高于50%,使得内存价格一直居高不下,导致部署成本非常高。 为了解决这些难题,华为云推出了自研的企业级Key-Value数据库——云原生分布式数据库[GaussDB(for Redis)](https://www.huaweicloud.com/product/gaussdbforredis.html?utm_source=goujian&utm_medium=database&utm_content=content)(下文简称**高斯Redis**),让开发者用更低的成本构建依赖缓存的应用,且性能更高,运行更稳定。**本文将从高斯Redis的技术架构和应用场景出发,一一道来为什么高斯Redis比开源香,以及它是如何做到又快又好的。** # 开源不够,自研顶上 开门见山,先看看开发者最关心的性能和成本。如下图所示,与开源Redis相比,高斯 Redis在**成本、可用容量、吞吐、压缩上**都有非常大的优势:  注:比较相同数据容量(约200G)的成本开销 核算下来,高斯Redis以1/4的价格拥有10倍以上的可用空间,整体成本相当于是开源Redis自建数据库的1/40,这里还不包括自建Redis数据库需要额外的搭建、运维、监控、升级扩容等各项成本。 同样,对比高斯Redis和开源Redis集群在X86架构下的性能测试,结果显示,它能较开源Redis集群能提供**更高的QPS,更低的访问延迟,以及更低的数据存储成本**。 性能优势:在相同测试条件下,高斯Redis的QPS较开源Redis集群提高了11%~19%,平均延迟和P99比Redis集群降低了70%以上,p9999比Redis集群降低了15%以上。 抗写优势:在数据量大于内存的写测试中,原生Redis集群因内存限制而OOM,高斯Redis依然可以提供不俗的性能服务,它的可用的存储空间由底层SSD大小决定的,相比原生Redis集群抗写优势显著。 据存储成本更低:高斯Redis提供了高效的数据压缩服务,其占用的存储空间只有开源Redis集群的十分之一,相当于数据存储成本降低了10倍。 那么,高斯Redis的优势源自什么?从它的架构中或许可以窥见一斑。 # 存算分离,突破瓶颈 高斯Redis有两个跟业界完全不一样的特性,**第一个便是独有的存算分离架构**, 计算层实现热数据缓存,存储层实现全量数据的落盘,中间通过RDMA高速网络互连,通过算法预测用户的访问规律,实现数据的自动冷热交换,最终达到性能提升。 该架构基于华为内部的**自研分布式共享存储池**, 它也是华为全栈数据服务的基石,比如文件EVS、对象存储OBS、块存储,还有数据库族、大数据族都依赖于此,可想它的强大及稳定性。  高斯Redis基于共享存储池实现了一套Shared Everything的云原生架构,充分发挥了云原生的弹性伸缩、资源共享的优势,使得它具备强一致、秒扩容、低成本、超可用等特性,完美避开了开源Redis的主从堆积、主从不一致、fork抖动、内存利用率只有50%、大key阻塞、gossip集群管理等问题。 至于高斯Redis的存算分离架构的设计和实现原理,在线课程[当Redis遇见计算存储分离](https://education.huaweicloud.com/courses/course-v1:HuaweiX+CBUCNXD057+Self-paced/about?utm_source=goujian&utm_medium=database&utm_content=content)中有更详细的解读,包括软件架构的剖析,计算层的模块的分工,组网的设计以及容灾架构等等。 在存算分离的架构下,高斯Redis的优势可以总结为:强一致、高可用、弹性伸缩、高性能。 ### 强一致 高斯Redis将全量数据下沉到强一致的共享存储池,得益于共享存储池的3副本机制,因此写入高斯Redis的数据,在客户端收到回复时,数据也将是**3副本强一致**的,保证宕机的时候数据不会丢失,从而为业务提供前后一致的状态,再也不用担心主从切换后的数据一致性和丢失问题。 ### 高可用 其次是**高可用**,受益于分布式共享存储池,高斯Redis的每个计算节点都可以看到并共享所有数据,当某一个计算节点发生故障挂掉,其维护的slot路由信息,会被剩下的节点自动接管。由于不涉及底层数据的迁移,这个接管过程非常快。所以**N个节点下,最多可以容忍挂掉N-1个节点**。 ### 弹性伸缩 再就是弹性伸缩带来的**秒扩容能力**,实现按需扩容计算和存储。计算资源的扩容只涉及到元数据的修改,把相应的slot路由信息迁移到新的节点上,迁移速度非常快。由于采用的共享存储,大多数情况下存储扩容只要进行逻辑扩容,不涉及数据的搬迁,在后台修改存储配额即可。 ### 高性能 存算分离的架构看似比较重,链路比较复杂,实则在硬件采用、软件优化上,可以做的更大胆更激进,比如RDMA网络、用户态协议、持久化内存等等。因此受益于这些专属的存储设备,加上计算层全负荷分担架构(不引入从节点,因此性能轻松翻倍),对比同类商业数据库产品,在数据量大于内存的存储场景下,高斯Redis的性能表现很好。另外,对比开源Redis,在数据小于内存的点查场景下,高斯性能也有很大优势。 **第二个特性是多模架构带来的产品使用便捷性**。高斯Redis是多模数据库Gauss NoSQL的一员,Gauss NoSQL提供了全栈的分布式KV引擎、用户态文件系统、存储池等技术,只需要在接口上封装Redis协议,即可轻松实现一个全新的NoSQL产品。类似的,华为还提供了MongoDB、Cassandra、Influx等NoSQL引擎。 也正是得益于高斯Redis的独特优势,使得它在一些典型的应用场景下,能够应对各种突发情况,最大化发挥出Redis的特性。 ## 互联网业务神器,支撑海量存储场景 Redis最常见的应用场景是缓存,用来存放秒杀、热点事件的数据,比如微博热搜。同时,凭借其优异的存储能力,缓存场景之外的诸多应用Redis也可以轻松应对,比如 **流**: feed、消息队列、IM聊天、IoT心跳上报; **只读状态**: 历史订单、日志审计、归档信息、历史轨迹、消费记录、物流详情; **可变状态**: BI报表、金融风控、智能客服、广告推荐、标签工程、用户画像、地理位置、路径规划、知识图谱等。 下面,以其中的一些场景为例,具体看看高斯Redis到底有多强大? # Geo 饭点时打开大众点评查看附近的餐馆,外卖小哥根据距离远近来决定配送的路径规划……这些都依靠LBS服务,它的实现又需要Redis来存储地理位置数据。但开源版本Redis因为内存限制,一直没有大规模应用支持地理位置信息存储管理的Geo功能。 高斯Redis使用磁盘替代内存,解决了这些难题,它的Geo功能适用于数据量大、读写频繁的场景,可以应对诸如外卖平台、点评平台、找房平台中,随着用户增长而对应的地理位置信息的数据量的增长,最高可达TB级别。以下图为例,可以看到在高斯Redis支持下,外卖系统可以使用Geo的相关命令,让用户获取骑手的实时位置,骑手也能找到附近可配送的订单,最终顺利将用户的外卖送到用户。  # 计数 社交平台每条热搜记录的搜索量数值;用户注册一个帐号后,网站记录的关注数、粉丝数、动态数;一个接口一分钟被限制100次请求等。这些数据背后,是一个个计数器在工作。 计数是典型的强一致应用场景,比如电商在秒杀活动中,往往会搭建Redis主从集群给下层MySQL做缓存,用Redis的计数器功能抵住流量压力。 所以如果数据发生不一致,计数器就会得到错误的信息,整个数据库可能面临崩溃的危险。但原生Redis的主从同步是异步的,当主节点写入数据后,从节点不保证立刻更新数据,如果此时读取数据,读到的就是过期的旧数据,产生数据不一致问题。高斯Redis则可以把全量数据下沉到强一致共享存储池,彻底摒弃了开源Redis的异步复制机制。另外,计算层将海量数据进行分片,在故障场景下,自动进行接管,实现了服务的高可用。 # 即时通讯 即时通讯(简称IM)是一个实时通信系统,允许两人或多人使用网络实时的传递文字消息、文件、语音与视频。它最核心的是消息系统,包括聊天消息的同步、存储和检索。而消息存储库和同步库又对存储层的性能有很高的要求:要能支撑海量消息数据的永久存储,具备极高的写入吞吐能力,尽可能低的读取延迟等等。 综上,存储层的性能会直接影响到IM系统的用户体验。高斯Redis在性能和规模上可以满足IM系统对存储层的严格要求,它作为IM系统的存储层,可以将大量的随机写转换为顺序写,提升数据写入性能,再通过读缓存、bloom filter优化读取性能。 下图是一个基于高斯Redis的IM应用案例,使用的是Stream作为基本数据结构。创建一个群聊时,在Redis中对应地为该群聊创建一个Stream队列。在发送消息时,每个用户都将消息按照时间顺序添加到Stream队列中,保证了消息的有序性。  这个应用中涉及到了一种数据类型——Redis Stream,它也是一种消息队列,提供消息的落地存储功能,让每个客户端可以访问任意时刻的消息,并记录访问位置,保证消息不会丢失,以IM中的文字聊天为例,使用Stream作为中间件,实现聊天室的发言和信息查看。高斯Redis可以存储和处理大规模的Stream数据,鲁棒性强的同时成本相对更低,适用于海量消息队列的场景。所以,相较于原生Redis,是更为理想的Stream队列承载方案。 # Feed流 互联网时代,微博、抖音、头条等都在通过Feed流(信息流)将关注的好友或感兴趣的内容及时推送给用户,吸引用户的兴趣,提高产品的商业价值。Feed流系统是Feed生成者将生产的Feed经过存储分发系统传递给Feed消费者,最终以某种展现形式。 整个系统最关键的是同步存储系统,首先是内容存储模块,由它来存储最原始的内容,比如用户发的一条微博;其次是关联关系存储模块,存储的是用户之间的关系;最后是信箱模块,也叫消息传递模块 ,通过它将消息传递到每个关联用户手中。 在Feed流场景下,高斯Redis能够支撑海量消息内容的存储和低延迟访问,以及关联关系的增删查改。在同步存储系统中的信箱存储模块,高斯Redis的Stream数据结构可以实现队列能力,实现Feed流消息读取。 # 推荐系统 电商、社交等领域的推荐系统非常发达,追溯其背后技术,不外乎这三个环节:分布式计算、特征存储、推荐算法。其中,特征数据的存储起到关键的衔接作用,由于KV形式的数据抽象与特征数据极为接近,因此推荐系统里往往少不了Redis的身影。 由于开源Redis在大数据场景下的一些固有痛点,高斯Redis是不少客户首选的数据库选型。由高斯Redis负责核心的特征数据存储,提供稳定、可靠的KV存储能力。加上它的高性能持久化技术和细粒度存储池,可帮助企业将数据库使用成本降低75%以上。高斯Redis独特的多线程设计和全部节点可写,抗写能力强,可从容应对Spark灌库压力和实时更新。 而且因为高斯Redis完全兼容Redis协议,即开即用,用户可使用熟悉的Spark SQL语法轻松访问,完成特征数据灌库、更新、提取等关键任务。 与此同时,数据源经过Flink加工后,也可轻松存入高斯Redis中。 # 成为VMALL智能推荐背后的英雄 当电商平台对AI算法模型的需求越来越多,特征数据平台的统一建设是不少开发团队头疼的事情。 只有通过统一的特征数据存储,才能改变原有的“数据孤岛”,解决生产重复造轮子的窘境。 华为商城(VMALL)就有这样的困扰,VMALL使用了大量的AI和大数据技术,用来支撑智能推荐、精准营销、智能搜索、选品投放等业务的高效开展。但因为特征数据准备阶段缺乏通用平台,严重影响研发效率。 特征数据库需要承担打通线上/线下多个场景,对接批式/流式多种数据源,满足训练/推理多样消费需求,相应地对存储也提出了高要求:既能提供**低成本的海量数据存储并方便扩容**, 又能保证数据的绝对可靠和服务的高可用;既要满足**低时延的线上推理,又要满足高吞吐的线下训练**; 既能提供简洁的KV接口供下游轻松消费,又要兼容主流的批式/流式处理引擎(Spark/Flink等)供上游快速接入。 为了满足这些要求,深入调研后,VMALL大数据团队最终选择了高斯Redis作为特征数据库。  在线上推理的特征生产(抽取、处理、存储)中,特征平台会定时调度Spark作业,从各种数据仓库、数据湖中提取数据,进行特征工程处理后,存入高斯Redis。至于实时特征,则由Flink消费Kafka,或流式存储中的数据,持续更新到高斯Redis中。 在特征消费的推理环节,对于使用实时特征的场景(如实时推荐系统),由Flink从Kafka中实时取得用户请求记录,并从高斯Redis查询取得特征,将记录和特征拼接成训练样本,存储到文件中,供线下训练使用。 目前VMALL已完成一期的特征数据迁移,包括“特征生产”业务中的“Spark离线特征生产”,以及“特征消费”业务中的“线下训练Flink特征查询”。迁移后的运行结果显示,高斯Redis在业务高峰时段时延稳定,能够满足VMALL当前业务要求。其中,读平均时延0.2ms(p990.4ms),写入平均时延0.6ms(P992ms)。 费用方面,按照VMALL的特征体量测算,亿级用户,每个用户的特征数量是数K-数10K,高斯Redis一年的费用仅3W出头,如果选用社区Redis,费用在**20W+**。 综上,高斯Redis在VMALL特征工程平台建设中,起到了关键作用。它在成本,可靠性,可扩展性等方面具有优势,可作为特征数据存储的理想方案,提供企业级的稳定可靠的Redis服务能力。 # 最后 作为一款KV数据库,高斯Redis即保留了开源Redis的能力,同时凭借其存算分离的架构,在成本、稳定性、可靠性、一致性等方面做出了新的突破,它也更加适用于当下数据规模庞大的互联网业务,包括电商平台的秒杀、推荐系统、社交平台的信息流等等。本文只是简单地解读了高斯Redis的几个典型特性,更多技术细节,以及应用案例、迁移指南等可以查看高斯Redis系列合集。
-
 Redis支持五种数据类型:string(字符串),hash(哈希),list(列表),set(集合)及zset(sorted set:有序集合)。String(字符串)string是redis最基本的类型,你可以理解成与Memcached一模一样的类型,一个key对应一个value。string类型是二进制安全的。意思是redis的string可以包含任何数据。比如jpg图片或者序列化的对象 。string类型是Redis最基本的数据类型,一个键最大能存储512MB。实例redis 127.0.0.1:8848> SET name "huaweicloud.com" OK redis 127.0.0.1:8848> GET name "huuaweicloud"实例中我们使用了 Redis 的 SET 和 GET 命令。键为 name,对应的值为huaweicloud.comHash(哈希)Redis hash 是一个键值对集合。Redis hash是一个string类型的field和value的映射表,hash特别适合用于存储对象。实例redis 127.0.0.1:8848> HMSET user:1 username huaweicloud.com password huaweicloud.com points 200 OK redis 127.0.0.1:8848> HGETALL user:1 1) "username" 2) "huaweicloud.com" 3) "password" 4) "huaweicloud.com" 5) "points" 6) "200" redis 127.0.0.1:8848>以上实例中 hash 数据类型存储了包含用户脚本信息的用户对象。 实例中我们使用了 Redis HMSET, HGETALL 命令,user:1 为键值。每个 hash 可以存储 232 - 1 键值对(40多亿)。List(列表)Redis 列表是简单的字符串列表,按照插入顺序排序。你可以添加一个元素导列表的头部(左边)或者尾部(右边)redis 127.0.0.1:8848> lpush huaweicloud.com redis (integer) 1 redis 127.0.0.1:8848> lpush huaweicloud.com mongodb (integer) 2 redis 127.0.0.1:8848> lpush huaweicloud.com rabitmq (integer) 3 redis 127.0.0.1:8848> lrange huaweicloud.com 0 10 1) "rabitmq" 2) "mongodb" 3) "redis" redis 127.0.0.1:6379>列表最多可存储 232 - 1 元素 (4294967295, 每个列表可存储40多亿)。Set(集合)Redis的Set是string类型的无序集合。集合是通过哈希表实现的,所以添加,删除,查找的复杂度都是O(1)。sadd 命令添加一个string元素到,key对应的set集合中,成功返回1,如果元素以及在集合中返回0,key对应的set不存在返回错误。sadd key memberredis 127.0.0.1:8848> sadd huaweicloud.com redis (integer) 1 redis 127.0.0.1:8848> sadd huaweicloud.com mongodb (integer) 1 redis 127.0.0.1:8848> sadd huaweicloud.com rabitmq (integer) 1 redis 127.0.0.1:8848> sadd huaweicloud.com rabitmq (integer) 0 redis 127.0.0.1:8848> smembers huaweicloud.com 1) "rabitmq" 2) "mongodb" 3) "redis"以上实例中 rabitmq 添加了两次,但根据集合内元素的唯一性,第二次插入的元素将被忽略。集合中最大的成员数为 232 - 1 (4294967295, 每个集合可存储40多亿个成员)。参考文章:http://www.manongjc.com/redis/redis_data_types.html
-
>摘要:其实开源Redis的弱一致性已经不满足很多应用场景的诉求。怎么,不信?本文分享自华为云社区《华为云企业级Redis揭秘第15期:Redis为什么需要强一致?》,作者: GaussDB 数据库。有人说,开源Redis的最终一致性已经能满足大部分应用场景,也有人说,多副本的强一致代价太大,没有必要实现。要笔者说,其实弱一致性已经不满足很多应用场景的诉求。怎么,不信?请听笔者娓娓道来。1. 不一致带来的困扰1.1 秒杀变秒崩分享一个电商秒杀活动中限流器的例子,在电商的秒杀活动中,为了扛住前端对数据库的超大流量冲击,一般使用两种方案来保护系统,一个是缓存,另一个则是限流。缓存这个容易实现,只需要在数据库前加一层缓存服务器,而对于限流来说,最简单的可以使用Redis的计数器来实现限流功能。具体来说,假设我们需要对某个接口限定流量为5000QPS,即每秒钟访问的次数不能超过5000。那么我们可以这么做:在一开始的时候设置一个计数器counter为5000,并且过期时间为1s,即1s后计数器失效。每当一个请求过来的时候,counter的值减1,判断当前counter的值是否等于0,如果等于,则说明请求次数过多,直接拒绝请求。如果counter计数器不存在,则重置计数器为5000,开始新一秒的接口限流,注意并发情况下计数器需要加锁。正常情况下,这种方案不会出现问题,但是针对这种秒杀活动,不怕一万,就怕万一,万一Redis突然宕机怎么办,那岂不是限流器形同虚设,所有流量全部涌向后端的数据库,瞬间系统崩溃。此时聪明的你肯定会想到,给Redis搞一个备用服务器不就解决了,主服务器如果宕机,备用服务器顶上。没错,这种方案是对的,但是只正确了一半。为什么呢,如下图所示。当给Redis配置从服务器之后,如果主服务器出现宕机,可以立刻切换到从服务器,但是由于开源Redis主从服务器之间的数据是异步复制的,如果网络不畅,经常发生主从数据不一致,如果此时主服务器发生宕机,切换到从服务器之后,因为限流器的判断出错,流量压力很容易超出阈值,一下子涌向数据库服务器,同样会造成系统崩溃。仔细探究这个问题产生,根因是在于开源Redis的一致性机制为弱一致性,在某些时间内,主从副本数据不一致。而要彻底解决这个问题,只有真正的强一致才能解决。1.2 难以维护的MySQL组件其实不止Redis,就连大名鼎鼎的MySQL也逃不过弱一致的坑。MySQL的部署中,为了保证高可用性,主从热备份是MySQL常用的部署方式。但是如果发生故障时,仅仅靠MySQL自身的同步机制,是无法保证主库和从库之前的数据一致的,于是出现了重要的辅助组件MHA(Master High Availability),它的部署方式如下:MHA由管理服务和Node服务组成,Node服务部署在每个MySQL节点上,MHA组件负责让MySQL的从库尽可能的追平主库,提供主从一致的状态。发生故障进行主从切换时,Manager首先为从库补充落后的数据,然后再将用户访问切换到从库,这个过程可能长达数十秒。MHA的部署和维护都相当复杂,如未能顺利执行故障切换或发生数据丢失,运维面临的场面都将很棘手。其实运维同学何尝不希望手中的系统稳定运行呢?要是数据库自身能提供强一致保障,何苦再依赖复杂的辅助组件!2. 什么是强一致上一节中笔者介绍了弱一致带来各种问题,接下来这一节具体介绍下什么是强一致。在“分布式系统”和“数据库”这两个领域中,一致性都是重要概念,但它表达的内容却并不相同。对于分布式系统而言,一致性是在探讨当系统内的一份逻辑数据存在多个物理的数据副本时,对其执行读写操作会产生什么样的结果,这也符合 CAP 理论对一致性的表述。而在数据库领域,“一致性”与事务密切相关,又进一步细化到 ACID 四个方面。因此,当我们谈论分布式数据库的一致性时,实质上是在谈论事务一致性和数据一致性两个方面。2.1 事务一致性事务的一致性主要是指的事务的ACID,分别是原子性、一致性、隔离性和持久性,如下图所示:原子性:事务中的所有变更要么全部发生,要么一个也不发生,通过日志技术实现;一致性:事务要保持数据的完整性,它是应用程序的属性,依赖原子性和隔离属性来实现;隔离性:多事务并行执行所得到的结果,与串行执行(一个接一个)完全相同,通过并发控制技术来实现;持久性:一旦事务提交,它对数据的改变将被永久保留,不应受到任何系统故障的影响,通过日志技术实现。2.2 数据一致性在分布式系统中,为了避免网络不可靠带来的问题,通常会存储多个数据副本,逻辑上的一份数据存储在多个物理副本上,自然带来了数据一致性问题。(1)状态视角从状态的视角来看,任何变更操作后,数据只有两种状态,所有副本一致或者不一致。在某些条件下,不一致的状态是暂时,还会转换到一致的状态,而那些永远不一致的情况几乎不会去讨论,所以习惯上大家会把不一致称为“弱一致”。相对的,一致就叫做“强一致”了。以一个一主两备的MySQL集群为例,“强一致”的交互过程如下:在该模式下,主库与备库同步 binlog 时,主库只有在收到两个备库的成功响应后,才能够向客户端反馈提交成功。显然,用户获得响应时,主库和备库的数据副本已经达成一致,所以后续的读操作肯定是没有问题的,这就是状态视角的“强一致”的模型。但是状态视角的这种强一致副作用很大:第一个是性能很差,主库必须要等备库1和备库2成功返回后才能返回;第二个是可用性问题,如果主备节点很多,出现故障的概率非常高。因此,状态视角的强一致代价非常大,所以很少使用。(2)操作视角状态视角的强一致降低了系统的可用性,因此很多系统选择状态视角的弱一致性模型,通过额外的算法(如Raft、Paxos)在不保证所有节点状态的一致的情况下,来保证操作视角的一致性,同时提高了系统的可用性。通过加入一些限定条件,衍生出了若干种一致性模型:线性一致性:操作视角实现真正的强一致顺序一致性:一致性强度弱于线性一致性因果一致性:一致性强度弱于顺序一致性写后读一致性:一致性强度相当,弱于因果一致性3. 强一致的刚需场景上一节我们介绍了什么是强一致,这一节我们介绍下强一致的典型应用场景。在常见的互联网应用中,如果数据库服务器只部署在单个节点上,那么应用程序所有的读和写都只会访问单个节点,一份逻辑数据在物理上也只有一份,这种场景下就谈不上强一致的问题。但是随着系统中业务访问量的增加,如果是单机部署数据库,就会导致I/O访问频率过高,数据库就会成为系统的瓶颈。此时,为了降低单机磁盘的I/O访问频率,提高单个机器的I/O性能,通常会增加多个数据存储节点,形成一主一从或者一主多重的架构,此时,我们可以将负载分布在多个从节点上,一方面可以实现读写分离,写请求访问主库,读请求访问备库。另一方面,还可以在主库如果出现宕机的情况下进行主备切换,增强系统的稳定性。在以上两个场景中,由于一份逻辑数据在物理上有多个副本,那么如何保证多个副本之间的数据一致呢,这就是强一致需要解决的问题。3.1 读写分离场景以关系型数据库MySQL为例,典型的部署方案为一主两从三节点方案,主节点负责处理写操作,两个从节处理读操作,分担主库的压力,如下图所示:此时,如果系统没有实现强一致,就有可能会遇到执行完写操作后,立刻去读,然后发现读不到或者读到旧状态的尴尬场景,比如操作顺序为以下操作:客户端首先通过代理向主节点 Master 进行了写入操作,此时由于没有实现强一致,写操作写完后立即返回;紧接着第二步去从节点 Slave A 执行读操作,此时Master和Slave A之间的同步还未完成,系统处于非强一致的状态,所以第二步的读操作读取到了旧状态。可以看出,在一主多备读写分离的场景下,如果想要保证写入和读取操作的准确无误,系统实现强一致是非常重要的。3.2 主备切换场景主备切换的场景也需要强一致来保证,以目前业内使用最广泛的内存数据库Redis为例,Redis的主从同步如下图所示:从上图可以看出,当Redis客户端向Master服务器发送一条命令时,Master服务器立即回复客户端命令的执行结果,并不等待命令同步到从服务器再回复,也就是说Redis的主从同步其实是异步的。由于Master节点存在宕机的可能,在这种情况下,如果在Master收到命令但是还没同步到Slave服务器时发生了宕机,Redis就会发生主备切换,然后此时Master服务器和Slave服务器的数据还没有同步,就导致了数据丢失的情况。可见,开源Redis弱一致性本身的缺陷和不足,而要解决这个问题,必须实现强一致性才能解决。4. 高斯Redis强一致由于开源的Redis不具备强一致的特性,导致开源Redis的应用也受到了诸多限制,为了解决开源Redis弱一致的问题,GaussDB(for Redis)应运而生。GaussDB(for Redis) 是华为云数据库团队自主研发的兼容Redis协议的云原生数据库,彻底解决了开源Redis一致性问题带来的痛点。4.1 高斯Redis架构高斯Redis的整体架构如下:相比开源Redis,高斯Redis采用存算分离的设计思想,计算层负责计算和协议的处理,聚焦服务。而存储层负责副本管理、扩缩容等处理,聚焦数据本身。高斯Redis的优势如下:数据强一致:存储层使用分布式存储DFV,轻松实现了3副本强一致;超可用:N个节点的集群最多可以挂掉N – 1个节点;低成本:数据采用磁盘存储并且进行压缩,每GB的成本不到开源Redis的十分之一;秒扩容:计算层仅需修改路由映射,无需数据搬迁,实现秒级扩容;自动备份:高斯Redis可以实现MVCC快照备份和定期自动备份。4.2 高斯Redis强一致的实现开源Redis和高斯Redis的架构如下图所示:5. 结语我们在做架构设计的时候,其实很多场景都隐藏着强一致的诉求。如朋友圈这类应用,如果没有实现强一致,朋友圈的评论很容易乱序。再比如限流器的场景,如果没有强一致的保证,也极容易造成数据库的崩溃。因此,必须在系统设计之初就认识到强一致的重要性,才能设计出更加稳定和可靠的系统。而高斯Redis基于存算分离的架构设计,实现了数据的强一致,为业务的稳定可靠提供了超强保障。
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签