-
 近期,华为云GaussDB(for Redis)缓存数据库再次推出全新版本,携新特性重磅来袭!GaussDB(for Redis)是华为云推出的企业级分布式KV数据库,它完全兼容Redis协议,提供丰富的数据类型,基于云原生存储计算分离架构,在成本、可靠性等方面为企业带来全新价值。 本次GaussDB(for Redis)推出的全新特性,不仅对基础性能和连接管理等进行了大幅优化,同时突破开源Redis短板,实现增强版前缀搜索和集群版多租隔离功能,前缀搜索时延较开源Redis降低千倍,为助力企业业务发展带来了更多可能。关键特性1:增强版前缀扫描,千倍性能提升GaussDB(for Redis)推出的增强版前缀扫描功能,优化了String、Hash、Set、Zset四种数据类型scan的前缀搜索。GaussDB(for Redis)的SCAN、HSCAN、SSCAN、ZSCAN命令在使用方法上与开源Redis完全兼容,但前缀匹配模式的性能更为优秀,从开源的耗时O(N)优化到O(logN + M)(其中N是整体数据量,M是匹配的数据量)。下面根据某客户实际场景,对比GaussDB(for Redis)和开源Redis的性能:数据:500w个key,均为String,范围为“1”~“5000000”, value大小为100B。命令:Scan 0 Match 499999* Count 100。在500w个key中搜索11个key。结果:开源Redis为7.67s ,GaussDB(for Redis)仅为2.92ms,快了2600倍,且开源Redis在返回搜索结果前返回了4.98w+次的空结果,而GaussDB(for Redis)第一次就返回了搜索结果。开源Redis:GaussDB(for Redis):在互联网业务中,诸如批量查找/删除一批相同前缀的key是很常见的业务场景,在上百万的数据量下,开源Redis的秒级时延显然是不可接受的。GaussDB(for Redis)针对这一场景进行了有效优化,将时延降低上千倍至毫秒级,带来了极致的性能体验。关键特性2:多租隔离,集群版业务数据隔离能力GaussDB(for Redis) 提供的多租隔离功能,允许用户为不同的业务创建不同的DB,实现不同业务数据隔离。使用方法上,GaussDB(for Redis)的多租隔离功能与开源Redis单机版本的多DB用法保持完全兼容(开源Redis集群版本不支持多DB)。用户可以通过SELECT DB来切换/新建不同的DB给不同的业务使用,通过FLUSHDB删除一个DB中的全部数据而不影响其他DB,从而高效地实现多租隔离效果。GaussDB(for Redis)多DB实现业务多租隔离GaussDB(for Redis)的多DB核心价值在于:集群版多DB:GaussDB(for Redis)集群版本可支持多DB;开源Redis的“多DB”只能用于单机,不支持集群。大规模多DB:GaussDB(for Redis)单实例支持65536个DB,搞定多业务多租隔离。高扩展性:开源Redis单机扩容到64G已经是极限,更不用说fork导致的容量利用率只有50%。GaussDB(for Redis)吞吐可水平扩展至百万QPS,容量支持12TB,解决了扩展性问题。低成本:GaussDB(for Redis)相比开源Redis,成本可降20%~70%。多租隔离是数据库的必备功能,在实际业务场景中,不同模块共享同一Redis实例是很常见的需求。GaussDB(for Redis)超越开源Redis,支持集群版本下的多DB,依托现有的秒级弹性扩缩容能力,在海量业务压力下仍能为客户提供灵活便捷的业务数据访问控制服务。目前,GaussDB(for Redis)已经凭借出色的产品实力在游戏系统、电商平台、推荐系统、社交媒体、物联网等众多企业级应用场景中发挥出巨大作用,而新推出的增强版前缀扫描与多租隔离两大功能特性,将以更优异的能力使企业在降本的同时实现增效,助力企业高效数字化!连接:https://bbs.huaweicloud.com/blogs/352808
-
近期,华为云GaussDB(for Redis)缓存数据库再次推出全新版本,携新特性重磅来袭!GaussDB(for Redis)是华为云推出的企业级分布式KV数据库,它完全兼容Redis协议,提供丰富的数据类型,基于云原生存储计算分离架构,在成本、可靠性等方面为企业带来全新价值。 本次GaussDB(for Redis)推出的全新特性,不仅对基础性能和连接管理等进行了大幅优化,同时突破开源Redis短板,实现增强版前缀搜索和集群版多租隔离功能,前缀搜索时延较开源Redis降低千倍,为助力企业业务发展带来了更多可能。关键特性1:增强版前缀扫描,千倍性能提升GaussDB(for Redis)推出的增强版前缀扫描功能,优化了String、Hash、Set、Zset四种数据类型scan的前缀搜索。GaussDB(for Redis)的SCAN、HSCAN、SSCAN、ZSCAN命令在使用方法上与开源Redis完全兼容,但前缀匹配模式的性能更为优秀,从开源的耗时O(N)优化到O(logN + M)(其中N是整体数据量,M是匹配的数据量)。下面根据某客户实际场景,对比GaussDB(for Redis)和开源Redis的性能:数据:500w个key,均为String,范围为“1”~“5000000”, value大小为100B。命令:Scan 0 Match 499999* Count 100。在500w个key中搜索11个key。结果:开源Redis为7.67s ,GaussDB(for Redis)仅为2.92ms,快了2600倍,且开源Redis在返回搜索结果前返回了4.98w+次的空结果,而GaussDB(for Redis)第一次就返回了搜索结果。开源Redis:GaussDB(for Redis):在互联网业务中,诸如批量查找/删除一批相同前缀的key是很常见的业务场景,在上百万的数据量下,开源Redis的秒级时延显然是不可接受的。GaussDB(for Redis)针对这一场景进行了有效优化,将时延降低上千倍至毫秒级,带来了极致的性能体验。关键特性2:多租隔离,集群版业务数据隔离能力GaussDB(for Redis) 提供的多租隔离功能,允许用户为不同的业务创建不同的DB,实现不同业务数据隔离。使用方法上,GaussDB(for Redis)的多租隔离功能与开源Redis单机版本的多DB用法保持完全兼容(开源Redis集群版本不支持多DB)。用户可以通过SELECT DB来切换/新建不同的DB给不同的业务使用,通过FLUSHDB删除一个DB中的全部数据而不影响其他DB,从而高效地实现多租隔离效果。GaussDB(for Redis)多DB实现业务多租隔离GaussDB(for Redis)的多DB核心价值在于:集群版多DB:GaussDB(for Redis)集群版本可支持多DB;开源Redis的“多DB”只能用于单机,不支持集群。大规模多DB:GaussDB(for Redis)单实例支持65536个DB,搞定多业务多租隔离。高扩展性:开源Redis单机扩容到64G已经是极限,更不用说fork导致的容量利用率只有50%。GaussDB(for Redis)吞吐可水平扩展至百万QPS,容量支持12TB,解决了扩展性问题。低成本:GaussDB(for Redis)相比开源Redis,成本可降20%~70%。多租隔离是数据库的必备功能,在实际业务场景中,不同模块共享同一Redis实例是很常见的需求。GaussDB(for Redis)超越开源Redis,支持集群版本下的多DB,依托现有的秒级弹性扩缩容能力,在海量业务压力下仍能为客户提供灵活便捷的业务数据访问控制服务。目前,GaussDB(for Redis)已经凭借出色的产品实力在游戏系统、电商平台、推荐系统、社交媒体、物联网等众多企业级应用场景中发挥出巨大作用,而新推出的增强版前缀扫描与多租隔离两大功能特性,将以更优异的能力使企业在降本的同时实现增效,助力企业高效数字化!连接:https://bbs.huaweicloud.com/blogs/352808
-
 个人无法免费试用,使用?
-
 创建1、首先 是找到使用页面 https://activity.huaweicloud.com/free_test/index.html2、全新注册用户,自行解决。(ps:需要邮箱认证,我的邮箱之前 注册过无法重复注册,原账号找回密码需要很多注册信息。。。,最后用guge的邮箱。。)3、点击0元试用 自动跳转到实例控制台,这里体验很流畅。4、点击实例列表名称进入 实例详情,一个月31天。这里开个玩笑,我买12个月 算31x12 不。。。好了进入主页面,咱们开始 详细的了解 华为云的redis实例详情如何了。二 详情页面详解1、基本信息采用arm架构,维护时间窗口默认帮用户设置了。这也是行业惯例。2、拓扑信息基本的主从架构,实例id 也是默认映射主节点的地址,一会可以连接实例看下支持的命令 和主从连接信息。3、连接信息连接信息访问方式免密访问连接地址redis-87f5d492-8b12-4d6f-9d6e-2984bec7e1af.cn-east-3.dcs.myhuaweicloud.com:6379只读地址redis-87f5d492-8b12-4d6f-9d6e-2984bec7e1af-readonly.cn-east-3.dcs.myhuaweicloud.com:6379IP地址172.31.201.38:6379公网访问查看文档我通过电脑自带的redis-cli 无法连接地址【 redis-87f5d492-8b12-4d6f-9d6e-2984bec7e1af.cn-east-3.dcs.myhuaweicloud.com 】,我以为是白名单的问题。然后在实例配置白名单配置里,设置自己的公网地址。(浏览器输入ip.cn,找到自己的公网地址),然后添加我的公网ip地址后 依然不可以访问。仔细 一看如下文字所示,也就是 说这里的配置只是vpc内部的连接白名单。所以,url连接不是用来公网访问的,而是用来内部dns定向访问的。比如不同的子网划分,不同的地址映射吧,这样可以无需修改应用的ip地址配置。您还没有添加任何白名单,所有与VPC互通的IP地址均可访问实例。若需要指定的IP地址才能访问,请将这些IP地址加入白名单。那么如何公网访问呢?连接如下,需要自己开一个云主机用nginx的tcp代理来 映射,6379端口,操作指南详见连接 使用Nginx实现公网访问Redis 4.0/5.0的单机/主备/Proxy集群实例_分布式缓存服务 DCS_最佳实践_华为云 (huaweicloud.com)然后返回体验页面 https://activity.huaweicloud.com/free_test/index.html。 这里开始白嫖一个云主机,发现云主机被体验光了。好吧,下一篇博客在细说 通过云主机的redis-cli连接。这里先小结下体验感受:由于我使用过谷歌 和 redislab的kv服务,国内阿里云的kv服务,体验这里给在国内比较给中上评价吧,如果在国际上就比较差了,连接地址和 只读地址 都是无法通过公网连接的。原因如下:redislabs的使用企业版 url连接自动连上,他是自动化的dbaas服务部署是通过调用aws的接口 创建小实例,并且是可以直接公网访问的。阿里的实例是可以自动开公网访问,并且做到了一个url地址既可以公网也可以内网,并且就在实例的详情主页里实例【公网访问】开通一点击就OK,设置完白名单可以很方便通过url了解访问。4、web console体验直接在概览页面右上角点击 【连接Redis】,跳转到 web的console页面。页面很简洁。页面有db信息,并且自动auth成功,推出当前实例定跳转到 实例列表页面。进行简单操作 set hw hwc,info all。回显如下信息set hw hwcOKinfo all# Server redis_version:5.0.14 patch_version:5.0.14.1 redis_git_sha1:00000000 redis_git_dirty:0 redis_build_id:0 redis_mode:standalone os:Linux arch_bits:64 multiplexing_api:epoll atomicvar_api:atomic-builtin gcc_version:0.0.0 process_id:1 run_id:a7b30d214bf934f5a3254a6596f0bd83dd5c850d tcp_port:2407 uptime_in_seconds:2539 uptime_in_days:0 hz:10 configured_hz:10 lru_clock:8266221 executable:redis-server config_file:redis.conf instance_id:87f5d492-8b12-4d6f-9d6e-2984bec7e1af # Clients connected_clients:7 client_recent_max_input_buffer:2 client_recent_max_output_buffer:0 blocked_clients:0 rx_controlled_clients:0 total_real_rx_controlled:0 total_tx_controlled:0 total_rx_controlled:0 proxy_header_error:0 # Memory used_memory:2341624 used_memory_human:2.23M used_memory_rss:9961472 used_memory_rss_human:9.50M used_memory_peak:2464272 used_memory_peak_human:2.35M used_memory_peak_perc:95.02% used_memory_overhead:2300662 used_memory_startup:1082800 used_memory_dataset:40962 used_memory_dataset_perc:3.25% allocator_allocated:2725304 allocator_active:3088384 allocator_resident:19886080 total_system_memory:1081361883136 total_system_memory_human:1007.10G used_memory_lua:37888 used_memory_lua_human:37.00K used_memory_scripts:0 used_memory_scripts_human:0B number_of_cached_scripts:0 maxmemory:268435456 maxmemory_human:256.00M maxmemory_policy:volatile-lru allocator_frag_ratio:1.13 allocator_frag_bytes:363080 allocator_rss_ratio:6.44 allocator_rss_bytes:16797696 rss_overhead_ratio:0.50 rss_overhead_bytes:-9924608 mem_fragmentation_ratio:4.29 mem_fragmentation_bytes:7641792 mem_not_counted_for_evict:106 mem_replication_backlog:1048576 mem_clients_slaves:17042 mem_clients_normal:152066 mem_aof_buffer:106 mem_allocator:jemalloc-5.1.0 active_defrag_running:0 lazyfree_pending_objects:0 # Persistence loading:0 rdb_changes_since_last_save:1 rdb_bgsave_in_progress:0 rdb_last_save_time:1652430851 rdb_last_bgsave_status:ok rdb_last_bgsave_time_sec:0 rdb_current_bgsave_time_sec:-1 rdb_last_cow_size:299008 aof_enabled:1 aof_rewrite_in_progress:0 aof_rewrite_scheduled:0 aof_last_rewrite_time_sec:-1 aof_current_rewrite_time_sec:-1 aof_last_bgrewrite_status:ok aof_last_write_status:ok aof_last_cow_size:0 aof_current_size:53 max_aof_size:1342177280 aof_base_size:0 aof_pending_rewrite:0 aof_buffer_length:0 aof_rewrite_buffer_length:0 aof_pending_bio_fsync:0 total_aof_write_error:0 aof_delayed_fsync:0 # Stats total_connections_received:717 total_commands_processed:15038 instantaneous_ops_per_sec:5 total_net_input_bytes:889498 total_net_output_bytes:8147140 instantaneous_input_kbps:0.41 instantaneous_output_kbps:1.32 rejected_connections:0 sync_full:1 sync_partial_ok:0 sync_partial_err:0 expired_keys:0 expired_stale_perc:0.00 expired_time_cap_reached_count:0 evicted_keys:0 keyspace_hits:0 keyspace_misses:0 pubsub_channels:1 pubsub_patterns:0 latest_fork_usec:432 migrate_cached_sockets:0 slave_expires_tracked_keys:0 active_defrag_hits:0 active_defrag_misses:0 active_defrag_key_hits:0 active_defrag_key_misses:0 # Replication role:master connected_slaves:1 slave0:ip=192.168.30.31,port=3184,state=online,offset=663452,lag=0 master_replid:c07fd7bb03ad6d1628cde2f017a34d22ea8b36d0 master_replid2:0000000000000000000000000000000000000000 master_repl_offset:663629 second_repl_offset:-1 repl_backlog_active:1 repl_backlog_size:1048576 repl_backlog_first_byte_offset:1 repl_backlog_histlen:663629 # CPU used_cpu_sys:1.036002 used_cpu_user:2.197352 used_cpu_sys_children:0.000000 used_cpu_user_children:0.002273 # Commandstats cmdstat_dcs.getBandwidth:calls=2,usec=16,usec_per_call=8.00 cmdstat_publish:calls=3722,usec=21106,usec_per_call=5.67 cmdstat_ping:calls=7298,usec=9439,usec_per_call=1.29 cmdstat_replconf:calls=2536,usec=4751,usec_per_call=1.87 cmdstat_set:calls=1,usec=10,usec_per_call=10.00 cmdstat_command:calls=4,usec=2607,usec_per_call=651.75 cmdstat_client:calls=6,usec=10,usec_per_call=1.67 cmdstat_subscribe:calls=3,usec=11,usec_per_call=3.67 cmdstat_info:calls=1399,usec=109527,usec_per_call=78.29 cmdstat_config:calls=23,usec=428,usec_per_call=18.61 cmdstat_slowlog:calls=43,usec=227,usec_per_call=5.28 cmdstat_psync:calls=1,usec=595,usec_per_call=595.00 # Cluster cluster_enabled:0 # Keyspace db0:keys=1,expires=0,avg_ttl=0在输入 config get * 看看配置信息config get *dbfilename redis.rdb requirepass masterauth cluster-announce-ip unixsocket /opt/redis/redis.sock logfile /var/log/redis.log pidfile /opt/redis/redis.pid slave-announce-ip replica-announce-ip maxmemory 268435456 max-aof-memory-multiplier 5 max-aof-size 1342177280 proto-max-bulk-len 536870912 client-query-buffer-limit 1073741824 maxmemory-samples 5 lfu-log-factor 10 lfu-decay-time 1 timeout 0 active-defrag-threshold-lower 10 active-defrag-threshold-upper 100 active-defrag-ignore-bytes 104857600 active-defrag-cycle-min 5 active-defrag-cycle-max 75 active-defrag-max-scan-fields 1000 auto-aof-rewrite-percentage 0 auto-aof-rewrite-min-size 67108864 hash-max-ziplist-entries 512 hash-max-ziplist-value 64 stream-node-max-bytes 4096 stream-node-max-entries 100 list-max-ziplist-size -2 list-compress-depth 0 set-max-intset-entries 512 zset-max-ziplist-entries 128 zset-max-ziplist-value 64 hll-sparse-max-bytes 3000 lua-time-limit 5000 slowlog-log-slower-than 10000 latency-monitor-threshold 0 slowlog-max-len 128 port 2407 cluster-announce-port 0 cluster-announce-bus-port 0 tcp-backlog 10000 databases 256 repl-ping-slave-period 10 repl-ping-replica-period 10 repl-timeout 60 repl-backlog-size 1048576 repl-backlog-ttl 3600 maxclients 10010 watchdog-period 0 slave-priority 100 replica-priority 100 slave-announce-port 0 replica-announce-port 0 min-slaves-to-write 0 min-replicas-to-write 0 min-slaves-max-lag 10 min-replicas-max-lag 10 hz 10 cluster-node-timeout 15000 cluster-migration-barrier 1 cluster-slave-validity-factor 10 cluster-replica-validity-factor 10 repl-diskless-sync-delay 5 tcp-keepalive 30 incremental-eviction-num 65535 active-expire-num 20 active-expire-cycle-slow-time-perc 25 cluster-require-full-coverage yes cluster-slave-no-failover no cluster-replica-no-failover no no-appendfsync-on-rewrite yes slave-serve-stale-data yes replica-serve-stale-data yes slave-read-only yes replica-read-only yes slave-ignore-maxmemory yes replica-ignore-maxmemory yes stop-writes-on-bgsave-error yes daemonize no rdbcompression no rdbchecksum yes activerehashing yes activedefrag no protected-mode no repl-disable-tcp-nodelay no repl-diskless-sync no aof-rewrite-incremental-fsync yes rdb-save-incremental-fsync yes aof-load-truncated yes aof-use-rdb-preamble yes lazyfree-lazy-eviction yes lazyfree-lazy-expire yes lazyfree-lazy-server-del yes slave-lazy-flush yes replica-lazy-flush yes dynamic-hz yes master-read-only no vpc-endpoint-proxy-header no tenant-sync no enable-write-protection no maxmemory-policy volatile-lru loglevel notice supervised no appendfsync no syslog-facility local0 appendonly yes dir /opt/redis save client-output-buffer-limit normal 0 0 0 slave 26843545 26843545 60 pubsub 33554432 8388608 60 unixsocketperm 600 slaveof notify-keyspace-events xE bind 192.168.36.137使用小结:由于带了控制台功能,那么开云主机的需要就不那么紧要了,客户几乎可以执行所有的可配置的 命令。命令支持的也很全面原文连接:https://bbs.huaweicloud.com/blogs/352815
-
BleepingComputer 网站消息,威胁情报和研究公司 Group-IB 共享的一份报告中显示,公开暴露在互联网上的数据库数量近期有所增加 ,从 2021 年的 308000 个持续增长,截至 2022 年第一季度,暴露的数据库峰值数量已达 91200 个,创造了历史记录。在大多数情况下,数据库被公开至网络是由于配置错误的原因造成,黑客常常使用可从开放网络访问的搜索引擎索引系统来寻找这些数据库,以窃取内容或进行金融勒索。Group-IB 使用其攻击面管理解决方案扫描整个 IPv4 空间来查找与访问数据库相关的开放端口,并检查索引或表是否可用。Group-IB 的攻击面管理产品负责人 Tim Bobak 告诉 BleepingComputer,该公司的解决方案仅限于检查数据库是否暴露,不会收集或分析数据库内容。以这种方式收集的遥测数据不会显示开放数据库是否容易受到安全漏洞的影响,或者未经授权的一方是否在暴露在网络上时访问了它们。中美数据库占比最多Group-IB 发现,大多数暴露的数据库都位于美国和中国服务器,德国、法国和印度也占很多。在暴露实例中使用的数据库管理系统中,今年一季度的暴露数量最多的是 Redis,是排名第二的 MongoDB 的近两倍, MySQL 则占比较少。目前这些管理系统已采取措施,在管理员将实例配置为无需密码即可公开访问时会对管理员进行提醒,但目前问题仍然存在。专攻数据库安全的安全研究员 Bob Diachenko 告诉 Bleeping Computer:目前一些数据库供应商引入的 dbms (数据库管理系统)越复杂,反而越容易出现配置错误,从而在无意中暴露数据。他认为,数据库的目的不仅是存储数据,而且还允许以即时和便捷的方式共享这些数据,并由其他团队成员对其进行分析,如今,越来越多的人参与到数据库管理过程中,为了试图简化和加快访问速度,甚至对登录措施进行了省略。同时,管理员平均需要 170 天的时间来发现错误配置并修复暴露问题,这足以让恶意行为者找到实例并窃取其内容。预防措施Group-IB 的 Bobak 指出,大多数困扰数据库安全的问题都可以轻松预防。如果管理员在设置和维护数据库时遵循特定关键措施,则可以确保数据库安全。总结为以下几点:如无必要,确保数据库不公开;使数据库管理系统保持最新版本,以减少可利用的缺陷;使用强用户身份验证;为所有存储的信息部署强大的数据加密协议;使用采用数据包过滤器、数据包检查和代理的数据库和 Web 应用程序防火墙;使用实时数据库监控;避免使用将数据库暴露给恶意扫描的默认网络端口;尽可能遵循服务器分段做法;以加密形式对数据进行离线备份。
-
 本文分享自华为云社区《秒杀系统架构设计都有哪些关键点?》,作者:JavaEdge 。 # 0、目标 - 秒杀重复排队 重复排队:一个人抢购商品,若未支付,不准重复排队抢购 - 超卖问题 1个商品卖给多个人:1商品多订单 - 秒杀订单支付 秒杀支付:支付流程调整 - 超时未支付订单,库存回滚 1.RabbitMQ延时队列 2.利用延时队列实现支付订单的监听,根据订单支付状况进行订单数据库回滚 # 1、防止重复排队 用户每次抢单时,一旦排队,设置个自增值,让该值的初始值为1。 每次进入抢单时,对其递增,若值>1,则表明已排队,为禁止重复排队,直接对外抛异常信息xxx表示已在排队。 ## 1.1 后台排队记录 修改SeckillOrderServiceImpl#add方法,新增递增值判断是否已排队: 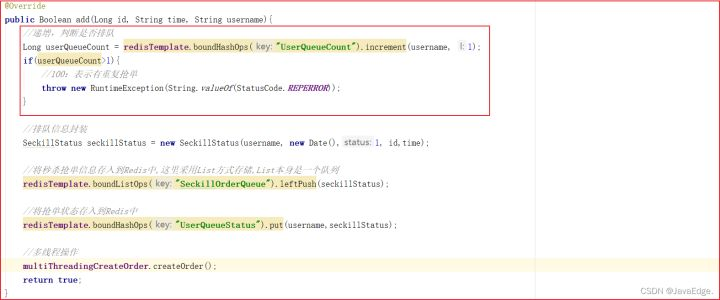 //递增,判断是否排队 Long userQueueCount = redisTemplate.boundHashOps("UserQueueCount").increment(username, 1); if(userQueueCount>1){ // 有重复抢单 throw new RuntimeException(String.valueOf(StatusCode.REPERROR)); } # 2、超卖问题 多人抢购同一商品时,多人同时判断是否有库存,若只剩一个,则都会判断有库存,此时会导致超卖,即一个商品被下了多个订单。 ## 2.1 思路分析 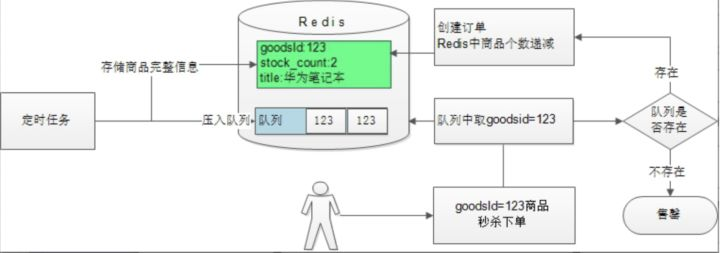 利用Redis list队列,给每件商品创建一个独立的商品个数队列,如:A商品有2个,A商品的ID为1001,则创建一个list,key=SeckillGoodsCountList_1001,往该队列中塞2次该商品ID。 每次给用户下单时,先从队列取数据: - 能取到数据 有库存 - 取不到 无库存 这就防止了超卖。 操作Redis大部分都是先查出数据查,在内存中修改,然后存入Redis。高并发下就有数据错乱问题,为控制数量准确,单独将商品数量整个自增键,自增键是线程安全的,无需担心并发问题。  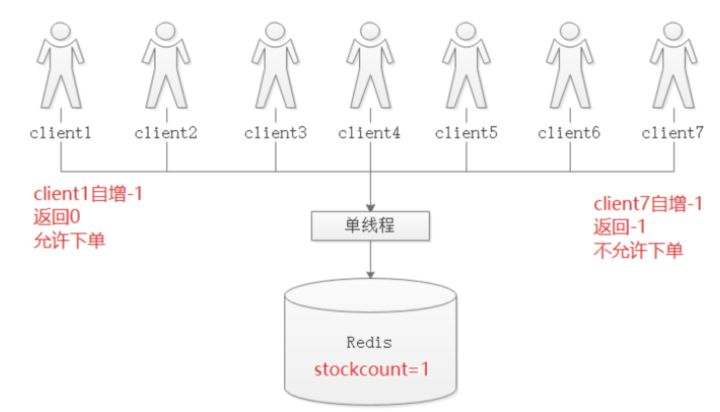 ## 2.2 代码 每次将商品压入Redis时,创建一个商品队列。 修改SeckillGoodsPushTask,添加一个pushIds方法,用于将指定商品ID放入到指定数字: /*** * 将商品ID存入到数组中 * @param len:长度 * @param id :值 * @return */ public Long[] pushIds(int len,Long id){ Long[] ids = new Long[len]; for (int i = 0; i } return ids; } SeckillGoodsPushTask#loadGoodsPushRedis,添加队列操作: 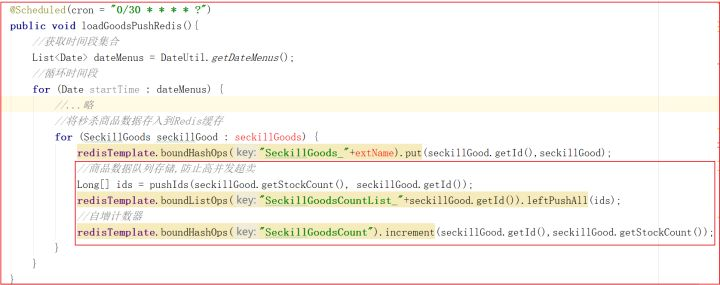 ## 2.3 防止超卖 修改多线程下单方法,分别修改数量控制,以及售罄后用户抢单排队信息的清理: 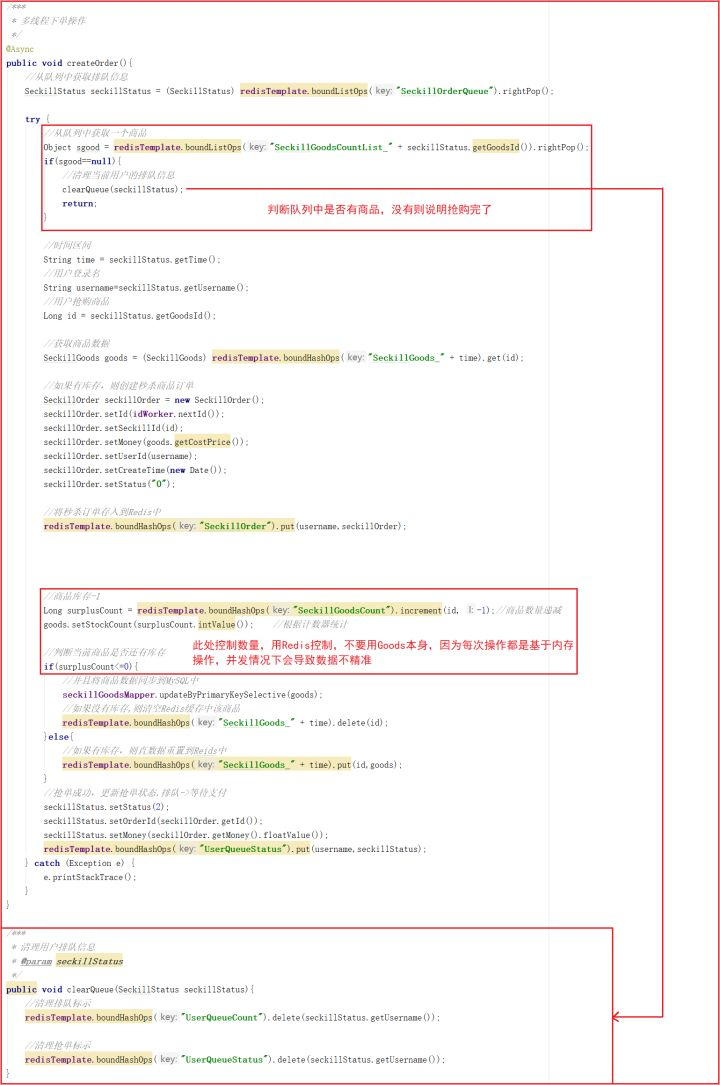 # 3、订单支付 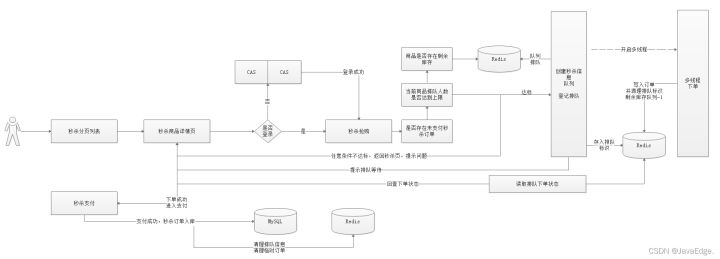 完成秒杀下订单后,进入支付页面,此时前端会每3s向后台发送一次请求,判断当前用户订单是否完成支付: 若完成支付,则清理排队信息,并修改订单状态。 ## 3.1 创建支付二维码 下单成功后,会跳转到支付选择页面,在支付选择页面要显示订单编号和订单金额,所以我们需要在下单的时候,将订单金额以及订单编号信息存储到用户查询对象。 选择微信支付后,会跳转到微信支付页面,微信支付页面会根据用户名查看用户秒杀订单,并根据用户秒杀订单的ID创建预支付信息并获取二维码信息,展示给用户看,此时页面每3秒查询一次支付状态,如果支付成功,需要修改订单状态信息。 ### 3.1.1 回显订单号、金额 下单后,进入支付选择页面,需显示订单号和订单金额,所以需要在用户下单后将该数据传入到pay.html页面,所以查询订单状态时,需要将订单号和金额封装到查询的信息中,修改查询订单装的方法加入他们。 修改SeckillOrderController#queryStatus: 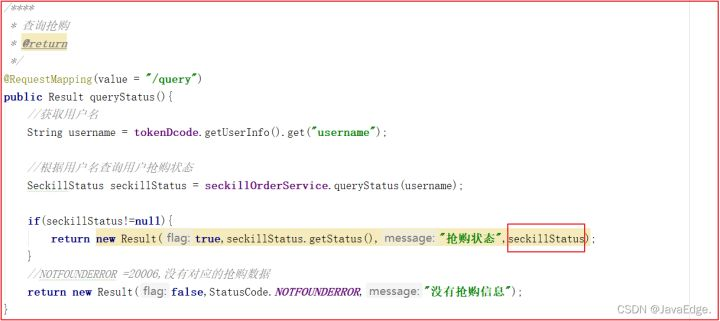 测试: 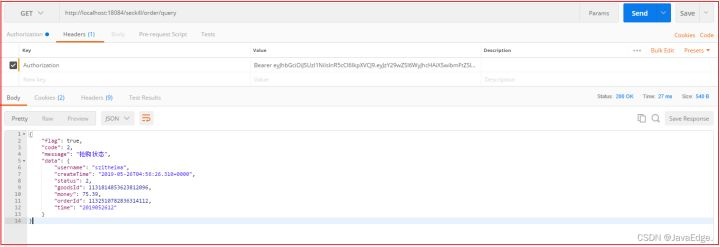 ### 3.1.2 创建二维码 用户创建二维码,可以先查询用户的秒杀订单抢单信息,然后再发送请求到支付微服务中创建二维码,将订单编号以及订单对应的金额传递到支付微服务:/weixin/pay/create/native。 使用Postman测试效果如下: 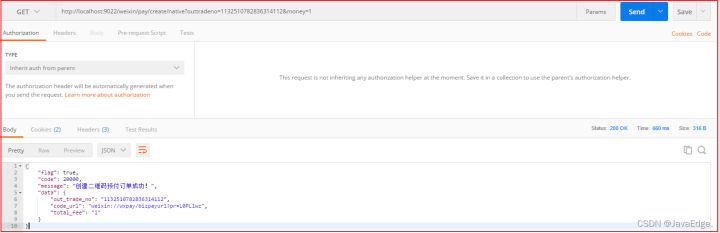 ## 3.2 支付流程分析 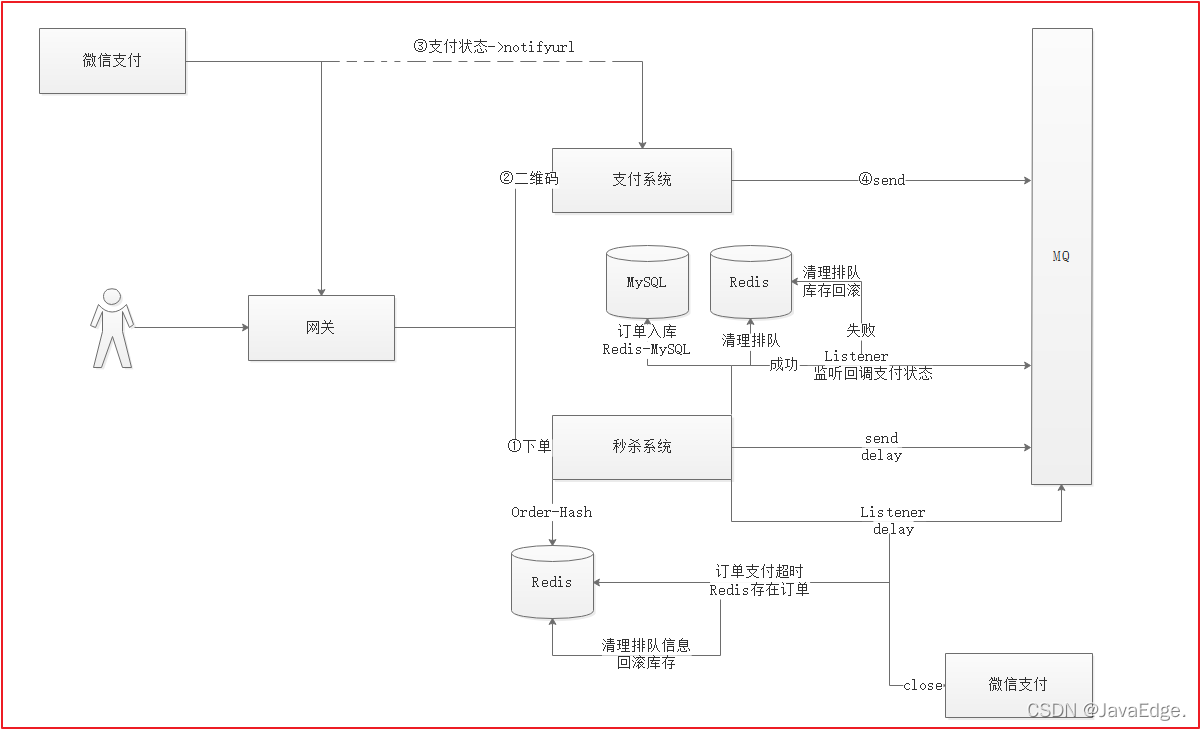 1. 用户抢单,经过秒杀系统实现抢单,下单后会将向MQ发送一个延时消息,包含抢单信息 2. 秒杀系统同时启用延时消息监听,一旦监听到订单抢单信息,判断Redis缓存中是否存在订单信息,若存在,则回滚 3. 秒杀系统启动监听支付回调信息。若支付完成,则将订单持久化到MySQL,如果没完成,清理排队信息,回滚库存 4. 每次秒杀下单后调用支付系统,创建二维码。若用户支付成功,微信系统会将支付信息发给支付系统指定的回调地址,支付系统收到信息后,将信息发给MQ,第3个步骤就能监听到消息。 ## 3.3 支付回调更新 支付回调这一块代码已经实现了,但之前实现的是订单信息的回调数据发送给MQ,指定了对应队列,不过现在需要实现的是秒杀信息发送给指定队列,所以之前的代码那块需要动态指定队列。 ### 3.3.1 支付回调队列指定 创建支付二维码需要指定队列 回调地址回调时,获取支付二维码指定的队列,将支付信息发到指定队列 在微信支付统一下单API中,有个附加参数: `attach:附加数据,String(127),在查询API和支付通知中原样返回,可作为自定义参数使用。` 可在创建二维码时,设置该参数以指定回调支付信息的对应队列,每次回调时,会获取该参数,然后将回调信息发到该参数对应的队列。 #### 3.3.1.1 改造支付方法 修改支付微服务的WeixinPayController#createNative: 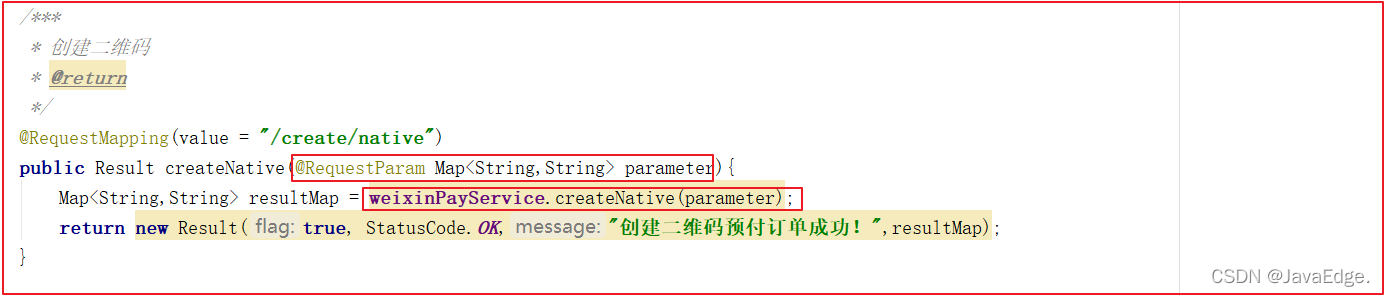 修改支付微服务的WeixinPayService#createNative: 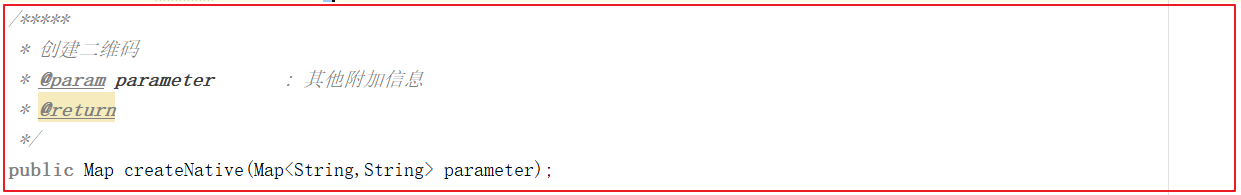 修改支付微服务的WeixinPayServiceImpl#createNative: 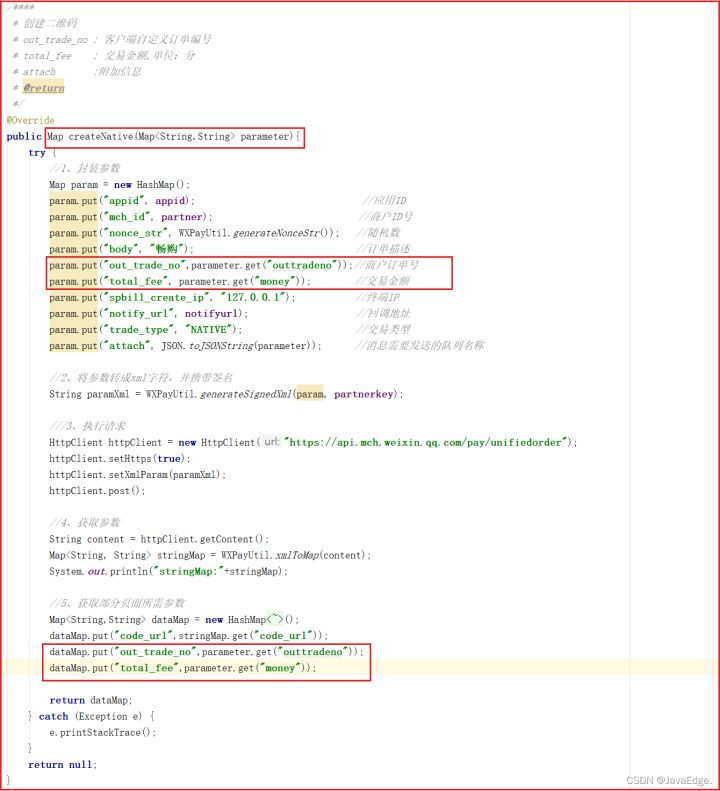 创建二维码时,传递如下参数 - username,用户名 可根据用户名,查询用户排队信息 - outtradeno商户订单号 下单必需 - money,支付金额 支付必需 - queue,队列名字 回调时,可知将支付信息发送到哪个队列 修改WeixinPayApplication,添加对应队列以及对应交换机绑定,代码如下: @SpringBootApplication @EnableEurekaClient @EnableFeignClients public class WeixinPayApplication { public static void main(String[] args) { SpringApplication.run(WeixinPayApplication.class,args); } @Autowired private Environment env; // 创建DirectExchange交换机 @Bean public DirectExchange basicExchange(){ return new DirectExchange(env.getProperty("mq.pay.exchange.order"), true,false); } // 创建队列 @Bean(name = "queueOrder") public Queue queueOrder(){ return new Queue(env.getProperty("mq.pay.queue.order"), true); } // 创建秒杀队列 @Bean(name = "queueSeckillOrder") public Queue queueSeckillOrder(){ return new Queue(env.getProperty("mq.pay.queue.seckillorder"), true); } // 队列绑定到交换机上 @Bean public Binding basicBindingOrder(){ return BindingBuilder .bind(queueOrder()) .to(basicExchange()) .with(env.getProperty("mq.pay.routing.orderkey")); } // 队列绑定到交换机 @Bean public Binding basicBindingSeckillOrder(){ return BindingBuilder .bind(queueSeckillOrder()) .to(basicExchange()) .with(env.getProperty("mq.pay.routing.seckillorderkey")); } } 修改application.yml,添加如下配置 #位置支付交换机和队列 mq: pay: exchange: order: exchange.order seckillorder: exchange.seckillorder queue: order: queue.order seckillorder: queue.seckillorder routing: key: queue.order seckillkey: queue.seckillorder #### 3.3.1.2 测试 创建二维码测试 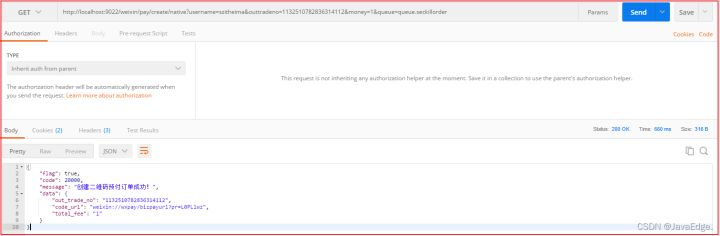 以后每次支付,都需要带上对应的参数,包括前面的订单支付。 #### 3.3.1.3 改造支付回调方法 修改WeixinPayController#notifyUrl,获取自定义参数,并转成Map,获取queue地址,并将支付信息发送到绑定的queue: 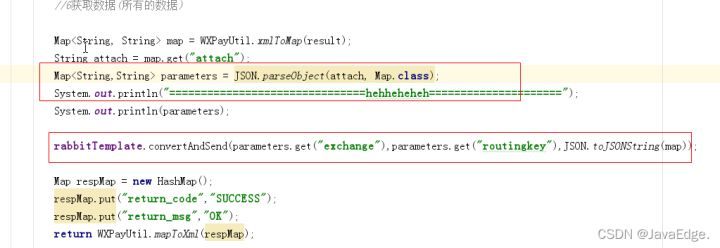 ### 3.3.2 支付状态监听 支付状态通过回调地址发给MQ后,需要在秒杀系统中监听支付信息: - 支付成功,修改用户订单状态 - 支付失败,删除订单,回滚库存。 SeckillOrderPayMessageListener监听消息: @Component @RabbitListener(queues = "${mq.pay.queue.seckillorder}") public class SeckillOrderPayMessageListener { // 监听消费消息 @RabbitHandler public void consumeMessage(@Payload String message) { System.out.println(message); // 将消息转换成Map对象 Map resultMap = JSON.parseObject(message,Map.class); System.out.println("监听到的消息:"+resultMap); } } 修改SeckillApplication创建对应的队列以及绑定对应交换机。 @SpringBootApplication @EnableEurekaClient @EnableFeignClients @MapperScan(basePackages = {"com.changgou.seckill.dao"}) @EnableScheduling @EnableAsync public class SeckillApplication { public static void main(String[] args) { SpringApplication.run(SeckillApplication.class,args); } @Bean public IdWorker idWorker(){ return new IdWorker(1,1); } @Autowired private Environment env; /*** * 创建DirectExchange交换机 * @return */ @Bean public DirectExchange basicExchange(){ return new DirectExchange(env.getProperty("mq.pay.exchange.order"), true,false); } /*** * 创建队列 * @return */ @Bean(name = "queueOrder") public Queue queueOrder(){ return new Queue(env.getProperty("mq.pay.queue.order"), true); } /*** * 创建秒杀队列 * @return */ @Bean(name = "queueSeckillOrder") public Queue queueSeckillOrder(){ return new Queue(env.getProperty("mq.pay.queue.seckillorder"), true); } /**** * 队列绑定到交换机上 * @return */ @Bean public Binding basicBindingOrder(){ return BindingBuilder .bind(queueOrder()) .to(basicExchange()) .with(env.getProperty("mq.pay.routing.orderkey")); } /**** * 队列绑定到交换机上 * @return */ @Bean public Binding basicBindingSeckillOrder(){ return BindingBuilder .bind(queueSeckillOrder()) .to(basicExchange()) .with(env.getProperty("mq.pay.routing.seckillorderkey")); } } 添加配置: #位置支付交换机和队列 mq: pay: exchange: order: exchange.order seckillorder: exchange.seckillorder queue: order: queue.order seckillorder: queue.seckillorder routing: key: queue.order seckillkey: queue.seckillorder ### 3.3.3 修改订单状态 监听到支付信息后,根据支付信息判断,如果用户支付成功,则修改订单信息,并将订单入库,删除用户排队信息,如果用户支付失败,则删除订单信息,回滚库存,删除用户排队信息。 #### 3.3.3.1 业务层 修改SeckillOrderService,添加修改订单方法: /*** * 更新订单状态 */ @Override public void updatePayStatus(String out_trade_no, String transaction_id,String username) { //订单数据从Redis数据库查询出来 SeckillOrder seckillOrder = (SeckillOrder) redisTemplate.boundHashOps("SeckillOrder").get(username); //修改状态 seckillOrder.setStatus("1"); //支付时间 seckillOrder.setPayTime(new Date()); //同步到MySQL中 seckillOrderMapper.insertSelective(seckillOrder); //清空Redis缓存 redisTemplate.boundHashOps("SeckillOrder").delete(username); //清空用户排队数据 redisTemplate.boundHashOps("UserQueueCount").delete(username); //删除抢购状态信息 redisTemplate.boundHashOps("UserQueueStatus").delete(username); } #### 3.3.3.2 修改订单对接 修改微信支付状态监听的代码,当用户支付成功后,修改订单状态: 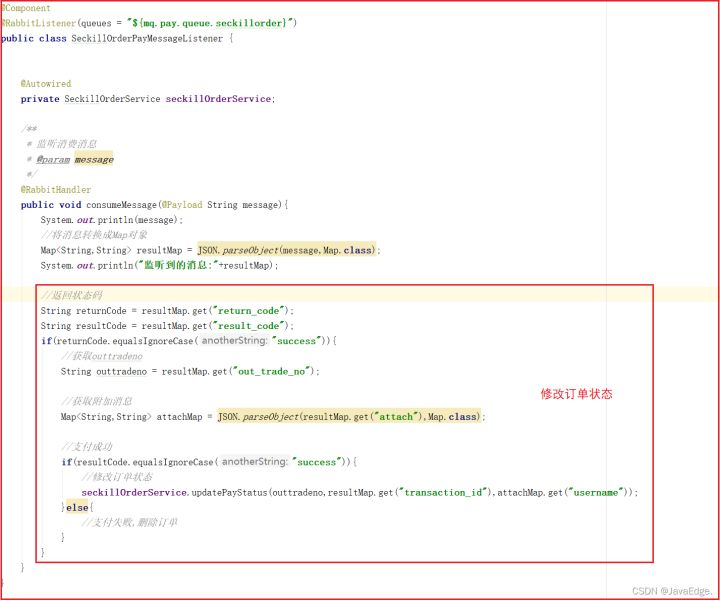 ### 3.3.4 删除订单回滚库存 如果用户支付失败,我们需要删除用户订单数据,并回滚库存。关闭订单: /*** * 关闭订单,回滚库存 */ @Override public void closeOrder(String username) { //将消息转换成SeckillStatus SeckillStatus seckillStatus = (SeckillStatus) redisTemplate.boundHashOps("UserQueueStatus").get(username); //获取Redis中订单信息 SeckillOrder seckillOrder = (SeckillOrder) redisTemplate.boundHashOps("SeckillOrder").get(username); //如果Redis中有订单信息,说明用户未支付 if(seckillStatus!=null && seckillOrder!=null){ //删除订单 redisTemplate.boundHashOps("SeckillOrder").delete(username); //回滚库存 //1)从Redis中获取该商品 SeckillGoods seckillGoods = (SeckillGoods) redisTemplate.boundHashOps("SeckillGoods_"+seckillStatus.getTime()).get(seckillStatus.getGoodsId()); //2)如果Redis中没有,则从数据库中加载 if(seckillGoods==null){ seckillGoods = seckillGoodsMapper.selectByPrimaryKey(seckillStatus.getGoodsId()); } //3)数量+1 (递增数量+1,队列数量+1) Long surplusCount = redisTemplate.boundHashOps("SeckillGoodsCount").increment(seckillStatus.getGoodsId(), 1); seckillGoods.setStockCount(surplusCount.intValue()); redisTemplate.boundListOps("SeckillGoodsCountList_" + seckillStatus.getGoodsId()).leftPush(seckillStatus.getGoodsId()); //4)数据同步到Redis中 redisTemplate.boundHashOps("SeckillGoods_"+seckillStatus.getTime()).put(seckillStatus.getGoodsId(),seckillGoods); //清理排队标示 redisTemplate.boundHashOps("UserQueueCount").delete(seckillStatus.getUsername()); //清理抢单标示 redisTemplate.boundHashOps("UserQueueStatus").delete(seckillStatus.getUsername()); } } #### 3.3.4.1 调用删除订单 SeckillOrderPayMessageListener,在用户支付失败后调用关闭订单: //支付失败,删除订单 seckillOrderService.closeOrder(attachMap.get("username")); 支付微服务 server: port: 9022 spring: application: name: pay main: allow-bean-definition-overriding: true rabbitmq: host: 127.0.0.1 #mq的服务器地址 username: guest #账号 password: guest #密码 eureka: client: service-url: defaultZone: http://127.0.0.1:6868/eureka instance: prefer-ip-address: true feign: hystrix: enabled: true #hystrix 配置 hystrix: command: default: execution: timeout: #如果enabled设置为false,则请求超时交给ribbon控制 enabled: true isolation: strategy: SEMAPHORE #微信支付信息配置 weixin: appid: wx8397f8696b538317 partner: 1473426802 partnerkey: T6m9iK73b0kn9g5v426MKfHQH7X8rKwb notifyurl: http://2cw4969042.wicp.vip:36446/weixin/pay/notify/url #位置支付交换机和队列 mq: pay: exchange: order: exchange.order queue: order: queue.order seckillorder: queue.seckillorder routing: orderkey: queue.order seckillorderkey: queue.seckillorder 秒杀微服务配置 server: port: 18084 spring: application: name: seckill datasource: driver-class-name: com.mysql.jdbc.Driver url: jdbc:mysql://127.0.0.1:3306/changgou_seckill?useUnicode=true&characterEncoding=UTF-8&serverTimezone=UTC username: root password: itcast rabbitmq: host: 127.0.0.1 #mq的服务器地址 username: guest #账号 password: guest #密码 main: allow-bean-definition-overriding: true eureka: client: service-url: defaultZone: http://127.0.0.1:6868/eureka instance: prefer-ip-address: true feign: hystrix: enabled: true mybatis: configuration: map-underscore-to-camel-case: true mapper-locations: classpath:mapper/*Mapper.xml type-aliases-package: com.changgou.seckill.pojo #hystrix 配置 hystrix: command: default: execution: timeout: #如果enabled设置为false,则请求超时交给ribbon控制 enabled: true isolation: thread: timeoutInMilliseconds: 10000 strategy: SEMAPHORE #位置支付交换机和队列 mq: pay: exchange: order: exchange.order queue: order: queue.order seckillorder: queue.seckillorder routing: orderkey: queue.order seckillorderkey: queue.seckillorder # 4、库存回滚 ## 4.1 秒杀流程回顾 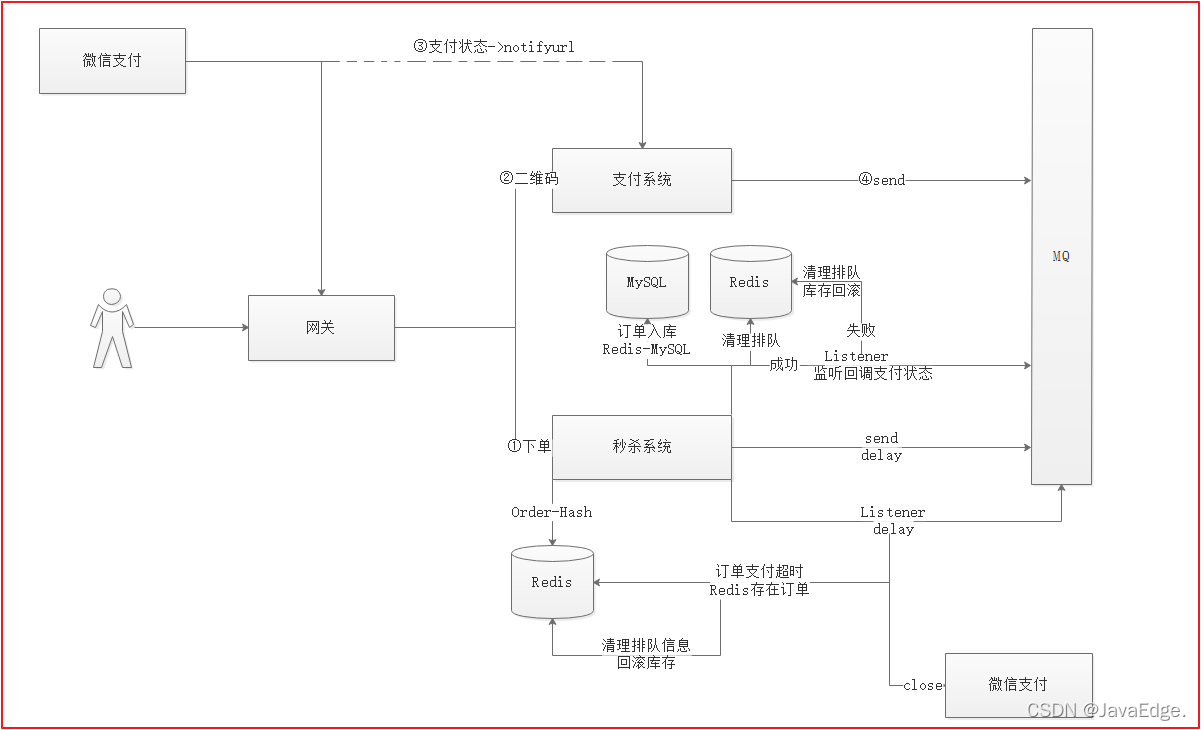 1.用户抢单,经过秒杀系统实现抢单,下单后会将向MQ发送一个延时队列消息,包含抢单信息,延时半小时后才能监听到 2.秒杀系统同时启用延时消息监听,一旦监听到订单抢单信息,判断Redis缓存中是否存在订单信息,如果存在,则回滚 3.秒杀系统还启动支付回调信息监听,如果支付完成,则将订单吃句话到MySQL,如果没完成,清理排队信息回滚库存 4.每次秒杀下单后调用支付系统,创建二维码,如果用户支付成功了,微信系统会将支付信息发送给支付系统指定的回调地址,支付系统收到信息后,将信息发送给MQ,第3个步骤就可以监听到消息了。 延时队列实现订单关闭回滚库存: 1.创建一个过期队列 Queue1 2.接收消息的队列 Queue2 3.中转交换机 4.监听Queue2 1)SeckillStatus->检查Redis中是否有订单信息 2)如果有订单信息,调用删除订单回滚库存->[需要先关闭微信支付] 3)如果关闭订单时,用于已支付,修改订单状态即可 4)如果关闭订单时,发生了别的错误,记录日志,人工处理 ## 4.2 关闭支付 用户如果半个小时没有支付,我们会关闭支付订单,但在关闭之前,需要先关闭微信支付,防止中途用户支付。 修改支付微服务的WeixinPayService,添加关闭支付方法,代码如下: /*** * 关闭支付 * @param orderId * @return */ Map closePay(Long orderId) throws Exception; 修改WeixinPayServiceImpl,实现关闭微信支付方法,代码如下: /*** * 关闭微信支付 * @param orderId * @return * @throws Exception */ @Override public Map closePay(Long orderId) throws Exception { //参数设置 Map paramMap = new HashMap(); paramMap.put("appid",appid); //应用ID paramMap.put("mch_id",partner); //商户编号 paramMap.put("nonce_str",WXPayUtil.generateNonceStr());//随机字符 paramMap.put("out_trade_no",String.valueOf(orderId)); //商家的唯一编号 //将Map数据转成XML字符 String xmlParam = WXPayUtil.generateSignedXml(paramMap,partnerkey); //确定url String url = "https://api.mch.weixin.qq.com/pay/closeorder"; //发送请求 HttpClient httpClient = new HttpClient(url); //https httpClient.setHttps(true); //提交参数 httpClient.setXmlParam(xmlParam); //提交 httpClient.post(); //获取返回数据 String content = httpClient.getContent(); //将返回数据解析成Map return WXPayUtil.xmlToMap(content); } ## 4.3 关闭订单回滚库存 ### 4.3.1 配置延时队列 在application.yml文件中引入队列信息配置,如下: #位置支付交换机和队列 mq: pay: exchange: order: exchange.order queue: order: queue.order seckillorder: queue.seckillorder seckillordertimer: queue.seckillordertimer seckillordertimerdelay: queue.seckillordertimerdelay routing: orderkey: queue.order seckillorderkey: queue.seckillorder 配置队列与交换机,在SeckillApplication中添加如下方法 /** * 到期数据队列 * @return */ @Bean public Queue seckillOrderTimerQueue() { return new Queue(env.getProperty("mq.pay.queue.seckillordertimer"), true); } /** * 超时数据队列 * @return */ @Bean public Queue delaySeckillOrderTimerQueue() { return QueueBuilder.durable(env.getProperty("mq.pay.queue.seckillordertimerdelay")) .withArgument("x-dead-letter-exchange", env.getProperty("mq.pay.exchange.order")) // 消息超时进入死信队列,绑定死信队列交换机 .withArgument("x-dead-letter-routing-key", env.getProperty("mq.pay.queue.seckillordertimer")) // 绑定指定的routing-key .build(); } /*** * 交换机与队列绑定 * @return */ @Bean public Binding basicBinding() { return BindingBuilder.bind(seckillOrderTimerQueue()) .to(basicExchange()) .with(env.getProperty("mq.pay.queue.seckillordertimer")); } ### 4.3.2 发送延时消息 修改MultiThreadingCreateOrder,添加如下方法: /*** * 发送延时消息到RabbitMQ中 * @param seckillStatus */ public void sendTimerMessage(SeckillStatus seckillStatus){ rabbitTemplate.convertAndSend(env.getProperty("mq.pay.queue.seckillordertimerdelay"), (Object) JSON.toJSONString(seckillStatus), new MessagePostProcessor() { @Override public Message postProcessMessage(Message message) throws AmqpException { message.getMessageProperties().setExpiration("10000"); return message; } }); } 在createOrder方法中调用上面方法,如下代码: //发送延时消息到MQ中 sendTimerMessage(seckillStatus);
-
1.String 字符串类型是redis中最基本的数据类型,一个key对应一个value。String类型是二进制安全的,意思是 redis 的 string 可以包含任何数据。如数字,字符串,jpg图片或者序列化的对象。使用:get 、 set 、 del 、 incr、 decr 等实战场景:1.缓存: 经典使用场景,把常用信息,字符串,图片或者视频等信息放到redis中,redis作为缓存层,mysql做持久化层,降低mysql的读写压力。2.计数器:redis是单线程模型,一个命令执行完才会执行下一个,同时数据可以一步落地到其他的数据源。3.session:常见方案spring session + redis实现session共享2.Hash (哈希)是一个Mapmap,指值本身又是一种键值对结构,如 value={{field1,value1},......fieldN,valueN}}实战场景:1.缓存: 能直观,相比string更节省空间,的维护缓存信息,如用户信息,视频信息等。3.链表 List 说白了就是链表(redis 使用双端链表实现的 List),是有序的,value可以重复,可以通过下标取出对应的value值,左右两边都能进行插入和删除数据。实战场景:1.timeline:例如微博的时间轴,有人发布微博,用lpush加入时间轴,展示新的列表信息。4.Set 集合集合类型也是用来保存多个字符串的元素,但和列表不同的是集合中 1. 不允许有重复的元素,2.集合中的元素是无序的,不能通过索引下标获取元素,3.支持集合间的操作,可以取多个集合取交集、并集、差集。实战场景;1.标签(tag),给用户添加标签,或者用户给消息添加标签,这样有同一标签或者类似标签的可以给推荐关注的事或者关注的人。2.点赞,或点踩,收藏等,可以放到set中实现5.zset 有序集合有序集合和集合有着必然的联系,保留了集合不能有重复成员的特性,区别是,有序集合中的元素是可以排序的,它给每个元素设置一个分数,作为排序的依据。(有序集合中的元素不可以重复,但是score 分数 可以重复,就和一个班里的同学学号不能重复,但考试成绩可以相同)。实战场景:1.排行榜:有序集合经典使用场景。例如小说视频等网站需要对用户上传的小说视频做排行榜,榜单可以按照用户关注数,更新时间,字数等打分,做排行。
-
 漏洞信息:漏洞名称:Redis 沙盒逃逸漏洞 漏洞编号:CVE-2022-0543 漏洞等级:高 披漏时间:2022年03月10日漏洞描述:Redis存在沙盒逃逸漏洞。攻击者利用该漏洞可能打破Redis中的Lua沙盒并且执行任意代码。漏洞状态:脆弱组件覆盖面利用门槛POC工具EXP工具中等高已公开已公开影响版本: 运行在 Debian、Ubuntu 或其他基于 Debian 的 Linux 发行版系统上的 Redis 服务。漏洞排查:用户需排查Redis Server版本是否为以下版本: Debian Redis: 5:5.0.14-1+deb10u2 5:6.0.16-1+deb11u2 5:6.0.16-2 Ubuntu Redis: 5:6.0.15-1ubuntu0.1 5:5.0.7-2ubuntu0.1漏洞加固:目前厂商已发布升级补丁以修复漏洞,补丁获取链接: https://bugs.debian.org/cgi-bin/bugreport.cgi?bug=1005787
-
本文分享自华为云社区《[【高并发】什么是缓存穿透?击穿?雪崩?如何解决?](https://bbs.huaweicloud.com/blogs/336298?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content)》,作者:冰 河。 说到Redis,往往更多的场景是被用作系统的缓存,说到缓存,尤其是分布式缓存系统,在实际高并发场景下,稍有不慎,就会造成缓存穿透、缓存击穿和缓存雪崩的问题。那什么是缓存穿透?什么是缓存击穿,又什么是缓存雪崩呢?它们是如何造成的?又该如何解决呢?今天,我们就一起来探讨这些问题。 # 缓存穿透 首先,我们来说说缓存穿透。什么是缓存穿透呢?缓存穿透问题在一定程度上与缓存命中率有关。如果我们的缓存设计的不合理,缓存的命中率非常低,那么,数据访问的绝大部分压力都会集中在后端数据库层面。 ## 什么是缓存穿透? 如果在请求数据时,在缓存层和数据库层都没有找到符合条件的数据,也就是说,在缓存层和数据库层都没有命中数据,那么,这种情况就叫作缓存穿透。 我们可以使用下图来表示缓存穿透的现象。 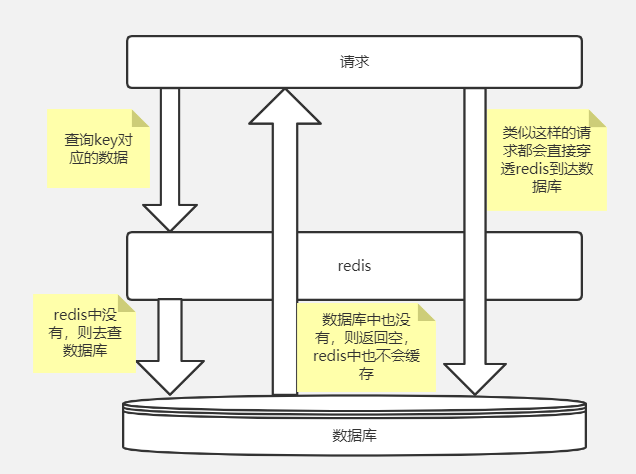 造成缓存穿透的主要原因就是:查询某个Key对应的数据,Redis缓存中没有相应的数据,则直接到数据库中查询。数据库中也不存在要查询的数据,则数据库会返回空,而Redis也不会缓存这个空结果。这就造成每次通过这样的Key去查询数据都会直接到数据库中查询,Redis不会缓存空结果。这就造成了缓存穿透的问题。 ## 如何解决缓存穿透问题? 既然我们知道了造成缓存穿透的主要原因就是缓存中不存在相应的数据,直接到数据库查询,数据库返回空结果,缓存中不存储空结果。 那我们就自然而然的想到了第一种解决方案:就是把空对象缓存起来。当第一次从数据库中查询出来的结果为空时,我们就将这个空对象加载到缓存,并设置合理的过期时间,这样,就能够在一定程度上保障后端数据库的安全。 第二种解决缓存穿透问题的解决方案:就是使用布隆过滤器,布隆过滤器可以针对大数据量的、有规律的键值进行处理。一条记录是不是存在,本质上是一个Bool值,只需要使用 1bit 就可以存储。我们可以使用布隆过滤器将这种表示是、否等操作,压缩到一个数据结构中。比如,我们最熟悉的用户性别这种数据,就非常适合使用布隆过滤器来处理。 # 缓存击穿 如果我们为缓存中的大部分数据设置了相同的过期时间,则到了某一时刻,缓存中的数据就会批量过期。 ## 什么是缓存击穿? 如果缓存中的数据在某个时刻批量过期,导致大部分用户的请求都会直接落在数据库上,这种现象就叫作缓存击穿。 我们可以使用下图来表示缓存击穿的线程。 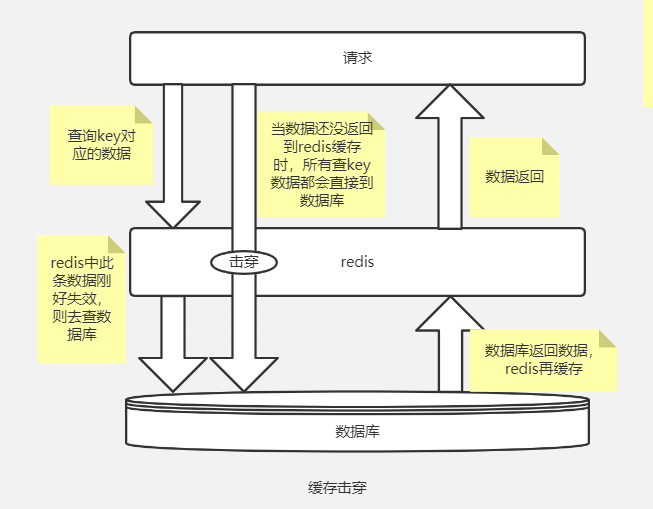 造成缓存击穿的主要原因就是:我们为缓存中的数据设置了过期时间。如果在某个时刻从数据库获取了大量的数据,并设置了相同的过期时间,这些缓存的数据就会在同一时刻失效,造成缓存击穿问题。 ## 如何解决缓存击穿问题? 对于比较热点的数据,我们可以在缓存中设置这些数据永不过期;也可以在访问数据的时候,在缓存中更新这些数据的过期时间;如果是批量入库的缓存项,我们可以为这些缓存项分配比较合理的过期时间,避免同一时刻失效。 还有一种解决方案就是:使用分布式锁,保证对于每个Key同时只有一个线程去查询后端的服务,某个线程在查询后端服务的同时,其他线程没有获得分布式锁的权限,需要进行等待。不过在高并发场景下,这种解决方案对于分布式锁的访问压力比较大。 # 缓存雪崩 如果缓存系统出现故障,所有的并发流量就会直接到达数据库。 ## 什么是缓存雪崩? 如果在某一时刻缓存集中失效,或者缓存系统出现故障,所有的并发流量就会直接到达数据库。数据存储层的调用量就会暴增,用不了多长时间,数据库就会被大流量压垮,这种级联式的服务故障,就叫作缓存雪崩。 我们可以用下图来表示缓存雪崩的现象。 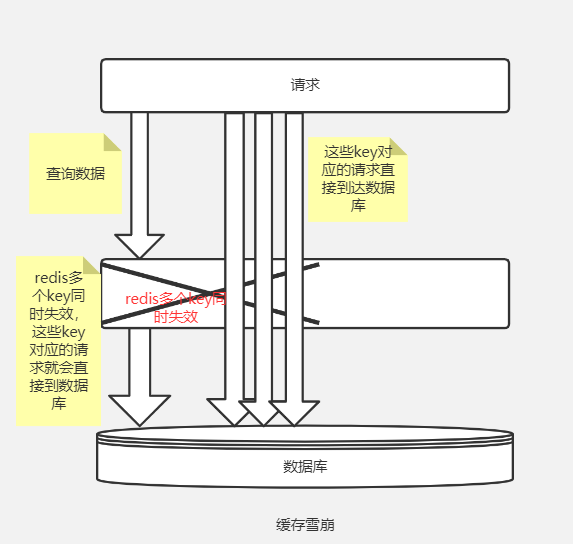 造成缓存雪崩的主要原因就是缓存集中失效,或者缓存服务发生故障,瞬间的大并发流量压垮了数据库。 ## 如何解决缓存雪崩问题? 解决缓存雪崩问题最常用的一种方案就是保证Redis的高可用,将Redis缓存部署成高可用集群(必要时候做成异地多活),可以有效的防止缓存雪崩问题的发生。 为了缓解大并发流量,我们也可以使用限流降级的方式防止缓存雪崩。例如,在缓存失效后,通过加锁或者使用队列来控制读数据库写缓存的线程数量。具体点就是设置某些Key只允许一个线程查询数据和写缓存,其他线程等待。则能够有效的缓解大并发流量对数据库打来的巨大冲击。 另外,我们也可以通过数据预热的方式将可能大量访问的数据加载到缓存,在即将发生大并发访问的时候,提前手动触发加载不同的数据到缓存中,并为数据设置不同的过期时间,让缓存失效的时间点尽量均匀,不至于在同一时刻全部失效。
-
Redis想必大家都或多或少听过吧,我们在工作学习中通常用它来作为缓存使用,既然是作为缓存,大家的第一反应肯定是:这家伙很快!实际上它确实也很快 : ),但Redis底层却是单线程的!有同学可能就要有疑问了,为什么单线程的Redis却能够快到飞起?别急,我尽量用通俗易懂的语言来给各位说道说道~~Redis是单线程,主要是指Redis的网络IO和读写是由一个线程来完成的,但Redis的其他功能,比如持久化、异步删除、集群数据同步等,其实是由额外的线程执行的。这不是本文讨论的重点,有个印象即可Redis为什么用单线程?多线程的开销通常情况下,在采用多线程后,如果没有良好的系统设计,其实是左图所展示的那样(注意纵坐标)。刚开始增加线程数时,系统吞吐率会增加,再进一步增加线程时,系统吞吐率就增长迟缓了,甚至还会出现下降的情况。上面两张图的标题手误被我标反了,源码还删了=_=关键瓶颈在于: 系统中通常会存在会被多线程同时访问的共享资源,为了保证共享资源的正确性,就需要有额外的机制保证线程安全性,例如加锁,这会带来额外的开销。比如拿最常用的List类型来举例吧,假设Redis采用多线程设计,有两个线程A和B分别对List做LPUSH和LPUSH操作,为了使得每次执行都是相同的结果,即【B线程取出A线程放入的数据】就需要让这两个过程串行执行。这就是多线程编程模式面临的共享资源的并发访问控制问题。并发访问控制一直是多线程开发中的一个难点问题:如果只是简单地采用一个互斥锁,就会出现即使增加了线程,大部分线程也在等待获取互斥锁,并行变串行,系统吞吐率并没有随着线程的增加而增加。同时加入并发访问控制后也会降低系统代码的可读性和可维护性,所以Redis干脆直接采用了单线程模式。Redis使用单线程为什么还这么快?之所以使用单线程是Redis设计者多方面衡量的结果。Redis的大部分操作在内存上完成采用了高效的数据结构,例如哈希表和跳表采用了多路复用机制,使其在网络IO操作中能并发处理大量的客户端请求,实现高吞吐率既然Redis使用单线程进行IO,如果线程被阻塞了就无法进行多路复用了,所以不难想象,Redis肯定还针对网络和IO操作的潜在阻塞点进行了设计。网络与IO操作的潜在阻塞点在网络通信里,服务器为了处理一个Get请求,需要监听客户端请求(bind/listen),和客户端建立连接(accept),从socket中读取请求(recv),解析客户端发送请求(parse),最后给客户端返回结果(send)。最基本的一种单线程实现是依次执行上面的操作。上面标红的accept和recv操作都是潜在的阻塞点:当Redis监听到有连接请求,但却一直不能成功建立起连接时,就会阻塞在accept()函数这里,其他客户端此时也无法和Redis建立连接当Redis通过recv()从一个客户端读取数据时,如果数据一直没有到达,也会一直阻塞基于多路复用的高性能IO模型为了解决IO中的阻塞问题,Redis采用了Linux的IO多路复用机制,该机制允许内核中,同时存在多个监听套接字和已连接套接字(select/epoll)。内核会一直监听这些套接字上的连接或数据请求。一旦有请求到达,就会交给Redis处理,这就实现了一个Redis线程处理多个IO流的效果。此时,Redis线程就不会阻塞在某一个特定的客户端请求处理上,所以它可以同时和多个客户端连接并处理请求。回调机制select/epoll一旦监测到FD上有请求到达时,就会触发相应的事件被放进一个队列里,Redis线程对该事件队列不断进行处理,所以就实现了基于事件的回调。例如,Redis会对Accept和Read事件注册accept和get回调函数。当Linux内核监听到有连接请求或读数据请求时,就会触发Accept事件和Read事件,此时,内核就会回调Redis相应的accept和get函数进行处理。Redis的性能瓶颈点经过上面的分析,虽然通过多路复用机制可以同时监听多个客户端的请求,但Redis仍然有一些性能瓶颈点,这也是我们平时编程需要极力避免的情况。1. 耗时操作任意一个请求在Redis中一旦耗时较久,都会影响整个server的性能。后面的请求都要等前面这个耗时请求处理完成,自己才能被处理到。这一点需要我们在设计业务场景时去规避;Redis的lazy-free机制也把释放内存的耗时操作放在了异步线程中去执行了。2. 高并发场景并发量非常大时,单线程读写客户端IO数据存在性能瓶颈,虽然采用IO多路复用机制,但还是只能单线程依次读取客户端的数据,无法利用到CPU多核。Redis在6.0可以利用CPU多核多线程读写客户端数据,但只是针对客户端的读写是并行的,每个命令的真正操作还是单线程。其他Redis相关的有趣问题借此机会也提几个和redis相关的有意思的问题。1. 为什么要用Redis,直接访问内存不好吗?这一条其实并没有很明确的界定,对于一些不经常变动的数据,可以直接放到内存里,不一定要放到Redis里,可以放到内存里。一致性问题:如果一个数据被修改了,数据在本地内存里的话,可能只有一台服务器上的数据被修改了。如果用Redis里面的话,我们访问Redis服务器,可以解决一致性问题。2. 数据太多内存放不下怎么办?比如我要缓存100G的数据,怎么办?这里也要打一个广告Tair是淘宝开源的分布式KV缓存系统,它从Redis继承了丰富的操作,理论上总数据量无限制,针对可用性、可扩展性、可靠性也进行了升级,感兴趣的小伙伴们可以了解一下~原文链接:https://blog.csdn.net/HNU_Csee_wjw/article/details/122567260
-
链接:https://bbs.huaweicloud.com/blogs/335976压缩列表简介压缩列表(ziplist)是由一个连续内存组成的顺序型数据结构。一个压缩列表可以包含任意多个节点,每个节点上可以保存一个字节数组或整数值。它是Redis为了节省内存空间而开发的。压缩列表(ziplist)是哈希(hash)和有序集合(zset)的内部编码之一。当哈希(hash)中的元素个数比较少并且每个元素的值占用空间比较小的时候,Redis就会使用压缩列表做为哈希的内部编码。当有序集合(zset)中的元素个数比较少并且每个元素的值占用空间比较小的时候,Redis也会使用压缩列表做为有序集合的内部编码。压缩列表结构接下来,我们来看以下压缩列表的内部构造,压缩列表由以下几个部分组成:zlbytes:表示整个压缩列表占用的内存字节数。xltail:表示压缩列表起始地址到最后一个节点的字节数,可以快速找到最后一个节点。zllength:表示压缩列表包含的节点个数。entries:节点列表,一个挨着一个地紧凑存储。zlend:特殊值0xFF(十进制为255),表示压缩列表的结束。压缩列表节点结构每个压缩列表的节点由三部分组成: prevlen、 encoding和content。prevlenprevlen:表示该节点前一个节点的字节长度。 prevlen的长度可能是1个字节,也可能是5个字节。当前一个节点的长度小于254个字节时, prevlen的长度为1个字节,直接存储前一个节点的字节长度;当前一个节点的长度大于或等于254个字节时, prevlen的长度为5个字节,其中的第一个字节被设置为0xFE,随后的四个字节保存前一个节点的字节长度。可以通过 prevlen和压缩列表结构中的xltail逆序遍历压缩列表。encodingencoding表示该节点中保存数据的类型和长度。当encoding的最高位以00开头时,表示最大长度为63的短字符串,此时encoding的长度为1个字节,其后面6个位表示字符串的字节长度;当encoding的最高位以01开头时,表示最大长度为16383的中等长度的字符串,此时encoding的长度为2个字节,其后面14个位表示字符串的字节长度;当encoding的最高位以10开头时,表示最大长度为4294967295的特长的字符串,此时encoding的长度为5个字节,其后面4个字节表示字符串的字节长度;当encoding的最高位以11开头时,表示整数值,此时encoding的长度为1个字节,其后面6个位表示整数值的类型和长度。contentcontent用于存储节点的值,节点的值可以是一个字节数组,也可以是正数,其类型和长度由encoding决定。总结压缩列表(ziplist)是由一个连续内存组成的顺序型数据结构。一个压缩列表可以包含任意多个节点,每个节点上可以保存一个字节数组或整数值。压缩列表(ziplist)是哈希(hash)和有序集合(zset)的内部编码之一。
-
链接:https://bbs.huaweicloud.com/blogs/330938一、前言不卷了,能用就行!哈哈哈,说好的不卷了,能凑活用就行了。但每次接到新需求时都手痒,想结合着上一次的架构设计和落地经验,在这一次需求上在迭代更新,或者找到完全颠覆之前的更优方案。卷完代码的那一刻总是神清气爽其实大部分喜欢写代码的一类纯粹码农,都是比较卷的,就比如一个需求在实现上是能用大概是P5、如果这个做出来的功能不只是能用还非常好用是P6、除了好用还凝练共性需求开发成通用的组件服务是P7。每一个成长过来的码农,都是在造轮子的路上一次次验证自己的想法和加以实践,绝对不是一篇篇的八股文就能累出来一个高级的技术大牛。二、延迟任务场景什么是延迟任务?当我们的实际业务需求场景中,有一些活动开始前的状态变更、订单结算后的T+1对账、贷款单息费的产生,都是需要使用到延迟任务来进行触达。实际的操作一般会有 Quartz、Schedule 来对你的库表数据进行定时扫描和处理,当条件满足后做数据状态的变更或者产生新的数据插入到表中。这样一个简单的需求就是延迟任务最初需求,如果需求前期内容较少、使用方不多,可能在实际开发中就只是一个单台机器直接对着表一顿轮训就完事了。但随着业务需求的发展和功能的复杂度提升,往往反馈到研发设计和实现,就不那么简单了,比如:你需要保障尽可能低延迟完成较大规模的数据量扫描处理,否则就像贷款单息费的产生,已经到了第二天用户还没看到自己的息费信息或者是还款后的重新对账,可能就这个时候就要产生客诉了。那么,类似这样的场景该如何设计呢?三、延迟任务设计通常的任务中心处理流程主要,主要是由定时任务扫描任务库表,把即将达到超时时间的任务信息扫描到处理队列(内存/MQ消息),再由业务系统进行处理任务,处理完成后更新库表中的任务状态。问题:海量数据规模较大的任务列表数据,在分库分表下该需要快速扫描。任务扫描服务与业务逻辑处理,耦合在一起,不具有通用性和复用性。细分任务体系有些是需要低延迟处理的,不能等待过长时间。1. 任务表方式除了一些较小的状态变更场景,例如在各自业务的库表中,就包含了一个状态字段,这个字段一方面有程序逻辑处理变更的状态,也有到达指定到期时间后由任务服务自动变更处理的操作,一般这类功能,直接设计到自己的库表中即可。那么还有一些较大也较为频繁使用的场景,如果都是在每个系统的各自所需的N多个表中,都添加这样的字段进行维护,就显得非常冗余了,也不那么易于维护。所以针对这样的场景就很适合做一个通用的任务延时系统,各业务系统把需要被延时执行的动作提交到延时系统中,再有延时系统在指定时间下进行回调,回调的动作可以是接口或者MQ消息进行触达。例如可以设计这样一个任务调度表:抽取的任务调度表,主要是拿到什么任务,在什么时间发起动作,具体的动作处理仍交给业务工程处理。大批量的各自业务的任务进行集中处理,则需要设计一个分库分表,满足于后续业务体量的增长。门牌号设计,针对一张表的扫描,如果数据量较大,又不希望只是一个任务扫描一个表,可以多个任务扫描一个表,加到扫描的体量。这个时候就需要一个门牌号来隔离不同任务扫描的范围,避免扫描出重复的任务数据。2. 低延迟方式低延迟处理方案,是在任务表方式的基础上,新增加的时间把控处理。它可以把即将到期的前一段时间的任务,放置到 Redis 集群队里中,在消费的时候再从队列中 pop 出来,这样可以更快的接近任务的处理时效,避免因为扫库间隔较大延迟任务执行。在接收业务系统提交进来的延迟任务时,按照执行时间的长短放置到任务库或者也同步到 Redis 集群中,一些执行时间较晚的任务则可以先放到任务库,再通过扫描的方式添加到超时任务执行队列中。那么关于这块的设计核心在于 Redis 队列的使用,以及为了保证消费的可靠性需要引入二阶段消费、注册 ZK 注册中心至少保证一次消费的处理。本文重点主要放在 Redis 队列的设计,其他更多的逻辑处理,可以按照业务需求进行扩展和完善Redis 消费队列按照消息体计算对应数据所属的槽位 index = CRC32 & 7StoreQueue 采用 Slot 按照 SlotKey = #{topic}_#{index} 和 Sorted Set 的数据结构按执行任务分数排序,存放任务执行信息。定时消息将时间戳作为分数,消费时每次弹出分数小于当前时间戳的一个消息为了保障每条消息至少可消费一次,消费者不是直接 pop 有序集合中的元素,而是将元素从 StoreQueue 移动到 PrepareQueue 并返回消息给消费者。消费成功后再从 PrepareQueue 从删除,如果消费失败则从PreapreQueue 重新移动到 StoreQueue,这样二阶段消费的方式进行处理。参考文档:2021 阿里技术人的百宝黑皮书PDF文,低延迟的超时中心实现方式简单案例@Test public void test_delay_queue() throws InterruptedException { RBlockingQueue<Object> blockingQueue = redissonClient.getBlockingQueue("TASK"); RDelayedQueue<Object> delayedQueue = redissonClient.getDelayedQueue(blockingQueue); new Thread(() -> { try { while (true){ Object take = blockingQueue.take(); System.out.println(take); Thread.sleep(10); } } catch (InterruptedException e) { e.printStackTrace(); } }).start(); int i = 0; while (true){ delayedQueue.offerAsync("测试" + ++i, 100L, TimeUnit.MILLISECONDS); Thread.sleep(1000L); } }测试数据2022-02-13 WARN 204760 --- [ Finalizer] i.l.c.resource.DefaultClientResources : io.lettuce.core.resource.DefaultClientResources was not shut down properly, shutdown() was not called before it's garbage-collected. Call shutdown() or shutdown(long,long,TimeUnit) 测试1 测试2 测试3 测试4 测试5 Process finished with exit code -1源码:https://github.com/fuzhengwei/TimeOutCenter描述:使用 redisson 中的 DelayedQueue 作为消息队列,写入后等待消费时间进行 POP 消费。四、总结调度任务的使用在实际的场景中非常频繁,例如我们经常使用 xxl-job,也有一些大厂自研的分布式任务调度组件,这些可能原本都是很小很简单的功能,但经过抽象、整合、提炼,变成了一个个核心通用的中间件服务。当我们在考虑使用任务调度的时候,无论哪种方式的设计和实现,都需要考虑这个功能使用时候的以为迭代和维护性,如果仅仅是一个非常小的场景,又没多少人使用的话,那么在自己机器上折腾就可以。过渡的设计和使用有时候也会把研发资源代入泥潭其实各项技术的知识点,都像是一个个工具,刀枪棍棒斧钺钩,那能怎么结合各自的特点,把这些兵器用起来,才是一个程序员不断成长的过程。如果你希望了解更多此类有深度的技术内容,可以加入 Lottery 分布式抽奖秒杀系统 学习更有价值的更抗用的实战手段。五、系列推荐金三银四面试前,把自己弄成卷王!方案设计:基于IDEA插件开发和字节码插桩技术,实现研发交付质量自动分析工作两三年了,整不明白架构图都画啥?工作两年简历写成这样,谁要你呀!BATJTMD,大厂招聘,都招什么样Java程序员?
-
 最基础的概念,什么是幂等性?幂等性:提交多次的情况下,结果都一样。比如数据库查询,可称为天然幂等性,即查询多次结果都一样,无需人为去做幂等性操作。但是update table set value=value+1 where id=1,每次执行的结构都会发生变化,不是幂等。inter into table(id,name)values(1,‘name’),如id不是主键或者没有唯一索引,重复操作上面的业务,会插入多条数据,不具备幂等性;所以我们在什么情景下需要确保幂等性呢?用户多次点击保存按钮用户保存成功后,返回上一页再次保存微服务相互调用,由于网络原因,导致请求失败解决方案一、token机制:1、根据业务场景,判断哪些业务存在幂等性问题,在执行业务之前先获取token,将token缓存止redis中2、调用业务接口时,将token携带过去,一般放在请求头,作为Auth认证3、服务器判断token是否存在于redis中,存在表示第一次请求,然后删除token,继续执行业务4、如果不存在,则表示反复操作,不执行业务逻辑,直接返回重复标志!结束风险性:业务执行前删除还是后删除token?如果是执行后删除,在业务执行中,未删除token,用户又点了请求进来,那么则无法保障幂等性。如果是执行前删除,在分布式下,用户快速请求2次,这时2个请求同时到redis去获取token,对比成功,同时删除,同时执行业务,那么也无法保障幂等性。so:使用执行前删除,在分布式情况下,获取,对比,删除必须确保原子性,所以要加分布式锁。二、加锁1、数据库锁select * from table where … for update2、业务层面加分布式锁将获取、对比、删除作为一个原子性的操作加锁,处理完成后释放锁,确保串行操作。三、约束数据库唯一约束:通过主键、唯一索引,确保无法重复新增同一笔数据,这就能确保幂等性
-
本文分享自华为云社区《[Redis现网那些坑:用个缓存,还要为磁盘故障买单?](https://bbs.huaweicloud.com/blogs/334929?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=database&utm_content=content)》,作者: GaussDB 数据库 。 近日,网上一些电商用户出现了库存业务查询超时的现象,深究根源,是其使用的Redis云服务底层SSD卡硬件故障,影响了Redis的稳定性,最终导致业务超时。 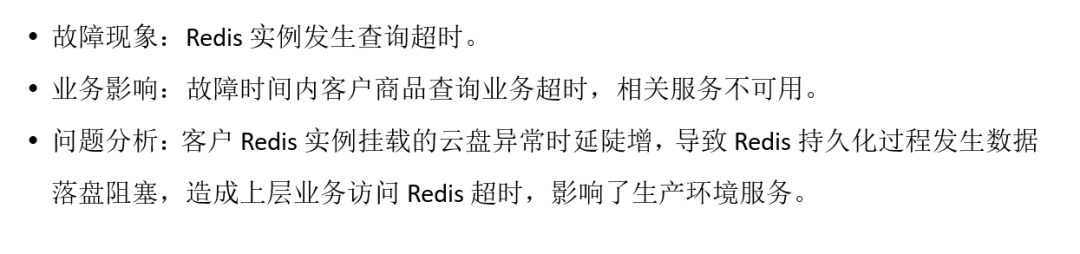 此时笔者脑中闪过一连串问号:  **那么,缓存Redis究竟为啥绕不过磁盘这道坎呢?** 从技术角度讲,使用缓存Redis还要配磁盘,一方面是因为开源Redis依赖持久化机制,保证宕机后能取回一部分数据,另一方面这也是主从同步必不可少的。开源Redis提供了两种持久化方案——RDB和AOF,其中: 1. RDB是通过对内存打快照的方式,将数据备份到磁盘。开源Redis主从之间全量同步就依赖于RDB文件。 2. AOF是通过日志追加的方式记录数据变化。开源Redis宕机重启可用AOF文件加载“较为完整”的数据。 想到这里,笔者恍然大悟:电商用户的现网问题,原来就在于RDB和AOF机制都要进行磁盘IO,而磁盘故障直接影响了Redis的持久化,进而阻塞了Redis的正常服务!  除此之外,缓存Redis的持久化还有各种缺陷: 1. AOF写入频率通常只能配置为秒级,在Redis动辄十万QPS的情况下,宕机时仍会有大量数据无法找回; 2. 数据量越大,重启加载AOF越缓慢; 3. RDB的生成和AOF重写都会引发fork问题,造成性能抖动。 由此可见,缓存Redis的持久化既不稳定、也不可靠,甚至还会因为磁盘性能、fork问题导致上层业务不稳定。然而出于数据“相对”安全、可靠的需求,缓存Redis还真就跨不过磁盘这道坎。  自建Redis的朋友们难免遇到这种窘境:最开始配了一个普通磁盘,后来遇到各种持久化阻塞服务的问题,不得不对磁盘进行升级。回顾前文的Redis实例故障,我们不难发现:缓存Redis的持久化与磁盘问题似乎永远无法令人放心。 **那么,是否有一劳永逸的方案,可以和Redis持久化带来的问题说拜拜呢?**  GaussDB(for Redis)作为华为云主推的企业级Redis,有着稳定可靠的天然优势,其基于存算分离、多副本强一致的架构,摒弃了RDB/AOF机制,彻底解决了开源Redis持久化性能不稳定、数据不一致、磁盘不可靠等问题,帮助企业用户真正实现降本增效。 **那GaussDB(for Redis)都有哪些“黑科技”呢?** 1. 采用SPDK技术,通过用户态、异步、无锁、轮询的方式驱动磁盘,相比开源Redis内核态驱动,速度大幅提高。 2. 高性能分布式共享存储池采用RDMA和DPDK技术,极大提高了系统吞吐量,加速数据处理,降低通信延迟。 3. 采用SCM技术,将接近内存的性能和速度,与类似SSD的容量和成本结合起来,打造强悍底座。 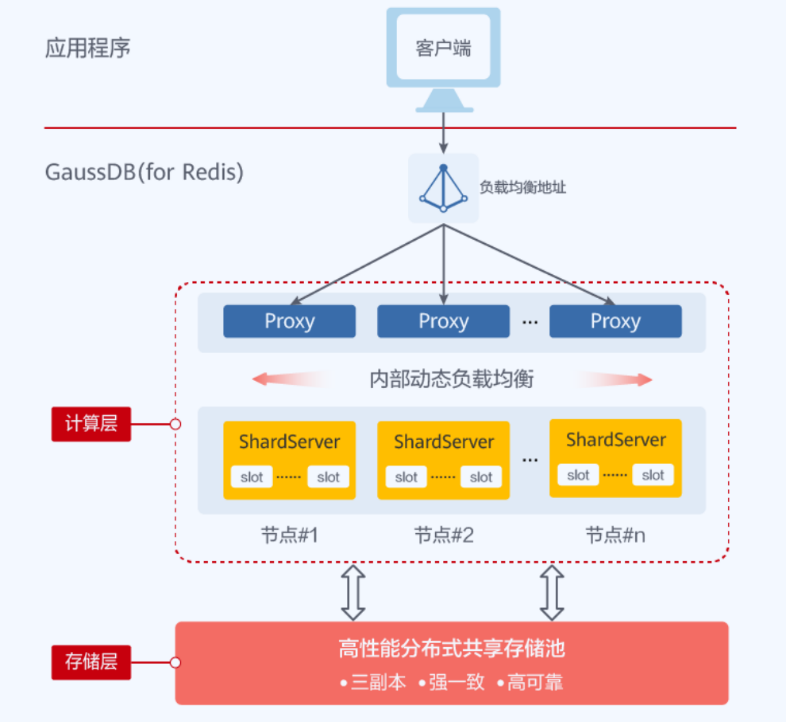 正是如此,GaussDB(for Redis)在保证数据命令级落盘的同时,能够轻松支持百万级QPS的高并发访问,以及亚毫秒级时延。其底层使用高性能分布式共享存储池,不会因磁盘故障而阻塞服务;同时,硬件成本又远低于缓存Redis,且数据量越大性价比越高。 既然Redis离不开持久化、离不开磁盘,那何不选择一款兼具性能与持久化优势的Redis数据库呢?就如上文提到的电商场景,GaussDB(for Redis)凭借独有的强一致、稳定性、ACID事务,不但能轻松搞定“库存”业务,其强大的持久化能力更能够为企业核心数据存储保驾护航。
-
最基础的概念,什么是幂等性?幂等性:提交多次的情况下,结果都一样。比如数据库查询,可称为天然幂等性,即查询多次结果都一样,无需人为去做幂等性操作。但是update table set value=value+1 where id=1,每次执行的结构都会发生变化,不是幂等。inter into table(id,name)values(1,‘name’),如id不是主键或者没有唯一索引,重复操作上面的业务,会插入多条数据,不具备幂等性;所以我们在什么情景下需要确保幂等性呢?用户多次点击保存按钮用户保存成功后,返回上一页再次保存微服务相互调用,由于网络原因,导致请求失败解决方案一、token机制:1、根据业务场景,判断哪些业务存在幂等性问题,在执行业务之前先获取token,将token缓存止redis中2、调用业务接口时,将token携带过去,一般放在请求头,作为Auth认证3、服务器判断token是否存在于redis中,存在表示第一次请求,然后删除token,继续执行业务4、如果不存在,则表示反复操作,不执行业务逻辑,直接返回重复标志!结束风险性:业务执行前删除还是后删除token?如果是执行后删除,在业务执行中,未删除token,用户又点了请求进来,那么则无法保障幂等性。如果是执行前删除,在分布式下,用户快速请求2次,这时2个请求同时到redis去获取token,对比成功,同时删除,同时执行业务,那么也无法保障幂等性。so:使用执行前删除,在分布式情况下,获取,对比,删除必须确保原子性,所以要加分布式锁。二、加锁1、数据库锁select * from table where … for update2、业务层面加分布式锁将获取、对比、删除作为一个原子性的操作加锁,处理完成后释放锁,确保串行操作。三、约束数据库唯一约束:通过主键、唯一索引,确保无法重复新增同一笔数据,这就能确保幂等性
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签