-
 【故障现象】docker 容器中运行redis无法启动,详情截图如下:【故障诊断】根据redis的日志信息提示,初步判断是配置文件的问题。【故障原因】配置文件中的内容导致redis无法启动。【解决方案】Redis will now exit to prevent data corruption. Note that it is possible to suppress this warning by setting the following config: ignore-warnings ARM64-COW-BUG。根据信息提示,即在 redis.conf 中取消这最后一条注释: ignore-warnings ARM64-COW-BUG ,再重启redis服务即可。
-
 最基础的概念,什么是幂等性?幂等性:提交多次的情况下,结果都一样。比如数据库查询,可称为天然幂等性,即查询多次结果都一样,无需人为去做幂等性操作。但是update table set value=value+1 where id=1,每次执行的结构都会发生变化,不是幂等。inter into table(id,name)values(1,‘name’),如id不是主键或者没有唯一索引,重复操作上面的业务,会插入多条数据,不具备幂等性;所以我们在什么情景下需要确保幂等性呢?用户多次点击保存按钮用户保存成功后,返回上一页再次保存微服务相互调用,由于网络原因,导致请求失败解决方案一、token机制:1、根据业务场景,判断哪些业务存在幂等性问题,在执行业务之前先获取token,将token缓存止redis中2、调用业务接口时,将token携带过去,一般放在请求头,作为Auth认证3、服务器判断token是否存在于redis中,存在表示第一次请求,然后删除token,继续执行业务4、如果不存在,则表示反复操作,不执行业务逻辑,直接返回重复标志!结束风险性:业务执行前删除还是后删除token?如果是执行后删除,在业务执行中,未删除token,用户又点了请求进来,那么则无法保障幂等性。如果是执行前删除,在分布式下,用户快速请求2次,这时2个请求同时到redis去获取token,对比成功,同时删除,同时执行业务,那么也无法保障幂等性。so:使用执行前删除,在分布式情况下,获取,对比,删除必须确保原子性,所以要加分布式锁。二、加锁1、数据库锁select * from table where … for update2、业务层面加分布式锁将获取、对比、删除作为一个原子性的操作加锁,处理完成后释放锁,确保串行操作。三、约束数据库唯一约束:通过主键、唯一索引,确保无法重复新增同一笔数据,这就能确保幂等性
-
 随着计算机硬件性能的提高,企业对数据保存量的要求不断提高。使用Redis能够有效减少数据库磁盘IO,减轻管理维护工作量,降低数据库存储成本。一、Redis概述概念Redis是用C语言开发的一个开源的高性能基于内存运行的键值对NoSQL数据库特征(1) 支持数据的持久化,可以将数据保存在磁盘中,重启之后可以再次加载到内存中使用(2) 支持多种数据类型,除了KV类型的数据,还支持list、set、hash等数据结构(3) 支持master-slave模式的数据备份二、Redis应用场景热点数据加速查询(主要场景),如热点商品、热点信息等访问量较高的数据即时信息查询,如公交到站信息、在线人数信息等时效性信息控制,如验证码控制、投票控制等分布式数据共享,如分布式集群架构中的session分离消息队列三、Redis的下载和安装去官网下载redis-3.0.4.tar.gz安装包,并放入Linux中的/opt目录在/opt目录下,执行解压命令tar -zxvf redis-3.0.4.tar.gz解压完成后出现文件夹redis-3.0.4进入文件夹redis-3.0.4,在此目录下执行make && make install命令进入默认安装目录cd /usr/local/bin,此目录中有如下文件四、Redis服务的启动修改redis配置文件,vim /opt/redis-3.0.4/redis.conf启动redis服务,cd /usr/local/bin,执行redis-server /opt/redis-3.0.4/redis.conf查看服务是否启动,ps aux | grep redis-server五、Redis命令行工具六、Redis基础知识Redis采用单线程机制进行工作Redis默认拥有16个数据库,数据库编号从0开始,默认使用0号数据库使用select 数据库编号 可以切换使用的数据库dbsize 命令查看当前数据库key的数量keys * 命令查看当前数据库所有的keyflushdb 命令清空当前数据库flushall 命令清空所有数据库Redis中所有数据库使用同一个密码,默认没有密码,Redis认为安全层面应该由Linux来保证Redis中所有索引都是从0开始Redis默认端口是6379
-
 1、客户介绍华为商城(VMALL)是华为公司旗下的自营电子商务平台,以最终用户为主要对象,提供华为手机、无线上网设备、平板电脑、配件等系列终端产品和服务,是以营造用户的移动信息生活为服务宗旨的互联网商务平台。云数据库GaussDB(for Redis)作为华为云旗下企业级Redis,致力于为客户提供稳定可靠、超高并发,且能够极速弹性扩容的KV存储服务。GaussDB(for Redis)在VMALL特征工程平台建设中,起到了关键作用。2、业务痛点 VMALL使用了大量的AI和大数据技术,用来支撑智能推荐,精准营销,智能搜索,选品投放等业务的高效开展。 随着业务的快速发展,系统对AI算法模型的需求日益增多。当前的AI开发流程中,“模型训练”和“模型部署”阶段都已经有成熟的平台支撑,唯独“特征数据准备”阶段缺乏通用平台, 导致了“线上推理和线下训练的特征数据不一致”,“各算法模型独立开发,特征生产重复造轮子”,“特征工程投入时间多(占据算法开发耗时的60%-70%)”3个关键问题,严重影响了研发效率,阻碍业务发展。为解决此问题,VMALL大数据团队开始着手建设统一的特征平台。 特征平台的核心部件是特征存储数据库,只有通过统一的特征数据存储,才能改变原有的“数据孤岛”窘境,彻底解决“不一致”,“难共享”,“效率低”3大问题。但也正是由于特征数据库需要承担打通线上/线下多个场景,对接批式/流式多种数据源,满足训练/推理多样消费需求,对特征数据库的选型提出了非常高的要求:需要找到一款数据存储服务,既能提供低成本的海量数据存储并方便扩容,又能保证数据的绝对可靠和服务的高可用;既要满足低时延的线上推理,又要满足高吞吐的线下训练;既能提供简洁的KV接口供下游轻松消费,又要兼容主流的批式/流式处理引擎(Spark/Flink等)供上游快速接入。 经过深入调研,VMALL大数据团队最终选择了GaussDB(for Redis)作为特征数据库,下面就让我们详细看看GaussDB(for Redis)是如何满足上述苛刻要求的。3、解决方案1. 特征平台使用GaussDB(for Redis)的主要流程1)特征生产(抽取、处理、存储)离线特征(静态特征):定时调度Spark作业,从各种数据仓库、数据湖中提取数据,进行特征工程处理后,存入GaussDB(for Redis) 。实时特征(动态特征):Flink消费Kafka,或流式存储中的数据,持续更新到GaussDB(for Redis)中。1)特征消费线上推理:模型已经部署到生产,开始承接业务,需要低时延,高并发的消费数据,从GaussDB(for Redis)中读取数据。线下训练:GaussDB(for Redis)存有最新的特征数据,OBS中存有全量的特征数据。对于使用静态特征的较为简单的模型,可以直接从OBS中获取特征使用。对于使用实时特征的场景(如实时推荐系统),由Flink从Kafka中实时取得用户请求记录,并从GaussDB(for Redis) 查询取得特征,将记录和特征拼接成训练样本,存储到文件中,供线下训练使用。2. 特征平台对GaussDB(for Redis)的核心诉求 结合上述业务场景,总结特征平台对GaussDB(for Redis)的核心诉求如下:序号类别诉求点1业务接口支持简洁的KV接口(不需要范围查询),支持和Spark/Flink快速对接,提升业务开发效率2稳定性作为电商应用的关键支撑系统,需要具备企业级应用的稳定性。如社区Redis存在的fork抖动,oom等问题,需要解决3可靠性特征数据决定了最终给客户的推荐效果,需要确保数据零丢失,强一致4成本特征数据体量庞大,希望采用内存+磁盘混合存储,降低使用成本5性能抗写能力必须强,满足特征数据批量灌库的要求;读取总体要低时延,但非缓存场景,可接受非活跃用户的时延毛刺6可扩展性随着业务发展,特征数据上量很快;扩容要简单,快速,业务影响尽量小3. GaussDB(for Redis)满足特征平台诉求的关键方案1)业务接口 GaussDB(for Redis)兼容社区Redis5.0接口,支持和Spark/Flink Connector的对接,很好的满足了业务的使用需求2)稳定性 GaussDB(for Redis)采用自研内核,解决了社区Redis的fork,oom等老大难问题,具备了企业级应用的稳定性3)可靠性数据零丢失:逐条命令实时落盘,底层三副本冗余存储,无数据丢失风险数据强一致:基于GaussDB公共的共享存储部件DFV,实现三副本强一致,多点访问无脏读风险4)成本 GaussDB(for Redis)实现数据的自动冷热分离,采用内存+SSD的混合存储方案,大幅降低了客户的使用成本。按照VMALL的特征体量测算,亿级用户,每个用户的特征数量是数K-数10K,GaussDB(for Redis)一年的费用仅3W出头,如果选用社区Redis,费用在20W+5)性能 GaussDB(for Redis)采用多线程架构,并且所有节点可以同时支持写入,因此可以较好满足批量灌库的高吞吐写需求。读方面,基于冷热分离方案,热数据常驻内存提供稳定低时延;冷数据读涉及IO交换,存在一定长尾,但可满足VMALL业务要求(目前VMALL线上GaussDB(for Redis)实例读时延平均0.16ms,P99 0.4ms,P9999 1.5ms)6)可扩展性 基于计算存储分离架构,底层数据可被任一节点访问,扩容过程不发生数据拷贝搬迁,因此速度极快;计算节点扩容分钟级完成,存储扩容秒级完成,RTO < 10秒综上,与社区Redis相比,GaussDB(for Redis)提供了更稳定的使用体验,更可靠的数据存储,更低廉的使用成本和更便捷的扩展能力,是更适合像VMALL特征平台这样大规模电商大数据应用的企业级Redis服务。因此,VMALL特征平台最终选择GaussDB(for Redis)作为特征数据的存储服务。4、上线后效果目前VMALL已完成一期的特征数据迁移,包括“特征生产”业务中的“Spark离线特征生产”,以及“特征消费”业务中的“线下训练Flink特征查询”,已迁移到GaussDB(for Redis)。当前GaussDB(for Redis)运行平稳,业务高峰时段时延稳定,能够满足VMALL当前业务要求。其中,读平均时延0.2ms(p99<0.4ms),写入平均时延0.6ms(P99<2ms)。VMALL当前已启动二期的特征数据迁移,计划完成包括“Flink在线特征生成”,“线上推理”等核心业务的接入。5、 总结本文介绍了华为商城(VMALL)在建设特征平台过程中,对特征数据存储服务的选型和应用。由此可见,华为云GaussDB(for Redis)服务在成本,可靠性,可扩展性等方面具有优势,可作为特征数据存储的理想方案,提供企业级的稳定可靠的Redis服务能力。6、附录GaussDB(for Redis)产品主页:https://www.huaweicloud.com/product/gaussdbforredis.html更多技术文章,请关注GaussDB(for Redis)官方博客:https://bbs.huaweicloud.com/community/usersnew/id_1614151726110813
-
华为的redis经过定制,增加了krb5认证。需要提供连接redis集群对应版本的java样例代码 经过验证,华为之前提供的文档的样例代码,依赖的第三方jar包(jredisclient-8.0.2-302002.jar)是华为基于jedis进行了定制化。 该jar包与dts依赖的jar包(jedis-3.3.0.jar)存在冲突,引用该jar包会导致DTS程序无法启动。 DTS程序使用的是springboot(版本:2.4.9)+jedis(版本:3.3.0)的方式接入redis,请帮忙协调华为的同事提供该模式接入redis的样例代码。 附件为启动的错误日志信息。
-
 volatile-lru:从已设置过期时间的数据集(server.db[i].expires)中挑选最近最少使用的数据淘汰volatile-ttl:从已设置过期时间的数据集(server.db[i].expires)中挑选将要过期的数据淘汰volatile-random:从已设置过期时间的数据集(server.db[i].expires)中任意选择数据淘汰allkeys-lru:从数据集(server.db[i].dict)中挑选最近最少使用的数据淘汰allkeys-random:从数据集(server.db[i].dict)中任意选择数据淘汰no-enviction(驱逐):禁止驱逐数据
-
 # 华为FusionInsight MRS实战 - 使用FlinkSQL处理数据并使用redis做实时展示 ## 场景说明 【需求】计算最近1小时各个账户交易总金额。 【分析】将账户交易数据接入Kafka中,通过Flink计算过去1小时各个账户的交易总金额,将计算结果写入Redis中。做实时大屏展示。 【实现】通过FlinkSQL的滚动窗口计算 数据流图 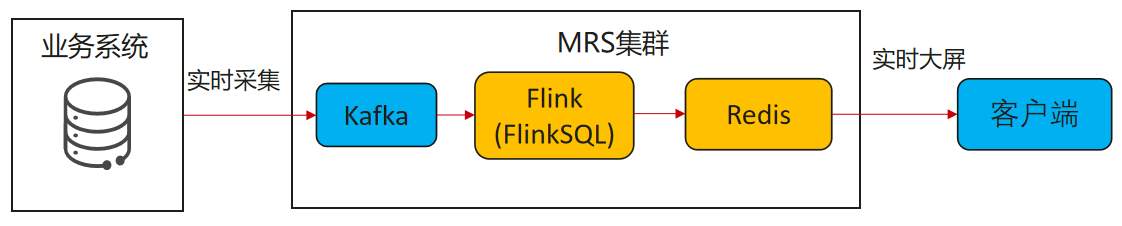 ## 操作步骤 - 登录华为FusionInisght MRS Flink WebUI  - 在作业管理选择新建作业创建一个FlinkSQL任务 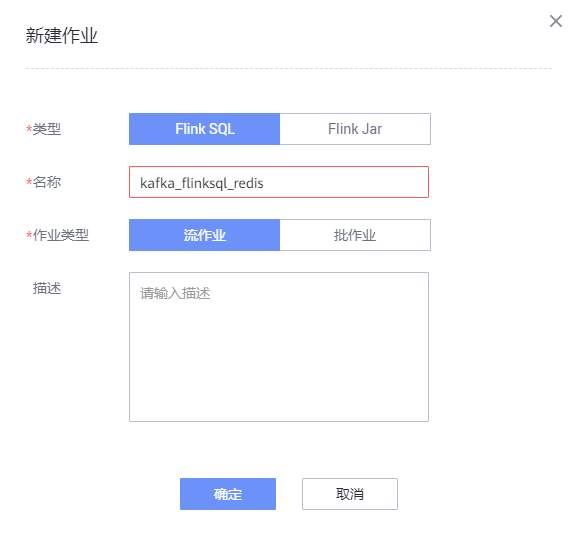 - 编辑如下Flink SQL语句 ``` CREATE TABLE kafka_source ( account varchar(10), cost int, ts AS PROCTIME() ) WITH ( 'connector' = 'kafka', 'topic' = 'redisdemo', 'properties.bootstrap.servers' = '172.16.9.117:21005', 'properties.group.id' = 'testGroup', 'scan.startup.mode' = 'latest-offset', 'format' = 'json' ); CREATE SINK STREAM redis_sink( account varchar, costs int, PRIMARY KEY(account) ) WITH ( 'isSafeMode' = 'true', 'clusterAddress' = '172.16.9.117:22404,172.16.9.118:22404,172.16.9.113:22404', 'redistype' = 'String', 'type' = 'Redis', 'isSSLMode' = 'false' ); INSERT INTO redis_sink SELECT account, SUM(cost) FROM kafka_source GROUP BY TUMBLE(ts, INTERVAL '10' SECOND), --为了快算看到计算结果使用10s窗口 account; ``` - 点击语义校验,确保语义校验通过 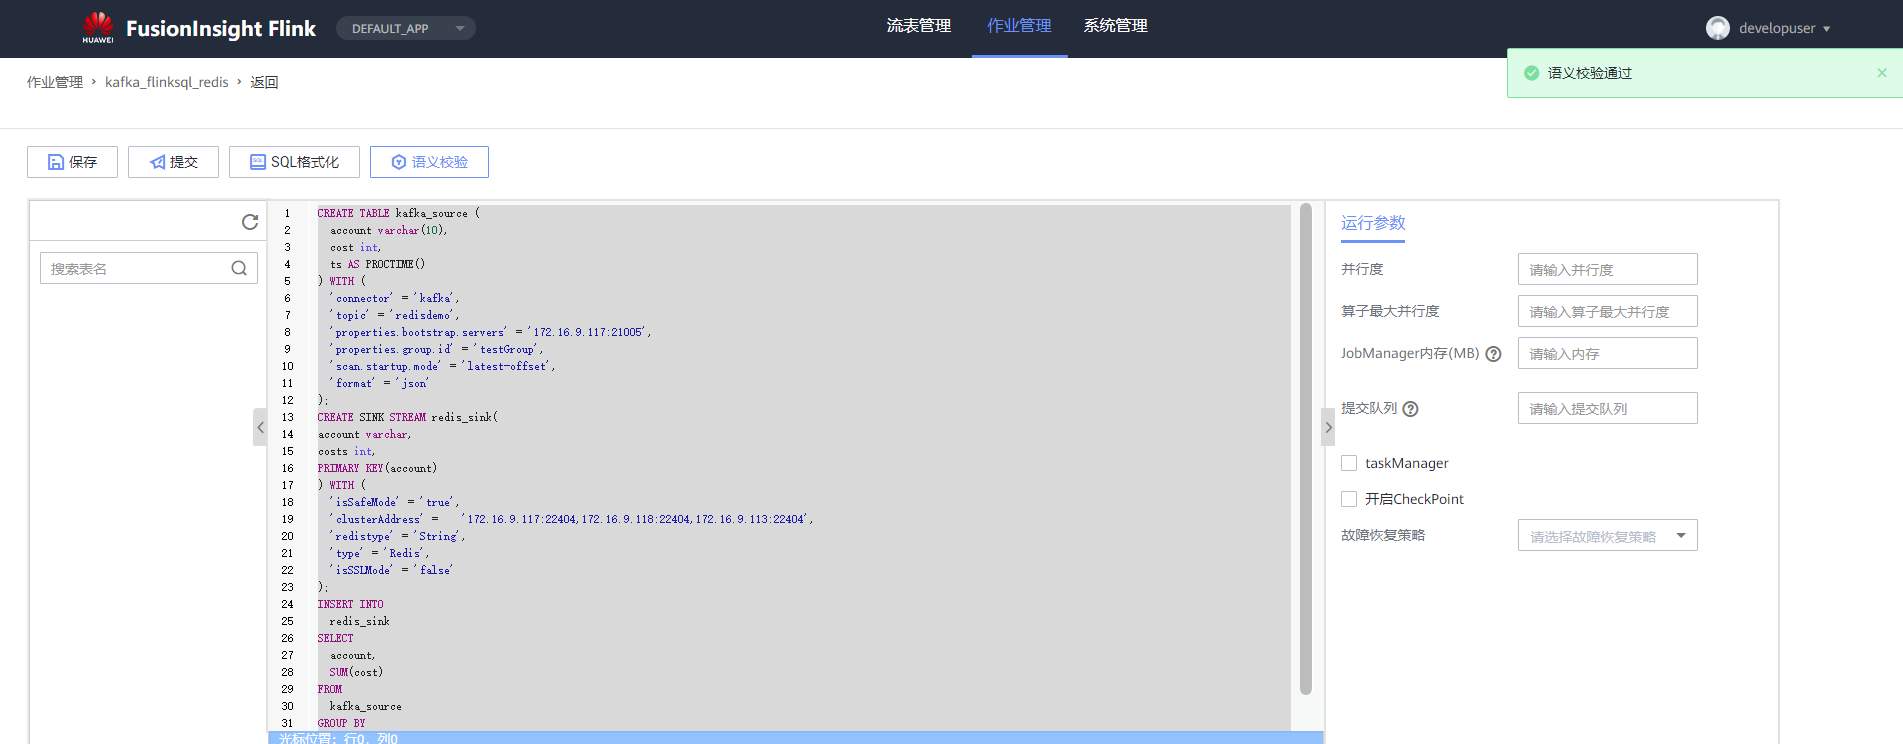 - 启动该Flink SQL任务 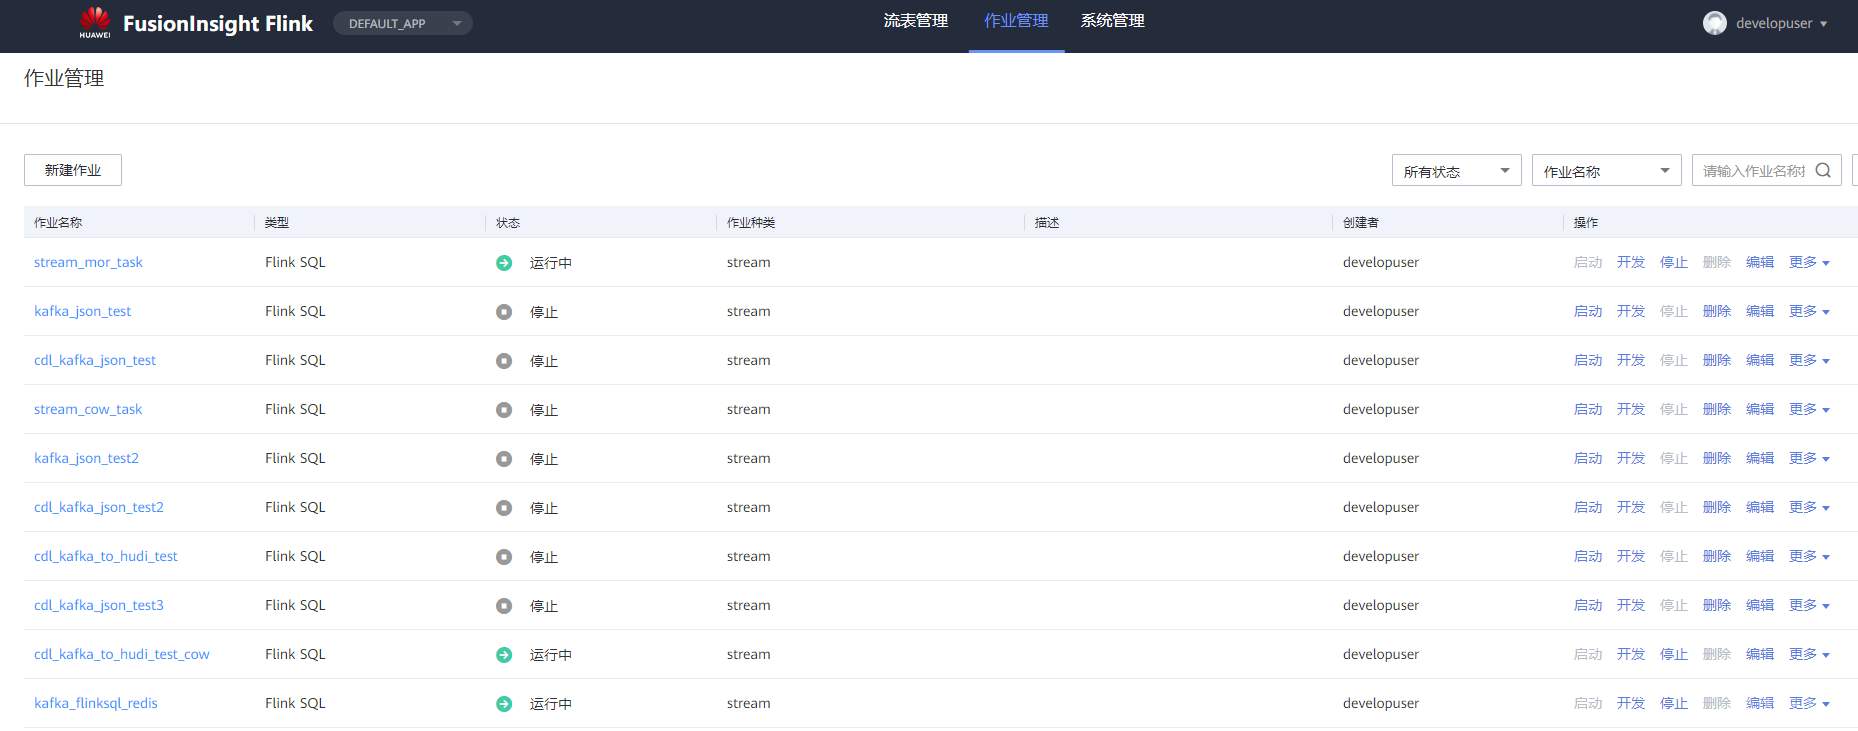 - 使用kafka客户端插入测试数据 ``` {"account": "A1","cost":"11"} {"account": "A1","cost":"22"} {"account": "A2","cost":"33"} {"account": "A3","cost":"44"} ```  注意: 因为flink窗口时间为10秒,并且redis是key value数据库,数据会根据主键覆盖,所以需要在10s内将数据全部输入 - 登录redis客户端查看结果: `redis-cli -c -h 172.16.9.117 -p 22404` 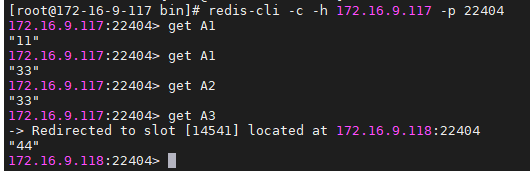
-
 在共享数据加速,保持数据(如订单数据)一致性的场景下,采用单主多从的缓存模式,在两个数据中心更新缓存时,是先写到一个Redis Master集群中,然后从一个Redis Master集群同步到两个数据中心的Redis Slave集群中,整个请求的逻辑就是:请求进入其中一个机房的微服务中,微服务首先会读取微服务本地的一级缓存,如果没有命中,再去本数据中心的Redis Slave集群进行查询,如果还是没有命中,再回源到本数据中心的数据库中进行查询,将读取后的数据写入到Redis Master集群,同时更新本地的一级缓存和Redis Slave集群,当然Redis Master集群也会将数据同步更新到另一个数据中心的Redis Slave集群中。这种单写多读的缓存模式实现数据加速以及保证数据一致性的要求。目前这种跨机房的主从同步延时并不明显,延迟在一两毫秒左右。在共享数据加速但不考虑数据(商品)一致性的场景下,也是采用多活的理念,即在两个数据中心部署完全对等的缓存集群。在上图的机房一中,当有数据请求时,首先从本地一级缓存进行查询,如果没有命中,再去查本地的Redis集群,依旧没有命中时,回源到本地的数据库进行查询,同时将查询到的数据更新到本数据中心的Redis集群。虽然两个数据中心的缓存集群部署一致,但是在Redis集群中存的数据可能不一致。数据层作为六层架构中的最底层,主要的应用还是基于MySQL的主从模式。下面提到的特点是在非核心业务上的一些尝试,并没有大面积应用:同城双活,即由业务层来控制数据的实时性和最终一致性,而不是通过数据同步来保证实时性和一致性。业务层双写,数据异步分发至两个数据中心,任意机房写入的数据通过异步消息的方式分发到另一个机房,以此来保证两个机房数据的最终一致性。业务层通过二级查询保证数据的实时一致性,由于业务层双写只能保证数据的最终一致性,无法保证实时一致性,因此,针对具有实时一致性要求的业务场景,我们通过业务层的二级查询来保证。 重复写入应对单机房故障,当任意机房出现故障时,如果写入的数据还没有分发至另一个机房,则由业务层在可用机房重复写入数据,通过算法来生成相同的ID。通过failover库为高可用提供双重保险,针对流水型业务数据,在数据库故障时,需要进行主从切换,此时通过业务层将所有数据的读写切换至failover库,主库恢复以后再将流量切回主库。垂直拆分与水平拆分结合使用。 服务化 之所以需要服务化,是因为在做服务化之前系统高度耦合,牵一发而动全身,直接影响到系统可用性;同时业务相互影响,系统很难维护;系统逻辑过于耦合,很难进行水平扩展;也无法通过流控、降级等手段保障系统的可用性;此外由于系统的高度耦合,极易产生雪崩效应。因此基于上述原因,服务化改造势在必行。对于服务化而言,最核心的就是服务的发现、注册、调用。目前有货采用的是Spring+Register+Zookeeper搭建的最简单的服务框架,通过Zookeeper完成的服务注册和发现,通过Register完成服务的调用。集中式的LoadBalance,在服务消费者和提供者之间通过阿里云的负载均衡或者F5搭建独立的LoadBalance,通过集中式的负载均衡设备完成对服务调用的负载均衡;在进程内做负载均衡,即软负载的方式,将负载均衡策略渗入到服务框架里面,服务消费者作为负载均衡的客户端,请求只需要从服务注册中心获取最新的服务列表,利用服务框架自身携带的负载均衡策略,完成负载均衡的调用。在服务降级方面,通过使用开源的Hystrix配置服务超时时间,当服务调用超时时,直接返回或执行Fallback逻辑。另外基于Hystrix提供的熔断器组件,可以自动运行或手动调用对当前服务进行暂停后再重新调用服务。流量控制方面,通过计数器服务限定单位时间内当前服务的最大调用次数(比如600次/分钟),如果超过则拒绝,以保证系统的可用性;同时为每个服务提供一个小的线程池,如果线程池已满,调用将被立即拒绝,默认不采用排队,加速失败判定时间。服务化中,对于服务的监控、性能优化以及调用链的分析也尤为重要。通过Hystrix提供的服务化监控工具实时观察在线服务的运行状态,有了监控之后可以进行相应的性能优化。对于调用链分析,当请求从网关层进入时,追加一个Trace ID,Trace ID会在整个调用过程中保留,最后通过分析Trace ID将整个请求的调用链串联起来。
-
项目背景:用户通过域名访问vip, nginx做为负载均衡为后端应用分发请求, 后端应用为dubbo服务,存储分为redis和mysql. redis做为持久会存储数据库,支持前端业力. 并且通过mq同步数据到mysql,供后端使用. 同时后台写mysql也要通过mq同步到redis.目前后端服务qps最高可以达到5万,本次架构设计在不重构的情况下短期内最快的方法达到目标10万qps.架构方案:一,现有idc架构可支撑5万qps。这是经过一年考验下来的,可做为保底的;如果应用全部上云,需要从0开始重新验证能否达到现有5万qps,再去验证能否达到10万qps,时间等未知风验很大; 二,10万qps目标,建议用简单粗暴的方式,直接把idc应用层架构复制一套上云;不建议在现有架构上继续调优,现在架构如果不重构,可能很难找到问题;与其这样不如把人力时间用到另一个方向,比如数据中心; 三,由idc+公有云两套系统构成混合云模式,数据统一使用idc的redis和mysql,公有云与idc 的数据库连接建立专线;混合云的方式可以检测公有云的实际性能,也能为将来全部迁移公有云提供真实参考; 四,平时比赛,使用idc架构完全可以支撑,公有云留少量机器和用户请求预热,重要比赛,临时增加云资源扛突发,服务器成本节约,扩展性也灵活; 五,公有云都有出现过大规模事故,造成全站不能访问的情况,为了保险,我们依然要保留idc的服务,所以混合云也许是最适合的; 技术难点: 一,如何将用户请求分流到 idc和公有云两套应用 1,域名解析两条A记录,分别指向idc和公有云两个vip,通过dns平均分配用户请求 2,idc架构在nginx前端增加四层负载均衡(lvs,ha_porxy),由四层负载均衡将用户请求转发给idc的nginx和公有云的负载均衡,lvs与公有云通信通过专线; 二,前端应用入口放大,后端数据中心,需要扩容 1,redis使用多主多从,redis3.0 还是用 代理(predixy,codis); 2,业务拆分,组建更多的一主多从; 具体实施: 1,双系统流量分发配置lvs即可,本赛季最好能用上几轮,演练资源增减,熟悉流程,检测可行性; 2,redis数据中心需要大量的测试,选型,可做重点研究(这也是目前急需解决的单点);
-
 云数据库GaussDB(for Redis)介绍页入口,详情请点击链接云数据库GaussDB(for Redis)成长地图入口,详情请点击链接小云妹又来啦,生命不息,学习不止,今天要着重介绍的是我们的——云数据库GaussDB(for Redis)有着稳定、可靠的企业级产品定位,它完全兼容开源Redis,还能为企业带来降本增效的重要价值。稳定实用就是我~~~
-
企业级Redis的几个典型需求:海量数据存储、高并发、服务高可用、数据高可靠Redis数据存储在内存中,服务器集群的内存已能达到T级别,能实现每秒几十万上百万级别的高并发。那么Redis如何实现数据高可靠呢?Redis不同于磁盘数据库,服务器宕机或者Redis服务关闭都会导致内存中数据丢失。因此引入Redis的持久化机制,实现灾备,数据恢复,以及服务高可用能力:借助持久化文件的增量同步,实现Redis主备高可用。将持久化文件转移存储,实现异地灾备与数据恢复能力下面简要介绍下Redis数据导出与持久化&远程导出很多场景下,我们需要将远程的Redis数据导出到本地。主要利用了Redis的持久化命令(SAVE/BGSAVE),以及复制命令(SYNC/PSYNC)导出方式1: Redis-liRedis自带命令行工具,它支持导出RDB文件,也支持将持久化的AOF文件整库导入。导出为RDB文件命令:redis-cli -h {redis_address) -p 6379 --rdb {outputfile.rdb}开启AOF持久化命令:redis-cli -h {redis_address) -p 6379 config set appendonly yes注意:此命令会生成一个AOF文件,默认保存在Redis实例运行的安装目录导出方式2: 第三方开源工具redis-portredis-port的导出工作原理,主要是伪装成slave,利用sync命令接收RDB文件。导出为RDB文件命令:redis-dump -n 3 -m {password}@{redis-host}:{port} -o {outputfile. rdb}导出方式3:有些云厂商服务禁用了客户端发起的config/save/sync等命令,导致不能使用redis-cli或第三方工具导出RDB、 AOF文件。不过云厂商一般都提供Redis实例的备份以及备份文件下载功能。下载文件为AOF或RDB格式。
-
主服务器写内存快照,会阻塞主线程的工作,当快照比较大时对性能影响是非常大的,会间断性暂停服务,所以主服务器最好不要写内存快照。Redis 主从复制的性能问题,为了主从复制的速度和连接的稳定性,主从库最好在同一个局域网内。
-
volatile-lru:从已设置过期时间的数据集(server. db[i]. expires)中挑选最近最少使用的数据淘汰。 volatile-ttl:从已设置过期时间的数据集(server. db[i]. expires)中挑选将要过期的数据淘汰。 volatile-random:从已设置过期时间的数据集(server. db[i]. expires)中任意选择数据淘汰。 allkeys-lru:从数据集(server. db[i]. dict)中挑选最近最少使用的数据淘汰。 allkeys-random:从数据集(server. db[i]. dict)中任意选择数据淘汰。 no-enviction(驱逐):禁止驱逐数据。
-
尽量使用 Redis 的散列表,把相关的信息放到散列表里面存储,而不是把每个字段单独存储,这样可以有效的减少内存使用。比如将 Web 系统的用户对象,应该放到散列表里面再整体存储到 Redis,而不是把用户的姓名、年龄、密码、邮箱等字段分别设置 key 进行存储。
-
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签