-
 [作者按] Solv 研究组的系列文章 《Web3 国际市场危机分析》已经发表了三篇。这一系列的文章,主要是从美元稳定币的创造、流动和配置的视角来分析本轮 Web3 国际市场危机的一些深层原因。我收到一些读者的评论,认为部分内容比较专业,对基础要求较高,尤其是涉及到货币经济的一些行文表述,让一部分读者理解起来吃力。实际上为了能够让大部分读者能够理解,我们在写作中已经尽量采用文字来描述问题和阐述观点,避免使用更加专业的工具。这样看来,授人以鱼不如授人以渔,我们可能应该给读者一些学习建议,或者补充一些基础知识,这对于那些对 Web3 感兴趣的读者,可能是有帮助的。为此,我计划发表三篇短文,第一篇介绍学习 Web3 的一些基础知识,第二篇介绍资产负债表在 Web3 和 DeFi 分析当中的一些应用,第三篇推荐几本书。希望这些文章能帮助读者在 Web3 的学习中少走弯路。这几篇文章与 Solv 研究组的危机系列分析文章并行发表,先到先发,不拘于特定次序。Web3 是经济、金融、法律、机制设计等经济社会学科与 IT、数学、密码学等数字信息科技交叉整合的新领域,它如此之新,以至于不仅没有出现权威学者,甚至连一个基本知识体系都没有梳理出来,人们连该学什么都不知道。大多数从业者不具备相关基础知识和基本观念,一边不着边际胡思乱想,一边赤手空拳乱打乱撞,导致很多肤浅荒谬的观念流行,搞出很多从根子上就是虚妄的项目。结果,一个好端端的未来数字科技,闻上去跟神拳教大师兄气味相仿。另一方面,大多数学富五车的学者则居高临下,先入为主,生搬硬套一些来自传统世界的理论和模型,极少有人愿意躬身入局,亲自耕耘这野蛮而充满活力的新大陆,因此对于现实缺乏基本的解释能力,更谈不上预测和引领趋势。可以说,Web3 现在完全是一片理论的蛮荒之地。在这种情况下,如果我跳出来提出一个 Web3 和数字资产的“知识体系”或者“学习路径”,那肯定是自不量力、别有用心了,读者大可以把我当成贩卖大力丸的江湖骗子叱责之。但是,以我七年以来的区块链和 Web3 学习从业经验和所见所闻,在读了上百本书、研究跟踪了几十个项目,并且在海外亲自创业实践的经历,如果说功夫没有全然白花、还稍有点心得的话,倒是可以总结几点,比如:整天去分析某个数字资产或者某个 NFT 为什么会火,试图总结其“基本面”规律,把握财富密码,是全然徒劳,而且通常是适得其反,乃插标卖首之学;各种交易秘籍、技术分析、历史模型,基本都是见光死,意义参考上一条。即使存在有效的技术分析模型,也不会放出来让你看到,能让你看到的肯定是无效的;一些投资理念、投资哲学的东西,似乎有帮助,又说不出具体有什么帮助,读之若有所思,用之则无从下手;大数据分析和数据可视化当然是各行各业都离不了的基本工具,Web3 也不例外,但人工智能、机器学习这些高级技术,对于预测 Web3 市场意义极其有限,却经常能给你虚假的自信,引导你做出错误决策;经济学的思维方式是有用的,帮助我们从市场经济的基本原理来理解和看待 Web3,判断总体发展趋势,但专业经济学者花费最多时间讲授和研究的那些宏观微观模型,则绝大多数毫无用处;奥地利学派的自由主义经济思想、货币和商业周期理论和对于理解 Web3 的价值主张以及行业中的市场周期颇有帮助,但其中也包含了大量艰深复杂而关系不大的思辨;新制度经济学有价值,里面很多理论对于我们理解网络协作、自治组织、合约关系等 Web3 的重要话题很有帮助;金融学中,资产组合理论在思维上是很有启发的,实践当中则难以应用;对于 DeFi 的读者来说,基本金融工具和衍生品的知识非常有用,但是那些估值模型、定价理论以及随机微分方程的各种公式,至少在现在这个阶段没有什么用处。不过,能够气定神闲地随口说出 “Alpha收益”、“Beta 收益”、“systematic risk”、“idiosyncratic risk”、CAPM 和 APT 模型,对于社交确有好处,国内外皆然。至于更高级的术语,多说则无益有害;如果亲自搞 Web3 创业,懂一点公司金融和财务报表是有必要的,尽管大多数 Web3 创业公司都没有严格的财务报表制度,但是这个知识技能确有价值,而且大概率将来能用上;在互联网时代发展起来的信息经济学,比如网络效应导致的自然垄断,结合经济学基础知识学习,对于理解行业格局,制定发展战略,非常有帮助;博弈论,理论上应该是本行业最有用的学问之一,不过实际上,博弈论现有的结论和工具远远解决不了 Web3 的真实问题,可以说相差甚远。学习博弈论的主要价值可能也是在社交中使用“囚徒困境”、“纳什均衡”等术语的时候更加自信。以上这些,主要还是我自己的主观感受,也并不十分有把握,读者参考一下就好,如果反对,我也无意争论。下面才是重点。有四门学问,我可以保证对于学习和理解数字资产和 Web3 确实有帮助,我自己学了以后受益确凿,推荐给朋友和同事以后,也反馈良好,基本上没有人说是白花功夫,故我可以非常自信地列举如下:第一,智能合约开发部署的基本知识和技能。若要真正理解区块链,懂一点智能合约开发、部署、触发执行等等基础知识,是必要的。反过来说,如果你真的懂了智能合约,也就具备了区块链的基础知识了。所以很多人要学习区块链,看一大堆理论书籍,可能总还是觉得隔着一层。这种情况下,如果有一点编程基础,倒不如直接学习智能合约技术,当心一剑,戳个通透,省得在旁边绕圈圈。第二,系统思考。也就是基于系统论的观点,通过反馈回路、存量流量的分析,定性地认识系统的运动规则,加深理解,增强洞察力。这是一种非常通用的认识方法,自然对 Web3 也管用。不过,系统思考历史上是系统动力学的一部分,但系统动力学对于 Web3 来说则过犹不及,希望对复杂系统的发展变化进行数学建模和精确仿真。对于 Web3 这么复杂的社会经济系统来说,实用性不高,误导性不低。因此,只需要了解系统思考就足够了,不必深入系统动力学。第三,货币和金融发展史,以及围绕货币的政治经济学议题。这一部分侧重于从货币的角度来看待各个国家的经济发展,以及全球政经格局演化,最近十多年来是全球中文圈的显学,相关图书资料可谓汗牛充栋,有不少书籍写得通俗生动,其中当然也有一些哗众取宠、煽风点火,近乎志怪演义,但诚意之作也不少,需要留心鉴别,交叉验证。读史使人智慧,Web3 本身也是货币金融体系发展到新阶段,与数字科技结合的产物,未来也必将被写入到历史当中,因此了解货币和金融是如何一路走过来的,对于理解 Web3 非常有益处。这种好处,未必是你能够直接拿出来当成工具使用,而是潜移默化地开阔你的视野,深化你的思考,特别是能够给你很多参考模型和故事,帮助你在面对选择和需要决策的时候更加明智。第四,中央银行学、金融市场与金融机构。这可能是对于理解和应用 Web3、DeFi 和通证经济最为有用的单一学科,通常是货币经济学的一部分,比如这个领域的一部名著就是米什金的《货币、银行和金融市场经济学》,光看书名就知道是一门大学问,包含不少内容,广而言之就是从“钱”的流动角度来看现实世界的经济运行。不过其中的内容对于学习 Web3 来说有远近之分,比如商业银行相关的理论跟 Web3 就没有什么关系,因为像商业银行那样通过信贷创造流动性的方式,恐怕在可见的未来都不会见容于 Web3 世界。货币理论、特别是宏观经济学中涉及到货币需求量的几个模型,乍一听好像很有价值,其实只具有认识上的参考意义,实践当中完全用不上,找一本经济学入门书看看相关章节即可。真正特别实用的部分,就是中央银行货币政策及工具,以及金融市场与金融机构。这一部分主要探讨中央银行、商业银行和其他非银金融机构如何基于市场机制相互配合,把货币从银行系统这个心脏中创造出来,然后再通过各种金融工具在市场上泵送给经济各部门,并调节优化,达成一系列政策目标。这些知识对于 Web3 行业运行机制的理解、周期的判断,以及具体到 Web3 通证经济机制的设计,都有非常直接的参考价值,因此我建议在这个方向上投入较多的时间。我对几个朋友和同事都给出了这样的建议,他们当中能够塌下心来认真学习一段时间的人,很快对于整个 Web3 和数字资产的认识就会得到一个升级。我的主要建议就是这样。不过另一方面,也得提醒一下,所有前面提到的种种,全都是传统的知识,没有一个是为 Web3 创建的学问,更没有一个能“保送”你成为 Web3 高手。如何将这些旧酒装到 Web3 这个新瓶里,这正是你自己要去解决的问题。不过,另一方面,这也是机遇所在。另外,如果要研究 Web3 的某一个具体的应用分支,比如游戏、电商、交易,肯定还有很多更专业东西需要掌握。但是依我看来,今天学习 Web3 的人,普遍缺少的是经济、货币、金融方面的正确认识,而不是其他,因此在上面的推荐中我重点覆盖了相关内容。缺少认识,却勇于创新,读得太少,想得太多,胆子太大,这是很多 DeFi 和 Web3 项目崩溃的一个主观原因。希望本文能帮助有心的读者稍探路径,在学习 Web3 时少走弯路,多些分寸。《Web3 国际市场危机分析》系列文章:市场危机分析|其一:DeFi 伪创新导致市场失灵市场危机分析|其二:Crypto 市场的美元化流动性视角中 CeFi 的功与过————————————————版权声明:本文为CSDN博主「myan」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。原文链接:https://blog.csdn.net/myan/article/details/125795577
-
 以证件号码(既有纯数字字符串,也有数字字母混合的字符串)为例,通过js代码获取数据对象executeScript后(方法可参考[executeScript]快速完成网页数据的填充/JS脚本操作网页的方法分享/js/),通过assign赋予明确的数据类型为string,而不是让RPA自动识别数据类型,避免后续运行eval表达式、字符串子串截取时出现数据类型不匹配。
-
 导入证书是原因是应为浏览器需要和软终端进行wss链接,改链接需要用到证书。但是有个问题就是需要手动在浏览器导入根证书。有没有办法做到不需要手动导入证书到浏览器。菜鸟一枚。恳请大佬们给与帮助。非常感谢
-
我十分荣幸能够参加openLooKeng Web UI增强项目,这是我接触的第一个项目,在这个项目中我学到了很多东西,成长了很多,也收获了很多。在做项目的过程中,不仅强化了我的写代码能力,也接触到了前沿的技术和理念。 openLooKeng Web UI增强项目主要包括以下业务:openLooKeng审计日志功能增强 openLooKeng SQL历史记录查询功能增强SQLEditor支持自动联想支持常用sql语句的收藏前端异常标记显示数据源 在刚开始接手这个项目的时候,我手足无措,不知道从哪里入手。同时,对于第一次做项目的我而言,openLooKeng项目的代码量绝对可以用“庞大”这个词来形容了。仅仅是阅读并理解前端的主要代码都耗费了将近一周的时间,并一度陷入焦虑,怀疑自己到底能不能把这个项目要求的功能完整实现。这个时候,我感受到了团队的力量。一个人的力量毕竟有限,不论是智力,能力还是精力,都有所不能及的地方,集一个团队的力量,发挥整个团队的作用,这样就能解决更多的问题,战胜更多的困难。学长给予了我很多指导和帮助,并且让我有了信心。在他的帮助下,我更快地进入到了工作状态,提高了工作效率。 通过参加华为openLooKeng Web UI增强项目,让我对前端开发有了更进一步的认知以及更深入的学习,并且让我对React框架更加熟悉,对JavaScript语言有了更深层次的了解,对前后端交互认识的更加透彻。同时,也让我认识到,在整个项目周期,计划显得格外的重要,只有进行详细的计划,我们才能各施其职,各尽其责,也才有紧迫感,并要求自己抓紧时间完成当天的任务。这样就不会畏首畏尾,也不至于不知道下一步该干什么,不会遗漏掉太多东西。当然,就算制定了一个计划,如果没有按照那个计划来,或者拖沓松懈,有今天不能完成明天做的思想,总觉得有的是时间,把大量的任务往后压,就达不到预期的效果。此时,组长的带头作用以及监督作用就很有必要,严格按照计划执行,是计划行之有效的强有力保证。 从一开始的手足无措到后面独立完成自己对应的任务,可以清晰地看到我的成长,同时也离不开老师的教诲与学长的指导,我非常感恩参加openLooKeng Web UI增强项目的这一段经历,“逼”着我迈出了舒适圈,尝试自己涉足未深但即将踏入的领域,给我带来了很多收获,同时也让我认识到了自己很多的不足。如果以后有机会,我愿意更多地参加华为的项目,在提升自己的同时,也能为祖国的发展贡献出自己的绵薄之力!华中科技大学——杨劲帆指导老师:甘早斌
-
非常荣幸可以参加 openLooKeng Web UI增强项目的开发,在此项目中跟着学校老师和华为团队学到很多的东西。在项目中不仅学习到了前沿的技术,还锻炼了我的学习能力和动手能力。从项目初期,到项目经过了一段时间之后,对项目有了整体的把握,对各环节有了更清晰的认识与规划。这对我来说是一个全新的领域。于是从零开始一步步搭建环境,编码开发,集成测试。在此过程中,除了克服自己负责区域的困难之外,对于有需要和衔接的问题,还与小组成员一起在一次次的磨合中找出了解决方案,有妥协,有商量,分阶段对成果进行总结,分析,改进,及时调整研究方向的偏差,尽力保证项目质量。通过参加这次 openLooKeng Web UI增强项目的开发,我们都有了很多收获。首先是对这种项目的进一步认识。在 openLooKeng Web UI增强项目中强调的是自主性、探索性、实践性和协作性,强调项目实施过程中在创新思维和创新实践方面的收获,重在参与过程中充分发挥主观能动性,运用所学的知识,使自己得到锻炼和提高。回想自己参加openLooKeng Web UI增强项目的经历,从开始对项目内容的理解认识到项目计划的讨论和确定,从对项目的整体把握到寻找突破点,并制定详细的项目方案和进程,以及项目当中重要的实践环节,整个openLooKeng Web UI增强项目的过程中我不仅学到了许多我所感兴趣的、觉得有用的东西,更重要的是自己的思维能力、团队协作能力、实践能力都得到了提高,而且也学到了坚持不懈、善于思考、积极总结的可贵精神。这次的项目对我来说是个很好的体验,感谢学校老师和华为团队。参与此项目即提升了自己的能力,又为祖国的伟大复兴贡献了自己的力量。华中科技大学---孙锐指导老师:甘早斌
-
我非常荣幸参加了鲲鹏openLooKeng集群管理平台项目的方案设计。我从需求分析,方案调研,方案设计,系统开发、测试、部署以及文档编写等环节中受益良多,与华为团队的合作也让我体会到了一个优秀公司对于项目开发的严谨与求真。 我们的任务是开发一套管理平台,供方便的集群部署功能和集群管理功能,降低用户搭建openLooKeng集群的难度。在指导老师的带领下,对项目需求分析和相关集群管理平台的功能调研,我们主要从三个方面进行评估方案设计: 1. 平台搭建的简易度 通过上面openLooKeng的需求分析和相关集群管理平台的功能参考,对比发现CDH、Ambari在配置主机的时候都相对复杂,用户需要登录物理服务器去进行配置。 我们对集群管理平台的设计理念是简化用户实际操作服务器的步骤。同时考虑对openLooKeng平台不熟悉的用户能有更好的体感,平台需增加引导安装功能,帮助用户快速完成openLooKeng管理平台的搭建。openLooKeng搭建的业务流程设计为:添加主机-->创建集群(选择已添加的运行主机、选择角色)-->属性配置-->完成安装。相应页面设计如下:• 添加主机:• 新建集群:• 属性配置: 2. 页面布局 对比相关集群管理平台的页面布局及风格: 1)CDH、Ambari对于主机和集群的监控展示较为丰富,rainbond的页面布局和风格更加简洁和美观。 2)可视化监控方面,Ambari的监控看板更加灵活。 openLooKeng集群管理平台可进行参考设计如下: 数据看板: • 主机监控: • 集群监控: • 实例监控: 3. 用户体验 openLooKeng集群管理平台对于用户而言必须操作方便,我们将复杂的代码编写转变成web页面操作,设计的页面简洁而功能灵活丰富,其主要功能操作页面如下: • 属性配置 coordinator=1个时的基础配置 coordinator>=2个,进入基础配置&HA配置(基础配置下方多出两项配置:状态存储、文件系统)。 • 版本升级:分为在线、离线两种方式。 集群/实例在线升级: 集群/实例离线升级: • 集群/实例功能操作:启动、停止、升级、卸载、重启功能,还可以查看实例列表,对单个或多个实例进行关闭、重启、升级、卸载、配置的操作。 在【集群概览】页面点击“访问地址”路径进入集群使用平台,对实例监控运行情况或功能操作: • 主机(实例)的伸缩 添加主机: 日志下载: 对主机实例的功能操作: 好的方案设计是团队所有成员共同努力、相互协作的成果。在项目开发过程中我们特别感谢华为涂盛霞团队老师们的辛苦付出,老师们积极、严谨、友好沟通的态度,是我们学习的标杆!苏州旺满信息科技有限公司-旺满鲲鹏openLookeng团队-王海琴指导老师:王满海
-
 本人有幸参与了 openGauss 众智计划《ShardingSphere 对接 openGauss》,让我学习到了很多与 openGauss 数据库协议、安全等方面的知识。 本文主要记录如何在没有协议文档的情况下,根据 openGauss JDBC Driver 源码,让 ShardingSphere openGauss Proxy 支持 openGauss 的 SCRAM SHA-256 前端认证机制。 ## 前言 > 目标:让 ShardingSphere openGauss Proxy 支持以 SCRAM SHA-256 机制验证 openGauss 客户端的身份。 最近在做一个和 ShardingSphere Proxy openGauss 前端认证方式相关的 issue [ShardingSphere openGauss Proxy supports sha256 authentication method #13995](https://github.com/apache/shardingsphere/issues/13995)。 PostgreSQL 有一种前端认证方式是 `MD5` Password。客户端根据服务端提供的 salt 对密码进行 MD5 加密并发送,完成认证过程。 但 MD5 安全性比较有限,openGauss 前端认证推荐并默认使用 `SHA-256`。 虽然说是 `SHA-256` 认证,听起来就是与 PostgreSQL 的 MD5 认证大同小异,只是摘要的长度不一样,后来做起来才发现完全不是这样。openGauss 用的是 SCRAM,其中的哈希算法可以使用 `SHA-256` 或者国密算法。 在做这个 issue 之前,我不了解 SCRAM,其他安全相关知识也了解不深,实现过程也是费了一些心思。 ## 环境准备 ### openGauss 数据库与客户端 本文所使用的 openGauss 数据库及 `gsql` 均使用 Docker Image [enmotech/opengauss:2.1.0](https://hub.docker.com/r/enmotech/opengauss) openGauss JDBC Driver 使用 [org.opengauss:opengauss-jdbc:2.0.1-compatibility](https://mvnrepository.com/artifact/org.opengauss/opengauss-jdbc/2.0.1-compatibility) ```xml org.opengauss opengauss-jdbc 2.0.1-compatibility ``` ### openGauss 服务端配置 `enmotech/opengauss:2.1.0` 默认使用了 MD5 认证方式,需要修改各项配置为 `sha256` 并新建用户。 `postgresql.conf` 需要配置: ``` password_encryption_type = 2 ``` `pg_hba.conf` 需要配置: ``` host all all 0.0.0.0/0 sha256 ``` 配置完成后需要重启或执行 `gs_ctl reload` 生效。 最后创建一个新用户: ``` CREATE USER wuweijie PASSWORD 'Wuweijie@123'; ``` ## 没有文档?去扒一下客户端源码看看是怎么做的。 ### 确定 SHA-256 认证方式的枚举值 可能是一般的用户与开发者不会关心数据库协议,openGauss 的文档中没有包含对协议细节的说明,包括本次要做的 SCRAM SHA-256 前端认证,openGauss 文档说明了如何配置,但没有说明如何实现。 没有文档怎么办?就像之前实现 openGauss 批量协议一样,看一下客户端是怎么做的。 /gitee.com/opengauss/openGauss-connector-jdbc/blob/master/pgjdbc/src/main/java/org/postgresql/core/v3/ConnectionFactoryImpl.java#L63> ```java private static final int AUTH_REQ_MD5 = 5; // 省略部分代码... private static final int AUTH_REQ_SHA256 = 10; ``` PostgreSQL MD5 认证方式的枚举值为 5,openGauss 所增加的 SHA-256 认证方式枚举值为 10。 ### 确定 Auth Request 数据包的内容 /gitee.com/opengauss/openGauss-connector-jdbc/blob/master/pgjdbc/src/main/java/org/postgresql/core/v3/ConnectionFactoryImpl.java#L668> openGauss JDBC Driver 认证相关关键逻辑节选及本文注释说明: ```java case AUTH_REQ_SHA256: { // 省略部分代码... byte[] digest; int passwordStoredMethod = pgStream.receiveInteger4(); // 省略部分代码... if (passwordStoredMethod == PLAIN_PASSWORD || passwordStoredMethod == SHA256_PASSWORD) { String random64code = pgStream.receiveString(64); String token = pgStream.receiveString(8); byte[] result = null; // 由于 openGauss 最新的客户端都使用 3.51 的协议版本,以下分支只需关心最后的 else if (this.protocolVerion PROTOCOL_VERSION_350) { // 省略部分代码... } else if (this.protocolVerion == PROTOCOL_VERSION_350) { // 省略部分代码... } else { // 本次实现只看本分支 int server_iteration = pgStream.receiveInteger4(); result = MD5Digest.RFC5802Algorithm(password, random64code, token, server_iteration); } if (result == null) // 省略部分代码... pgStream.sendChar('p'); pgStream.sendInteger4(4 + result.length + 1); pgStream.send(result); pgStream.sendChar(0); pgStream.flush(); break; } else if (passwordStoredMethod == MD5_PASSWORD) { // 省略部分代码... } else { // 省略部分代码... } // 省略部分代码... } ``` > 代码中的方法 `RFC5802Algorithm` 也就是 `SCRAM`。 ### 大致明确 Auth Request 数据包的结构 综上,如果要把 ShardingSphere Proxy 伪装成 openGauss 数据库服务端进行 SCRAM SHA-256 认证,需要发送的数据包长这样: ``` Byte1('R') 表明这个消息是个认证请求。 Int32(88) 消息内容的长度(以字节为单位),包括长度自身,不包括消息类型。 Int32(10) 表明使用的认证方式为 SHA-256。 Int32(2) 表明用户的密码存储方式使用的是 SHA-256。 Byte64 random64code 长度为 64 的字符串,含义暂时不清楚,根据命名猜测类似 salt,参与 SCRAM 计算。 Byte8 token 长度为 8 的字符串,参与 SCRAM 计算。 Int32 server_iteration 一个整数,参与 SCRAM 计算。 ``` 从客户端接收到的数据包长这样: ``` Byte1('p') 表明这个消息是个认证响应。 Int32 消息内容的长度(以字节为单位),包括长度自身,不包括消息类型。 String 一个以 '\0' 结尾的字符串。 ``` ## Wireshark 抓包观察 从源码层面了解了数据包的格式后,通过 Wireshark 抓包偷窥 openGauss 客户端与数据库的交互过程。 当数据库收到客户端发送的 Startup 消息后,给客户端响应了一个类型为 `R` 的消息,要求客户端按照协议完成身份认证。以下为服务端发送给客户端的数据: > 因为 Wireshark 只支持解析 PostgreSQL 协议,openGauss 特有的消息在 Wireshake 里体现为 Malformed Packet。 下图中数据包的结构用不同颜色的方框标注,可以看出数据的结构跟前面明确的数据包结构一致。(看不清可以点开大图)  再看以下客户端返回的信息,根据之前明确的数据包结构,客户端的认证消息里面只有一个字符串,所以客户端发送的是一个长度为 `64` 的字符串。(69 - 长度字段本身 4 - `'\0'` 结尾字符)  ## 实现过程 ### 创建对应的消息定义 Proxy 发送给客户端的认证请求节选: [OpenGaussAuthenticationSha256Packet.java](https://github.com/apache/shardingsphere/pull/14002/files#diff-7b4e56bc061bee907486d1077830e8b9e1e70ba4c8c9730e581609b3f8bc9574) ```java public final class OpenGaussAuthenticationSha256Packet implements PostgreSQLIdentifierPacket { private static final int AUTH_REQ_SHA256 = 10; private static final int PASSWORD_STORED_METHOD_SHA256 = 2; private final byte[] random64Code; private final byte[] token; private final int serverIteration; @Override public void write(final PostgreSQLPacketPayload payload) { payload.writeInt4(AUTH_REQ_SHA256); payload.writeInt4(PASSWORD_STORED_METHOD_SHA256); payload.writeBytes(random64Code); payload.writeBytes(token); payload.writeInt4(serverIteration); } @Override public PostgreSQLIdentifierTag getIdentifier() { return PostgreSQLMessagePacketType.AUTHENTICATION_REQUEST; } } ``` 客户端发送给 Proxy 的认证响应直接复用了 [PostgreSQLPasswordMessagePacket.java](https://github.com/apache/shardingsphere/pull/14002/files#diff-7b4e56bc061bee907486d1077830e8b9e1e70ba4c8c9730e581609b3f8bc9574),代码节选: ```java public final class PostgreSQLPasswordMessagePacket implements PostgreSQLIdentifierPacket { private final String digest; public PostgreSQLPasswordMessagePacket(final PostgreSQLPacketPayload payload) { payload.readInt4(); digest = payload.readStringNul(); } @Override public void write(final PostgreSQLPacketPayload payload) {} @Override public PostgreSQLIdentifierTag getIdentifier() { return PostgreSQLMessagePacketType.PASSWORD_MESSAGE; } } ``` ### 实现校验逻辑 首次实现校验逻辑的时候,我还不了解 SCRAM 的逻辑,于是我就按照 `MD5` 认证方式的实现方式去做。 实现思路:把客户端对密码的处理方式在 Proxy 重现一遍,最后把客户端发送的认证数据和 Proxy 内计算产生的结果对比。 Proxy 在认证请求里需要给客户端发送两个字符串 `random64code` 和 `token`,那就随机生成;整数 `server_iteration` 看到代码里在协议 `3.50` 里写死 `2048`,那此处就取 `2048`: ```java public OpenGaussAuthenticationEngine() { random64Code = RandomStringUtils.randomAlphanumeric(64); token = RandomStringUtils.randomAlphanumeric(8); serverIteration = 2048; } ``` ### 初步验证 写了一段简单的程序验证:(`5433` 是 openGauss,`55433` 是 ShardingSphere Proxy openGauss) ```java //try (Connection connection = DriverManager.getConnection("jdbc:opengauss://127.0.0.1:5433/postgres", "u3", "Wuweijie@123")) { try (Connection connection = DriverManager.getConnection("jdbc:opengauss://127.0.0.1:55433/freedom", "wuweijie", "Wuweijie@123")) { try (PreparedStatement preparedStatement = connection.prepareStatement("show all variables")) { try (ResultSet resultSet = preparedStatement.executeQuery()) { while (resultSet.next()) { System.out.println(resultSet.getString(1) + " -> " + resultSet.getString(2)); } } } } ``` 部分输出: ``` sql_show -> true sql_simple -> false ``` 能够正常连接 ShardingSphere Proxy openGauss 并通过认证,于是就形成了这个 PR: [Add SHA256 authentication for openGauss Proxy #14002](https://github.com/apache/shardingsphere/pull/14002) ### 无意间发现问题 第二天想着当时只用了 openGauss JDBC Driver 验证,要不试试 `gsql`: ```bash wuweijie@wuweijie-ubuntu /home/wuweijie % docker run --rm -i -t --network host enmotech/opengauss:2.1.0 gsql -h 127.0.0.1 -Uwuweijie -W'Wuweijie@123' -p 55433 freedom gsql: FATAL: password authentication failed for user "wuweijie" ``` 结果发现认证失败!以同样的方式直连 openGauss 却没有问题,可能是我的实现方式有问题。但是 openGauss 在协议方面没有文档,我也不知道应该怎么做。问了一下 openGauss 的专家,得到一个参考文档:[openGauss支持国密SM3和SM4算法](https://opengauss.org/zh/blogs/blogs.html?post/douxin/sm3_for_opengauss/) 除了哈希算法不一样,SCRAM 的机制是一样的。 这时候我才进一步了解 SCRAM 这种机制。 ### 调整 Proxy 校验逻辑 后面我根据以下参考资料调整了 Proxy 的校验逻辑。  以上图片来源于:/opengauss.org/zh/blogs/blogs.html?post/douxin/sm3_for_opengauss/> 之前的变量名对应关系如下: * `random64code` -> `salt` * `token` -> `nonce` 调整后的逻辑大致如下: ```java private static boolean isPasswordRight(final ShardingSphereUser user, final Object[] args) { String h3HexString = (String) args[0]; String salt = (String) args[1]; String nonce = (String) args[2]; int serverIteration = (int) args[3]; byte[] serverStoredKey = calculatedStoredKey(user.getPassword(), salt, serverIteration); byte[] h3 = hexStringToBytes(h3HexString); byte[] h2 = calculateH2(user.getPassword(), salt, nonce, serverIteration); byte[] clientCalculatedStoredKey = sha256(xor(h3, h2)); return Arrays.equals(clientCalculatedStoredKey, serverStoredKey); } ``` ### 再次验证 实现完了,使用之前的 Java 代码验证 openGauss JDBC Driver 能够通过认证。 再用 `gsql` 验证,居然还是报错: ```bash wuweijie@wuweijie-ubuntu /home/wuweijie % docker run --rm -i -t --network host enmotech/opengauss:2.1.0 gsql -h 127.0.0.1 -Uwuweijie -W'Wuweijie@123' -p 55433 freedom gsql: FATAL: password authentication failed for user "wuweijie" ``` 又试了一下 2.0.0 的版本,同样报错: ```bash wuweijie@wuweijie-ubuntu /home/wuweijie % docker run --rm -i -t --network host enmotech/opengauss:2.0.0 gsql -h 127.0.0.1 -Uwuweijie -W'Wuweijie@123' -p 55433 freedom gsql: FATAL: password authentication failed for user "wuweijie" ``` ### 再次 Review 并修改 看逻辑没看出什么问题,再次观察 Wireshake 窃听到的 openGauss 数据库发送给客户端的数据包:  发现我之前遗漏了细节: 在数据包的 `random64code` 和 `token` 参数部分,数据值的字符只有 `[a-f0-9]`,而我用的随机字符串生成方法是 `[A-Za-z0-9]`。 ```java random64Code = RandomStringUtils.randomAlphanumeric(64); token = RandomStringUtils.randomAlphanumeric(8); ``` 调整随机字符串生成方法并重命名变量: ```java saltHexString = generateRandomHexString(64); nonceHexString = generateRandomHexString(8); private String generateRandomHexString(final int length) { ThreadLocalRandom random = ThreadLocalRandom.current(); StringBuilder result = new StringBuilder(length); for (int i = 0; i result.capacity(); i++) { result.append(Integer.toString(random.nextInt(0x10), 0x10)); } return result.toString(); ``` 再次验证。 ### 最终验证 `gsql` 输出结果: ``` [~] docker run --rm -i -t --network host enmotech/opengauss:2.1.0 gsql -h 127.0.0.1 -Uwuweijie -W'Huawei@123' -p 55433 freedom gsql ((openGauss 2.1.0 build 590b0f8e) compiled at 2021-09-30 14:29:04 commit 0 last mr ) Non-SSL connection (SSL connection is recommended when requiring high-security) Type "help" for help. freedom=> show all variables; variable_name | variable_value ---------------------------------------+---------------- sql_show | true sql_simple | false kernel_executor_size | 0 省略部分输出 transaction_type | LOCAL (20 rows) ``` 用之前的代码验证 openGauss JDBC Driver,部分输出: ``` sql_show -> true sql_simple -> false ``` 两种客户端都能完成认证,于是再提一个 PR。 [Refactor openGauss frontend SCRAM SHA-256 authentication #14073](https://github.com/apache/shardingsphere/pull/14073) 完成! ## 回顾 如果一开始能够正确生成随即字符串,第一个 PR 的做法应该也是能够达到身份认证的目的的,但这不符合 SCRAM 的做法。 本次众智计划,让我学习到了很多与 openGauss 数据库协议、安全等方面的知识。后续再做类似的事情的时候,一定要先了解清楚相关知识,比如本次的 SCRAM。不明确字段含义的时候,一定要多观察特征、细节。 ## 参考资料 * /opengauss.org/zh/docs/2.1.0/docs/Developerguide/%E9%85%8D%E7%BD%AE%E5%AE%A2%E6%88%B7%E7%AB%AF%E6%8E%A5%E5%85%A5%E8%AE%A4%E8%AF%81.html> * /datatracker.ietf.org/doc/html/rfc5802> * /opengauss.org/zh/blogs/blogs.html?post/douxin/sm3_for_opengauss/>
-
编译完成下载前端包时出现报错
-
配置文件已经按照用户文档配置好了。直接运行Loader的 ./shell-client/submit_job.sh的命令。./submit_job.sh -n GaussDB-to-HDFS -u n(已经通过webui配置了名为GaussDB-to-HDFS的作业,并且页面成功了)web页面已经配置并运行成功了。但shell还是报错shell这个报错是log4j的问题,感觉是shell-client下面的conf/log4j.properties有问题。但是检查了下并没有发现错误
-
【功能模块】【RPA】【WeAutomate浏览器插件】【操作步骤&问题现象】1、步骤:谷歌浏览器启用WeAutomate插件,在浏览器中登录我们的Web系统2、现象:浏览器卡死,点页面无任何反应,CPU动态100%3、反例:禁用WeAutomate插件时,一切正常;【截图信息】【日志信息】(可选,上传日志内容或者附件)
-
X企业容器化改造方案 【背景】A企业是一家位于杭州的软件开发公司,具备自主设计软件,交付软件及销售的能力,目前公司业务已经上华为云,考虑到开发及交付的便利性,准备进行容器化改,目标是能够实现软件开发即交付。业务现网状况如下:目前2台web服务器作为前端,mysql数据库,软件负载均衡器,无数据库中间件,后端EVS云硬盘,针对于本企业的现状,给出各部分的容器化改造及后续方案. 1:负载均衡应用改造点:选择合适的负载均衡器中小型的Web应用可以使用ngnix或HAProxy,大型网站或重要的服务可以使用LVS,目前该企业业务较小,选取nginx作为负载均衡器!2:web应用改造点:应用存在长时间执行请求 增加消息队列,通过消息队列将长任务与用户请求解耦3:应用服务器应用改造点:应用实例依赖于本地的存储来持久化数据如果是日志,建议变成流汇聚到分布式日志系统中。如果必须要使用存储,要使用共享文件系统如NFS4:资源及集群规划规划:目前采用单集群规划,云资源中有其他应用项目请画出简要的资源规划图: 5:高可用规划 结合华为云,给出高可用规划的简单说明: 分别在2个AZ中部署两套CCE集群,K8S Master采用本地3节点高可用部署;应用AZ内高可用部署,通过ClusterIP服务调用不跨AZ。应用发布LoadBalancer类型的Service对接到集群所在AZ的融合ELB服务实例;应用通过VIP访问数据库,数据库自动切换应用不感知。支持多AZ动态容器存储,根据pod所在AZ创建数据卷。6:网络规划:集群内部应用默认可通过ClusterIP类型服务相互通信。k8s集群内置DNS服务,服务间访问可以通过IP或域名访问,请画出K8S集群内部应用网络互通示意图: Step1:kube-proxy、core-dns从Master中kube-apiserver订阅service,POD2的Service创建时,kube-proxy刷新本节点iptables,core-DNS更新路由数据。Step2:Pod2通过域名访问Pod4的service4,发起到core-dns查询请求,并获取对应的ClusterIP(如果使用ClusterIP直接访问则忽略这一步骤)Step3:Pod2发送业务报文,目的地址为获取到的ClusterIP。容器网络根据目的地址匹配策略后进行VxLAN封装,封装源地址为容器所在的VM IP地址,目的地址为目的容器所在VM IP,并将报文发给I层vSwitch,然后转发至目的容器所在VM,容器网络解VxLAN封装后,根据ClusterIP将业务报文发送目的service及POD。
-
中小企业容器化改造建议企业应用容器化改造,一般有以下三种方式:• 方式一:单体应用整体容器化,应用代码和架构不做任何改动。• 方式二:将应用中升级频繁,或对弹性伸缩要求高的组件拆分出来,将这部分组件容器化。• 方式三:将应用做全面的微服务架构改造,再单独容器化。对于中小企业而言,首次做容器化改造,建议选择方式一,主要优点有:• 业务0修改:应用架构和代码不需要做任何改动。• 提升部署和升级效率:应用可构建为容器镜像,确保应用环境一致性,提升部署效率。• 降低资源成本:Docker对系统资源利用率高。相比虚拟机技术,一个相同配置的主机,往往可以运行更多数量的应用。确定容器化改造方式后,企业就可以着手改造。以近期遇到的某中小企业改造为例。企业现状:该企业目前2台web服务器作为前端,mysql数据库,软件负载均衡器,无数据库中间件,后端EVS云硬盘。企业改造点:1、负载均衡应用改造点:选择合适的负载均衡器。一般中小型的Web应用可以使用ngnix或HAProxy,大型网站或重要的服务可以使用LVS,目前该企业业务规模较小,选取nginx作为负载均衡器;2、web应用改造点:应用存在长时间执行请求。增加消息队列,通过消息队列将长任务与用户请求解耦。3、应用服务器应用改造点:应用实例依赖于本地的存储来持久化数据。日志建议变成流汇聚到分布式日志系统中。如果必须要使用存储,要使用共享文件系统如NFS。4、资源及集群规划:目前采用单集群规划(假设云资源中有其他应用项目),给出示意图如下:5、 高可用规划• 分别在2个AZ中部署两套CCE集群,K8S Master采用本地3节点高可用部署。• 应用AZ内高可用部署,通过ClusterIP服务调用不跨AZ。• 应用发布LoadBalancer类型的Service对接到集群所在AZ的融合ELB服务实例。• 应用通过VIP访问数据库,数据库自动切换应用不感知。• 支持多AZ动态容器存储,根据pod所在AZ创建数据卷。6、 网络规划集群内部应用默认可通过ClusterIP类型服务相互通信。k8s集群内置DNS服务,服务间访问可以通过IP或域名访问。K8S内部应用网络互通示意图如下:Step1:kube-proxy、core-dns从Master中kube-apiserver订阅service,POD2的Service创建时,kube-proxy刷新本节点iptables,core-DNS更新路由数据。Step2:Pod2通过域名访问Pod4的service4,发起到core-dns查询请求,并获取对应的ClusterIP(如果使用ClusterIP直接访问则忽略这一步骤)Step3:Pod2发送业务报文,目的地址为获取到的ClusterIP。容器网络根据目的地址匹配策略后进行VxLAN封装,封装源地址为容器所在的VM IP地址,目的地址为目的容器所在VM IP,并将报文发给I层vSwitch,然后转发至目的容器所在VM,容器网络解VxLAN封装后,根据ClusterIP将业务报文发送目的service及POD。
-
现在前端开发的主流框架是啥啊
-
async handleExcel() { await exportExcel(JSON.stringify(this.gridData)).then(res => { const a = document.createElement("a"); a.download = "新闻"; const blob = new Blob([res], { type: "application/vnd.ms-excel" }); const objectUrl = URL.createObjectURL(blob); a.href = objectUrl; a.click(); window.URL.revokeObjectURL(objectUrl); }); },// 通用下载方法export function download(url, params, filename) { return service.post(url, params, { transformRequest: [(params) => { return tansParams(params) }], headers: { 'Content-Type': 'application/x-www-form-urlencoded' }, responseType: 'blob' }).then((data) => { const content = data const blob = new Blob([content]) if ('download' in document.createElement('a')) { const elink = document.createElement('a') elink.download = filename elink.style.display = 'none' elink.href = URL.createObjectURL(blob) document.body.appendChild(elink) elink.click() URL.revokeObjectURL(elink.href) document.body.removeChild(elink) } else { navigator.msSaveBlob(blob, filename) } }).catch((r) => { console.error(r) })}//zipexport function resolveBlob(res) { const aLink = document.createElement('a') var blob = new Blob([res.data], { type: 'zip' }) // //从response的headers中获取filename, 后端response.setHeader("Content-disposition", "attachment; filename=xxxx.docx") 设置的文件名; var patt = new RegExp('filename=([^;]+\\.[^\\.;]+);*') var contentDisposition = decodeURI(res.headers['content-disposition']) var result = patt.exec(contentDisposition) var fileName = result[1] fileName = fileName.replace(/\"/g, '') aLink.href = URL.createObjectURL(blob) aLink.setAttribute('download', fileName) // 设置下载文件名称 document.body.appendChild(aLink) aLink.click() document.body.appendChild(aLink)}
-
 ## 前言 Postman和Apifox有什么区别?他们之间分别有什么优势,感兴趣的同学可以继续往下看。 不吹不黑,只列功能,纯客观比对。 ## 一.功能列表对比 ### (一)接口设计与文档管理功能  1.导入功能对比 Apifox的导入功能除了支持OpenApi之外,还支持yapi,RAP2,postman等国内用得比较多的接口文档导入,而Postman支持的格式相对较少。   2.在线分享功能对比 Postman的在线分享功能,付费版支持“只读”功能,Apifox分享功能支持选择过期日期、设置密码,选择分享内容的范围,选择环境等功能。   3.编辑接口文档对比 接口文档既可以纯粹的MD格式文档对接口做整体说明,也可以在单个接口内部对单个接口进行说明注释。Apifox会增加创建时间、负责人、所属业务分组等业务和协同层面的注释信息。     4.生成代码功能对比 Postman支持将接口生成代码,postman支持的接口和框架为4种,Apifox支持130多种语言和框架 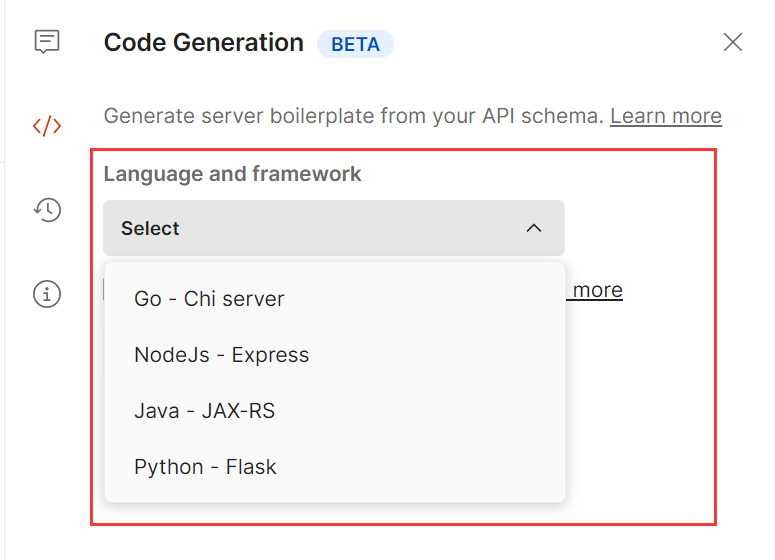  5.数据模型功能对比 在postman中没有这个功能,在Apifox中,由于本身具备接口设计的功能,因此会将实体类的相关参数封装成一个数据模型,供不同的接口调用,提高数据复用的效率,提高接口封装的程度,减少重复的工作。  ### (二)接口调试功能对比  对比了下,Postman基本依赖于JS脚本,通过编写脚本对接口进行调试。 Apifox则是可视化调试界面为主,自定义脚本编辑为辅。     两者对比,在postman中需要写脚本才能实现的接口断言和提取变量、等待时间,在这里都能直接通过填写参数来完成、不需要写脚本。 而操作数据库这个功能postman则不支持。postman只支持js脚本,Apifox目前支持调用其他语言的外部函数和脚本,不过需要先安装相关的Python、java等环境。 ### (三)接口mock功能  Postman也有mock功能,但它的mock服务需要自己搭建而且mock功能并不强。 在Postman上执行API mock 需要经过3步: 第一步:创建 mock服务器,获得mock url 第二步:逐个编写并添加 mock 示例,供执行mock时返回对应的接口响应  也就是说接口mock 出来的响应来源于先前调试已经有的,或者直接自己编辑一个响应进去,才能得到一个返回。 mock server 只能返回自己手动添加进去的几条响应,而无法自己无限制创建出mock 数据。 第三步: 将mock url 复制到接口里进行调试。 而想要在 Apifox 内做接口 mock 只需要在`环境`中选择mock服务 在响应参数中选择mock规则,点击发送请求,则mock服务会返回与实际业务返回高度相似的接口响应。    ### (四)接口测试功能  在Postman里写测试脚本,使用动态参数,接口响应断言,参数传递都通过写脚本来实现。 如果要作业务接口测试,需要写各种场景下的用例,同样是通过写脚本来修改参数用例的执行顺序和设置循环次数的。使用postman至少需要掌握基础的js语言。 Apifox里面做自动化测试可视化程度相对较高一些,创建用例的时候可以在接口设计面板修改参数然后保存,场景用例可以添加不同的参数用例作为步骤,通过拖曳来选择用例的执行顺序。 右侧的面板可以填写循环次数,接口间的参数传递和断言也可以在可视化面板提取出来。完成单个接口测试或者场景测试,都不需要写代码。  ## 二.团队协作功能  Postman的团队协作功能是付费的,3人以下团队可使用免费版协作,3人以上根据可用功能和人数有不同的价格版本。 但通常一个团队不可能只有3个人,也就是说,有限开放的那点协同功能是无法支持正常的团队协作需求的。  Apifox的协同功能是免费的,团队成员的权限管理,接口数据同步、在线分享都没有障碍。 本身Apifox的定位和Postman就不一样,它一出生就是定位在API管理和协作上。 所以除了协作功能必须的权限管理和数据同步上,它也最大程度地做数据复用,尽量减少不必要的工作量。 比如说接口调试的参数用例可以直接导入来做自动化测试,一个数据模型可以给多个接口使用,一套接口数据可以给后端做调试、前端做mock、测试做自动化。  ## 三.Apifox 没有的功能 Postman支持fork GitHub上的代码,以及API 网关。这两块在Apifox上均没有相关的功能。 两个工具的功能有相同的地方,但本质上各自的市场定位还是不同的,Postman打通了接口调试、测试、到线上监测,代码生成。 而Apifox始终立身于前端、后端测试间基于接口的设计、调试、测试、文档管理等一系列接口的生命周期管理来发力。 在相同的功能点上,Apifox基于本土互联网团队的协作模式和痛点,基本做到了人无我有,人有我优 的程度。 因此如果基于各种原因,寻找Postman替代的开发们,不妨体验一下Apifox。 ## 四.产品价格 从收费模式上看,postman是基础功能不收费,协作功能收费;Apifox是公网版本不收费,私有化部署收费。 Apifox的SaaS版本也没有什么功能和团队人数的限制,对于我们常规的项目开发来说,免费版本就够用了。 公网的SaaS版本,数据的确是放在他们服务器上的,但这点Postman其实也一样,而且postman的服务器可是放在国外的。 如果大家的项目安全保密级别较高,想要做私有化部署,可以去他们官网咨询,这方面我没咨询过就不对比了。  ### 下载地址 **Apifox官网**:[www.apifox.cn](https://www.apifox.cn/?utm_source=liam)
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签