-
 了解鲲鹏BoostKit大数据图分析算法,更多详情可参见鲲鹏文档中心:https://www.hikunpeng.com/document/detail/zh/kunpengbds/appAccelFeatures/algorithmaccelf_ga
-
 大家好!我是酷哥,数据库相关资讯,带您速览,欢迎大家阅读。 ------------------------------------------------ **本期精选** ------------------------------------------------ - 计世指数-数据库产品影响力指数发布会成功召开 - 数据库未来:湖仓一体新趋势 - 推动数据中心绿色高质量发展的技术趋势和解决思路 - 数据资产如何确权认责 - 大数据时代的“冷热数据”管理 - Gartner发布2022年银行技术趋势,包含隐私增强计算 - 摘取皇冠上的明珠,华为云数据库的创新与探索 ------------------------------------------------ **资讯摘要** ------------------------------------------------ - 计世指数-数据库产品影响力指数发布会成功召开 **摘要:** 5月28日,围绕数据库产品,成功举办“计世指数-数据库产品影响力指数”线上发布会。本次发布会包括30个分布式数据库产品和8个集中式数据库产品。 数据库是IT系统存储和计算的基础,广泛应用于各行业,随着数据资源的爆发式增长,数字经济的发展壮大,迎来高速发展的重要机遇。数据库产品影响力指数旨在能够客观反映我国数据库的发展及应用情况,促进技术产品创新和行业应用,推动数据库产业高质量发展。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=189787](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=189787) - 数据库未来:湖仓一体新趋势 **摘要:** 随着企业数字化转型的推进,越来越多的企业视湖仓一体为数字化变革的契机。当然,关注度越高,市场上嘈杂的声音也就越多。 在实际业务场景中,数据的移动不只是存在于数据湖和数据仓库之间,湖仓一体不仅需要把数仓和数据湖集成起来,还要让数据在服务之间按需流动。 湖仓一体化架构,可以方便、快捷地将大量数据从数仓转移至数据湖内,同时这些移到湖里的数据,仍然可以被数仓查询使用。 目前湖仓一体已广泛应用于金融、电信、交通等行业。在PB级的数据量下,可以为企业节省上百万的服务器采购成本,充分实现了降本提效的目标。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=189797](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=189797) - 推动数据中心绿色高质量发展的技术趋势和解决思路 **摘要:** 5月26日,在贵州举行的2022中国国际大数据产业博览会“东数西算:构建国家算力网络体系”论坛上,由华为技术有限公司(以下简称“华为”)与国家信 息 中心、贵州省大数据发展管理局和粤港澳大湾区大数据研究院联合发布了《“碳达峰、碳中和”背景下数据中心绿色高质量发展研究报告》(以下简称《研究报告》)。 在推动数据中心绿色高质量发展的技术趋势和解决思路专项建议中,《研究报告》重点阐述了四大存储技术方向。即如何利用全闪存储技术、存算分离架构、数据重删压缩、数据密集型存储等技术推动在“东数西算”的背景下高质量达成数据中心“碳中和、碳达峰”目标。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=189523](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=189523) - 数据资产如何确权认责 **摘要:** 2020年04月10日,中 共 中 央、国务院印发《关于构建更加完善的要素市场化配置体制机制的意见》,将数据定义为与土地、劳动力、资本、技术并列的第五大生产要素——数字化时代的一种新型的生产要素。数据的价值越来越重要!然而对于“数据”,各个国家的法律似乎还没有准确界定数据资产权责体系。 所谓数据确权,就是确定数据的权利属性,主要包含两个层面:第一是确定数据的权利主体,即谁对数据享有权利。第二是确定权利的内容,即享有什么样的权利。 从这两个层面看,数据从产生到消亡的整个生命周期中,主要涉及四类角色,即:数据所有者、数据生产者、数据使用者和数据管理者。而确权就是针对特定的数据资产明确定义这四类角色的过程。也就是说,不同的数据资产其所有者、生产者、使用者和管理者可能不同。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=189529](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=189529) - 大数据时代的“冷热数据”管理 **摘要:** 冷热数据主要从数据访问频度、更新频度进行划分。冷数据,即实际生产中被访问、更新频度比较低、概率比较低的数据。热数据,访问、更新频度较高,未来被调用的概率较高的数据。冷数据在业务场景中计算时效要求慢,可以做集中化部署,可以对数据进行压缩、去重等降低成本的方法。热数据因为访问频次需求大,效率要求高,可以高性能存储与就近计算部署; 数据冷热管理最核心目标提高算力利用率,所谓算力通常包含CPU、GPU、内存、带宽等能力,算力瓶颈在于单位时间内处理数据能力。视频、人工智能等领域的算力消耗集中在对大规模数据及参数的“算法”的计算处理。在传统行业领域以结构化数据为主,算力消耗集中在“订单、客户、事件”三大类数据的搬运、数据排序、数据关联、数据合并、数据算术运算、数据的查询等。 希望通过对数据冷热区分,精准识别出“热”数据,减少对“冷数据”的搬运、关联、排序、计算等,把算力集中在刀刃上,实现数据处理“提速、降本”。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=190217](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=190217) - Gartner发布2022年银行技术趋势,包含隐私增强计算 **摘要:** 数博5月31日消息,Gartner发布了2022年银行和投资服务行业的三大热门技术趋势,分别是:生成式AI、自主系统和隐私增强计算。Gartner指出,这三项趋势将在未来两到三年内继续增长,推动金融服务机构的增长和转型。 Gartner研究副总裁Moutusi Sau表示:“虽然金融服务机构的首要事项是增长,但他们同样需要新的技术创新来管理风险、优化成本和提高效率。银行首席信息官可以通过生成式AI为追求收入增长的业务提供技术解决方案,而自主系统和隐私增强计算是能够为金融服务业务转型带来各种新选项的长期解决方案。” **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=189958](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=189958) - 摘取皇冠上的明珠,华为云数据库的创新与探索 **摘要:** 在国内做数据库,是一件很具挑战性的事情,因为这是基础软件皇冠上的明珠,是卡脖子的关键技术。 从海外厂商攻城略池的垄断到国产数据库厂商的艰难成长,从去IOE浪潮下的国产替代再到如今的百花齐放的市场局面,国产数据库产业一路走来,背后都是一批批企业和个人的信念与坚守。 目前,GaussDB立足创新与自研,基于同一架构,一方面拥抱并兼容主流关系型数据库生态如MySQL及非关系型数据库 MongoDB、Redis等生态,另一方面围绕自身开源的openGauss生态,打造面向政企客户,强调高性能、高可靠、高安全的产品。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=190216 ](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=190216) 上一期:[【技术之声】第二十一期(20220530)数据库资讯精选](https://bbs.huaweicloud.com/forum/thread-189422-1-1.html) *声明:文章源于第三方公开的信息,如果存在侵权或信息不实时,请及时联系处理。* 整理者:酷哥
-
一、为“数据”降本的背景 信息爆炸的时代数据极速膨胀,数据存储与计算消耗的IT资源、能源日益增长。为了节省能源,例如我国推出了东数西算,腾讯把数据中心装进了贵州山里,微软把数据中心建在海底,“脸书”在犹他州雪山旁建立新数据中心。海底的数据中心建设从硬件、技术角度进行“数据成本”控制。从业务角度对膨胀的数据本身进行“冷热”分级管理,不仅有利于节约“计算成本”,也可以提高业务数据化运营效率。 二、冷热数据定义及意义 冷热数据主要从数据访问频度、更新频度进行划分。冷数据,即实际生产中被访问、更新频度比较低、概率比较低的数据。热数据,访问、更新频度较高,未来被调用的概率较高的数据。冷数据在业务场景中计算时效要求慢,可以做集中化部署,可以对数据进行压缩、去重等降低成本的方法。热数据因为访问频次需求大,效率要求高,可以高性能存储与就近计算部署;数据冷热管理最核心目标提高算力利用率,所谓算力通常包含CPU、GPU、内存、带宽等能力,算力瓶颈在于单位时间内处理数据能力。视频、人工智能等领域的算力消耗集中在对大规模数据及参数的“算法”的计算处理。在传统行业领域以结构化数据为主,算力消耗集中在“订单、客户、事件”三大类数据的搬运、数据排序、数据关联、数据合并、数据算术运算、数据的查询等。希望通过对数据冷热区分,精准识别出“热”数据,减少对“冷数据”的搬运、关联、排序、计算等,把算力集中在刀刃上,实现数据处理“提速、降本”。三、系统架构设计时对数据的“冷热”管理 数据规模控制目前有“冷热分离异构系统”和“冷热分离同构系统”两类架构。“冷热分离异构系统”:将冷热数据根据被访问的频度及概率,一般来说将“时间序列较早,访问频度较低于一定比例”归档转移至另一个系统的进行存储。两套系统拥有不同的存储特性、访问方式等,优先热数据访问性能的同时,降低冷数据的运维成本“冷热分离同构系统”:冷热数据应用同一套规则,同一个数据集群中部署不同配置的机器,不同服务器进HOT/COLD属性标志。高配置服务器管理管理热数据,低配置服务器用于管理冷数据。当创建一个新的Index时,指定其数据分配到Hot属性的机器上;一段时间后,再将其配置修改为分配到Cold属性机器上,Elasticsearch便会自动完成数据迁移。系统级数据的冷热分级管理可以有效提高算力使用效率。图:冷热存储策略全冷存储指数据全部存储在HDD盘,是一种较为经济的存储策略。全热存储指数据全部存储在SSD盘,满足高性能访问的需求。冷热混合存储指一定数量的分区存储在SSD盘,其余数据存储在HDD盘。四、数据结构设计时进行“冷热”管理 传统行业的数据处理不需要像阿尔法狗即时计算出围棋的落子位置,更多的是固化的计算逻辑。因此可以通过“数据分区、计算分时”等策略优化算力利用率数据分区,数据结构设计时从动态与静态维度对数据进行“冷热”分区,减少对“冷数据”的搬运、关联、排序、计算等,降低参与计算的数据规模。计算分时,很多传统领域数据计算步骤是相对固化的、非实时的,可以通过对计算步骤分解在多个时段,平滑并发计算量。1、所谓静态数据主要指事件类数据,描述发生一个事件的数据记录,如保险领域理赔,报案事件、理算记录、结案事件,每个事件包含了对象、时间、事件内容等。静态数据参与的计算主要在于“被搬运、被查询、被关联、被计算”,静态数据本身几乎不进行合并更新计算。对于静态数据中被关联、被计算关键字段可以进行热度标识,参与计算的高频字段可以分配至临时表独立存储,减少统计类计算时加载的数据规模。如:保险领域对理赔事件原始数据字段超过20个,数据“入湖共享”时对高频度报表计算的“案件类型、报案时间、结案时间、金额”4个“热”数据字段拆出一个独立表进行共享,并增加“机构属性标记、客户号、手机号、保单号”关联关键字段(数据规模比原始数据降低3/4)。这样不同机构在开展个性化理赔统计报表分析时(不同分公司报表分析频度、统计样式可以个性化),仅需要加载对应机构的数据,快速完成“客户-理赔”与“保单-理赔”关联计算,减少“客户-保单-理赔”跨表数据搬运及复杂关联。2、动态数据指会时序更新的数据,如客户类的数据“收入、偏好、最近一次交易等”涉及持续更新合并。动态数据消耗的算力集中在“数据更新合并、数据排序、查询、关联”,其中数据的Update涉及较多校验规则。针对动态数据中各字段更新频度进行冷热标识,对于高频度update字段进行独立表管理,避免高频对大宽表的读写操作。如在保险领域,客户高频度更新信息字段主要是“职业、出险次数、最近投保”等和交易关联性强字段,客户数据中台数据结构设计时,对高频update字段独立表写入管理,减少对客户大宽表加载与读写。结语目前在IT行业系统架构设计重视度比较高,在数据结构设计有很大提升空间。如我所在在保险企业业务核心系统为外资产品,运行10多年后进行升级重构时,最大的难题就是数据结构设计,招投标时国内厂商可以在系统结构上给出较为完善的解决方案,但在数据结构上、数据规则上面临很大挑战。
-
 5月26日,2022中国国际大数据产业博览会(以下简称“数博会”)线上正式开幕。数博会是全球首个以大数据为主题的博览会,由国家发展和改革委员会、工业和信息化部、国家互联网信息办公室和贵州省人民政府共同主办,是助力全球大数据技术应用和产业发展的重要平台。大会开幕式上,华为高级副总裁、华为云CEO张平安发表主题演讲。聚焦大会主题“抢数字新机,享数字价值”,他在演讲中主张,发挥数据的集聚规模效应,以数智融合重塑数据价值,围绕“一切皆服务”帮助更多企业容易上云、方便上云、用好云:让数据资源在集聚中实现效益最优“东数西算”是把握数字经济发展机遇期、构建算力新格局的重要举措。为加快推动“东数西算”建设,全力打造“中国数谷”,华为云已在贵州布局全球总部和最大的云数据中心,持续发挥数据资源集聚的规模效应,提升资源使用效率。以“数智融合”重塑数据价值数字时代,数据是千行百业重要的生产要素和资产,目前数据的价值仍未充分得以利用,实现高效的数据治理、促进“数智融合”仍是业界难题。华为云着力打造“数智融合”云平台,打通数据治理生产线、AI开发生产线,构建统一的开发环境、统一的元数据管理、统一的存储,让数据开发效率由“周”级提升到“小时”级,大幅降低数据存储成本,让数据和AI开发进入现代化的生产阶段。一切皆服务,让千行百业真正用好云为帮助千行百业的客户容易上云、方便上云、用好云,华为云提出“一切皆服务”,把基础设施、技术以及经验云化、服务化。例如,不少企业缺乏专家和训练数据,未能有效地将AI能力与业务场景结合,因此难以快速开发出AI应用;为此华为云已将AI、大数据,音视频等核心技术云化,集成海量开发工具,让所有客户随取随用,高效开发。同时,华为云持续深耕政府、金融、工业等行业,将华为与伙伴、客户的合作创新以及数字化转型经验沉淀成为云服务,已陆续开放了50多个应用场景,提供超过2万个API服务,让更多企业就不必重复“造轮子”,通过云服务即获得全行业最优秀的数字化经验。本届数博会上,华为云还斩获了多项大奖,涵盖从数据库、数据湖、到数据和AI融合分析的技术创新,以及运用湖仓库AI技术支持的梦饷集团创新实践入选“十佳大数据案例”,充分证明了业界对华为云数据领域技术创新的认可:在数博会的重头戏——“数博发布”特色活动中,华为云GaussDB(for openGauss)分布式数据库斩获领先科技成果“新产品”奖。该奖项是数博会的最高奖项,同时也是唯一以大数据为主题的社会科技奖励,其专业性、权威性、引领性获业界一致认可。 华为云GaussDB(for openGauss) 基于华为主导的开放生态openGauss而打造,是主打政企核心业务负载的金融级分布式数据库旗舰产品。 例如,在工商银行核心交易系统分布式改造过程中,华为云GaussDB提供了完备的一站式数据迁移解决方案,实现高可用、性能线性扩展、弹性部署三大核心价值,助力客户数据库选型安心、迁移放心、管理省心,让核心交易系统可靠性得到了大幅度提升,持续满足未来长期业务发展需求。 华为云数智融合平台为企业在云上打造了统一的数据底座,把原本散落在各个部门和组织的数据统一汇聚到数据湖中,省去开发者关注各种底层的琐碎文件管理,以及大量、复杂的分析引擎、AI引擎和管理运维工作,支持开发者在集成的开发平台上,便捷地使用最新的算法模型挖掘各种数据的潜在价值。 例如,平台助力T3出行将多套集群架构优化至湖仓一体的存算分离架构,同时支撑数据分析的BI和数据智能的AI场景,不仅使TCO降低20%以上,更解决了出行场景下“长尾支付”系统更新慢的难题,数据处理效率提升150%。数智融合,让企业像管理代码一样管理数据,让机器学习的效率更高,提升乘客的安全体验。华为云FusionInsight MRS IoTDB聚焦工业物联网领域的工业复杂时序数据的处理,解决通用数据库在超大规模复杂时序场景的功能短板和性能瓶颈,形成跨越端、边、云的工业物联网大数据的利器。 目前,清华大学和华为云已开展合作,以Apache IoTDB开源组件为基础,持续探索新型的、基于开源社区的“产、学、研”合作模式,加快在华为云FusionInsight MRS云原生数据湖服务中完成IoTDB商用版本开发和集成,进一步完善MRS“三湖一集市”能力,为工业海量时序数据分析提供企业级的时序数据库。IoTDB相关技术已在交通、制造等众多工业级时序数据分析应用中落地。 作为“新电商”领域创新者,梦饷集团全面拥抱云、大数据、AI技术,与华为云合作数据创新,让200万“宝妈”不需要投入成本、无需复杂的数字技术背景,即可利用碎片时间进行数字圈层电商营销。以数据智能进行业务创新和社会价值创造,该案例也入选联合国可持续发展目标(SDGs)最佳案例。在数智融合实践中,梦饷集团实现了TCO下降30%,实时分析能力提升50%。其中,华为云DWS提供涵盖T+1批量分析、流式分析、小微实时分析、IoT分析、交互式分析以及复杂高维业务分析等;华为数仓技术提供了100PB级数据容量,以超大集群、混合负载的关键能力,保障多租户、高并发场景可为用户输出持续稳定的SLA,让梦饷集团轻松应对电商高并发业务挑战。基于超过10年的数据领域研发与投入,华为云以成熟的全生命周期数据治理能力,持续帮助电商、游戏、金融、保险、物流、零售等行业客户实现业务智能,释放企业数据价值。围绕“一切皆服务”,华为云面携手客户、合作伙伴和开发者持续创新,帮助千行百业的客户容易上云、方便上云、用好云。
-
5月26日,在贵州举行的2022中国国际大数据产业博览会“东数西算:构建国家算力网络体系”论坛上,由华为技术有限公司(以下简称“华为”)与国家信息中心、贵州省大数据发展管理局和粤港澳大湾区大数据研究院联合发布了《“碳达峰、碳中和”背景下数据中心绿色高质量发展研究报告》(以下简称《研究报告》)。在推动数据中心绿色高质量发展的技术趋势和解决思路专项建议中,《研究报告》重点阐述了四大存储技术方向。即如何利用全闪存储技术、存算分离架构、数据重删压缩、数据密集型存储等技术推动在“东数西算”的背景下高质量达成数据中心“碳中和、碳达峰”目标。方向一:加速数据中心向“硅进磁退”的闪存化方向演进闪存介质具备高密度、高可靠、低延迟、低能耗等特点,在相同的容量下,闪存相较于HDD的能耗降低70%,性能提升100倍,占用空间节约50%。数据中心存储介质全闪存化是未来发展方向,应逐步提升数据中心存储介质闪存化比例,建议2025年达到50%,2030年达到90%,远期实现100%全闪存化。方向二:推动大数据场景存算分离架构的使用普通的通用型服务器配备硬盘的数量有限,而专门设计的高密存储型节点的密度是传统存储服务器的2~2.6倍,同等容量下能耗节约10%~30%。如在大数据分析场景下,采用存算分离架构的同时利用数据纠删码技术,可进一步把磁盘利用率从33%提升到91%,减少磁盘空间占用,节约能耗。方向三:应用数据重删压缩算法,提高数据存储效率数据重删和数据压缩是通过一系列的算法优化数据存储布局,提高存储效率的技术,进而提高数据存储的能效。尤其在闪存介质快速应用的背景下,更能凸显其价值。如在数据库、桌面云、虚拟机等业务场景下实现2~3.6倍的数据缩减率,耗能节约50%以上。方向四:推广数据密集型集群存储技术数据密集型集群存储是面向中大型绿色节能数据中心打造的存算网融合一体化整柜液冷解决方案。采用高密、大比例EC、存算分离、DPU卸载、数据处理加速、数据高缩减和存储液冷等创新技术,提升数据中心交付效率,缩短上线周期。同时通过一池对接多云,实现跨数据中心统一融合存储资源池,资源利用率提升50%。实施“东数西算”工程,对于推动数据中心合理布局、优化供需、绿色集约和互联互通等意义重大。对数据中心设计、PUE、IT设备等方面都提出了较高的要求。华为依托业内领先的全闪数据中心、数据密集型存储,加快先进存储产业升级,助力数据中心绿色高质量发展。
-
想要通过使用Streamx提交大数据MRS 集群spark/flink作业,是否有相关的安装配置教程?
-
 第七次人口普查数据可视化分析实战个人主页:JoJo的数据分析历险记个人介绍:小编大四统计在读,目前保研到统计学top3高校继续攻读统计研究生如果文章对你有帮助,欢迎✌关注、点赞、✌收藏、订阅专栏文章目录第七次人口普查数据可视化分析实战写在前面1.数据集导入2.总人口统计3.性别比统计4.老龄化率5.人均受教育年限6. 城镇化率7.GDP总结写在前面国家统计局发布的第七次人口普查数据较为宏观,未能较好的体现各地区人口指标的分布情况。本文基于Pyecharts初步分析各地区人口普查数据的分布情况。# 导入相关库import pyechartspyecharts.globals._WarningControl.ShowWarning = Falseimport warningswarnings.filterwarnings('ignore')import pandas as pdfrom pyecharts.charts import Mapfrom pyecharts import options as opts1.数据集导入df = pd.read_csv(r'C:\Users\DELL\Desktop\Statistic learning\数据分析案例\第七次人口普查\pop.csv')df.head()province Total Male Female sex-ratio Aging-rate AHP Edu-level GDP CR0 北京 2189.31 1120 1070 104.65 13.30 2.31 11.87 36102.55 86.201 天津 1386.60 714 672 106.31 14.75 2.40 10.81 14083.73 80.432 河北 7461.02 3768 3693 102.02 13.92 2.75 9.46 36206.89 45.593 山西 3491.56 1781 1711 104.06 12.90 2.52 10.02 17651.93 49.794 内蒙古 2404.92 1228 1177 104.26 13.05 2.35 9.94 17359.82 57.04这里是我对第七次人口普查数据进行了基本处理后得到的数据集,感兴趣的小伙伴可以下载:数据下载地址上述数据包含十个指标,分别如下:province:省份,包含31个省、直辖市和自治区(不包含港澳台)Total:总人口,各地区第七次人口普查总人口(千万)Male:男性人口(千万)Female:女性人口(千万)sex-ratio:性别比(%),男 性 人 口 女 性 人 口 × 100 % \frac{男性人口}{女性人口} \times 100\% 女性人口男性人口 ×100%Aging-rate:65岁及以上人口占总人口的比例,用来衡量一个地区的老龄化程度(%)AHP:户均人口。各地区平均每户人口数Edu-level:各地区受教育年限(经过处理后的数据)(年)GDP:各地区GDP数据(亿元)CR:各地区城镇化率(%)2.总人口统计# 总人口统计df['Total'][df['province']=='全国']31 141178.0Name: Total, dtype: float64根据第七次全国人口普查结果,我国人口达14.1178亿,突破14亿大关。那么各个地区的人口分布情况如何呢?来看看你的家乡属于第几梯队♂️'''导入地图和数据'''m1=Map()m1.add("总人口", [list(z) for z in zip(df.province, df.Total)], "china",is_map_symbol_show=False)'''自定义间隔'''pieces = [ {'max': 500, 'label': '500以下'}, {'min': 500, 'max': 1000, 'label': '500-1000'}, {'min': 1000, 'max': 2000, 'label': '1000-2000'}, {'min': 2000, 'max': 5000, 'label': '2000-5000'}, # 有下限无上限 {'min': 5000, 'max': 10000, 'label': '5000-10000'}, {'min': 10000, 'label': '10000以上'} ]'''全局设置'''m1.set_global_opts( title_opts=opts.TitleOpts('第七次人口普查各地区人口总量分布图'),#设置图标题 visualmap_opts=opts.VisualMapOpts(is_piecewise=True,pieces=pieces))#热力图相关设置m1.render_notebook()可以看出人口分布的整体趋势是由东南沿海逐渐向西北内陆地区递减人口最高的两个省份是广东和山东,均超过了1亿,而广东则是达到了1.2亿。北上广深四个一线城市,广东就包含了两个,吸引了大量的外来人口。人口最低的省份是西藏,不足500万。这里有一部分原因是因为西藏有很多环境不适合居住,此外,由于经济发达水平相较较低,地区对人才吸引力较低,很多选择外出工作。这种人口分布情况预计在未来很长一段时间都会保持。3.性别比统计这里的性别比为:男 性 人 口 / 女 性 人 口 × 100 % {男性人口}/{女性人口}\times100 \%男性人口/女性人口×100%# 全国性别比情况df['sex-ratio'][df['province']=='全国']31 105.07Name: sex-ratio, dtype: float64可以看出,全国性别比为105.07%,我国已经成为世界上性别比失衡较为严重、持续时间较长的国家。这里一部分原因是受到了传统重男轻女思想的影响,导致男性人口基数较大,可能要在很长时间才有望达到平衡。这也意味着将会有一部分♂️男性较难脱单。接下来我们来看看各地区的性别比例吧!'''导入地图和数据'''m2=Map()m2.add("性别比例(%)", [list(z) for z in zip(df.province, df['sex-ratio'])], "china",is_map_symbol_show=False)'''自定义间隔'''pieces = [ {'max': 100, 'label': '100以下'},#有上限无下限 {'min': 100, 'max': 105, 'label': '100-105'}, {'min': 105, 'max': 110, 'label': '105-110'}, {'min': 110, 'label': '110以上'}# 有下限无上限 ]'''全局设置'''m2.set_global_opts( title_opts=opts.TitleOpts('第七次人口普查各地区性别比分布图'),#设置图标题 visualmap_opts=opts.VisualMapOpts(is_piecewise=True,pieces=pieces))#热力图相关设置m2.render_notebook()从上面这个性别比热力图,我们发现一个有意思的规律。从全局来看,性别比呈现由北向南逐渐上升的情况。也就是说南方地区,男性比例要更高。其中吉林和辽宁两地区性别比居然还小于100%,广大男性朋友想要脱单的建议去试试!而广东、海南、西藏的男性朋友们就比较惨了,性别比超过了110%。4.老龄化率根据国际标准,65岁以上人口占比7-14%为轻度老龄化,14-20%为中度老龄化,21-40%为重度老龄化。# 全国老龄化程度情况df['Aging-rate'][df['province']=='全国']31 13.5Name: Aging-rate, dtype: float64此次人口普查结果显示我国65岁以上人口占比已经达到13.5%,这意味着中国已经处于中度老龄化的边缘,面对老龄化程度不断上升,国家也在不断推进“三胎”政策来缓解老龄化程度。接下来我们来看看各地区的老龄化情况'''导入地图和数据'''m3=Map()m3.add("65岁及以上人口比例", [list(z) for z in zip(df.province, df['Aging-rate'])], "china",is_map_symbol_show=False)'''自定义间隔'''pieces = [ {'max': 7, 'label': '非老龄化'},#有上限无下限 {'min': 7, 'max': 14, 'label': '轻度老龄化'}, {'min': 14, 'max': 20, 'label': '中度老龄化'}, {'min': 20, 'label': '重度老龄化'}, ]'''全局设置'''m3.set_global_opts( title_opts=opts.TitleOpts('第七次人口普查各地区老龄化程度分布图'),#设置图标题 visualmap_opts=opts.VisualMapOpts(is_piecewise=True,pieces=pieces))#热力图相关设置m3.render_notebook()#pic_center从上面这个热力图可以看出:目前我国各地区均面临老龄化问题(西藏除外)中部地区和和东北地区面临着中度老龄化问题目前我国还没有面临到重度老龄化的程度5.人均受教育年限人均受教育年限是衡量一个地区文化水平的重要指标,在第七次人口普查数据中,统计了大专及以上、高中、初中和小学的人数,这里做如下处理后得到人均受教育年限大专及以上:16年高中:12年初中:9年小学:6年# 全国受教育情况df['Edu-level'][df['province']=='全国']31 8.88Name: Edu-level, dtype: float64可以看出我国平均受教育年限为8.88,这说明我国九年义务教育基本完成保障(上个世纪一部分人受教育程度较低)。下面我们来看一下各地区的受教育年限分布情况'''导入地图和数据'''m4=Map()m4.add("人均教育年限", [list(z) for z in zip(df.province, df['Edu-level'])], "china",is_map_symbol_show=False)'''自定义间隔'''m4.set_series_opts(label_opts=opts.LabelOpts(is_show=True))pieces = [ {'max': 8, 'label': '8年以下'},#有上限无下限 {'min': 8, 'max': 9, 'label': '8-9年'}, {'min': 9, 'max': 10, 'label': '9-10年'}, {'min': 10, 'label': '12年以上'} ]'''全局设置'''m4.set_global_opts( title_opts=opts.TitleOpts('第七次人口普查各地区人均受教育年限分布图'),#设置图标题 visualmap_opts=opts.VisualMapOpts(is_piecewise=True,pieces=pieces))#热力图相关设置m4.render_notebook()从上述热力图可以看出:整体而言,随着大家对教育的重视,各个地区的受教育程度差距逐渐缩小。但东部地区整体受教育程度要高于西部地区,这也和地区经济发展水平存在一定关系♂️西藏、云南、贵州、青海几个地区的人均受教育年限较低。这也反应了这些地区的教育水平相较于其他地区有所落后♀️而北京、上海最高,平均受教育年限超过了11年,北京上海作为我国最发达的城市,教育水平也是全国最领先的地位,另一方面也反映了其对教育的重视程度6. 城镇化率df['CR'][df['province']=='全国']31 63.89Name: CR, dtype: float64根据第七次人口普查结果可以看出,我国城镇化率达到63.89%,新型城镇化和城乡融合发展工作取得新成效,农业转移人口市民化加快推进,城市群和都市圈承载能力得到增强。根据联合国的估测,世界发达国家的城市化率在2050年将达到86%,我国离这个数字还有一定的距离。下面我们来看看各地区城镇化率分布情况'''导入地图和数据'''m5=Map()m5.add("城镇化(%)", [list(z) for z in zip(df.province, df['CR'])], "china",is_map_symbol_show=False)'''自定义间隔'''pieces = [ {'max': 30, 'label': '30以下'},#有上限无下限 {'min': 30, 'max': 50, 'label': '30-50'}, {'min': 50, 'max': 60, 'label': '50-60'}, {'min': 60, 'max': 80, 'label': '60-80'}, {'min': 80, 'label': '80以上'} ]'''全局设置'''m5.set_global_opts( title_opts=opts.TitleOpts('第七次人口普查各地区城镇化率分布图'),#设置图标题 visualmap_opts=opts.VisualMapOpts(is_piecewise=True,pieces=pieces))#热力图相关设置m5.render_notebook()从热力图来看,城镇化率也基本呈现由东部沿海向西部递减的趋势。不同地区的城镇化率差距明显:可以看出北京、天津、上海三个地区的城镇化率已经超过了80%西藏的城镇化率却不足30%7.GDP上述是第七次人口普查的基本分析情况,下面我们来看看大家特别关注的一个指标,GDPdf['GDP'][df['province']=='全国']131 1013567.0Name: GDP, dtype: float6412可以看出2020年,我国GDP总额超过100万亿。这是一个里程碑的数字。那么各个地区的GDP分布情况如何呢,来看看你的家乡属于哪一档的。'''导入地图和数据'''m6=Map()m6.add("GDP(亿元)", [list(z) for z in zip(df.province, df['GDP'])], "china",is_map_symbol_show=False)'''自定义间隔'''pieces = [ {'max': 10000, 'label': '10000以下'},#有上限无下限 {'min': 10000, 'max': 20000, 'label': '10000-20000'}, {'min': 20000, 'max': 50000, 'label': '20000-50000'}, {'min': 50000, 'max': 100000, 'label': '50000-100000'}, {'min': 100000, 'label': '100000以上'}]'''全局设置'''m6.set_global_opts( title_opts=opts.TitleOpts('第七次人口普查各地区生产总值分布图'),#设置图标题 visualmap_opts=opts.VisualMapOpts(is_piecewise=True,pieces=pieces))#热力图相关设置m6.render_notebook()从上图发现:东南地区GDP要远高于其他地区,其次是中部地区。西部地区和东北地区GDP总值相对较低其中江苏省和广东省最高,均超过了10亿元相反,海南作为自由贸易港建设试验区,GDP还不到万亿,在十四五期间,海南省力图超过万亿大关总结文章对第七次人口普查数据进行了初步分析,主要是运用可视化技术,分析各地区的各项人口指标总体情况。并进行一定总结,后续将进一步做各个指标的结构分析、时间序列分析等,敬请期待!原文链接:https://blog.csdn.net/weixin_45052363/article/details/124789121
-
-
近日,国源科技入驻华为云市场,在华为云市场发布“国源农业生产社会化服务监管平台”。平台立足于“服务三农”,振兴乡村经济发展。针对小农户托管难、服务组织实施难、政府监管难、监管成本高等问题,国源科技利用云计算、大数据、IOT、3S等现代信息技术,提供“项目管理-服务组织备案-托管合同网签-农机作业监管-补贴精准兑付”全流程的线上托管监管等“耕、种、管、收”一站式服务,帮助农民放心便捷托管、服务组织规模化、标准化作业、政府主管部门精准监管和科学指导,推进多种形式适度规模经营,促进农业增效和农民增收。一、国源科技 国源科技成立于2005年, 是国家级高新技术企业、北京市“专精特新”企业。2021年11月15日作为数字农业农村领域唯一企业首批登录北交所,注册资本13,379万元,拥有3家全资子公司,25家分公司。 国源科技专注于自然资源和农业农村领域,以地理信息开发应用为核心,通过将3S技术与云计算、大数据、人工智能等现代信息技术相结合,向客户提供以土地空间为载体的数字化和信息化服务,已累计服务1000+家政府部门、近2000家农业金融机构和3000+涉农组织 2021年,国源科技“农业生产社会化服务智能服务云平台”成功入选2021数字农业农村新技术新产品新模式优秀案例;同年,国源科技已连续提供两年“农业生产社会化服务项目全流程监管”服务的两个县区(河北省邯郸市邱县和宁夏回族自治区中卫市沙坡头区),分别荣获农业农村部择优遴选全国农业社会化服务典型。二、 国源农业生产社会化服务监管平台(一) 产品特点(二)产品能力1、公开遴选备案 通过服务组织在线注册、申请备案,政府主管部门公开遴选,建立服务组织主体库、名录库及黑名单。并以服务组织为单位,进行组织成员、作业机具、实施效果的关联,帮助管理人员快速复核服务组织能力、衡量服务水平,进行服务组织的黑名单管理,解决“信息公开难、组织管理分散”的问题。2、合同在线网签 利用OCR识别技术、地理空间定位技术,自动识别农户身份信息,将农户信息、托管信息与托管地块进行空间自动关联,为小农户、新型经营主体提供在线/异地签订托管合同和托管地块自动落图,实现基于空间位置信息的精准托管、实时汇总监管托管小农户占比,解决“服务对象不清晰、合同托管地块不明确”的问题。3、作业过程监控 平台支持江苏北斗、智能装备中心、上海牧星、三一智能等多家不同能力的IOT硬件设备接入,自动采集不同作物在耕、种、防、收各环节的作业时间、作业农机具、农机手等基础信息和作业轨迹、作业质量、作业照片、作业视频等动态变化信息,支持作业轨迹回放、质量检查及预警、作业日报统计和汇总统计,解决“作业过程监管难、作业面积监控难”的问题。4、服务效果评价 搭建评价反馈微信小程序,建立小农户与政府沟通的桥梁,让服务对象作为服务的监管方,对作业质量、收费标准、作业完成情况等进行实名打分,实现作业真实性100%调查反馈,大大提升调查效率和覆盖率,同时基于评级结果精准勾画服务组织的作业画像,为服务组织黑名单管理提供数据支撑。5、数据多维度统计 针对不同应用场景,不同业务数据,提供基于行政区划、基于服务组织、基于作业作物、基于作业环节的多维度数据统计,形成“一个领导驾驶舱+6张表+N张图”的数据统计成果,帮助业务管理人员快速掌控项目进度,实时监控县、乡、村各级社会化项目推进情况,各服务组织社会化服务实施效果。6、项目多级验收 建立县、乡、村三级核查机制,以“外业调查+内业验收”为手段的多级验收模式。针对外业调查,平台提供便捷化移动核查工具,实现基于空间位置的实景照片、视频采集上报;针对内业核查,平台自动多维度统计托管合同、作业面积、外业调查成果等数据,形成以服务组织为单位的服务组织备案信息、托管合同、作业轨迹图、监测报告等补贴申请材料数据一键汇总导出,实现逐级汇总、逐级确认、逐级验收,助力补贴资金的精准发放。三、 典型案例(一)辽宁省级监管平台建设 2020年3月,平台率先在辽宁省上线应用,并荣获辽宁省农业生产社会化服务业务第一批面向全省推荐单位。 辽宁省监管大屏 农机作业地图(二)中原农耕社会化综合服务平台 2021年,与河南省农机协会联合建设“中原农耕社会化综合服务平台”,为政府、服务组织及小农户等用户提供农情监测、在线托管、农机作业、质量监控、农技服务等多场景应用服务。(三)宁夏沙坡头区智能化托管服务平台 2020年平台面向宁夏区域的生产托管监管服务率先在中卫市沙坡头区落地,探索农业生产托管补贴项目从“准备—实施—验收”全流程线上化监管服务,形成区域示范效应并带动海原县、石嘴山市平罗县及吴忠市红寺堡区开展全程托管监管服务。 托管情况 农机调度(四)邱县社会化服务智慧监管 邱县农业生产社会化服务智慧监管项目是以生产托管为核心,围绕农业生产全流程开展的智能监管服务,实现了小麦、水稻、文冠果等作物的农情遥感监测,农产品质量溯源、农业生产社会化服务监管,实现不同作物的从种植过程、种植方式、长势产量等信息全流程记录,积累了完整、全面、可追溯的全流程项目管理、项目运营、项目实施、项目验收的“电子化成果”。 农业生产托管监管服务 农产品溯源服务作物遥感解译服务 未来,国源科技将持续构建全产业链社会化服务模式,将产前的农资统购、智能灌溉、智能水肥、精准指导,产后的包装销售、冷链物流、仓储管理等业务融入现有平台内,形成闭环的全链条时空溯源平台。
-
天我们来讨论一下关于云运维的话题越来越多政企客户们开始从推动“云优先”向关注“云效能”转变:云平台运维要赋予IT更好的能力帮助业务更高效运营更好地满足IT信息化决策的需求那么,云运维到底难在哪?王强 IT运维工程师王强 IT运维工程师:“干了十多年的IT运维工作,以前都是以基础设施作为维护对象,现在业务全面上云之后,容器、大数据、人工智能等新技术和多云运维面临的挑战扑面而来,我们经常打趣说,运维从“机械时代”跳跃到“智能时代”了。”●痛点1:复杂的云平台架构对平台运维人员能力提出更高的要求。张升 业务开发工程师张升 业务开发工程师:“新业务上线,软件升级和配置变更必不可少。此类升级变更任务对操作可靠性要求极高,一旦出错往往会带来系统性业务可用性风险,经营损失不可估量。”●痛点2:多元化的业务应用带来快速的平台软件迭代和更高的系统风险。Peter Lee CIOPeter Lee CIO:“上云之后,配备多领域的高级别运维专家是必要的,可以对平台建设及业务规划给出更科学合理的建议;同时我们运维部门希望引入自动化、在线化、移动化的运维工具,然而这些都需要高昂的投资,这让我们望而却步。”●痛点3:专业运维人员配置和大量自动化能力开发,使得运维成本飙升。丁力波 能源信息建设规划架构师丁力波 能源信息建设规划架构师:“作为一家超过10万人的企业,我们在20多个城市部署有分支机构,业务规模及支撑系统部署存在差异,各分支自有的运维人员技能和经验参差不齐,如何把多分支的运维工作统一管理起来,实现有效的协同,这不是一道简单的命题。”●痛点4:大规模多分支机构的差异化业务场景,大大增加了全局统一运维的复杂度。华为云Stack提供三种云平台运维模式解决政企客户的运维挑战:选择一省心省力的远程托管运维无须自建云运维能力,华为一站式运维服务,客户聚焦业务应用,省心无忧。远程托管运维,客户最省心省力,无需花精力建设和管理自有运维团队,将平台可靠性设计、可用性保障等运维工作托付华为远程运维中心,即可从繁琐的基础维护工作中释放出来,从而可以聚焦到政企自身服务和业务创新等核心经营事务。优点:1、远程运维团队经验丰富,监控到告警后快速响应,远程登录云平台,快速分析问题,并提供最优处理方案;2、华为200+运维专家团队,覆盖IaaS、PaaS、大数据、人工智能、安全等10+类云产品技能,单局点问题经验可以快速复制应用于同类问题解决;3、华为运维团队致力于集中化运维工具平台开发创新,采用运维数据底座+DevOps的敏捷工具开发,将加速客户云平台运维智能化进程。选择二按需服务的远程协助运维本地+远程协助的两级运维体系,提供快捷、高效、安全的运维服务。在客户负责整体云平台运维管理职责,但自身运维团队只具备基础运维能力的情况下,华为可派驻驻场团队承担必要的云服务运维工作,通过安全专线与华为远程运维中心建立连接,把涉及主动预防、高阶云服务操作等技术要求高的维护工作交给华为。华为将定期和不定期(重大事件)向客户汇报提供的服务交付成果。优点:1、简化客户现场运维难度,高阶云服务专家集中远程中心,把复杂技术问题留给华为,降低对客户现场人力数量和能力的要求;2、高阶服务专家按需介入,重大故障/问题快速修复,缩短故障闭环时间;3、专家在线支持版本迭代升级,季度开展深度巡检、有效降低升级风险。选择三行业云技术服务中心华为专业运维能力下沉至行业云技术服务中心,行业专网保障数据安全,应急连线加持紧急恢复。行业云技术服务中心,适应于行业一片云或大规模行业局点需构建专属运维团队和能力的场景。华为可提供专业运维能力下沉支持,如运维专家培养、运维工具使用、运维体系及流程建设等。优点:1、随行业云平台建设,适配客户业务场景,帮助客户快速构建基础云服务/高阶云服务运维团队,及高效运维流程体系;2、在行业云技术服务中心部署远端运维工具平台,实现对分支机构的可监控、可维护、可管理,为业务快速决策、指标分析提供重要参考;3、运维工具平台和所有运维操作数据流都在行业内网,可以供行业云运维中心实时查阅,运维全局统一管理。▎华为云Stack运维解决方案五大关键能力关键能力一:基于业界及华为最佳实践,形成一整套运维管理体系华为长期参与国家ITSS组织运维标准制定讨论,同时遵循ITIL、ISO20000、ISO27001等国际通用的标准要求,形成一整套标准化、数字化、智能化的运维管理体系。关键能力二:专家服务队伍汇聚从解决方案设计、交付、云服务运维各领域的专家,在运维中心拥有5年以上的资深专家近200名,持有ITIL、PMP、HCIE相关的认证。关键能力三:技术支持中心(TSC)平台:它拥有业界领先的运维工具体系,致力于集中化、自动化和数字化运维,助力客户快速使用云服务,聚焦业务创新。全场景覆盖:高效标准的流程与工具,覆盖智能监控、故障处理、服务变更、主动运维;运维自动化:运维操作自动化和基于运维大数据的智能化,提升运维效率;主动运维:AIOps(Artificial Intelligence for IT Operations),异常事件发现,故障预测、深度巡检;云梯接入网关:网络反向建连,消除监听端口,通信矩阵极致收编,通信可审计,可控易控。关键能力四:完善的集中运维安全管理机制,保障运维安全华为云(西安)运维中心已经通过了国家网络安全认证,遵守国内外法律法规约束,以及客户自身对安全管理的要求,在数据安全、IT安全、人员安全、物理安全、作业可信五个方面提供可信、可控、透明的运维服务。关键能力五:华为全球交付与运维服务能力华为云全球技术服务体系将华为30多年的运维能力加以沉淀,以华为云自研工具平台为底座,集结500+原厂运维服务工程师和30000+严选合作伙伴工程师,共同打造“1+3+N”的华为云全球交付与运维能力。(1+3+N:即1个西安运维中心核心节点,罗马尼亚、马来西亚、墨西哥3个海外节点, 以及N个客户现场运维中心。)▎华为云(西安)运维中心华为云构建“1+3+N”全球技术服务体系,让用户聚焦创新,安心上云用云。坐落在西安的华为云运维中心为客户提供包括托管运维、远程协助和行业云技术服务在内的三大运维服务模式,同时以自动化工具、“远程+现场”两级安全运维体系、资深专家和海量行业经验等能力为政企客户智能运维保驾护航。华为云(西安)运维中心核心节点将承载华为云中国区全部政企客户集中运维业务,同时也是全球技术服能力孵化中心和政企客户云运维体验中心。预计到2025年,华为云(西安)运维中心将接入超过1000个节点,服务25万多台设备。华为云Stack运维解决方案,聚焦支撑业务云化转型、优化运维成本、保障平台安全可靠,使客户聚焦业务上云,享受平滑安全的用云体验。链接:https://bbs.huaweicloud.com/blogs/353712
-
 本文分享自华为云社区《[GaussDB(DWS) SQL进阶之PLSQL(二)-游标](https://bbs.huaweicloud.com/blogs/330535?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=ei&utm_content=content)》,作者: xxxsql123 。 # 前言 游标是一种数据处理方法,提供了在查询结果集中进行逐行遍历浏览数据的方法,也可以将游标当做上下文区域的句柄或者指针,借助游标对指定位置的数据进行查询与处理,本章我们主要聚焦于GaussDB(DWS)存储过程中的游标使用。 # 显式游标 显示游标主要用于处理存储过程中的查询结果集是游标常用的用法,具体分为如下几个步骤: # Step 1 定义游标: ## 静态游标定义: 即定义一个游标名以及与其相对应的SELECT语句 语法图:  示例如下: ``` --在存储过程的DECLARE中声明游标定义 CURSOR C1 IS SELECT section_name, place_id FROM hr.sections WHERE section_id = 50; CURSOR C2(sect_id INTEGER) IS SELECT section_name, place_id FROM hr.sections WHERE section_id = sect_id; ``` ## 动态游标定义: 即ref游标,可以通过静态的SQL语句在合适的时候动态的打开游标。先定义ref游标类型,后面通过open for动态绑定SELECT语句 语法图:  示例如下: ``` --在存储过程的DECLARE中声明游标定义 TYPE CURSOR_TYPE IS REF CURSOR; ``` 同时GaussDB(DWS)做了Oracle兼容,支持sys_refcursor动态游标类型,函数或存储过程可以通过sys_refcursor参数传入或传出游标结果集合,函数也可以通过返回sys_refcursor来返回游标结果集合。 语法图:  示例如下: ``` --在存储过程的DECLARE中声明游标定义 C1 SYS_REFCURSOR; ``` # Step 2 打开游标: ## 静态游标打开: 即执行游标对应的SELECT语句,将结果集放入工作区,将游标的指针指向工作区的起始位置。 语法图:  示例如下: ``` --在存储过程的BODY中打开游标 OPEN C1; OPEN C2(10); ``` ## 动态游标打开: 通过OPEN FOR语句打开动态游标,通过USING对SELECT语句进行动态绑定。 语法图:  示例如下: ``` --在存储过程的BODY中打开游标 SQL_STR := 'SELECT section_name, place_id FROM hr.sections WHERE section_id = :DEPT_NO;'; OPEN C3 FOR SQL_STR USING 50; ``` # Step 3 提取游标数据: 即提取游标指针指向的数据 语法图:  示例: ``` --在存储过程的BODY中执行 FETCH C3 INTO DEPT_NAME, DEPT_LOC; ``` # Step 4 循环处理游标数据: 提取数据后可以基于存储过程的语句灵活发挥 例如,给工资低于3000的员工增加500块钱工资 ``` --在存储过程的BODY中执行 LOOP FETCH C INTO V_EMPNO, V_SAL; EXIT WHEN C%NOTFOUND; IF V_SAL=3000 THEN UPDATE hr.staffs_t1 SET salary =salary + 500 WHERE staff_id = V_EMPNO; END IF; END LOOP; ``` # Step 5 关闭游标: 在处理完游标的数据后,应及时释放游标,以便释放游标所占用系统资源,游标关闭后工作区将变成无效,不能再使用FETCH语句获取其中数据。关闭后的游标可以使用OPEN语句重新打开。 语法图:  ``` --在存储过程的BODY中执行 CLOSE C1;--关闭游标 ``` # 游标属性 我们可以通过游标的属性来了解当前游标的状态。下面将介绍4中游标属性: ※ %FOUND布尔型属性:当最近一次读记录时成功返回,则值为TRUE。 ※ %NOTFOUND布尔型属性:与%FOUND相反。 ※ %ISOPEN布尔型属性:当游标已打开时返回TRUE。 ※ %ROWCOUNT数值型属性:返回已从游标中读取的记录数。 示例: ``` OPEN C1;--打开游标 LOOP --通过游标取值 FETCH C1 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C1%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C1;--关闭游标 ``` 接下来我们将结合前面所学习的知识,在存储过程运用显示游标。 数据准备: ``` CREATE SCHEMA hr; SET CURRENT_SCHEMA = 'hr'; DROP TABLE IF EXISTS sections; CREATE TABLE sections(section_id INT, section_name VARCHAR(100), place_id NUMBER(4)) DISTRIBUTE BY HASH(section_id); INSERT INTO sections VALUES (1, 'section_name1', 1),(2, 'section_name2', 2),(3, 'section_name3', 3); ``` 显示游标使用示例: ``` --游标参数的传递方法。 CREATE OR REPLACE PROCEDURE cursor_proc1() AS DECLARE DEPT_NAME VARCHAR(100); DEPT_LOC NUMBER(4); --定义游标 CURSOR C1 IS SELECT section_name, place_id FROM hr.sections WHERE section_id = 50; CURSOR C2(sect_id INTEGER) IS SELECT section_name, place_id FROM hr.sections WHERE section_id = sect_id; TYPE CURSOR_TYPE IS REF CURSOR; C3 CURSOR_TYPE; SQL_STR VARCHAR(100); BEGIN OPEN C1;--打开游标 LOOP --通过游标取值 FETCH C1 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C1%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C1;--关闭游标 OPEN C2(10); LOOP FETCH C2 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C2%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C2; SQL_STR := 'SELECT section_name, place_id FROM hr.sections WHERE section_id = :DEPT_NO;'; OPEN C3 FOR SQL_STR USING 50; LOOP FETCH C3 INTO DEPT_NAME, DEPT_LOC; EXIT WHEN C3%NOTFOUND; DBMS_OUTPUT.PUT_LINE(DEPT_NAME||'---'||DEPT_LOC); END LOOP; CLOSE C3; END; / CALL cursor_proc1(); DROP PROCEDURE cursor_proc1; ``` 执行结果: ``` postgres=# CALL cursor_proc1(); section_name3---3 section_name1---1 section_name2---2 section_name1---1 section_name2---2 section_name3---3 section_name1---1 section_name2---2 section_name3---3 cursor_proc1 -------------- (1 row) ``` SYS_REFCURSOR游标示例: ``` --SYS_REFCURSOR类型做为函数参数 CREATE OR REPLACE PROCEDURE proc_sys_ref(O OUT SYS_REFCURSOR) IS C1 SYS_REFCURSOR; BEGIN OPEN C1 FOR SELECT section_ID FROM HR.sections ORDER BY section_ID; O := C1; END; / DECLARE C1 SYS_REFCURSOR; TEMP NUMBER(4); BEGIN proc_sys_ref(C1); LOOP FETCH C1 INTO TEMP; DBMS_OUTPUT.PUT_LINE(C1%ROWCOUNT); EXIT WHEN C1%NOTFOUND; END LOOP; END; / --删除存储过程 DROP PROCEDURE proc_sys_ref; ``` 执行结果: ``` postgres=# DECLARE postgres-# C1 SYS_REFCURSOR; postgres-# TEMP NUMBER(4); postgres-# BEGIN postgres$# proc_sys_ref(C1); postgres$# LOOP postgres$# FETCH C1 INTO TEMP; postgres$# DBMS_OUTPUT.PUT_LINE(C1%ROWCOUNT); postgres$# EXIT WHEN C1%NOTFOUND; postgres$# END LOOP; postgres$# END; postgres$# / 1 2 3 3 ANONYMOUS BLOCK EXECUTE ``` # 隐式游标 对于非SELECT语句,例如UPDATE,DELETE操作,系统会自动的未这些操作设置游标,这些有系统隐含创建的游标即隐式游标。隐式游标的定义,打开,取值,关闭操作均有系统自动的完成,无需用户进行处理,用户只能通过隐式游标的相关属性完成相应的操作。 隐式游标属性: ※ SQL%FOUND布尔型属性:当最近一次读记录时成功返回,则值为TRUE。 ※ SQL%NOTFOUND布尔型属性:与%FOUND相反。 ※ SQL%ROWCOUNT数值型属性:返回已从游标中读取得记录数。 ※ SQL%ISOPEN布尔型属性:取值总是FALSE。SQL语句执行完毕立即关闭隐式游标。 隐式游标示例如下: ``` --删除EMP表中某部门的所有员工,如果该部门中已没有员工,则在DEPT表中删除该部门。 CREATE TABLE hr.staffs_t1 AS TABLE hr.staffs; CREATE TABLE hr.sections_t1 AS TABLE hr.sections; CREATE OR REPLACE PROCEDURE proc_cursor3() AS DECLARE V_DEPTNO NUMBER(4) := 100; BEGIN DELETE FROM hr.staffs WHERE section_ID = V_DEPTNO; --根据游标状态做进一步处理 IF SQL%NOTFOUND THEN DELETE FROM hr.sections_t1 WHERE section_ID = V_DEPTNO; END IF; END; / CALL proc_cursor3(); --删除存储过程和临时表 DROP PROCEDURE proc_cursor3; DROP TABLE hr.staffs_t1; DROP TABLE hr.sections_t1; ``` 以上就是在GuassDB(DWS)的存储过程中游标的基本使用。 # 总结 GuassDB(DWS)的游标使用在postgresql的基础上做了对Oracle的语法兼容,存储过程中的游标功能对于原来依赖Oracle的系统可以平滑的迁移。同时由于GuassDB(DWS)是分布式架构,和postgresql本身以及GuassDB(DWS)的单机模式上游标的行为细节上会略有不同,例如事务中的DECLARE CURSOR由于分布式和单机的实现差异导致在pg_cursors视图查询结果差异等。
-
活动说明:欢迎参与评论区留言互动,活动结束我们将选取5位高赞的留言赠送精美礼物一份。活动话题:说说你理解的数据治理平台需要包含哪些功能,可以解决哪些业务卡点?活动时间: 2022年5月23日-2022年6月30日奖励说明:活动小助手将会用心查看参与活动的用户评论,选取5位高赞的留言赠送蓝牙鼠标一份解锁问卷答案:下列哪个大数据服务可以提供数据调度、数据建模、数据治理、数据分析等能力?答案:B.DGC分析:数据湖治理中心(DGC)是数据全生命周期一站式开发运营平台,提供数据集成、数据开发、数据治理、数据服务、数据可视化等功能,支持行业知识库智能化建设,支持大数据存储、大数据计算分析引擎等数据底座,帮助企业客户快速构建数据运营能力。官网:https://www.huaweicloud.com/product/dayu.html知识大比拼,你答对了吗?《智能数据湖》微信公众号:ei-datalake大数据免费资源领取:https://activity.huaweicloud.com/Date-free.html
-
 2022年3月,openEuler 22.03 LTS版本ISO安装包仓库及LTS官方软件仓库均上线openGauss2.1.0版本安装包,提供RPM一键安装openGauss的能力,提高用户易用性。openEuler 22.03 LTS版本中涉及的openGauss安装包及其依赖仓库如下:https://gitee.com/src-openeuler/opengauss-serverhttps://gitee.com/src-openeuler/opengauss-dcfopenGauss是一款开源的关系型数据库,采用客户端/服务器、单进程多线程架构,支持单机和一主多备部署方式,备机只读,支持双机高可用和读扩展。openGauss相比于其他开源数据库主要有以下几个主要特点:高性能提供了面向多核架构的并发控制技术结合鲲鹏硬件优化,在两路鲲鹏下TPCC Benchmark达成性能150万tpmc。针对当前硬件多核numa的架构趋势, 在内核关键结构上采用了Numa-Aware的数据结构。提供Sql-bypass智能快速引擎、融合引擎技术。高可用支持主备同步、异步和级联备机多种部署模式。数据页CRC校验,损坏数据页通过备机自动修复。备机并行恢复,10秒内可升主提供服务。高安全支持全密态计算、访问控制、加密认证、数据库审计和动态数据脱敏等安全特性,提供全方位端到端的数据安全保护。易运维基于AI的智能参数调优和索引推荐,提供AI自动参数推荐。慢SQL诊断,多维性能自监控视图,实时掌控系统的性能表现。提供在线自学习的SQL时间预测。全开放采用木兰宽松许可证协议,允许对代码自由修改、使用和引用。数据库内核能力全开放。提供丰富的伙伴认证,培训体系和高校课程。#openEuler 22.03 LTS ISO镜像安装操作系统时,安装引导界面的选择软件包里面勾选上openGauss Server,在安装完成操作系统后,默认安装上openGauss数据库并启动单机数据库进程。openGauss社区与openEuler社区作为两个开源开放的社区,通过相互协作和融合,使得openGauss进入openEuler 22.03 LTS ISO镜像,同时为openEuler 22.03 LTS官方仓库提供openGauss软件包,极大地提高了openGauss用户易用性;同时,也为使用openEuler 22.03 LTS ISO及其他镜像源的用户带来了便利。#查看cpu相关信息 lscpu du -sh * #openGauss官网 https://opengauss.org/zh/#UKUI~(希望早点支持UKUI3.0版本) UKUI是麒麟软件团队历经多年打造的一款Linux 桌面,主要基于 GTK 和 QT开发。与其它UI界面相比,UKUI更加注重易用性和敏捷度,各元件相依性小,可以不依赖其它套件而独自运行,给用户带来亲切和高效的使用体验。UKUI支持x86_64和aarch64两种架构。 #下载 openEuler21.03及以上 镜像并安装系统。https://repo.openeuler.org/openEuler-21.09/ sudo dnf update #安装UKUI sudo dnf install ukui -y #在确认正常安装后,重启reboot systemctl set-default graphical.target#DDE DDE是统信软件团队研发的一款功能强大的桌面环境。包含数十款功能强大的桌面应用,是真正意义上的自主自研桌面产品 #更新软件源 sudo dnf update #安装DDE sudo dnf install dde -y #设置以图形界面的方式启动 sudo systemctl set-default graphical.target #重启 sudo reboot #dde桌面无法使用root账号登陆 dde内置了openeuler用户,密码为openeuler#安装opengauss2.1.0,(aarch64/x86_64) yum list opengauss* yum -y install opengauss 或dnf install opengauss -y#启动,自启 systemctl start opengauss systemctl status opengauss systemctl enable opengauss#登录数据库 su - opengauss gsql -d postgres -r参考来源:openGauss公众号 https://mp.weixin.qq.com/s/sh6GIhTV2V2aaxuZQDoozg
-
本文分享自华为云社区《从零开发大数据SQL引擎》,作者:JavaEdge 。 学习大数据技术的核心原理,掌握一些高效的思考和思维方式,构建自己的技术知识体系。 明白了原理,有时甚至不需要学习,顺着原理就可以推导出各种实现细节。 各种知识表象看杂乱无章,若只是学习繁杂知识点,固然自己的知识面是有限的,并且遇到问题的应变能力也很难提高。所以有些高手看起来似乎无所不知,不论谈论起什么技术,都能头头是道,其实并不是他们学习、掌握了所有技术,而是他们是在谈到这个问题时,才开始进行推导,并迅速得出结论。 高手不一定要很资深、经验丰富,把握住技术的核心本质,掌握快速分析推导的能力,能迅速将自己的知识技能推到陌生领域,就是高手。 本系列专注大数据开发需要关注的问题及解决方案。跳出繁杂知识表象,掌握核心原理和思维方式,进而融会贯通各种技术,再通过各种实践训练,成为终极高手。 # 大数据仓库Hive 作为一个成功的大数据仓库,它将SQL语句转换成MapReduce执行过程,并把大数据应用的门槛下降到普通数据分析师和工程师就可以很快上手的地步。 但Hive也有问题,由于它使用自定义Hive QL,对熟悉Oracle等传统数据仓库的分析师有上手难度。特别是很多企业使用传统数据仓库进行数据分析已久,沉淀大量SQL语句,非常庞大也非常复杂。某银行的一条统计报表SQL足足两张A4纸,光是完全理解可能就要花很长时间,再转化成Hive QL更费力,还不说可能引入bug。 开发一款能支持标准数据库SQL的大数据仓库引擎,让那些在Oracle上运行良好的SQL可以直接运行在Hadoop上,而不需要重写成Hive QL。 # Hive处理过程 1. 将输入的Hive QL经过语法解析器转换成Hive抽象语法树(Hive AST) 2. 将Hive AST经过语义分析器转换成MapReduce执行计划 3. 将生成的MapReduce执行计划和Hive执行函数代码提交到Hadoop执行 可见,最简单的,对第一步改造即可。考虑替换Hive语法解析器:能将标准SQL转换成Hive语义分析器能处理的Hive抽象语法树,即红框代替黑框 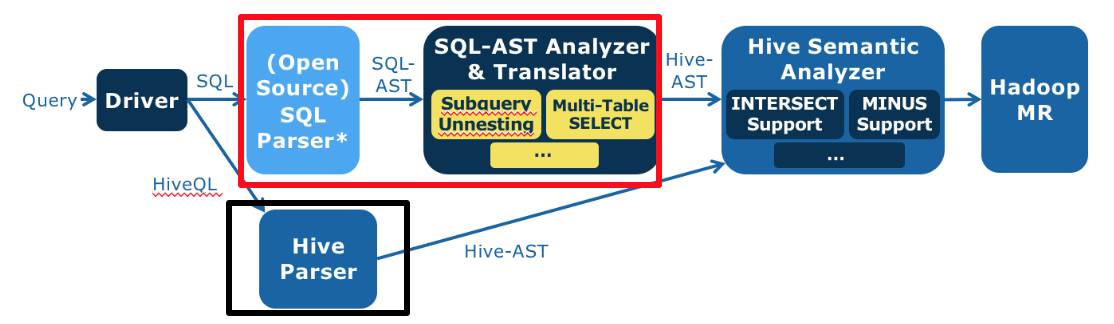 红框内:浅蓝色是个开源的SQL语法解析器,将标准SQL解析成标准SQL抽象语法树(SQL AST),后面深蓝色定制开发的SQL抽象语法树分析与转换器,将SQL AST转换成Hive AST。 那么关键问题就来了: # 标准SQL V.S Hive QL - 语法表达方式,Hive QL语法和标准SQL语法略有不同 - Hive QL支持的语法元素比标准SQL要少很多,比如,数据仓库领域主要的测试集TPC-H所有的SQL语句,Hive都不支持。尤其是Hive不支持复杂嵌套子查询,而数据仓库分析中嵌套子查询几乎无处不在。如下SQL,where条件existes里包含了另一条SQL: ```mysql select o_orderpriority, count(*) as order_count from orders where o_orderdate >= date '[DATE]' and o_orderdate date '[DATE]' + interval '3' month and exists (select * from lineitem where l_orderkey = o_orderkey and l_commitdate l_receiptdate) group by o_orderpriority order by o_orderpriority; ``` 开发支持标准SQL语法的SQL引擎难点,就是**消除复杂嵌套子查询掉**,即让where里不包含select。 SQL理论基础是关系代数,主要操作仅包括:并、差、积、选择、投影。而一个嵌套子查询可等价转换成一个连接(join)操作,如: ```mysql select s_grade from staff where s_city not in ( select p_city from proj where s_empname = p_pname ) ``` 这是个在where条件里嵌套了not in子查询的SQL语句,它可以用left outer join和left semi join进行等价转换,示例如下,这是Panthera自动转换完成得到的等价SQL。这条SQL语句不再包含嵌套子查询, ```mysql select panthera_10.panthera_1 as s_grade from (select panthera_1, panthera_4, panthera_6, s_empname, s_city from (select s_grade as panthera_1, s_city as panthera_4, s_empname as panthera_6, s_empname as s_empname, s_city as s_city from staff) panthera_14 left outer join (select panthera_16.panthera_7 as panthera_7, panthera_16.panthera_8 as panthera_8, panthera_16.panthera_9 as panthera_9, panthera_16.panthera_12 as panthera_12, panthera_16.panthera_13 as panthera_13 from (select panthera_0.panthera_1 as panthera_7, panthera_0.panthera_4 as panthera_8, panthera_0.panthera_6 as panthera_9, panthera_0.s_empname as panthera_12, panthera_0.s_city as panthera_13 from (select s_grade as panthera_1, s_city as panthera_4, s_empname as panthera_6, s_empname, s_city from staff) panthera_0 left semi join (select p_city as panthera_3, p_pname as panthera_5 from proj) panthera_2 on (panthera_0.panthera_4 = panthera_2.panthera_3) and (panthera_0.panthera_6 = panthera_2.panthera_5) where true) panthera_16 group by panthera_16.panthera_7, panthera_16.panthera_8, panthera_16.panthera_9, panthera_16.panthera_12, panthera_16.panthera_13) panthera_15 on ((((panthera_14.panthera_1 => panthera_15.panthera_7) and (panthera_14.panthera_4 => panthera_15.panthera_8)) and (panthera_14.panthera_6 => panthera_15.panthera_9)) and (panthera_14.s_empname => panthera_15.panthera_12)) and (panthera_14.s_city => panthera_15.panthera_13) where ((((panthera_15.panthera_7 is null) and (panthera_15.panthera_8 is null)) and (panthera_15.panthera_9 is null)) and (panthera_15.panthera_12 is null)) and (panthera_15.panthera_13 is null)) panthera_10 ; ``` 通过可视化工具将上面两条SQL的语法树展示出来,是这样的。  这是原始的SQL抽象语法树。  这是等价转换后的抽象语法树,内容太多被压缩的无法看清,不过你可以感受一下(笑)。 那么,在程序设计上如何实现这样复杂的语法转换呢?当时Panthera项目组合使用了几种经典的设计模式,每个语法点被封装到一个类里去处理,每个类通常不过几十行代码,这样整个程序非常简单、清爽。如果在测试过程中遇到不支持的语法点,只需为这个语法点新增加一个类即可,团队协作与代码维护非常容易。 使用装饰模式的语法等价转换类的构造,Panthera每增加一种新的语法转换能力,只需要开发一个新的Transformer类,然后添加到下面的构造函数代码里即可。 private static SqlASTTransformer tf = new RedundantSelectGroupItemTransformer( new DistinctTransformer( new GroupElementNormalizeTransformer( new PrepareQueryInfoTransformer( new OrderByTransformer( new OrderByFunctionTransformer( new MinusIntersectTransformer( new PrepareQueryInfoTransformer( new UnionTransformer( new Leftsemi2LeftJoinTransformer( new CountAsteriskPositionTransformer( new FilterInwardTransformer( //use leftJoin method to handle not exists for correlated new CrossJoinTransformer( new PrepareQueryInfoTransformer( new SubQUnnestTransformer( new PrepareFilterBlockTransformer( new PrepareQueryInfoTransformer( new TopLevelUnionTransformer( new FilterBlockAdjustTransformer( new PrepareFilterBlockTransformer( new ExpandAsteriskTransformer( new PrepareQueryInfoTransformer( new CrossJoinTransformer( new PrepareQueryInfoTransformer( new ConditionStructTransformer( new MultipleTableSelectTransformer( new WhereConditionOptimizationTransformer( new PrepareQueryInfoTransformer( new InTransformer( new TopLevelUnionTransformer( new MinusIntersectTransformer( new NaturalJoinTransformer( new OrderByNotInSelectListTransformer( new RowNumTransformer( new BetweenTransformer( new UsingTransformer( new SchemaDotTableTransformer( new NothingTransformer()))))))))))))))))))))))))))))))))))))); 而在具体的Transformer类中,则使用组合模式对抽象语法树AST进行遍历,以下为Between语法节点的遍历。我们看到使用组合模式进行树的遍历不需要用递归算法,因为递归的特性已经隐藏在树的结构里面了。 @Override protected void transform(CommonTree tree, TranslateContext context) throws SqlXlateException { tf.transformAST(tree, context); trans(tree, context); } void trans(CommonTree tree, TranslateContext context) { // deep firstly for (int i = 0; i tree.getChildCount(); i++) { trans((CommonTree) (tree.getChild(i)), context); } if (tree.getType() == PantheraExpParser.SQL92_RESERVED_BETWEEN) { transBetween(false, tree, context); } if (tree.getType() == PantheraExpParser.NOT_BETWEEN) { transBetween(true, tree, context); } } 将等价转换后的抽象语法树AST再进一步转换成Hive格式的抽象语法树,就可以交给Hive的语义分析器去处理了,从而也就实现了对标准SQL的支持。 当时Facebook为证明Hive对数据仓库的支持,手工将TPC-H的测试SQL转换成Hive QL,将这些手工Hive QL和Panthera进行对比测试,两者性能各有所长,总体上不相上下,说明Panthera自动进行语法分析和转换的效率还行。 Panthera(ASE)和Facebook手工Hive QL对比测试:  标准SQL语法集的语法点很多,007进行各种关系代数等价变形,也不可能适配所有标准SQL语法。 # SQL注入 常见的Web攻击手段,如下图所示,攻击者在HTTP请求中注入恶意SQL命令(drop table users;),服务器用请求参数构造数据库SQL命令时,恶意SQL被一起构造,并在数据库中执行。  但JDBC的PrepareStatement可阻止SQL注入攻击,MyBatis之类的ORM框架也可以阻止SQL注入,请从数据库引擎的工作机制解释PrepareStatement和MyBatis的防注入攻击的原理。
-
 本文是avro解析的demo,当前FlinkSQL仅适用于简单的avro数据解析,复杂嵌套avro数据暂时不支持。本文主要解析Apache Avro数据的相关内容,感兴趣的朋友一起看看吧摘要:本文将演示如果序列化生成avro数据,并使用FlinkSQL进行解析。 Avro官方文档所写,http://avro.apache.org/docs/current/index.html.Avro简介avro是一个数据序列化系统提供了:• 丰富的数据结构• 紧凑的,快速的,二进制的数据格式• 一种文件格式,用于存储持久化数据• 远程过程调用系统(RPC)• 和动态语言的简单交互。并不需要为数据文件读写产生代码,也不需要使用或实现RPC协议。代码生成是一种优化方式,但是只对于静态语言有意义。技术背景随着互联网高速的发展,云计算、大数据、人工智能AI、物联网等前沿技术已然成为当今时代主流的高新技术,诸如电商网站、人脸识别、无人驾驶、智能家居、智慧城市等等,不仅方面方便了人们的衣食住行,背后更是时时刻刻有大量的数据在经过各种各样的系统平台的采集、清晰、分析,而保证数据的低时延、高吞吐、安全性就显得尤为重要,Apache Avro本身通过Schema的方式序列化后进行二进制传输,一方面保证了数据的高速传输,另一方面保证了数据安全性,avro当前在各个行业的应用越来越广泛,如何对avro数据进行处理解析应用就格外重要,本文将演示如果序列化生成avro数据,并使用FlinkSQL进行解析。本文是avro解析的demo,当前FlinkSQL仅适用于简单的avro数据解析,复杂嵌套avro数据暂时不支持。场景介绍本文主要介绍以下三个重点内容:• 如何序列化生成Avro数据• 如何反序列化解析Avro数据• 如何使用FlinkSQL解析Avro数据前提条件• 了解avro是什么,可参考apache avro官网快速入门指南• 了解avro应用场景操作步骤1、新建avro maven工程项目,配置pom依赖pom文件内容如下:1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950515253<?xml version="1.0" encoding="UTF-8"?><project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.huawei.bigdata</groupId> <artifactId>avrodemo</artifactId> <version>1.0-SNAPSHOT</version> <dependencies> <dependency> <groupId>org.apache.avro</groupId> <artifactId>avro</artifactId> <version>1.8.1</version> </dependency> <dependency> <groupId>junit</groupId> <artifactId>junit</artifactId> <version>4.12</version> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.apache.avro</groupId> <artifactId>avro-maven-plugin</artifactId> <version>1.8.1</version> <executions> <execution> <phase>generate-sources</phase> <goals> <goal>schema</goal> </goals> <configuration> <sourceDirectory>${project.basedir}/src/main/avro/</sourceDirectory> <outputDirectory>${project.basedir}/src/main/java/</outputDirectory> </configuration> </execution> </executions> </plugin> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-compiler-plugin</artifactId> <configuration> <source>1.6</source> <target>1.6</target> </configuration> </plugin> </plugins> </build> </project>注意:以上pom文件配置了自动生成类的路径,即${project.basedir}/src/main/avro/和${project.basedir}/src/main/java/,这样配置之后,在执行mvn命令的时候,这个插件就会自动将此目录下的avsc schema生成类文件,并放到后者这个目录下。如果没有生成avro目录,手动创建一下即可。2、定义schema使用JSON为Avro定义schema。schema由基本类型(null,boolean, int, long, float, double, bytes 和string)和复杂类型(record, enum, array, map, union, 和fixed)组成。例如,以下定义一个user的schema,在main目录下创建一个avro目录,然后在avro目录下新建文件 user.avsc :123456789{"namespace": "lancoo.ecbdc.pre", "type": "record", "name": "User", "fields": [ {"name": "name", "type": "string"}, {"name": "favorite_number", "type": ["int", "null"]}, {"name": "favorite_color", "type": ["string", "null"]} ]}3、编译schema点击maven projects项目的compile进行编译,会自动在创建namespace路径和User类代码4、序列化创建TestUser类,用于序列化生成数据1234567891011121314151617181920212223User user1 = new User();user1.setName("Alyssa");user1.setFavoriteNumber(256);// Leave favorite col or null // Alternate constructorUser user2 = new User("Ben", 7, "red"); // Construct via builderUser user3 = User.newBuilder() .setName("Charlie") .setFavoriteColor("blue") .setFavoriteNumber(null) .build(); // Serialize user1, user2 and user3 to diskDatumWriter<User> userDatumWriter = new SpecificDatumWriter<User>(User.class);DataFileWriter<User> dataFileWriter = new DataFileWriter<User>(userDatumWriter);dataFileWriter.create(user1.getSchema(), new File("user_generic.avro"));dataFileWriter.append(user1);dataFileWriter.append(user2);dataFileWriter.append(user3);dataFileWriter.close();执行序列化程序后,会在项目的同级目录下生成avro数据user_generic.avro内容如下:Objavro.schema{"type":"record","name":"User","namespace":"lancoo.ecbdc.pre","fields":[{"name":"name","type":"string"},{"name":"favorite_number","type":["int","null"]},{"name":"favorite_color","type":["string","null"]}]}5、反序列化通过反序列化代码解析avro数据1234567891011// Deserialize Users from diskDatumReader<User> userDatumReader = new SpecificDatumReader<User>(User.class);DataFileReader<User> dataFileReader = new DataFileReader<User>(new File("user_generic.avro"), userDatumReader);User user = null;while (dataFileReader.hasNext()) { // Reuse user object by passing it to next(). This saves us from // allocating and garbage collecting many objects for files with // many items. user = dataFileReader.next(user); System.out.println(user);}执行反序列化代码解析user_generic.avroavro数据解析成功。6、将user_generic.avro上传至hdfs路径12hdfs dfs -mkdir -p /tmp/lztest/hdfs dfs -put user_generic.avro /tmp/lztest/7、配置flinkserver准备avro jar包将flink-sql-avro-*.jar、flink-sql-avro-confluent-registry-*.jar放入flinkserver lib,将下面的命令在所有flinkserver节点执行123cp /opt/huawei/Bigdata/FusionInsight_Flink_8.1.2/install/FusionInsight-Flink-1.12.2/flink/opt/flink-sql-avro*.jar /opt/huawei/Bigdata/FusionInsight_Flink_8.1.3/install/FusionInsight-Flink-1.12.2/flink/libchmod 500 flink-sql-avro*.jarchown omm:wheel flink-sql-avro*.jar同时重启FlinkServer实例,重启完成后查看avro包是否被上传hdfs dfs -ls /FusionInsight_FlinkServer/8.1.2-312005/lib8、编写FlinkSQL1234567891011121314151617181920212223242526CREATE TABLE testHdfs( name String, favorite_number int, favorite_color String) WITH( 'connector' = 'filesystem', 'path' = 'hdfs:///tmp/lztest/user_generic.avro', 'format' = 'avro');CREATE TABLE KafkaTable ( name String, favorite_number int, favorite_color String) WITH ( 'connector' = 'kafka', 'topic' = 'testavro', 'properties.bootstrap.servers' = '96.10.2.1:21005', 'properties.group.id' = 'testGroup', 'scan.startup.mode' = 'latest-offset', 'format' = 'avro');insert into KafkaTableselect *from testHdfs;保存提交任务9、查看对应topic中是否有数据FlinkSQL解析avro数据成功。转载自https://www.jb51.net/article/233454.htm
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签