-
 文章目录1.实现原理1.1认识 URL1.2 http请求报文格式1.3 http响应报头格式2.具体实现2.1 获取url2.2 获取请求报文的报头2.3 获取请求报文的数据2.4 获取本机的局域网ip3.自动连接Wi-Fi4.打包成exe文件原来在本科期间买的老华硕电脑,最近开始无缘无故的黑屏、死机,让我开始有了换电脑的念头,早都想试一试苹果的系统了,所以趁着这次618活动来临,也是狠下手笔,入手了人生第一台MacBook-Air。在适应了一天之后,基本上使用起来没什么障碍了,肯定还有很多功能是我没发现的,以后在慢慢探索了。期间我也遇到了一个令人烦恼的事情,就是每次连学校的校园网,都要弹窗、登录,很繁琐,就想着试试看,自己能不能也写一个脚本来实现自动连接校园网的功能。第一次搞这玩意儿,也是遇到各种问题,写帖记录一下。1.实现原理刚好最近学了http协议,就当是复习了。简单概括就是,通过网址找到登录界面,然后发送post请求,把登录信息提交给服务器,从而完成登录。图片来源于朋友博客的,他的更详细介绍了http协议,感兴趣可以看看。1.1认识 URL我们所说的网址,其实就是统一资源定位符(uniform resource locator简称URL),通过这个唯一的地址,可以找到对应的服务。它的标准格式如下:协议://用户名:密码@子域名.域名.顶级域名:端口号/目录/文件名.文件后缀?参数=值#标志这个只是标准的格式,有些信息是可以省略的,比如登录信息等,还有服务器地址可以用域名地址,也可以用ip地址。带层次的文件路径其实就是你要访问的服务器资源,问号?后面是get请求的参数。http协议有多种请求方法,post和get只是其中的两种。1.get方法主要是获取服务器的资源信息,请求的参数一般放在url?后面。2.post方法主要是把数据提交给服务器,在报文的正文部分进行提交。http协议本质是获得某种“资源”(视频、音频、网页、图片……),而传输则是其功能。实际上,上网的大部分行为,都在进行着进程间通信,既然是通信,就需要获取信息和发送信息,所以对应到我们生活中,大部分的上网行为无非两种:1.把服务器上面的资源拿到本地(下载短视频、网络小说……)2.把本地的服务器推送到服务器(搜索、登录、下单……)1.2 http请求报文格式首行: [方法] + [url] + [版本]Header: 请求的属性, 冒号分割的键值对;每组属性之间使用\n分隔;遇到空行表示Header部分结束Body: 空行后面的内容都是Body. Body允许为空字符串. 如果Body存在, 则在Header中会有一个 Content-Length属性来标识Body的长度;1.3 http响应报头格式首行: [版本号] + [状态码] + [状态码解释]Header: 请求的属性, 冒号分割的键值对;每组属性之间使用\n分隔;遇到空行表示Header部分结束Body: 空行后面的内容都是Body. Body允许为空字符串. 如果Body存在, 则在Header中会有一个 Content-Length属性来标识Body的长度; 如果服务器返回了一个html页面, 那么html页面内容就是在 body中。HTTP常见Header:Content-Type: 数据类型(text/html等) Content-Length: Body的长度Host: 客户端告知服务器, 所请求的资源是在哪个主机的哪个端口上; User-Agent: 声明用户的操作系统和浏览器版本信息;referer: 当前页面是从哪个页面跳转过来的;location: 搭配3xx状态码使用, 告诉客户端接下来要去哪里访问;Cookie: 用于在客户端存储少量信息. 通常用于实现会话(session)的功能;2.具体实现import requestsimport socket# 获取ip地址def get_host_ip(): """ 查询本机ip地址 :return: ip """ try: s = socket.socket(socket.AF_INET, socket.SOCK_DGRAM) s.connect(('10.255.255.255', 1)) ip = s.getsockname()[0] finally: s.close() return ipuser_ip = get_host_ip()# 校园网地址,最好不要用浏览器里的url,还是建议抓包获取post_addr = "http://10.10.244.11:801/eportal/"#下面两个大括号里面都是复制自己学校校园网登录网站中的,冒号两边都要加上双引号post_header = {#报头信息,通过抓包,获取} post_data = { #正文数据,通过抓包获取} #提交http请求报文z = requests.post(post_addr, data=post_data, headers=post_header)print("登录校园网成功,局域网ip如下:")print(user_ip)#input("")上面是代码的主要逻辑,细节信息还需要抓包填充。一开始电脑上是没有安装requests包的,需要自己先安装一下,后面python需要导入的包都是用pip3命令安装。如果没安装pip3命令的,请自行安装。pip3 install requests12.1 获取url在谷歌浏览器先打开上网登录窗口,然后按F12键进入开发者模式,勾选保留日志,输入账号密码,进行登录,在网络那里获取登录时的http请求报文。然后查看抓到的包,查看第一个即可,一般是第一个,如果不放心可以点进区查看,看到标头里的请求方法,确保是post。然后里面还有一个请求网址,就是url了。只需要复制?问号前面的内容即可,后面的是一些get方法的请求参数,不明白什么意思的看长文url的解释。往下拉,还有响应标头,请求标头等信息,⚠️注意,因为我们要向服务器请求登录,所以我们需要的是请求标头,而不是响应,别搞错了。# 校园网地址,最好不要用浏览器里的url,还是建议抓包获取post_addr = "http://10.10.244.11:801/eportal/"这样就完成了第一步,获取到了校园网地址。为什么说不建议直接从浏览器里面复制呢,比如我们学校这种情况返回的响应是3xx,说明网址被重定向过了,所以抓包到的地址比较准确一些。2.2 获取请求报文的报头把请求标头里的内容填充到代码块里,部分header的含义上文已经解释过,还想了解更多请自行搜索。填充的格式是键值 key:values模式,key和values都是字符串需要加引号,上下键值用逗号隔开,下面是我自己的报文,只是个例子。#下面两个大括号里面都是复制自己学校校园网登录网站中的,冒号两边都要加上双引号post_header = { 'Accept': '*/*', 'Accept-Encoding': 'gzip, deflate', 'Accept-Language': 'zh-CN,zh;q=0.9', 'Cache-Control': 'max-age=0', 'Connection': 'keep-alive', 'Host': '10.10.244.11', 'Referer': 'http://10.10.244.11/', 'Upgrade-Insecure-Requests': '1', 'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/101.0.4951.64 Safari/537.36',}2.3 获取请求报文的数据把载荷里的查询字符串、表单数据都填充到程序块中,这里主要上传的就是你的登录信息,不要填错了。post_data = { 'c': 'ACSetting', 'a': 'Login', 'DDDDD': 'xxxx', 'upass': 'xxxxx', 'protocol': 'http:', 'hostname': '10.10.244.11', 'iTermType': '1', 'wlanuserip': user_ip, 'wlanacip': 'xxxxxx', 'wlanacname': 'SPL-BRAS-SR8806-X', 'mac': '00-00-00-00-00-00', 'ip': user_ip, 'enAdvert': '0', 'queryACIP': '0', 'loginMethod': '1'}2.4 获取本机的局域网ip为什么要单独写一个函数获取主机IP呢,因为IP地址分为固定IP地址和动态IP地址,我们需要获取的是动态的IP地址,它是一直变化的,不能直接在请求数据里填抓包拿到的地址,不然你换个地方,可能那个地址就失效了。固定IP:固定IP地址是长期固定分配给一台计算机使用的IP地址,一般是特殊的服务器才拥有固定IP地址。动态IP:因为IP地址资源非常短缺,通过电话拨号上网或普通宽带上网用户一般不具备固定IP地址,而是由ISP动态分配暂时的一个IP地址,这些都是计算机系统自动完成的。# 获取ip地址#需要导入socket包,系统应该自带def get_host_ip(): """ 查询本机ip地址 :return: ip """ try: s = socket.socket(socket.AF_INET, socket.SOCK_DGRAM) s.connect(('10.255.255.255', 1)) ip = s.getsockname()[0] finally: s.close() return ipuser_ip = get_host_ip()写到这里其实,已经可以自动连接校园网了,但是前提是你先打开Wi-Fi,连到学校的校园网Wi-Fi。说到底,现在的功能只能帮助你登录校园网,连接校园网Wi-Fi的事情还是得你来做,如果你之前连的是其他网络,那么你还有进行网络的切换。所以还要再增加一个自动连接Wi-Fi的功能,刚好python里有一个pywifi包可以支持这个功能。但是!!直接pip3 安装的pywifi包里面不支持mac os的Wi-Fi控制,因为开发这个pywifi包的作者不用mac os系统,所以pywifi包只支持windows和linux。好在,后来有人提出这个问题,作者后来又写了一个适合mac os的包,不过需要自己下载。我也是经历很多波折,才解决了这个问题。3.自动连接Wi-Fi还是先在终端安装pywifi包,然后找到pywifi包对应位置,把内容全部替换成支持moc os 的pywifi包。pip3 install pywifi1如果找不到pywifi路径可以先执行卸载命令,然后就会弹出所以安装过的包路径了,然后复制所需的路径,最好选择n命令,停止卸载就行。得到安装路径以后,可以在终端里查看,也可以在mac可视化文件模式里查看,我更喜欢可视化,打开的时候有的文件夹就翻译成中文了,我相信只要用心肯定能找到。找到pywifi路径之后,就要下载支持mac os的pywifi包了,下载完进行替换就行。那这个支持mac os的pywifi在哪呢?这里给出作者github的地址,作者awkman在Issue24里面也回答了,他写了一个兼容Macos的demo程序。moc版pywifi作者回复可以在终端用git命令下载,也可以,直接到作者仓库取自己下载,大家随意。git命令下载指令如下:-b 后面带的是分支,作者放在macos_dev里了。git clone -b macos_dev https://github.com/awkman/pywifi.git1下载完检查一下是不是包含了mac的.py文件,包含了就没问题。然后把包含了mac的这个pywifi文件和之前的pywifi进行替换就行。先cd到当前文件夹,然后cp拷贝到原来路径(怎么找路径前文已经说了),文件名相同会自动替换里面内容。cd pywificp -r pywifi /Users/wenanqin/Library/Python/3.8/lib/python/site-packages12之前我在这样做完,运行还是报错,因为发现_wifiutil_macos.py里有一个包没安装,装完就好了。pip3 install pyobjc1下面开始完成连接wifi功能的代码,在统一路径下,新建一个wifi.py文件。import pywifiimport time#保存包中写义的常量from pywifi import constdef wifi_connect_status(): """ 判断本机是否有无线网卡,以及连接状态 :return: 已连接或存在无线网卡返回1,否则返回0 """ #创建一个元线对象 wifi = pywifi.PyWiFi() #取当前机器,第一个元线网卡 iface = wifi.interfaces()[0] #有可能有多个无线网卡,所以要指定 #判断是否连接成功 if iface.status() in [const.IFACE_CONNECTED,const.IFACE_INACTIVE]: #print('wifi已经连接了网络') return 1 else: print("兄弟,我没设置自动打开Wi-Fi功能,你先打开wifi再试?") return 0def scan_wifi(): """ 扫描附件wifi :return: 扫描结果对象 """ #扫描附件wifi wifi = pywifi.PyWiFi() iface = wifi.interfaces()[0] iface.scan() #扫描附件wifi time.sleep(1) basewifi = iface.scan_results() # for i in basewifi: # print('wifi扫描结果:{}'.format(i.ssid)) # ssid 为wifi名称 # print('wifi设备MAC地址:{}'.format(i.bssid)) return basewifidef connect_wifi(): wifi = pywifi.PyWiFi() # 创建一个wifi对象 ifaces = wifi.interfaces()[0] # 取第一个无限网卡 #print("本机无线网卡名称:") #print(ifaces.name()) # 输出无线网卡名称 ifaces.disconnect() # 断开网卡连接 time.sleep(3) # 缓冲3秒 profile = pywifi.Profile() # 配置文件 profile.ssid = "NJUPT-CMCC" # wifi名称 #连校园网不需要密码登录,另有登录模块 # profile.auth = const.AUTH_ALG_OPEN # 需要密码 # profile.akm.append(const.AKM_TYPE_WPA2PSK) # 加密类型 # profile.cipher = const.CIPHER_TYPE_CCMP # 加密单元 # profile.key = '4000103000' #wifi密码 ifaces.remove_all_network_profiles() # 删除其他配置文件 tmp_profile = ifaces.add_network_profile(profile) # 加载配置文件 ifaces.connect(tmp_profile) # 连接 time.sleep(1) # 尝试10秒能否成功连接 isok = True if ifaces.status() == const.IFACE_CONNECTED: print("连接校园网成功") else: print("连接校园网失败") #ifaces.disconnect() # 断开连接 time.sleep(1) return isok这里有三个功能,前两个测试用的,实际可以只调用第三个。link.py登录校园网之前先调用连接wifi模块。import requestsimport socket#导入刚才写的wifi模块,一定放在同一文件夹内import wifi#查看wifi状态wifi.wifi_connect_status()#连接wifiwifi.connect_wifi()# 获取ip地址def get_host_ip(): """ 查询本机ip地址 :return: ip """ try: s = socket.socket(socket.AF_INET, socket.SOCK_DGRAM) s.connect(('10.255.255.255', 1)) ip = s.getsockname()[0] finally: s.close() return ipuser_ip = get_host_ip()# 校园网地址post_addr = "http://10.10.244.11:801/eportal/"#下面两个大括号里面都是复制自己学校校园网登录网站中的,冒号两边都要加上双引号post_header = { 'Accept': '*/*', 'Accept-Encoding': 'gzip, deflate', 'Accept-Language': 'zh-CN,zh;q=0.9', 'Cache-Control': 'max-age=0', 'Connection': 'keep-alive', 'Host': '10.10.244.11', 'Referer': 'http://10.10.244.11/', 'Upgrade-Insecure-Requests': '1', 'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/101.0.4951.64 Safari/537.36',} post_data = { 'c': 'ACSetting', 'a': 'Login', 'DDDDD': ',0,xxxxxxx@cmcc', 'upass': 'xxxxx', 'protocol': 'http:', 'hostname': '10.10.244.11', 'iTermType': '1', 'wlanuserip': user_ip, 'wlanacip': 'xxxxxxx', 'wlanacname': 'SPL-BRAS-SR8806-X', 'mac': '00-00-00-00-00-00', 'ip': user_ip, 'enAdvert': '0', 'queryACIP': '0', 'loginMethod': '1'}z = requests.post(post_addr, data=post_data, headers=post_header)#如果不想每次都手动关闭窗口可以删除下面的input,然后将print里的内容改成自己想要的print("登录校园网成功,局域网ip如下:")print(user_ip)#input("")4.打包成exe文件1.先安装pyinstaller包pip3 install pyinstaller12.找到pyinstaller命令路径(带bin,老方法卸载看路径),我直接执行不了pyinstaller指令,因为python系统就有,环境变量还没配置。3.执行指令打包先cd到需要打包文件的路径下,然后执行指令,我安装了一个超级右键程序,很方便操作#将 xx.py 打包为 xx.exe/Users/wenanqin/Library/Python/3.8/bin/pyinstaller -F xx.py1执行完操作,会生成三个文件,exe文件在dist文件内,至此,全部工作完成。执行程序,效果如上。如果想实现开盖自连,可看MacBook利用sleepwatcher实现开盖自动联网。原文链接:https://blog.csdn.net/weixin_42907822/article/details/125105976
-
 >摘要:本篇文章主要讲解Python调用OpenCV实现图像阈值化处理操作,包括二进制阈值化、反二进制阈值化、截断阈值化、反阈值化为0、阈值化为0。 本文分享自华为云社区《[[Python图像处理] 七.图像阈值化处理及算法对比](https://bbs.huaweicloud.com/blogs/293565?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content) 》,作者: eastmount 。 # 一. 阈值化 (注:该部分参考作者的论文《基于苗族服饰的图像锐化和边缘提取技术研究》) 图像的二值化或阈值化(Binarization)旨在提取图像中的目标物体,将背景以及噪声区分开来。通常会设定一个阈值T,通过T将图像的像素划分为两类:大于T的像素群和小于T的像素群。 灰度转换处理后的图像中,每个像素都只有一个灰度值,其大小表示明暗程度。二值化处理可以将图像中的像素划分为两类颜色,常用的二值化算法如公式1所示: 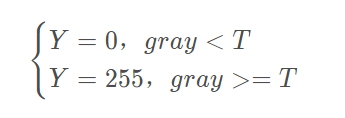 当灰度Gray小于阈值T时,其像素设置为0,表示黑色;当灰度Gray大于或等于阈值T时,其Y值为255,表示白色。 Python OpenCV中提供了阈值函数threshold()实现二值化处理,其公式及参数如下图所示: retval, dst = cv2.threshold(src, thresh, maxval, type) 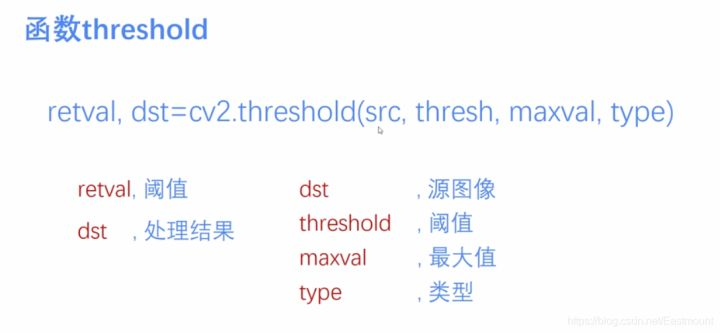 常用的方法如下表所示,其中函数中的参数Gray表示灰度图,参数127表示对像素值进行分类的阈值,参数255表示像素值高于阈值时应该被赋予的新像素值,最后一个参数对应不同的阈值处理方法。 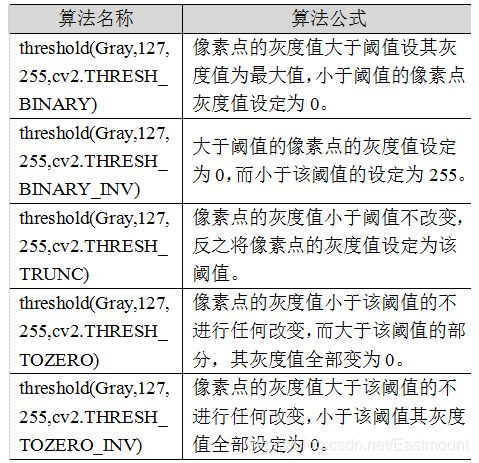 对应OpenCV提供的五张图如下所示,第一张为原图,后面依次为:二进制阈值化、反二进制阈值化、截断阈值化、反阈值化为0、阈值化为0。 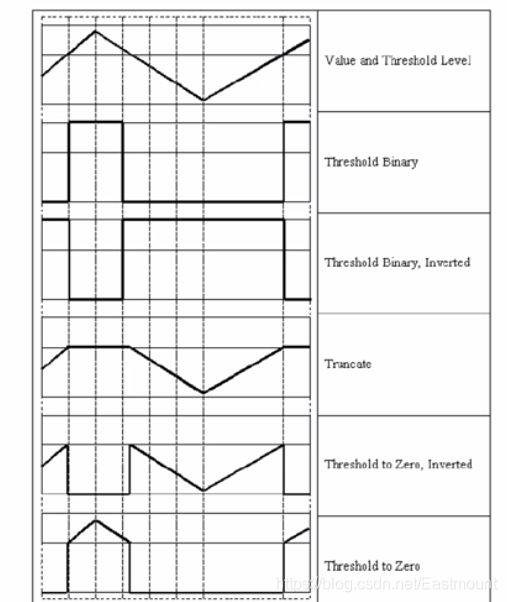 二值化处理广泛应用于各行各业,比如生物学中的细胞图分割、交通领域的车牌设别等。在文化应用领域中,通过二值化处理将所需民族文物图像转换为黑白两色图,从而为后面的图像识别提供更好的支撑作用。下图表示图像经过各种二值化处理算法后的结果,其中“BINARY”是最常见的黑白两色处理。 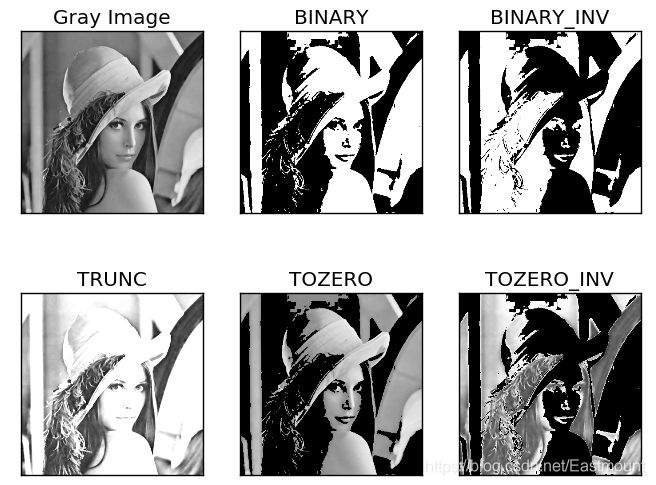 # 二. 二进制阈值化 该方法先要选定一个特定的阈值量,比如127。新的阈值产生规则如下: 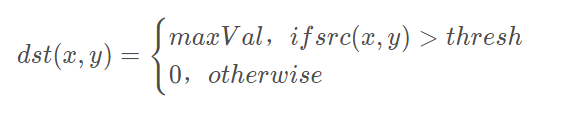 (1) 大于等于127的像素点的灰度值设定为最大值(如8位灰度值最大为255) (2) 灰度值小于127的像素点的灰度值设定为0 例如,163->255,86->0,102->0,201->255。 关键字为 cv2.THRESH_BINARY,完整代码如下: ``` #encoding:utf-8 import cv2 import numpy as np #读取图片 src = cv2.imread('test.jpg') #灰度图像处理 GrayImage = cv2.cvtColor(src,cv2.COLOR_BGR2GRAY) #二进制阈值化处理 r, b = cv2.threshold(GrayImage, 127, 255, cv2.THRESH_BINARY) print r #显示图像 cv2.imshow("src", src) cv2.imshow("result", b) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() ``` 输出为两个返回值,r为127,b为处理结果(大于127设置为255,小于设置为0)。如下图所示: 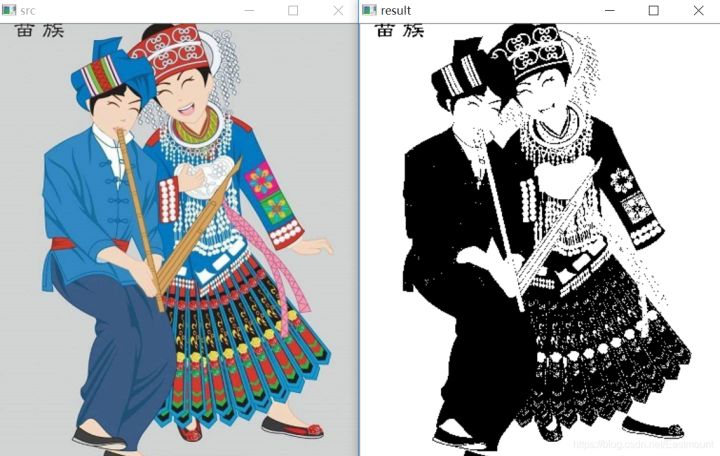 # 三. 反二进制阈值化 该方法与二进制阈值化方法相似,先要选定一个特定的灰度值作为阈值,比如127。新的阈值产生规则如下: 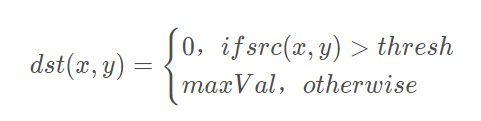 (1) 大于127的像素点的灰度值设定为0(以8位灰度图为例) (2) 小于该阈值的灰度值设定为255 例如,163->0,86->255,102->255,201->0。 关键字为 cv2.THRESH_BINARY_INV,完整代码如下: ``` #encoding:utf-8 import cv2 import numpy as np #读取图片 src = cv2.imread('test.jpg') #灰度图像处理 GrayImage = cv2.cvtColor(src,cv2.COLOR_BGR2GRAY) #反二进制阈值化处理 r, b = cv2.threshold(GrayImage, 127, 255, cv2.THRESH_BINARY_INV) print r #显示图像 cv2.imshow("src", src) cv2.imshow("result", b) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() ``` 输出结果如下图所示: 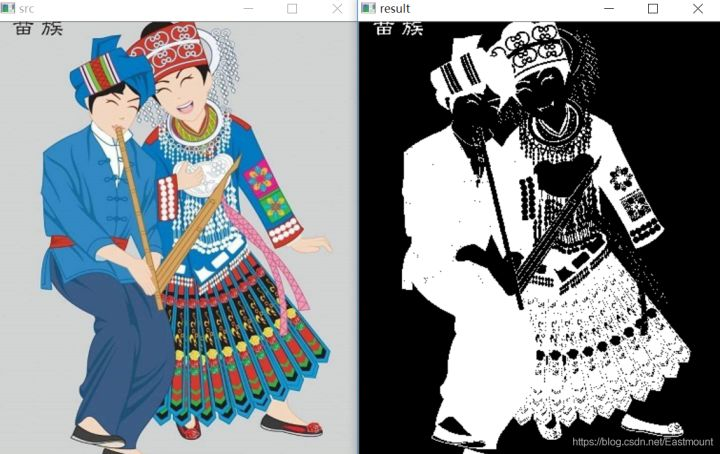 该方法得到的结果正好与二进制阈值化方法相反,亮色元素反而处理为黑色,暗色处理为白色。 # 四. 截断阈值化 该方法需要选定一个阈值,图像中大于该阈值的像素点被设定为该阈值,小于该阈值的保持不变,比如127。新的阈值产生规则如下: 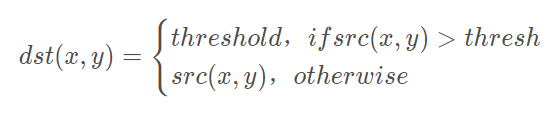 (1) 大于等于127的像素点的灰度值设定为该阈值127 (2) 小于该阈值的灰度值不改变 例如,163->127,86->86,102->102,201->127。 关键字为 cv2.THRESH_TRUNC,完整代码如下: ``` #encoding:utf-8 import cv2 import numpy as np #读取图片 src = cv2.imread('test.jpg') #灰度图像处理 GrayImage = cv2.cvtColor(src,cv2.COLOR_BGR2GRAY) #截断阈值化处理 r, b = cv2.threshold(GrayImage, 127, 255, cv2.THRESH_TRUNC) print r #显示图像 cv2.imshow("src", src) cv2.imshow("result", b) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() ``` 输出结果如下图所示: 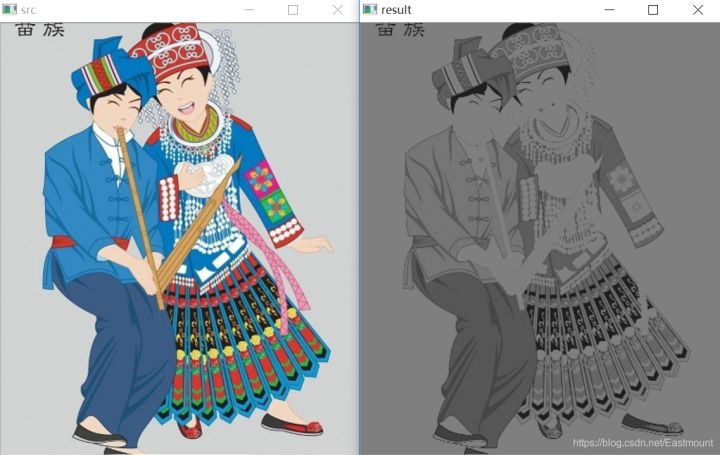 该处理方法相当于把图像中比较亮(大于127,偏向于白色)的像素值处理为阈值。 # 五. 反阈值化为0 该方法先选定一个阈值,比如127,接着对图像的灰度值进行如下处理: 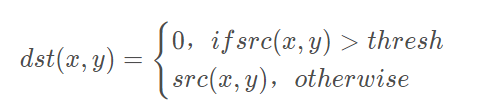 (1) 大于等于阈值127的像素点变为0 (2) 小于该阈值的像素点值保持不变 例如,163->0,86->86,102->102,201->0。 关键字为 cv2.THRESH_TOZERO_INV,完整代码如下: ``` #encoding:utf-8 import cv2 import numpy as np #读取图片 src = cv2.imread('test.jpg') #灰度图像处理 GrayImage = cv2.cvtColor(src,cv2.COLOR_BGR2GRAY) #反阈值化为0处理 r, b = cv2.threshold(GrayImage, 127, 255, cv2.THRESH_TOZERO_INV) print r #显示图像 cv2.imshow("src", src) cv2.imshow("result", b) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() ``` 输出结果如下图所示: 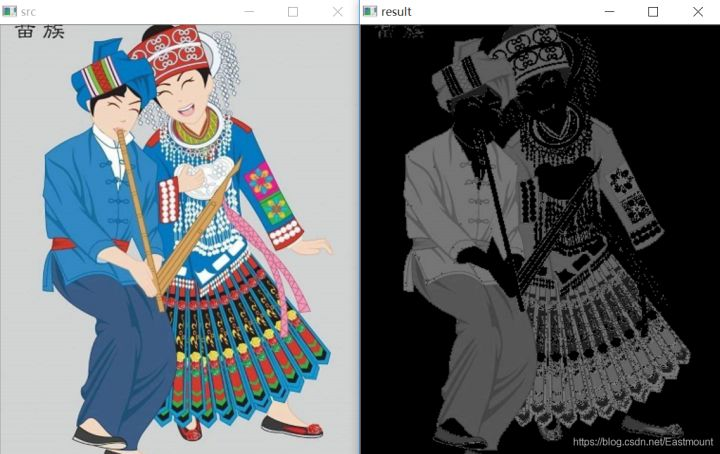 # 六. 阈值化为0 该方法先选定一个阈值,比如127,接着对图像的灰度值进行如下处理: 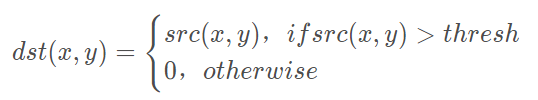 (1) 大于等于阈值127的像素点,值保持不变 (2) 小于该阈值的像素点值设置为0 例如,163->163,86->0,102->0,201->201。 关键字为 cv2.THRESH_TOZERO,完整代码如下: ``` #encoding:utf-8 import cv2 import numpy as np #读取图片 src = cv2.imread('test.jpg') #灰度图像处理 GrayImage = cv2.cvtColor(src,cv2.COLOR_BGR2GRAY) #阈值化为0处理 r, b = cv2.threshold(GrayImage, 127, 255, cv2.THRESH_TOZERO) print r #显示图像 cv2.imshow("src", src) cv2.imshow("result", b) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() ``` 输出结果如下图所示: 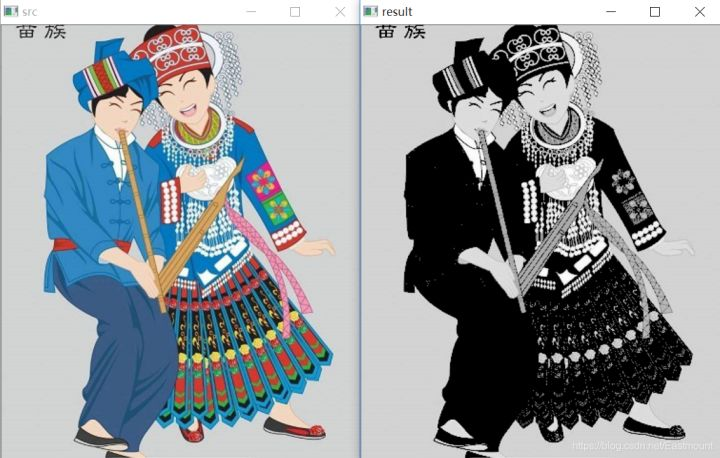 该算法把比较亮的部分不变,比较暗的部分处理为0。 完整五个算法的对比代码如下所示: ``` #encoding:utf-8 import cv2 import numpy as np import matplotlib.pyplot as plt #读取图像 img=cv2.imread('test.jpg') lenna_img = cv2.cvtColor(img,cv2.COLOR_BGR2RGB) GrayImage=cv2.cvtColor(img,cv2.COLOR_BGR2GRAY) #阈值化处理 ret,thresh1=cv2.threshold(GrayImage,127,255,cv2.THRESH_BINARY) ret,thresh2=cv2.threshold(GrayImage,127,255,cv2.THRESH_BINARY_INV) ret,thresh3=cv2.threshold(GrayImage,127,255,cv2.THRESH_TRUNC) ret,thresh4=cv2.threshold(GrayImage,127,255,cv2.THRESH_TOZERO) ret,thresh5=cv2.threshold(GrayImage,127,255,cv2.THRESH_TOZERO_INV) #显示结果 titles = ['Gray Image','BINARY','BINARY_INV','TRUNC','TOZERO','TOZERO_INV'] images = [GrayImage, thresh1, thresh2, thresh3, thresh4, thresh5] for i in xrange(6): plt.subplot(2,3,i+1),plt.imshow(images[i],'gray') plt.title(titles[i]) plt.xticks([]),plt.yticks([]) plt.show() ``` 输出结果如下图所示: 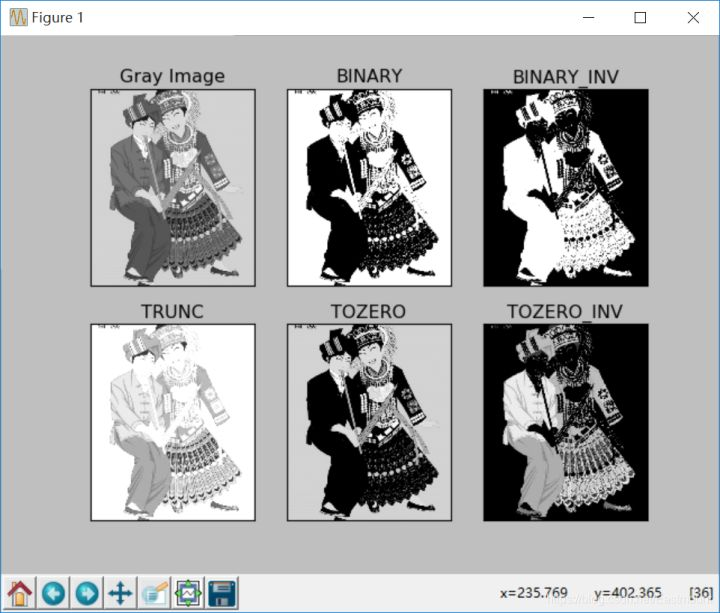 本文摘录自eastmount X华为云开发者社区联合出品的电子书《从零到一 • Python图像处理及识别》。
-
 Python由荷兰数学和计算机科学研究学会的吉多·范罗苏姆 于1990 年代初设计,作为一门叫做ABC语言的替代品。 Python提供了高效的高级数据结构,还能简单有效地面向对象编程。Python语法和动态类型,以及解释型语言的本质,使它成为多数平台上写脚本和快速开发应用的编程语言, 随着版本的不断更新和语言新功能的添加,逐渐被用于独立的、大型项目的开发。Python解释器易于扩展,可以使用C语言或C++(或者其他可以通过C调用的语言)扩展新的功能和数据类型。Python 也可用于可定制化软件中的扩展程序语言。Python丰富的标准库,提供了适用于各个主要系统平台的源码或机器码。 2021年10月,语言流行指数的编译器Tiobe将Python加冕为最受欢迎的编程语言,20年来首次将其置于Java、C和JavaScript之上。Python 程序能用很多方式处理日期和时间,转换日期格式是一个常见的功能。Python 提供了一个 time 和 calendar 模块可以用于格式化日期和时间。时间间隔是以秒为单位的浮点小数。每个时间戳都以自从 1970 年 1 月 1 日午夜(历元)经过了多长时间来表示实例#!/usr/bin/python3import time ticks = time.time()print ("当前时间戳为:", ticks)时间元组序号字段值04位数年20081月1 到 122日1到313小时0到234分钟0到595秒0到61 (60或61 是闰秒)6一周的第几日0到6 (0是周一)7一年的第几日1到366 (儒略历)8夏令时-1, 0, 1, -1是决定是否为夏令时的标识struct_time元组。这种结构具有如下属性:序号属性值0tm_year20081tm_mon1 到 122tm_mday1 到 313tm_hour0 到 234tm_min0 到 595tm_sec0 到 61 (60或61 是闰秒)6tm_wday0到6 (0是周一)7tm_yday一年中的第几天,1 到 3668tm_isdst是否为夏令时,值有:1(夏令时)、0(不是夏令时)、-1(未知),默认 -1获取当前时间#!/usr/bin/python3import timelocaltime = time.localtime(time.time())print ("本地时间为 :", localtime)
-
>摘要:本文主要介绍如何在MRS之上使用Superset进行数据分析。 本文分享自华为云社区《[使用商业智能软件Superset分析MRS数据之最佳实践](https://bbs.huaweicloud.com/blogs/358344?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=ei&utm_content=content)》,作者: 啊喔YeYe 。 # 1. 概要 ## Superset Apache Superset是一个现代的数据探索和可视化平台。具有功能强大、支持数据种类多、使用简单、易扩展、可视化能力丰富等诸多优势,在github上也有4.6w+的star.  ## MRS MRS是华为云提供的一站式大数据平台,基本覆盖了Hadoop生态中常用的基本组件,免去我们运维、搭建的烦恼。 本文主要介绍如何在MRS之上使用Superset进行数据分析。 # 2.环境准备 1. 在华为云购买创建弹性云服务器ECS(公共镜像建议选择CentOS 8.2 64bit),用于安装运行Superset,并绑定弹性公网IP,用于访问公网安装依赖包和Superset服务。 2. MRS服务开通,选择MRS 3.1.0版本的普通集群模式。注意网络与superset打通 # 3. superset安装 ## 3.1 登录已购买的Linux弹性云服务器,执行以下命令安装Superset运行依赖包 ``` yum install gcc gcc-c++ libffi-devel openssl-devel cyrus-sasl-devel openldap-devel python36-devel cyrus-sasl-plain ``` ## 3.2 执行以下命令升级pip版本 ``` pip3 install --upgrade pip ``` ## 3.3 执行以下命令安装python虚拟环境 ``` pip install virtualenv ``` ## 3.4 执行以下命令创建,并进入python虚拟环境 ``` python3 -m venv venv . venv/bin/activate ``` ## 3.5 执行以下命令安装python依赖包 ``` pip install dataclasses pip install pyhive[hive] pip install pyhive[presto] 3.6 执行以下命令安装Superset pip install apache-superset ``` ## 3.7 执行以下命令初始化database ``` superset db upgrade ``` ## 3.8 执行以下命令创建admin用户。需要输入用户名、FirstName、LastName和电子邮箱地址和密码 ``` export FLASK_APP=superset superset fab create-admin ``` ## 3.9 执行以下命令初始化角色和用户信息 ``` superset init ``` ## 3.10 执行以下命令启动superset服务 ``` superset run -p 8088 -h 0.0.0.0 --with-threads --reload --debugger ``` ## 3.11 选择“服务列表 > 弹性云服务器ECS > 待操作弹性云服务器名称 > 安全组”,单击“配置规则”。在配置规则界面,选择“入方向规则 > 添加规则”,将协议端口设置为8088,源地址设置为访问Supereset页面的机器的IP。 ## 3.12 访问http://ECS弹性IP:8088,并以admin用户登录,开始使用Superset  # 4. MRS Hive对接 MRS HiveServer通过ZooKeeper实现高可用,Superset直接使用pyhive连接HiveServer,无法通过ZooKeeper进行服务发现,因此只配置连接一个HiveServer。 ## 4.1 登录MRS管理控制台,在现有集群页面,单击集群名称进入MRS Manager页面。选择“组件管理 > Hive > 实例”,查看HiveServer实例所在节点IP  ## 4.2 在Superset界面,选择“Data > Databases”,单击右侧的“+”按钮进入创建Database页面  ## 4.3 在Add Database页面填写Database和SQL Alchemy URI。SQL Alchemy URI的填写内容为“hive://{HiveServer实例ip}:端口/{hive database名字}?auth=NONE”,其中,{HiveServer实例ip}为HiveServer实例的业务IP,{hive database名字}为要连接的Hive Database,例如default。勾选“Expose in SQL Lab”,单击“Save”保存配置. MRS 普通集群hiveserver2默认端口为10000。查看方式:登录manager,点击hive服务,点击全部配置,搜索hive.server2.thrift.port  superset配置:  ## 4.4 选择“SQL Lab > SQL Editor”,进入Untitled Query页面。在左侧“Database”下拉菜单中选择创建好的Database,在“Select a schema”下拉菜单中选择要查询的Schema(即Hive的databse,如default),在中间SQL编辑框内输入SQL语句。然后单击“RUN”按钮执行SQL,在下方Result页签中查看执行结果。  # 5. MRS SparkJDBC对接使用 ## 5.1 参考hive对接方式获取SparkJDBC实例ip与端口(默认22550,配置项:hive.server2.thrift.port),然后在Superset添加database。  ## 5.2 执行SQL验证  # 6. Superset中使用MRS PrestoSQL ## 6.1 在Manager界面,选择“集群 > 服务 > Presto > 配置 > 全部配置” ,搜索配置项PRESTO_COORDINATOR_FLOAT_IP ,获取Presto Coordinator浮动IP  端口:默认7520  ## 6.2 添加Presto database SQL Alchemy URI填写内容为“presto://{Presto Coordinator浮动IP}:{port}/{catalog名称}/{schema名称}”,其中{Presto Coordinator浮动IP}为1中获取的Presto Coordinator浮动IP,{catalog名称}为要连接的Presto catalog,{schema名称}为catalog对应的schema名字,例如hive/default.  ## 6.3 执行Presto SQL验证 
-
 编写100以内逢7拍手游戏(含7和7倍数的数用@替换)。for i in range(1, 101): # 把i转成字符串,使用find方法(字符串中不包含时,返回-1) include = str(i).find("7") # 判断条件:既不包含7,也不是7的倍数 if include == -1 and int(i) % 7 != 0: # 输出,去掉了换行符,加了、 print(i, end="、") # 如果包含7 输出* elif include != -1 or int(i) % 7 == 0: print("*", end='、') 输入100以内整数,5次机会猜此数。import randomprint("猜数字游戏,输入一个1-100以内的数字")random_num = random.randint(1, 100)# print(random_num) # 打开注释可查看生成的随机数for frequency in range(1,6): number = input("请输入一个数字:") if number.isdigit() is False: print('请输入一个正确的数字') elif int(number) < 0 or int(number) > 100: print("请输入1-100范围的数字") elif random_num == int(number): print("恭喜你用了%d次猜对了" % frequency) break elif random_num > int(number): print("很遗憾,你猜小了") else: print("很遗憾,你猜大了") if frequency == 5: print("很遗憾,%d次机会已用尽,游戏结束,答案为%d" % (frequency, random_num)) 列表中存放若干商品的价格,输入价格区间上限和下限,输出该区间所有价格。num = [399, 4369, 539, 288, 109, 749, 235, 190, 99, 1000]a = int(input("请输入最大价格:"))b = int(input("请输入最小价格:"))c = input('''1.价格降序排序2.价格升序排序请选择...:''')num1 = []for i in num: if i >= b and i <= a: num1.append(i)if c == '1': d = sorted(num1, reverse=True) print(d)if c == '2': num1.sort() print(num1) 列表(namel)中存放若干老师姓名,嵌套列表(officelJ, L. OI)三个子列表(办公室)随机存储name中各老师姓名,输出office内容。import randomteachers=['A','B','C','D','E','F','G','H']offices=[[],[],[]]for name in teachers: num=random.randint(0,2) offices[num].append(name)i=0for i in offices: m=len(i) print(m)print(offices) 编写函数:输入两个数和运算符输出运算结果。a = int(input("请输入第一个数:"))b = int(input("请输入第二个数:"))symbol = input("请输入四则运算符号:(+-*/%)")if symbol == "+": print("%s%s%s=%s"%(a,symbol,b,a+b))elif symbol == "-": print("%s%s%s=%s"%(a,symbol,b,a-b))elif symbol == "*": print("%s%s%s=%s"%(a,symbol,b,a*b))elif symbol == "/": if b == 0: print("除数不能为零") else:print("%s%s%s=%s"%(a,symbol,b,a/b))elif symbol=="%": print("%s%s%s=%s"%(a,symbol,b,a%b))else: print("符号输入有误,请重新输入!!!") 编写函数:输出20项斐波那契数列项。listnum = []for x in range(1, 21): if x == 1 or x == 2: listnum.append(x) else: listnum.append(listnum[x-2]+listnum[x-3])print(listnum) 设计编写长方体类,输入长、宽和高,输出面积和体积。import mathimport decimalclass Rect(object): def __init__(self,l,h,z): self.l = l self.h = h self.z = z def length(self): return 2*(self.l+self.h) def area(self): return self.l*self.hclass Cubic(Rect): def __init__(self,l,h,z): super(Cubic,self).__init__(l,h,z) #表面积 def area(self): return 2*(self.l*self.h) + 2*(self.h*self.z) + 2* (self.l*self.z) #体积 def tj(self): return super(Cubic,self).area() * self.z def show(self): print('{} {}'.format(decimal.Decimal(self.area()).quantize(decimal.Decimal('0.00')),decimal.Decimal(self.tj()).quantize(decimal.Decimal('0.00'))),end=' ')if __name__ == '__main__': while True: a = float(input('请输入长:')) b = float(input('请输入宽:')) c = float(input('请输入高:')) if a <= 0 or b <= 0 or c <= 0: print('0.00 0.00 0.00 0.00') else: m = Cubic(a, b, c) m.show() 设计编写动物类Animal,属性、函数自定义;子类鸟Bird,属性继承父类属性,函数完成属性值的输出。编写代码执行子类函数。class Animal(object): """定义动物类""" name = "" time = 0 def __init__(self, name, time): self.setName(name) self.setTime(time) def setName(self, name): self.name = name def setTime(self, time): if not isinstance(time, int): print('必须是整数') self.time = time def tell(self): print("动物名称: " + self.name) print("喂食次数: " + str(self.time))class brid(Animal): """定义猫类""" color = "" def __init__(self, name, time, color): Animal.__init__(self, name, time) self.color = color def tell(self): Animal.tell(self) print("动物颜色: " + self.color) def feed(self): self.time += 1if __name__ == "__main__": Brid1 = brid("小鸟1号", 0, "花色") Brid1.tell() Brid1.feed() Brid1.tell() 登陆mysql数据库的用户名密码自定义,数据库名为mydb。数据表为login,包含uname、upassword字段。要求完成注册和登陆功能,注册:输入用户名和密码,如果login表无此用户则插入到login中否则显示'用户已存在; ⑵登陆:输入用户名和密码,如果login表有此用户则'登陆成功'否则显示'登陆失败'。"""mysql1.创建数据库create database python charset=uft8;2.创建表create table py_users(id int unsigned auto_increment not null primary key,uname varchar(20) not null,upwd char(40) not null,);"""# 注册import pymysql, pymongo, osdef login(): """ 登录 :return: """ try: # 接收输入用户名、密码 uname = input('请输入用户名:') upwd = input('请输入密码:') print(uname+upwd) # 根据用户名查询密码 # 先到mongodb上查,没有再到mysql上查 #client = pymongo.MongoClient('localhost', 27017) # 连接数据库 #db = client.py3 # 连接py_users集合 #result = db.py_users.find_one({'uname': uname}) # 如果集合中的数据为空,在mysql中查询 #if result is None: conn = pymysql.connect(host='localhost', port=3306, database='mydb2', user='root', password='wzh123sal', charset='utf8') if conn: print('connect successful') cur = conn.cursor() sql = 'select * from py_users where uname=%s and upwd=%s;' sql1 = "select * from py_users ;" params = [uname, upwd] #cur.execute(sql) cur.execute(sql,params) if cur: print('cur successful') result = cur.fetchone() if result : print(result[0]+':'+result[1]) print('登录成功') show_stu() else: print('用户名不存在') #else: # print('登录成功') except: print("用户名未注册,请先注册") sel = input("是否需要注册:1:注册 2:退出") if sel == '1': registered() else: os._exit(0)def show_stu(): try: conn = pymysql.connect(host='localhost', port=3306, database='mydb2', user='root', password='wzh123sal', charset='utf8') if conn: print('connect successful') cur = conn.cursor() sql = "select * from student2;" cur.execute(sql) if cur: print('cur successful') results = cur.fetchall() print('studentid'+' '+'studentname'+' '+'age'+' '+'gender') print('-' * 30) for row in results: # studentid = row[0] # studentname = row[1] # age = row[2] # gender = row[3] print(f'{row[0]}',end='\t') print(f'{row[1]}',end='\t') print(f'{row[2]}',end='\t') print(f'{row[3]}') print('-'*30) except: print("no such tables!")def registered(): """ 注册 :return: """ uname = input('请输入用户名:') upwd = input('请输入密码:') sql = 'select upwd from py_users where uname=%s' params = [uname] # 打开与数据库的连接 try: conn = pymysql.connect(host='localhost', port=3306, database='mydb2', user='root', password='wzh123sal', charset='utf8') cur = conn.cursor() # 判断用户名是否存在 sql = 'select count(*) from py_users where uname=%s' params = [uname] cur.execute(sql, params) result = cur.fetchone() if result[0] == 1: print('用户名已经存在,注册失败') else: # 用户名不存在 sql = 'insert into py_users(uname,upwd) values(%s,%s)' params = [uname, upwd] result = cur.execute(sql, params) conn.commit() if result == 1: print('注册成功') else: print('注册失败') cur.close() except Exception as e: print('注册失败,原因是:%s' % e) finally: conn.close()def main(): # 打印菜单 print('————功能选择——————') print('1.登录') print('2.注册') sel = input("登录(1)or 注册(2)?") try: if sel == '1': login() elif sel == '2': registered() except Exception as e: print('程序错误,%s'%e)if __name__ == '__main__': main()
-
 在开发SND/GND/SSP等软件包,都需要编辑软件包配置文件pkg.json,填写hook配置。这里总结了hook中参数填写的原则。通常hook需要填写3个参数type:回调对应类型,由系统中给定类型值。 SND包:SND GND包:rpc/discover/service_settings/gnd-rpc/gnd-action/port/link SSP包:rpc/discover/service_settings如需要支持填充在YANG模型中定义参数默认值,type设置为service_settings。data-with-default代替python-class-name参数,可以设置为all或explicit,all表示填充定义的参数默认值,explicit表示默认不填充定义的参数默认值。key:回调key值。SND包:一般只需配置“ecs-driver”,指定在SND包中具体实现类;用户不使用系统默认连接agent时,再补充配置“ecs-connect-agent”,自定义hook中配置的连接agent,要生效需要同时设备的连接能力参数connectPolicy 配置为“COMPATIBLE_CONNECT”。GND/SSP包:一般情况下,YANG模型中的“app:application-definition”的值对应key值,即业务定义点。type设置为service-rpc时,key值规则为“(namespace:revision)localname”,localname指YANG模型rpc节点名称,例如"(http://example.com/RPC?revision=2018-12-09)read_device_vrf"。python-class-name: Python开发语言特有值,回调映射类。不能超过 256个字符。取值为.py文件中实现类的相对路径(相对于python目录),py文件名称不需要带后缀,路径层级之间用“.”连接。如python\temp\test.py定义实现类Test,则值为“temp.test.Test”。
-
 1.使用前先要安装 yagmailpip install yagmail -i https://pypi.douban.com/simple2.使用QQ邮箱发送邮件,使用的是授权码,需要先到QQ邮箱申请授权码。邮箱设置-->账户3.yagmail 模块发送邮件更加简单,四行代码12345678910111213141516171819202122232425262728293031# -*- encoding: utf-8 -*- import yagmail def E_mali_jj(fr,key,etype,text,to,attachments): ''' :param fr: 发送邮箱 :param key: 授权码 :param etype: 邮件类型 :param text: 文本 :param to: 接受邮箱 :param attachments: 附件文件地址,空则填'' :return: ''' # 链接邮箱服务器 yag=yagmail.SMTP(user=fr,password=key,host=etype) # 邮箱正文 contents=[text] # 发送邮件 yag.send(to=to,subject='邮件标题',contents=contents, attachments=attachments) #subject 标题 yag.close() print("邮件发送成功") if __name__ == '__main__': E_mali_jj("123456@qq.com", "gwheybuaamrqbihh", 'smtp.qq.com', "邮件正文内容", "123456@qq.com", "E:\\proto_code\\Roshan-01-microscript-proto_test-master-src\\src\\report\\report.html")邮件发送给多个人,将接受的邮箱放在列表中即可12# 发送邮件yag.send(to = ['123456@qq.com','678910@qq.com', '10111213@qq.com'], subject='subject', contents = contents, attachments="")4.发送邮件带附件12345678910111213141516171819202122232425262728293031# -*- coding:utf-8 -*-import yagmail yag = yagmail.SMTP( user="157540957@qq.com", password="kayzilfyziulbhbb1", host='smtp.qq.com')"""user: 发送的邮箱password: 授权码"""# 邮箱正文contents = ['测试发送邮件']# 附件attachments = "D:\\code\\0906\\api_test009\\report\\report.html"# 发送邮件try: yag.send(to = '3437871062@qq.com', subject='subject', contents = contents, attachments=attachments) except Exception as e : print("Error: 抱歉!发送邮件失败。", e)"""to : 接收者subject : 邮件主题contents: 正文attachments: 附件""" yag.close()5.封装1234567891011121314151617181920212223242526272829303132333435# -*- coding:utf-8 -*-import yagmail def send(user, password, receiver): yag = yagmail.SMTP( user=user, password=password, host='smtp.qq.com') """ user: 发送的邮箱 password: 授权码 """ # 邮箱正文 contents = ['测试发送邮件'] # 附件 attachments = "D:\\code\\0906\\api_test009\\report\\report.html" # 发送邮件 try: yag.send(to=receiver, subject='subject', contents = contents, attachments=attachments) except Exception as e : print("Error: 抱歉!发送邮件失败。", e) """ to : 接收者 subject : 邮件主题 contents: 正文 attachments: 附件 """ yag.close() if __name__ == '__main__': send("123456@qq.com", "kayzilfyziulbhbb1", "45678910@qq.com")
-
目录常规用法使用案例:常规用法用法作用random()返回0<=n<1之间的随机浮点数nrandom.uniform(a, b)用于生成一个指定范围内的随机符点数random.randint(a, b)用于生成一个指定范围内的整数random.randrange([start], stop[, step])从指定范围内,按指定基数递增的集合中 获取一个随机数choice(seq)从序列seq中返回随机的元素shuffle(seq[, random])原地指定seq序列sample(seq, n)从序列seq中选择n个随机且独立的元素gauss(mu, sigma)返回一个平均值为mu标准差为sigma的高斯分布,也可以由正态分布函数生成normalvariate(mu, sigma)lognormvariate(mu, sigma)返回一个平均值为mu,标准差为sigma的对数正态分布使用案例:1.random():2.random.uniform(a, b)3.random.randint(a, b)4.random.randrange([start],[ stop], step)从指定范围【start,stop】内,按指定基数step递增的集合中获取一个随机数,如:random.randrange(10, 100, 2),结果相当于从[10, 12, 14, 16, … 96, 98]序列中获取一个随机数。5.choice(seq)6.shuffle(seq[, random])7.sample(seq, n) 随机获取指定长度的片段,获取后元序列长度不变。8.gauss(mu, sigma)9.lognormvariate(mu, sigma)
-
目录一、Python输出1、repr() 或 str() 转成字符串2、字符串填充空格进行格式化3、!a (使用 ascii()), !s (使用 str()) 和 !r (使用 repr()) 可以用于在格式化某个值之前对其进行转化二、Python标识符三、Python保留字符(关键字)四、Python模块写法五、Python引号1、多行字符串2、转义符 '\'六、Python注释1、单行注释#2、多行注释’’’七、Python空行八、Python用户输入九、Python一行多段代码十、多行语句十一、三元表达式十二、Python代码组十三、import 与 from...import十四、Python 调试方法1、print2、assert3、debugger一、Python输出print是python输出的关键字,默认是输出内容后换行。如果不想换行,需要在变量末尾加上 end="" 。1234567a = 'hello'b = 'world'print(a)print(b)print(a, end=" " )print(b, end=" " )print(a, b)输出信息:1234C:\PycharmProjects\untitled\venv\Scripts\python.exe C:/PycharmProjects/untitled/test.pyhelloworldhello world多个变量输出之间加上逗号(,),默认为空格分隔符,如:12print(x, y)print(x, y, sep="-")1、repr() 或 str() 转成字符串如果你希望将输出的值转成字符串,可以使用 repr() 或 str() 函数来实现。str(): 函数返回一个用户易读的表达形式。repr(): 产生一个解释器易读的表达形式。12345678910111213141516s = 'Hello, Runoob'print(s)# Hello, Runoob print(repr(s))# 'Hello, Runoob' # repr() 函数可以转义字符串中的特殊字符hello = 'hello, runoob\n'hellos = repr(hello)print(hellos)# 'hello, runoob\n' # repr() 的参数可以是 Python 的任何对象print(repr((32.5, 40000, ('Google', 'Runoob'))))# (32.5, 40000, ('Google', 'Runoob'))2、字符串填充空格进行格式化字符串对象的 rjust() 方法, 它可以将字符串靠右, 并在左边填充空格。还有类似的方法, 如 ljust() 和 center()。 这些方法并不会写任何东西, 它们仅仅返回新的字符串。另一个方法 zfill(), 它会在数字的左边填充 0。有两种方式输出一个平方与立方的表:12345678910111213141516171819202122232425262728for x in range(1, 11): print(repr(x).rjust(2), repr(x * x).rjust(3), end=' ') # 注意前一行 'end' 的使用 print(repr(x * x * x).rjust(4)) # 1 1 1# 2 4 8# 3 9 27# 4 16 64# 5 25 125# 6 36 216# 7 49 343# 8 64 512# 9 81 729# 10 100 1000 for x in range(1, 11): print('{0:2d} {1:3d} {2:4d}'.format(x, x * x, x * x * x)) # 1 1 1# 2 4 8# 3 9 27# 4 16 64# 5 25 125# 6 36 216# 7 49 343# 8 64 512# 9 81 729# 10 100 10003、!a (使用 ascii()), !s (使用 str()) 和 !r (使用 repr()) 可以用于在格式化某个值之前对其进行转化123456import mathprint('使用 ascii(): {!a}'.format('哈哈啊W2'))# 使用 ascii(): '\u54c8\u54c8\u554aW2'。 print('常量 PI 的值近似为: {!r}。'.format(math.pi))# 常量 PI 的值近似为: 3.141592653589793。二、Python标识符在 Python 里,标识符可由字母、数字、下划线组合而成(但不能以数字开头),且标识符是区分字母大小写的,比如hello和Hello会被系统认为是两个标识符。以下划线开头的标识符是有特殊意义的。单下划线开头,如 _abc, 代表不能直接访问的类属性,需通过类提供的接口进行访问,不能用" from xxx import * "导入双下划线开头,如 __abc, 代表类的私有成员开头和结尾都有双下划线,如 __abc__ , 代表 Python 里特殊方法专用的标识,如 __init__() 代表类的构造函数三、Python保留字符(关键字)所有”保留字符“,也就是已经被Python系统征用的标识符,俗称“key word(关键字)”,这些保留字符不能用作常量或变量,以及任何标识符名称。以下是Python保留字符表:and、exec、not、assert、finally、or、break、for、pass、class、from、print、continue、global、raise、def、if、return、del、import、try、elif、in、while、else、is、with、except、lambda、yield四、Python模块写法与其他语言最大的不同在于,Python不使用大括号( { } )来描述类、函数以及其他逻辑判断,而是采用缩进的方式来写模块。而缩进的空白数量是可变的,如果你想确保代码块能正确运行,那必须确保代码块中的语句都是一样的缩进数量。举例:1234if True: print ("True") #此处缩进了2个空白数else: print ("False") #此处缩进了2个空白数如果是下面的写法,则会报错,因为最后的print只缩进了2个空白数,没有与代码块中的对齐:1234567if True: print ("Answer") print ("True")else: print ("Answer") # 没有严格缩进,在执行时会报错 print ("False")报错信息:File "D:/PythonProject/hello.py", line 7 print ("False") ^ IndentationError: unindent does not match any outer indentation level 因此,建议你使用 单个制表符 或 两个空格 或 四个空格 来对代码进行缩进,切勿混用。五、Python引号python中单引号和双引号使用完全相同。python支持用单引号(' ')、双引号( " " )、三个双引号( """ """ )或三个单引号( ''' ''' ),都可以表示字符串,引号的开始与结束必须相同类型和数量。1、多行字符串注意:使用三引号('''或""")可以指定一个多行字符串。可以由多行组成,为编写多行文本的快捷语法,常用于文档字符串。在文件的特定地点,被当做注释。(见注释讲解)123a = """这是一个三引号。包含了三个双引号。"""print(a)输出结果:D:/PythonProject/hello.py 这是一个三引号。 包含了三个双引号。2、转义符 '\'反斜杠可以用来转义,使用r可以让反斜杠不发生转义。。 如 r"this is a line with \n" 则\n会显示,并不是换行。这里的 r 指 raw,即 raw string六、Python注释注释是指用来在代码中进行标注的信息,是不会被系统处理或显示的。Python的注释有2种方式:1、单行注释#在一段代码或描述前加上井号(#) ,如:12a = 1+1 #我是一段注释print(a)输出结果:D:/PythonProject/hello.py 22、多行注释’’’用三引号(""" """)或(''' ''')来对多行代码或描述进行注释,如:12345a = 1+1'''我是多行注释这是第二行这是第三行'''print(a)输出结果:D:/PythonProject/hello.py 2七、Python空行与其他语言不同的还有,python采用空一行的方式,来表示多个函数、多个方法、或类和函数的入口。空行的作用在于区分两段不同功能或定义的代码,便于日后代码的维护。因此:空行也是程序代码的一部分。八、Python用户输入下面的代码执行后就会等待用户输入,如按回车键后,执行就会结束:12input("按下 enter 键退出,其他任意键显示...\n")九、Python一行多段代码如果想在同一行中编写多段代码,可以使用分号(;)来表示,如下:1x = 'abc'; print(x)输出结果:D:/PythonProject/hello.py abc Python可以用分号“;”在同一行编写多条语句,执行后会当作多行输出,如:123>>> print ('hello'); print ('world');12hellorunoob十、多行语句Python 通常是一行写完一条语句,但如果语句很长,我们可以使用反斜杠(\)来实现多行语句,例如:123total = item_one + \ item_two + \ item_three在 [], {}, 或 () 中的多行语句,不需要使用反斜杠(\),例如:1total = ['item_one', 'item_two', 'item_three', 'item_four', 'item_five']十一、三元表达式语法:条件成立时的返回值 if 条件 else 条件不成立时的返回值1234x = 10y = 20 print(x if x > y else y) # 20十二、Python代码组缩进相同的一组语句构成一个代码块,我们称之代码组。像if、while、def等这样的复合语句,首行以关键字开始,以冒号( : )结束,该行之后的一行或多行代码构成代码组,如:123456if a: xxxxx elif b: xxxxx else : xxxxx十三、import 与 from...import在 python 用 import 或者 from...import 来导入相应的模块。将整个模块(somemodule)导入,格式为: import somemodule从某个模块中导入某个函数,格式为: from somemodule import somefunction从某个模块中导入多个函数,格式为: from somemodule import firstfunc, secondfunc, thirdfunc将某个模块中的全部函数导入,格式为: from somemodule import *导入 sys 模块:123456import sysprint('================Python import mode==========================')print ('命令行参数为:')for i in sys.argv: print (i)print ('\n python 路径为',sys.path)导入 sys 模块的 argv,path 成员:1234from sys import argv,path # 导入特定的成员 print('================python from import===================================')print('path:',path) # 因为已经导入path成员,所以此处引用时不需要加sys.path十四、Python 调试方法1、print123print('here')# 可以发现某段逻辑是否执行# 打印出变量的内容2、assert12assert false, 'blabla'# 如果条件不成立,则打印出 'blabla' 并抛出AssertionError异常3、debugger可以通过 pdb、IDE 等工具进行调试。调试的具体方法这里不展开。Python 中有两个内置方法在这里也很有帮助:locals: 执行 locals() 之后, 返回一个字典, 包含(current scope)当前范围下的局部变量。globals: 执行 globals() 之后, 返回一个字典, 包含(current scope)当前范围下的全局变量。
-
time和datetime是Python中常用的两个时间模块,本文将通过示例详细为大家讲讲二者的使用方法,感兴趣的小伙伴可以跟随小编一起学习学习目录time时间模块time -- 获取本地时间戳localtime -- 获取本地时间元组(UTC)gmtime -- 获取时间元组(GMT)mktime -- 时间元组获取时间戳ctime -- 获取时间字符串asctime -- 时间元组获取时间字符串strftime -- 格式化时间strptime -- 格式化时间sleep -- 时间睡眠perf_counter -- 时间计时模拟进度条程序计时时间转换示意图datetime时间模块date类time类datetime类timedelta类time时间模块import timetime -- 获取本地时间戳时间戳又被称之为是Unix时间戳,原本是在Unix系统中的计时工具。它的含义是从1970年1月1日(UTC/GMT的午夜)开始所经过的秒数,不考虑闰秒。UNIX时间戳的 0 按照ISO 8601规范为 :1970-01-01T00:00:00Z。比如:时间戳 60 表示 1970-01-01T00:01:00Z时间戳 120 表示 1970-01-01T00:02:00Z时间戳 3600 表示 1970-01-01T01:00:00Z小知识:最开始的时候,时间戳的开始年份是1971年,那个时候Unix系统和C语言刚刚诞生,所以时间戳0也就是Unix系统和C语言的生日。那时候的时间位数只有32位,而且每秒中有60个数字,发现只要两年多的时间时间戳就能完成一个轮回,十分的不方便!所以后来的一系列改革,将时间戳的数值改为每秒1个数字,还有一些新的系统可以将时间戳的位数增大,可以让时间戳的轮回扩展到一百多年,再后来为了方便人们记忆,将时间戳的起始年份定位1970年整。1234import time stamp_time = time.time()print(stamp_time) # 1635768368.2838552localtime -- 获取本地时间元组(UTC)参数为时间戳,默认为本地时间戳,获取时间元组。时间元组是python中的一个特殊的数据类型type: time.struct_time,但是它和tuple的特性是相同的。12345678910111213141516171819202122import time # 时间元组中的值分别表示: # tm_year: 年 # tm_mon: 月 # tm_mday: 日 # tm_hour: 时 # tm_min: 分 # tm_sec: 秒 # tm_wday: 周几(0表示星期一) # tm_yday: 一年中的第几天(从1开始) # tm_isdst: 夏令标识(1夏令时、0非夏令时、-1未知) # 默认当前时间time_tuple = time.localtime()print(time_tuple)# time.struct_time(tm_year=2021, tm_mon=11, tm_mday=1, tm_hour=20, tm_min=7, tm_sec=50, tm_wday=0, tm_yday=305, tm_isdst=0) # 指定时间戳time_tuple = time.localtime(3600)print(time_tuple)# time.struct_time(tm_year=1970, tm_mon=1, tm_mday=1, tm_hour=9, tm_min=0, tm_sec=0, tm_wday=3, tm_yday=1, tm_isdst=0)有大问题啦!!!时间戳的起始时间是1970-1-1 0:0:0, 这个时候的时间戳是0,那么时间戳3600就是整整一个小时之后,那么时间就应该是1970-1-1 0:1:0 才对的呀!怎么上面的3600确实9点钟了呢?怎么起始时间变成了8点了呢?然后你发现你在中国,时间是北京时间,北京在东八区时区,嘶,怎么正好也是个八?是这样的,按照道理来说的话全世界任何一个地方的时间戳所代表的时间都应该是一样的,而且时间戳的起始时间确实是 1970-1-1 0:0:0 ,但是这个时间是位于英国的一个叫做格林威治的小镇的,格林威治有一个天文台叫做皇家格林尼治天文台,后来国际上将这个地方的经线作为本初子午线,作为时间计算时间和地理精度的起点。那么,有时区的存在打破了这个可能,我们在中国,所有的设备都是按照中国的时区编码的,中国位于东八区,在时间上比英国快八个小时,所以我们中国的本地时间戳就是 1970-1-1 8:00:00。gmtime -- 获取时间元组(GMT)在不知道这个函数的时候,我就很好奇为什么localtime的初始时间比格林威治时间要快8小时,现在就明白了:函数描述gmtime获取时间元组(GMT格林威治时间)localtime获取时间元组(UTC协调世界时)mktime -- 时间元组获取时间戳注意:参数必须是时间元组time.struct_time 或者元组 tuple 类型;元组中的元素一个也不能少,必须九个元素都存在;得到的时间戳只收到前六个值的影响,即:年月日时分秒;时间元组中的时间表示,最小时间不能低于当地的最小时间戳;时间元组中的时间表示,单位可以超出原本的范围,比如秒满60进1,我们将秒写成100,系统也不会报错,但是时间上会自动的将多出的时间进位。但是数字也不能过大,因为数据类型的大小是有极限的。mktime返回的数值是浮点型的,但是精度只能到1;123456import time # 在中国的最小时间单位tst = (1970, 1, 1, 8, 0, 0, 0, 0, 0)time_stamp = time.mktime(tst)print(time_stamp) # 0.0ctime -- 获取时间字符串参数默认为本地时间戳,获取的数据类型是 str,这个时间字符串不像时间元组是一个单独的数据类型。12345678910111213import time # 时间字符串中的含义是: # Mon Nov 1 21:34:39 2021 # 星期 月 日 时 分 秒 年 # 默认为本地时间戳time_char = time.ctime()print(time_char) # Mon Nov 1 21:34:39 2021 # 指定时间戳time_char = time.ctime(0)print(time_char) # Thu Jan 1 08:00:00 1970asctime -- 时间元组获取时间字符串注意,asctime有弊端,看下例:123456789import time tst = (1970, 1, 1, 8, 24, 61, 1, 0, 0)time_char = time.asctime(tst)print(time_char) # Tue Jan 1 08:24:61 1970 tst = (1970, 1, 1, 8, 24, 61, 2, 0, 0)time_char = time.asctime(tst)print(time_char) # Tue Jan 1 08:24:61 1970看上面的例子,时间元组变成时间字符串的时候,会将星期的数据也读取到,但是却不会分辨数据是否正确,所以asctime并不常用。如果要将一个不确定正确性的时间元组变成时间字符串的话,先通过 mktime 获取时间戳(mktime可以分辨出正确的时间信息),然后在将时间戳通过 ctime 变成时间字符串。strftime -- 格式化时间格式化时间,按照指定的格式(一段格式化字符串,就像字符串的格式化一样)将时间元组变成时间字符串。我们先来学习一下时间占位符的含义是什么:注意!!!这些占位符的大小写的含义是不同的:占位符含义%Y以十进制数字表示以世纪为单位的年份(四位数)%y以十进制数字表示年份(两位数)%m以十进制数字表示月份%D以月/日/年(两位数)的格式表示年月日%d以十进制数字表示日期%H以十进制数字表示二十四小时制的时%M以十进制数字表示分钟%S以十进制数字表示秒%z与UTC的时区偏移%a区域设置的缩写工作日名称%A区域设置的完整工作日名称%b区域设置的缩写月份名称%B区域设置的完整月份名称%c语言环境的适当日期和时间表示%I以十进制数表示十二小时制的时(大写 ‘爱’)%p语言环境的等效值:AM 或者 PM现在根据使用时间占位符用字符串格式化将时间元组变成字符串。123456789101112import time # 注意,如果格式化字符串中出现中文字符,只能在linux系统下运行,windows下不能解析,直接报错。 tst = (1970, 1, 1, 8, 0, 0, 0, 0, 0)time_tuple = time.strftime('%Y-%m-%d-%H-%m-%S',tst)print(time_tuple) # 1970-01-01-08-01-00 # 有中文在windows下报错tst = (1970, 1, 1, 8, 0, 0, 0, 0, 0)time_tuple = time.strftime('%Y-%m哈哈-%d-%H-%m-%S',tst)print(time_tuple) # 1970-01-01-08-01-00strptime -- 格式化时间格式化时间,通过格式化字符串将一个字符串中的时间变成时间元组。12345678import time # 格式化字符串要和原字符串一模一样,只是将需要提出的部分使用占位符替换char = '2000年10月30日一个伟大的中国少年在三晋大地诞生了'format_char = '%Y年%m月%d日一个伟大的中国少年在三晋大地诞生了' tst = time.strptime(char, format_char)print(tst)sleep -- 时间睡眠等待指定秒数的时间:12345import time print('开始睡觉')time.sleep(2)print('睡了两秒钟,神清气爽')perf_counter -- 时间计时用于计算程序运行的时间1234567891011121314151617import time # perf_counter 用于计算程序运行的时间 # 记录开始时间start_time = time.perf_counter() # 程序运行for i in range(10000): pass # 记录时间end_time = time.perf_counter() # windows系统直接拿到第二次的值就可以了,不用减去第一次的值也行print(end_time, '秒') # 0.0003918 秒print(end_time - start_time, '秒') # 0.0003916 秒如果使用多次perf_counter()函数,直接输出其的值是距第一次使用的时间长度:123456789101112131415161718192021import time time1 = time.perf_counter()time.sleep(1)time2 = time.perf_counter()print(time2) time.sleep(2)time3 = time.perf_counter()print(time3) time.sleep(3)time4 = time.perf_counter()print(time4) """结果:1.00025583.00489416.019172"""注意:windows系统下使用perf_counter()函数可以直接输出耗时长度,每次的耗时默认都是距离第一次使用perf_counter()函数的时间长度;如果在linux系统下使用perf_counter()函数则必须要使用第二次的结果减去之前的结果,因为在linux系统中perf_counter()函数的值和time()函数的值都是一样的,那就是返回一个时间戳。使用time.time()计算时间123456789101112131415import time # perf_counter 用于计算程序运行的时间 # 记录开始时间start_time = time.time() # 程序运行for i in range(10000): pass # 记录时间end_time = time.time() print(end_time - start_time, '秒') # 0.001001119613647461 秒耗时短的计时推荐使用pref_counter,耗时长的推荐使用time。模拟进度条123456# 1、定义进度条样式print('[%-50s]' % ('###########'))print('[%-50s]' % ('###################'))print('[%-50s]' % ('###########################'))print('[%-50s]' % ('####################################'))print('[%-50s]' % ('########################################'))12345678910# 2、让进度条动起来import time progress_char = ''for i in range(50): progress_char += '#' time.sleep(0.05) # 延时看起来不是很快 # end使不能换行,\r使进度条不断刷新,保持在同一行显示; print('\r[%-50s]' % (progress_char), end='')print('\n')1234567891011121314151617181920212223242526272829# 3、根据文件的大小调整进度条的进度import time def progress(percent): """控制进度条的显示 参数是下载的百分比,用来控制进度条的进展 """ # 如果百分比超过了1,说明数据已经接受完毕 if percent > 1: percent = 1 # 打印对应的进度条效果 char = '#' * int(percent * 50) print('\r[%-50s]%d%%' % (char, int(percent * 100)), end='') # 已下的大小rec_size = 0 # 下载文件的大小total_size = 102400 # 模拟下载过程while rec_size < total_size: rec_size += 10240 # 下载速度 time.sleep(0.05) # 模拟网络延迟 percent = rec_size / total_size # 计算下载的进度(百分比) # 调用进度条 progress(percent)程序计时在学习了perf_counter计时后,我们知道有很多种方法可以用于计时:1.time函数:返回当前时间戳,使用time函数计时是获取两个节点各自的时间戳,然后计算其之间的差值,即为耗时时长。优点:计算的是真实世界中的时间长度,而且计时本身不消耗计算机资源,计算长时间的程序优势较大;缺点:time函数的时间获取来源于计算机本身的时间,如果在计时途中计算机的时间发生变化,比如人为的调快一小时,那么计时就会比正确的时间慢一个小时的时间。2.perf_counter函数:是time模块中专门用于性能计时的函数,具有高分辨率的时钟,已测量短持续的时间。优点:是专门用于性能计时的函数,精确度高,适合计算耗时短的程序;缺点:专门用于计时的函数,计时本身就会消耗计算机资源,所以计时过长难免会有一定的影响;3.process_time函数:用于评测处理时间,计算内核和用户空间CPU时间之和,这个时间不包含程序阻塞的时间,比如time.sleep()、input()等。优点:专门用于计算程序本身内在的时间消耗,排除外来因素、提升系统本身效率、优化程序使用;1234567891011121314151617181920212223242526272829303132333435import time def loop(): time.sleep(1) input('请输入:') # 这个位置人为数三秒回车执行 num = 10 ** 8 for _ in range(num): pass time.sleep(1) # time.timestart_time = time.time()loop()end_time = time.time()print(start_time) # 1640270620.4077902print(end_time) # 1640270628.1165576print(end_time - start_time) # 7.708767414093018 # time.perf_counterstart_time = time.perf_counter()loop()end_time = time.perf_counter()print(start_time) # 3e-07print(end_time) # 7.823952print(end_time - start_time) # 7.8239517 # time.process_timestart_time = time.process_time()loop()end_time = time.process_time()print(start_time) # 3.234375print(end_time) # 4.8125print(end_time - start_time) # 1.578125除此之外,python3.7之后,新增了精确到纳秒的函数:time.time_ns()time.perf_counter_ns()time.process_time_ns()还有标准库timeit用于程序的性能计时。datetime时间模块import datatimedatatime模块重新封装了time模块,提供更多的接口。date类date类专门用于描述日期,实例化对象时必须填入参数,分别表示:年、月、日,返回datetime.date对象。datetime.date(year, month, day)123456789101112from datetime import date date_o = date(2022, 3, 1) print(date_o)print(type(date_o)) """结果:2022-03-01<class 'datetime.date'>"""常用属性属性作用yeardate对象表示的具体年份(实例化对象调用达到效果);monthdate对象表示的具体月份(实例化对象调用达到效果);daydate对象表示的具体日(实例化对象调用达到效果);maxdate类能够表示的最大日期;mindate类能够表示的最小日期;resolutiondate类能够表示的最小单位;常用方法注意,以下方法如果可以返回新的对象,使用对象调用时,返回新的对象,原对象不变;如果根据对象值返回对应的值,则使用类调用达不到目标效果;方法作用today()返回本地日期对象;fromtimestamp(time_stamp)给定时间戳返回日期对象;replace(y, m, d)给定年月日返回日期对象;timetuple()返回本地当前时间元组time.struct_time对象;weekday()返回星期序号,星期一返回0;isoweekday()返回星期序号,星期一返回1;isocalendar()返回元组,表示日期的年份、第几周、第几周之后的第几天;isoformat()返回时间字符串;strftime()格式化日期,参考time.strftime();time类time类是datetime模块中专门用于描述时间的类,四个参数:hour、minute、second、microsecond默认都为0。datetime.time(hour=0, minute=0, second=0, microsecond=0)123456789101112from datetime import time time_0 = time() print(time_0)print(type(time_0)) """结果:00:00:00<class 'datetime.time'>"""time的属性和date类的属性方法基本相同,可以参考使用;datetime类相同于date和time两个类的结合,使用基本相同;timedelta类timedelta类用于时间运算,类的参数有datetime模块支持的所有时间单位,使用其它的时间和日期对象可以和timedelta对象进行时间加减运算,注意在实例化时使用关键字传参;123456789101112131415161718192021from datetime import datetimefrom datetime import timedelta # 日期对象datetime_o = datetime(2000, 10, 30, 14, 40, 6)print(datetime_o) # ## 假设我们要计算这个时间5天4小时23分6秒之后的时间 # 实例化 5天4小时23分6秒 的timedelta对象timedelta_o = timedelta(days=5, hours=4, minutes=23, seconds=6) # 将时间对象和timedelta对象相加datetime_o += timedelta_oprint(datetime_o) """结果:2000-10-30 14:40:062000-11-04 19:03:12"""
-
目录前言一、请求接口的基本系统参数解析二、具体参数的代码实现总结提示:嗨咯,大家好,今天又来更新了 本章要和大家分享的是关于美团接口的实现方式以及部分代码的展示。前言首先我们去对接一个接口时首先要懂它的接口规则,也就是要读懂他的官方文档 地址如下:https://open-shangou.meituan.com/home/doc/bulkPurchasing/37一、请求接口的基本系统参数解析解析:时间戳(timestamp)获取当前的时间转化为一串数字app_id 是美团给的官方id这个没什么好说的sig 这个值是根据一系列的参数和 美团Secret拼接 通过mod5加密然后得到的一个字符串。具体 计算签名的方法再看看官方文档:美团闪购开放平台 这几个系统级参数都是每次必填的二、具体参数的代码实现1.timestamp(时间戳)123def get_tamp(): # 获取当前的时间戳 t = time.time() return int(t)2.计算sig签名代码如下(示例):12345678910111213141516#这个方法可以直接将传入的参数拼接成加密前的字符串def param_sort(param_dict): #传入字典,返回生成sig的字符串 keys_list = sorted(param_dict.keys()) rb_str = '' for k in keys_list: key_value = k + '=' + str(param_dict[k]) rb_str = rb_str + key_value + "&" # rb_str = rb_str[0:-1] #不保留字符串末尾的& return rb_str[0:-1]#通过前面的字符串 加密出sigdef sig_mod5(sig_url): #将字符串传入进行加密 m = hashlib.md5() m.update(sig_url.encode('utf8')) sig = m.hexdigest() return sig3.获取一个时间段的订单号下面就浅浅的演示一下吧1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950515253def param_sort(param_dict): #传入字典,返回生成sig的字符串 keys_list = sorted(param_dict.keys()) rb_str = '' for k in keys_list: key_value = k + '=' + str(param_dict[k]) rb_str = rb_str + key_value + "&" # rb_str = rb_str[0:-1] #不保留字符串末尾的& return rb_str[0:-1] def sig_mod5(sig_url): m = hashlib.md5() m.update(sig_url.encode('utf8')) sig = m.hexdigest() return sig def get_tamp(): # 获取当前的时间戳 t = time.time() return int(t) def req_get_result(api_url, api_data): # get方法请求函数 req_get = requests.get(api_url, api_data) result = req_get.json() return result def req_post_result(api_url, api_data): # post方法请求函数 req_post = requests.post(api_url, data=api_data) result = req_post.json() return result def 获取一个时间段的订单号(date_time, day_seq_start,day_seq_end,mendian): # 今日流水单号,门店编号 sing_data = { 'app_id': 2005,#演示app_id并非真的 'app_poi_code': mendian, #门店编号 'timestamp': get_tamp(), # 时间戳 'date_time': date_time, #下面几个参数是应用级参数 'day_seq_start': day_seq_start, 'day_seq_end': day_seq_end } # 请求地址 url = 'https://waimaiopen.meituan.com/api/v1/ecommerce/order/getOrderIdByDaySeq' # 美团Secret secret = '6322e9b60722123cd196729a9481223b' #演示secret 并非真的 # 拼接sig前的字符串 befsig = url + '?' + param_sort(sing_data) + secret #把参数拼接成美团规定的格式 sig = sig_mod5(befsig) #然后对拼接字符串进行加密 urls = url + '?' + param_sort(sing_data) + '&sig=' + sig #加密之后再次拼接请求地址 print(urls) req_get = requests.get(urls) #发起请求 result = req_get.json() return result['data'] #返回结果总结总的来说实现的方式还是比较简单,可能难点就是要去读懂他们的文档,了解他们规则,今天的分享就到此为啦!!!
-
pip提供我们各色各样的软件(第三方库),而这些第三方库又可以给我们实现各种各样不同的功能,科学计算、画图、操作文件、聊天……我们可以通过Cmd终端、Pycharm、Jupyter三种平台使用pip安装这些第三方库。官方Python 第三方库软件包地址:PyPI · Python 包索引Anaconda,Conda,Pip的关系Anaconda是一个python发行版。软件发行版是在系统上提前编译和配置好的软件包集合, 装好了后就可以直接用。Conda是一个包管理器。包管理器是自动化软件安装,更新,卸载的一种工具。Conda,有命令”conda install”, “conda update”, “conda remove”, 所以很明显, conda是包管理器。Conda和Anaconda名字相似,但没有必然关系, 你可以不安装Anaconda的同时, 使用Conda安装和管理软件。Conda是一个通用的包管理器,当初设计来管理任何语言的包。所以用来管理python包当然也是绰绰有余。Conda 和 pip 目标并不相同, 只有小部分子集有交集有竞争关系:比如python包的安装和环境隔离。pip可以允许你在任何环境中安装python包,而conda允许你在conda环境中安装任何语言包(包括c语言或者python)。一、Pip介绍pip是Python包管理工具,可以通过命令行的方式安装、卸载、更新三方库,先来看看具体有哪些指令:1、常用指令pip help / pip -h:查看pip的所有指令信息pip install 库名:安装第三发库pip install django==1.10.0:后面可以用==号指定包的版本pip --default-timeout=100 install -U django==1.10.0:万能安装第三方库,增加延迟,添加管理员权限安装pip install –-upgrade/ -U 库名:更新第三方库pip uninstall 库名:卸载第三方库pip list / pip freeze:列举当前项目路径安装的所有的包pip show:查看已经安装的包的信息,如pip show django查看django的具体信息,pip show --files django查看django的所有文件pip freeze > requirements.txt:将项目目录下安装的所有包信息输出到requirements.txt文件中。pip freeze -r requirements.txt:读取requirements.txt文件中的包信息,安装所有包。这样先将项目的三方包版本信息保存在requirements.txt文件中,切换到不同的环境,还可以安装该文件的所有三方包。2、pip更新:pip可以自己更新自己pip install -U pip3、基本使用(以django包为例)1、安装django软件pip install django #最新版本2、安装具体版本软件pip install django==1.11.8 # 指定版本pip install 'django>=1.11.0' # 大于某个版本3、查看具体安装文件pip show --files django4、列出软件包清单pip list5、查看哪些软件需要更新pip list --outdated6、升级软件包pip install --upgrade django7、卸载软件包pip uninstall django8、Requirements文件安装依赖软件Requirements文件 一般记录的是依赖软件列表,通过pip可以一次性安装依赖软件包:pip freeze > requirements.txtpip install -r requirements.txt9、查看软件包信息pip show django10、搜索pip search django
-
什么是 AOP装饰器函数装饰器类装饰器1、函数装饰函数2、类装饰函数3、函数装饰类4、类装饰类什么是 AOPAOP,就是面向切面编程,简单的说,就是动态地将代码切入到类的指定方法、指定位置上的编程思想就是面向切面的编程。我们管切入到指定类指定方法的代码片段称为切面,而切入到哪些类、哪些方法则叫切入点。这样我们就可以把几个类共有的代码,抽取到一个切片中,等到需要时再切入对象中去,从而改变其原有的行为。这种思想,可以使原有代码逻辑更清晰,对原有代码毫无入侵性,常用于像权限管理,日志记录,事物管理等等。而 Python 中的装饰器就是很著名的设计,常用于有切面需求的场景。类如,Django 中就大量使用装饰器去完成一下切面需求,如权限控制,内容过滤,请求管理等等。装饰器Python 装饰器(fuctional decorators)就是用于拓展原来函数功能的一种函数,目的是在不改变原函数名或类名的情况下,给函数增加新的功能。下面就跟我一起详细的了解下装饰器是如何工作的。首先,要明确一个概念:Python 中万物皆对象,函数也是是对象!所以,一个函数作为对象,可以在另一个函数中定义。看下面示例:12345678910def a(): def b(): print("I'm b") b() c = b return cd = a()d()b()c()输出结果为:I'm bI'm b抛出 NameError: name 'b' is not defined 错误抛出 NameError: name 'c' is not defined 错误从上可以看出,由于函数是对象,所以:可以赋值给变量可以在另一个函数中定义然后,return 可以返回一个函数对象。这个函数对象是在另一个函数中定义的。由于作用域不同,所以只有 return 返回的函数可以调用,在函数 a 中定义和赋值的函数 b 和 c 在外部作用域是无法调用的。这意味着一个功能可以 return 另一个功能。除了可以作为对象返回外,函数对象还可以作为参数传递给另一个函数:123456def a(): print("I'm a")def b(func): print("I'm b") func()b(a) 输出结果:I'm bI'm aOK,现在,基于函数的这些特性,我们就可以创建一个装饰器,用来在不改变原函数的情况下,实现功能。函数装饰器比如,我们要在函数执行前和执行后分别执行一些别的操作,那么根据上面函数可以作为参数传递,我们可以这样实现,看下面示例:1234567def a(): print("I'm a")def b(func): print('在函数执行前,做一些操作') func() print("在函数执行后,做一些操作")b(a)输出结果:在函数执行前,做一些操作I'm a在函数执行后,做一些操作但是这样的话,原函数就变成了另一个函数,每加一个功能,就要在外面包一层新的函数,这样原来调用的地方,就会需要全部修改,这明显不方便,就会想,有没有办法可以让函数的操作改变,但是名称不改变,还是作为原函数呢。看下面示例:123456789101112def a(): print("I'm a") def c(func): def b(): print('在函数执行前,做一些操作') func() print("在函数执行后,做一些操作") return b a = c(a)a()输出结果:在函数执行前,做一些操作I'm a在函数执行后,做一些操作如上,我们可以将函数再包一层,将新的函数 b,作为对象返回。这样通过函数 c,将 a 改变并重新赋值给 a,这样就实现了改变函数 a,并同样使用函数 a 来调用。但是这样写起来非常不方便,因为需要重新赋值,所以在 Python 中,可以通过 @ 来实现,将函数作为参数传递。看下示例:12345678910def c(func): def b(): print('在函数执行前,做一些操作') func() print("在函数执行后,做一些操作") return b@cdef a(): print("I'm a")a() 输出结果:在函数执行前,做一些操作I'm a在函数执行后,做一些操作如上,通过 @c,就实现了将函数 a 作为参数,传入 c,并将返回的函数重新作为函数 a。这 c 也就是一个简单的函数装饰器。且如果函数是有返回值的,那么改变后的函数也需要有返回值,如下所以:123456789101112def c(func): def b(): print('在函数执行前,做一些操作') result = func() print("在函数执行后,做一些操作") return result return b@cdef a(): print("函数执行中。。。") return "I'm a"print(a())输出结果:在函数执行前,做一些操作函数执行中。。。在函数执行后,做一些操作I'm a如上所示:通过将返回值进行传递,就可以实现函数执行前后的操作。但是你会发现一个问题,就是为什么输出 I'm a 会在最后才打印出来?因为 I'm a 是返回的结果,而实际上函数是 print("在函数执行后,做一些操作") 这一操作前运行的,只是先将返回的结果给到了 result,然后 result 传递出来,最后由最下方的 print(a()) 打印了出来。那如何函数 a 带参数怎么办呢?很简单,函数 a 带参数,那么我们返回的函数也同样要带参数就好啦。看下面示例:123456789101112def c(func): def b(name, age): print('在函数执行前,做一些操作') result = func(name, age) print("在函数执行后,做一些操作") return result return b@cdef a(name, age): print("函数执行中。。。") return "我是 {}, 今年{}岁 ".format(name, age)print(a('Amos', 24))输出结果:在函数执行前,做一些操作函数执行中。。。在函数执行后,做一些操作我是 Amos, 今年24岁 但是又有问题了,我写一个装饰器 c,需要装饰多个不同的函数,这些函数的参数各不相同,那么怎么办呢?简单,用 *args 和 **kwargs 来表示所有参数即可。如下示例:1234567891011121314151617def c(func): def b(*args, **kwargs): print('在函数执行前,做一些操作') result = func(*args, **kwargs) print("在函数执行后,做一些操作") return result return b@cdef a(name, age): print('函数执行中。。。') return "我是 {}, 今年{}岁 ".format(name, age)@cdef d(sex, height): print('函数执行中。。。') return '性别:{},身高:{}'.format(sex, height)print(a('Amos', 24))print(d('男', 175))输出结果:在函数执行前,做一些操作函数执行中。。。在函数执行后,做一些操作我是 Amos, 今年24岁 在函数执行前,做一些操作函数执行中。。。在函数执行后,做一些操作性别:男,身高:175如上就解决了参数的问题,哇,这么好用。那是不是这样就没有问题了?并不是!经过装饰器装饰后的函数,实际上已经变成了装饰器函数 c 中定义的函数 b,所以函数的元数据则全部改变了!如下示例:123456789101112def c(func): def b(*args, **kwargs): print('在函数执行前,做一些操作') result = func(*args, **kwargs) print("在函数执行后,做一些操作") return result return b@cdef a(name, age): print('函数执行中。。。') return "我是 {}, 今年{}岁 ".format(name, age)print(a.__name__)输出结果:b会发现函数实际上是函数 b 了,这就有问题了,那么该怎么解决呢,有人就会想到,可以在装饰器函数中先把原函数的元数据保存下来,在最后再讲 b 函数的元数据改为原函数的,再返回 b。这样的确是可以的!但我们不这样用,为什么?因为 Python 早就想到这个问题啦,所以给我们提供了一个内置的方法,来自动实现原数据的保存和替换工作。哈哈,这样就不同我们自己动手啦!看下面示例:1234567891011121314from functools import wrapsdef c(func): @wraps(func) def b(*args, **kwargs): print('在函数执行前,做一些操作') result = func(*args, **kwargs) print("在函数执行后,做一些操作") return result return b@cdef a(name, age): print('函数执行中。。。') return "我是 {}, 今年{}岁 ".format(name, age)print(a.__name__)输出结果:a使用内置的 wraps 装饰器,将原函数作为装饰器参数,实现函数原数据的保留替换功能。耶!装饰器还可以带参数啊,你看上面 wraps 装饰器就传入了参数。哈哈,是的,装饰器还可以带参数,那怎么实现呢?看下面示例:123456789101112131415161718from functools import wrapsdef d(name): def c(func): @wraps(func) def b(*args, **kwargs): print('装饰器传入参数为:{}'.format(name)) print('在函数执行前,做一些操作') result = func(*args, **kwargs) print("在函数执行后,做一些操作") return result return b return c@d(name='我是装饰器参数')def a(name, age): print('函数执行中。。。') return "我是 {}, 今年{}岁 ".format(name, age) print(a('Amos', 24))输出结果:装饰器传入参数为:我是装饰器参数在函数执行前,做一些操作函数执行中。。。在函数执行后,做一些操作我是 Amos, 今年24岁 如上所示,很简单,只需要在原本的装饰器之上,再包一层,相当于先接收装饰器参数,然后返回一个不带参数的装饰器,然后再将函数传入,最后返回变化后的函数。这样就可以实现很多功能了,这样可以根据传给装饰器的参数不同,来分别实现不同的功能。另外,可能会有人问, 可以在同一个函数上,使用多个装饰器吗?答案是:可以!看下面示例:1234567891011121314151617181920212223242526272829303132from functools import wrapsdef d(name): def c(func): @wraps(func) def b(*args, **kwargs): print('装饰器传入参数为:{}'.format(name)) print('我是装饰器d: 在函数执行前,做一些操作') result = func(*args, **kwargs) print("我是装饰器d: 在函数执行后,做一些操作") return result return b return cdef e(name): def c(func): @wraps(func) def b(*args, **kwargs): print('装饰器传入参数为:{}'.format(name)) print('我是装饰器e: 在函数执行前,做一些操作') result = func(*args, **kwargs) print("我是装饰器e: 在函数执行后,做一些操作") return result return b return c@e(name='我是装饰器e')@d(name='我是装饰器d')def func_a(name, age): print('函数执行中。。。') return "我是 {}, 今年{}岁 ".format(name, age) print(func_a('Amos', 24))行后,做一些操作我是 Amos, 今年24岁 输出结果:装饰器传入参数为:我是装饰器e我是装饰器e: 在函数执行前,做一些操作装饰器传入参数为:我是装饰器d我是装饰器d: 在函数执行前,做一些操作函数执行中。。。我是装饰器d: 在函数执行后,做一些操作我是装饰器e: 在函数执如上所示,当两个装饰器同时使用时,可以想象成洋葱,最下层的装饰器先包装一层,然后一直到最上层装饰器,完成多层的包装。然后执行时,就像切洋葱,从最外层开始,只执行到被装饰函数运行时,就到了下一层,下一层又执行到函数运行时到下一层,一直到执行了被装饰函数后,就像切到了洋葱的中间,然后再往下,依次从最内层开始,依次执行到最外层。示例:当一个函数 a 被 b,c,d 三个装饰器装饰时,执行顺序如下图所示,多个同理。12345@d@c@bdef a(): pass类装饰器在函数装饰器方面,很多人搞不清楚,是因为装饰器可以用函数实现(像上面),也可以用类实现。因为函数和类都是对象,同样可以作为被装饰的对象,所以根据被装饰的对象不同,一同有下面四种情况:函数装饰函数类装饰函数函数装饰类类装饰类下面我们依次来说明一下这四种情况的使用。1、函数装饰函数1234567891011121314151617181920from functools import wrapsdef d(name): def c(func): @wraps(func) def b(*args, **kwargs): print('装饰器传入参数为:{}'.format(name)) print('在函数执行前,做一些操作') result = func(*args, **kwargs) print("在函数执行后,做一些操作") return result return b return c@d(name='我是装饰器参数')def a(name, age): print('函数执行中。。。') return "我是 {}, 今年{}岁 ".format(name, age) print(a.__class__)# 输出结果:<class 'function'>此为最常见的装饰器,用于装饰函数,返回的是一个函数。2、类装饰函数也就是通过类来实现装饰器的功能而已。通过类的 __call__ 方法实现:1234567891011121314151617181920from functools import wrapsclass D(object): def __init__(self, name): self._name = name def __call__(self, func): @wraps(func) def wrapper(*args, **kwargs): print('装饰器传入参数为:{}'.format(self._name)) print('在函数执行前,做一些操作') result = func(*args, **kwargs) print("在函数执行后,做一些操作") return result return wrapper@D(name='我是装饰器参数')def a(name, age): print('函数执行中。。。') return "我是 {}, 今年{}岁 ".format(name, age)print(a.__class__)# 输出结果:<class 'function'>以上所示,只是将用函数定义的装饰器改为使用类来实现而已。还是用于装饰函数,因为在类的 __call__ 中,最后返回的还是一个函数。此为带装饰器参数的装饰器实现方法,是通过 __call__ 方法。若装饰器不带参数,则可以将 __init__ 方法去掉,但是在使用装饰器时,需要 @D() 这样使用,如下:123456789101112131415161718from functools import wrapsclass D(object): def __call__(self, func): @wraps(func) def wrapper(*args, **kwargs): print('在函数执行前,做一些操作') result = func(*args, **kwargs) print("在函数执行后,做一些操作") return result return wrapper@D()def a(name, age): print('函数执行中。。。') return "我是 {}, 今年{}岁 ".format(name, age) print(a.__class__)# 输出结果:<class 'function'>如上是比较方便简答的,使用类定义函数装饰器,且返回对象为函数,元数据保留。3、函数装饰类下面重点来啦,我们常见的装饰器都是用于装饰函数的,返回的对象也是一个函数,而要装饰类,那么返回的对象就要是类,且类的元数据等也要保留。不怕丢脸的说,目前我还不知道怎么实现完美的类装饰器,在装饰类的时候,一般有两种方法:返回一个函数,实现类在创建实例的前后执行操作,并正常返回此类的实例。但是这样经过装饰器的类就属于函数了,其无法继承,但可以正常调用创建实例。如下:123456789101112131415161718192021222324252627282930from functools import wrapsdef d(name): def c(cls): @wraps(cls) def b(*args, **kwargs): print('装饰器传入参数为:{}'.format(name)) print('在类初始化前,做一些操作') instance = cls(*args, **kwargs) print("在类初始化后,做一些操作") return instance return b return c@d(name='我是装饰器参数')class A(object): def __init__(self, name, age): self.name = name self.age = age print('类初始化实例,{} {}'.format(self.name, self.age)) a = A('Amos', 24)print(a.__class__)print(A.__class__) # 输出结果:装饰器传入参数为:我是装饰器参数在类初始化前,做一些操作类初始化实例,Amos 24在类初始化后,做一些操作<class '__main__.A'><class 'function'>如上所示,就是第一种方法。4、类装饰类接上文,返回一个类,实现类在创建实例的前后执行操作,但类已经改变了,创建的实例也已经不是原本类的实例了。看下面示例:1234567891011121314151617181920212223242526272829303132def desc(name): def decorator(aClass): class Wrapper(object): def __init__(self, *args, **kwargs): print('装饰器传入参数为:{}'.format(name)) print('在类初始化前,做一些操作') self.wrapped = aClass(*args, **kwargs) print("在类初始化后,做一些操作") def __getattr__(self, name): print('Getting the {} of {}'.format(name, self.wrapped)) return getattr(self.wrapped, name) def __setattr__(self, key, value): if key == 'wrapped': # 这里捕捉对wrapped的赋值 self.__dict__[key] = value else: setattr(self.wrapped, key, value) return Wrapper return decorator@desc(name='我是装饰器参数')class A(object): def __init__(self, name, age): self.name = name self.age = age print('类初始化实例,{} {}'.format(self.name, self.age)) a = A('Amos', 24)print(a.__class__)print(A.__class__)print(A.__name__)输出结果:装饰器传入参数为:我是装饰器参数在类初始化前,做一些操作类初始化实例,Amos 24在类初始化后,做一些操作<class '__main__.desc.<locals>.decorator.<locals>.Wrapper'><class 'type'>Wrapper如上,看到了吗,通过在函数中新定义类,并返回类,这样函数还是类,但是经过装饰器后,类 A 已经变成了类 Wrapper,且生成的实例 a 也是类 Wrapper 的实例,即使通过 __getattr__ 和 __setattr__ 两个方法,使得实例a的属性都是在由类 A 创建的实例 wrapped 的属性,但是类的元数据无法改变。很多内置的方法也就会有问题。我个人是不推荐这种做法的!所以,我推荐在代码中,尽量避免类装饰器的使用,如果要在类中做一些操作,完全可以通过修改类的魔法方法,继承,元类等等方式来实现。如果避免不了,那也请谨慎处理。
-
python区块链实现简版工作量证明 更新时间:2022年05月24日 16:48:41 作者:晓彬_ 这篇文章主要为大家介绍了python区块链实现简版工作量证明详解,有需要的朋友可以借鉴参考下,希望能够有所帮助,祝大家多多进步,早日升职加薪目录说明回顾工作量证明哈希计算Hashcash实现说明本文根据https://github.com/liuchengxu/blockchain-tutorial的内容,用python实现的,但根据个人的理解进行了一些修改,大量引用了原文的内容。文章末尾有"本节完整源码实现地址"。回顾在上一节,我们构造了一个非常简单的数据结构 – 区块,它也是整个区块链数据库的核心。目前所完成的区块链原型,已经可以通过链式关系把区块相互关联起来:每个块都与前一个块相关联。但是,当前实现的区块链有一个巨大的缺陷:向链中加入区块太容易,也太廉价了。而区块链和比特币的其中一个核心就是,要想加入新的区块,必须先完成一些非常困难的工作。在本文,我们将会弥补这个缺陷。工作量证明区块链的一个关键点就是,一个人必须经过一系列困难的工作,才能将数据放入到区块链中。正是由于这种困难的工作,才保证了区块链的安全和一致。此外,完成这个工作的人,也会获得相应奖励(这也就是通过挖矿获得币)。这个机制与生活现象非常类似:一个人必须通过努力工作,才能够获得回报或者奖励,用以支撑他们的生活。在区块链中,是通过网络中的参与者(矿工)不断的工作来支撑起了整个网络。矿工不断地向区块链中加入新块,然后获得相应的奖励。在这种机制的作用下,新生成的区块能够被安全地加入到区块链中,它维护了整个区块链数据库的稳定性。值得注意的是,完成了这个工作的人必须要证明这一点,即他必须要证明他的确完成了这些工作。整个 “努力工作并进行证明” 的机制,就叫做工作量证明(proof-of-work)。要想完成工作非常地不容易,因为这需要大量的计算能力:即便是高性能计算机,也无法在短时间内快速完成。另外,这个工作的困难度会随着时间不断增长,以保持每 10 分钟出 1 个新块的速度。在比特币中,这个工作就是找到一个块的哈希,同时这个哈希满足了一些必要条件。这个哈希,也就充当了证明的角色。因此,寻求证明(寻找有效哈希),就是矿工实际要做的事情。哈希计算获得指定数据的一个哈希值的过程,就叫做哈希计算。一个哈希,就是对所计算数据的一个唯一表示。对于一个哈希函数,输入任意大小的数据,它会输出一个固定大小的哈希值。下面是哈希的几个关键特性:无法从一个哈希值恢复原始数据。也就是说,哈希并不是加密。对于特定的数据,只能有一个哈希,并且这个哈希是唯一的。即使是仅仅改变输入数据中的一个字节,也会导致输出一个完全不同的哈希。本质上哈希是一个摘要算法。哈希函数被广泛用于检测数据的一致性。软件提供者常常在除了提供软件包以外,还会发布校验和。当下载完一个文件以后,你可以用哈希函数对下载好的文件计算一个哈希,并与作者提供的哈希进行比较,以此来保证文件下载的完整性。在区块链中,哈希被用于保证一个块的一致性。哈希算法的输入数据包含了前一个块的哈希,因此使得不太可能(或者,至少很困难)去修改链中的一个块:因为如果一个人想要修改前面一个块的哈希,那么他必须要重新计算这个块以及后面所有块的哈希。Hashcash比特币使用 Hashcash ,一个最初用来防止垃圾邮件的工作量证明算法。它可以被分解为以下步骤:取一些公开的数据(比如,如果是 email 的话,它可以是接收者的邮件地址;在比特币中,它是区块头)给这个公开数据添加一个计数器。计数器默认从 0 开始将 data(数据) 和 counter(计数器) 组合到一起,获得一个哈希检查哈希是否符合一定的条件:如果符合条件,结束如果不符合,增加计数器,重复步骤 3-4因此,这是一个暴力算法:改变计数器,计算新的哈希,检查,增加计数器,计算哈希,检查,如此往复。这也是为什么说它的计算成本很高,因为这一步需要如此反复不断地计算和检查。现在,让我们来仔细看一下一个哈希要满足的必要条件。在原始的 Hashcash 实现中,它的要求是 “一个哈希的前 20 位必须是 0”。在比特币中,这个要求会随着时间而不断变化。因为按照设计,必须保证每 10 分钟生成一个块,而不论计算能力会随着时间增长,或者是会有越来越多的矿工进入网络,所以需要动态调整这个必要条件。为了阐释这一算法,我从前一个例子(“I like donuts”)中取得数据,并且找到了一个前 3 个字节是全是 0 的哈希。实现这里我们实现一个简易的区块链,就不动态调节难度了,使用固定的难度。1234567891011class ProofOfWork(object): """ pow """ _N_BITS = 16 MAX_BITS = 256 MAX_SIZE = sys.maxsize def __init__(self, block, n_bits=_N_BITS): self._n_bits = n_bits self._target_bits = 1 << (self.MAX_BITS - n_bits) self._block = block这里的_n_bits就是难度值。 在比特币中,当一个块被挖出来以后,“n_bits” 代表了区块头里存储的难度,也就是开头有多少个 0。这里的 16 指的是算出来的哈希前 16 位必须是 0,如果用 16 进制表示,就是前 6 位必须是 0,这一点从最后的输出可以看出来。目前我们并不会实现一个动态调整目标的算法,所以将难度定义为一个全局的常量即可。16 其实是一个可以任意取的数字,其目的只是为了有一个目标而已,这个目标占据不到 256 位的内存空间。同时,我们想要有足够的差异性,但是又不至于大的过分,因为差异性越大,就越难找到一个合适的哈希。这里的_target_bits则表示满足要求的最大值,即一个上界,它是由1左移256-n_bits位来的。计算出来的哈希只要满足小于它就满足条件了。接下来我们要准备用于计算哈希的数据:1234567def _prepare_data(self, nonce): data_lst = [str(self._block.block_header.prev_block_hash), str(self._block.block_header.hash_merkle_root), str(self._block.block_header.timestamp), str(self._block.block_header.height), str(nonce)] return utils.encode(''.join(data_lst))nonce就是我们要不断尝试要寻找的值,就是上面 Hashcash 所提到的计数器,它是一个密码学术语。其他数据都是区块头的数据。我们需要把这些数据进行合并作为计算哈希的原数据。寻找nonce的方法:1234567891011121314151617181920def run(self): nonce = 0 found = False hash_hex = None print('Mining a new block') while nonce < self.MAX_SIZE: data = self._prepare_data(nonce) hash_hex = utils.sum256_hex(data) hash_val = int(hash_hex, 16) sys.stdout.write("try nonce == %d hash_hex == %s \r" % (nonce, hash_hex)) if (hash_val < self._target_bits): found = True break nonce += 1 if found: print('Found nonce == %d' % nonce) else: print('Not Found nonce') raise NonceNotFoundError('nonce not found') return nonce, hash_hex为防止溢出,我们要设定一个上线为int64的上限。然后我们不断循环寻找目标值,直到满足难度要求。当然,如果难度设计得过高,有可能寻找不到,所以也需要判断一下。所以我们再循环内做了一下事:1. 准备数据2. 用 SHA-256 对数据进行哈希3. 将哈希转换成一个大整数4. 将这个大整数与目标进行比较然后我们还需要很方便的去检验这个块的难度值是否满足我们的要求:12345678def validate(self): """ validate the block """ data = self._prepare_data(self._block.block_header.nonce) hash_hex = utils.sum256_hex(data) hash_val = int(hash_hex, 16) return hash_val < self._target_bits最后运行以前的main.py,结果如下:12345Mining a new block.........Block(_block_header=BlockHeader(timestamp='1548213145.24', hash_merkle_root='', prev_block_hash='', hash='00008fbcbe3a817641195652d9bad37fa8c974536f152f4bc575b3ead9dc6407', nonce=62489, height=0))Block(_block_header=BlockHeader(timestamp='1548213166.65', hash_merkle_root='', prev_block_hash='00008fbcbe3a817641195652d9bad37fa8c974536f152f4bc575b3ead9dc6407', hash='9e851f78295e7933cd9749f712d1f09f1408dff9bd37cc2f79f1c65d1ab39e2e', nonce=16184, height=1))Block(_block_header=BlockHeader(timestamp='1548213171.15', hash_merkle_root='', prev_block_hash='9e851f78295e7933cd9749f712d1f09f1408dff9bd37cc2f79f1c65d1ab39e2e', hash='f88e7a382dafc50b01c43cbbdbbdfa20ac2bffcf5ddf36b97439ff09203f8c2a', nonce=8286, height=2))可以看到这次我们产生三个块花费了25秒多,比没有工作量证明之前慢了很多(也就是成本高了很多)。参考:[1] proof-of-work[2] 完整源码
-
目录说明引言区块区块头区块链总结说明本文根据https://github.com/liuchengxu/blockchain-tutorial的内容,用python实现的,但根据个人的理解进行了一些修改,大量引用了原文的内容。文章末尾有"本节完整源码实现地址"。引言区块链是 21 世纪最具革命性的技术之一,它仍然处于不断成长的阶段,而且还有很多潜力尚未显现。 本质上,区块链只是一个分布式数据库而已。 不过,使它独一无二的是,区块链是一个公开的数据库,而不是一个私人数据库,也就是说,每个使用它的人都有一个完整或部分的副本。 只有经过其他“数据库管理员”的同意,才能向数据库中添加新的记录。 此外,也正是由于区块链,才使得加密货币和智能合约成为现实。在本系列文章中,我们将实现一个简化版的区块链,并基于它来构建一个简化版的加密货币。区块首先从 “区块” 谈起。在区块链中,真正存储有效信息的是区块(block)。而在比特币中,真正有价值的信息就是交易(transaction)。实际上,交易信息是所有加密货币的价值所在。除此以外,区块还包含了一些技术实现的相关信息,比如版本,当前时间戳和前一个区块的哈希。不过,我们要实现的是一个简化版的区块链,而不是一个像比特币技术规范所描述那样成熟完备的区块链。所以在我们目前的实现中,区块仅包含了部分关键信息,它的数据结构如下:123456789101112class Block(object): """A Block Attributes: _magic_no (int): Magic number _block_header (Block): Header of the previous Block. _transactions (Transaction): transactions of the current Block. """ MAGIC_NO = 0xBCBCBCBC def __init__(self, block_header, transactions): self._magic_no = self.MAGIC_NO self._block_header = block_header self._transactions = transactions字段解释_magic_no魔数_block_header区块头_transactions交易这里的_magic_no, _block_header, _transactions, 也是比特币区块的构成部分,这里我们简化了一部分信息。在真正的比特币中,区块 的数据结构如下:FieldDescriptionSizeMagic novalue always 0xD9B4BEF94 bytesBlocksizenumber of bytes following up to end of block4 bytesBlockheaderconsists of 6 items80 bytesTransaction counterpositive integer VI = VarInt1 - 9 bytestransactionsthe (non empty) list of transactions-many transactions区块头1234567891011121314151617class BlockHeader(object): """ A BlockHeader Attributes: timestamp (str): Creation timestamp of Block prev_block_hash (str): Hash of the previous Block. hash (str): Hash of the current Block. hash_merkle_root(str): Hash of the merkle_root. height (int): Height of Block nonce (int): A 32 bit arbitrary random number that is typically used once. """ def __init__(self, hash_merkle_root, height, pre_block_hash=''): self.timestamp = str(time.time()) self.prev_block_hash = pre_block_hash self.hash = None self.hash_merkle_root = hash_merkle_root self.height = height self.nonce = None字段解释timestamp当前时间戳,也就是区块创建的时间prev_block_hash前一个块的哈希,即父哈希hash当前块头的哈希hash_merkle_root区块存储的交易的merkle树的根哈希我们这里的 timestamp,prev_block_hash, Hash,hash_merkle_root, 在比特币技术规范中属于区块头(block header),区块头是一个单独的数据结构。完整的 比特币的区块头(block header)结构 如下:FieldPurposeUpdated when…Size (Bytes)VersionBlock version numberYou upgrade the software and it specifies a new version4hashPrevBlock256-bit hash of the previous block headerA new block comes in32hashMerkleRoot256-bit hash based on all of the transactions in the blockA transaction is accepted32TimeCurrent timestamp as seconds since 1970-01-01T00:00 UTCEvery few seconds4BitsCurrent target in compact formatThe difficulty is adjusted4Nonce32-bit number (starts at 0)A hash is tried (increments)4我们的简化版的区块头里,hash和hash_merkle_root是需要计算的。hash_merkle_root暂且不管留空,它是由区块中的交易信息生成的merkle树的根哈希。而hash的计算如下:1234567891011def set_hash(self): """ Set hash of the header """ data_list = [str(self.timestamp), str(self.prev_block_hash), str(self.hash_merkle_root), str(self.height), str(self.nonce)] data = ''.join(data_list) self.hash = sum256_hex(data)
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签