-
 【功能模块】HetuEngine【操作步骤&问题现象】1、HetuEngine如何添加mysql类型的数据源2、在MRS的数据源类型中没有mysql这一类型【截图信息】【日志信息】(可选,上传日志内容或者附件)
-
openGauss有类似于MySQL的MGR或PXC结构的多主模式吗?
-
 >摘要:使用索引也很简单,然而, 会使用索引是一回事, 而深入理解索引原理又能恰到好处使用索引又是另一回事。 本文分享自华为云社区[《索引到底能提升多少查询效率?何时该使用索引?一文快速搞懂数据库索引及合理使用它》](https://bbs.huaweicloud.com/blogs/303909?utm_source=zhihu&utm_medium=bbs-ex&utm_campaign=other&utm_content=content),作者: 曲鸟。 # 一、前言 无论是面试、还是日常工作中,或多或少都会使用或者听到别人谈论索引这个技术。 然而很大一部份程序员对索引的了解仅限于到“加索引能使查询变快”这个概念为止。 使用索引也很简单,然而, 会使用索引是一回事, 而深入理解索引原理又能恰到好处使用索引又是另一回事。 这已经是两个相差甚远的技术层级了。 # 二、千万级数据表索引和无索引查询效率对比 现在有一个学生表student,有1000万条数据  未加索引,查询class_id=2的学生信息的耗时:SELECT * FROM student WHERE class_id=2 花费了3.357秒  加上索引,查询class_id=2的学生信息的耗时:SELECT * FROM student WHERE class_id=2 花费了0.017秒  1000万条数据下,两个查询的性能差了近200倍!! 这个差距是特别大的! 难怪需要加索引!!! # 三、什么是索引 网上很多讲解索引的文章对索引的描述是这样的: 索引就像书的目录, 通过书的目录就可以准确的定位到书籍的具体的内容。 这句话概述的非常正确! 但说了跟没说一样,懂的人自然懂!不懂的人感觉懂了,但还是一脸蒙的状态! 其实想要理解索引原理,必须清楚一种数据结构: 平衡树」(非二叉),也就是b tree或者 b+ tree 当然, 有的数据库也使用哈希桶作用索引的数据结构 , 然而, 主流的RDBMS都是把平衡树当做数据表默认的索引数据结构的。 我们平时建表的时候都会为表加上主键, 在某些关系数据库中, 如果建表时不指定主键,数据库会拒绝建表的语句执行。 事实上, 一个加了主键的表,并不能被称之为“表”。一个没加主键的表,它的数据无序的放置在磁盘存储器上,一行一行的排列的很整齐。如果给表上了主键,那么表在磁盘上的存储结构就由整齐排列的结构转变成了树状结构,也就是上面说的“平衡树”结构,换句话说,就是整个表就变成了一个索引。 没错, 再说一遍, 整个表变成了一个索引! 也就是所谓的“聚集索引”。 这就是为什么一个表只能有一个主键, 一个表只能有一个“聚集索引”,因为主键的作用就是把“表”的数据格式转换成“树(索引)”的格式。 未加索引时,之前执行的查询sql会让数据库系统逐行的遍历整张表,对于每一行都要检查其class_id字段是否等于“2”。因为我们要查找所有class_id为“2”的员工,所以当我们发现了一条class_id是“2”的记录后,并不能停止继续查找,因为可能还有class_id等于“2”的其他记录。 这就意味着,对于表中的千万条记录,数据库每一条都要检查。这就是所谓的“全表扫描”( full table scan) 而加上索引的最大作用就是加快查询速度,它能从根本上减少需要扫表的记录/行的数量。 # 四、Mysql中的索引 在MySQL中, 索引有两种分类方式:逻辑分类和物理分类。 按照逻辑分类,索引可分为: 主键索引:一张表只能有一个主键索引,不允许重复、不允许为 NULL; 唯一索引:数据列不允许重复,允许为 NULL 值,一张表可有多个唯一索引,但是一个唯一索引只能包含一列,比如身份证号码、卡号等都可以作为唯一索引; 普通索引:一张表可以创建多个普通索引,一个普通索引可以包含多个字段,允许数据重复,允许 NULL 值插入; 全文索引:让搜索关键词更高效的一种索引。 按照物理分类,索引可分为: 聚集索引:一般是表中的主键索引,如果表中没有显示指定主键,则会选择表中的第一个不允许为 NULL 的唯一索引,如果还是没有的话,就采用 Innodb 存储引擎为每行数据内置的 6 字节 ROWID 作为聚集索引。每张表只有一个聚集索引,因为聚集索引的键值的逻辑顺序决定了表中相应行的物理顺序。聚集索引在精确查找和范围查找方面有良好的性能表现(相比于普通索引和全表扫描),聚集索引就显得弥足珍贵,聚集索引选择还是要慎重的(一般不会让没有语义的自增 id 充当聚集索引); 非聚集索引:该索引中索引的逻辑顺序与磁盘上行的物理存储顺序不同(非主键的那一列),一个表中可以拥有多个非聚集索引。 在目前用的最多的mysql的InnoDB存储引擎中,是使用B+Tree索引方法来进行索引建立的。 B+树索引是B+树在数据库中的一种实现,是最常见也是数据库中使用最为频繁的一种索引。 B+树中的B代表平衡(balance),而不是二叉(binary),因为B+树是从最早的平衡二叉树演化而来的。先了解二叉查找树、平衡二叉树(AVLTree)和平衡多路查找树(B-Tree),B+树即由这些树逐步优化而来。 具体的讲解可参考:https://www.cnblogs.com/wuzhenzhao/p/10341114.html 该博客。 # 五、索引的优缺点 ## 优点: 1、索引能够提高数据检索的效率,降低数据库的IO成本。 2、通过创建唯一性索引,可以保证数据库表中每一行数据的唯一性,创建唯一索引 3、在使用分组和排序子句进行数据检索时,同样可以显著减少查询中分组和排序的时间 4、加速两个表之间的连接,一般是在外键上创建索引 ## 缺点: 1、创建索引和维护索引要耗费时间,这种时间随着数据量的增加而增加 2、索引需要占物理空间,除了数据表占数据空间之外,每一个索引还要占一定的物理空间,如果要建立聚簇索引,那么需要的空间就会更大 3、当对表中的数据进行增加、删除和修改的时候,索引也要动态的维护,降低了数据的维护速度 # 六、索引何时应该使用 **需创建索引的情况:** 1.主键,自动建立唯一索引 2.频繁作为查询的条件的字段 3.查询中与其他表关联的字段存在外键关系 4.查询中排序的字段,排序字段若通过索引去访问将大大提高排序的速度 5.查询中统计或者分组字段 **避免创建索引的情况:** 1.数据唯一性差的字段不要使用索引 比如性别,只有两种可能数据。意味着索引的二叉树级别少,多是平级。这样的二叉树查找无异于全表扫描。 2.频繁更新的字段不要使用索引 比如登录次数,频繁变化导致索引也频繁变化,增大数据库工作量,降低效率。 3.字段不在where语句出现时不要添加索引 只有在where语句出现,mysql才会去使用索引 4.数据量少的表不要使用索引 使用了改善也不大 # 七、哪些sql能命中索引 1.前导模糊查询不能使用索引, 如name like ‘%涛’ 2、Union、in、or可以命中索引,建议使用in。 3、负条件查询不能使用索引,可以优化为in查询,其中负条件有!=、、not in、not exists、not like等 4、联合索引最左前缀原则,又叫最左侧查询,如果在(a,b,c)三个字段上建立联合索引,那么它能够加快a|(a,b)|(a,b,c)三组的查询速度。 5、建立联合查询时,区分度最高的字段在最左边 6、如果建立了(a,b)联合索引,就不必再单独建立a索引。同理,如果建立了(a,b,c)索引就不必再建立a,(a,b)索引 7、存在非等号和等号混合判断条件时,在建索引时,要把等号条件的列前置 8、范围列可以用到索引,但是范围列后面的列无法用到索引。 索引最多用于一个范围列,如果查询条件中有两个范围列则无法全用到索引。范围条件有:、=、>、>=、between等。 9、把计算放到业务层而不是数据库层。在字段上计算不能命中索引, 10、强制类型转换会全表扫描, 如果phone字段是varcher类型,则下面的SQL不能命中索引。Select * fromuser where phone=13800001234 11、更新十分频繁、数据区分度不高的字段上不宜建立索引。 更新会变更B+树,更新频繁的字段建立索引会大大降低数据库性能。 “性别”这种区分度不太大的属性,建立索引是没有什么意义的,不能有效过滤数据,性能与全表扫描类似。 一般区分度在80%以上就可以建立索引。区分度可以使用count(distinct(列名))/count(*)来计算。 12、利用覆盖索引来进行查询操作,避免回表。 被查询的列,数据能从索引中取得,而不是通过定位符row-locator再到row上获取,即“被查询列要被所建的索引覆盖”,这能够加速度查询。 13、建立索引的列不能为null,使用not null约束及默认值 14、利用延迟关联或者子查询优化超多分页场景, MySQL并不是跳过offset行,而是取offset+N行,然后放弃前offset行,返回N行,那当offset特别大的时候,效率非常低下,要么控制返回的总数,要么对超过特定阈值的页进行SQL改写。 15、业务上唯一特性的字段,即使是多个字段的组合,也必须建成唯一索引。 16、超过三个表最好不要用join,需要join的字段,数据类型必须一致,多表关联查询时,保证被关联的字段需要有索引。 17、如果明确知道查询结果只要一条,limit 1能够提高效率,比如验证登录的时候。 18、Select语句务必指明字段名称 19、如果排序字段没有用到索引,就尽量少排序 20、尽量用union all 代替 union。Union需要将集合合并后在进行唯一性过滤操作,这会涉及到排序,大量的cpu运算,加大资源消耗及延迟,当然,使用union all的前提条件是两个结果集没有重复数据。 # 八、总结 索引是非常重要的技术! 但每建立一个索引,实际上都需要在硬盘上开辟一块空间用于存储这个索引所需要的数据结构(虽然表述不太准确但是是这个意思),因此不建议对太长的字段建立索引。 而且建立的索引并不是越多越好,因为索引虽然能够提高查询效率,但是会大大得影响插入、删除和修改的效率,因为每一次数据的更新都会牵涉到对索引的修改。 综上所述,往往在对于大量数据的插入的情况的时候,我们需要先删除掉数据表的索引,等插入完毕后重新建立索引,这样才能最大限度地保证数据库的效率
-
 如果我们需要完全的复制MySQL的数据表,包括表的结构,索引,默认值等。 如果仅仅使用CREATE TABLE ... SELECT 命令,是无法实现的。本章节将为大家介绍如何完整的复制MySQL数据表,步骤如下:使用 SHOW CREATE TABLE 命令获取创建数据表(CREATE TABLE) 语句,该语句包含了原数据表的结构,索引等。复制以下命令显示的SQL语句,修改数据表名,并执行SQL语句,通过以上命令 将完全的复制数据表结构。如果你想复制表的内容,你就可以使用 INSERT INTO ... SELECT 语句来实现。实例尝试以下实例来复制表 tutorials_tbl 。步骤一:获取数据表的完整结构。mysql> SHOW CREATE TABLE tutorials_tbl \G; *************************** 1. row *************************** Table: tutorials_tbl Create Table: CREATE TABLE `tutorials_tbl` ( `tutorial_id` int(11) NOT NULL auto_increment, `tutorial_title` varchar(100) NOT NULL default '', `tutorial_author` varchar(40) NOT NULL default '', `submission_date` date default NULL, PRIMARY KEY (`tutorial_id`), UNIQUE KEY `AUTHOR_INDEX` (`tutorial_author`) ) TYPE=MyISAM 1 row in set (0.00 sec) ERROR: No query specified步骤二:修改SQL语句的数据表名,并执行SQL语句。mysql> CREATE TABLE `clone_tbl` ( -> `tutorial_id` int(11) NOT NULL auto_increment, -> `tutorial_title` varchar(100) NOT NULL default '', -> `tutorial_author` varchar(40) NOT NULL default '', -> `submission_date` date default NULL, -> PRIMARY KEY (`tutorial_id`), -> UNIQUE KEY `AUTHOR_INDEX` (`tutorial_author`) -> ) TYPE=MyISAM; Query OK, 0 rows affected (1.80 sec)步骤三:执行完第二步骤后,你将在数据库中创建新的克隆表 clone_tbl。 如果你想拷贝数据表的数据你可以使用 INSERT INTO... SELECT 语句来实现。mysql> INSERT INTO clone_tbl (tutorial_id, -> tutorial_title, -> tutorial_author, -> submission_date) -> SELECT tutorial_id,tutorial_title, -> tutorial_author,submission_date -> FROM tutorials_tbl; Query OK, 3 rows affected (0.07 sec) Records: 3 Duplicates: 0 Warnings: 0参考文章:http://www.manongjc.com/mysql/mysql_clone_tables.html
-
多个可以操作的数据库,所以你需要选择你要操作的数据库。从命令提示窗口中选择MySQL数据库在 mysql> 提示窗口中可以很简单的选择特定的数据库。你可以使用SQL命令来选择指定的数据库。实例以下实例选取了数据库 TUTORIALS:[root@host]# mysql -u root -p Enter password:****** mysql> use TUTORIALS; Database changed mysql>执行以上命令后,你就已经成功选择了 TUTORIALS 数据库,在后续的操作中都会在 TUTORIALS 数据库中执行。注意:所有的数据库名,表名,表字段都是区分大小写的。所以你在使用SQL命令时需要输入正确的名称。使用PHP脚本选择MySQL数据库PHP 提供了函数 mysql_select_db 来选取一个数据库。函数在执行成功后返回 TRUE ,否则返回 FALSE 。语法bool mysql_select_db( db_name, connection );参数描述db_name必需。规定要选择的数据库。connection可选。规定 MySQL 连接。如果未指定,则使用上一个连接。实例以下实例展示了如何使用 mysql_select_db 函数来选取一个数据库:<html> <head> <title>Selecting MySQL Database</title> </head> <body> <?php $dbhost = 'localhost:3036'; $dbuser = 'guest'; $dbpass = 'guest123'; $conn = mysql_connect($dbhost, $dbuser, $dbpass); if(! $conn ) { die('Could not connect: ' . mysql_error()); } echo 'Connected successfully'; mysql_select_db( 'TUTORIALS' ); mysql_close($conn); ?> </body> </html>
-
问题背景描述使用sysbench对mysql5.7.21进行256并发压测时,x86下TPS为10685,Kunpeng920 下压测结果为4197,性能较原有X86环境下有较大差距。 问题分析过程Top命令查看cpu资源使用情况 执行脚本进行压测时发现,top命令下mysql进程cpu使用率6000%左右,其中系统调用占用较高,为进一步明确mysql进程在执行哪些过程进行perf 热点函数和火焰图分析。perf命令查看热点函数通过在压测过程中执行perf top命令,查看到相关函数调用较高:进一步明确分析函数调用栈关系,使用perf record命令抓取一段时间perf 数据,进行解析后生成相应火焰图:分析发现mysql中调用的热点函数MVCC::view_open和PolycyMutex_在底层调用的是spin_lock相关函数,进而导致系统调用高,大量线程都在进行自旋空转,消耗cpu资源。问题解决措施及结果修改Mysql源码中CacheLine(可选优化项)通过github上mysql相关issue发现,在mysql中存在对cacheLine的硬编码现象,mysql中cachline大小是适配X86平台的为64字节,Kunpeng 920下cacheLine为128字节。可参考以下issue链接cid:link_2对mysql源码进行修改,此措施可获得相应的性能提升。Cacheline机制理解:CPU标识Cache中的数据是否为有效数据不是以内存位宽为单位,而是以Cacheline为单位。这个机制可能会导致伪共享(false sharing)现象,从而使得CPU的Cache命中率变低。出现伪共享的常见原因是高频访问的数据未按照Cacheline大小对齐,而在高并发压测mysql时,其中加锁的全局变量或数据一般是在高频的访问,这就可能导致性能的下降。(对于高频访问的锁变量,实际是对锁变量进行高频的读写操作,容易发生伪共享问题)修改mysql数据库配置参数Mysql中主要影响spin_lock相关性能参数的主要有:innodb_thread_concurrency、innodb_spin_wait_delay、innodb_sync_spin_loops。其中nnodb_thread_concurrency推荐设置为cpu的核心数,通过上调innodb_spin_wait_delay和innodb_sync_spin_loops参数,同时使用perf top命令观测MVCC::view_open和PolycyMutex_热点函数使用率,当使用率下降到合理范围内时,即达到预期效果。由于原子操作在x86和kunpeng 920平台上的实现存在差异,加上kunpeng920的核心数较多,导致在mysql高并发压测时出现了spin_lock相关系统调用较高,通过相应的mysql参数优化即可实现性能提升,结合Mysql下相关自旋锁的代码实现,可更好的理解这两个参数的作用,参考链接如下:cid:link_1优化后测试结论 通过对mysql的相关优化,最终在256并发下,kunpeng 920上TPS达到了11700,优于原X86压测结果(TPS 10685)。
-
 【功能模块】DWS中有没有gis函数,类似MySQL中的ST_WITHIN【操作步骤&问题现象】mysql gis函数ST_WITHIN一个常见的应用需求是找出你周围的目的地(例如餐馆),可以使用该函数。ST_WITHIN(g1, g2): 如果g1在g2的范围内,则返回1,否则返回0mysql> set @g1 = ST_GeomFromText('POINT(1.558064 110.341903)');Query OK, 0 rows affected (0.00 sec) mysql> set @g2 = ST_GeomFromText('POLYGON((1.558467 110.341781, 1.558081 110.342317, 1.557764 110.34175, 1.558467 110.341781 ))');Query OK, 0 rows affected (0.00 sec) mysql> select st_within(@g1, @g2);+---------------------+| st_within(@g1, @g2) |+---------------------+| 1 |+---------------------+1 row in set (0.00 sec)ST_CONTAINS是ST_WITHIN的反向操作,表示某个多边形内是否包含某个点。mysql> select st_contains(@g2, @g1);+-----------------------+| st_contains(@g2, @g1) |+-----------------------+| 1 |+-----------------------+1 row in set (0.00 sec)
-
 # 华为FusionInsight MRS CDL最新版本使用指南 ## CDL简介 CDL(全称Change Data Loader)是一个基于Kafka Connect框架的实时数据集成服务。 CDL服务能够从各种OLTP数据库中捕获数据库的Data Change事件,并推送到kafka,再由sink connector推送到大数据生态系统中。 CDL在1.1.0版本中提供了**图形化**开发界面,能够大大的简化CDL配置工作。 本此实践介绍以mysql作为数据源进行数据抓取,将结果数据写入mrs的kafka组件。 ## 前提条件 - MRS集群已安装CDL服务。 - MySQL数据库需要开启mysql的bin log功能(默认情况下是开启的)。 查看MySQL是否开启bin log: 使用工具或者命令行连接MySQL数据库(本示例使用navicat工具连接),执行show variables like 'log_%'命令查看。 例如在navicat工具选择"File > New Query"新建查询,输入如下SQL命令,单击"Run"在结果中"log_bin"显示为"ON"则表示开启成功。 `show variables like 'log_%'`  - 检查用户是否有访问CDLService UI的权限  ## 上传驱动文件 - 获取mysql数据库对应的驱动文件:mysql-connector-java-8.0.24.jar - 登录CDLService UI, 单击“驱动管理 > 上传驱动”,在弹出的窗口选择本地已准备的数据库驱动文件,单击“打开”,等待驱动上传完成。  ## 创建数据库连接 - 选择“连接管理 > 新增连接”,在弹出窗口中输入数据连接的名称(Name,不能与已存在的名称相同)并选择连接类型(Link Type)。 - mysql数据库连接信息如下:  点击测试链接测试  ## 创建kafka连接 - 选择“连接管理 > 新增连接”,在弹出窗口中输入数据连接的名称(Name,不能与已存在的名称相同)并选择连接类型(Link Type)。 - kafka数据库连接信息如下:  点击测试链接测试  ## 创建CDL作业 - 单击“作业管理 > 新建作业”,在弹出的窗口中输入作业相关信息,然后单击“下一步”。 - Name:作业名称。 - Default Topic:作业对接的Kafka topic名称,系统自动创建,可以自己填入一个topic。 - Desc:作业描述信息。  - 在“作业管理”界面,根据业务数据流向,从界面左侧列表中分别选择“Source”和“Sink”中数据连接元素并将其拖到右侧的操作界面中  - mysql配置   - kafka配置  - 作业参数配置完成后,拖拽图标将作业进行关联,然后单击“保存”,作业配置完成 - 在“作业管理”的作业列表中,找到创建的作业名称,单击操作列的“启动”,等待作业启动  ## 检查结果 增加操作:insert into hudisource2 values (6,"郑雨泽",50,"男","板","植物",5988);  更改操作:UPDATE hudisource2 SET uname="Anne Marie" WHERE uid=6;  删除操作:delete from hudi.hudisource2 where uid=6; 
-
 WHERE 子句WHERE 子句用于提取满足指定标准的的记录。语法SELECT column_name(s)FROM table_nameWHERE column_name operator value如需学习更多关于 SQL 的知识,请访问我们的 SQL 教程。为了让 PHP 执行上面的语句,我们必须使用 mysqli_query() 函数。该函数用于向 MySQL 连接发送查询或命令。实例下面的实例将从 "Persons" 表中选取所有 FirstName='Peter' 的行:<?php$con=mysqli_connect("localhost","username","password","database");// 检测连接if (mysqli_connect_errno()){ echo "连接失败: " . mysqli_connect_error();}$result = mysqli_query($con,"SELECT * FROM PersonsWHERE FirstName='Peter'");while($row = mysqli_fetch_array($result)){ echo $row['FirstName'] . " " . $row['LastName']; echo "<br>";}?>以上代码将输出:Peter Griffin
-
最近收到一个客户反馈使用DRS同步后,源库和目标库的数据不一致。数据一致性是DRS的生存之本,团队上下非常重视,收到反馈后马上联系客户了解情况排查原因,最终发现原来是虚惊一场。那么这个“不一致”是怎么产生的?它底层的根本原因又是什么呢?接下来我们一起来挖一挖。 ### 问题现象 客户使用DRS创建了MySQL到PostgreSQL的同步任务,MySQL表中存在一个FLOAT类型的列,DRS任务启动后会在PostgreSQL中对应创建一个FLOAT4的列。同步过程中在MySQL中插入一条FLOAT列值为3.1415926的数据,同步后在源库MySQL中SELECT出来的数据是3.14159,而在目标库PostgrSQL中SELECT出来却是3.1415925。 ### 复现步骤: 1. 在源库建表: ``` CREATE TABLE `float_test` ( `id` int(11) primary key, `id2` float ) ENGINE=InnoDB DEFAULT CHARSET=utf8 ``` 2. 创建DRS任务,同步这张表的数据到PostgreSQL。目标库会自动创建下表: ``` CREATE TABLE "root"."float_test" ( "id" int PRIMARY KEY, "id2" FLOAT4 ) ``` 3. 在源库insert数据: ``` insert into `float_test` values (1, 3.1415926); ``` 4. 数据同步之后 通过mysql客户端查询:  通过postgresql客户端查询: 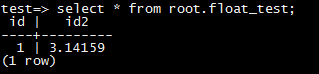 而通过jdbc查询: mysql: 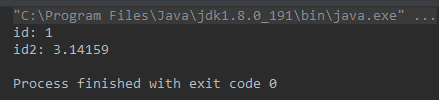 postgresql: 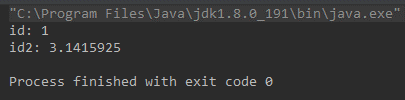 ### 问题原因: mysql底层存储3.1415926的时候,binlog中记录的数据为3.1415925,DRS从binlog中解析出来数据,同步到PostgrSQL的也是3.1415925。 而通过mysql的driver进行select的时候,mysql driver对数据进行了截断,所以查出来是3.14159,而PostgrSQL的driver没有进行截断,导致通过两种driver select出的数据不一致。 如果不想让driver截断,可以在jdbc的url中增加useServerPrepStmts=true的option。
-
已经使用过python 连接MySQL的操作,这个练习复习一下。vi demo.pyfrom pymysql import *import jsondef connectDB(): db = connect('127.0.0.1','root','Aa12345@','test',charset='utf8') return dbdb = connectDB()# 创建persons表def createTable(db): cursor = db.cursor() sql = '''CREATE TABLE persons (id INT PRIMARY KEY NOT NULL, name TEXT NOT NULL, age INT NOT NULL, address CHAR(50), salary REAL);''' try: cursor.execute(sql) db.commit() return True except: db.rollback() return False# 向persons表插入4条记录def insertRecords(db): c = db.cursor() try: c.execute('delete from persons') c.execute("insert into persons(id,name,age,address,salary)\ values(1,'Bill', 32,'California',20000.12)") c.execute("insert into persons(id,name,age,address,salary)\ values(2,'Mary', 26,'Texas',1234)") c.execute("insert into persons(id,name,age,address,salary)\ values(3,'John', 36,'Norway',5432)") c.execute("insert into persons(id,name,age,address,salary)\ values(4,'Joe', 16,'Rich-Mond',6543)") db.commit() return True except: db.rollback() return Falsedef selectRecords(db): cursor = db.cursor() sql = 'select name,age,salary from persons order by age desc' cursor.execute(sql) results = cursor.fetchall() print(results) fields = {'name','age','salary'} records = [] for row in results: records.append(dict(zip(fields,row))) return json.dumps(records)if createTable(db): print('成功创建persons表')else: print('persons表已经存在')if insertRecords(db): print('成功插入记录')else: print('插入记录失败')print(selectRecords(db))db.close()同样使用cloudIDE来做实验环境,简单起见使用ECS搭建的mysql服务器。运行结果:user@ppyb5rpzt12svhu-machine:~/ghj-1635491515588$ /usr/bin/python /home/user/ghj-1635491515588/demo.pyTraceback (most recent call last): File "/home/user/ghj-1635491515588/demo.py", line 8, in <module> db = connectDB() File "/home/user/ghj-1635491515588/demo.py", line 4, in connectDB db = connect(host='x.x.x.x',user='root',password='*******',database='test',charset='utf8') File "/home/user/.local/lib/python3.6/site-packages/pymysql/connections.py", line 353, in __init__ self.connect() File "/home/user/.local/lib/python3.6/site-packages/pymysql/connections.py", line 632, in connect self._get_server_information() File "/home/user/.local/lib/python3.6/site-packages/pymysql/connections.py", line 1055, in _get_server_information packet = self._read_packet() File "/home/user/.local/lib/python3.6/site-packages/pymysql/connections.py", line 725, in _read_packet packet.raise_for_error() File "/home/user/.local/lib/python3.6/site-packages/pymysql/protocol.py", line 221, in raise_for_error err.raise_mysql_exception(self._data) File "/home/user/.local/lib/python3.6/site-packages/pymysql/err.py", line 143, in raise_mysql_exception raise errorclass(errno, errval)pymysql.err.OperationalError: (1130, "117.78.40.113' is not allowed to connect to this MySQL server")这里报了个权限的错误,需要修改mysql的权限数据:mysql> use mysqlReading table information for completion of table and column namesYou can turn off this feature to get a quicker startup with -ADatabase changedmysql> select host,user from user;+-----------+---------------+| host | user |+-----------+---------------+| localhost | mysql.session || localhost | mysql.sys || localhost | root |+-----------+---------------+3 rows in set (0.00 sec)mysql> update user set host = '%' where user ='root'; #修改权限Query OK, 1 row affected (0.00 sec)Rows matched: 1 Changed: 1 Warnings: 0mysql> flush privileges;#刷新Query OK, 0 rows affected (0.01 sec)mysql> select host,user from user;+-----------+---------------+| host | user |+-----------+---------------+| % | root || localhost | mysql.session || localhost | mysql.sys |+-----------+---------------+3 rows in set (0.00 sec)mysql> 再次执行:user@ppyb5rpzt12svhu-machine:~/ghj-1635491515588$ /usr/bin/python /home/user/ghj-1635491515588/demo.py成功创建persons表成功插入记录(('John', 36, 5432.0), ('Bill', 32, 20000.12), ('Mary', 26, 1234.0), ('Joe', 16, 6543.0))[{"name": "John", "salary": 36, "age": 5432.0}, {"name": "Bill", "salary": 32, "age": 20000.12}, {"name": "Mary", "salary": 26, "age": 1234.0}, {"name": "Joe", "salary": 16, "age": 6543.0}]user@ppyb5rpzt12svhu-machine:~/ghj-1635491515588$
-
【功能模块】1、参照指导文档 https://support.huaweicloud.com/prtg-kunpengdbs/kunpengmysql8017_02_0008.html 在openeuler上安装mysql 8.0.17 报错【截图信息】【日志信息】(可选,上传日志内容或者附件)
-
 漏洞名称 : Oracle MySQL JDBC XML外部实体注入漏洞 CVE-2021-2471组件名称 : Oracle MySQL影响范围 : Oracle MySQL < 8.0.27漏洞类型 : XML外部实体注入利用条件 : 未知综合评价 : <综合评定利用难度>:未知。<综合评定威胁等级>:高危,能获取敏感信息。漏洞分析:1、组件介绍MySQL是一个关系型数据库管理系统,由瑞典MySQL AB 公司开发,目前属于Oracle旗下产品。MySQL 是当前流行的关系型数据库管理系统之一。2、漏洞描述2021年10月21日,监测到一则Oracle MySQL组件在JDBC过程中存在XML外部实体注入漏洞的信息,漏洞编号:CVE-2021-2471,漏洞威胁等级:高危。攻击者可以利用该漏洞获取服务器敏感信息,最终导致信息泄露。影响范围:MySQL 是当前流行的关系型数据库管理系统之一,所提供的服务和产品众多且应用广泛。此次可能受漏洞影响的资产也分布于世界各地,中国地区也使用广泛。目前受影响的Oracle MySQL版本:Oracle MySQL < 8.0.27解决方案:1、官方修复建议当前官方已发布对应安全补丁,建议受影响用户及时更新。参考链接如下:https://www.oracle.com/security-alerts/cpuoct2021.html
-
-
 mysql版本是8.0.20,针对mysql的OLAP场景的打patch的方法参考如下:https://support.huaweicloud.com/fg-kunpengdbs/kunpengolap_20_0006.html 第一、判断是否打patchshow variables like ‘%parallel%’;第二、打patch后需要设置参数set global force_parallel_execute=ON; //需要全局的,然后退出再进入进去如果看到上面的参数force_parallel_execut =ON 表明patch打成功也已经开启并时功能同时可以尝试把参数parallel_default_dop 设置为8:set global parallel_default_dop=8;注意:参数设置后不需要重启数据库,如果数据库重启后参数需要重新设置。第三、配置文件中的两个参数vim /etc/my.cfginnodb_spin_wait_delay=180innodb_sync_spin_loops=25第四、测试打patch前后的性能:测试数据库:方法一:使用sysbench 工具测试1、登录mysql数据库mysql -uuser -p -hlocalhost -P33062、创建sysbench测试使用的数据库“dbtest”。create database dbtest;show databases;3、准备数据:创建10个表,每个表有10万条数据,使用10个线程来创建sysbench --test= /usr/local/share/sysbench/tests/include/oltp_legacy/parallel_prepare.lua --mysql-host=175.2.12.68 --mysql-db=dbtest --mysql-port=3306 --mysql-user=root --mysql-password=lvan2020 --oltp-tables-count=10 --oltp-table-size=100000 --threads=10 --time=120 --report-interval=10 prepare4、需要增大—threads的参数找到一个合适的线程数来测试。sysbench /usr/local/share/sysbench/oltp_point_select.lua --db-driver=mysql --mysql-db=dbtest --mysql-password=lvan2020 --threads=300 --mysql-host=195.2.12.68 --mysql-port=3306 --mysql-user=root --report-interval=10 --time=60 run打patch前打pathch后5、清理数据:sysbench /usr/local/share/sysbench/tests/include/oltp_legacy/oltp.lua --db-driver=mysql --mysql-host=195.2.12.68 --mysql-db=dbtest --mysql-user=root --mysql-password=lvan2020 cleanup 方法二:使用TPC-H工具测试(如果是mysql的OLAP的场景推荐使用这个方法测试)https://support.huaweicloud.com/tstg-kunpengdbs/kunpengtpch_02_0004.html 附:1、数据库的启停/etc/init.d/mysql stop/etc/init.d/mysql start/etc/init.d/mysql restart2、如果数据库mysql启动报错如下:解决方法:mkdir -p /tmp/mysqlchown mysql.mysql /tmp/mysql
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签