-
 需求公司数据统计报表查询,几张大表关联查询,包含跨库查询,数据联查,数据过滤,数据统计。问题主表数据1 主表数据2 … 统计数据1 统计数据2 …数据 数据 数据 数据 报表结构是主表数据+统计数据,只查主表数据速度很快,统计数据需要跨库联查,且表数据量大,拖慢了速度。一开始的做法是,每次分页请求都先获取主表list,再foreach主表list,根据主表字段去查询统计数据并进行计算,再合并到主表进行返回,查询速度不理想。分页查响应时间=1次主表查询时间+10次统计数据查询时间思路复杂的报表数据统计不应全部由DB层面去解决,而是SQL仅负责数据过滤,返回统计所需的字段,SQL尽量简单高效,service层拿到DB返回的结果集,由代码层面去进行较为复杂的数据合并与统计。最总给到前端的是一个分页,那么优化的话是基于分页去进行,分页10条,线程池开启10个线程去并行查询,最总汇总返回给前端。分页查响应时间=1次主表查询时间+1次统计数据查询时间(10条中最慢的一条)代码线程池工具类package com.youxue.weliao.utils;import com.google.common.util.concurrent.ThreadFactoryBuilder;import lombok.extern.slf4j.Slf4j;import java.util.concurrent.Future;import java.util.concurrent.LinkedBlockingQueue;import java.util.concurrent.ThreadPoolExecutor;import java.util.concurrent.TimeUnit;/** * @Author lhy * @Date 2022/5/13 */@Slf4jpublic class ThreadUtil { private volatile static ThreadUtil threadUtil; private ThreadPoolExecutor executor; /** * 单例 */ private ThreadUtil() { } public static ThreadUtil getThreadUtilInstance() { if (null == threadUtil) { synchronized (ThreadUtil.class) { if (null == threadUtil) { threadUtil = new ThreadUtil(); } } } return threadUtil; } /** * 提交任务 * * @param task */ public Future<?> submit(Runnable task) { if (executor == null) { // 初始化线程池 executor = initialize(); } // 执行线程 return executor.submit(task); } /** * 初始化线程池 * * @return */ private synchronized ThreadPoolExecutor initialize() { ThreadPoolExecutor executor = new ThreadPoolExecutor(10, 10, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<>(1024), new ThreadFactoryBuilder() .setNameFormat("task-admin-getlist--%d") .build(), new ThreadPoolExecutor.CallerRunsPolicy()); log.info("===================>ThreadUtil线程池初始化"); return executor; } /** * 关闭线程池 */ public void shutdown() { if (executor != null) { executor.shutdown(); } }}service层实际调用,这里我就不把全部业务代码放出来了,简化后如下 @Override public IPage<ManageDto> getManageDto(IPage<ManageDto> page, String str, String end, List<Integer> taskAdminIds) { // 主表查询 IPage<ManageDto> manageDtos = baseMapper.getManageDto(page, str, end, taskAdminIds); if (manageDtos.getTotal() > 0) { // 主表查询结果集 List<ManageDto> manageDtoList = manageDtos.getRecords(); // 异步线程Future集合 List<Future<?>> futures = new ArrayList<>(); for (ManageDto manageDto : manageDtoList) { // 本页有几条数据便开启几条线程去进行统计数据查询 futures.add(ThreadUtil.getThreadUtilInstance().submit(() -> { // 统计数据查询 List<ManageVo> manageVos = groupCyberArmyService.getManageVos(manageDto.getProcessAdminUserId(), manageDto.getTaskAdminId()); // 业务逻辑运算后合并到主表Dto })) } this.waitFinish(futures); manageDtos.setRecords(manageDtoList); return manageDtos; } return null; } /** * 线程池内线程是否已全部执行结束 * * @param futures 异步线程Future集合 */ @SneakyThrows private void waitFinish(List<Future<?>> futures) { for (Future<?> future : futures) { future.get(); } }解析future.get方法线程池线程是异步提交的,但是返回分页结果是需要同步返回,Future的get是个阻塞方法。只有所有的任务全部完成,我们才能用get按照任务的提交顺序依次返回结果,调用future.get()方法查看线程池内所有方法是否已执行完成,达到线程异步提交,结果集同步返回的效果。线程池工具类单例就不多解释了,这里用的是DCL单例,线程池根据自身需求配置核心线程等参数。————————————————版权声明:本文为CSDN博主「幸福往往是摸得透彻」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。原文链接:https://blog.csdn.net/weixin_43840809/article/details/124767908
-
一、建表优化1.1 数据类型1.1.1 时间字段时间字段建议存储为DateTime类型,不需要经过函数转换处理,执行效率高,可读性好。1.1.2 空值存储类型Nullable类型几乎总是会拖累性能,因为存储Nullable列时需要创建一个额外的文件来存储NULL的标记,并且Nullable列无法被索引。参考:nullable列,clickhouse中Nullable与非空字段的建表与类型互转1.2 分区和索引分区粒度一般按天分区,也可以指定Tuple(),也就是不分区。常规来说,1亿条数据分30个分区比较合适。必须指定索引列,clickhouse中的索引列即排序列,通过order by指定。通常是查询频率大的在前,高级列在前原则。基数大的不适合做索引列(即重复数据特别少的列)。1.3 表参数index_granularity控制索引粒度,默认8192。不保存全量历史数据的可以用TTL。1.4 写入和删除优化尽量不要执行单条或小批量删除和插入操作,因为会产生小分区文件,给后台Merge任务带来巨大压力。不要一次写入太多分区,或数据写入太快,数据写入太快会导致Merge速度跟不上报错。一般建议每秒发起2-3次写入操作,每次操作写入2w-5w条数据。1.5 举例参考:ClickHouse元数据以下例子主要测试两部分内容:一是删除数据时,查看系统表分区情况会发现删除的数据并没有马上删掉;二是使用TTL的效果。CREATE TABLE test.t_null( id String, name Nullable(String), create_time DateTime default now()) ENGINE = MergeTree PARTITION BY id ORDER BY id TTL create_time + INTERVAL 10 minute ; --默认是delete-- 注意8小时时差insert into test.t_null values('1', 'alice', '2021-12-25 09:41:00'),('1', NULL, '2021-12-25 09:41:00'),('2', 'bob', '2021-12-02 06:41:00'),('3', 'carolin', '2021-12-02 06:41:00');--查询结果select * from test.t_null;--删除某个分区alter table test.t_null delete where id = '3';--系统存储情况,注意观察 name列,删除前后生成的小分区select partition, name, part_type, active, marks, rows, --bytes_on_disk, --data_compressed_bytes, --data_uncompressed_bytes, remove_time, --partition_id, level, database, table, disk_name, --path, column, type, column_positionfrom system.parts_columnswhere database='test' and table='t_null';--合并数据optimize table test.t_null final;123456789101112131415161718192021222324252627282930313233343536373839404142434445464748491.6 常见配置1.6.1CPU资源config.xml配置项users.xml配置项background_pool_size:后台线程池大小,merge线程就是在该线程池执行,默认16,允许的前提下建议改成cpu个数的2倍(线程数)。background_schedule_pool_size:执行后台任务的线程数,默认128,建议改成cpu个数的2倍(线程数)。background_distributed_schedule_pool_size:设置为分布式发送执行后台任务的线程数,默认16,建议改成cpu个数的2倍(线程数)。max_concurrent_queries:最大并发处理的请求数(包含select, insert等),默认值100,推荐150-300。max_threads:单个查询所能使用的cpu个数,默认是cpu核数。1.6.2 内存资源max_memory_usage:在users.xml中,表示单次Query占用内存最大值,可以设置稍大。比如128G的内存设置为100G。max_bytes_before_external_group_by:一般按照max_memory_usage的一般设置,当group使用内存超过阈值后会刷到磁盘运行。建议50G。max_bytes_before_external_sort:超过时进行溢写磁盘。max_table_size_to_drop:在config.xml中,默认是50GB,建议修改为0,不限制。1.6.3 存储不支持设置多数级目录,为了提升数据io性能,看挂载虚拟券组。二、语法优化规则基于RBO(Rule Based Optimization),参考:RBO优化器下面通过explain语句查看执行计划,来看看不同的查询语句执行效果,其中部分是clickhouse自动帮我们进行优化的,但另一部分是在查看优化的执行语句之后,我们需要手动对查询语句进行修改。2.1 count优化-- 只要加了具体字段就会导致扫描全表explain plan select count(UserID) from hits_v1;-- count(*), count(1)都会优化直接获取count文件explain plan select count() from hits_v1;123452.2 消除子查询重复字段explain syntax select UserID, UserID, VisitID from visits_v1;explain syntax select UserID, UserID as UserID2, VisitID from visits_v1;122.3 谓词下推2.3.1 having当group by有having子句,但是没有with cube, with rollup 或者 with totals修饰的时候,having过滤会下推到where提前过滤。explain syntax select UserID from hits_v1 group by UserID having UserID = '8585742290196126178';--优化后SELECT UserID FROM hits_v1 WHERE UserID = '8585742290196126178' GROUP BY UserID;12342.3.2 子查询优化后过滤条件被移至子查询中。explain syntax select * from (select UserID from visits_v1) where UserID = '8585742290196126178';--优化后SELECT UserIDFROM (SELECT UserID FROM visits_v1 WHERE UserID = '8585742290196126178') WHERE UserID = '8585742290196126178'12345672.4 聚合计算外推explain syntax select sum(UserID * 2) from visits_v1--优化结果select sum(UserID) * 2 from visits_v11234explain syntax select sum(exp_cnt * 2) from test.test1;--优化结果SELECT sum(exp_cnt) * 2 FROM test.test1;1234需要注意的是clickhouse并不会自动帮我们优化,可以执行两种查询语句查看执行时间:--明显第二种方式结果更快select sum(exp_cnt * 2) from test.test1;SELECT sum(exp_cnt) * 2 FROM test.test1;1232.5 聚合函数消除explain syntaxselect sum(UserID * 2), max(VisitID), max(UserID)from visits_v1group by UserID--优化后的语句SELECT sum(UserID) * 2, max(VisitID), UserID --去掉无意义的函数FROM visits_v1 GROUP BY UserID123456789101112131415162.6 删除重复2.6.1 删除重复的order by keyexplain syntaxselect UserID, VisitIDfrom visits_v1order by UserID ASC, UserID DESC, VisitID ASC, VisitID ASC--优化后语句explain syntaxselect UserID, VisitIDfrom visits_v1order by UserID ASC, VisitID ASC12345678910111213141516172.6.2 删除重复的limit by key参考:LIMIT BYexplain syntaxselect *from visits_v1order by CounterIDlimit 2 by CounterID, CounterID --每个单独的CounterID保留两条数据LIMIT 10--优化后的语句select *from visits_v1order by CounterIDlimit 2 by CounterIDLIMIT 1012345678910111213142.6.3 删除重复的USING Keyexplain syntaxselect a.UserID, b.VisitID, a.URL, b.UserIDfrom hits_v1 AS aleft join visits_v1 as b using (UserID, UserID) --on a.UserID=b.UserID--返回优化后的语句select UserID, VisitID, URL, b.UserIDfrom hits_v1 AS aleft join visits_v1 as b using (UserID)12345678910111213141516172.7 标量替换如果子查询只返回一行数据,在被引用的时候用标量替换。在本例中,指的是``with (select sum(bytes) from system.parts where active) as total_disk_usage`会被优化为用一个数值代替。explain syntaxwith (select sum(bytes) from system.parts where active) as total_disk_usageselect table, (sum(bytes) / total_disk_usage) * 100 as table_disk_usage, total_disk_usagefrom system.partsgroup by tableorder by table_disk_usage desclimit 10;--优化结果,WITH语句内容似乎是与查询语句绑定的,不能单独执行,不然结果是不对的WITH identity(CAST(0, 'UInt64')) AS total_disk_usageSELECT table, (sum(bytes) / total_disk_usage) * 100 AS table_disk_usage, total_disk_usageFROM system.partsGROUP BY tableORDER BY table_disk_usage DESCLIMIT 10;123456789101112131415161718192.8 三元运算优化开启参数 optimize_if_chain_to_multiif,则三元运算符会被替换成multiIf函数explain syntaxselect number = 1 ? 'hello' : (number = 2 ? 'world' : 'atguigu')from numbers(10)settings optimize_if_chain_to_multiif = 1;--优化结果SELECT multiIf(number = 1, 'hello', number = 2, 'world', 'atguigu')FROM numbers(10)SETTINGS optimize_if_chain_to_multiif = 1;123456789三、查询优化3.1 单表查询3.1.1 prewhere代替wherewhere是先过滤出满足条件的行,然后再选择需要的列。prewhere只支持MergeTreee族系列引擎的表,首先会读取指定的列数据,来判断数据过滤,等待数据过滤之后再读取select声明的列字段来补全其余属性,这样可以避免整行扫描。当查询列明显多于筛选列时,prewhere可十倍提升查询性能,自动优化执行过滤阶段的数据读取方式,降低io操作。默认情况下,where条件会自动优化成prewhere。关闭自动优化:set optimize_move_to_prewhere=0;explain syntaxselect WatchID, EventTime, UserID, URLDomain, RefererDomainfrom datasets.hits_v1where UserID = '8585742290196126178'--优化结果SELECT WatchID, EventTime, UserID, URLDomain, RefererDomainFROM datasets.hits_v1PREWHERE UserID = '85857422901961261712345678910不能自动优化的情况:使用常量表达式使用默认值为alias类型的字段包含了arrayJOIN, globalIn, globalNotIn, indexHint的查询使用了主键字段select 查询的列字段和where的谓词相同explain syntaxselect UserIDfrom datasets.hits_v1where UserID = '8585742290196126178';--结果没有优化SELECT UserIDFROM datasets.hits_v1WHERE UserID = '8585742290196126178';1234567893.1.2 数据采样采样可以极大提升数据分析的性能select Title, count(*) as PageViewsfrom datasets.hits_v1sample 0.1where CounterID = 57group by Titleorder by PageViews desc limit 10001234563.1.3 列裁剪与分区裁剪数据量太大时应避免使用select * 操作,尽量只取用到的列,必要时可对分区进行过滤-- 反例select * from datasets.hits_v1;-- 正例select WatchID, JavaEnable, Title, EventTime, EventDate, CounterID, ClientIP, ClientIP6, RegionID, UserIDfrom datasets.hits_v1;-- 分区裁剪select WatchID, JavaEnable, Title, EventTime, EventDate, CounterID, ClientIP, ClientIP6, RegionID, UserIDfrom datasets.hits_v1where EventDate = '2014-03-23';12345678910113.1.4 orderby结合where, limit千万以上数据集进行order by查询时需要搭配where条件和limit语句一起使用。-- 正例select UserID, Agefrom hits_v1where CounterID = 57order by Age desc limit 1000;-- 反例select UserID, Agefrom hits_v1order by Age desc;123456789103.1.5 避免构建虚拟列如非必须,不要在结果集上构建虚拟列,虚拟列非常消耗资源浪费性能,可以考虑前端进行处理,或者在表中构造实际字段进行额外存储。-- 反例select Income, Age, Income/Age as IncRate from datasets.hits_v1;-- 正例select Income, Age from datasets.hits_v1;12343.1.6 uniqCombined替代distinct性能可提升10倍以上,uniqCombined底层采用类似HyperLogLog算法实现,能接受数据误差,可直接使用这种去重方式提升查询性能。-- 反例select count(distinct UserID) from datasets.hits_v1;-- SELECT uniqExact(UserID) FROM datasets.hits_v1-- 正例select uniqCombined(UserID) from datasets.hits_v1;1234563.1.7 其他注意事项1)查询熔断为了避免因个别慢查询引起的服务雪崩的问题,除了可以为单个查询设置超时以外,还可以配置周期熔断,在一个查询周期内,如果用户频繁进行慢查询,超出规定阈值后将无法继续进行查询操作。2)关闭虚拟内存物理内存和虚拟内存的数据交换会导致查询变慢,资源允许的情况下,关闭虚拟内存。3)配置join_use_nulls为每一个账户添加join_use_nulls配置,左表中的一条记录在右表中不存在,游标的相应字段会返回该字段相应数据类型的默认值,而不是Null值。4)批量写入时先排序批量写入数据时,必须控制每个批次的数据中涉及到的分区的数量,在写入之前最好对需要导入的数据进行排序。无序的数据或者涉及的分区太多,会导致clickhouse无法及时对新导入的数据进行合并,从而影响查询性能。5)关注CPUcpu一般在50%左右会出现查询波动,达到70%会出现大范围的查询超时,cpu是最关键的指标,要非常关注。3.2 多表关联3.2.1 准备表和数据# 创建小表create table visits_v2engine = CollapsingMergeTree(Sign)partition by toYYYYMM(StartDte)order by (CounterID, StartDate, intHash32(UserID), VisitID)sample by intHash32(UserID)settings index_granularity = 8192as select * from visits_v1 limit 10000;# 创建join结果表,避免控制台疯狂打印数据# 巧用条件语句复制表结构而不导入数据create table hits_v2engine = MergeTree()partition by toYYYYMM(EventDate)order by (CounterID, StartDate, intHash32(UserID))sample by intHash32(UserID)settings index_granularity = 8192as select * from hits_v1 where 1=0;1234567891011121314151617183.2.2 join优化3.2.2.1 常规join方式表A和表B进行join时,先将B加载到内存中,然后A每一条数据都去内存中查询表B进行匹配。3.2.2.2 大小表join多表join时要满足小表在右的原则,右表关联时被加载到内存中与左表进行比较。clickhouse中无论时left join, right join还是inner join,永远都是拿着右表中的每一条记录到左表中查找该记录是否存在,所以右表必须是小表。小表在右insert into table hits_v2select a.* from hits_v1 a left join visits_v2 b on a.CounterID = b.CounterID;12大表在右insert into table hits_v2select a.* from visits_v2 b left join hits_v1 a on a.CounterID = b.CounterID;123.2.2.3 用in代替join多表联查时,查询的数据仅从其中一张表出时,可以考虑用in操作而不是joininsert into hits_v2select a.* from hits_v1 a where a.CounterID in (select CounterID from visits_v1);1233.2.2.4 谓词下推谓词下推的基本思想即:将过滤表达式尽可能移动至靠近数据源的位置,以使真正执行时能直接跳过无关的数据。join查询时不会主动发起谓词下推的操作,需要每个子查询提前完成过滤操作,需要注意的时,是否执行谓词下推,对性能影响差别很大(新版本不存在该问题,但需要注意谓词的位置不同依然有性能的差异)explain syntaxselect a.* from hits_v1 a left join visits_v2 b on a.CounterID = b.CounterIDhaving a.EventDate = '2014-03-17';# 最后一行变成了PREWHERE EventDate = '2014-03-17'explain syntaxselect a.* from hits_v1 a left join visits_v2 b on a.CounterID = b.CounterIDhaving b.StartDate = '2014-03-17';# 最后一行变成了WHERE StartDate = '2014-03-17'123456789尽量在join前进行where过滤,提升查询效率explain syntaxselect a.* from ( select * from hits_v1 where EventDate = '2014-03-17')a left join visits_v1 b on a.CounterID = b.CounterID;# PREWHERE EventDate = '2014-03-17'1234567on关联条件中不可有过滤条件# 报错,关联条件不可用来做过滤explain syntaxselect a.* from hits_v1 a left join visits_v2 b on a.CounterID = b.CounterIDand a.EventDate = '2014-03-17';12343.2.2.5 分布式表使用global两张分布式表上的in和join之前必须加上global关键字,右表只会在接收查询请求的那个节点查询一次,并将其分发到其他节点上。如果不加global关键字的话,每个节点都会单独发起一次对右表的查询,而右表又是分布式表,就导致右表一共会被查询N的2次方(N是分布式表的分片数量),这就是查询放大,会带来很大开销。可能会减小为N次。3.2.2.6 使用字典表将一些需要关联分析的业务创建成字典表进行join操作,前提字典表不宜太大,因为字典表会常驻内存。3.2.2.7 提前过滤通过增加逻辑过滤可以减少数据扫描,达到提高执行速度及降低内存消耗的目的。3.3 总结尽量不要用join能过滤先过滤,尤其是右表右边放小表特殊场景可以考虑使用字典表可以替换的话,尽量不要用join,比如用In实现参考:https://play.clickhouse.com/http://nicethemes.cn/news/txtlist_i169603v.html————————————————版权声明:本文为CSDN博主「囊萤映雪的萤」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。原文链接:https://blog.csdn.net/liuyingying0418/article/details/121618255
-
 【功能模块】kafka消费线程停止,并报错,报错日志在下面【操作步骤&问题现象】1、2、【截图信息】这是我们消费端kafka配置,看报错说group.instance.id问题不知道怎么回事【日志信息】(可选,上传日志内容或者附件)2022-07-04 10:53:51.550 ERROR [] [kafkaTopicNormalConsumer] com.cloudwalk.portal.config.HwMrsKafkaConfig$1[76] - [kafkaTopicNormalConsumer]: Error due toorg.apache.kafka.common.errors.FencedInstanceIdException: The broker rejected this static consumer since another consumer with the same group.instance.id has registered with a different member.id.2022-07-04 10:53:51.508 ERROR [] [kafkaTopicNormalConsumer] org.apache.kafka.clients.consumer.internals.AbstractCoordinator[1326] - [Consumer instanceId=mh_id_c, clientId=consumer-1-mh_id_c, groupId=1] Caught fenced group.instance.id Optional[mh_id_c] error in heartbeat thread2022-07-04 10:53:51.461 ERROR [] [kafkaTopicNormalConsumer] org.apache.kafka.clients.consumer.internals.AbstractCoordinator[1062] - [Consumer instanceId=mh_id_c, clientId=consumer-1-mh_id_c, groupId=1] Received fatal exception: group.instance.id gets fenced
-
 1. 没有开tomcat服务 在浏览器的地址栏中输入localhost:8080 回车会出现如下界面 tomcat没有开服务。在cmd中输入startup.bat。不要关闭开启的tomcat窗口。 2.输入url路径错误 在浏览器中输入url显示404,可能是输入的路径不存在或输入错误路径。 3. Java JDK环境变量未设置好 在cmd输入startup.bat时,报错。 如图: 解决方案: 这个是Java jdk的环境变量名设置不规范,将jdk的路径设置变量名必须是JAVA_HOME。 找到系统变量界面,更改错误的jdk变量名。 更改完后: 修改完之后,重新打开cmd在输入startup.bat就可以正常启动了 4.重复开启服务 服务已经开启,不需要重复打开。 5.端口被占用 通过网页访问出现 Access Error错误,端口被占用 打开cmd输入指令:将占用你所指定的端口号进程删掉netstat -ano :查看所有端口信息netstat ano | findstr "8080" :查看端口8080占用信息tasklist :查看所有进程tasklist | findstr "1": 查看某进程taskkill /f /pid 进程号: 删除某进程号到此这篇关于安装tomcat后可能出现的问题介绍的文章就介绍到这了转载自https://www.jb51.net/article/233667.htm
-
【操作步骤&问题现象】为Ubuntu20.04安装Xfce图形化界面,使用VNC连接,出现频繁卡死的情况。“卡死”:鼠标可以移动,但是不能操作界面。而且应用占用的CPU很低,即使kill掉当前进程,进程代表的应用退出界面,但是界面依旧处于卡死、无法操作的状态。目前每次卡死必须重启服务器才能解决问题,几乎无法进行有效的操作,请问这个问题该如何解决?【截图信息】下图展示了卡死时CPU使用情况:下图展示了屏幕卡死时的样子(无法操作):
-
 >摘要: J.U.C是Java并发编程中非常重要的工具包,今天,我们就来着重讲讲J.U.C里面的FutureTask、Fork/Join框架和BlockingQueue。 本文分享自华为云社区《[【高并发】J.U.C组件扩展](https://bbs.huaweicloud.com/blogs/353871?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content)》,作者: 冰 河 。 # FutureTask FutureTask是J.U.C(java.util.concurrent)下的,但不是AQS(AbstractQueuedSynchronizer)的子类。其对线程结果的处理值得借鉴和在项目中使用。 Thread和Runnable执行完任务无法获取执行结果。Java1.5开始提供了Callable和Future,通过它们可以在任务执行完毕之后,得到任务执行的结果。 # Callable与Runnable接口对比 Callable:泛型接口,提供一个call()方法,支持抛出异常,并且执行后有返回值 Runnable:接口,提供一个run()方法,不支持抛出异常,执行后无返回值 # Future接口 对于具体的Callable和Runnable任务,可以进行取消,查询任务是否被取消,查询是否完成以及获取结果等。 Future可以监视目标线程调用call()的情况,当调用Future的get()方法时,就可以获得结果。此时,执行任务的线程可能不会直接完成,当前线程就开始阻塞,直到call()方法结束返回结果,当前线程才会继续执行。总之,Future可以得到别的线程任务方法的返回值。 # FutureTask类 实现的接口为RunnableFuture,而RunnableFuture接口继承了Runnable和Future两个接口,所以FutureTask类最终也是执行Callable类型的任务。如果FutureTask类的构造方法参数是Runnable的话,会转换成Callable类型。 类实现了两个接口:Runnable和Future。所以,它即可以作为Runnable被线程执行,又可以作为Future得到Callable的返回值,这样设计的好处如下: 假设有一个很费时的逻辑,需要计算并且返回这个值,同时,这个值又不是马上需要,则可以使用Runnable和Future的组合,用另外一个线程去计算返回值,而当前线程在使用这个返回值之前,可以做其他的操作,等到需要这个返回值时,再通过Future得到。 Future示例代码如下: ``` package io.binghe.concurrency.example.aqs; import lombok.extern.slf4j.Slf4j; import java.util.concurrent.Callable; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; import java.util.concurrent.Future; @Slf4j public class FutureExample { static class MyCallable implements Callable{ @Override public String call() throws Exception { log.info("do something in callable"); Thread.sleep(5000); return "Done"; } } public static void main(String[] args) throws Exception { ExecutorService executorService = Executors.newCachedThreadPool(); Future future = executorService.submit(new MyCallable()); log.info("do something in main"); Thread.sleep(1000); String result = future.get(); log.info("result: {}", result); executorService.shutdown(); } } ``` FutureTask示例代码如下: ``` package io.binghe.concurrency.example.aqs; import lombok.extern.slf4j.Slf4j; import java.util.concurrent.Callable; import java.util.concurrent.FutureTask; @Slf4j public class FutureTaskExample { public static void main(String[] args) throws Exception{ FutureTask futureTask = new FutureTask(new Callable() { @Override public String call() throws Exception { log.info("do something in callable"); Thread.sleep(5000); return "Done"; } }); new Thread(futureTask).start(); log.info("do something in main"); Thread.sleep(1000); String result = futureTask.get(); log.info("result: {}", result); } } ``` # Fork/Join框架 位于J.U.C(java.util.concurrent)中,是Java7中提供的用于执行并行任务的框架,其可以将大任务分割成若干个小任务,最终汇总每个小任务的结果后得到最终结果。基本思想和Hadoop的MapReduce思想类似。 主要采用的是工作窃取算法(某个线程从其他队列里窃取任务来执行),并行分治计算中的一种Work-stealing策略 ## 为什么需要使用工作窃取算法呢? 假如我们需要做一个比较大的任务,我们可以把这个任务分割为若干互不依赖的子任务,为了减少线程间的竞争,于是把这些子任务分别放到不同的队列里,并为每个队列创建一个单独的线程来执行队列里的任务,线程和队列一一对应,比如A线程负责处理A队列里的任务。但是有的线程会先把自己队列里的任务干完,而其他线程对应的队列里还有任务等待处理。干完活的线程与其等着,不如去帮其他线程干活,于是它就去其他线程的队列里窃取一个任务来执行。而在这时它们会访问同一个队列,所以为了减少窃取任务线程和被窃取任务线程之间的竞争,通常会使用双端队列,被窃取任务线程永远从双端队列的头部拿任务执行,而窃取任务的线程永远从双端队列的尾部拿任务执行。 ## 工作窃取算法的优点: 充分利用线程进行并行计算,并减少了线程间的竞争 ## 工作窃取算法的缺点: 在某些情况下还是存在竞争,比如双端队列里只有一个任务时。并且该算法会消耗更多的系统资源,比如创建多个线程和多个双端队列。 对于Fork/Join框架而言,当一个任务正在等待它使用Join操作创建的子任务结束时,执行这个任务的工作线程查找其他未被执行的任务,并开始执行这些未被执行的任务,通过这种方式,线程充分利用它们的运行时间来提高应用程序的性能。为了实现这个目标,Fork/Join框架执行的任务有一些局限性。 ## Fork/Join框架局限性: (1)任务只能使用Fork和Join操作来进行同步机制,如果使用了其他同步机制,则在同步操作时,工作线程就不能执行其他任务了。比如,在Fork/Join框架中,使任务进行了睡眠,那么,在睡眠期间内,正在执行这个任务的工作线程将不会执行其他任务了。 (2)在Fork/Join框架中,所拆分的任务不应该去执行IO操作,比如:读写数据文件 (3)任务不能抛出检查异常,必须通过必要的代码来出来这些异常 Fork/Join框架的核心类 Fork/Join框架的核心是两个类:ForkJoinPool和ForkJoinTask。ForkJoinPool负责实现工作窃取算法、管理工作线程、提供关于任务的状态以及执行信息。ForkJoinTask主要提供在任务中执行Fork和Join操作的机制。 示例代码如下: ``` package io.binghe.concurrency.example.aqs; import lombok.extern.slf4j.Slf4j; import java.util.concurrent.ForkJoinPool; import java.util.concurrent.Future; import java.util.concurrent.RecursiveTask; @Slf4j public class ForkJoinTaskExample extends RecursiveTask { public static final int threshold = 2; private int start; private int end; public ForkJoinTaskExample(int start, int end) { this.start = start; this.end = end; } @Override protected Integer compute() { int sum = 0; //如果任务足够小就计算任务 boolean canCompute = (end - start) = threshold; if (canCompute) { for (int i = start; i = end; i++) { sum += i; } } else { // 如果任务大于阈值,就分裂成两个子任务计算 int middle = (start + end) / 2; ForkJoinTaskExample leftTask = new ForkJoinTaskExample(start, middle); ForkJoinTaskExample rightTask = new ForkJoinTaskExample(middle + 1, end); // 执行子任务 leftTask.fork(); rightTask.fork(); // 等待任务执行结束合并其结果 int leftResult = leftTask.join(); int rightResult = rightTask.join(); // 合并子任务 sum = leftResult + rightResult; } return sum; } public static void main(String[] args) { ForkJoinPool forkjoinPool = new ForkJoinPool(); //生成一个计算任务,计算1+2+3+4 ForkJoinTaskExample task = new ForkJoinTaskExample(1, 100); //执行一个任务 Future result = forkjoinPool.submit(task); try { log.info("result:{}", result.get()); } catch (Exception e) { log.error("exception", e); } } } ``` # BlockingQueue 阻塞队列,是线程安全的。 ## 被阻塞的情况如下: (1)当队列满时,进行入队列操作 (2)当队列空时,进行出队列操作 ## 使用场景如下: 主要在生产者和消费者场景 ## BlockingQueue的方法 BlockingQueue 具有 4 组不同的方法用于插入、移除以及对队列中的元素进行检查。如果请求的操作不能得到立即执行的话,每个方法的表现也不同。这些方法如下:  四组不同的行为方式解释: - 抛出异常 如果试图的操作无法立即执行,抛一个异常。 - 特殊值 如果试图的操作无法立即执行,返回一个特定的值(常常是 true / false)。 - 阻塞 如果试图的操作无法立即执行,该方法调用将会发生阻塞,直到能够执行。 - 超时 如果试图的操作无法立即执行,该方法调用将会发生阻塞,直到能够执行,但等待时间不会超过给定值。返回一个特定值以告知该操作是否成功(典型的是 true / false)。 ## BlockingQueue的实现类如下: - ArrayBlockingQueue:有界的阻塞队列(容量有限,必须在初始化的时候指定容量大小,容量大小指定后就不能再变化),内部实现是一个数组,以FIFO的方式存储数据,最新插入的对象是尾部,最新移除的对象是头部。 - DelayQueue:阻塞的是内部元素,DelayQueue中的元素必须实现一个接口——Delayed(存在于J.U.C下)。Delayed接口继承了Comparable接口,这是因为Delayed接口中的元素需要进行排序,一般情况下,都是按照Delayed接口中的元素过期时间的优先级进行排序。应用场景主要有:定时关闭连接、缓存对象、超时处理等。内部实现使用PriorityQueue和ReentrantLock。 - LinkedBlockingQueue:大小配置是可选的,如果初始化时指定了大小,则是有边界的;如果初始化时未指定大小,则是无边界的(其实默认大小是Integer类型的最大值)。内部实现时一个链表,以FIFO的方式存储数据,最新插入的对象是尾部,最新移除的对象是头部。 - PriorityBlockingQueue:带优先级的阻塞队列,无边界,但是有排序规则,允许插入空对象(也就是null)。所有插入的对象必须实现Comparable接口,队列优先级的排序规则就是按照对Comparable接口的实现来定义的。可以从PriorityBlockingQueue中获得一个迭代器Iterator,但这个迭代器并不保证按照优先级的顺序进行迭代。 - SynchronousQueue:队列内部仅允许容纳一个元素,当一个线程插入一个元素后,就会被阻塞,除非这个元素被另一个线程消费。因此,也称SynchronousQueue为同步队列。SynchronousQueue是一个无界非缓存的队列。准确的说,它不存储元素,放入元素只有等待取走元素之后,才能再次放入元素
-
【问题现象】1、现场单实例故障,手动拉起build实例后实例状态显示build failed,反复重试后此问题仍然存在2、某节点所有实例down unkown与starting状态来回切换【原因分析】1、现场查看gs_ctl 日志无报错,异常中断2、现场手动拉起build后发现gs_ctl进程报错退出,查看此节点进程存在停止此节点命令3、查看父进程调用为mpp-stop.sh脚本调起4、此脚本为线下纯软版本慢节点检测特性,现场将此脚本停止节点功能注释后重新拉起注:集群升级补丁等变更会使用此脚本,待build完成后需要回退5、注释以上脚本后重新拉起build正常,待build完后回退即可
-
一、内存相关命令1、free – 显示系统内存使用量情况free命令的功能是显示系统内存使用量情况,包含物理和交换内存的总量、使用量和空闲量情况。语法格式free [参数]1常用参数参数 解析-b 以Byte显示内存使用情况-k 以kb为单位显示内存使用情况-m 以mb为单位显示内存使用情况-g 以gb为单位显示内存使用情况-s 持续显示内存-t 显示内存使用总合-h 以易读的单位方式显示内存使用情况参考实例以默认的容量单位显示内存使用量信息:[root@root ~]# free total used free shared buff/cache availableMem: 65353144 8354168 53956676 39716 3042300 56522796Swap: 0 0 0以MB位单位显示内存使用量信息:[root@root ~]# free -m total used free shared buff/cache availableMem: 63821 8154 52696 38 2971 55202Swap: 0 0 0以易读的单位显示内存使用量信息:[root@root ~]# free -h total used free shared buff/cache availableMem: 62G 8.0G 51G 38M 2.9G 53GSwap: 0B 0B 0B以易读的单位显示内存使用量信息,每个10秒刷新一次:[root@root ~]# free -hs 10 total used free shared buff/cache availableMem: 62G 8.0G 51G 38M 2.9G 53GSwap: 0B 0B 0B total used free shared buff/cache availableMem: 62G 8.0G 51G 38M 2.9G 53GSwap: 0B 0B 0B字段解析#total:物理内存大小,就是机器实际的内存#used:已使用的内存大小,这个值包括了cached和应用程序实际使用的内存#free:未被使用的内存大小(俗称:空闲内存)#shared:共享内存大小,是进程间通信的一种方式#buffers:被缓冲区占用的内存大小#cached:被缓存占用的内存大小2、cat /proc/meminfomeminfo中包含所有的内存相关信息。[root@root ~]# cat /proc/meminfo MemTotal: 65353144 kBMemFree: 53956672 kBMemAvailable: 56523144 kBBuffers: 49180 kBCached: 2889216 kBSwapCached: 0 kBActive: 7603092 kBInactive: 2691064 kBActive(anon): 7356648 kBInactive(anon): 38800 kBActive(file): 246444 kBInactive(file): 2652264 kBUnevictable: 0 kBMlocked: 0 kBSwapTotal: 0 kBSwapFree: 0 kBDirty: 36 kBWriteback: 0 kBAnonPages: 7360372 kBMapped: 764500 kBShmem: 39684 kBSlab: 306384 kBSReclaimable: 104216 kBSUnreclaim: 202168 kBKernelStack: 22464 kBPageTables: 30644 kBNFS_Unstable: 0 kBBounce: 0 kBWritebackTmp: 0 kBCommitLimit: 32676572 kB #系统中可以申请的虚拟内存最大值Committed_AS: 27883644 kB #系统已经申请的虚拟内存VmallocTotal: 34359738367 kBVmallocUsed: 525916 kBVmallocChunk: 34325372924 kBHardwareCorrupted: 0 kBAnonHugePages: 4573184 kBCmaTotal: 0 kBCmaFree: 0 kBHugePages_Total: 0HugePages_Free: 0HugePages_Rsvd: 0HugePages_Surp: 0Hugepagesize: 2048 kBDirectMap4k: 771124 kBDirectMap2M: 11393024 kBDirectMap1G: 56623104 kB二、内存相关问题1、内存泄漏解析:如果程序运行过程中不能正常回收不用的内存,那么一段时间就会导致内存增长很高,最终导致系统不可以用,这种情况称为内存泄漏。内存泄漏可以使用内存分享工具valgrind进行内存分析。[root@root ~]# yum -y install valgrind[root@root ~]# valgrind --tool=memcheck ./mem_leak -t==1738== Memcheck, a memory error detector==1738== Copyright (C) 2002-2017, and GNU GPL'd, by Julian Seward et al.==1738== Using Valgrind-3.13.0 and LibVEX; rerun with -h for copyright info==1738== Command: ./mem_leak -t==1738== ==1738== ==1738== HEAP SUMMARY:==1738== in use at exit: 4 bytes in 1 blocks==1738== total heap usage: 1 allocs, 0 frees, 4 bytes allocated==1738== ==1738== LEAK SUMMARY:==1738== definitely lost: 4 bytes in 1 blocks==1738== indirectly lost: 0 bytes in 0 blocks==1738== possibly lost: 0 bytes in 0 blocks==1738== still reachable: 0 bytes in 0 blocks==1738== suppressed: 0 bytes in 0 blocks==1738== Rerun with --leak-check=full to see details of leaked memory==1738== ==1738== For counts of detected and suppressed errors, rerun with: -v==1738== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)2、虚拟内存、物理内存内存的最小单位为页(paging),默认情况一页是4K。虚拟内存与物理内存 当进程向操作系统申请10G内存时,操作系统收到请求后先进行自我检查,经过分析后决定给予进程10G内存空间,但是系统此时并没有真正给进程10G,系统会判断进程运行实际需要的内存大小,比如该进程需要300M就够用了,所以系统只划分300M内存给进程运行,这种实际分配的内存称为物理内存。[root@root ~]# ps aux|head -1USER PID %CPU %MEM VSZ RSS TTY STAT START TIME COMMAND#VSZ 虚拟内存#RSS 物理内存3、内存溢出内存溢出(out of memory,OOM),当进程运行向系统申请内存时,系统没有更多的进程分配给该进程了,就会出现内存溢出。内存溢出后系统会杀掉系统中的一些进程来释放内存,通常OOM Killer杀死的都是占用内存较多的服务,直到内存够用为止,所以内存溢出的直观现象通常是某些服务异常或宕机。当发生内存溢出后可以通过dmesg命令或者通过/var/log/messages来快速确定。[root@root ~]# dmesg |tail -5[ 3613.796390] [ 1277] 0 1277 28983 1 16 217 0 bash[ 3613.796393] [ 1446] 0 1446 29003 0 16 221 0 bash[ 3613.796395] [ 1546] 0 1546 774216 213712 1439 513149 0 python[ 3613.796396] Out of memory: Kill process 1546 (python) score 912 or sacrifice child[ 3613.796422] Killed process 1546 (python) total-vm:3096864kB, anon-rss:854848kB, file-rss:0kB, shmem-rss:0kB[root@root ~]# cat /proc/sys/vm/panic_on_oom [root@root ~]# echo 1 > /proc/sys/vm/panic_on_oompanic_on_oom该参数的值共有三个选项:0是触发oom killer进行杀进程处理(/proc/sys/vm/oom_kill_allocating_task默认值为0,结束占用内存多的进程;如果设置为1,就杀死当前申请内存的进程)2是直接触发kernel panic(类似于Windows的蓝屏),此时系统开发人员可以连接进行debug,但是对其他人并没有什么用。更多希望系统快速重启(/proc/sys/kernel/panic设置多少秒后重启)1是根据不同情况会有不同处理;4、Overcommit一般情况下,进程并不会一次用光申请的内存,所以操作系统为了提高内存使用率,会向进程“超卖”内存,以便能响应更多的进程内存申请。但是为了保证程序的稳定运行,系统并不会无限制响应内存申请,这样可以防止内存申请过多,导致系统本身内存空间不足而无法正常运行。Linux系统中使用OverCommit的方式控制内存的申请。内核参数overcommit_memory 内存分配策略可选值:0、1、2。0, 表示内核将检查是否有足够的可用内存供应用进程使用;如果有足够的可用内存,内存申请允许;否则,引发OOM。1, 表示内核允许分配所有的物理内存,而不管当前的内存状态如何。2, 表示内核不允许进程申请超过系统设置大小的内存空间。在这种模式下,系统设置的可申请内存空间大小为:Swap+RAM*(“/proc/sys/vm/overcommit_ratio”/100)说明:/proc/sys/vm/overcommit_ratio就是系统最大可以分配内存的百分比,默认是50.总结 相关文章【Linux】之【CPU】相关的命令及解析[lscpu、mpstat]【Linux】之【内存】相关的命令&&解析以及内存相关的问题[free、meminfo、内存泄漏、内存溢出、Overcommit]【Linux】之【磁盘】相关的命令及解析[df、du、iostat、iotop]【Linux】之【网络】相关的命令及解析[ethtool、nload、nethogs、iftop、iptraf、ifstat]【Linux】综合性命令及解析【top、htop、vmstat、dstat、glances、sar】【Linux】系统如何查看服务器带宽及网络使用情况原文链接:https://blog.csdn.net/liu_chen_yang/article/details/125146057
-
01 死锁的概念在多线程编程中,我们为了防止多线程竞争共享资源而导致数据错乱,都会在操作共享资源之前加上互斥锁,只有成功获得到锁的线程,才能操作共享资源,获取不到锁的线程就只能等待,直到锁被释放。那么,当两个线程为了保护两个不同的共享资源而使用了两个互斥锁,那么这两个互斥锁应用不当的时候,可能会造成两个线程都在等待对方释放锁,在没有外力的作用下,这些线程会一直相互等待,就没办法继续运行,这种情况就是发生了死锁。举个例子,小林拿了小美房间的钥匙,而小林在自己的房间里,小美拿了小林房间的钥匙,而小美也在自己的房间里。如果小林要从自己的房间里出去,必须拿到小美手中的钥匙,但是小美要出去,又必须拿到小林手中的钥匙,这就形成了死锁。死锁只有同时满足以下四个条件才会发生:互斥条件;持有并等待条件;不可剥夺条件;环路等待条件;1.1 互斥条件互斥条件是指多个线程不能同时使用同一个资源。比如下图,如果线程 A 已经持有的资源,不能再同时被线程 B 持有,如果线程 B 请求获取线程 A 已经占用的资源,那线程 B 只能等待,直到线程 A 释放了资源。1.2 持有并等待条件持有并等待条件是指,当线程 A 已经持有了资源 1,又想申请资源 2,而资源 2 已经被线程 C 持有了,所以线程 A 就会处于等待状态,但是线程 A 在等待资源 2 的同时并不会释放自己已经持有的资源 1。1.3 不可剥夺条件不可剥夺条件是指,当线程已经持有了资源 ,在自己使用完之前不能被其他线程获取,线程 B 如果也想使用此资源,则只能在线程 A 使用完并释放后才能获取。1.4 环路等待条件环路等待条件指都是,在死锁发生的时候,两个线程获取资源的顺序构成了环形链。比如,线程 A 已经持有资源 2,而想请求资源 1, 线程 B 已经获取了资源 1,而想请求资源 2,这就形成资源请求等待的环形图02 模拟死锁问题的产生Talk is cheap. Show me the code.下面,我们用代码来模拟死锁问题的产生。首先,我们先创建 2 个线程,分别为线程 A 和 线程 B,然后有两个互斥锁,分别是 mutex_A 和 mutex_B,代码如下:pthread_mutex_t mutex_A = PTHREAD_MUTEX_INITIALIZER;pthread_mutex_t mutex_B = PTHREAD_MUTEX_INITIALIZER;int main(){ pthread_t tidA, tidB; //创建两个线程 pthread_create(&tidA, NULL, threadA_proc, NULL); pthread_create(&tidB, NULL, threadB_proc, NULL); pthread_join(tidA, NULL); pthread_join(tidB, NULL); printf("exit\n"); return 0;}接下来,我们看下线程 A 函数做了什么。//线程函数 Avoid *threadA_proc(void *data){ printf("thread A waiting get ResourceA \n"); pthread_mutex_lock(&mutex_A); printf("thread A got ResourceA \n"); sleep(1); printf("thread A waiting get ResourceB \n"); pthread_mutex_lock(&mutex_B); printf("thread A got ResourceB \n"); pthread_mutex_unlock(&mutex_B); pthread_mutex_unlock(&mutex_A); return (void *)0;}可以看到,线程 A 函数的过程:先获取互斥锁 A,然后睡眠 1 秒;再获取互斥锁 B,然后释放互斥锁 B;最后释放互斥锁 A;//线程函数 Bvoid *threadB_proc(void *data){ printf("thread B waiting get ResourceB \n"); pthread_mutex_lock(&mutex_B); printf("thread B got ResourceB \n"); sleep(1); printf("thread B waiting get ResourceA \n"); pthread_mutex_lock(&mutex_A); printf("thread B got ResourceA \n"); pthread_mutex_unlock(&mutex_A); pthread_mutex_unlock(&mutex_B); return (void *)0;}可以看到,线程 B 函数的过程:先获取互斥锁 B,然后睡眠 1 秒;再获取互斥锁 A,然后释放互斥锁 A;最后释放互斥锁 B;然后,我们运行这个程序,运行结果如下:thread B waiting get ResourceB thread B got ResourceB thread A waiting get ResourceA thread A got ResourceA thread B waiting get ResourceA thread A waiting get ResourceB // 阻塞中。。。可以看到线程 B 在等待互斥锁 A 的释放,线程 A 在等待互斥锁 B 的释放,双方都在等待对方资源的释放,很明显,产生了死锁问题。03 利用工具排查死锁问题如果你想排查你的 Java 程序是否死锁,则可以使用 jstack 工具,它是 jdk 自带的线程堆栈分析工具。由于小林的死锁代码例子是 C 写的,在 Linux 下,我们可以使用 pstack + gdb 工具来定位死锁问题。pstack 命令可以显示每个线程的栈跟踪信息(函数调用过程),它的使用方式也很简单,只需要 pstack <pid> 就可以了。那么,在定位死锁问题时,我们可以多次执行 pstack 命令查看线程的函数调用过程,多次对比结果,确认哪几个线程一直没有变化,且是因为在等待锁,那么大概率是由于死锁问题导致的。我用 pstack 输出了我前面模拟死锁问题的进程的所有线程的情况,我多次执行命令后,其结果都一样可以看到,Thread 2 和 Thread 3 一直阻塞获取锁(pthread_mutex_lock)的过程,而且 pstack 多次输出信息都没有变化,那么可能大概率发生了死锁。但是,还不能够确认这两个线程是在互相等待对方的锁的释放,因为我们看不到它们是等在哪个锁对象,于是我们可以使用 gdb 工具进一步确认。整个 gdb 调试过程,如下:// gdb 命令$ gdb -p 87746// 打印所有的线程信息(gdb) info thread 3 Thread 0x7f60a610a700 (LWP 87747) 0x0000003720e0da1d in __lll_lock_wait () from /lib64/libpthread.so.0 2 Thread 0x7f60a5709700 (LWP 87748) 0x0000003720e0da1d in __lll_lock_wait () from /lib64/libpthread.so.0* 1 Thread 0x7f60a610c700 (LWP 87746) 0x0000003720e080e5 in pthread_join () from /lib64/libpthread.so.0//最左边的 * 表示 gdb 锁定的线程,切换到第二个线程去查看// 切换到第2个线程(gdb) thread 2[Switching to thread 2 (Thread 0x7f60a5709700 (LWP 87748))]#0 0x0000003720e0da1d in __lll_lock_wait () from /lib64/libpthread.so.0 // bt 可以打印函数堆栈,却无法看到函数参数,跟 pstack 命令一样 (gdb) bt#0 0x0000003720e0da1d in __lll_lock_wait () from /lib64/libpthread.so.0#1 0x0000003720e093ca in _L_lock_829 () from /lib64/libpthread.so.0#2 0x0000003720e09298 in pthread_mutex_lock () from /lib64/libpthread.so.0#3 0x0000000000400792 in threadB_proc (data=0x0) at dead_lock.c:25#4 0x0000003720e07893 in start_thread () from /lib64/libpthread.so.0#5 0x00000037206f4bfd in clone () from /lib64/libc.so.6// 打印第三帧信息,每次函数调用都会有压栈的过程,而 frame 则记录栈中的帧信息(gdb) frame 3#3 0x0000000000400792 in threadB_proc (data=0x0) at dead_lock.c:2527 printf("thread B waiting get ResourceA \n");28 pthread_mutex_lock(&mutex_A);// 打印mutex_A的值 , __owner表示gdb中标示线程的值,即LWP(gdb) p mutex_A$1 = {__data = {__lock = 2, __count = 0, __owner = 87747, __nusers = 1, __kind = 0, __spins = 0, __list = {__prev = 0x0, __next = 0x0}}, __size = "\002\000\000\000\000\000\000\000\303V\001\000\001", '\000' <repeats 26 times>, __align = 2}// 打印mutex_B的值 , __owner表示gdb中标示线程的值,即LWP(gdb) p mutex_B$2 = {__data = {__lock = 2, __count = 0, __owner = 87748, __nusers = 1, __kind = 0, __spins = 0, __list = {__prev = 0x0, __next = 0x0}}, __size = "\002\000\000\000\000\000\000\000\304V\001\000\001", '\000' <repeats 26 times>, __align = 2}我来解释下,上面的调试过程:通过 info thread 打印了所有的线程信息,可以看到有 3 个 线程,一个是主线程(LWP 87746),另外两个都是我们自己创建的线程(LWP 87747 和 87748);通过 thread 2,将切换到第2个线程(LWP 87748);通过 bt,打印线程的调用栈信息,可以看到有 threadB_proc 函数,说明这个是线程B函数,也就说 LWP 87748 是线程 B;通过 frame 3,打印调用栈中的第三个帧的信息,可以看到线程 B 函数,在获取互斥锁 A 的时候阻塞了;通过 p mutex_A,打印互斥锁 A 对象信息,可以看到它被 LWP 为 87747(线程 A) 的线程持有者;通过 p mutex_B,打印互斥锁 A 对象信息,可以看到他被 LWP 为 87748 (线程 B) 的线程持有者;因为线程 B 在等待线程 A 所持有的 mutex_A, 而同时线程 A 又在等待线程 B 所拥有的mutex_B, 所以可以断定该程序发生了死锁04 避免死锁问题的发生前面我们提到,产生死锁的四个必要条件是:互斥条件、持有并等待条件、不可剥夺条件、环路等待条件。那么避免死锁问题就只需要破环其中一个条件就可以,最常见的并且可行的就是使用资源有序分配法,来破环环路等待条件。那什么是资源有序分配法呢?线程 A 和 线程 B 获取资源的顺序要一样,当线程 A 是先尝试获取资源 A,然后尝试获取资源 B 的时候,线程 B 同样也是先尝试获取资源 A,然后尝试获取资源 B。也就是说,线程 A 和 线程 B 总是以相同的顺序申请自己想要的资源。我们使用资源有序分配法的方式来修改前面发生死锁的代码,我们可以不改动线程 A 的代码。我们先要清楚线程 A 获取资源的顺序,它是先获取互斥锁 A,然后获取互斥锁 B。所以我们只需将线程 B 改成以相同顺序地获取资源,就可以打破死锁了。总结简单来说,死锁问题的产生是由两个或者以上线程并行执行的时候,争夺资源而互相等待造成的。死锁只有同时满足互斥、持有并等待、不可剥夺、环路等待这四个条件的时候才会发生。所以要避免死锁问题,就是要破坏其中一个条件即可,最常用的方法就是使用资源有序分配法来破坏环路等待条件。
-
>摘要:本文我们就来说说使用ReadWriteLock如何实现一个通用的缓存中心。 本文分享自华为云社区《[【高并发】原来ReadWriteLock也能开发高性能缓存,看完我也能和面试官好好聊聊了!](https://bbs.huaweicloud.com/blogs/357370?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content)》,作者: 冰 河。 在实际工作中,有一种非常普遍的并发场景:那就是读多写少的场景。在这种场景下,为了优化程序的性能,我们经常使用缓存来提高应用的访问性能。因为缓存非常适合使用在读多写少的场景中。而在并发场景中,Java SDK中提供了ReadWriteLock来满足读多写少的场景。本文我们就来说说使用ReadWriteLock如何实现一个通用的缓存中心。 本文涉及的知识点有: 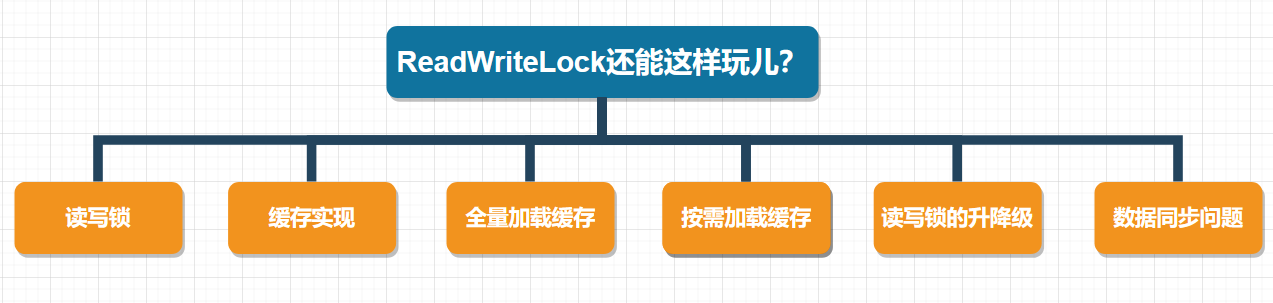 # 读写锁 说起读写锁,相信小伙伴们并不陌生。总体来说,读写锁需要遵循以下原则: - 一个共享变量允许同时被多个读线程读取到。 - 一个共享变量在同一时刻只能被一个写线程进行写操作。 - 一个共享变量在被写线程执行写操作时,此时这个共享变量不能被读线程执行读操作。 **这里,需要小伙伴们注意的是:读写锁和互斥锁的一个重要的区别就是:读写锁允许多个线程同时读共享变量,而互斥锁不允许。所以,在高并发场景下,读写锁的性能要高于互斥锁。但是,读写锁的写操作是互斥的,也就是说,使用读写锁时,一个共享变量在被写线程执行写操作时,此时这个共享变量不能被读线程执行读操作。** 读写锁支持公平模式和非公平模式,具体是在ReentrantReadWriteLock的构造方法中传递一个boolean类型的变量来控制。 ``` public ReentrantReadWriteLock(boolean fair) { sync = fair ? new FairSync() : new NonfairSync(); readerLock = new ReadLock(this); writerLock = new WriteLock(this); } ``` **另外,需要注意的一点是:在读写锁中,读锁调用newCondition()会抛出UnsupportedOperationException异常,也就是说:读锁不支持条件变量。** # 缓存实现 这里,我们使用ReadWriteLock快速实现一个缓存的通用工具类,总体代码如下所示。 ``` public class ReadWriteLockCache { private final Map m = new HashMap(); private final ReadWriteLock rwl = new ReentrantReadWriteLock(); // 读锁 private final Lock r = rwl.readLock(); // 写锁 private final Lock w = rwl.writeLock(); // 读缓存 public V get(K key) { r.lock(); try { return m.get(key); } finally { r.unlock(); } } // 写缓存 public V put(K key, V value) { w.lock(); try { return m.put(key, value); } finally { w.unlock(); } } } ``` 可以看到,在ReadWriteLockCache中,我们定义了两个泛型类型,K代表缓存的Key,V代表缓存的value。在ReadWriteLockCache类的内部,我们使用Map来缓存相应的数据,小伙伴都都知道HashMap并不是线程安全的类,所以,这里使用了读写锁来保证线程的安全性,例如,我们在get()方法中使用了读锁,get()方法可以被多个线程同时执行读操作;put()方法内部使用写锁,也就是说,put()方法在同一时刻只能有一个线程对缓存进行写操作。 **这里需要注意的是**:无论是读锁还是写锁,锁的释放操作都需要放到finally{}代码块中。 在以往的经验中,有两种向缓存中加载数据的方式,**一种是:项目启动时,将数据全量加载到缓存中,一种是在项目运行期间,按需加载所需要的缓存数据。** 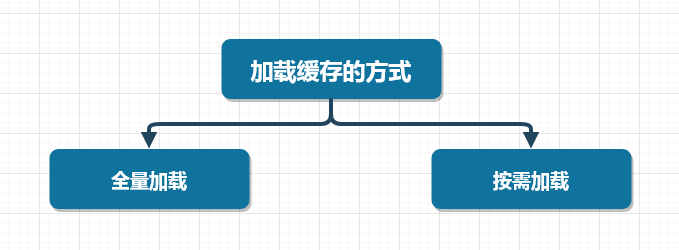 接下来,我们就分别来看看全量加载缓存和按需加载缓存的方式。 # 全量加载缓存 全量加载缓存相对来说比较简单,就是在项目启动的时候,将数据一次性加载到缓存中,这种情况适用于缓存数据量不大,数据变动不频繁的场景,例如:可以缓存一些系统中的数据字典等信息。整个缓存加载的大体流程如下所示。 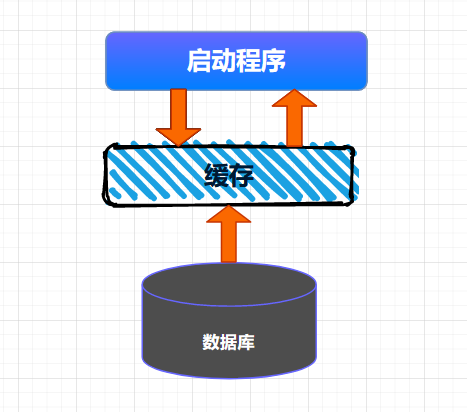 将数据全量加载到缓存后,后续就可以直接从缓存中读取相应的数据了。 全量加载缓存的代码实现比较简单,这里,我就直接使用如下代码进行演示。 ``` public class ReadWriteLockCache { private final Map m = new HashMap(); private final ReadWriteLock rwl = new ReentrantReadWriteLock(); // 读锁 private final Lock r = rwl.readLock(); // 写锁 private final Lock w = rwl.writeLock(); public ReadWriteLockCache(){ //查询数据库 List> list = .....; if(!CollectionUtils.isEmpty(list)){ list.parallelStream().forEach((f) ->{ m.put(f.getK(), f.getV); }); } } // 读缓存 public V get(K key) { r.lock(); try { return m.get(key); } finally { r.unlock(); } } // 写缓存 public V put(K key, V value) { w.lock(); try { return m.put(key, value); } finally { w.unlock(); } } } ``` # 按需加载缓存 按需加载缓存也可以叫作懒加载,就是说:需要加载的时候才会将数据加载到缓存。具体来说:就是程序启动的时候,不会将数据加载到缓存,当运行时,需要查询某些数据,首先检测缓存中是否存在需要的数据,如果存在,则直接读取缓存中的数据,如果不存在,则到数据库中查询数据,并将数据写入缓存。后续的读取操作,因为缓存中已经存在了相应的数据,直接返回缓存的数据即可。 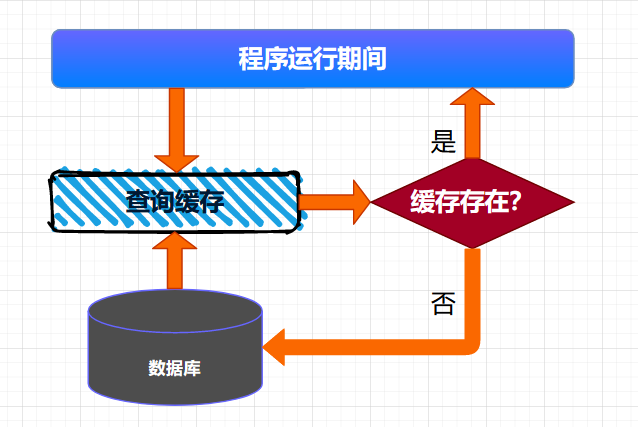 这种查询缓存的方式适用于大多数缓存数据的场景。 我们可以使用如下代码来表示按需查询缓存的业务。 ``` class ReadWriteLockCache { private final Map m = new HashMap(); private final ReadWriteLock rwl = new ReentrantReadWriteLock(); private final Lock r = rwl.readLock(); private final Lock w = rwl.writeLock(); V get(K key) { V v = null; //读缓存 r.lock(); try { v = m.get(key); } finally{ r.unlock(); } //缓存中存在,返回 if(v != null) { return v; } //缓存中不存在,查询数据库 w.lock(); try { //再次验证缓存中是否存在数据 v = m.get(key); if(v == null){ //查询数据库 v=从数据库中查询出来的数据 m.put(key, v); } } finally{ w.unlock(); } return v; } } ``` 这里,在get()方法中,首先从缓存中读取数据,此时,我们对查询缓存的操作添加了读锁,查询返回后,进行解锁操作。判断缓存中返回的数据是否为空,不为空,则直接返回数据;如果为空,则获取写锁,之后再次从缓存中读取数据,如果缓存中不存在数据,则查询数据库,将结果数据写入缓存,释放写锁。最终返回结果数据。 **这里,有小伙伴可能会问:为啥程序都已经添加写锁了,在写锁内部为啥还要查询一次缓存呢?** 这是因为在高并发的场景下,可能会存在多个线程来竞争写锁的现象。例如:第一次执行get()方法时,缓存中的数据为空。如果此时有三个线程同时调用get()方法,同时运行到 w.lock()代码处,由于写锁的排他性。此时只有一个线程会获取到写锁,其他两个线程则阻塞在w.lock()处。获取到写锁的线程继续往下执行查询数据库,将数据写入缓存,之后释放写锁。 此时,另外两个线程竞争写锁,某个线程会获取到锁,继续往下执行,如果在w.lock()后没有v = m.get(key); 再次查询缓存的数据,则这个线程会直接查询数据库,将数据写入缓存后释放写锁。最后一个线程同样会按照这个流程执行。 这里,实际上第一个线程已经查询过数据库,并且将数据写入缓存了,其他两个线程就没必要再次查询数据库了,直接从缓存中查询出相应的数据即可。所以,在w.lock()后添加v = m.get(key); 再次查询缓存的数据,能够有效的减少高并发场景下重复查询数据库的问题,提升系统的性能。 # 读写锁的升降级 **关于锁的升降级,小伙伴们需要注意的是:在ReadWriteLock中,锁是不支持升级的,因为读锁还未释放时,此时获取写锁,就会导致写锁永久等待,相应的线程也会被阻塞而无法唤醒。** 虽然不支持锁升级,但是ReadWriteLock支持锁降级,例如,我们来看看官方的ReentrantReadWriteLock示例,如下所示。 ``` class CachedData { Object data; volatile boolean cacheValid; final ReentrantReadWriteLock rwl = new ReentrantReadWriteLock(); void processCachedData() { rwl.readLock().lock(); if (!cacheValid) { // Must release read lock before acquiring write lock rwl.readLock().unlock(); rwl.writeLock().lock(); try { // Recheck state because another thread might have // acquired write lock and changed state before we did. if (!cacheValid) { data = ... cacheValid = true; } // Downgrade by acquiring read lock before releasing write lock rwl.readLock().lock(); } finally { rwl.writeLock().unlock(); // Unlock write, still hold read } } try { use(data); } finally { rwl.readLock().unlock(); } } }} ``` # 数据同步问题 首先,这里说的数据同步指的是数据源和数据缓存之间的数据同步,说的再直接一点,就是数据库和缓存之间的数据同步。 这里,我们可以采取三种方案来解决数据同步的问题,如下图所示 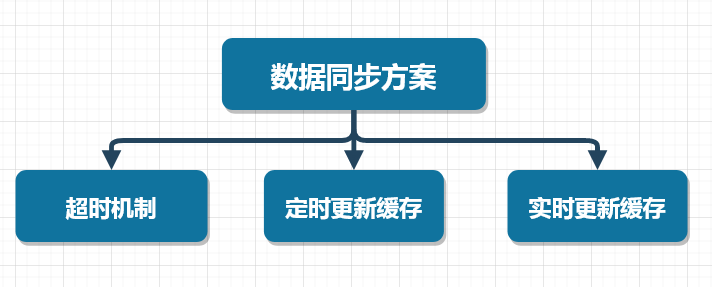 ## 超时机制 这个比较好理解,就是在向缓存写入数据的时候,给一个超时时间,当缓存超时后,缓存的数据会自动从缓存中移除,此时程序再次访问缓存时,由于缓存中不存在相应的数据,查询数据库得到数据后,再将数据写入缓存。采用这种方案需要注意缓存的穿透问题。 ## 定时更新缓存 这种方案是超时机制的增强版,在向缓存中写入数据的时候,同样给一个超时时间。与超时机制不同的是,在程序后台单独启动一个线程,定时查询数据库中的数据,然后将数据写入缓存中,这样能够在一定程度上避免缓存的穿透问题。 ## 实时更新缓存 这种方案能够做到数据库中的数据与缓存的数据是实时同步的,可以使用阿里开源的Canal框架实现MySQL数据库与缓存数据的实时同步。
-
https://support.huaweicloud.com/tngg-kunpenghpcs/kunpenghpcsolution_05_0026.html 在这里看到了IPM,请问ipm该怎么安装和使用?
-
 链接:https://bbs.huaweicloud.com/blogs/354287Strace 是一个调试工具,可以帮助您解决问题。Strace 监控特定程序的系统调用和信号。当您没有源代码并想调试程序的执行时,它会很有帮助。strace 为您提供二进制文件从头到尾的执行顺序。本文解释了 7 个 strace 示例以帮助您入门。1. 跟踪可执行文件的执行您可以使用 strace 命令来跟踪任何可执行文件的执行。以下示例显示了 Linux ls 命令的 strace 输出。$ strace ls execve("/bin/ls", ["ls"], [/* 21 vars */]) = 0 brk(0) = 0x8c31000 access("/etc/ld.so.nohwcap", F_OK) = -1 ENOENT (No such file or directory) mmap2(NULL, 8192, PROT_READ, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0xb78c7000 access("/etc/ld.so.preload", R_OK) = -1 ENOENT (No such file or directory) open("/etc/ld.so.cache", O_RDONLY) = 3 fstat64(3, {st_mode=S_IFREG|0644, st_size=65354, ...}) = 0 ... ... ...2. 使用选项 -e 跟踪可执行文件中的特定系统调用默认情况下,strace 显示给定可执行文件的所有系统调用。要仅显示特定的系统调用,请使用 strace -e 选项,如下所示。$ strace -e open ls open("/etc/ld.so.cache", O_RDONLY) = 3 open("/lib/libselinux.so.1", O_RDONLY) = 3 open("/lib/librt.so.1", O_RDONLY) = 3 open("/lib/libacl.so.1", O_RDONLY) = 3 open("/lib/libc.so.6", O_RDONLY) = 3 open("/lib/libdl.so.2", O_RDONLY) = 3 open("/lib/libpthread.so.0", O_RDONLY) = 3 open("/lib/libattr.so.1", O_RDONLY) = 3 open("/proc/filesystems", O_RDONLY|O_LARGEFILE) = 3 open("/usr/lib/locale/locale-archive", O_RDONLY|O_LARGEFILE) = 3 open(".", O_RDONLY|O_NONBLOCK|O_LARGEFILE|O_DIRECTORY|O_CLOEXEC) = 3 Desktop Documents Downloads examples.desktop libflashplayer.so Music Pictures Public Templates Ubuntu_OS Videos上面的输出只显示了 ls 命令的 open 系统调用。在 strace 输出的末尾,它还显示 ls 命令的输出。如果要跟踪多个系统调用,请使用“-e trace=”选项。以下示例显示了 open 和 read 系统调用。$ strace -e trace=open,read ls /home open("/etc/ld.so.cache", O_RDONLY) = 3 open("/lib/libselinux.so.1", O_RDONLY) = 3 read(3, "\177ELF\1\1\1\3\3\1\260G004"..., 512) = 512 open("/lib/librt.so.1", O_RDONLY) = 3 read(3, "\177ELF\1\1\1\3\3\1\300\30004"..., 512) = 512 .. open("/lib/libattr.so.1", O_RDONLY) = 3 read(3, "\177ELF\1\1\1\3\3\1\360\r004"..., 512) = 512 open("/proc/filesystems", O_RDONLY|O_LARGEFILE) = 3 read(3, "nodev\tsysfs\nnodev\trootfs\nnodev\tb"..., 1024) = 315 read(3, "", 1024) = 0 open("/usr/lib/locale/locale-archive", O_RDONLY|O_LARGEFILE) = 3 open("/home", O_RDONLY|O_NONBLOCK|O_LARGEFILE|O_DIRECTORY|O_CLOEXEC) = 3 bala3. 使用选项 -o 将跟踪执行保存到文件以下示例将 strace 输出存储到 output.txt 文件。$ strace -o output.txt ls Desktop Documents Downloads examples.desktop libflashplayer.so Music output.txt Pictures Public Templates Ubuntu_OS Videos $ cat output.txt execve("/bin/ls", ["ls"], [/* 37 vars */]) = 0 brk(0) = 0x8637000 access("/etc/ld.so.nohwcap", F_OK) = -1 ENOENT (No such file or directory) mmap2(NULL, 8192, PROT_READ, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0xb7860000 access("/etc/ld.so.preload", R_OK) = -1 ENOENT (No such file or directory) open("/etc/ld.so.cache", O_RDONLY) = 3 fstat64(3, {st_mode=S_IFREG|0644, st_size=67188, ...}) = 0 ... ...4. 使用选项 -p 在正在运行的 Linux 进程上执行 Strace您可以使用进程 ID 在已经运行的程序上执行 strace。首先,使用ps 命令识别程序的 PID 。例如,如果要对当前正在运行的 firefox 程序执行 strace,请确定 firefox 程序的 PID。$ ps -C firefox-bin PID TTY TIME CMD 1725 ? 00:40:50 firefox-bin使用如下所示的 strace -p 选项来显示给定进程 ID 的 strace。$ sudo strace -p 1725 -o firefox_trace.txt $ tail -f firefox_trace.txt现在 firefox 进程的执行跟踪将被记录到 firefox_trace.txt 文本文件中。您可以跟踪此文本文件以查看 firefox 可执行文件的实时跟踪。当您的用户 ID 与给定进程的用户 ID 不匹配时,Strace 将显示以下错误。$ strace -p 1725 -o output.txt attach: ptrace(PTRACE_ATTACH, ...): Operation not permitted Could not attach to process. If your uid matches the uid of the target process, check the setting of /proc/sys/kernel/yama/ptrace_scope, or try again as the root user. For more details, see /etc/sysctl.d/10-ptrace.conf5. 使用选项 -t 打印每个跟踪输出行的时间戳要打印每个 strace 输出行的时间戳,请使用选项 -t,如下所示。$ strace -t -e open ls /home 20:42:37 open("/etc/ld.so.cache", O_RDONLY) = 3 20:42:37 open("/lib/libselinux.so.1", O_RDONLY) = 3 20:42:37 open("/lib/librt.so.1", O_RDONLY) = 3 20:42:37 open("/lib/libacl.so.1", O_RDONLY) = 3 20:42:37 open("/lib/libc.so.6", O_RDONLY) = 3 20:42:37 open("/lib/libdl.so.2", O_RDONLY) = 3 20:42:37 open("/lib/libpthread.so.0", O_RDONLY) = 3 20:42:37 open("/lib/libattr.so.1", O_RDONLY) = 3 20:42:37 open("/proc/filesystems", O_RDONLY|O_LARGEFILE) = 3 20:42:37 open("/usr/lib/locale/locale-archive", O_RDONLY|O_LARGEFILE) = 3 20:42:37 open("/home", O_RDONLY|O_NONBLOCK|O_LARGEFILE|O_DIRECTORY|O_CLOEXEC) = 3 bala6. 使用选项 -r 打印系统调用的相对时间Strace 还可以选择打印每个系统调用的执行时间,如下所示。$ strace -r ls 0.000000 execve("/bin/ls", ["ls"], [/* 37 vars */]) = 0 0.000846 brk(0) = 0x8418000 0.000143 access("/etc/ld.so.nohwcap", F_OK) = -1 ENOENT (No such file or directory) 0.000163 mmap2(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0xb787b000 0.000119 access("/etc/ld.so.preload", R_OK) = -1 ENOENT (No such file or directory) 0.000123 open("/etc/ld.so.cache", O_RDONLY) = 3 0.000099 fstat64(3, {st_mode=S_IFREG|0644, st_size=67188, ...}) = 0 0.000155 mmap2(NULL, 67188, PROT_READ, MAP_PRIVATE, 3, 0) = 0xb786a000 ... ...7.使用选项-c生成系统调用的统计报告使用选项 -c,strace 为执行跟踪提供有用的统计报告。以下输出中的“调用”列指示了该特定系统调用执行了多少次。$ strace -c ls /home bala % time seconds usecs/call calls errors syscall ------ ----------- ----------- --------- --------- ---------------- -nan 0.000000 0 9 read -nan 0.000000 0 1 write -nan 0.000000 0 11 open -nan 0.000000 0 13 close -nan 0.000000 0 1 execve -nan 0.000000 0 9 9 access -nan 0.000000 0 3 brk -nan 0.000000 0 2 ioctl -nan 0.000000 0 3 munmap -nan 0.000000 0 1 uname -nan 0.000000 0 11 mprotect -nan 0.000000 0 2 rt_sigaction -nan 0.000000 0 1 rt_sigprocmask -nan 0.000000 0 1 getrlimit -nan 0.000000 0 25 mmap2 -nan 0.000000 0 1 stat64 -nan 0.000000 0 11 fstat64 -nan 0.000000 0 2 getdents64 -nan 0.000000 0 1 fcntl64 -nan 0.000000 0 2 1 futex -nan 0.000000 0 1 set_thread_area -nan 0.000000 0 1 set_tid_address -nan 0.000000 0 1 statfs64 -nan 0.000000 0 1 set_robust_list ------ ----------- ----------- --------- --------- ---------------- 100.00 0.000000 114 10 total
-
主从复制:主节点负责写数据,从节点负责读数据,从而实现读写分离,提高redis的高可用性。让一个服务器去复制(replicate)另一个服务器,我们称呼被复制的服务器为主节点(master),而对主服务器进行复制的服务器则被称为从节点(slave)主从复制的特点:1、一个master可以有多个slave2、一个slave只能有一个master3、数据流向是单向的,master到slave 主从复制的作用:1、数据副本:多一份或多份数据拷贝,保证redis高可用2、扩展性能:单机redis的性能是有限的,主从复制能横向扩展 如容量、QPS等主从复制实现方式客户端命令:slaveof全量复制和增量复制全量复制过程:1. 向主节点发送psync,有两个参数,第一个参数是runId,第二个参数是偏移量,第一次发送不知道主节点的runId,也不知道偏移量,因此从节点发送 ? -12. 主节点收到消息,根据? -1 能判断出来是第一次复制,主节点把runId和offset 发送给Slave节点,3. 从节点保存主节点基本信息4-5-6. Master节点执行bgsave生成快照,在此期间会记录后续执行的数据更改命令所更改的数据,直到主节点将生成的RDB文件传输到从节点为止, 期间Master节点执行的写操作,主节点会将缓冲区中记录的新更改的数据发送给从节点7-8 从节点清空此前的所有数据,加载RDB文件恢复数据并存入新更改的数据说明: 全量复制的性能开销:1. bgsave生成RDB文件需要的时间,2. RDB文件在网络间的传输时间,3. 从节点的数据清空时间 , 4. 加载RDB文件的时间 5. 可能的 AOF 重写时间 数据更改命令缓冲区repl_back_buffer用于:当Redis通过Linux中的fork()函数开辟一个子进程处理其他事务(比如主进程执行bgsave生成一个RDB文件时,或者主进程执行bgrewriteaof生成一个AOF文件时), 而主进程(即处理客户端命令的进程)后续执行的一些数据更改命令会被暂时保存在该区域,而且该区域空间有限(配置文件中repl-backlog-size 1mb即可配置该处空间大小)部分复制部分复制解决的问题:在实际环境中,主节点与从节点之间可能会发生一些网络波动等情况,导致从节点与主节点之间的网络连接断开(主从节点的Redis均未关闭),如果重新连接上后,可以使用全量复制来重新进行一次主从节点数据同步,但是全量复制会带来一个性能开销的问题,而且从节点中可能有大量数据是主节点中没有更该过的,也就是不需要进行再次同步的数据,如果使用全量复制肯定是带来了一些不必要的浪费。所以,部分复制功能就是为了解决该问题的。过程:1. 主从节点直接连接断开,2. 此时主节点继续执行的数据更改命令会被记录在一个缓冲区 repl_back_buffer 中3. 当从节点重新连接主节点时,4. 自动发出一条命令(psync offset run_id),将从节点中存储的主节点的Redis运行时id和从节点中保存的偏移量发送给主节点5. 主节点接收从节点发送的偏移量和id,对比此时主节点的偏移量和接收的偏移量,如果两个偏移量之差大于repl_back_buffer中的数据,那么就表示在断开连接期间从节点已经丢失了超出规定数量的数据,此时就需要进行全量复制了,否则就进行部分复制6. 将主节点缓冲区中的数据同步更新到从节点中,这样就实现了部分数据的复制同步,降低了性能开销主从节点的故障处理故障发生时服务自动转移(自动故障转移):即当某个节点发生故障导致停止服务时,该节点提供的服务会有另一个节点自动代替提供,这样就实现了一个高可用的效果从节点故障:即如果某个从节点发生了故障,导致无法向在该节点上的客户端提供读服务,解决办法就是使该客户端转移到另一个可用从节点上,但是在转移时,应该考虑该从节点能承受几个客户端的压力主节点故障:如果主节点发生故障,在使用主节点进行读写操作的客户端就无法使用了,而使用从节点只进行读操作的客户端还是可以继续使用的,解决办法就是从从节点中选一个节点更改为主节点,并且将原主节点的客户端连接到新的主节点上,然后通过该客户端将其他从节点连接到新的主节点中主从复制确实可以解决故障问题,但是主从复制不能实现自动故障转移,其必须要通过一些手动操作,而且非常麻烦,所以要实现自动故障转移还需要另一个功能,Redis中提供了sentinel功能来实现自动故障转移。主从节点的故障处理 1. 读写分离:即客户端发来的读写命令分开,写命令交给主节点执行,读命令交给从节点执行,不仅减少了主节点的压力,而且增强了读操作的能力;但也会造成一些问题但是主从节点之间数据复制造成的阻塞延迟也可能会导致主从不一致的情况,也就是主节点先进行了写操作,但可能因为数据复制造成的阻塞延迟,导致在从节点上进行的读操作获取的数据与主节点不一致读取过期数据:主从复制会将带有过期时间的数据一并复制到从节点中,但是从节点是没有删除数据的能力的,即使是过期数据,所以主节点中的已经删除了过期数据,但是因为主从复制的阻塞延迟问题导致从节点中的过期数据没有删除,此时客户端就会读到一个过期数据 2. 主从配置不一致:造成的问题有比如配置中的maxmemory参数如果配置不一致,比如主节点2Gb,从节点1Gb,那么就可能会导致数据丢失;以及一些其他配置问题 3. 规避全量复制:全量复制的性能开销较大,所以要尽量避免全量复制,在第一次建立主从节点关系式一定会发生全量复制;可以适当减小Redis的maxmemory参数,这样可以使得RDB更快,或者选择在客户端操作低峰期进行,比如深夜从节点中保存的主节点run_id不一致时也一定会发生全量复制(比如主节点的重启);可以通过故障转移来尽量避免,例如Redis Sentinel 与 Redis Cluster 当主从节点的偏移量之差大于命令缓冲区repl_back_buffer中对应数据的偏移差时,也会发生全量复制,也就是上面的部分复制的复制过程中所说的;可以适当增大配置文件中repl-backlog-size即数据缓冲区可尽量避免 4. 规避复制风暴:单主节点导致的复制风暴,即当主节点重启后,要向其所有的从节点都进行一次全量复制,这非常消耗性能;可以更换主从节点的拓扑结构,更换为类似树形的结构,一个主节点只与少量的从节点建立主从关系,而而这些主节点又与其他从节点构成主从关系单主节点机器复制风暴:即如果过一台机器专门用来部署多个主节点,然后其他机器部署从节点,那么一旦主节点机器宕机重启,就会引起所有的主从节点之间的全量复制,造成非常大的性能开销;可以采用多台机器,分散部署主节点,或者使用自动故障转移来将某个从节点变为主节点实现一个高可用
-
对Redis而言,其数据是保存在内存中的,一旦机器宕机,内存中的数据会丢失,因此需要将数据异步持久化到硬盘中保存。这样,即使机器宕机,数据能从硬盘中恢复。常见的数据持久化方式:1.快照:类似拍照记录时光,快照是某时某刻将数据库的数据做拍照记录下其数据信息。如MYSQL的Dump,Redis的RDB模式2.写日志方式:是将数据的操作全部写到日志当中,需要恢复的时候,按照日志记录的操作记录重新再执行一遍。例如MYSQL的Binlog,Redis的AAOF模式、RDB说明:redis默认开启,将redis在内存中保存的数据,以快照的方式持久化到硬盘中保存。触发机制:1.save命令:阻塞方式,需要等redis执行完save后,才能执行其他get、set等操作。同步方式2.bgsave命令:非阻塞,其原理是调用linux 的 fork()函数,创建redis的子进程,子进程进行创建 rdb 文件的操作。异步方式,3.自动方式:在redis.conf文件中配置,如下 save <指定时间间隔> <执行指定次数更新操作> ,save 60 10000 表示 60秒年内有10000次操作会自动生成rdb文件。4.其他方式4.1 执行flushall命令,清空数据,几乎不用4.2 执行shutdown命令,安全关闭redis不丢失数据,几乎用不到。4.3 主从复制,在主从复制的时候,rdb文件作为媒介来关联主节点和从节点的数据一致。RDB优缺点优点:1 适合大规模的数据恢复。2 如果业务对数据完整性和一致性要求不高,RDB是很好的选择。缺点:1 不可控,容易丢失数据:数据的完整性和一致性不高,因为RDB可能在最后一次备份时宕机了。2 耗时耗性能:备份时占用内存,因为Redis 在备份时会独立创建一个子进程,将数据写入到一个临时文件(此时内存中的数据是原来的两倍哦),最后再将临时文件替换之前的备份文件。所以Redis 的持久化和数据的恢复要选择在夜深人静的时候执行是比较合理的。AOF说明: redis默认不开启,采用日志的形式来记录每个写操作,并追加到 .aof 文件中。Redis 重启的会根据日志文件的内容将写指令从前到后执行一次以完成数据的恢复工作生成AOF的三种策略:1. always : 每条命令都会刷新到缓冲区,把缓冲区fsync到硬盘,对硬盘IO压力大,一般sata盘只有几百TPS,如果redis的写入量非常大,那对硬盘的压力也横刀。2. everysec: 每秒把缓冲区fsync 到硬盘,如果出现故障,会丢失1s(默认配置是1秒)的数据。一般使用这种。3. no : 由操作系统来定什么时候fsync到硬盘中。 缺点:不可控 AOF重写:把过期的,没有用的,重复的,可优化的命令简化为很小的aof文件。实际上是redis内存中的数据回溯成aof文件。如下图所示:作用:1.减少硬盘占用量2.加快恢复速度 AOF重写的实现方式1.bgrewriteaof 命令 : 从redis的主进程fork一个子进程生成包含当前redis内存数据的最小命令集、2.AOF重写配置:# 1. aof文件增长率 auto-aof-rewrite-percentage 100# 2. aof文件重写需要的尺寸 auto-aof-rewrite-min-size 64mb自动触发时机:(需要同时满足)当前的aof文件大小 > aof文件重写需要的尺寸 (aof当前文件大小 - 上次aof的文件大小)/ 上次aof文件大小 > aof文件增长率 AOF优缺点优点:1.数据的完整性和一致性更高缺点:1.因为AOF记录的内容多,文件会越来越大,数据恢复也会越来越慢。2. AOF每秒fsync一次指令硬盘,如果硬盘IO慢,会阻塞父进程;风险是会丢失1秒多的数据;在Rewrite过程中,主进程把指令存到mem-buffer中,最后写盘时会阻塞主进程。关于Redis持久化方式RDB和AOF的缺点原因是redis持久化方式的痛点,缺点比较明显。1、RDB需要定时持久化,风险是可能会丢两次持久之间的数据,量可能很大。2、AOF每秒fsync一次指令硬盘,如果硬盘IO慢,会阻塞父进程;风险是会丢失1秒多的数据;在Rewrite过程中,主进程把指令存到mem-buffer中,最后写盘时会阻塞主进程。3、这两个缺点是个很大的痛点。为了解决这些痛点,GitHub的两位工程师 Bryana Knight 和 Miguel Fernández 日前写了一篇 文章 ,讲述了将持久数据从Redis迁出的经验: http://www.open-open.com/lib/view/open1487736984424.html如何选择RDB和AOF建议全都要。1、对于我们应该选择RDB还是AOF,官方的建议是两个同时使用。这样可以提供更可靠的持久化方案。在redis 4.0 之后,官方提供了混合持久化模式,具体如下持久化文件结构上半段RDB格式,后半段是AOF模式。
-
1.1 高健壮性机器人要求对于复杂度为O(n2)的脚本或者脚本涉及到UI页面操作就必须使用Try-catch+SubProcess保证高健壮性。Tips:在读写文件,比如读Excel的时候,也可以放入到Try-Catch-Finally里,如果Excel被打开了则脚本执行打开Excel会出错,可以在Catch里调用脚本杀掉Excel进程,在下一次Try的时候就可以顺利打开文件了1.2 转变成机器思维的要求比如将一个Excel表格里的内容,循环100次录入到web页面里。如果在没有模板可以一次导入的情况下,需要循环100次。人的操作思维:1, 登陆网页。2, 选中相应的内容copy到网页里,并提交。3, 循环填入下一条。4, 结束。 当用脚本实现时,我们建议:1, 打开excel读取1000条内容到内存里。可以避免文件交叉操作导致任务失败。2, 循环内存中1000条数据的第一条,并判断网页是否ready可以填入内容,并提交。如果网页未ready那么就打开网页。3, 循环填入下一条。4, 结束。这样做的好处是:不管网页是否稳定,即便网络中断几分钟,都可以顺利的保证完成录入任务。1.3 便于定位问题添加必要打印的要求当开发完成转维后,想要再去查找问题就比较困难, 所以在开发初期增加足够的日志,便于后期定位问题。例如在进入新脚本的时候、查询到结果的时候、关键节点等。1.4 查询再执行类增加校验的要求比如下图处理当前单处理的问题,要把单号记录下来,便于出现问题后排查问题,如果允许的话可以在失败的时候截图保留截图。 如果查询结果不一致,则继续查询一次,多次后未果,则发送通知消息。1.5 使用文字或者相对路径定位的要求xpath=//button[text()="Reset"]xpath=//a[contains(text(),'我的任务')]xpath=//*[contains(@id,"datatable")]/div[2]/div[1]/div/div[4]/divxpath=//*[text()="提交"]或者使用相对路径,这样在网页变动后还能增加成功定位的概率。网页操作中xpath的定位非常重要,可以参考网上资料进行深入学习。1.6 使用GETTABLE代替循环的要求在很多网页中某些表比较长,当前窗口显示不全,可以使用gettable,这样可以避免取不到拖动后才能看到的元素,如下图右侧的元素定位。当然,有些看上去是表的展示,单实际并不是表,还是要循环去操作。对于gettable的使用可以登陆www.ilearningx.huawei.com,搜索AntRobot,查看高级课程的9.2章节1.7 双重保护确保任务达成的要求比如对于鼠标移动网页元素上面的时候才会出现的菜单,actionchains 不一定会每次稳定运行。此时可以增加ClickPicxx的操作。1.8 串行任务改并行的要求比如登陆网站下载几千张图片,并对图片做OCR识别,比较推荐的解决办法是: 1,WeAutomate负责下载 图片,并拆分成不同的小组,比如100张一组。2,一组完成下载后即调用Java或者python等实现处理每个小组的图片,并继续下载下一组照片3,WeAutomate判断图片所有图片识别结束后进行信息汇总。4,最后一个小组与倒数第二个小组都完成,或者所有小组都完成,则执行完毕。1.9 拆分超长流程的要求不要将所有的流程全部放在一个子脚本/Script里,跟写代码时不允许一个函数体超过150行或者200行一个道理。缺点: 1,太长的流程很难读懂,别人很难很快了解流程的结构2,没有异常处理逻辑3,如果系统中出现小问题,则进程将终止 改进建议:主页保留流程主线,把大部分二级处理逻辑移到子页之后对完成的任务进行合理的拆分。1.10 安全开发规范要求1,WeAutomate Studio支持敏感信息本地存储、使用双重加密2,管理中心运行账号与开发账号隔离3,开发人员只接触测试账号1.11 其它要求1,流程应该简洁、干净且有逻辑2,应当在在定义好流程的输入、输出、处理过程后,再着手进行开发3,保存流程前,应该先检查所有Error。开发过程中的Error应当保证可控;开发完成后流程中不应当存在Error
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签