-
 锁是GaussDB(DWS)实现并发管理的关键要素,GaussDB(DWS)锁类别有表级锁、分区级锁(和表级锁一致)、事务锁、咨询锁等,当前业务最常用的是表级锁、分区级锁(和表级锁一致)、事务锁。不同的SQL语句执行时需要申请并持有对应的锁,当这些锁资源存在互斥时,对应的业务SQL就会产生等待;这种等待会产生下面几种后果持锁的一方释放锁(一般对应的动作为持锁的事物提交),等待锁的一方申请到锁,然后继续执行持锁的一方事物长时间未提交,等待锁的一方因为锁等待超时导致作业报错A实例上持锁事物和申请锁的事物在B实例上角色互换,产生分布式死锁(具体见下文介绍)。这种场景下需要首先达到锁等待超时的事物报错回滚时释放锁资源,然后另外一个事物申请到才能正常进行从上述的描述可以看到,锁等待特别是分布式死锁对业务影响很大,轻则产生等待导致业务性能抖动和下降,甚至业务报错。GaussDB(DWS)提供了两个集群级别的视图快速识别和查询锁等待和分布式死锁信息,可实现此类问题的秒级问题的定位和分析1)锁等待检测视图pgxc_lock_conflicts【功能】查询当前库里面不同节点上的锁等待信息字段名称数据类型字段描述locktypetext被锁定对象的类型,当前支持relation、partition、transactionid三种类型的锁类型nodenamename被锁定对象的节点的名称dbnamename被锁定对象的数据库的名称。如果被锁定对象是事务,则为NULLnspnamename被锁定对象的命名空间的名称relnamename被锁定对象对应的relation的名称。如果被锁定对象既不是relation,也不是relation的一部分,则为NULLpartnamename被锁定对象对应的分区的名称。如果被锁定对象不是分区,则为NULLpageinteger被锁定对象对应的页面的编号。如果被锁定对象既不是页面,也不是元组,则为NULLtuplesmallint被锁定对象对应的元组的编号。如果被锁定对象不是元组,则为NULLtransactionidxid被锁定对象对应的事务的ID。如果被锁定对象不是事务,则为NULLusernamename当前线程所处session的用户名,一般也是当前线程执行语句的用户名称gxidxid当前线程所处事物的事物IDxactstarttimestamptz当前线程所处事务的事物开始时间queryidbigint申请锁的线程的最新查询的queryidquerytext申请锁的线程的最新查询语句pidbigint申请锁的线程的IDmodetext锁的级别grantedbooleanTRUE表示当前线程持有上述指定的锁FALSE表示当前线程正在申请锁,但是没有申请上,处在等待锁的状态【解析】执行如下查询结果postgres=# SELECT * FROM pgxc_lock_conflicts ORDER BY nodename,dbname,locktype,nspname,relname,partname; locktype | nodename | dbname | nspname | relname | partname | page | tuple | transactionid | username | gxid | xactstart | queryid | query | pid | mode | granted -----------+----------+----------+---------+-----------------------+----------+------+-------+---------------+-----------+----------+-------------------------------+--------------------+----------------------------------------------------------+-----------------+---------------------+--------- partition | cn_5001 | postgres | public | table_partition_num_3 | p1 | | | | dfm | 24097147 | 2022-02-17 17:56:03.113194+08 | 104145741383084190 | alter table table_partition_num_3 truncate partition p1; | 140160505136896 | AccessExclusiveLock | f partition | cn_5001 | postgres | public | table_partition_num_3 | p1 | | | | dfm | 24102679 | 2022-02-17 18:41:36.580348+08 | 0 | alter table table_partition_num_3 truncate partition p1; | 140160568055552 | AccessExclusiveLock | t relation | cn_5002 | postgres | public | xxx | | | | | dfm | 24102679 | 2022-02-17 18:41:36.580348+08 | 175921860444402398 | truncate xxx; | 140418767369984 | AccessShareLock | f relation | cn_5002 | postgres | public | xxx | | | | | dfm | 24097147 | 2022-02-17 17:56:03.113194+08 | 0 | truncate xxx; | 140420489144064 | AccessExclusiveLock | t (4 rows)如上的SQL显示在节点cn_5001的postgres里面的表public.table_partition_num_3的分区p1上存在分区级别(partition)的锁冲突。在当前的锁冲突中线程140160568055552持有锁(mode = true),锁级别是AccessExclusiveLock,执行语句为alter table table_partition_num_3 truncate partition p1。线程140160568055552在等待(mode = false)AccessExclusiveLock锁,等待锁的语句也是alter table table_partition_num_3 truncate partition p1。在节点cn_5002的postgres里面的表public.xxx上存在表级别(relation)的锁冲突。线程140420489144064持有锁AccessExclusiveLock(mode = true),线程140418767369984在等待(mode = false)AccessShareLock锁2)分布式锁等待检测视图pgxc_deadlock【功能】查询当前库里面不同节点上的分布式死锁信息字段名称数据类型字段描述locktypetext被锁定对象的类型,当前支持relation、partition、transactionid三种类型的锁类型nodenamename被锁定对象的节点的名称dbnamename被锁定对象的数据库的名称。如果被锁定对象是事务,则为NULLnspnamename被锁定对象的命名空间的名称relnamename被锁定对象对应的关系的名称。如果被锁定对象既不是关系,也不是关系的一部分,则为NULLpartnamename被锁定对象对应的分区的名称。如果被锁定对象不是分区,则为NULLpageinteger被锁定对象对应的页面的编号。如果被锁定对象既不是页面,也不是元组,则为NULLtuplesmallint被锁定对象对应的元组的编号。如果被锁定对象不是元组,则为NULLtransactionidxid被锁定对象对应的事务的ID。如果被锁定对象不是事务,则为NULLwaitusernamename等待锁的用户的名称waitgxidxid等待锁的事务的IDwaitxactstarttimestamptz等待锁的事务的开始时间waitqueryidbigint等待锁的线程的最新查询IDwaitquerytext等待锁的线程的最新查询语句waitpidbigint等待锁的线程的IDwaitmodetext等待的锁的级别holdusernamename持有锁的用户的名称holdgxidxid持有锁的事务的IDholdxactstarttimestamptz持有锁的事务的开始时间holdqueryidbigint持有锁的线程的最新查询IDholdquerytext持有锁的线程的最新查询语句holdpidbigint持有锁的线程的IDholdmodetext持有的锁的级别【解析】执行如下查询结果postgres=# SELECT * FROM pgxc_deadlock ORDER BY nodename,dbname,locktype,nspname,relname,partname; locktype | nodename | dbname | nspname | relname | partname | page | tuple | transactionid | waitusername | waitgxid | waitxactstart | waitqueryid | waitquery | waitpid | waitmode | holdusername | holdgxid | holdxactstart | holdqueryid | holdquery | holdpid | holdmode ----------+----------+----------+---------+---------+----------+------+-------+---------------+--------------+----------+-------------------------------+--------------------+-----------------------------------------------------+-----------------+-----------------+--------------+----------+-------------------------------+-------------+--------------+-----------------+--------------------- relation | cn_5001 | postgres | public | t2 | | | | | j00565968 | 24112406 | 2022-02-17 20:01:57.421532+08 | 104145741383110084 | EXECUTE DIRECT ON(dn_6003_6004) 'SELECT * FROM t2'; | 140160505136896 | AccessShareLock | j00565968 | 24112465 | 2022-02-17 20:02:24.220656+08 | 0 | TRUNCATE t2; | 140160421234432 | AccessExclusiveLock relation | cn_5002 | postgres | public | t1 | | | | | j00565968 | 24112465 | 2022-02-17 20:02:24.220656+08 | 175921860444446866 | EXECUTE DIRECT ON(dn_6001_6002) 'SELECT * FROM t1'; | 140418784151296 | AccessShareLock | j00565968 | 24112406 | 2022-02-17 20:01:57.421532+08 | 0 | TRUNCATE t1; | 140421763163904 | AccessExclusiveLock (2 rows)如上的SQL显示,在postgres库里面节点cn_5001上 事务24112465通过线程140160421234432持有表public.t2的AccessExclusiveLock锁 事务24112406通过线程140160505136896在等待申请表public.t2的AccessShareLock锁节点cn_5002上 事务24112465通过线程140418784151296在等待申请表public.t1的AccessShareLock锁 事物24112406通过线程140421763163904持有表public.t1的AccessExclusiveLock锁如果我们把资源的持有情况按照持有到申请定义一个防线的话,可以形成如下表格节点事务24112465方向事务24112406cn_5001持有表public.t2的AccessExclusiveLock锁→申请表public.t2的AccessShareLock锁cn_5002申请表public.t1的AccessShareLock锁←持有表public.t1的AccessExclusiveLock锁从上述可以看出,事务24112465在节点cn_5001持有表public.t2的AccessExclusiveLock锁,等待申请申请表public.t1的AccessShareLock锁;事务24112406在节点cn_5002上持有表public.t1的AccessExclusiveLock锁,等待申请申请表public.t2的AccessShareLock锁;事务24112406和事务24112465只有等待彼此提交才能申请到锁资源,让自己继续执行,这种在多个实例上的分布式等待关系形成了一个环状,我们称这种现象为分布式死锁。3) 锁等待和分布式死锁的区别对于分布式死锁,只能一个事务因为锁等待(参数lockwait_timeout)超时回滚的时候,另外一个事务才能进行下去;或者人工干预kill或者cancel其中一个事务,让另外一个事务进行下去。对于没有分布式死锁的锁等待,这种一般不需要人工干涉,等待持锁事务正常执行完成之后另外一个事务就可以正常执行;但是如果事务持锁时间超过锁等待超时参数(参数lockwait_timeout),等待锁的事务会因为锁等待超时失败。
-
锁是GaussDB(DWS)实现并发管理的关键要素,GaussDB(DWS)锁类别有表级锁、分区级锁(和表级锁一致)、事务锁、咨询锁等,当前业务最常用的是表级锁、分区级锁(和表级锁一致)、事务锁。不同的SQL语句执行时需要申请并持有对应的锁,当这些锁资源存在互斥时,对应的业务SQL就会产生等待;这种等待会产生下面几种后果持锁的一方释放锁(一般对应的动作为持锁的事物提交),等待锁的一方申请到锁,然后继续执行持锁的一方事物长时间未提交,等待锁的一方因为锁等待超时导致作业报错A实例上持锁事物和申请锁的事物在B实例上角色互换,产生分布式死锁(具体见下文介绍)。这种场景下需要首先达到锁等待超时的事物报错回滚时释放锁资源,然后另外一个事物申请到才能正常进行从上述的描述可以看到,锁等待特别是分布式死锁对业务影响很大,轻则产生等待导致业务性能抖动和下降,甚至业务报错。GaussDB(DWS)提供了两个集群级别的视图快速识别和查询锁等待和分布式死锁信息,可实现此类问题的秒级问题的定位和分析1)锁等待检测视图pgxc_lock_conflicts【功能】查询当前库里面不同节点上的锁等待信息字段名称数据类型字段描述locktypetext被锁定对象的类型,当前支持relation、partition、transactionid三种类型的锁类型nodenamename被锁定对象的节点的名称dbnamename被锁定对象的数据库的名称。如果被锁定对象是事务,则为NULLnspnamename被锁定对象的命名空间的名称relnamename被锁定对象对应的relation的名称。如果被锁定对象既不是relation,也不是relation的一部分,则为NULLpartnamename被锁定对象对应的分区的名称。如果被锁定对象不是分区,则为NULLpageinteger被锁定对象对应的页面的编号。如果被锁定对象既不是页面,也不是元组,则为NULLtuplesmallint被锁定对象对应的元组的编号。如果被锁定对象不是元组,则为NULLtransactionidxid被锁定对象对应的事务的ID。如果被锁定对象不是事务,则为NULLusernamename当前线程所处session的用户名,一般也是当前线程执行语句的用户名称gxidxid当前线程所处事物的事物IDxactstarttimestamptz当前线程所处事务的事物开始时间queryidbigint申请锁的线程的最新查询的queryidquerytext申请锁的线程的最新查询语句pidbigint申请锁的线程的IDmodetext锁的级别grantedbooleanTRUE表示当前线程持有上述指定的锁FALSE表示当前线程正在申请锁,但是没有申请上,处在等待锁的状态【解析】执行如下查询结果postgres=# SELECT * FROM pgxc_lock_conflicts ORDER BY nodename,dbname,locktype,nspname,relname,partname; locktype | nodename | dbname | nspname | relname | partname | page | tuple | transactionid | username | gxid | xactstart | queryid | query | pid | mode | granted -----------+----------+----------+---------+-----------------------+----------+------+-------+---------------+-----------+----------+-------------------------------+--------------------+----------------------------------------------------------+-----------------+---------------------+--------- partition | cn_5001 | postgres | public | table_partition_num_3 | p1 | | | | dfm | 24097147 | 2022-02-17 17:56:03.113194+08 | 104145741383084190 | alter table table_partition_num_3 truncate partition p1; | 140160505136896 | AccessExclusiveLock | f partition | cn_5001 | postgres | public | table_partition_num_3 | p1 | | | | dfm | 24102679 | 2022-02-17 18:41:36.580348+08 | 0 | alter table table_partition_num_3 truncate partition p1; | 140160568055552 | AccessExclusiveLock | t relation | cn_5002 | postgres | public | xxx | | | | | dfm | 24102679 | 2022-02-17 18:41:36.580348+08 | 175921860444402398 | truncate xxx; | 140418767369984 | AccessShareLock | f relation | cn_5002 | postgres | public | xxx | | | | | dfm | 24097147 | 2022-02-17 17:56:03.113194+08 | 0 | truncate xxx; | 140420489144064 | AccessExclusiveLock | t (4 rows)如上的SQL显示在节点cn_5001的postgres里面的表public.table_partition_num_3的分区p1上存在分区级别(partition)的锁冲突。在当前的锁冲突中线程140160568055552持有锁(mode = true),锁级别是AccessExclusiveLock,执行语句为alter table table_partition_num_3 truncate partition p1。线程140160568055552在等待(mode = false)AccessExclusiveLock锁,等待锁的语句也是alter table table_partition_num_3 truncate partition p1。在节点cn_5002的postgres里面的表public.xxx上存在表级别(relation)的锁冲突。线程140420489144064持有锁AccessExclusiveLock(mode = true),线程140418767369984在等待(mode = false)AccessShareLock锁2)分布式锁等待检测视图pgxc_deadlock【功能】查询当前库里面不同节点上的分布式死锁信息字段名称数据类型字段描述locktypetext被锁定对象的类型,当前支持relation、partition、transactionid三种类型的锁类型nodenamename被锁定对象的节点的名称dbnamename被锁定对象的数据库的名称。如果被锁定对象是事务,则为NULLnspnamename被锁定对象的命名空间的名称relnamename被锁定对象对应的关系的名称。如果被锁定对象既不是关系,也不是关系的一部分,则为NULLpartnamename被锁定对象对应的分区的名称。如果被锁定对象不是分区,则为NULLpageinteger被锁定对象对应的页面的编号。如果被锁定对象既不是页面,也不是元组,则为NULLtuplesmallint被锁定对象对应的元组的编号。如果被锁定对象不是元组,则为NULLtransactionidxid被锁定对象对应的事务的ID。如果被锁定对象不是事务,则为NULLwaitusernamename等待锁的用户的名称waitgxidxid等待锁的事务的IDwaitxactstarttimestamptz等待锁的事务的开始时间waitqueryidbigint等待锁的线程的最新查询IDwaitquerytext等待锁的线程的最新查询语句waitpidbigint等待锁的线程的IDwaitmodetext等待的锁的级别holdusernamename持有锁的用户的名称holdgxidxid持有锁的事务的IDholdxactstarttimestamptz持有锁的事务的开始时间holdqueryidbigint持有锁的线程的最新查询IDholdquerytext持有锁的线程的最新查询语句holdpidbigint持有锁的线程的IDholdmodetext持有的锁的级别【解析】执行如下查询结果postgres=# SELECT * FROM pgxc_deadlock ORDER BY nodename,dbname,locktype,nspname,relname,partname; locktype | nodename | dbname | nspname | relname | partname | page | tuple | transactionid | waitusername | waitgxid | waitxactstart | waitqueryid | waitquery | waitpid | waitmode | holdusername | holdgxid | holdxactstart | holdqueryid | holdquery | holdpid | holdmode ----------+----------+----------+---------+---------+----------+------+-------+---------------+--------------+----------+-------------------------------+--------------------+-----------------------------------------------------+-----------------+-----------------+--------------+----------+-------------------------------+-------------+--------------+-----------------+--------------------- relation | cn_5001 | postgres | public | t2 | | | | | j00565968 | 24112406 | 2022-02-17 20:01:57.421532+08 | 104145741383110084 | EXECUTE DIRECT ON(dn_6003_6004) 'SELECT * FROM t2'; | 140160505136896 | AccessShareLock | j00565968 | 24112465 | 2022-02-17 20:02:24.220656+08 | 0 | TRUNCATE t2; | 140160421234432 | AccessExclusiveLock relation | cn_5002 | postgres | public | t1 | | | | | j00565968 | 24112465 | 2022-02-17 20:02:24.220656+08 | 175921860444446866 | EXECUTE DIRECT ON(dn_6001_6002) 'SELECT * FROM t1'; | 140418784151296 | AccessShareLock | j00565968 | 24112406 | 2022-02-17 20:01:57.421532+08 | 0 | TRUNCATE t1; | 140421763163904 | AccessExclusiveLock (2 rows)如上的SQL显示,在postgres库里面节点cn_5001上 事务24112465通过线程140160421234432持有表public.t2的AccessExclusiveLock锁 事务24112406通过线程140160505136896在等待申请表public.t2的AccessShareLock锁节点cn_5002上 事务24112465通过线程140418784151296在等待申请表public.t1的AccessShareLock锁 事物24112406通过线程140421763163904持有表public.t1的AccessExclusiveLock锁如果我们把资源的持有情况按照持有到申请定义一个防线的话,可以形成如下表格节点事务24112465方向事务24112406cn_5001持有表public.t2的AccessExclusiveLock锁→申请表public.t2的AccessShareLock锁cn_5002申请表public.t1的AccessShareLock锁←持有表public.t1的AccessExclusiveLock锁从上述可以看出,事务24112465在节点cn_5001持有表public.t2的AccessExclusiveLock锁,等待申请申请表public.t1的AccessShareLock锁;事务24112406在节点cn_5002上持有表public.t1的AccessExclusiveLock锁,等待申请申请表public.t2的AccessShareLock锁;事务24112406和事务24112465只有等待彼此提交才能申请到锁资源,让自己继续执行,这种在多个实例上的分布式等待关系形成了一个环状,我们称这种现象为分布式死锁。3) 锁等待和分布式死锁的区别对于分布式死锁,只能一个事务因为锁等待(参数lockwait_timeout)超时回滚的时候,另外一个事务才能进行下去;或者人工干预kill或者cancel其中一个事务,让另外一个事务进行下去。对于没有分布式死锁的锁等待,这种一般不需要人工干涉,等待持锁事务正常执行完成之后另外一个事务就可以正常执行;但是如果事务持锁时间超过锁等待超时参数(参数lockwait_timeout),等待锁的事务会因为锁等待超时失败。
-
 大家好!我是酷哥,一周精选,带您速览,欢迎大家关注。 **本期整理如下:** ------------------------------------------------ **本期精选** ------------------------------------------------ - 中国信通院云原生数据湖首批评测正式启动 - 中山大学联合创邻科技Galaxybase破万亿数据挖掘世界纪录 - IDC FutureScape:2022年中国数据与内容技术十大预测 - 国产分布式数据库在证券行业的应用及实践 - 金融行业分布式数据库选型及实践经验 - openGauss助力中国移动获 “ICT优秀案例” - 未来分布式数据库凭事务+存储**,HTAP是特性但非万能丨新创访谈 ------------------------------------------------ **资讯全文** ------------------------------------------------ - 中国信通院云原生数据湖首批评测正式启动 **摘要:** 大数据技术的内涵伴随着传统信息技术和数据应用的发展不断演进,而大数据技术体系的核心始终是面向海量数据的存储、计算、处理等基础技术。支撑数据存储计算的软件系统起源于20世纪60年代的数据库;70年代出现的关系型数据库成为了沿用至今最常用的数据存储计算系统;80年代末,专门面向数据分析决策的数据仓库理论被提出,成为接下来很长一段时间内发掘数据价值的主要工具和手段。2000年前后,面向非结构化数据的NoSQL数据库兴起。2010年前后,对于大量异构数据源进行统一存储使用的需求催生了数据湖概念。同时随着云计算技术的深入应用,大数据技术完成了从私有化部署到云上部署再向云原生的转变。 中国信通院云计算与大数据研究所依托中国通信标准化协会大数据技术标准推进委员会(CCSA TC601),联合腾讯云、阿里云、华为、星环、百度、海康威视、亚信、中国移动云能力中心等企业的二十余位专家共同参与编制完成了《云原生数据湖技术要求与测试方法》,帮助大数据产品供应商及用户方评估云原生数据湖的技术能力和研发方向。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178460](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178460) - 中山大学联合创邻科技Galaxybase破万亿数据挖掘世界纪录 **摘要:** 数字经济时代,数据成为关键生产要素。企业从海量数据中挖掘商业价值的需求越发迫切。但这些高维、异构、复杂关联的数据给传统大数据处理和关系型数据库产品带来了极大挑战。中山大学联合创邻科技 “Galaxybase”图数据库,完成了万亿规模交易数据智能挖掘性能测试,为图数据库赋能的智慧互联数字化未来开启了新**。“超级算力+创新存储技术”,推动大数据智能革命。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178835](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178835) - IDC FutureScape:2022年中国数据与内容技术十大预测 **摘要:** IDC近日发布了《IDC FutureScape: 全球数据和内容技术2022年预测 – 中国启示》,报告提供了 IDC 对数据和内容技术的 2022 年十大预测,主要关注数据和内容为企业所创造的价值,代表未来几年对数据、内容及分析技术的部署和使用具有最大潜在影响的预期趋势。 本报告基于全球预测提供对中国市场的启示,预测内容的主题分别为:数据运维、实时流式数据、AI增强分析及知识网络、规范事物命名、决策平台、视频内容分析、数据共享、数据文化、智能文档处理和图数据库。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178655](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178655) - 国产分布式数据库在证券行业的应用及实践 **摘要:** 近年来,证券行业线下服务转型线上化进程加速,包括营销获客的方式、AI单向智能开户、非现场业务的办理、在线直播、小程序、小视频等互联网方式的使用等,同时近年证券市场行情火爆,证券用户数量和并发量大幅提升,从而对支撑业务的IT系统及数据库提出了更高要求;伴随在证券公司进入全面创新发展阶段,证券业务品种也日渐增加、业务流程复杂度不断提高,现有非国产集中式数据库架构在满足新业务、新监管规定以及今后一段时期内部控制管理的高效率监控及管理的需求方面已逐渐困难。 但随着国产分布式数据库产品不断的更新优化和技术发展,可以为我们带来越来越多的可适配场景。国产分布式数据库可在证券行业产生越来越多的应用价值。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178558](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178558) - 金融行业分布式数据库选型及实践经验 **摘要:** 随着企业数字化转型深化,数据在企业中扮演着愈发重要的作用。数据无论从存储规模、还是计算要求都有着较之以往更高的需求。 金融行业,作为数据应用的“高地”,这一点表现尤为突出。如何在新时期,满足对数据基础设施更高的要求,成为各金融机构首要面对的问题。分布式数据库,作为一种新的数据库架构,经过近十余年的高速发展,已逐步成熟,并开始在一些金融机构中投产使用。但这种新的架构,较之以往的传统架构有着诸多不同。本文尝试从建设背景、技术趋势、落地实践、典型产品等多角度,分析当前分布式数据库与金融行业背景想结合,如何实现更好的落地实践。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178658](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178658) - openGauss助力中国移动获 “ICT优秀案例” **摘要:** 中国移动在线营销服务中心是中国移动连接亿万客户的桥梁,拥有全球最大的融合智能泛呼叫中心。依托数字化、云化、智能化的服务营销能力,实现热线与互联网融通,多媒体智能交互应用;构建起全国一体化线上运营能力,支持数万客服云上生产。已将数智化的营销服务能力产品化,赋能社会千行百业助力经济社会发展。作为线上渠道的生产运营者、在线服务的全网提供者、全网生态合作运营的支撑者、智能化营销服务能力的构建者,正积极推动中国移动营销服务体系改革开启新征程。 近日,中国移动在线营销服务中心联合华为共同申报的“中国移动在线营销服务中心全栈自主可控基础软件最佳实践”荣获了《人民邮电报》2021年“ICT优秀案例”“强基筑魂卓越创新标杆”称号。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178841](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178841) - 未来分布式数据库凭事务+存储**,HTAP是特性但非万能丨新创访谈 **摘要:** 承载着业务快速发展与数据体量激增的重压,数据库在可用性、扩展性、兼容性、稳定性等核心能力上被投注了越来越多的诉求与期望,面对这些由时代赋予数据库厂商和企业用户的新命题,解法显然不止一种,但思路却终归一致——顺势而为,应变而变。由此,近年来,我们看到了分布式架构带来的降本增效、云原生技术带来的弹性便捷,还看到了国产数据库从外围到核心业务系统应用的渐入佳境。这些看得见的变化仅仅只是开端,那些还未企及的变革,我们或许能从华为云数据库服务总经理苏光牛的本次专访中得到启发。 专访过程中,苏光牛多次表现出对国产数据库核心技术、用户适配度的信心和肯定,但他同时也指出,展望未来发展,一款真正的企业级分布式数据库,必定要在分布式事务和分布式存储上取得更大的改进和突破,才能从根本上解决用户的核心需求。此外,在国产数据库后续的大浪淘沙中,生态建设及人才培养将是制胜关键,需要持之以恒的投入。 **文章详情:** [https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178987](https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=178987) [上一期:【技术之声】第六期(20220124)一周精选](https://bbs.huaweicloud.com/forum/thread-178517-1-1.html) *声明:文章源于第三方公开的信息,如内容中涉嫌侵权或存在信息不实时,请及时联系删除。* |整理者:酷哥
-
 文章目录多租户介绍计算资源:cpu管控计算资源:内存管控存储资源:磁盘空间正文一、什么是多租户? 所谓多租户:就是我们一套集群内,可以有多个用户使用,比如说云上,一个集群中有多个用户,大家都有自己的业务要运行,假如其中某个用户A运行了一些很吃资源的业务,一个人就把cpu、内存等资源用得淋漓尽致,那么其他人就只能看着了,自己的业务完全受阻,这时候,就需要多租户手段,去限制A用户所使用的资源,比如规定好让他最多使用1G的内存,最多使用30%的cpu,这样的话他的作业跑起来也不会影响到其他人,大家相安无事,好好工作。二、GaussDB for DWS多租户概述 GaussDB for DWS 用两层用户架构组织租户。一个父租户下有多个子租户,一个子租户只能属于一个父租户。我们通过给父租户分配资源配额,同时限定附属于该父租户的子租户的资源使用。其中,子租户也可以分配父租户分配到的资源。 主要涉及的资源有以下几种: 1)计算资源:CPU资源、内存资源。 2)存储资源:磁盘空间。 下面我们分别对各种资源的分隔方式进行一个技术分享。三、计算资源CPU资源管控 GaussDB for DWS的CPU管控机制,是基于linux自带机制:CGroup来实现的,CGroup是Linux内核提供的一种限制、记录、隔离进程组所使用的物理资源(如CPU、 Memory、I/O等)的机制。 我们以一种树的形式,组织各个分配了资源的租户,如下图所示: 图中是控制组的一个挂载树,从最上层开始,就分为了两部分,一部分是属于Gaussdb的资源,一部分是留给系统其他进程使用的资源,我们使用的资源如图所示,都是挂载到Gaussdb:gaussdba的,其中第一层又分为两个控制组,Backend用来预留资源给数据库常驻的各个工作线程,Class控制组的资源用来分配给各个用户进行作业执行。 我们每创建一个父租户,就会对应创建一个UserClass1-n挂载到Class控制组下,去从Class控制组分到对应配额的CPU资源。而我们创建的子租户,会从他们的父租户那里分配资源,当前我们支持两层的架构,父租户对应数据库中的组用户,子租户对应数据库中的业务用户。 总体来说可以这样表述:给父租户分配40%的CPU,此时子租户将父租户的40%当做100%来分配,比如子租户A设置配额为50%,那么实际上是相当于分配了整体CPU资源的40%*50%=20%。 2.内存资源管控 Gaussdb for DWS数据库当前的架构由最早的多进程架构,演变为多线程架构,因此单独一个数据库实例,比如一个coordinator或者datanode,都是作为一个进程运行,进程中会用多个线程去负责各种不同的工作,比如有的用来执行用户作业,有的用来处理后台的任务,各个cn与dn互相之间由一套独特的通信架构进行联络(基于TCP协议),由cn解析下发客户端发过来的作业,下推给dn去执行,结果再返回汇总到cn,完成各种业务。 DWS会直接在数据库进程启动的时候,就为其分配好内存,为实例分配的一整块内存中,会根据不同的需要,划分为各种不同的内存上下文,其中有一块内存,叫做dynamic_workload_memory,作为作业运行时可以使用的内存,总体大小也会在一开始被规定好,举个例子,整个进程分配到20G内存,可以给dynamic_workload_memory根据算法从中分配对应的内存,比如会分配20G中的15G用于作业执行。 而我们要说的多租户内存管控机制,就是从这15G的内存中,按照租户规定的百分比,对一个租户可以使用的资源进行限制。当给一个租户设置了一定额度的内存之后,数据库中会对他使用的内存进行一个记录,当他运行的作业所使用的内存要超过对应的内存的时候,就会不再执行,作业进入排队状态,等待资源释放之后再继续执行。四、存储资源 存储资源主要就是指磁盘空间上的管控,在实际使用的过程中,很容易出现由一条坏SQL一直执行,持续下盘,导致整个磁盘到达使用率100%的状态,后果非常严重,因此,DWS也为了避免出现这种状况,提供了磁盘管控的功能,在内核8.0版本中,一共提供了三种类型的磁盘空间管控:永久表空间管控、临时表空间管控、以及SQL执行时的算子罗盘使用的临时空间管控。日常使用过程中进行下盘的无非这三种场景,我们已经都可以对其进行磁盘额度限制,这个额度和用户绑定,我们在使用过程中,创建用户或者修改用户,都可以指定该用户可以使用的永久空间,临时表空间,算子落盘空间。使一个用户所使用的磁盘空间在可控制的范围内,一旦超过限制,该用户将不能再进行落盘的操作,并且如果是当前正在执行的语句导致的磁盘空间膨胀,数据库内核也会把他找到并且干掉。 具体内部机制可以这样描述:内核中会记录每个用户使用的空间大小,并且在用户进行落盘等使用到磁盘空间操作时也进行对应记录,直到用户所使用的空间达到限额时,内核就会做出对应的策略,不允许该用户再进行落盘。 此外,内核中还有一个保护机制,就是当某个dn实例使用率达到90%时,整个集群会进入只读状态,为防止磁盘达到100%后的未知后果,直接禁止所有的写入操作。五、后记 与此同时,对于用户所使用的资源,DWS也提供了监控功能,从页面上可以看到当前用户的资源使用情况,同样也可以在内核中查询视图:pg_total_user_resource_info进行查看。 希望通过本文可以加深读者对于DWS多租户功能的认识理解。
-
承载着业务快速发展与数据体量激增的重压,数据库在可用性、扩展性、兼容性、稳定性等核心能力上被投注了越来越多的诉求与期望,面对这些由时代赋予数据库厂商和企业用户的新命题,解法显然不止一种,但思路却终归一致——顺势而为,应变而变。由此,近年来,我们看到了分布式架构带来的降本增效、云原生技术带来的弹性便捷,还看到了国产数据库从外围到核心业务系统应用的渐入佳境。这些看得见的变化仅仅只是开端,那些还未企及的变革,我们或许能从华为云数据库服务总经理苏光牛的本次专访中得到启发。专访过程中,苏光牛多次表现出对国产数据库核心技术、用户适配度的信心和肯定,但他同时也指出,展望未来发展,一款真正的企业级分布式数据库,必定要在分布式事务和分布式存储上取得更大的改进和突破,才能从根本上解决用户的核心需求。此外,在国产数据库后续的大浪淘沙中,生态建设及人才培养将是制胜关键,需要持之以恒的投入。而对于企业用户如何应对海量数据挑战,进行数据库改造和国产化替代,苏光牛一语中的,指出大多数企业的担忧并不在于数据库本身,而在于“变化”,担忧作出变化后带来不可预测和不可控制的风险。他建议企业抛开传统思想,用辩证的思维综合衡量规模、成本、效率、安全、运维难度等问题,致力于将更多精力集中在应用和业务当中。以下内容整理自dbaplus社群联合发起人、新炬网络董事/副总经理程永新与华为云数据库服务总经理苏光牛的独家对话,希望能同时给到国产数据库厂商和企业用户更具体、更详实、更适用的数据库应用策略与发展建议。新 创 访 谈受访嘉宾:苏光牛,华为云数据库服务总经理,负责华为云数据库业务的战略制定与发展,负责华为云数据库服务产品与解决方案的研发、运营和运维等。在数据库领域、IT基础设施、虚拟化和底层软件具备丰富的开发经验和团队管理经验,长期负责华为公司IT基础设施的研究与开发、虚拟化、数据库等解决方案的交付。采访者:程永新,dbaplus社群联合发起人,新炬网络董事/副总经理,拥有超过20年IT行业管理经验,计算机本科、工商管理硕士及EMBA。何为真正面向未来的分布式数据库?——分布式事务+分布式存储齐头并进,HTAP是趋势但并非万能程永新:作为一种新兴技术产品,分布式数据库的成熟度还有待提升,很多人依然保持观望态度,尤其是应用于核心系统,对此您有什么建议?苏光牛:从技术角度以及企业发展来看,随着业务的快速发展和数据量的爆发式增长,传统数据库在容量、扩展性、可用性等方面都遇到了巨大的挑战,只有分布式才能解决这些问题,才能满足企业的核心需求。所以在技术层面,分布式数据库是大势所趋,是未来。从产品创新的角度来看,传统数据库以Oracle为代表,在集中式架构上已经做得非常成熟和完善,而基于企业客户当前的真实需求,分布式架构正是时代给予数据库产品的新命题。从商业落地的现状来看,业界要对分布式数据库有信心,要给分布式数据库更多机会。以华为云GaussDB为例,当前已经在1500+政企客户规模商用,其中包括对数据库产品综合能力要求最为严苛的金融行业,GaussDB已经在国有6大行中的4家商用,并且应用在其核心业务系统中。经历更多核心业务系统的打磨,产品能力也将进一步得以完善成熟。程永新:分布式数据库目前有多种技术路线在同步发展,不同人口中的“分布式数据库”可能代表不同的技术栈,主要被归纳为分布式中间件、分布式事务、分布式存储这三大类。您认为未来的趋势是这种多样化持续发展,还是会最终统一为一种形态?或者说怎么才是真正的分布式数据库架构?苏光牛:分布式中间件是介于上层应用和数据库之间的一层架构,或者说更贴近于应用层。实际上,分布式中间件会造成应用复杂度的提升,而通过底层数据库来实现分布式,应用开发者只需要关注数据库提供的API和开放能力,降低了应用的复杂度,企业可以将更多资源投入到应用以及业务本身。我们认为真正的分布式数据库应该是分布式事务与分布式存储的深度融合,这是分布式数据库的典型特征。首先,分布式事务最大的特点就是解决性能问题,分布式数据库要确保高可用必须在分布式事务上进行更多的改进;其次,分布式存储也要重点突破,要做到在存储上具备一定的计算能力,让存储去理解一定的数据结构。华为云GaussDB在分布式事务以及分布式存储层面做了大量优化和创新,在分布式事务层面提升性能和数据一致性;在存储层面充分利用存储的计算能力,创新性地推出了近存储数据处理(NDP, Near Data Processing),并结合并行处理(PQ, Parallel Processing),进一步提升了分布式数据库性能。程永新:不少企业在经历了数据库拆分后,随着对数据一致性和实时性要求的进一步提高,发现对数据库整合的需求越来越强烈,最终又想回到集中式架构的怀抱。您认为企业该如何避免盲目跟风为了拆而拆,重新审视数据库架构选型的合理性?苏光牛:相比较集中式数据库,分布式数据库的扩展性、可靠性、可用性以及灾备能力的增强,可以给企业的运维以及系统设计带来更大的弹性。但这不意味着一个分布式数据库就可以满足企业的所有诉求,而是要从业务、安全、容灾、性能以及运维角度出发,综合考量,选择适合自身业务和应用场景的数据库,设计合适的数据库架构,不能为了拆而拆。程永新:说到合还是分这个话题,不得不提到近年来许多国内外数据库厂商都在聚焦的HTAP,您如何看待这种可同时支持OLTP和OLAP的混合负载能力?会是未来数据库主流发展方向吗?苏光牛:HTAP是未来数据库发展的一个方向,一个数据库同时满足企业对OLTP和OLAP的诉求,保证了查询和分析结果的实时性,更好地支持业务决策的实时性和敏捷性,但是需要注意以下三点:分布式数据库是实现HTAP的最佳方案;HTAP有一定的适用范围,是在TP的基础上增强了其AP能力,支持对查询分析有时效性诉求的业务场景。另外,一个数据库不可能存储企业所有的数据;从企业的业务角度出发,复杂决策需要汇聚不同来源、不同类型的数据在一个集中点,需要通过专业的数据仓库、数据湖或者湖仓一体的方案来构建专业的数据分析系统。数据库迁移的风险防控与选型建议 ——兼容Oracle是个移动靶,还容易把自身产品做成“四不像”程永新:更换数据库存在不少挑战,一是新产品、新架构带来的风险,二是迁移改造中的不确定性,三是产品本身在稳定性上潜在的问题。应对这些情况,有没有较为稳妥的迁移方式?苏光牛:数据库是底层软件,上面是应用和中间件,下面是操作系统和硬件,所以数据库尤其是异构数据库的替换是一个非常复杂的系统性工程,在替换过程中会遇到各种各样的问题,这些问题的解决不是靠某个工具或某个人就能搞定的,比较稳妥的方式是把整个迁移过程细化、分解,针对每个阶段都制定详细的方案并做好验证,能工具化的一定要工具化,因为工具出错的概率比人要低很多,不能工具化的一定要找对应的专家来解决,过程中做好风险管理,及时闭环。为了帮助客户迁移,我们提供了多种工具,比如:数据库迁移工具UGO,实现异构数据库对象和应用迁移,语法的转化率达到90%以上;提供14类核心对象的采集,是当前业界最全的对象采集工具;数据在线迁移工具DRS,能帮助客户实现数据的在线迁移、数据校验;流量回放工具,可实现对源端业务流量抓取,然后在目标端进行回放能力,确保迁移后业务的稳定性和性能。程永新:在不少“去O”项目中,为了尽量减少迁移工作,会选择兼容Oracle语法、甚至存储过程的产品。此类产品确实减少了迁移工作量,但从长远角度来看会是一个很好的选择吗?苏光牛:的确,现在有很多数据库厂商为了减少迁移工作量,主动或被动选择了兼容Oracle这个策略,但显然这不是最好的选择。首先,兼容Oracle是一个移动靶,永远不可能做到100%兼容,因为Oracle本身也在演进;其次,做Oracle兼容很容易把自己的产品做成一个“四不像”,今天兼容Oracle,明天就有可能兼容DB2或SQL Server,这么做反而会牺牲掉自身产品原生设计的优势;另外,Oracle兼容也可能存在法律风险,尤其是兼容Oracle特有的语法,要慎重。程永新:站在用户的角度看,目前各分布式数据库厂商在产品技术实现上存在较大差异,并且没有通用的使用标准,您有什么选型建议?苏光牛:我认为在产品选型时应该考虑以下几个方面:厂商层面:产品是否是长期战略投入以及具备规模商用能力,是否有完整的产业生态、未来人才储备,确保厂商有能力长期服务客户并保证市场人才供给;技术层面:产品的成熟度如何,是否经过核心商业系统对高可靠性、高可用性、安全性的打磨和考验,是否有规模应用案例;外围工具:是否提供数据迁移、容灾备份,以及完善的管理监控工具来帮助客户更好地使用和管理数据库;生态开放:数据库能力开放,客户不被封闭生态所绑定。云化及国产化的势在必行——拥抱云架构,借助国产数据库优势,应变而变才能乘势而上程永新:数据库上云是大势所趋,但鉴于中国国情等特殊原因,金融、电信、政务等行业的数据不可能完全搬到公有云上,混合云将成为中国企业用云的主流模式。然而由于不同的云资源壁垒难以打通,各业务系统架构也缺乏规模效应,会使混合云运维与运营更加复杂,稳定性、数据一致性等问题得不到保障,可有较好的解决方法?苏光牛:数据库上云已经是业界共识,即使客户因为特殊原因无法将业务部署到公有云,最终也会采用混合云或者云化架构。如今,我们面临的是愈加庞大的IT系统场景,如果企业没能及时转变到云架构的设计思路,依然用传统思维去建设和应对大规模复杂IT系统,当遇到机器故障时就很容易酿成事故。混合云或云架构的弹性和易用性给企业运维带来的好处是显而易见的,但既然选择这种特殊方式,就免不了要接受一定的运维成本,但相对于企业自行搭建一套负载均衡等平台,无论是从人员成本、运维成本还是使用难度来说,整体下来其实都比用公有云要高。为了满足不同的客户诉求,华为云数据库以公有云和华为云Stack形式提供服务,客户可以选择适合业务模式的部署形式;而且云上云下版本、技术栈、API保持一致,客户可以在合适的时间在混合云和公有云之间迁移。程永新:圈子里不乏这样一些声音,说目前市面上不少国产数据库都是由MySQL和PostgreSQL魔改而来的,倒不如直接用MySQL或PostgreSQL。对此您有什么看法?苏光牛:这是一个产品应用场景的问题,开源数据库产品和自研产品针对的应用场景和客户诉求是不同的。直接使用开源数据库产品,要求企业自身具备一定的人才储备和技术能力,熟悉产品的使用场景和技术细节,可以在产品出现问题而社区没有修复的情况下,有能力解决问题。开源数据库对于初创期的数据库厂商来说,的确是一个很好的范本和参考对象,但要作为一款企业级数据库推出市面,真正满足企业实际需求,其实需要做很多非功能性的属性,包括性能、可安装、可用性、易用性、安全性等,这些非功能性需求对数据库来说占比非常高,但开源产品是不具备的。在华为云上,我们提供了不同的数据库服务来满足不同应用场景的客户诉求:华为云RDS for MySQL、RDS for PostgreSQL、DDS文档数据库服务(文档类型Mongo),基于开源打造的数据库服务,主要面向数据规模较小、对性能要求不高的业务场景,提供极致性价比的解决方案。华为GaussDB系列,立足创新与自研,一方面拥抱并兼容MySQL等生态,另一方面打造开放的openGauss生态,主要面向政企客户,满足对高性能、高可靠、高安全以及服务能力等方面的诉求。 程永新:如今,数据库国产化替代已不再停留于能不能的问题,而是对谁能交付得更快、投入成本更少、安全性更高的考量。您认为目前国产数据库与Oracle为代表的国外商用数据库还存在哪些差距?接下来国产数据库该如何在技术、生态等层面消除用户的后顾之忧?苏光牛:首先,以Oracle为代表的传统数据库产品,经过多年发展和积累,产品能力完善,生态成熟。与之相比,目前国产数据库在特性上仍然存在不少差距,但在实际的企业使用中,已经足够满足包括接口上、数据迁移上、应用改造上等大多数需求。而且随着业务的增长,企业对数据库的可用性、可靠性、性能以及扩展性提出了新的要求,传统数据库已经无法满足,而云原生、分布式,则更适合企业当下及未来对数据库的诉求,这也是以GaussDB为代表的国产数据库的优势所在。在技术层面,其实国产数据库的性能已不是问题,当然也不能盲目追求性能数字,很多特殊的优化手段在实际应用中根本无法使用,多数企业更多的担忧其实在于变化,担心变化后带来不可预测和不可控制的风险。所以正如我前面所说,业界要给国产数据库更多信心和机会,只有经历过核心系统的不断打磨,才能促进产品技术能力的进一步成熟。在生态层面,以GaussDB为例,我们通过产学研用全面结合,为业界培养未来数据库人才,同时为开发者提供全方位的资源支持,上线GaussDB从初级到专家的培训认证,以及与合作伙伴联合开发解决方案,从全产业链打造生态,确保为用户提供可靠的、持续的服务和支持。以开源打造数据库根技术——开源需要持之以恒的投入,国产数据库亟需人才的培养程永新:开源是近年数据库领域非常火的一个词,2020年华为就开源了openGauss,对于这种投入巨大且短期内较难收益的举措,你们是出于怎样的考量要和开发者、伙伴一起共建openGauss开源社区?苏光牛:华为一直积极参与开源社区,是多个全球顶级开源项目的重要成员,在开源领域贡献排名国内公司第一。说到数据库,华为在2001年就开始做数据库,当时是为了满足运营商业务需求,做的是一个内存数据库。从2011年开始战略投入,荟聚全球7大研究所、1000多名数据库专业人才,结合华为软硬全栈协同方面的优势,先满足华为自身极度复杂业务场景的需求。在当前的大环境下,中国需要发展自己的数据库根技术。基于华为多年参与、支持开源社区的积累,我们将GaussDB单机主备能力开源,与合作伙伴、客户、开发者共建、共享、共治openGauss开源社区,共同促进国内数据库行业的快速发展,打造数据库根技术。程永新:在开源至今一年多的时间里,开源给你们带来了什么?苏光牛:数据库是一个生态型的产品,只有把生态做起来,才能形成共赢的局面。从2020年6月开源到现在,openGauss社区吸引了2500多开发者、30000多用户、20个兴趣小组、6个城市用户组,12家合作伙伴基于openGauss发布了自有品牌数据库,100家头部企业加入社区,我们看到了一个蓬勃发展、越来越活跃的openGauss开源社区。程永新:您如何看待国产数据库相继开源的热潮及未来发展?苏光牛:开源将会促进国产数据库的快速发展,对整个数据库行业以及数据库从业者都是有利的。但是开源需要真正的开源,不是简单的开放代码,而是需要长期的、大量的人员和资源投入,与业界共建社区、不断改进产品。长远来看,只有像华为这样将开源当作业务来做的才得以促进开源的持续发展,获得生态的成功。纵观当下国产数据库百花齐发的态势,未来要想真正将数据库产品做大做强,我认为核心在于人才。因为数据库是一个对工程化要求特别高的东西,对代码精细化程度有非常高的标准,如何把成熟的理论在代码层面实现出来,既满足高可用,又满足高性能,还要满足数据一致性等基本要求,并不是一件简单的事情。所以国产数据库想保持向上的势头,未来发展必须注重数据库内核人才的引入和培养。
-
 >摘要:Apache Flink是为分布式、高性能的流处理应用程序打造的开源流处理框架。本文分享自华为云社区《[【云驻共创】手把手教你玩转Flink流批一体分布式实时处理引擎](https://bbs.huaweicloud.com/blogs/317816?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content)》,作者: 萌兔之约。 Apache Flink是为分布式、高性能的流处理应用程序打造的开源流处理框架。Flink不仅能提供同时支持高吞吐和exactly-once语义的实时计算,还能提供批量数据处理。相较于市面上的其他数据处理引擎,它采用的是基于流计算来模拟批处理。 # 一、Flink原理及架构 ## Flink简介 Apache Flink是为分布式、高性能的流处理应用程序打造的开源流处理框架。Flink不仅能提供同时支持高吞吐和exactly-once语义的实时计算,还能提供批量数据处理。主要由Java代码实现,支持实时流处理和批处理,批数据只是流数据的一个极限案例。支持了迭代计算,内存管理和程序优化。  相较于市面上的其他数据处理引擎,Flink和Spark都可以同时支持流处理和批处理。但是,Spark的技术理念是基于批处理来模拟流的计算;而Flink则完全相反,它采用的是基于流计算来模拟批处理。 ## Flink关键机制 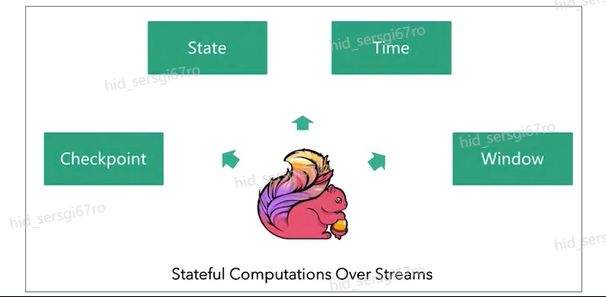 四个机制:状态、时间、检查点、窗口 Flink中有四种最重要的关键机制,这些关键机制在后面我们也会来进行详细的介绍,这里我们主要介绍它的基本概念以及主要用途。首先Flink中最重要的一个机制是状态机制(State),Flink是一种有状态的流计算引擎。状态的作用主要是我们Flink是一种流计算,它需要存储节点的中间计算结果。另外状态的保存还有利于Flink进行容错恢复。状态有密切关系的是Flink的Checkpoint,也就是检查点的机制,Checkpoint能够去把Flink的状态进行存储,相当于是做一次快照,方便Flink进行容错恢复。另外因为Flink它是一种流计算引擎,它的数据是不间断产生的,是没有界限的,因此我们需要有一种机制能够对数据进行切分,我们会采用的时间(Time)作为切分点,另外Flink进行容错性的恢复,它也需要知道从哪个时间点来进行恢复。所以说时间也是Flink中一种很重要的机制。最后是窗口window,在Flink中需要使用的窗口对数据进行切分,也方便对数据进行聚合计算。 ## Flink核心理念 Flink与其他流计算引擎的最大区别,就是状态管理。 Flink提供了内置的状态管理,可以把工作时状态存储在Flink内部,而不需要把它存储在外部系统。这样做的好处: - 降低了计算引擎对外部系统的依赖,使得部署、运维更加简单; - 对性能带来了极大的提升。 ## Flink Runtime整体架构 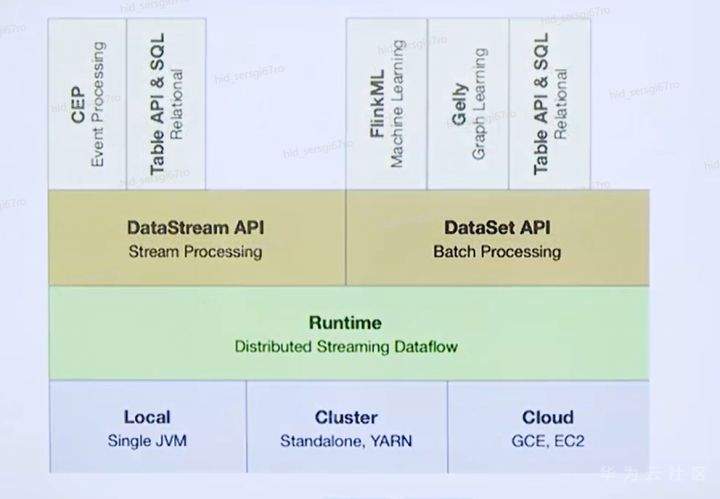 Flink运行时架构从下至上可以分为了三层,在最下层是Flink的一些配置方式,Flink可以采用单机的方式安装,也可以采用的集群的方式安装,另外也可以采用云的方式部署。在大多数情况下,Flink都是采用的集群的方式进行配置和安装的。其中呢它支持了两种集群模式,一种是Standalon,这种方式是采用了Flink自身提供的资源调度管理器。另外一种方式是基于YARN的方式进行了配置安装。 YARN提供了专用的资源管理器。在中间层次是Flink的计算引擎,这个计算引擎它同时能够支持流处理和批处理,可以接收了上层的api提交给它做作业 。Runtime这个引擎上面可以分为了两个模块,一个模块是DataStream api,一个是DataSet api。Flink向dataset和datastream,也就是批数据集以及流数据集是分开处理的,但是都是公用下面的计算引擎。基于两种类型的api,Flink又提供了更多的上层的抽象的api,API越抽象,它的表达能力越弱,但是它对数据的处理能力、抽象性也越强。在针对于上层Table api和SQL,它是主要是针对关系运算的,那针对关系数据的查询,Flink提供了统一的接口,基于流数据api,同时提供了复杂事件处理api。复杂事件指的就是说对不能够用时间去表示事件的开始、次序以及结束这样的事件进行处理的api接口。另外针对于数据及api,它提供了机器学习api以及图计算的api。 ## Flink核心概念- DataStream  DataStream: Flink用类DataStream来表示程序中的流式数据。用户可以认为它们是含有重复数据的不可修改的集合(collection),DataStream中元素的数量是无限的。 从图中我们可以发现,对DataStream可以使用一些算子,例如KeyBy这样的算子,对它进行处理转换之后,它会转换成另外一种数据流,也称为keyedstream。那么基于keyedstream,我们进一步可以使用窗口算子,这主要是Flink程序设计中对数据流的一些处理方式。 ## Flink核心概念- DataSet DataSet : Flink系统可对数据集进行转换(例如,过滤,映射,联接,分组),数据集可从读取文件或从本地集合创建。结果通过接收器( Sink)返回,接收器可以将数据写入(分布式)文件或标准输出(例如命令行终端) ## Flink程序 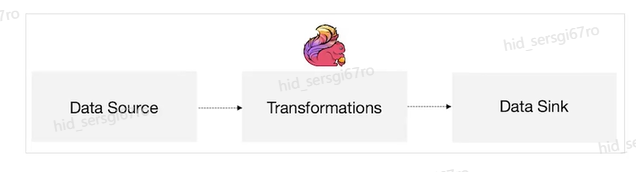 Flink程序由Source、Transformation和Sink三部分组成,其中Source主要负责数据的读取,支持HDFS、kafka和文本等;Transformation主要负责对数据的转换操作; Sink负责最终数据的输出,支持HDFS、kafka和文本输出等。在各部分之间流转的数据称为流( stream ) 。 ## Flink数据源 批处理: Files:HDFS,Local file system,MapR file system;Text,CSV,Avro,Hadoop input formats JDBC、HBase和 Collections 流处理: Files、Socket streams、Kafka、RabbitMQ、Flume、Collections、 Implement your own和SourceFunction.collecto # Flink程序运行图 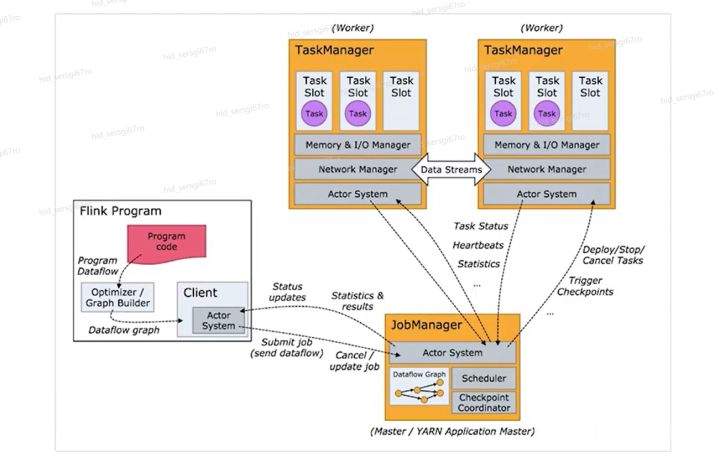 Flink是一种master-Slave架构,它在启动的时候就会产生了JobManger以及TaskManager。事实上在Flink程序中还包含两个组件,这两个组件一个叫resource manager,主要负责了资源的调度与管理,另外一个称为Dispatcher。主要是用来进行client,要把JobManager进行分发公布。我们来看一看具体的运行流程。 首先是用户提交Flink程序,这个Flink程序就会转换成逻辑数据流图。客户端接收到逻辑数据流图之后,然后连同jar包以及一些依赖包就会提交给了JobManger,JobManger接收到逻辑数据流图之后会转成物理数据流图,这个物理数据流图是真实的可执行的,能够具体的将任务放置在TaskManager上,在TaskManager中会将它所拥有的资源划分成一个一个的TaskSlot。每个TaskSlot实际上就相当于是jvm,它的一个具体的线程。每个TaskSlot占用了TaskManager的一部分资源,这里的资源主要是以内存进行划分的,TaskSlot不对cpu的资源进行划分,因此没有对cpu的资源进行隔离。 ## Flink作业运行流程(一) 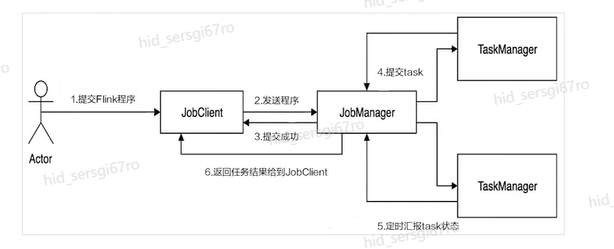 用户首先提交Flink程序到JobClient,经过JobClient的处理、解析、优化提交到JobManager,最后由TaskManager运行task。 在Flink中它通过了JobClient提交了任务,做过JobClient提交的任务进一步的进行优化、解析以及处理,提交给了JobManager。JobManager会将jobClient提交了逻辑数据流图转换成物理数据流图,然后将这些任务分配给taskmanager。taskmanager接受到任务之后就相应地进行处理,并且汇报了task的状态给JobManager,JobManager最后就把结果反馈给jobClient。 JobClient是Flink程序和JobManager交互的桥梁。主要负责接收程序、解析程序的执行计划、优化程序的执行计划,然后提交执行计划到JobManager。在Flink中主要有三类Operator。 Source Operator:数据源操作,比如文件、socket、Kafka等。 Transformation Operator:数据转换操作,比如map,flatMap,reduce等算子。 Sink Operator:数据存储操作。比如数据存储到HDFS、Mysql、Kafka等等。 ## 一个完整的Flink程序---java  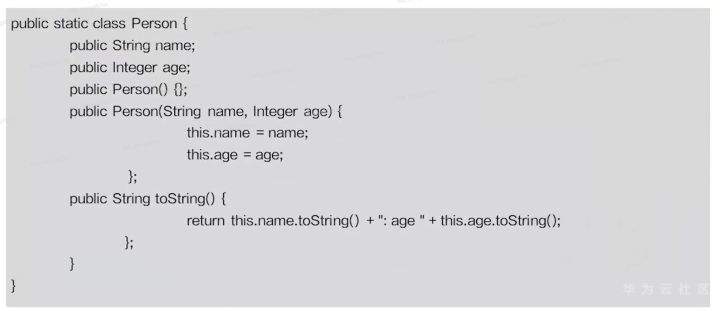 ## Flink的数据处理 Apache Flink它同时支持批处理和流处理,也能用来做一些基于事件的应用。 首先Flink是一个纯流式的计算引擎,它的基本数据模型是数据流。流可以是无边界的无限流,即一般意义上的流处理。也可以是有边界的有限流,就是批处理。因此Flink用一套架构同时支持了流处理和批处理。 其次,Flink的一个优势是支持有状态的计算。如果处理一个事件(或一条数据)的结果只跟事6件本身的内容有关,称为无状态处理;反之结果还和之前处理过的事件有关,称为有状态处理。 ## 有界流与无界流 无界流:有定义流的开始,但没有定义流的结束。数据源会无休止地产生数据。无界流的数据必须持续处理,即数据被读取后需要立刻处理。不能等到所有数据都到达再处理,因为输入是无限的,在任何时候输入都不会完成。处理无界数据通常要求以特定顺序摄取事件,例如事件发生的顺序,以便能够推断结果的完整性。 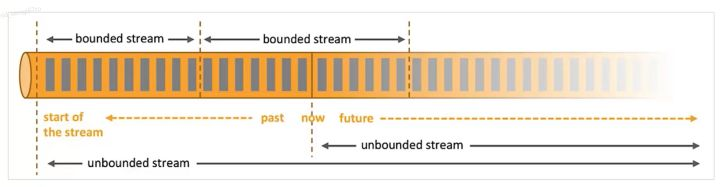 有界流:有定义流的开始,也有定义流的结束。有界流可以在读取所有数据后再进行计算。有界流所有数据可以被排序,所以并不需要有序摄取。有界流处理通常被称为批处理。 ## 批处理示例 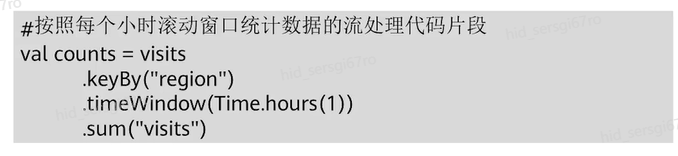 批处理是流处理的一种非常特殊的情况。在流处理中,我们为数据定义滑动窗口或滚动窗口,并且在每次窗口滑动或滚动时生成结果。批处理则不同,我们定义一个全局窗口,所有的记录都属于同一个窗口。举例来说,以下代码表示一个简单的Flink程序,它负责每小时对某网站的访问者计数,并按照地区分组。 如果知道输入数据是有限的,则可以通过以下代码实现批处理。 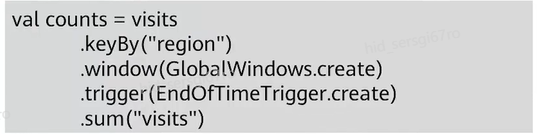 如果输入数据是有限的,那么下面代码与上面代码的运行结果相同。 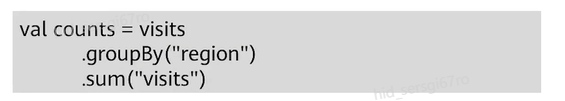 ## Flink批处理模型 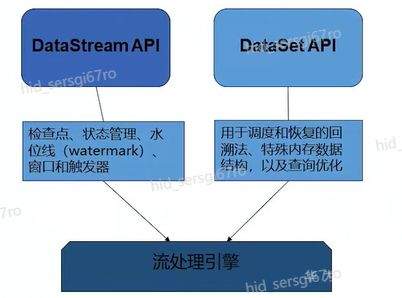 Flink通过一个底层引擎同时支持流处理和批处理。 在流处理引擎之上,Flink 有以下机制: - 检查点机制和状态机制:用于实现容错、有状态的处理; - 水印机制:用于实现事件时钟; - 窗口和触发器:用于限制计算范围,并定义呈现结果的时间。 在同一个流处理引擎之上,Flink 还存在另一套机制,用于实现高效的批处理。 - 用于调度和恢复的回溯法:由 Microsoft Dryad 引入,现在几乎用于所有批处理器; - 用于散列和排序的特殊内存数据结构:可以在需要时,将一部分数据从内存溢出到硬盘上; - 优化器:尽可能地缩短生成结果的时间。 流与批处理机制 两套机制分别对应各自的API(DataStream API 和 DataSet API);在创建 Flink 作业时,并不能通过将两者混合在一起来同时 利用 Flink 的所有功能。 Flink支持两种关系型的API,Table APl和sQL。这两个API都是批处理和流处理统一的APl,这意味着在无边界的实时数据流和有边界的历史记录数据流上,关系型API会以相同的语义执行查询,并产生相同的结果。 - **Table API / SQL** 正在以流批统一的方式成为分析型用例的主要 API。 - **DataStream API** 是数据驱动应用程序和数据管道的主要API。 # 二、Flink的Time与Window ## 时间背景 在流处理器编程中,对于时间的处理是非常关键的。比如计数的例子,事件流数据(例如服务器日志数据、网页点击数据和交易数据)不断产生,我们需要用key将事件分组,并且每隔一段时间就针对每一个key对应的事件计数。这就是我们熟知的“大数据”应流处理中的时间分类 在数据流处理过程中,我们经常使用系统处理时间即: processing time作为某个事件的时间,而实际上系统时间processing time是我们强加给事件的时间,由于网络延迟等原因并不能较好的反应事件之间发生的先后顺序。 在实际场景中,每个事件的时间可以分为三种: - event time,即事件发生时的时间; - ingestion time,即事件到达流处理系统的时间; - processing time,即事件被系统处理的时间。 ## 三种时间示例 例如,一条日志进入Flink的时间为2019-11-1210:00:00.123,到达window的系统时间为2019-11-1210:00:01.234,日志的内容如下: 2019-11-0218:37:15.624 INFO Fail over to rm2 2019-11-0218:37:15.624是Event Time; 2019-11-1210:00:00.123是Ingestion Time; 2019-11-1210:00:01.234是Processing Time; ## 三种时间的区别 实际情况中事件真正发生的先后顺序与系统处理时间存在一定的差异,这些差异主要由网络延迟、处理时间的长短等造成。如图所示: 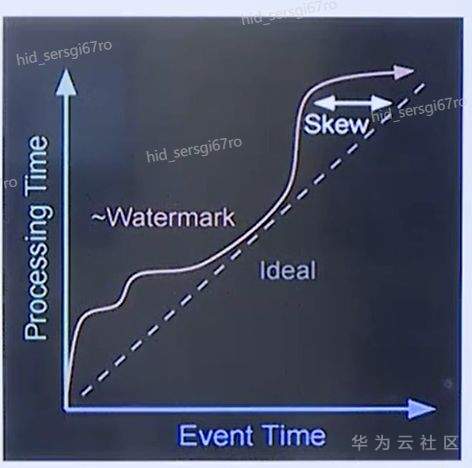 横坐标代表Event time,纵坐标代表processing time。理想情况下,eventtime和processing time构成的坐标应该形成一条倾斜角为45度的线。但实际应用过程中,processing time要落后与eventtime,造成事件到来的先后顺序不一致。 ## Flink支持的时间语义 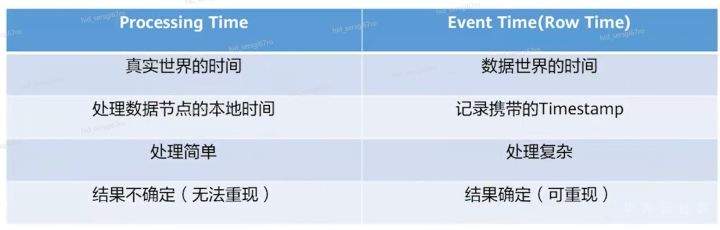 Processing Time是指事件数据被Operator处理时所在机器的系统时间,它提供了最好的性能和最低的延迟。 Event Time是指在数据产生时该设备上对应的时间,这个时间在进入Flink之前已经存在于数据记录中了。 Ingestion Time指的是事件数据进入到Flink的时间。 ## Window概述 流式计算是一种被设计用于处理无限数据集的数据处理引擎,而无限数据集是指一种不断增长的本质上无限的数据集,而Window是一种切割无限数据为有限块进行处理的手段。Window是无限数据流处理的核心,它将一个无限的stream拆分成有限大小的"buckets"桶,我们可以在这些桶上做计算操作。 ## Window类型 Window根据应用类型可以分成两类: - CountWindow:数据驱动,按照指定的数据条数生成一个Window,与时间无关。 - TimeWindow:时间驱动,按照时间生成Window。 Apache Flink是一个天然支持无限流数据处理的分布式计算框架,在Flink中 Window可以将无限流切分成有限流。Flink中 Window可以是Time Window,也可以是Count Window。 # TimeWindow分类 TimeWindow可以根据窗口实现原理的不同分成三类:滚动窗口(Tumbling Window ) .滑动窗口( Sliding Window)和会话窗口( Session Window)。 ## 滚动窗口 将数据依据固定的窗口长度对数据进行切片。特点:时间对齐,窗口长度固定,没有重叠。 适用场景:适合做Bl统计等(做每个时间段的聚合计算)。 举一个例子,假设要对传感器输出的数值求和。一分钟滚动窗口收集最近一分钟的数值,并在一分钟结束时输出总和,如下图所示。 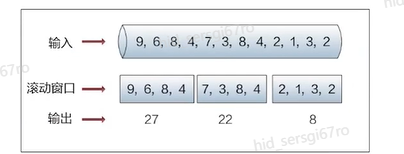 ## 滑动窗口 滑动窗口是固定窗口的更广义的一种形式,滑动窗口由固定的窗口长度和滑动间隔组成。特点∶时间对齐,窗口长度固定,有重叠。 适用场景:对最近一个时间段内的统计(求某接口最近5min的失败率来决定是否要报警)。 示例:一分钟滑动窗口计算最近一分钟的数值总和,但每半分钟滑动一次并输出结果,如下图所示。 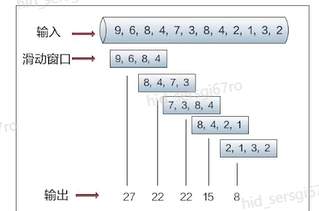 ## 会话窗口 会话窗口由一系列事件组合一个指定时间长度的timeout间隙组成,类似于web应用的session,也就是一段时间没有接收到新数据就会生成新的窗口。特点:时间无对齐。 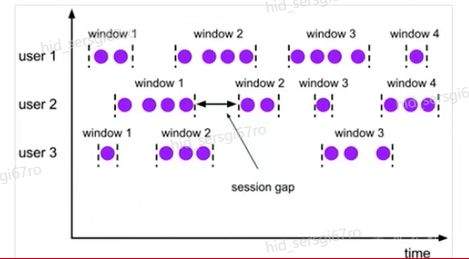 ## 代码定义 在Flink中,一分钟滚动窗口的定义如下: `stream.timeWindow(Time.minutes(1));` 在Flink中,每半分钟(即30秒)滑动一次的一分钟滑动窗口,如下所示: `stream.timeWindow(Time.minutes(1),Time.seconds(30));` # 三、Flink的Watermark ## 乱序问题 流处理从事件产生,到流经source,再到operator,中间是有一个过程和时间的,虽然大部分情况下,流到operator的数据都是按照事件产生的时间顺序来的,但是也不排除由于网络、分布式等原因,导致乱序的产生,所谓乱序,就是指Flink接收到的事件的先后顺序不是严格按照事件的Event Time顺序排列的。 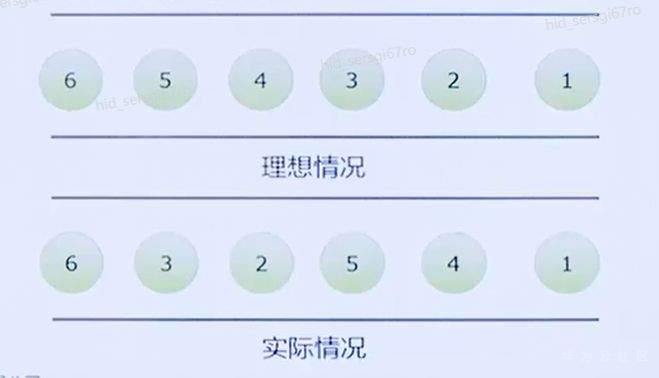 此时出现一个问题,一旦出现乱序,如果只根据eventTime决定window的运行,我们不能明确数据是否全部到位,但又不能无限期的等下去,此时必须要有个机制来保证一个特定的时间后,必须触发window去进行计算了,这个特别的机制,就是Watermark。 ## 乱序示例 例子:某App会记录用户的所有点击行为,并回传日志(在网络不好的情况下,先保存在本地,延后回传)。A用户在11:02对App进行操作,B用户在11:03对App进行操作,但是A用户的网络不太稳定,回传日志延迟了,导致我们在服务端先接受到B用户11:03的消息,然后再接受到A用户11:02的消息,消息乱序了。 # 水位线(Watermark) 对于无穷数据集,我们缺乏一种有效的方式来判断数据完整性,因此就有了Watermark,它是建立在事件时间上的一个概念,用来刻画数据流的完整性。如果按照处理时间来衡量事件,一切都是有序的、完美的,自然而然也就不需要Watermark了。换句话说事件时间带来了乱序的问题,而Watermark就是用来解决乱序问题。所谓的乱序,其实就是有事件延迟了,对于延迟的元素,我们不可能无限期的等下去,必须要有一种机制来保证一个特定的时间后,必须触发Window进行计算。这个特别的机制,就是Watermark,它告诉了算子延迟到达的消息不应该再被接收。 - Watermark是一种衡量Event Time进展的机制。 - Watermark是用于处理乱序事件的,而正确的处理乱序事件,通常用Watermark机制结合window来实现。 - 数据流中的Watermark用于表示timestamp小于Watermark的数据,都已经到达了,因此,window的执行也是由Watermark触发的。 - Watermark可以理解成一个延迟触发机制,我们可以设置Watermark的延时时长t,每次系统会校验已经到达的数据中最大的maxEventTime,然后认定eventTime小于maxEventTime - t的所有数据都已经到达,如果有窗口的停止时间等于maxEventTime – t,那么这个窗口被触发执行。 - watermark 用来让程序自己平衡延迟和结果正确性 # Watermark的原理 Flink怎么保证基于event-time的窗口在销毁的时候,已经处理完了所有的数据呢? 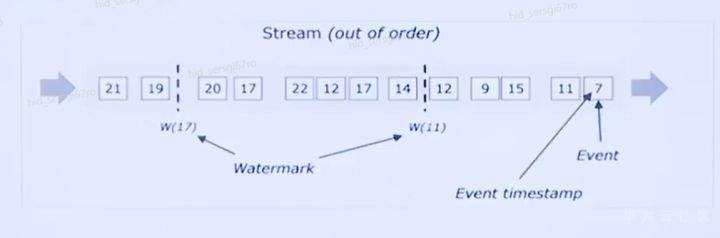 这就是watermark的功能所在。watermark会携带一个单调递增的时间戳t,Watermark(t)表示所有时间戳不大于t的数据都已经到来了,未来小于等于t的数据不会再来,因此可以放心地触发和销毁窗口了。 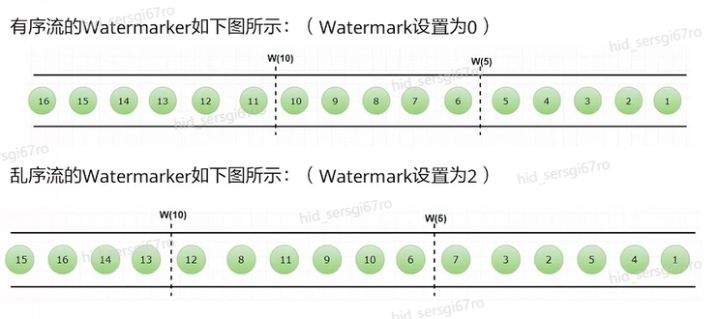 当Flink,接收到数据时,会按照一定的规则去生成Watermark,这条Watermark就等于当前所有到达数据中的maExertT me"-延N时长,也就定说,Watermark是基于数据携带的时间戳生成的,一旦Watermark比当前未触发的窗口的停止时间要晚,那么就会触发相应窗口的执行。由于eventtime是由数据携带的,因此,如果运行过程中无法获取新的数据,那么没有被触发的窗口将永远都不被触发。 上图中,我们设置的允许最大延迟到达时间为2s,所以时间戳为7s的事件对应的Watermark 是 5s,时间戳为12s的事件的Watermark是10s,如果我们的窗口是1s-5s,窗口2是6s~-10s,那么时间戳为7s的事件到达时的Matermarker.恰好触发窗口1,时间戳为 12s的事件到达时的Watermark恰好触发窗口2。 Watermark就是触发前一窗口的“关窗时间”,一旦触发关门那么以当前时刻为准在窗口范围内的所有所有数据都会收入窗中。只要没有达到水位那么不管现实中的时间推进了多久都不会触发关窗。 ## 延迟的数据 Watermark能够应对乱序的数据,但是真实世界中没法得到一个完美的 Watermark数值。要么没法获取到,要么耗费太大,因此实际工作中会近似 Watermark(t)之后,还有较小的概率接受到时间戳t之前的数据,在Flink中将这些数据定义为“late elements”,同样可以在Window中指定允许延迟的最大时间(默认为О),可以使用下面的代码进行设置:  ## 延迟数据处理机制 延迟事件是乱序事件的特例,和一般乱序事件不同的是它们的乱序程度超出了水位线( Watermark)的预计,导致窗口在它们到达之前已经关闭。 延迟事件出现时窗口已经关闭并产出了计算结果,对于此种情况处理的方法有3种: - 重新激活已经关闭的窗口并重新计算以修正结果。 - 将延迟事件收集起来另外处理。 - 将延迟事件视为错误消息并丢弃。 Flink默认的处理方式是第3种直接丢弃,其他两种方式分别使用Side Output和AllowedLateness。 ## Side Output机制 Side Output机制可以将延迟事件单独放入一个数据流分支,这会作为Window计算结果的副产品,以便用户获取并对其进行特殊处理。 side Output获取延迟数据: 设置allowedLateness之后,迟来的数据同样可以触发窗口,进行输出,利用Flink的sideoutput机制,可以获取到这些延迟的数据,使用方式如下: 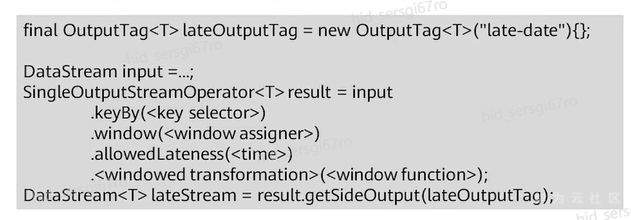 ## Allowed Lateness机制 Allowed Lateness机制允许用户设置一个允许的最大延迟时长。Flink会在窗口关闭后一直保存窗口的状态直至超过允许延迟时长,这期间的延迟事件不会被丢弃,而是默认会触发窗口重新计算。因为保存窗口状态需要额外内存,并且如果窗口计算使用了ProcessWindowFunction APl还可能使得每个延迟事件触发一次窗口的全量计算,代价比较大,所以允许延迟时长不宜设得太长,延迟事件也不宜过多。 # 四、Flink的容错 ## Flink容错机制 为了保证程序的容错恢复以及程序启动时其状态恢复,Flink任务都会开启Checkpoint或者触发Savepoint进行状态保存。 - Checkpoint机制。这种机制保证了实时程序运行时,即使突然遇到异常也能够进行自我恢复。Checkpoint对于用户层面,是透明的,用户会感觉不到Checkpoint过程的存在。 - Savepoint机制。是在某个时间点程序状态全局镜像,以后程序在进行升级,或者修改并发度等情况,还能从保存的状态位继续启动恢复。Savepoint可以看做是Checkpoint在特定时期的一个状态快照。 ## Checkpoint Flink 如何保证exactly-once呢?它使用一种被称为“检查点( Checkpoint )”的特性,在出现故障时将系统重置回正确状态。Flink状态保存主要依靠Checkpoint机制,Checkpoint会定时制作分布式快照,对程序中的状态进行备份。 ## Checkpoint检查点机制 Flink中基于异步轻量级的分布式快照技术提供了Checkpoints容错机制,分布式快照可以将同一时间点Task/Operator的状态数据全局统一快照处理。Flink会在输入的数据集上间隔性地生成checkpoint barrier,通过棚栏( barrier)将间隔时间段内的数据划分到相应的checkpoint中。当应用出现异常时,Operator就能够从上一次快照中恢复所有算子之前的状态,从而保证数据的一致性。 对于状态占用空间比较小的应用,快照产生过程非常轻量,高频率创建且对Flink任务性能影响相对较小。Checkpoint过程中状态数据一般被保存在一个可配置的环境中,通常是在JobManager节点或HDFS上。 ## Checkpoint配置 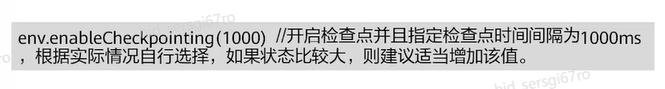 默认情况下Flink不开启检查点,用户需要在程序中通过调用enableCheckpointing(n)方法配置和开启检查点,其中n为检查点执行的时间间隔,单位为毫秒。 **exactly-once和at-least-once语义选择** exactly-once:保证端到端数据一致性,数据要求高,不允许出现数据丢失和数据重复,Flink的性能也相对较弱; at-least-once:时延和吞吐量要求非常高但对数据的一致性要求不高的场景。 Flink默认使用exactly-once模式,可以通过setCheckpointingMode()方法来设定语义模式。 env.getCheckpointConfig().setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE) **Checkpoint超时时间** 指定每次Checkpoint执行过程中的上限时间范围,一旦Checkpoint执行时间超过该阈值,Flink将会中断Checkpoint过程,并按照超时处理。 该指标可以通过setCheckpointTimeout方法设定,默认10分钟。 env.getCheckpointConfig().setCheckpointingTimeout(60000) **检查点之间最小时间间隔** 设定两个Checkpoint之间的最小时间间隔,防止出现状态数据过大而导致Checkpoint执行时间过长,从而导致Checkpoint积压过多,最终Flink应用密集地触发Checkpoint操作,会占用大量计算资源而影响到整个应用的性能。 env.getCheckpointConfig().setMinPauseBetweenCheckpoints(500) **最大并行执行的检查点数量** 设定能够同时执行的Checkpoint数量。在默认情况下只有一个检查点可以运行,根据用户指定的数量可以同时触发多个Checkpoint,从而提升Checkpoint整体的效率。 env.getCheckpointConfig().setMaxConcurrentCheckpoints(500) **外部检查点** 设定周期性的外部检查点,然后将状态数据持久化到外部系统中,使用这种方式不会在任务停止的过程中清理掉检查点数据,而是一直保存在外部系统介质中,也可以通过从外部检查点中对任务就行恢复。 env.getCheckpointConfig().enableExternalizedCheckpoints(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION) # 作业如何恢复数据? Flink在Cancel时允许在外部介质保留Checkpoint;另一方面,Flink还有另外一个机制是SavePoint. Savepoints是检查点的一种特殊实现,底层其实是使用Checkpoints的机制。Savepoints是用户以手工命令的方式触发,并将结果持久化到指定的存储路径中,目的是帮助用户在升级和维护集群过程中保存系统中的状态数据,避免因为停机运维或者升级应用等正常终止应用的操作而导致系统无法恢复到原有的计算状态的情况,从而无法实现端到端的Exactly-Once语义保证。 ## Savepoint与Checkpoint 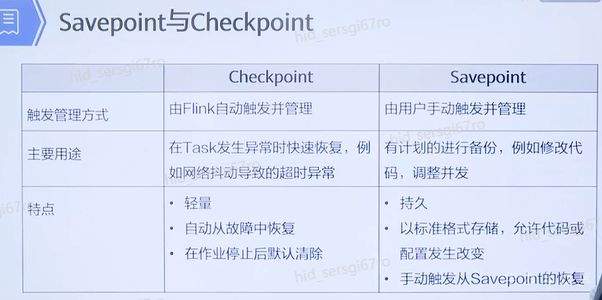 checkpoint的侧重点是“容错”,即Flink作业意外失败并重启之后,能够直接从早先打下的checkpoint恢复运行,且不影响作业逻辑的准确性。而savepoint的侧重点是“维护”,即Flink作业需要在人工干预下手动重启、升级、迁移或A/B测试时,先将状态整体写入可靠存储,维护完毕之后再从savepoint恢复现场。 savepoint是“通过checkpoint机制”创建的,所以savepoint本质上是特殊的checkpoint。 checkpoint面向Flink Runtime本身,由Flink的各个TaskManager定时触发快照并自动清理,一般不需要用户干预;savepoint面向用户,完全根据用户的需要触发与清理。 - 触发管理方式上,Checkpoint是由Flink自动触发并管理;Savepoint由用户手动触发并管理 - 主要用途上,Checkpoint在Task发生异常时快速恢复,例如网络抖动导致的超时异常;Savepoint有计划的进行备份,例如修改代码,调整并发 - 从特点上看,Checkpoint轻量,自动从故障中恢复,在作业停止后默认清除;Savepoint持久,以标准格式存储,允许代码或配置发生改变,手动触发从Savepoint的恢复。 ## 状态的存储方式-MemoryStateBackend 构造方式: MemoryStateBackend(int maxStateSize, boolean asynchronousSnapshots) 存储方式: - State: TaskManager内存;Checkpoint: JobManager内存。 容量限制: 单个state maxStateSize默认5M; maxStateSize=akka.framesize ,默认10 M。·总大小不超过JobManager的内存 推荐使用的场景:本地测试;几乎无状态的作业,比如ETL。 ## 状态的存储方式- FsStateBackend 构造方式: FsStateBackend(URI checkpointDataUri ,boolean asynchronousSnapshots) 存储方式: State: TaskManager内存; CHeckpoint:外部文件存储系统(本地或HDFS)。 容量限制: ·单TaskManager 上state总量不超过它的内存; ·总大小不超过配置的文件系统容量。 推荐使用的场景:常规使用状态的作业,例如分钟级别窗口聚合、Join;需要开启HA的作业;可以在生产场景使用。 ## 状态的存储方式- RocksDBStateBackend 构造方式: RocksDBStateBackend(URI checkpointDataUri ,boolean enableIncrementalCheckpointing) 存储方式: State: TaskManager上的KV数据库(实际使用内存+磁盘); CHeckpoint:外部文件存储系统(本地或HDFS)。 容量限制: 单TaskManager 上State总量不超过它的内存+磁盘; 单Key最大2G; 总大小不超过配置的文件系统容量。 推荐使用的场景:超大状态的作业,例如天级别窗口聚合;需要开启HA的作业;要求不高的作业;可以在生产场景使用。 # 总结 本章主要讲述了Flink的架构及技术原理,以及Flink程序的运行过程。重点在于Flink流处理与批处理的不同方式,从长远来看,DataStream API应该通过有界数据流完全包含DataSet APl。
-
在Hive流行之前,企业大多采用传统的并行数据仓库架构。传统的数据仓库一般采用国外知名厂商的大型服务器和成熟的解决方案,不仅价格昂贵且可拓展性较差,而且平台工具与其他厂商难以适配,用户操作体验也比较差、开发效率不高,当数据量达到TB级别后基本无法得到很好的性能。而且,传统数据仓库基本只擅长处理结构化或半结构化数据,对于非结构化数据的处理并不能很好地支持。Hive的出现,为企业提供了更加廉价且优质的解决方案。Hive的主要组件包括UI组件、Driver组件(Complier、Optimizer和Executor)、Metastore组件、JDBC/ODBC、Thrift Server和Hive Web Interface(HWI)等,接下来分别对这几个组件进行介绍。(1) Drvier组件: 该组件是Hive的核心组件,该组件包括Complier(编译器)、Optimizer(优化器)和Executor(执行器),它们的作用是对Hive SQL语句进行解析、编译优化、生成执行计划,然后调用底层MR计算框架。(2) MetaStore组件: 该组件是Hive用来负责管理元数据的组件。Hive的元数据存储在关系型数据库中,其支持的关系型数据库有Derby和Mysql,其中Derby是Hive默认情况下使用的数据库,它内嵌在Hive中,但是该数据库只支持单会话,在生产中并不适用,在我们日常的开发中,需要支持多会话,因此采用Mysql作为元数据库,Hive内部对Mysql提供了很好的支持。(3) Thrift Server:该组件提供JDBC和ODBC接入的能力,用来进行可扩展且跨语言的服务开发。Hive集成了该服务,能让不同的编程语言调用Hive的接口。(4) Web Interface:该组件是Hive客户端提供的一种通过网页方式访问Hive所提供的服务。
-
Hive 是基于Hadoop构建的一套数据仓库分析系统,用来进行数据提取、转化、加载,这是一种可以存储、查询和分析存储在Hadoop中的大规模数据的机制。Hive数据仓库工具能将结构化的数据文件映射为一张数据库表,并提供SQL查询功能,能将SQL语句转变成MapReduce任务来执行。Hive的优点是学习成本低,可以通过类似SQL语句实现快速MapReduce统计,使MapReduce变得更加简单,而不必开发专门的MapReduce应用。 Hive十分适合对数据仓库进行统计分析,Hive支持了绝大多数的语句如DDL、DML以及常见的聚合函数、连接查询、条件查询。它还提供了一系列的方法,进行数据提取转化加载,用来存储、查询和分析存储在Hadoop中的大规模数据集,并支持UDF(User-Defined Function)、UDAF(User-Defnes AggregateFunction)和UDTF(User-Defined Table-Generating Function),也可以实现对map和reduce函数的定制,为数据操作提供了良好的伸缩性和可扩展性。 Hive不适合用于联机(online)事务处理,也不提供实时查询功能。它最适合应用在基于大量不可变数据的批处理作业。Hive的特点包括:可伸缩(在Hadoop的集群上动态添加设备)、可扩展、容错、输入格式的松散耦合。
-
文章摘要:随着企业数字化转型深化,数据在企业中扮演着愈发重要的作用。数据无论从存储规模、还是计算要求都有着较之以往更高的需求。金融行业,作为数据应用的“高地”,这一点表现尤为突出。如何在新时期,满足对数据基础设施更高的要求,成为各金融机构首要面对的问题。分布式数据库,作为一种新的数据库架构,经过近十余年的高速发展,已逐步成熟,并开始在一些金融机构中投产使用。但这种新的架构,较之以往的传统架构有着诸多不同。本文尝试从建设背景、技术趋势、落地实践、典型产品等多角度,分析当前分布式数据库与金融行业背景想结合,如何实现更好的落地实践。1. 金融业分布式数据库建设背景1) 多元素驱动数据库架构升级数字化转型随着全行业数字化转型深化,金融业作为数据应用“高地”,走在这一趋势的前沿。一方面,金融业企业的业绩水平与数字化能力是直接挂钩的,从今年数据来看,转型较快的金融机构业绩提速明显快于较慢的;另一方面,来自宏观经济发展压力,导致规模盈利减低,进而导致业务转型加速。在数字化转型加剧的大背景下,金融 企业对数据使用呈现多样化特点且针对特性能力提出更高要求。相应的也对数据底层基础设施之一的数据库提出要求。金融业 业务驱动如上面所谈,金融业在数字化转型中,面临业务转型问题。当前金融业整体处于信息化末期、移动化成熟期、开放化成长期、智能化探索期。其典型特点是,金融行业的数据急剧增长,对数据存储和管理提出了更高要求;在高并发业务和大用户量带来的系统压力的同时,也要求移动应用响应速度更快。国家 政策指导在政策层面,国家很早就将新型数据库作为重要基础设施来看待并给出指导性原则。在《金融科技( FinTech)发展规划(2019-2021)》中明确指出:“加强分布式数据库的研发应用。做好分布式数据库金融应用的长期规划,加大研发与应用投入力度。有计划、分步骤稳妥推动分布式数据产品先行先试,形成可借鉴、能推广的典型案例和解决方案,为分布式数据库在金融领域的全面应用探明路径。建立健全产学结合、校企协同的人才培养机制,持续加强分布式数据库底层和前沿技术研究,制定分布式数据库金融应用标准规范,从技术架构、安全防护、灾难恢复等方面明确管理要求,确保分布式数据库在金融领域的稳妥应用。”2) 金融业对数据库转型诉求在上述大背景情况下,金融业对数据库支持能力呈现如下特点:实时性在数字化趋势下,数据会更多参与到企业决策、业务调整甚至驱动业务变化。数据的鲜活性,对企业价值意义完全不同。实时的交易处理、实时的反馈、实时的汇聚、实时的洞察成为全场景数字化的必备。例如在金融场景中,金融需求与生活场景相融合,实时风控的复杂度以及时效性要求随场景服务的发展不断增长,通常需要秒级完成业务流程。翻译成技术语言,即要求支持对数据高频实时多点写入、对多类信息实时汇聚分析处理。于是近些年来,在数据流式处理、 HTAP、高性能计算等领域的发展,正是为迎合这一诉求。敏捷性数字化转型下,各种业务形态不断涌现且单业务内变化也很大,这对底层基础设施提出了敏捷性要求。即具备快速响应能力,满足各类业务应用需求。作为传统的以静态、固定资源供给方式,过渡到以动态、可调节的资源供给方式。这其中以云、容器化、 Serverless、存算分离为代表的技术能力,正是为满足这类需求而诞生。即使是以较为传统架构的资源供给方式,也更为强调弹性、可定制能力,满足客户此方面需求。安全性数据安全,是近些年来的热门话题。从监管方的频频出台各项政策,可见一斑。作为承载数据的主体,数据库首当其冲需要将更为重视安全问题。从数据存储、数据访问、数据传输、数据应用等多角度解决数据安全问题。特别是过去一二十年开源数据库蓬勃发展,但开源数据库自身在安全方面是否能达到商用标准,值得关注。此外,考虑到复杂的国际产业环境,开源协议本身的合法合规性也值得关注。可用性可用性要求,一直是数据库提供的基本能力之一。随着数字化深入,越来越多的数据参与到企业经营管理之中,这些对于可用性要求提出了更高的要求。从数据库的角度来看,之前单机架构或集中式架构,一般是通过高可用硬件 +软件来解决;对于新兴的分布式架构来说,其组件更多也更为复杂,且对于硬件也无较多要求,这就要求软件本身提供更高要求。经济性随着数据存储规模越来越大,对数据计算要求越来越高,整体数据存储和计算的成本也整体提高。如何提供更具经济性的方案,对客户能否大规模使用意义很大。这其中云数据库、存算分离、数据分层等技术,正是为了应对这一诉求。云作为一种新的资源供给方式,可以带来更为切合需求的资源消耗。存算分离,则提供一种按计算和存储独立扩展能力,避免冗余浪费。数据分层,则可根据数据热度等因素提供不同的能力,满足个性化需求。智能化由上述变化可见,对于数据库而言,无论从使用规模、复杂程度都会带来很大调整。针对这一问题,一方面可以通过工具化、平台化的方式来满足管理问题;而更为优雅的方式是在数据库端提供内置的智能管理能力,例如智能调优、索引推荐、自我诊断、故障自愈等,可协助 DBA降低运维难度,大幅提升管理效率。海量并发这是两个需求,一个是数据规模问题,提供海量数据支撑能力;一个是数据计算问题,提供高并发访问支持。这些都是数字化会带来业务变化的必然。对应于技术而言,分布式数据库无疑是一种很好的方式,也是其主要面对解决的场景之一。统一管理随着数字化深入,对数据库的种类与数量、企业的 IT体系等都发生了不少变化。这些变化冲击了传统的数据库生态,第一数据库选型自身呈现多元化趋势;第二随着分布式、存算分离等新兴架构,对管理也带来了管理难题;第三随着对安全性、可靠性等方面的更高要求,也带来了不少难点。面对上述问题,为数据库提供统一管理和运维的平台型工具也逐渐走向台前,变得越来越重要。自主可控对基础软件来说,自主可控非常关键。作为数字化的载体,数据库的自主可控能力尤为重要。近些年国产化诉求日益高涨,也有着这方面的考虑。这其中值得关注的一点是关于开源的使用。根据近期的调研,开源数据库份额已经超越商业数据库;但对于开源数据库的把控能力,却有着较大差异。特别是某些商业数据库,底层也是基于开源产品的,尤其值得关注。开放生态数字化深入,带来的更多的场景、更多的方案、更多的产品。如何能做到产品之间的很好的融合,发挥最大的作用,开放生态非常重要。对于数据库而言,过去数十年来以国外商用数据库产品为主,已经培育自己的生态圈;而对于国内产品而言,还需要走过这一过程。比较可喜的是,开源软件的使用可大大加速这一过程。以 MySQL、PG为代表的开源软件,具有较为完备的生态,国内产品可通过兼容开源产品,复用其生态,大大加速这一进程。简化融合如之前所说,数字化深化带来的技术需求的多元化,与之对应的产品方案也呈现同样的态势。虽然可以通过统一管理角度去简化管理,但对于用户而言仍然不得不去面对复杂的管理和使用问题。如果能通过单一平台提供所需能力,无疑对用户非常有吸引力。这就是简化融合的诉求的来源。近些年来,包括混合事务与分析处理( HTAP)、湖仓一体、流批一体等,都是代表着用户追求 “简化、融合”技术栈的需求。此外,云也是一种简化融合的体现,通过一站式的产品+方案,解决用户复杂管理和使用问题。消费创新数据在未来扮演着愈发重要的角色,人们对数据的消费使用习惯也发生了很多变化。从使用角度来看,普惠性得以强调。数据的使用消费者,从传统的分析师、 BI工程师向普通的数据消费者转移。越来越多的用户能够触达数据,享受数据结果。当然,这也得对数据提供方式带来新的挑战,自助式、对话式、自动化甚至智能化的数据计算展现方式得到更多的使用,进一步减低人们使用数据的门槛。这对于底层数据库带来包括适配能力、实时计算、多模计算、智能分析等诸多要求。3) 分布式数据库在金融业使用痛点如之前所说,金融业一方面面临诸多转型压力,对底层数据库提出了更多要求;另一方面原有数据库技术已不适应当前业务特点,继续升级换代。面对底层基础设施的转型问题,分布式数据库作为解决上述方案的唯一选型。但在这一选择过程中,往往存在较多的痛点和难点。这主要是因为金融行业的特殊性所造成的。基础功能待完善对标传统集中式数据库,现有的分布式数据库在功能上仍然有待完善。这一方面是因为分布式架构所造成的功能 tradeoff,另一方面是在产品化能力完整性上的欠缺。前者是我们在使用分布式数据库产品时,需要在架构、设计层面需要在关注的,在项目初期都需要解决掉的。而后者厂商产品经过多年发展在内核能力上已趋于完善,但在周边配套的管理、设计、优化工具上,仍需进一步完善。毕竟最终为用户呈现的,是一套完整的数据库解决方案。运行稳定待验证对于金融行业而言,稳定性是第一位的。虽然分布式数据库在设计之初,就将稳定性设计放在优先位置,其天然的分布式架构也有利于提供更高的可用性保证。但一方面分布式架构天然由多组件组成,其复杂程度较集中式更高;另一方面其对底层基础环境的要求也更高。此外,产品的稳定性是要在长期实践中不断打磨、持续改进的。分布式数据库作为后来者,也需要经历这一过程。迁移改造任务重选择使用分布式数据库产品,对应用侧来说,需要有大量的应用迁移工作。一方面是由于分布式数据库较集中式数据库功能上有所削弱,另一方面更换数据库天然所需要的移植工作。虽然目前各分布式数据库也推出 兼容能力,但从实际效果来看仅能减少部分移植工作,整体迁移任务量仍然很高。且迁移采用所谓的兼容模式,也不利于后期平滑更换,这点后面会讲到。风险巨大需并行对底层数据库的更换,是存在较大技术风险的。一是由于新产品、新架构所带来的风险;二是应用迁移改造带来的不确定性;三是产品本身的稳定性的潜在风险。为应对这种情况,最为稳妥的方式是采取应用双发并行的方式解决。这种方式可在最大程度上减少可能初期的风险,可做到数据冗余、无缝切换、灵活可控等,但其花费的代价也是非常高的。需要从应用端做大量双发改造,如果更换系统很多,这方面代价是比较大的。生态环境需培育虽然发展多年,但国产分布式数据库在整体市场上仍然属于小众选择。之前国外厂商产品占据市场领导地位,经过多年发展已形成了较为完善的生态。随着近些年来, MySQL、PG开源数据库在互联网行业得到大量应用,积累大量用户,建立其不错的生态。很多国产分布式数据库采用迂回策略,通过兼容上述数据库标准,来享受开源生态红利。此外,近期国产数据库如TiDB、OceanBase、PorlaDB、openGuass等,也纷纷开源建设自有生态。信创要求时间紧作为国家安全的重要举措之一,安全可控成为基础要求,信创因而诞生。为保证上述政策执行到位,国家也设定实施计划。作为基础软件的数据库,也是信创工作的重点。如何在规定的时间内完成,也为各企业带来的很大压力。场景多元难选择与互联网企业不同,金融行业对数据的使用场景更加多元化,这也对数据库提出了较高的要求。仅选择单一数据库满足全场景需求,几乎是不可能的。在传统集中式数据库上,这一问题还不明显,因为这些数据库往往是多面手,各方面功能较为均衡;而分布式数据库则不然,其往往有明确的适用场景范围。而作为企业用户,是需要对自己场景有个清晰的认识,然后按图索骥找到适合自己的产品。厂商绑定风险高选择某厂商产品,也就意味着选择某一技术路线,如果深度依赖厂商产品的特有能力,无疑存在绑定风险问题。这点对于分布式数据库来说,表现尤甚。各厂商产品实现差异很大,没有通用的使用标准。如何规避这一风险,带来最大的自由度选择?后文会展开说明。2. 分布式数据库技术发展趋势1) 数据库技术发展整体趋势数据库技术 ,最早源自上世纪70年代,从IBM著名的论文开始,后面诞生了Oracle、DB2为代表的优秀商业产品以及PostgreSQL、MySQL为代表的开源产品。这些产品很好的满足了对数据存储和计算的需求。随着21世纪初期,互联网浪潮的来临,数据规模呈爆炸式增长,单机数据库越来越难以满足用户需求。这也催生了分布式数据库的到来。到了2006年之后,出现以HBase/Cassadra/MongoDB为代表的NoSQL类产品。这些产品实现了分布式架构,可以实现容量的水平扩展,但也牺牲了诸如事务、SQL访问接口等能力。存储模型的简化为存储系统的开发带来了便利,但是降低了对业务的支撑。在这一阶段,很多企业为了解决大规模数据存储与访问的问题,也研发了很多中间件产品。其原理是通过将数据分片存储到单机库,上层对SQL解析实现对语句的路由。这种方式有一定的难点,例如对分布式事务的处理及规模扩大下的管理问题。到了2012年,Google的论文为关系模型的分布式架构,提供了新型分布式数据库理论基础。在此之后,诞生了一系列新型分布式数据库产品。其原理是通过分布式一致性算法协议完成底层数据多副本存储,上层则实现了标准SQL支持能力。数据库架构演进,从整体来看,走过了大致三个阶段。第一阶段,是以单节点为主要特征,通过单机能力来承载数据计算和存储的能力。这一架构的优势在于架构简单、维护成本低,随着单机能力的提升可满足大部分业务场景需求。缺点是数据库节点(包括内置存储)容易出现单点故障,且计算和存储能力受限于硬件性能,无法扩展。第二阶段,是以共享存储为主要特征,通过多台主机来承载数据计算能力,数据存储则集中于集中式共享存储之中。这一架构的优势在于解决了前一阶段数据计算部分的单点故障,结构仍较简单,易于实现事务一致性等问题。缺点在于数据计算部分扩展能力有限,底层数据存储部分依赖于高端共享存储且扩展能力也有限。第三阶段,是以分布式为主要特征,通过多台主机来承担数据计算与存储能力。这一架构优点在于良好地水平扩展能力,数据多副本存储,无需依赖共享存储。缺点在于,计算与存储能力需同步扩展,灵活度稍差,此外存在分布式查询、分布式事务的处理开销问题。2) 主流的分布式数据库技术分布式中间件这种架构是从之前谈到的中间件路线演进而来 ,是一种典型的“ Share Nothing”架构。通过上层无状态的计算节点提供弹性可扩展的计算能力,下层通过增强单机数据库提供基础存储能力及本地算力。这一架构通过硬件堆叠,可近似线性地提供计算性能和存储容量,具有可支持超大规模集群的能力。这种架构在分布式事务、全局MVCC等方面,往往存在一定难点,各厂商也有各自解决之道。这一架构产品优势在于功能丰富、可按业务做定制;稳定性较高,基于成熟稳定的单机引擎。在面对超大规模数据存储,通过灵活的分片配置策略,支持高灵活度数据打散技术,并可贴近场景需求定制分片。相对不足在于全局事务能力、全局 MVCC、副本控制、高可用等方面存在先天短板,需要有针对性增强。例如引入全局事务管理器组件,突破单机限制,实现分布式事务的实时一致性及全局MVCC能力,对应用透明的分布式事务处理,应用无需改造。通过一阶段提交+自动补偿机制,提升分布式事务处理性能。针对数据强一致性的要求,在单机库同步技术基础上,通过内核级的增强优化实现更高级别的复制保证数据不丢失。此外,由于需维护多节点一致性而带来的在跨分片DDL、分片节点扩容、跨节点复杂查询、全局一致的备份恢复等方面问题值得关注。这种架构产品较为适用于数据规模巨大、对延迟要求很高的在线交易场景。在数据库设计时,需要特别注意分区键和分区策略的选择,合理布局数据,尽量避免跨节点的分布式事务处理,以提高数据库的效率。分布式事务这 种架构正是受到Google论文影响演进而来 ,采用“ Share Nothing”架构。其采用存储与计算分离架构,底层多采用自研或裸存储引擎,数据按规则打散并存储多个副本,通过paoxs/raft等分布式协议保证多个副本间数据一致。上层实现数据库基础的优化器、执行器等组件,对分布式事务、全局MVCC等支持更为彻底。此外,由于其底层的存储引擎不是依赖某一产品,可根据需要组织数据,因此在适配场景上 更有优势,例如在某些分析类场景可选择列存。原生分布式实现,工程上不依赖其他产品,可控程度更高。面对很多新的需求,可从底层加以实现支持,不受限于第三方。在副本控制、数据一致性、容灾、弹性能力等方面更具有优势。此外,场景方面有更为灵活的选择及未来可扩展的空间。 但这一方式在产品成熟度,仍需较长时间沉淀。特别是使用在核心业务场景,仍然需要较长时间的锤炼。此外,其内置的分片规则,对于某些需贴合业务的架构设计不太友好。对于高并发、低延迟的极端场景仍然有一定局限。分布式存储在某种程度上讲,云原生数据库也是一种分布式,但与前两者区别是非 Share Nothing架构,而是Share Everything模式。其底层是与分布式云存储,本质上来说仍然是一种集中式架构。上层的计算部分,是无状态的一组结点组成。针对这种架构不足展开说明,原因是这种方式是需要对底座有比较重的依赖,无法在金融行业相对要求独立环境中部署,除非整个底层都更换。因此,使用选择上存在一定困难。3. 分布式数据库金融业实践1) 金融业数据库选型难点金融业在分布式数据库选型存在若干难点:复杂业务逻辑问题,包括数据库技术基因匹配性(如:数据库本身锁机制、隔离级别问题),包括技术兼任性(如存储过程、视图兼容性);应用的适配度问题,银行应用大部分都是基于单机关系型数据库机制设计的,例如大部分场景都是串行机制,发挥不出来分布式数据库的强大并发处理技术,反而分布式数据库本身的二阶段提交机制,对简单事务的延时增加问题,造成串行事务执行性能低下;人员能力的匹配性,需要根据人员技术能力进行选型考虑,例如基于 Spanner体系,基于Aurora体系,基于国内互联网公司自研的产品等,要考虑现有人员对数据库技术的了解程度,更要关注数据库技术本身的开放度和社区热度,让人员可以很快的学习和提升数据库技术能力;数据库自身能力问题,包括在分布式事务、数据一致性、高可用容灾等,相较于传统集中式数据库还是存在一些不足;此外金融业在联机交易的低延迟要求、跑批类的高吞吐要求也对分布式数据库提出了很高的要求;数据库运营维护问题,包括是否具备足够能力维护分布式数据库?是否能够接受数据库转型期间的业务中断时间?是否具备迁移(甚至在线)迁移能力?是否具有应用级双发能力,规避可能出现的风险等。2) 金融业数据库选型策略通过数据库的技术标准化和轻量化工作,形成统一的数据库使用规范,解耦应用和底层数据库技术架构,在标准数据库协议及语义下,可以很轻松的更换数据库架构。通过构建异构间数据同步、流量接入控制(限流、灰度等)、全局数据服务(如事务、快照等),实现业务的无感切换和迁移回退,保证最大的灵活可控。针对上述诸多难点、痛点,作为金融行业如何选择分布式数据库呢?可遵从以下几个方面:尊重路线之争,无关技术领先如前面所述,分布式数据库的发展有着不同的技术路线。曾有种观点认为,“分布式数据库的发展方向代表着未来,分布式中间件方向没有前途”。针对这一问题,我的观点是采用不同技术路线的产品有自己的适用场景,与技术领先性无关。某种技术通过提出理论、工程化实现、产品能力输出,可解决某方面需求、甚至带来巨大产品能力的提升;但希望以此通过大一统的产品解决所有问题是不现实的,未来仍然是多种技术路线并存的情况。成熟度有待完善,但时不我待提前规划分布式数据库作为一种新兴技术产品,其成熟度尚需锤炼,但不能基于此就选择观望态度。产品成熟的提高,一方面来自厂商对产品的不断迭代优化;另一方面也来自使用者的不断打磨。企业内对数据库的落地使用,也需要较为长期的过程。此外,外部驱动也对这一选择起到加速推动作用。作为企业来讲,根据自身情况可以选择不同策略(引领、跟随);但无论那种都需要提前规划,有明确方向和实施路径。国产数据库百花齐放,机会无限近些年来,国产数据库发展迅猛,呈现百花齐放态势。针对这一现状,一方面要持续关注这些产品,给予这些产品充分施展机会;另一方面制定准入标准严格把关,让真正有实力的厂商能够进入,得到充分锻炼、打磨的机会。慎重技术选型,不迷信宣传技术选型是个很严谨的过程,需要慎重对待。有很多第三方的评测和厂商宣传结论,但这些只能做参考,决策层面的依据还是需依靠自己。一方面宣传内容一般都会所选择有利于自己,这会带来一定误导性;另一方面对同一概念的理解是有偏差的,很难仅仅通过一段文字描述就能完全说清楚。这些问题只有在真实环境,叠加上自身需求,测试出的结果才具说服力。结合场景需求,没有最好只有最适合业务场景千差万别,其对数据库能力要求和侧重点也有所不同。很难选择一款通用型产品满足全场景,那就需要根据实际情况做有针对性的选择。此外,不同产品各有强点和局限之处,选择最适合你的产品就好。例如上文谈到的分布式中间件产品,在超大规模、自定义分片、超高性能、业务控制等方面往往更有优势;而分布式数据库产品,则在分布式事务、数据强一致、混合负载等方面有所擅长。不选产品选兼容性,保持最大自由度当前分布式数据库,仍然处于快速发展期,很难确定未来的主流选择。为了规避路线选择、厂商绑定的风险,比较现实的方法是选择一款兼容通用性协议的产品,并且在使用中仅使用标准数据库的用法。举个例子,选择一款兼容 MySQL的产品并且安装标准MySQL的用法使用;当出现风险时完全可选择另外一款同样兼容MySQL的产品来替代。目前MySQL生态在国内最为成熟,很多厂商产品也选择了兼容它,因此选择兼容性产品在未来的自由度最大。保持技术敏感度,紧跟时代发展步伐面对技术发展多变、应用特点多变、外部需求紧迫的现状,时刻关注分布式数据库发展,保持足够的技术敏感度,紧跟技术发展趋势。采取架构前置、谨慎选型、局部试点、多线布局、掌握主动、自建增强等策略,保持主动。3) 金融业数据库场景梳理金融企业对数据库使用场景众多,而对应分布式数据库产品功能各异且特点鲜明。如何为不同场景选择最为适合的分布式数据库产品,成为分布式数据库落地前提。下表结合金融行业特点,抽象出若干数据应用场景,形成以事务类、分析类、混合类为代表的三大类五种典型场景。从适用场景、技术架构特征、关键指标、功能维度等多方面对场景进行梳理。一句话总结:“没有最好的产品,只有最合适的产品!”。4) 金融业分布式数据库选型技术要素技术为业务服务的,不能为了使用技术而使用,需要综合考虑成本和收益的平衡。分布式数据库使用场景,应当在数据大规模、高并发、高可用性等场景下有其特有优势。一般的业务场景如果能用单机数据库支撑的尽量用单机库。选择一款分布式数据库,会带来一系列的成本,如应用适配成本、运维成本、硬件成本,这方面后面会赘述。此外,在做上述判断时,还需考虑业务的发展,最好是能判断三年的数据量和交易量的增长变化。在进行分布式选型时,可重点考察下列几个方面:分布式事务分布式架构,自然会带来分布式事务的问题。由于需要跨节点的网络交互,因此较单机事务会有很多损耗。随之带来的是事务处理时间较长、事务期间的锁持有时间也会增加,数据库的并发性和扩展性也会很差。针对单笔事务来说,分布式事务执行效率是肯定会有降低的,分布式带来的更多是整体处理能力的提升。但在设计之初,就应尽量做到业务单元化,将事务控制为本地事务,这可大大提升执行效率。性能由于二阶段提交和各节点之间的网络交互会有性能影响,分布式数据库优势不是单个简单 SQL的性能,但是大数据量的SQL查询,每个节点会将过滤之后的数据集进行反馈,会提升性能,并且分布式数据库的优势是并发,大量的SQL并发也会比单机数据库强大,应用需要做分布式架构的适配,将串行执行机制尽量都改造成并发处理。对于含有需要节点间数据流动的SQL语句的事务,OLTP类的分布式数据库处理效率一般较差,事务处理时间会较长,事务期间的锁持有时间也会增加,数据库的并发性和扩展性也会很差。建议尽量改造存在跨节点数据流动的SQL语句 (主要是多表关联)的事务。 分布式数据库性能是软硬整体架构的保障,不仅在软件、S QL 语句方面做优化,硬件方面也需要重视,包括处理器、内存、网络、磁盘等等,尤其在支撑交易类业务系统时重视对基础设施选型和优化。数据备份分布式数据库一致性保证通过内部时钟机制,所有节点都会遵循一致的时钟,所以备份恢复的增量也是基于时钟,相当于单机数据,但是分布式数据库的备份解决方案最重要标志是否支持物理级的备份,物理级的备份会比逻辑的备份性能吞吐会大很多,还有就是是否支持一些分布式备份方案,比如 S3协议接口,是否支持压缩等功能。分布式数据库基本都具备备份和恢复方案,通常从备节点进行连续备份(全量+日志),恢复的时候制定节点进行恢复到指定时间点,整个过程可配置自动任务自动执行。高可用分布式数据库大多都是基于多数派协议,同城双中心不适合多数派的要求,同城数据级多活建议采用三中心部署,如果同城主备可以采用集群级的异步复制。异地建议采用集群级的 binlog异步复制。建议实例的主备节点设置在同城两个双活数据中心,仲裁节点三机房部署;异地灾备单独启实例与本地实例进行数据库间同步,也可以将本地备份文件T+1恢复到异地灾备。数据一致性NewSQL分布式数据库基本都是通过获取全局时钟时间戳,采用二阶段提交实现一致性,可以实现一致性的保证,分库分表架构对于事务的一致性,需要应用层考虑,比如通过合理的分区键设计来规避。分布式数据库对于跨节点事务目前还是实现的最终一致,对于全局一致性读,一般通过引入类似全局时间戳的组件统一管理全局事务,在数据库选型时可以重点关注厂商对这一块的实现。如果目前暂时无法提供全局一致性读的分布式数据库,对于要依赖分布式事务“中间状态”的业务,优先进行业务改造进行规避,其次通过合理的数据分片设计让其在单节点内完成。其他因素金融行业在数据库选型中,除了需要考虑上述外,还有其他一些因素的考虑。如原有系统的承载能力、是否必须进行选择等。5) 金融业分布式数据库选型非技术要素金融业分布式数据库选型,除了上述技术要素外,还包含如下非技术要素,主要是在成本投入方面:硬件成本一般采用 x86服务器,存储多为本地存储,推荐使用SSD甚至是NVMe SSD,网络一般 采用 万兆网络。在这部分主要成本是取决于集群规模、数据量及数据库自身架构。此外,如果涉及到灾备方案,还需要考虑灾备环境的硬件投入及主备间的专线费用。 此外,考虑很多金融单位现在机房建设空间和能耗有限,可采用配置较高的硬件设备,如基于英特尔 ®至强® 金牌处理器内核的x 86 物理机、配置 英特尔®傲腾™固态盘 等,减少服务器数量、降低耗电量。软件成本主要来自分布式数据库本身的软件采购成本,成本取决于各厂商的内部商业策略。但这部分总体来讲,是较传统数据库产品还是有优势的。此外,这部分还涉及到维保费用,针对分布式数据库来说,相对较新,企业自有能力尚不具备,还是建议购买原厂服务或其他三方公司的服务,降低风险。开发测试成本这部分是指针对数据库更换后,应用需要需要完成的必要的开发测试成本。这部分成本差异很大,跟原有系统实现有较大关系。如果原有系统重度依赖数据库(大量功能是基于数据库自身功能实现的),那么存在的改造量较大。新型分布式数据库的功能,不能与传统数据库做一一对应,很多能力是需要在应用层重构完成。针对这种情况,是建议应用开发遵循数据库标准方式进行(如采用 MySQL作为标准)开发,这样如有改型也很简单。此外,还有一类隐形成本包含在这部分,如果业务比较重要,是需要考虑双发支持或灰度迁移的方式,这会带来一部分工作量。总体来说, 这部分成本是比较高的,可能占整体成本的大部分。运营维护成本这部分成本,包括了为满足更换数据库所带来的数据迁移成本和上线后的日常维护成本。针对前者,可以在应用侧解决或者外采商业软件解决;后者更多是人员管理成本。针对这部分成本,是有个相对较长的投入,且整体成本不少。6) 金融业分布式数据库运维要点分布式数据库,作为较为新兴的基础架构产品,在运维层面有其独有特点。下面结合之前的实践,将运维要点整理如下:软件规划和部署方案分布式数据库组件众多,而且每个组件都有高可用备份,所以在有限数量的服务器下进行组件的分配要尽量考虑达到各个服务器负载的均衡, GTM作为分布式数据库的瓶颈尽量和他们组件分开部署。监控方案监控一般可以采用开源的 zabbix进行定制化开发,当然也可以基grafana+prometheus的方案做监控。但一般大中型金融企业都有一套自己的监控系统,这里需要有个对接适配的过程。此外,由于分布式的多组件特点,在监控指标数量及指标间关联上,与传统数据库差异巨大,是需要监控摸索过程。语句调优因为不同厂商研发的数据库 SQL优化器及执行计划都有所不同,所以要根据不同产品进行学习。天然由于分布式架构带来的复杂度,也会影响到语句的执行效率。比较常见的如数据库访问链路长所带来的的问题、数据分布不均带来的问题及分布式优化器的问题等。备份方案分布式数据库如何做到多节点全局一致性备份也是难点,要做到真正意义上的基于时点恢复,就需要做到分布式环境下每个全局事务的可追溯操作。应急方案因为分布式数据库还处于发展阶段,还不成熟,技术比较复杂,所以生产环境下要制定详细的应急方案,让不了解分布式数据库的同事也能够在出现问题时按照手册操作。DDL变更在分布式架构下, DDL变更是个难点。如果做到全局一致,做到业务无感知,是核心点。不同厂商产品实现能力层次不齐,介于此安排在低峰期操作并做好必要的监控回退。水平扩容分布式架构下,都是支持水平扩容的。一般来说,非数据节点的扩容是相对容易的,对业务也是无感的,但涉及到数据节点的扩容,势必会遇到数据 reshard的问题。建议选择在低峰期,同时控制好扩容粒度。即便如此,仍然建议提前做好容量规划,避免扩容。跨片计算分布式架构下,数据是分布在多个节点中。如果数据计算是可以在本地计算完成,无疑是效率最高的,但完全避免跨片计算是不太现实的。如果发生跨片计算,则不可避免地对上层节点带来压力,要做好相应监控,并争取在根本上避免跨片类计算。5. 总结分布式数据库 ,作为 一种新型数据库 产品架构,正处于蓬勃发展阶段。其 具备 的 数据分片管理、分布式事务、读写分离等关键分布式能力, 能够很好地满足企业在 高性能、大数据量 等多种 业务 场景 。近年来,各国产厂商都在积极推进分布式数据库产品的研发,技术已经逐步成熟 。金融行业,作为数字化转型的先导性行业,对数据基础设施有着更高的要求。分布式数据库的出现,恰好可以满足金融企业迫切需求。随着近些年来,分布式数据库的成熟,并在 金融行业已有成功案例投入生产系统使用。 相信,两者的结合,必定在未来能擦出更多火花,促进金融行业在新时代转型发展。文章来源:https://www.talkwithtrend.com/Article/259665 纯属学习、分享,如有涉及版权,请联系处理。
-
随着业务的发展与数据量的增长,在存储、计算、安全等方面占据优势的分布式架构数据中心或将成为数据中心未来发展的趋势。与此同时,分布式数据中心带来的建设挑战也为数据中心可持续发展指明方向。分布式数据中心(Distributed Data Center),简称DDC,是利用网络把成千上万台存储服务器连接、组合而成的一台虚拟超级存储服务器,用以完成单台存储服务器无法完成的超大规模问题求解。目前,分布式数据中心在建设过程中面临一些挑战,主要包括网络、存储、计算和安全四个方面。1.在网络方面,多个分布式数据中心间的通信是首要问题。建设时需考虑多区域间如何实现灵活组网与入云连接,但目前各个网络设备供应商间的大二层网络和协议并未统一,故在设备的兼容性上可能存在一定问题。2.在存储方面,如何实现数据协同是一大难题。随着业务高覆盖,各地数据中心协同的重要性日益提高,但受困于距离与规模等难题,各地数据中心间网络宽带无法保证数据实时同步,这对数据的一致性与完整性、业务的连续性造成一定影响。3.在计算方面,对计算资源的管理是重大挑战。数据迁移和灾备建设等难题,要求数据中心日常进行计算资源管理时,不仅要做好常规故障排查,还要做好数据资源的迁移规划和安排工作。4.在安全方面,如何保证数据中心安全性是严峻考验。传统数据中心虽然缺乏灵活性,但它的安全网关足够保证传统数据中心数据存储、处理安全。分布式数据中心的灵活性更高,但目前仍未形成完整统一的安全产品解决方案。来源:今日头条
-
墨天轮2019年6月即推出了中国数据库流行度排行,排行榜中的数量也从50增加到194个,每月一日更新,同时发布上月的大事记以及排行榜解读文章,另外我们举办了各种类型与中国数据库相关的活动,见证了中国数据库近三年的蓬勃发展,也为数据库国产化贡献了一份力量。2021年度中国数据库魔力象限墨天轮参考 Gartner 的魔力象限模型,结合墨天轮数据库流行度排行表现,综合得出了2021年度中国数据库魔力象限。魔力象限(Gartner Magic Quadrant)由Gartner于2006年推出,该模型是对某一特定企业级 IT 技术市场的研究总结。墨天轮选取2021年年度平均分排行前40的数据库产品,通过2021年平均分、最新得分、三方评测(TPC-C、TPC-DS、TPC-H、大数据产品能力以及电信行业能力)、生态(社区平台、高校合作、培训认证、开放文档、代码开源、介质下载)以及论文和专利数量综合评定,同时参考了该数据库在 Gartner 全球云数据库魔力象限的表现以及 IDC 全球数据库市场份额报告。最后将数据汇总到两个维度上 — Ability to Execute(执行层面,即当前产品、服务、销售等表现)和 Completeness of Vision (战略层面,即未来愿景的清晰完整性),根据各家供应商们的表现,将其划分入如下四个象限中,分别为:领导者、远见者、挑战者和特定领域者。领导者象限领导者象限代表当前数据库产品及服务能力强,市场销售表现好,客户满意度较高,同时有清晰完整的未来战略。该象限中有7个数据库:● TiDBTiDB 是 PingCAP 公司研发的开源分布式关系型数据库,是一款同时支持在线事务处理与在线分析处理(HTAP)的融合型分布式数据库产品,具备水平扩容或者缩容、金融级高可用、实时 HTAP、云原生的分布式数据库、兼容 MySQL 5.7 协议和 MySQL 生态等重要特性。TiDB技术创新能力处于世界领先水平,每年会进行超过 40% 的代码更新,在GitHub上获得逾3万颗星,已应用于全球超过 2000 家头部企业。● OceanBase蚂蚁集团 OceanBase 连续 8 年稳定支撑双 11,创新推出“三地五中心”城市级容灾新标准,是全球唯一在 TPC-C 和 TPC-H 测试上都刷新了世界纪录的国产原生分布式数据库,具备高可用、高扩展、高兼容、易管理、部署灵活、高性价比等特点,已助力 200+ 行业客户实现核心系统升级。在区域性的银行、保险、证券及基金公司中,OceanBase市场占比达到行业第一。来自非金融类客户的营收占比已达到OceanBase总营收的35%,且在快速增长中。● PolarDB阿里云 PolarDB 是全球范围内业界首个实现了存储、内存及计算三层解耦的云原生数据库,为用户提供具备极致弹性、海量存储、高性能、低成本的数据库服务。PolarDB目前兼容三种数据库引擎:MySQL、PostgreSQL、高度兼容Oracle语法。计算能力最高可扩展至1000核以上,存储容量最高可达 100T。PolarDB已经全面应用于天猫双11的交易、买家、卖家以及物流等系统,刷新了数据库处理峰值记录,高达1.4亿TPS。● 达梦达梦数据库源代码100%自主研发,特别是 DM8,是国内第一款实现数据共享存储集群的数据库,支持超大规模并发事务处理和事务-分析混合型业务处理,动态分配计算资源,降低成本。达梦数据库系列产品及解决方案现已服务于国内外用户数十万家,装机产品累计近百万套,已在金融、电力、民航、通信、审计、公安、铁路、电子政务、应急救援等50多个关乎国计民生的行业领域取得广泛应用。● GaussDB华为 Gauss 数据库是全球首款企业级 AI-Native 分布式数据库,将AI能力植入到数据库内核的架构和算法中,使其具备一定的自运维、自管理、自调优、故障自诊断和自愈的能力。Gauss 数据库异构计算支持X86、ARM、GPU、NPU,支持行存储和列存储,可增加节点实现存储、查询及加载性能的线性扩展,集群最大可扩展至 2048 个节点,支撑 PB 级数据管理能力。GaussDB已在1500+金融政企与泛互联网大客户取得规模商用。● openGaussopenGauss 是华为推出的一款企业级开源关系型数据库。在主备模式下60%满负载故障切换时间10秒以内;利用 AI 进行智能参数调优和索引推荐,可减少 85% 的传统索引,且索引的推荐准确率达 90%;支持全密态计算;结合鲲鹏硬件优化,1000wh数据量可跑到150万tmpC,相对业界主流产品的性能超过50%。openGauss全球下载量超50万,超过2500名开发者参与技术贡献,诸多合作伙伴基于openGauss打造商业发行版。● TDSQLTDSQL 是腾讯云企业级分布式数据库,旗下涵盖金融级分布式、云原生、分析型等多引擎融合的完整数据库产品体系,提供业界领先的金融级高可用、计算存储分离、数据仓库、企业级安全等能力,同时具备智能运维平台、Serverless版本等完善的产品服务体系 。TDSQL已被3000多家来自金融、公共服务和电信垂直行业的客户采用,中国十大银行中的六家都应用了该产品,在金融行业的核心系统国产化替换场景中表现抢眼。挑战者象限挑战者象限代表产品及服务能力较强,经营状况良好,有一定的市场占有率,拥有强大的企业生存能力和财务稳定性,并表现出强大的客户支持。该象限中有2个数据库:● Gbase南大通用 GBase 系列 主要包括分布式分析型数据库 GBase 8a、交易型数据库 GBase 8s、分布式交易型数据库 GBase 8c,以及目录型数据库 GBase 8d。目前已在金融、电信、政企、安全等关键领域得到规模化应用,服务范围覆盖全国 32 个省级行政区域,建立节点超过 30000 个,管理数据总量超过 300PB。● 人大金仓人大金仓 KingbaseES 搭载高内聚、低耦合的可扩展内核架构,支持大数据分析,单机单表支持140TB级大数据量存储;具备自动发现问题、诊断问题、异常发生的自愈以避免业务中断;具有良好的容灾恢复能力,支持双机热备功能。金仓数据库广泛服务于电子政务、国防军工、能源、金融、电信等千行百业,累计装机部署近100万套。远见者象限远见者象限表示数据库市场有着深刻的市场理解和强大的技术路线图,虽然当前的市场份额相对较少,但是作为长期主义者,他们对未来有十足的把握和信心。该象限中有2个数据库:● AnalyticDBAnalyticDB是阿里云自主研发的云原生数据仓库,采用存储计算分离+多副本架构,支持最大5000节点规模的弹性扩容,对复杂SQL查询速度比传统的关系型数据库快10倍以上。AnalyticDB高度兼容MySQL、PostgreSQL,Oracle应用迁移成本低,可对万亿级别的数据进行实时的多维度分析透视,极大地提升了企业挖掘数据价值效率。● SequoiaDBSequoiaDB (巨杉)作为一款金融级分布式数据库,多数据中心间容灾可做到 RPO = 0,RTO < 15秒。SequoiaDB 基于湖仓一体架构,能支撑联机交易和联机分析的场景,支持ACID事务一致性。在面向在线系统提供业务流程中,提供声纹指纹、人脸识别、音视频交互等联机处理的支持;更可以基于AI及机器学习,对非结构化的数据进行治理,实现与其他重要系统的交互。特定领域者象限特定领域者表示通过提供高度专业化的产品在某些场景下有独特的优势,能够高效解决特定问题,如客户明确产品及功能的使用定位,采用特定领域者产品也是一种好的选择。该象限中有8个数据库:● 神舟通用神通数据库是企业级大规模并行处理分布式关系型数据库,具备高兼容、高可靠、高安全、异地容灾等特点。神通数据库获得公安部国家安全四级的高安全等级认证,在长五火箭发射、“天问一号”探火、“天和”核心舱等任务中都有应用。神通数据库不仅成功应用于国防军工、航天等关键行业,也在政府、金融、电信、网安、能源等领域全面开花。● GoldenDB中兴通讯 GoldenDB 是一款具有银行基因的金融级分布式数据库产品,从架构层面保证事务强一致和数据高可靠,并可根据业务需要实现在线扩容,支持金融行业已有业务升级及创新业务快速部署的需求。GoldenDB 产品已覆盖国有大行、股份制银行、农信联社、城商行及农商行全系列银行。● TcaplusDBTcaplusDB 是腾讯专为游戏设计的分布式 NoSQL 数据库。结合内存和 SSD 高速磁盘,针对游戏业务的开发、运营需求,TcaplusDB 支持全区全服、分区分服的业务模式,为游戏业务爆发增长和长尾运维提供不停服扩缩容、自动合服等功能。TcaplusDB已应用于《王者荣耀》、《天涯明月刀手游》、《QQ飞车》等数百款腾讯游戏。● GoldilocksGoldilocks 是科蓝软件拥有完整自主知识产权的分布式内存数据库,具有极强的高并发、高吞吐量、低延时的性能优势,支持在线横向扩展、收缩的能力,能够满足大数据处理的多样化业务需求,适用于金融、电信等对实时性要求较为严格要求的场景。● UXDBUXDB(优炫数据库)具备支持多种数据类型、在线弹性扩容、高可用性、高性能、高安全性、数据即服务等核心能力;可应用于高频联机系统、地理信息、数据仓库、商业智能等多业务场景;产品已完成与多数芯片、操作系统、应用软件厂家适配,支持众多应用软件的稳健运行;满足我国政府、军工、金融、能源、制造、医疗等各行业产业升级需求。● TDengineTDengine 是涛思数据专为物联网、车联网、工业互联网、IT运维等设计和优化的时序数据库。除核心的快10倍以上的时序数据库功能外,还提供缓存、数据订阅、流式计算等功能,最大程度减少研发和运维的复杂度,且核心代码,包括集群功能全部开源。● MogDBMogDB 是云和恩墨基于基于华为openGauss内核推出的企业发行版。相较于MySQL,MogDB主备之间的数据一致性更容易得到保障。同时,MogDB可以提供SQL兼容性分析、性能压测对比分析、极限数据恢复等管理组件,帮助企业级用户方便高效地使用openGauss,减轻运维压力。目前,MogDB已应用在民生银行、哈尔滨银行、渤海财险、合众人寿等多个金融行业客户的核心或关键业务系统上。● EsgynDBEsgynDB(易鲸捷) 是一款企业级融合型分布式数据库。融合OLTP与OLAP能力,支持结构化与非结构化数据统一存储。相较于传统数据库,EsgynDB 的实时分析特性与分布式架构更能支撑5G时代的物联网、人工智能、智能制造、区块链等新兴技术对于实时海量数据的融合管理需求。以上象限仅供参考,具体市场请根据各自项目需求进行选型及测试验证。中国数据库的黄金年代国产化背景从2019年开始,中美贸易战常态化,华为等多家中国企业列入“实体清单”,同时芯片等多项技术及设备被列上“管制清单”,数据库、中间件、操作系统三大基础软件也在“卡脖子”之列,过去一直被美国巨头占据。结合国内数据产业的迅猛发展,数据库作为与之最紧密的软件成为国内企业争相突破的技术,追求自主创新、安全可控。中国数据库主要分为以下三类:以达梦、人大金仓、南大通用、神舟通用四大传统数据库厂商,在政务、能源等行业保持较高的市场占有率;阿里、华为、腾讯、中兴等头部科技企业,首先自有场景的数据库替换,然后通过公有云对外通过提供服务,近几年又从云上数据库并下沉到私有云平台的市场;最后就是PingCAP、易鲸捷、瀚高、巨杉等独立创业公司,通过分布式等技术在金融行业占据了半壁江山。通过数据库发展源流图发现,当前中国数据库多数是从MySQL以及PostgreSQL演讲而来,然后在兼容性、易用性进行了大量改造,同事通过降低国外商业数据库迁移的成本,使得中国数据库慢慢发展起来,开源数据库已经成为中国数据库突破实现突围、发展自主可控产品的主要途径。从2020年6月,华为建立openGauss开源社区,并于2021年3月发布第一个Release版本;2021年5月,阿里云宣布对外开放关系型数据库PolarDB for PostgreSQL源代码,同年6月,蚂蚁集团宣布开源OceanBase。2022年1月11日中国软件行业协会发布《中国软件根技术发展白皮书(基础软件册)》,表明当前国内已经开始着手构建自己的基础软件根技术。同时,我们注意到2020年我国高校和企业在 VLDB、ICDE 和 SIGMOD 数据库三大顶会上贡献占比为23.81%,也反映出目前中国数据库在技术创新上有了不错的成绩。近三年中国数据库大事记2019年-发展元年2019年8月28日,腾讯云一次推出五大数据库新品,包括数据库智能管家DBBrain、云原生数据库CynosDB正式商业化、数据库TBase启动公测、灾备服务DBS启动邀测、Redis混合存储版启动邀测。2019年10月2日,OceanBase打破数据库基准性能测试(TPC-C)的世界纪录,其tpmC值超过6000万,排名第一。2019年10月27日,采用中兴GoldenDB的中信银行信用卡中心核心业务系统上线运行。2020年-百家争鸣2020年6月30日,华为openGauss终于正式亮相,源代码开放、社区成立。2020年10月19日,易鲸捷数据库4.2亿中标贵阳银行核心业务系统中国数据库应用项目,创造了中国数据库的单一采购项目记录。2020年11月17日,PingCAP 完成 D 轮 2.7 亿美元融资,创造全球数据库历史新的里程碑。2021年-百花齐放2021年2月24日,华为云正式发布云数据库GaussDB(for openGauss)全网商用。2021年6月1日,蚂蚁集团自研数据库OceanBase宣布开源,开放近300万行源代码。2021年12月17日,Gartner 2021 云数据库管理系统魔力象限已经出炉。阿里云再次进入领导者象限,华为云进入特定领域者象限(NICHE PLAYERS),是国内入选的仅有两家企业。资本不断注入2019年开始资本大量进入中国数据库行业,其中2021年更是井喷式爆发,融资次数达到了20多次,融资额度超过30亿人民币。时间公司名称轮次金额2021年12月16日人大金仓战略融资近2亿人民币2021年12月9日智臾科技B轮1亿人民币2021年12月6日创邻科技A++轮过亿人民币2021年11月29日四维纵横A轮1亿元2021年11月19日拜贝思云计算科技天使轮300万美元2021年9月28日聚云位智B轮近亿人民币2021年8月25日偶数科技B+轮2亿人民币2021年7月20日PingCAPE轮数亿美元2021年7月12日睿帆科技A轮5000万人民币2021年7月8日人大金仓战略融资近亿人民币2021年6月22日中科知道天使轮1200万人民币2020年6月17日聚云位智A+轮未披露2021年5月24日涛思数据B轮4700万美元2021年5月9日易鲸捷战略投资5769万人民币2021年3月16日青云科技IPO上市7.644亿人民币2021年2月26日天云融创战略投资未披露2021年2月10日爱可生B轮近亿人民币2021年2月1日创邻科技A+轮数千万人民币2021年1月21日新炬网络IPO上市5.59亿人民币2021年1月18日智臾科技A轮数千万人民币数据库相关的上市公司有:优炫软件、科蓝软件、海量数据、东方国信、创意信息、金山云、青云科技,另外据悉有几家数据库厂商正处于上市前冲刺阶段。基础软件的投入成本和研发周期都非常长,在资本注入后,其中大部分都投入到研发中,只有数据库产品稳定、高效、安全,同时方便迁移和管理,替换原有市场也就变得非常容易,那么国内新增市场也就自然会优先采购中国数据库。政策持续利好当前中国数据库应用主要集中在金融、电信、政务、制造、互联网等行业,这离不开国家各种政策的引导,尤其是金融行业,人民银行等机构多次发文要求核心场景技术和产品自主可控,同时由于金融行业的高要求,也成了中国数据库的试炼场,经过近几年的高速发展和场景磨炼,已经有了非常成熟的金融行业案例。2021年12月12日,为应对新形势新挑战,把握数字化发展新机遇,拓展经济发展新空间,推动我国数字经济健康发展,依据《中华人民共和国国民经济和社会发展第十四个五年规划和2035年远景目标纲要》,支持具有自主核心技术的开源社区、开源平台、开源项目发展,推动创新资源共建共享,促进创新模式开放化演进。2022年1月16日出版的第2期《求是》杂志发表中共中央总书记的重要文章《不断做强做优做大我国数字经济》。文章指出要全面推进产业化、规模化应用,培育具有国际影响力的大型软件企业,重点突破关键软件,推动软件产业做大做强,提升关键软件技术创新和供给能力。市场足够大据IDC预测,2021全年中国关系型数据库软件市场规模为27.5亿美元,到2025年将达到76.7亿美元,未来5年市场年复合增长率(CAGR)为30.4%。据信通院预测,中国数据库市场总规模将达到688亿元,市场年复合增长率(CAGR)为23.4%,假如出现传统头部企业占据70%的市场,那就是480亿的营收。以上两个预测数据库行业市场规模年复合增长率都超过20%,属于高新赛道,一定会有更多的“玩家”加入,让技术、产品、生态、服务等都会得到快速发展。中国数据库未来发展趋势数据库私有云平台Gartner预测到2023年,全球数据库市场中75%的数据库将完成到云平台的迁移,公有云数据库的增速也将放缓,而下一个争夺的市场主要为数据库私有云平台,以云的方式部署在客户私有环境中,这样既享受了云的便捷,也打消了对公有云数据安全、可靠性等疑虑。开源生态建设2021年1月至今,在 DB-Engines 上开源数据库流行度超过商业数据库,开源生态建设既是帮助企业商业布局的利器,也是促进技术发展和推广的重要手段,国内以PingCAP、openGauss等数据库为例,通过开源生态的建设,大大提升了品牌的影响力,未来阿里、腾讯等越来越多的厂商会加大开源生态的建设。分布式分布式数据库成为解决传统数据库瓶颈的主要手段。分布式数据库可以帮助企业应对海量数据和高增长的问题,在数据增大时可以平滑的水平扩展,解决了过去系统数据增大时需要人工进行分库分表的复杂和高风险的工作。HTAPHTAP数据库即需要同时支持OLTP和OLAP场景,在报表实时性要求不断提升,HTAP数据库通过对计算、存储架构的调整省去数据同步的过程,在同一套数据库中完成交易和报表的请求。AI随着数据量的不断暴增,减轻人力维护成本以及避免故障,通过引入AI,让数据库自动驾驶,如自动调优、自诊断、自愈、自组装等,最终实现对管理员透明,只需提供简单API即可,在保证稳定和性能的情况下,让易用性达到极致。文章来源:https://www.modb.pro/db/240097
-
如今,我们正处于数据库从互联网基础软件转变为社会数字化基础软件的时代,在传统集中式数据库已不能满足大规模数据承载需求与高并发处理需求的形势下,基于海量数据场景应用而生的分布式数据库迎来应用热潮。据IDC调研,目前约26.8%的企业级市场用户部署了分布式数据库,超过90%的企业认可分布式数据库部署后的效果。在分布式数据库中,主要有三类解决方案,一类是以中间件+单机数据库为主的分布式数据库,下层的单机数据库提供存储和执行能力,在多个单机数据库上封装一层中间层,以统一分片规则管理及处理分布在不同数据库节点的数据,并提供SQL解析,请求转发和结果合并的能力;第二类是原生分布式数据库,在架构设计之初,便根据分布式一致性协议做底层设计,因此,数据的存储、查询、处理都天然具备分布式特性,各数据节点提供对等的读写服务,组成统一的集群对外提供服务;第三类是通过构建分布式共享存储实现扩展,采用非对称计算节点,大部分公有云数据库都属于此类。在本文中,我们重点说说前两类。 无论是分库分表中间件还是原生分布式数据库,目的都是解决数据容量问题,但实际上,二者的实践路径有本质区别。那么具体而言,分库分表中间件与原生分布式数据库的区别在哪,各自有哪些优劣势?原生分布式数据库与如今热炒的云原生数据库又是什么关系?CSDN采访了OceanBase CTO杨传辉(日照),以下为他的解读。一、原生分布式数据库与分库分表中间件的区别 区别一:是否依赖中间件 分库分表中间件大多采用中间件来补充分布式的能力,也就是说在各数据库节点上,架构一层事务处理和查询优化的中间层。在这套系统中,各个数据库可能是同构型,也可能是异构型,将各个数据库组合在一起,是一种松耦合的方式,会暴露不少问题,如事务处理能力、高可用受限等。 原生分布式数据库,由各个同构型的数据库组成,每个数据库节点天然具备分布式的能力,无需借助额外的中间件,也无需用户关注集群实现细节,是一个紧耦合的系统。由此可见,原生分布式数据库的能力有很大发展空间,但其开发难度也较大。 区别二:是否依赖分库分表 弹性扩容能力是考验分布式数据库面对流量高峰或极端场景时能否持续稳定运行的重要因素。比如在交易场景中,高峰时每秒可产生一百万笔订单,每笔订单对于数据库而言都是一个业务,需要数据库做扩容处理,其中的关键点就在于是否采用分库分表的方式,这对扩容能力有很大制约。 分库分表中间件的分片规则基于算法提供,下层计算节点之间并不会进行数据交互,扩展下层计算节点的时候就无法按需扩展。通过分库分表将原有机器划分为一百份,每台机器处理一笔业务,而如果想进一步拆分为一千份、一万份就很难做到了。这个过程还需要停机,由开发人员手动拆库,效率低,且弹性有限,但好在对数据库的依赖也低。 原生分布式数据库中设有分区表的功能,可以将中间件所拆分的一百份,每份再拆一百份,总共一万份,且每一份都至少能在一台机器被处理。在此过程中,系统自动扩容、按需扩容,不受数量和规模的限制,且无需人为干预。 分库分表中间件的核心理念是让多台服务器协同工作,完成单台服务器无法处理的任务,尤其是高并发或者大数据量的任务。而原生分布式高可用设计能够在普通服务器上实现无限水平扩展,通过添加低成本服务器即可扩展算力,提升数据库集群的整体性能。 区别三:是否实现数据强一致 分库分表中间件由于其架构特性,本质是将把单机数据库进行二次处理,在数据一致性、全局事务能力、全局MVCC、副本控制、高可用等方面存在短板,需要有针对性增强。 大多数原生分布式数据库是在分布式KV的基础上发展出SQL计算引擎,将分布式存储、事务、计算有机的结合在一起,数据由系统自动打散并存储多个副本,通过一致性协议保证多个副本和事务日志的一致性,对分布式事务、全局MVCC等支持更为彻底。 区别四:能否实现业务平滑迁移 众所周知,数据库对企业与机构来说是心脏所在,尤其是金融、能源、社保、政务等行业。当数据库已达到能力天花板或不足以满足企业需求时,企业也会考虑“换心”来维持活力。此时数据能否平滑迁移至新的数据库,保证数据的正确性且不丢失、保证业务不受影响是重要考虑因素。 分库分表中间件由于本身不具备分布式的能力,进行数据迁移时需要对业务做改造。才能使数据库正常运行。而且,由于每张表只能有一个分片规则,业务建模需要重新规划,业务代码也要相应修改,改造成本高。 而原生分布式数据库因其高兼容和透明性的优势,可以在不改业务代码的情况下,支持数据迁移,并保证数据库正常运行,不损害性能。因为整个分布式结构是包裹在集群内部的,应用对此无感知,对应用来说,与使用集中式数据库没有区别,所以不需要分布式改造。此外,由于原生分布式数据库对硬件依赖少,在云时代,可以灵活进行混合云和多云部署,以及跨多云的数据管理,为企业提供了更多且更方便的服务选择。 总的来说,分库分表中间件通常是在单机数据库之上构建数据分区的特性,支持扩展能力。因为基于传统的单机数据库,相对来说比较稳定,用户更容易上手。但缺点也很明显,其底层不具备分布式能力,只是在宏观架构上加补丁,不断增加机器冗余和系统复杂度,能力天花板较低。原生分布式数据库虽然综合表现更佳,而且支持调整底层模型,优化各方面的能力。但由于技术发展时间相对短,一些产品解决方案成熟度待提升。从眼下的行业发展趋势来看,随着技术的不断成熟,原生分布式数据库正在成为主流,大量企业与组织开始着手对传统数据库进行升级。二、原生分布式数据库和云原生数据库的区别 云原生数据库天然生长在云环境中,而且都是分布式的。云原生数据库有两种分布式的方式,一种方式是计算存储分离,例如,计算部分采用集中式数据库,存储采用远程的、分布式的文件系统。另一种方式是,计算与存储都采用分布式。 而原生分布式数据库既可以部署在本地或私有云,也可以部署在公有云上。比如OceanBase,除了支持计算存储分离的分布式之外,它还支持计算系统的分布式扩展,提升系统的处理能力。当它被部署到云上,就成为了云原生分布式数据库,提供与本地相同的用户体验。 此外,原生分布式数据库部署灵活的特性意味着不被特定硬件和服务绑定,能够做到机房部署、任意公有云部署,甚至集群内跨多基础设施的混合云或多云部署,被称为“多云原生”。三、总结 分库分表中间件在十多年前顺应互联网时代而生,相比传统集中式数据库,它确实帮助很多企业解决了降本增效的根本问题,顶住了更多的服务压力。如今十几年过去,新的数据库处理需求使传统分布式数据库的不足与限制暴露无遗,适应新环境需求的解决方案,即原生分布式数据库应时而生,逐渐变得炙手可热。未来,原生分布式数据库结合云原生,将发挥更大的能力。 而企业在选择数据库时,不管是分库分表中间件还是原生分布式数据库,亦或云原生分布式数据库,首要考虑数据的正确性。怎么判定数据库是否能够保证数据正确性呢?第一,这款分布式数据库经过了核心业务场景的检验,比如在金融、大促等海量、实时的数据处理场景中,持续稳定。第二,该分布式数据库已经在行业中证明自己,如TPC-C(主要测试联机交易处理能力)、TPC-H(检测系统处理复杂查询分析能力的多个方面)等数据库行业公认的测试,以及行业企业的良好口碑。 此外,每个企业需要根据业务特性选择数据库的功能特性,可以视情况做具体取舍。如今,分库分表中间件面临的挑战愈发巨大,具备一体化架构的原生分布式数据库正成为不少企业试用并应用的对象。其兼顾集中式与分布式的双重技术优势,将多种负载能力融合于一套数据库中。一方面具备强兼容性,能够兼容传统数据库如MySQL、Oracle的功能与单机性能;一方面具备强扩展性,当机器容量不足时,只需扩展机器,就能够解决大规模的需求。重要的是,一套系统便可处理OLTP(联机事务处理)与OLAP(联机分析处理)的需求,并保证事务的ACID(原子性、一致性、隔离性和持久性),加之本地部署与多云部署的灵活特性,也更适用于社会数字化时代。文章来源:CSDN
-
1月17日,国际数据公司(IDC)发布的《2021年上半年中国关系型数据库软件市场跟踪报告》显示,2021上半年中国关系型数据库软件市场规模为11.9亿美元,整体市场同比增长37.2%,其中,公有云关系型数据库规模6.7亿美金,同比增长50.1%;本地部署关系型数据库规模5.2亿美金,同比增长23.7%。IDC预测,2021全年中国关系型数据库软件市场规模为27.5亿美元, 到2025年将达到76.7亿美元,未来5年市场年复合增长率(CAGR)为30.4%。2021上半年中国关系型数据库软件市场关键发现和未来趋势如下:政策利好本土品牌:过去一年中本土厂商市场份额得到迅速扩大。特别是在政府行业,以达梦数据库、人大金仓为代表的本土传统数据库厂商业绩爆发增长。预计未来相关政策会逐步影响到金融、能源等行业,国外品牌未来市场空间将逐步缩小。公有云份额将继续提高:虽然占公有云数据库收入最大的互联网行业发展放缓,对云服务投入下降,但主要影响的是其对IaaS资源的采购,对数据库、大数据等PaaS层资源还在增加。同时其他行业数字化转型的深入,也在驱动对云数据库的采购。云数据库厂商市场战略下移:云数据库厂商寻求在私有云、行业客户等传统数据库市场发展,本地部署数据库市场竞争加剧。市场集中度较高:2021年上半年,总体关系型数据库软件呢市场前五名厂商总计占比69.5%;本地部署模式的关系型数据库软件市场前五名厂商总计占比63.3%;公有云关系型数据库市场前五名厂商总计占比86.7%。开源生态建设成为部分厂商的重要战略之一:开源生态建设既是帮助企业商业布局的利器,也是促进技术发展和推广的重要手段,但是开源生态的建设很难在短期内见到成效,需要厂商长期的投入和维护。分布式数据库快速发展:分布式数据库成为解决传统数据库瓶颈的主要手段。分布式数据库可以帮助企业应对海量数据和高增长的问题,在数据增大时可以平滑的水平扩展,解决了过去系统数据增大时需要人工进行分库分表的复杂和高风险的工作。2021上半年中国关系型数据库软件市场中,本地部署模式和公有云模式的厂商表现如下:在传统部署模式市场中,国际厂商仍占主导地位,但份额已开始缓慢下降。公有云关系型数据库市场集中度更高,前五名厂商占据接近90%的市场份额。在利好政策和旺盛的市场需求双重驱动下,国内数据库市场迎来蓬勃发展期,进入百花齐放、百家争鸣的时代。新兴数据库厂商在不断涌现,其他领域厂商向数据库跨界情况的也在增多,使中国关系型数据库市场更加繁荣和活跃。新兴厂商和跨界厂商的典型代表有:星环科技:星环科技是中国本土知名的大数据平台厂商,于2021-19年,先后推出了自主研发的分布式分析型数据库ArgoDB和分布式交易型数据库KunDB,其中数仓产品ArgoDB与原有大数据业务有良好互补性,基于ArgoDB的湖仓一体方案已经广泛应用于各个行业客户。中兴:GoldenDB是中兴自主研发的分布式关系型数据库产品, 2021年,中兴GoldenDB开始在中信银行核心系统上线,目前产品已应用于多家金融机构。巨杉数据库:以金融行业非结构化数据管理切入市场,后推出分布式金融数据库,目前已有部分商业用户。PingCAP:执行开源社区策略,有众多互联网行业实践客户。2021,PingCAP开始产品的商业化转型。IDC中国企业软件市场分析师王楠表示:“随着云计算、大数据、人工智能以及5G等新技术的不断出现,数据环境呈现出大规模、高增长、多样化和分布化等特征,而随着企业数字化转型的深入,企业对数据的管理和使用也有了更高的智能化和自动化需求,这些都对数据库产品的能力提出了更高的要求,关系型数据库正向着分布式、云原生、AI使能、HTAP(混合事务与分析型数据库)、多模等方向发展。”文章来源:http://www.idc311.com/IDC/172942.html
-
 绘画,是很多人的兴趣爱好,但是想要创作优秀的作品并不容易。这不仅依赖于个人的灵光乍现,往往还需要他人协作及灵感的支持。目前市面上大多数绘画应用在单设备上的体验已经足够优秀,但是对跨设备交互的支持仍略显不足,这就导致创作者无法让其他人共同参与其中。为了让绘画作品的分享和多设备编辑更便捷,基于HarmonyOS开发了《创想绘画》这款应用。它充分利用了HarmonyOS分布式能力,如远程启动FA、跨端流转和分布式文件系统等,这些特性带来多设备协同编辑等全新交互体验。在此基础上开发了跨端流转和远程分享,这两项功能可以为用户带来更出色的绘画体验。又如远程分享功能则允许将作品分享给同账号的另外一台设备,而且不会受到距离的约束,两台设备可以独立编辑且不会被覆盖。如果用电脑文件做类比的话,跨端流转就像是电脑文件的跨设备剪切,远程分享则更像是文件的远程传输,两端独立且互不干扰。HarmonyOS的分布式技术不仅给消费者带来出色的用户体验,也让应用的开发体验事半功倍。HarmonyOS一次开发、多端部署能力可以大幅简化应用的开发复杂度和工作量。其独有的分布式模拟器让应用调试效率更高,也让应用的开发成本显著降低。自2021年4月《创想绘画》上架至华为应用市场以来,下载量已经突破6万次,并获得用户的一致好评。她们团队未来还将在此基础上持续优化改进并带来更多实用功能,包括但不限于更丰富的笔刷、更多的图层以及云同步等。对于即将到来的开发者大会,希望在大会可以看到更完善的开发技术支持,并为她们这些独立开发者带来更多的交流机会。还希望可以与大咖进行交流,让广大HarmonyOS开发者群体迸发出新的思路。详情查看HarmonyOS开发者【开发者说】栏目:https://mp.weixin.qq.com/s/atFlqjzoZp8sUJBRbnunNA
-
 什么是一致性?至于原理什么的,这里就不赘述了,总的来说目前的分布式系统实现起来基本上都是基于BASE理论的,业务需要保持最终的一致性,说白了了是可以允许 中间过程的短暂不一致,只需要最后一致就好。一说到这个,很多人马上就能想到XA和TCC这两种分布式事务的实现,而且也有很多人针对这两种思想设计出了很好的实现,比如:tcc-lcn:https://github.com/codingapi/tx-lcn 还有很多的实现,去github上一搜就能找到。但是基于XA需要有强大的事务管理器来协调事务操作,TCC的方式需要第三方协调者,多一个中间件就多一分维护,同时业务难度也就上升很多 。当然如果公司中有非常牛逼的中间件团队这个就基本可以忽略了,基本能保持最少4个9的可靠性(https://blog.csdn.net/varyall/article/details/82592970)。B端业务场景通常业务系统B端非常重视一致性,C端则更加重视高可用,在B端数据配置的时候通常都是需要调用好几个系统才能完成一个数据的创建,如商品创建基本都需要创建商品基础数据创建凭证模板创建适用门店库创建xxx关联数据落本地数据在这里的每一步都可能会失败,比如网络超时,db抖动等等常见的失败原因。每一步失败都意味着整个流程需要重试(更恐怖的是有的业务需要回滚前面的步骤)。回滚基本不在业务考虑范围内,因为本来业务就是要做好创建的工作,而且在校验阶段都是符合创建条件的,那么业务上肯定是希望能够完整的建好业务数据,回滚只是作为非常规运维手段来使用。可以需要通过以下几个点来实现最终一致性.重试就像上面说的,在这种可重试的失败需要系统能够自动重试,重试的方法有很多,可以基于任何有定时任务功能的系统或框架来实行,如linux的crontabquartzschedulerxxxl-job等都符合重试的要求,处理业务的时候本地落一条流水数据,失败后设置可重试状态,等待定时任务来执行。注意:重试的时候记录好trace,这对排查问题非常有帮助需要考虑好幂等性需要考虑好并发重试次数幂等在任务进行重试执行的时候,如何保证重复执行的幂等性呢? 首先:底层接口需要支持幂等,每次重试的时候业务流水id都保持一致,这样通过流水id来实现幂等,防止数据重复创建。但是如果底层接口不支持幂等呢?(这种肯定有的,反正有各种历史原因) 那么就需要业务自己来保证幂等了,在接口执行的时候落一条流水记录,执行完成后更新流水,在执行前先判断流水是否已经执行成功,如果成功了就幂等返回,不做业务操作。通过本地落流水只能保证99%以上幂等,如果完全依赖这个做幂等那就想的太简单了,思考下,如果在调用某个接口的时候返回了超时的异常,此时流水状态设置的还是失败状态,等待重试的时候还是会进行重复请求,这样还是会重复创建数据。所以如果底层不支持流水幂等,而是支持业务幂等的话,如创建的时候有相同的id则会查询一下本地DB,已经有数据就返回指定的错误码,那么业务上还可以根据这个错误码进行幂等处理。如果底层业务幂等都不支持,那这个就只能在处理的时候先查一次,再决定是否调用这个接口了(还是有风险的)。并发做好幂等其实还不够,还需要做好并发处理,比如我的业务在处理的时候如果失败了任务重复调度导致两个任务一起执行了,或者任务执行的时候手动触发了任务执行等,这些问题都是存在的。要做好并发处理,优先考虑使用分布式锁,在业务处理前先获取锁,获取锁失败则说明已经有任务在执行了,当前任务执行结束,等待之前的任务执行完成。加个分布式锁就可以了? 那也还是想的太简单了,考虑下这个场景第一次用户编辑的时候,在执行第三步的时候网络超时失败了,落了重试任务,此时任务还没开始调度,用户又开始编辑数据,此时执行的时候获取到了锁,执行成功了。然后定时任务调度拉起之前重试的任务,继续执行第三步的操作,然后数据就被覆盖了。。。这时聪明的你已经想到了长锁+可重入锁的方式了:业务执行的时候先落一条长锁,只有执行成功的时候才会释放锁,同时通过请求id作为可重入的判断条件,业务失败后任务拉起来执行的时候还是相同的流水ID,这时任务是可以正常执行的。此时用户想要编辑数据,则会获取锁失败,用户无法进行编辑,此时给个友好的提示。这种方式还要注意一个点,分布式锁改为了分布式可重入锁,那么并发问题又来了,如果任务同时执行了都是相同的流水id,都能正常执行。 可以通过如下的方式来避免这个通过限制可重入个数为1在业务内部再加一个锁小结考虑好幂等,并发,重试这几个问题后,整个业务系统就可以非常健壮的跑起来了。那么问题来了,为什么只要重试而不需要做回滚呢?会进入任务执行的时候,需要基础校验都已经完成了,校验通过后说明数据是允许执行的,既然已经拿到了执行的门票,那么我们的任务就是要保证创建成功,至于回滚等操作只会在底层数据出现问题,无法执行完整的创建流程,需要回滚之前的操作。实际业务上使用的时候基本不会去写回滚的逻辑的,首先加重了开发的任务,其次回滚这种逻辑更适合作为运维手段来执行,这里可以考虑下原因哦。
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签