-
 【摘要】 英伟达提出multi-scale attention机制,并将 HRNet+OCR+multi-scale attention组合在一起训练的语义分割模型在Cityscapes数据集上的mIoU达到84.7,成为Cityscapes上新的SOTA,下面对组合中涉及的HRNet、OCR模块、multi-scale attention机制以及SegFix模型进行简要介绍。主要内容可分为:(1)Cityscapes数据集介绍(2)HRNet的动机、结构以及核心代码(3)OCR的动机、结构以及核心代码(4)SegFix的动机、结构以及核心代码(5)分层多尺度注意力的动机、结构1 Cityscapes数据集介绍Cityscapes评测数据集即城市景观数据集,在2015年由奔驰公司推动发布,是目前公认的机器视觉领域内最具权威性和专业性的图像分割数据集之一。Cityscapes拥有5000张精细标注的在城市环境中驾驶场景的图像(2975train,500 val,1525test)。它具有19个类别的密集像素标注(97%coverage),其中8个具有实例级分割。具体类别名称见于下表1。 表1 Cityscapes数据集中的类别名称2 Deep High-Resolution Representation Learning for Visual Recognition(HRNet)2.1动机当前语义分割方法面临3个挑战,其中第一个挑战是基于FCN的分辨率由高到低会损失信息。语义分割方法需要高分辨率特征,图中1展示了几种基于FCN的经典方法的,它们的共同点通过一个网络得到 低分辨 feature map,然后通过上采样或反卷积恢复到高分辨率。图1 基于FCN方法的几种经典结构这些看起来不同,但本质核心思路是差不多的。这些方法存在一个缺点,分辨率由高到低会损失信息!2.2 模型结构与核心代码为了解决2.1中的问题,作者团队(MSRA和中科院)提出一个方法,核心思路是“不恢复高分辨率,而是保持分辨率”。如下图2中是一个基本的高分辨率保持网络结构,该结构把不同分辨率的feature map并联,相同分辨率的占一条分支,不同分辨率的占不同分支。并在不同分支之间添加通路(图中的斜线),形成high-resolution network。图2 基本的high-resolution network结构图2中的机构由4个stage组成,每一个蓝底色块为一个stage。在SOTA方法中,采用的是HRNet-W48,其结构图如图3所示。图3 HRNet-W48结构图HRNet V2-W48是在4个stage(图3中蓝、绿、红、黄4种底**域)的头部加上stem net(图3中白色底**域),尾部加上segment head后(图中未画出)组成。下面按照先后顺序依次对stem net、4个stage以及segment head进行介绍。(1)stem netstem net由两个Bottelneck组成,与Resnet的结构一样,经过两个Bottelneck以后,输入图像的维度由H*W*3变成了(H/4)*(W/4)*256(2)4个stage每个 stage 上的各个组件配置如下表2,以 hrnet_48 为例stage之间通过transition_layer连接,stage内由重复的基本单元HighResolutionModule组成。HighResolutionModule由分支以及分支末尾的fuse_layers组成。每条分支内由重复的basicblock组成,具体数量见表2 表2 HRNet-W48模型配置表A:stage间的transition layer:完成 stage之间通道转换和尺寸下采样,即图3中不同底色之间连接的直线和斜线stage之间的斜线,指向不做任何处理。图4 stage间的transition layer构建代码B:构建stage每个stag均是有若干重复的HighResolutionModule组成,因此构架stage的核心在与构建HighResolutionModule。构建HighResolutionModule分两步:构建分支、构建分支末尾的fuse_layers。构建分支:图3种的4个连续的basicblock即一个分支。 图5 HighResolutionModule内分支构建代码构建fuselayer:以下图中蓝色框为例说明fuselayer层的处理过程: 图6 fuselayer层图6 HighResolutionModule内fuselayer层构建代码转自fdafad,https://bbs.huaweicloud.com/blogs/259223
-
 导 读本文是对发表于计算机图形学顶级会议 SIGGRAPH 2021 的论文 Learning Skeletal Articulations with Neural Blend Shapes 的解读。该论文由北京大学陈宝权教授研究团队与北京电影学院未来影像高精尖创新中心、Google Research、特拉维夫大学以及苏黎世联邦理工学院合作,针对骨骼驱动的模型动画的高质量自动化生成进行改进,提出了神经融合形状技术。实验证明,该方法显著减少了已有方法中需要的人工干预,大大提升了生成动画的质量。论文链接:https://peizhuoli.github.io/neural-blend-shapes/papers/neural-blend-shapes-camera-ready.pdf项目主页:https://peizhuoli.github.io/neural-blend-shapes/GitHub代码仓库:https://github.com/PeizhuoLi/neural-blend-shapes01引 言骨骼驱动的三维人物动画在游戏、影视等应用场景中随处可见。然而,使用骨骼驱动三维人物网格模型(mesh)进行变形并得到动画,通常需要经历繁琐的骨骼搭建(rigging)以及蒙皮权重绑定(skinning)。这些处理技术复杂而艰深,动画师通常需要数年的时间来尝试掌握。此外,一些常见的特定动作,例如弯曲肘部、蹲下,由于常用的蒙皮技术(线性融合蒙皮,Linear Blend Skinning)的局限性,关节区域的变形并不理想。左:现有技术在关节区域的问题;右:本文技术生成的高质量且细节丰富的动画为了简化骨骼搭建和蒙皮权重绑定的过程、高效利用动作捕捉数据以及生成高质量的动画,我们开发了一套能生成具有指定结构的骨骼以及精准绑定权重的神经网络。加以我们提出的神经融合形状(neural blend shapes)技术,我们实现了实时高质量三维人物模型动画的端到端自动生成。方法概览02方法简介从处于 T 姿态的人物模型以及在给定的骨骼结构上的关节旋转开始,我们的包裹变形分支(envelope deformation branch)学习并预测出相应的骨骼以及蒙皮权重。与此同时,补偿变形分支(residual deformation branch)预测出对应的融合形状(blend shapes)并使用输入的关节旋转预测对应的融合系数,然后基于此插值得到补偿变形。综合以上中间结果,可微分包裹变形模块将生成最终的变形结果。这一设计使得我们的神经网络能够通过仅观察变形后的人物模型进行间接学习,而不需要对训练数据集的变形方法有任何限制,极大增广了该方法的适用范围。方法框架我们的神经网络使用了网格卷积[1]和骨骼卷积[2]搭建各个模块。基于这些最前沿技术的基本算子,我们的网络可以在具有任意网格连通性的人物模型上生成高质量的结果。下图展示了我们的网络的具体架构:包裹变形分支补偿变形分支03结果展示我们的方法能准确的预测出与人物模型高度匹配的骨骼以及绑定权重:骨骼以及绑定权重的可视化特别的,我们的方法能生成符合预先指定结构的骨骼,这一点在使用动作捕捉数据时尤为关键。而 RigNet[3]只提供了十分有限的用户操纵参数,生成的骨骼结构难以控制:从左至右分别为:RigNet(12), RigNet(25), RigNet(50), Ours由于我们的神经网络直接在高质量变形模型上训练,仅使用包裹变形分支就已经超过了基准的线性融合蒙皮技术。再加上我们的神经融合形状技术,关节区域的变形结果便是更上一层楼:参考:[1] Hanocka et al., 2019, MeshCNN: A Network with an Edge[2] Aberman et al., 2020, Skeleton-Aware Networks for Deep Motion Retargeting[3] Xu et al., 2020, RigNet: Neural Rigging for Articulated Characters
-
将元学习明确地描述为两个嵌套的优化问题 内部优化在线进行指的是:智能体试图从系统设计阶段生成的一系列假设中找到在线学习数据中“得分”最佳的假设。内部优化的特色在于假设空间、评分标准和将用于搜索最佳假设的计算机算法。在传统的机器学习中,这些成分由人类工程师提供。 但在元学习中,至少一部分是由系统设计阶段进行的外部“元”优化过程所提供的。元优化试图找到内部学习过程本身的参数。这些参数能使学习在与元学习的环境相似的新环境中进行(源于相同的分布)。 最近有研究介绍了一种新的元学习形式,叫做“与模型无关的元学习”(model-agnostic meta-learning,MAML)。MAML是一个嵌套的优化框架,其中外部优化选择的是一些内部神经网络权重的初始值,能通过在线学习的标准梯度下降优化方法进一步调整。RL2算法在系统设计阶段中使用DRL来学习在线学习运行的一般小型程序,但这些小型程序不一定具有机器学习程序的形式。另一个变体试图在系统设计阶段发现可以组合起来以解决在线学习出现的问题的模块构造块(modular building blocks,如小型神经网络)。 自然界中的进化过程可以被认为是元学习的一种极端形式。在自然进化中,自然界会为了动物去寻找一个含有潜在学习算法的、极其不受限制的空间。(当然,从本质上讲,智能体的生理状况也会发生改变。)在机器人生命周期内,对内部优化问题的处理越灵活,越需要更多用于提高鲁棒性的资源,包括系统设计阶段的示例环境、在线学习的性能不佳的机器人,以及在两个阶段运行的计算容量。 这时候,我们又回到最初的问题:标准的强化学习方法不会被采用,因为尽管它是一种通用的学习方法,但它需要大量的在线学习经验。然而,元强化学习(meta-RL)需要丰富的系统设计经验,这可能会使开发过程变得迟钝、缓慢而花费高昂。因此,也许元学习也不是一个好的解决方法。 那还有什么解决方法呢?有很多方向可以探索,包括人类教学、与其他机器人协作学习,以及更改机器人的硬件和软件。在所有这些情况下,关键的一步还是设计出有效的方法来开发机器人软件。通过运用从计算机科学和工程学中所获得的见识以及认知神经科学的启发,我们可以找到能够内置到学习智能体中的算法和结构,并提供在系统设计阶段和在线学习算法和结构的杠杆。 卷积神经网络的发展是上述方法的典型例子。卷积神经网络的理念是设计出一种用于图像处理的神经网络,以使其执行“卷积”,即在整个图像上使用相同的计算模式对图像块进行局部处理。这个设计同时对先验知识进行了编码。在此处,先验知识指的是无论物体处于图像中的什么位置,物体都具有基本相同的外观(平移不变性),以及接近的像素组共享图像内容的信息(空间局部性)。与没有卷积结构的情况相比,以这种方式训练一个神经网络意味着需要的参数数量更少,因此训练次数也相应减少。 图像卷积的点子由工程师和自然启发,是早期信号处理和计算机视觉的基础概念。一直以来,人们都认为,哺乳动物视觉皮层中的细胞似乎也在执行类似的计算。 转自陈彩娴 ,https://www.leiphone.com/category/academic/VV75HfxY7dwQPurq.html
-
论文名称:Segmentation and Optimal Region Selection of Physiological Signals using Deep Neural Networks and Combinatorial Optimization作者:Jorge Oliveira /Margarida Carvalho /Diogo Marcelo Nogueira /Miguel Coimbra发表时间:2020/3/17论文链接:https://paper.yanxishe.com/review/14660?from=leiphonecolumn_paperreview0417推荐原因1 核心问题本文解决的是如何自动提取生理信号最优波段来辅助后续诊断和预测的问题。2 创新点本文使用神经网络去计算每个样本的状态概率分布,然后构造出一张图,同时在图中加入状态转换限制,并根据最大化用户提出的似然函数去使用一组约束来检索生理信号记录的子集。3 研究意义生理信号经常会被噪音干扰。通常情况下,人工智能算法会在无视质量的情况下对之进行整体分析。与之相反的是,医师则并不分析整个记录,而是会搜寻容易检测到基本波动和异常波动的波段进行分析,然后才进行预测。因此,受到以上事实启发,本文提出了一个基于用户自定标准,为后期处理自动选择最优波段的算法。本文将提出的方法使用在两个实际应用场景中,并且取得了很好的效果。转自Ai ,https://www.leiphone.com/category/academic/OplxYlWbr1ak9nCm.html
-
 ### 名称及链接 [电子相册智慧整理](https://edu.huaweicloud.com/certifications/880d036b9d6243f1871693a0706e7f2a) ### 课程章节 1. 相册整理与华为云EI服务 2. 图像处理基础知识 3. 卷积神经网络 4. 电子相册智慧整理项目实战 ### 证书  ### 笔记 1. 相册智能整理 1. 图片标签 2. 快速分类 3. 动态相册 4. 智能搜索 2. 华为云EI服务 1. 图像识别 1. 场景分析 2. 目标检测 3. 智能相册 4. 图像搜索 2. modelarts 3. 图像处理运用场景 1. 图像分类 2. 风格化 3. 低曝光增强 4. 超分辨率 5. 图像去雾 3. 计算机视觉 1. 图像的采集获取 2. 图像的压缩编码 3. 图像的存储和传输 4. 图像的合成 5. 三维图像重建 6. 图像增强 7. 图像修复 8. 图像的分类和识别 9. 目标的检测、跟踪、表达和描述 10. 特征提取 11. 图像的显示和输出 4. 颜色空间 1. RGB 2. HSV 3. CMYK 4. Lab 5. 常见图像存储格式 1. BMP 2. JPG 3. GIF 4. PNG 6. 图像预处理 1. 图像灰度调整 1. 最大值法 2. 平均值法 3. 加权平均值法 2. 对比度增强 1. 直方图均衡化 3. 锐化 1. 梯度法 4. 平滑 5. 去噪 6. 其他 1. 通道调整 2. 翻转 3. 缩放 4. 拉伸 5. 旋转 6. 噪声 7. 对比度 8. 剪切 7. 卷积神经网络(一种前馈神经网络) 1. 卷积层 1. 卷积核 2. 特征图 2. 激活函数 1. sigmoid 2. tanh 3. relu 4. leakyrelu 5. SoftMax 3. 池化层 1. 最大池化 2. 平均池化 4. 全连接层 8. 反向传播算法 9. 梯度下降算法 10. anaconda 11. jupyter notebook 12. python图像处理库 1. PIL 2. pillow 3. OpenCV 4. matplotlib 5. scikit-image 13. Base64编码方式 ### 备注 1. 感谢老师的教学与课件 2. 欢迎各位同学一起来交流学习心得^_^ 3. 在线课程、沙箱实验、博客和直播,其中包含了许多优质的内容,推荐了解与学习。
-
 Fast-SCNN由4部分构成,Learning to Down-sample(学习下采样),Global Feature Extractor(全局特征提取), Feature Fusion(特征融合), Classifier(分类器)。Learning to Down-sample,一个普通的卷积层Conv2D,两个depthwise separable卷积层(DSConv)。Global Feature Extractor,用于抓取图像分割的全局特征。与普通multi-branch方法不同,该模块对于低分辨率图像进行处理。Feature Fusion,融合特征,并且是以相对简单方式融合两个分支的特征,确保效率。Classifier,两个depthwise separable卷积层(DSConv),一个pointwise卷积层(Conv2D),包含一个softmax操作。此外,在梯度下降计算中,用argmax将softmax替代,以提高计算效率。Fast-SCNN的创新点主要在以下两个方面:“学习下采样”(Learning to Down-sample)和encoder-decoder中的 skip connection类似,确保了低层次特征能被有效地共享和使用,共三层。Fast-SCNN还借鉴了MobileNet的depthwise separable convolution和 residual bottleneck block,来降低计算成本和内存消耗。
-
 在架构内容设计方面,其中一个比较有帮助的想法是使用1×1卷积。也许你会好奇,1×1的卷积能做什么呢?不就是乘以数字么?听上去挺好笑的,结果并非如此,我们来具体看看。 过滤器为1×1,这里是数字2,输入一张6×6×1的图片,然后对它做卷积,起过滤器大小为1×1×1,结果相当于把这个图片乘以数字2,所以前三个单元格分别是2、4、6等等。用1×1的过滤器进行卷积,似乎用处不大,只是对输入矩阵乘以某个数字。但这仅仅是对于6×6×1的一个通道图片来说,1×1卷积效果不佳。  如果是一张6×6×32的图片,那么使用1×1过滤器进行卷积效果更好。具体来说,1×1卷积所实现的功能是遍历这36个单元格,计算左图中32个数字和过滤器中32个数字的元素积之和,然后应用**ReLU**非线性函数。  我们以其中一个单元为例,它是这个输入层上的某个切片,用这36个数字乘以这个输入层上1×1切片,得到一个实数,像这样把它画在输出中。 这个1×1×32过滤器中的32个数字可以这样理解,一个神经元的输入是32个数字(输入图片中左下角位置32个通道中的数字),即相同高度和宽度上某一切片上的32个数字,这32个数字具有不同通道,乘以32个权重(将过滤器中的32个数理解为权重),然后应用**ReLU**非线性函数,在这里输出相应的结果。  一般来说,如果过滤器不止一个,而是多个,就好像有多个输入单元,其输入内容为一个切片上所有数字,输出结果是6×6过滤器数量。  所以1×1卷积可以从根本上理解为对这32个不同的位置都应用一个全连接层,全连接层的作用是输入32个数字(过滤器数量标记为,在这36个单元上重复此过程),输出结果是6×6×#filters(过滤器数量),以便在输入层上实施一个非平凡(**non-trivial**)计算。  这种方法通常称为1×1卷积,有时也被称为**Network in Network**,在林敏、陈强和杨学成的论文中有详细描述。虽然论文中关于架构的详细内容并没有得到广泛应用,但是1×1卷积或**Network in Network**这种理念却很有影响力,很多神经网络架构都受到它的影响,包括下节课要讲的**Inception**网络。 举个1×1卷积的例子,相信对大家有所帮助,这是它的一个应用。 假设这是一个28×28×192的输入层,你可以使用池化层压缩它的高度和宽度,这个过程我们很清楚。但如果通道数量很大,该如何把它压缩为28×28×32维度的层呢?你可以用32个大小为1×1的过滤器,严格来讲每个过滤器大小都是1×1×192维,因为过滤器中通道数量必须与输入层中通道的数量保持一致。但是你使用了32个过滤器,输出层为28×28×32,这就是压缩通道数()的方法,对于池化层我只是压缩了这些层的高度和宽度。  在之后我们看到在某些网络中1×1卷积是如何压缩通道数量并减少计算的。当然如果你想保持通道数192不变,这也是可行的,1×1卷积只是添加了非线性函数,当然也可以让网络学习更复杂的函数,比如,我们再添加一层,其输入为28×28×192,输出为28×28×192。  1×1卷积层就是这样实现了一些重要功能的(**doing something pretty non-trivial**),它给神经网络添加了一个非线性函数,从而减少或保持输入层中的通道数量不变,当然如果你愿意,也可以增加通道数量。后面你会发现这对构建**Inception**网络很有帮助,我们放在下节课讲。 这里我们演示了如何根据自己的意愿通过1×1卷积的简单操作来压缩或保持输入层中的通道数量,甚至是增加通道数量。
-
### 残差网络为什么有用?(Why ResNets work?) 为什么**ResNets**能有如此好的表现,我们来看个例子,它解释了其中的原因,至少可以说明,如何构建更深层次的**ResNets**网络的同时还不降低它们在训练集上的效率。希望你已经通过第三门课了解到,通常来讲,网络在训练集上表现好,才能在**Hold-Out**交叉验证集或**dev**集和测试集上有好的表现,所以至少在训练集上训练好**ResNets**是第一步。 先来看个例子,上次我们了解到,一个网络深度越深,它在训练集上训练的效率就会有所减弱,这也是有时候我们不希望加深网络的原因。而事实并非如此,至少在训练**ResNets**网络时,并非完全如此,举个例子。 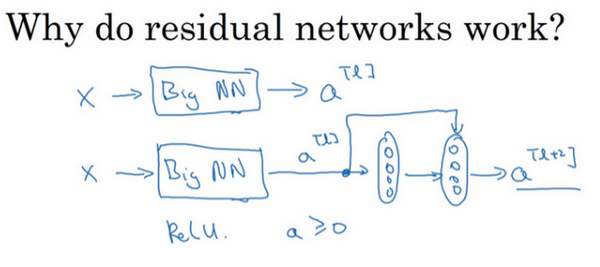 假设有一个大型神经网络,其输入为,输出激活值。假如你想增加这个神经网络的深度,那么用**Big NN**表示,输出为。再给这个网络额外添加两层,依次添加两层,最后输出为,可以把这两层看作一个**ResNets**块,即具有捷径连接的残差块。为了方便说明,假设我们在整个网络中使用**ReLU**激活函数,所以激活值都大于等于0,包括输入的非零异常值。因为**ReLU**激活函数输出的数字要么是0,要么是正数。 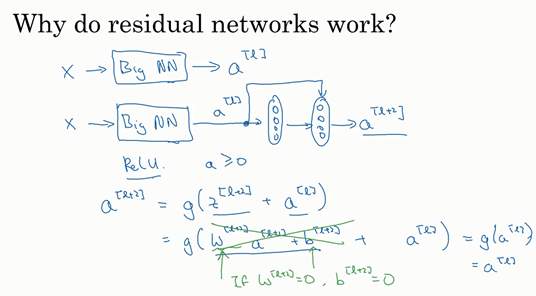 我们看一下的值,也就是上节课讲过的表达式,即,添加项是刚添加的跳跃连接的输入。展开这个表达式,其中。注意一点,如果使用**L2**正则化或权重衰减,它会压缩的值。如果对应用权重衰减也可达到同样的效果,尽管实际应用中,你有时会对应用权重衰减,有时不会。这里的是关键项,如果,为方便起见,假设,这几项就没有了,因为它们()的值为0。最后,因为我们假定使用**ReLU**激活函数,并且所有激活值都是非负的,是应用于非负数的**ReLU**函数,所以。 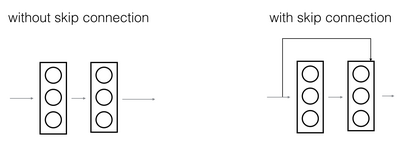  结果表明,残差块学习这个恒等式函数并不难,跳跃连接使我们很容易得出。这意味着,即使给神经网络增加了这两层,它的效率也并不逊色于更简单的神经网络,因为学习恒等函数对它来说很简单。尽管它多了两层,也只把的值赋值给。所以给大型神经网络增加两层,不论是把残差块添加到神经网络的中间还是末端位置,都不会影响网络的表现。 当然,我们的目标不仅仅是保持网络的效率,还要提升它的效率。想象一下,如果这些隐藏层单元学到一些有用信息,那么它可能比学习恒等函数表现得更好。而这些不含有残差块或跳跃连接的深度普通网络情况就不一样了,当网络不断加深时,就算是选用学习恒等函数的参数都很困难,所以很多层最后的表现不但没有更好,反而更糟。 我认为残差网络起作用的主要原因就是这些残差块学习恒等函数非常容易,你能确定网络性能不会受到影响,很多时候甚至可以提高效率,或者说至少不会降低网络的效率,因此创建类似残差网络可以提升网络性能。 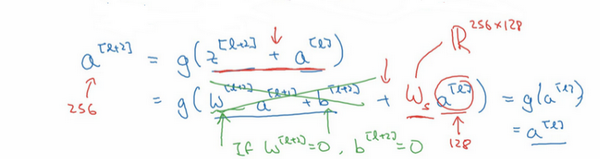 除此之外,关于残差网络,另一个值得探讨的细节是,假设与具有相同维度,所以**ResNets**使用了许多**same**卷积,所以这个的维度等于这个输出层的维度。之所以能实现跳跃连接是因为**same**卷积保留了维度,所以很容易得出这个捷径连接,并输出这两个相同维度的向量。 如果输入和输出有不同维度,比如输入的维度是128,的维度是256,再增加一个矩阵,这里标记为,是一个256×128维度的矩阵,所以的维度是256,这个新增项是256维度的向量。你不需要对做任何操作,它是网络通过学习得到的矩阵或参数,它是一个固定矩阵,**padding**值为0,用0填充,其维度为256,所以者几个表达式都可以。 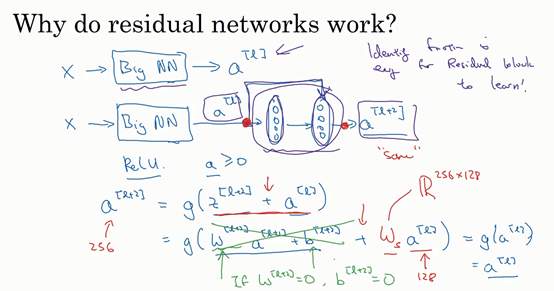 最后,我们来看看**ResNets**的图片识别。这些图片是我从何凯明等人论文中截取的,这是一个普通网络,我们给它输入一张图片,它有多个卷积层,最后输出了一个**Softmax**。 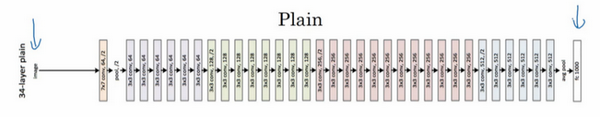 如何把它转化为**ResNets**呢?只需要添加跳跃连接。这里我们只讨论几个细节,这个网络有很多层3×3卷积,而且它们大多都是**same**卷积,这就是添加等维特征向量的原因。所以这些都是卷积层,而不是全连接层,因为它们是**same**卷积,维度得以保留,这也解释了添加项(维度相同所以能够相加)。  **ResNets**类似于其它很多网络,也会有很多卷积层,其中偶尔会有池化层或类池化层的层。不论这些层是什么类型,正如我们在上一张幻灯片看到的,你都需要调整矩阵的维度。普通网络和**ResNets**网络常用的结构是:卷积层-卷积层-卷积层-池化层-卷积层-卷积层-卷积层-池化层……依此重复。直到最后,有一个通过**softmax**进行预测的全连接层。 以上就是**ResNets**的内容。
-
我们来学习几个经典的神经网络结构,分别是**LeNet-5**、**AlexNet**和**VGGNet**,开始吧。 首先看看**LeNet-5**的网络结构,假设你有一张32×32×1的图片,**LeNet-5**可以识别图中的手写数字,比如像这样手写数字7。**LeNet-5**是针对灰度图片训练的,所以图片的大小只有32×32×1。实际上**LeNet-5**的结构和我们上周讲的最后一个范例非常相似,使用6个5×5的过滤器,步幅为1。由于使用了6个过滤器,步幅为1,**padding**为0,输出结果为28×28×6,图像尺寸从32×32缩小到28×28。然后进行池化操作,在这篇论文写成的那个年代,人们更喜欢使用平均池化,而现在我们可能用最大池化更多一些。在这个例子中,我们进行平均池化,过滤器的宽度为2,步幅为2,图像的尺寸,高度和宽度都缩小了2倍,输出结果是一个14×14×6的图像。我觉得这张图片应该不是完全按照比例绘制的,如果严格按照比例绘制,新图像的尺寸应该刚好是原图像的一半。  接下来是卷积层,我们用一组16个5×5的过滤器,新的输出结果有16个通道。**LeNet-5**的论文是在1998年撰写的,当时人们并不使用**padding**,或者总是使用**valid**卷积,这就是为什么每进行一次卷积,图像的高度和宽度都会缩小,所以这个图像从14到14缩小到了10×10。然后又是池化层,高度和宽度再缩小一半,输出一个5×5×16的图像。将所有数字相乘,乘积是400。 下一层是全连接层,在全连接层中,有400个节点,每个节点有120个神经元,这里已经有了一个全连接层。但有时还会从这400个节点中抽取一部分节点构建另一个全连接层,就像这样,有2个全连接层。 最后一步就是利用这84个特征得到最后的输出,我们还可以在这里再加一个节点用来预测的值,有10个可能的值,对应识别0-9这10个数字。在现在的版本中则使用**softmax**函数输出十种分类结果,而在当时,**LeNet-5**网络在输出层使用了另外一种,现在已经很少用到的分类器。 相比现代版本,这里得到的神经网络会小一些,只有约6万个参数。而现在,我们经常看到含有一千万到一亿个参数的神经网络,比这大1000倍的神经网络也不在少数。 不管怎样,如果我们从左往右看,随着网络越来越深,图像的高度和宽度在缩小,从最初的32×32缩小到28×28,再到14×14、10×10,最后只有5×5。与此同时,随着网络层次的加深,通道数量一直在增加,从1增加到6个,再到16个。  这个神经网络中还有一种模式至今仍然经常用到,就是一个或多个卷积层后面跟着一个池化层,然后又是若干个卷积层再接一个池化层,然后是全连接层,最后是输出,这种排列方式很常用。 对于那些想尝试阅读论文的同学,我再补充几点。接下来的部分主要针对那些打算阅读经典论文的同学,所以会更加深入。这些内容你完全可以跳过,算是对神经网络历史的一种回顾吧,听不懂也不要紧。 读到这篇经典论文时,你会发现,过去,人们使用**sigmod**函数和**tanh**函数,而不是**ReLu**函数,这篇论文中使用的正是**sigmod**函数和**tanh**函数。这种网络结构的特别之处还在于,各网络层之间是有关联的,这在今天看来显得很有趣。 比如说,你有一个的网络,有个通道,使用尺寸为的过滤器,每个过滤器的通道数和它上一层的通道数相同。这是由于在当时,计算机的运行速度非常慢,为了减少计算量和参数,经典的**LeNet-5**网络使用了非常复杂的计算方式,每个过滤器都采用和输入模块一样的通道数量。论文中提到的这些复杂细节,现在一般都不用了。 我认为当时所进行的最后一步其实到现在也还没有真正完成,就是经典的**LeNet-5**网络在池化后进行了非线性函数处理,在这个例子中,池化层之后使用了**sigmod**函数。如果你真的去读这篇论文,这会是最难理解的部分之一,我们会在后面的课程中讲到。 下面要讲的网络结构简单一些,幻灯片的大部分类容来自于原文的第二段和第三段,原文的后几段介绍了另外一种思路。文中提到的这种图形变形网络如今并没有得到广泛应用,所以在读这篇论文的时候,我建议精读第二段,这段重点介绍了这种网络结构。泛读第三段,这里面主要是一些有趣的实验结果。 我要举例说明的第二种神经网络是**AlexNet**,是以论文的第一作者**Alex Krizhevsky**的名字命名的,另外两位合著者是**ilya Sutskever**和**Geoffery Hinton**。  **AlexNet**首先用一张227×227×3的图片作为输入,实际上原文中使用的图像是224×224×3,但是如果你尝试去推导一下,你会发现227×227这个尺寸更好一些。第一层我们使用96个11×11的过滤器,步幅为4,由于步幅是4,因此尺寸缩小到55×55,缩小了4倍左右。然后用一个3×3的过滤器构建最大池化层,,步幅为2,卷积层尺寸缩小为27×27×96。接着再执行一个5×5的卷积,**padding**之后,输出是27×27×276。然后再次进行最大池化,尺寸缩小到13×13。再执行一次**same**卷积,相同的**padding**,得到的结果是13×13×384,384个过滤器。再做一次**same**卷积,就像这样。再做一次同样的操作,最后再进行一次最大池化,尺寸缩小到6×6×256。6×6×256等于9216,将其展开为9216个单元,然后是一些全连接层。最后使用**softmax**函数输出识别的结果,看它究竟是1000个可能的对象中的哪一个。 实际上,这种神经网络与**LeNet**有很多相似之处,不过**AlexNet**要大得多。正如前面讲到的**LeNet**或**LeNet-5**大约有6万个参数,而**AlexNet**包含约6000万个参数。当用于训练图像和数据集时,**AlexNet**能够处理非常相似的基本构造模块,这些模块往往包含着大量的隐藏单元或数据,这一点**AlexNet**表现出色。**AlexNet**比**LeNet**表现更为出色的另一个原因是它使用了**ReLu**激活函数。  同样的,我还会讲一些比较深奥的内容,如果你并不打算阅读论文,不听也没有关系。第一点,在写这篇论文的时候,**GPU**的处理速度还比较慢,所以**AlexNet**采用了非常复杂的方法在两个**GPU**上进行训练。大致原理是,这些层分别拆分到两个不同的**GPU**上,同时还专门有一个方法用于两个**GPU**进行交流。  论文还提到,经典的**AlexNet**结构还有另一种类型的层,叫作“局部响应归一化层”(**Local Response Normalization**),即**LRN**层,这类层应用得并不多,所以我并没有专门讲。局部响应归一层的基本思路是,假如这是网络的一块,比如是13×13×256,**LRN**要做的就是选取一个位置,比如说这样一个位置,从这个位置穿过整个通道,能得到256个数字,并进行归一化。进行局部响应归一化的动机是,对于这张13×13的图像中的每个位置来说,我们可能并不需要太多的高激活神经元。但是后来,很多研究者发现**LRN**起不到太大作用,这应该是被我划掉的内容之一,因为并不重要,而且我们现在并不用**LRN**来训练网络。 如果你对深度学习的历史感兴趣的话,我认为在**AlexNet**之前,深度学习已经在语音识别和其它几个领域获得了一些关注,但正是通过这篇论文,计算机视觉群体开始重视深度学习,并确信深度学习可以应用于计算机视觉领域。此后,深度学习在计算机视觉及其它领域的影响力与日俱增。如果你并不打算阅读这方面的论文,其实可以不用学习这节课。但如果你想读懂一些相关的论文,这是比较好理解的一篇,学起来会容易一些。 **AlexNet**网络结构看起来相对复杂,包含大量超参数,这些数字(55×55×96、27×27×96、27×27×256……)都是**Alex Krizhevsky**及其合著者不得不给出的。  这节课要讲的第三个,也是最后一个范例是**VGG**,也叫作**VGG-16**网络。值得注意的一点是,**VGG-16**网络没有那么多超参数,这是一种只需要专注于构建卷积层的简单网络。首先用3×3,步幅为1的过滤器构建卷积层,**padding**参数为**same**卷积中的参数。然后用一个2×2,步幅为2的过滤器构建最大池化层。因此**VGG**网络的一大优点是它确实简化了神经网络结构,下面我们具体讲讲这种网络结构。  假设要识别这个图像,在最开始的两层用64个3×3的过滤器对输入图像进行卷积,输出结果是224×224×64,因为使用了**same**卷积,通道数量也一样。**VGG-16**其实是一个很深的网络,这里我并没有把所有卷积层都画出来。  假设这个小图是我们的输入图像,尺寸是224×224×3,进行第一个卷积之后得到224×224×64的特征图,接着还有一层224×224×64,得到这样2个厚度为64的卷积层,意味着我们用64个过滤器进行了两次卷积。正如我在前面提到的,这里采用的都是大小为3×3,步幅为1的过滤器,并且都是采用**same**卷积,所以我就不再把所有的层都画出来了,只用一串数字代表这些网络。 接下来创建一个池化层,池化层将输入图像进行压缩,从224×224×64缩小到多少呢?没错,减少到112×112×64。然后又是若干个卷积层,使用129个过滤器,以及一些**same**卷积,我们看看输出什么结果,112×112×128.然后进行池化,可以推导出池化后的结果是这样(56×56×128)。接着再用256个相同的过滤器进行三次卷积操作,然后再池化,然后再卷积三次,再池化。如此进行几**作后,将最后得到的7×7×512的特征图进行全连接操作,得到4096个单元,然后进行**softmax**激活,输出从1000个对象中识别的结果。  顺便说一下,**VGG-16**的这个数字16,就是指在这个网络中包含16个卷积层和全连接层。确实是个很大的网络,总共包含约1.38亿个参数,即便以现在的标准来看都算是非常大的网络。但**VGG-16**的结构并不复杂,这点非常吸引人,而且这种网络结构很规整,都是几个卷积层后面跟着可以压缩图像大小的池化层,池化层缩小图像的高度和宽度。同时,卷积层的过滤器数量变化存在一定的规律,由64翻倍变成128,再到256和512。作者可能认为512已经足够大了,所以后面的层就不再翻倍了。无论如何,每一步都进行翻倍,或者说在每一组卷积层进行过滤器翻倍操作,正是设计此种网络结构的另一个简单原则。这种相对一致的网络结构对研究者很有吸引力,而它的主要缺点是需要训练的特征数量非常巨大。  有些文章还介绍了**VGG-19**网络,它甚至比**VGG-16**还要大,如果你想了解更多细节,请参考幻灯片下方的注文,阅读由**Karen Simonyan**和**Andrew Zisserman**撰写的论文。由于**VGG-16**的表现几乎和**VGG-19**不分高下,所以很多人还是会使用**VGG-16**。我最喜欢它的一点是,文中揭示了,随着网络的加深,图像的高度和宽度都在以一定的规律不断缩小,每次池化后刚好缩小一半,而通道数量在不断增加,而且刚好也是在每组卷积操作后增加一倍。也就是说,图像缩小的比例和通道数增加的比例是有规律的。从这个角度来看,这篇论文很吸引人。 以上就是三种经典的网络结构,如果你对这些论文感兴趣,我建议从介绍**AlexNet**的论文开始,然后就是**VGG**的论文,最后是**LeNet**的论文。虽然有些晦涩难懂,但对于了解这些网络结构很有帮助。 学过这些经典的网络之后,下次我会学习一些更先高级更强大的神经网络结构。
-
 讯方实训云教育解决方案整合行业先进技术及人才标准,通过产教融合协同育人服务高校ICT专业建设与学科发展,实现产、学、研、用人才闭环,助力云计算、大数据、人工智能及鲲鹏人才培养。 商品亮点:①丰富的课程和视频资源:华为认证课程+技术专业课程②实验环境:覆盖云计算、大数据、AI及鲲鹏等多个技术方向,满足日常教学+培训授课所需要的实验环境③智能的学习跟踪管理:提供专项学习、错误记录、模拟考试等多种测评方式,准确评估用户知识点掌握情况④全方位的教学服务项目:提供课程建设、师资培养、认证培训、实习服务等教学服务内容⑤灵活的部署模式:支持公有云、混合云部署方式,保障资源充分利用以5G、人工智能、大数据、云计算、物联网等为代表的新一代信息技术已经全面融合渗透到经济社会生活的各个领域,成为深刻改变人类社会生产方式、生活方式和思维方式的重要使能工具,并推动各行业各领域加速向数字化、网络化、智能化转型。信息技术产业的蓬勃发展,导致产业人才存在需求数量巨大、人才错位等特征。在这个背景下,国家近几年持续加大对教育领域的投入以及政策支持,先后出台多项促进产教融合的政策,并陆续批复设立了云计算、大数据、人工智能等技术方向的新专业。新专业的建设无成熟的模式可借鉴,院校存在人才培养如何定位、课程如何开设、师资培养等一系列问题。技术发展及人才需求走在前面,高校需要和行业优秀企业合作,需要企业在专业建设、课程建设、师资培养、实践环境建设、学生实习就业等多个领域提供支持和专业服务。华为云云市场讯方实训云教育解决方案是针对云计算、大数据、AI等新专业建设痛点的解决方案,主要提供以下核心功能及服务:1、云端教学:可以满足学校进行远程直播教学、线上教学、教学视频回看等需教学需求;2、云端实验:面向云计算、大数据、AI、鲲鹏等技术方向提供云端实验沙箱,满足项目实训需求;3、教学服务:面向专业建设过程的核心任务,提供课程建设、师资培养、认证培训、实习就业服务等教学服务项目: ①课程建设服务:专业课程植入;特色课程定制开发,打造金课、国家/省级精品课程;讲师驻场授课+项目实训 ②师资培养服务:鲲鹏讲师赋能培训、讲师入企业实践提升技能,双师互聘双向交流,打造双师师资队伍 ③认证培训服务:职业认证证书普及;HCIE精英认证服务打造人才培养特色;微认证赋能学生专项技能;1+X认证课程嵌入,实现课证融合 ④实习就业服务:专场招聘会助力学生对口就业;岗前培训、夏(冬)令营赋能职业素养;校内、校外实训基地提升职业技能 ⑤科研创新服务:联合科研助力技术创新平台、技术服务平台建设;创新创业服务打造双创教育高地。讯方技术专注ICT技术人才培养及软件与信息服务20年,整合行业先进技术及人才标准,通过讯方实训云教育解决方案践行产教融合,实现产、学、研、用人才闭环,助力ICT产业人才培养。 文中提到的商品链接:讯方实训云【华为云云市场,助您上云无忧】
-
-
经典算法所谓“工欲善其事必先利其器”,要解决问题,就要有好的算法。Scikit-Learn库中的几种经典机器学习算法:一、K最近邻(KNN)这个算法思路特别简单,就是随大流。对于需要贴标签的数据样本,他总是会找几个和自己离得最近的样本,也就是邻居,看看邻居是什么标签。如果他的邻居中的大多数样本都是某一类样本,他就认为自己也是这样一类样本。参数k,就是邻居的个数,通常是3,5,7,等不超过20的数字。在机器学习算法中,常用的距离计算公式包括欧式距离和曼哈顿距离所以,KNN算法的结果和K值的取值有关系,要注意的是,KNN要找的邻居都已经是“站好队的人”,也就是已经正确分类的对象。下面进行实战:对心脏病数据的进行推断客户是否有心脏病:1.导入数据:import numpy as np # 导入NumPy数学工具箱import pandas as pd # 导入Pandas数据处理工具箱df_heart = pd.read_csv("heart.csv") # 读取文件df_heart.head() # 显示前5行数据2.查看患病个数:import matplotlib.pyplot as pltimport seaborn as sns #导入seaborn画图工具箱sns.countplot(x="target", data=df_heart, palette="bwr")plt.show() 3.对某些特征转换为数值类型的哑变量:a = pd.get_dummies(df_heart['cp'], prefix = "cp")b = pd.get_dummies(df_heart['thal'], prefix = "thal")4.划分训练集和测试集:# 构建特征和标签集y = df_heart.target.valuesX = df_heart.drop(['target'], axis = 1)from sklearn.model_selection import train_test_split # 拆分训练集和测试集X_train, X_test, y_train, y_test = train_test_split(X,y,test_size = 0.2,random_state=0)5.进行特征缩放:# 进行特征缩放from sklearn import preprocessingscaler = preprocessing.MinMaxScaler()X_train = scaler.fit_transform(X_train)X_test = scaler.transform(X_test) =6.模型训练:from sklearn.neighbors import KNeighborsClassifier # 导入kNN算法k = 5 # 设定初始K值为5kNN = KNeighborsClassifier(n_neighbors = k) # kNN模型kNN.fit(X_train, y_train) # 拟合kNN模型y_pred = kNN.predict(X_test) # 预测心脏病结果from sklearn.metrics import (accuracy_score, f1_score, average_precision_score, confusion_matrix) # 导入评估标准print("{}NN 预测准确率: {:.2f}%".format(k, kNN.score(X_test, y_test)*100))print("{}NN 预测F1分数: {:.2f}%".format(k, f1_score(y_test, y_pred)*100))print('kNN 混淆矩阵:\n', confusion_matrix(y_pred, y_test)) =7.寻找最佳K值# 寻找最佳K值f1_score_list = []acc_score_list = []for i in range(1,15): kNN = KNeighborsClassifier(n_neighbors = i) # n_neighbors means k kNN.fit(X_train, y_train) acc_score_list.append(kNN.score(X_test, y_test)) y_pred = kNN.predict(X_test) # 预测心脏病结果 f1_score_list.append(f1_score(y_test, y_pred))index = np.arange(1,15,1)plt.plot(index,acc_score_list,c='blue',linestyle='solid')plt.plot(index,f1_score_list,c='red',linestyle='dashed')plt.legend(["Accuracy", "F1 Score"])plt.xlabel("K value")plt.ylabel("Score")plt.grid('false')plt.show()kNN_acc = max(f1_score_list)*100print("Maximum kNN Score is {:.2f}%".format(kNN_acc)8.结论当K=3时,F1分数达到89.86%,虽然K=7、8时也能达到88%,但是此时的F1分数不如k=3高。KNN算法在寻找最佳邻居时,要将余下所有的样本都遍历一遍,以确定谁和她最近,因此,如果数据量特别大,他的计算成本还是比较高的。=
-
 代码uent.pyimport numpy as npimport osimport skimage.io as ioimport skimage.transform as transimport numpy as npfrom tensorflow.keras.models import *from tensorflow.keras.layers import *from tensorflow.keras.optimizers import *from tensorflow.keras.callbacks import ModelCheckpoint, LearningRateSchedulerfrom tensorflow.keras import backend as kerasdef unet(pretrained_weights=None, input_size=(256, 256, 1)): inputs = Input(input_size) # 初始化keras张量 #第一层卷积 #实际上从unet的结构来看每一次卷积的padding应该是valid,也就是每次卷积后图片尺寸减少2, #但在这里为了避免裁剪,方便拼接,把padding设成了same,即每次卷积不会改变图片的尺寸。 conv1 = Conv2D(64, 3, activation='relu', padding='same', kernel_initializer='he_normal')(inputs) # filters:输出的维度 # kernel_size:卷积核的尺寸 # activation:激活函数 # padding:边缘填充,实际上在该实验中并没有严格按照unet网络结构进行卷积,same填充在卷积完毕之后图片大小并不会改变 # kernel_initializer:kernel权值初始化 conv1 = Conv2D(64, 3, activation='relu', padding='same', kernel_initializer='he_normal')(conv1) pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)#采用2*2的最大池化 #第二层卷积 #参数类似于第一层卷积,只是输出的通道数翻倍 conv2 = Conv2D(128, 3, activation='relu', padding='same', kernel_initializer='he_normal')(pool1) conv2 = Conv2D(128, 3, activation='relu', padding='same', kernel_initializer='he_normal')(conv2) pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #第三层卷积 conv3 = Conv2D(256, 3, activation='relu', padding='same', kernel_initializer='he_normal')(pool2) conv3 = Conv2D(256, 3, activation='relu', padding='same', kernel_initializer='he_normal')(conv3) pool3 = MaxPooling2D(pool_size=(2, 2))(conv3) #第四层卷积 conv4 = Conv2D(512, 3, activation='relu', padding='same', kernel_initializer='he_normal',dilation_rate=2)(pool3) conv4 = Conv2D(512, 3, activation='relu', padding='same', kernel_initializer='he_normal',dilation_rate=2)(conv4) drop4 = Dropout(0.5)(conv4) # 每次训练时随机忽略50%的神经元,减少过拟合 pool4 = MaxPooling2D(pool_size=(2, 2))(drop4) #第五层卷积 conv5 = Conv2D(1024, 3, activation='relu', padding='same', kernel_initializer='he_normal',dilation_rate=2)(pool4) conv5 = Conv2D(1024, 3, activation='relu', padding='same', kernel_initializer='he_normal',dilation_rate=2)(conv5) drop5 = Dropout(0.5)(conv5)# 每次训练时随机忽略50%的神经元,减少过拟合 #第一次反卷积 up6 = Conv2D(512, 2, activation='relu', padding='same', kernel_initializer='he_normal')( UpSampling2D(size=(2, 2))(drop5)) # 先上采样放大,在进行卷积操作,相当于转置卷积 # merge6 = merge([drop4, up6], mode='concat', concat_axis=3) #将第四层卷积完毕并进行Dropout操作后的结果drop4与反卷积后的up6进行拼接 merge6 = concatenate([drop4, up6], axis=3) # (width,heigth,channels)拼接通道数 conv6 = Conv2D(512, 3, activation='relu', padding='same', kernel_initializer='he_normal')(merge6) conv6 = Conv2D(512, 3, activation='relu', padding='same', kernel_initializer='he_normal')(conv6) #第二次反卷积 up7 = Conv2D(256, 2, activation='relu', padding='same', kernel_initializer='he_normal')( UpSampling2D(size=(2, 2))(conv6)) # merge7 = merge([conv3, up7], mode='concat', concat_axis=3) #将第三层卷积完毕后的结果conv3与反卷积后的up7进行拼接 merge7 = concatenate([conv3, up7], axis=3) conv7 = Conv2D(256, 3, activation='relu', padding='same', kernel_initializer='he_normal')(merge7) conv7 = Conv2D(256, 3, activation='relu', padding='same', kernel_initializer='he_normal')(conv7) #第三次反卷积 up8 = Conv2D(128, 2, activation='relu', padding='same', kernel_initializer='he_normal')( UpSampling2D(size=(2, 2))(conv7)) # merge8 = merge([conv2, up8], mode='concat', concat_axis=3) #将第二层卷积完毕后的结果conv2与反卷积后的up8进行拼接 merge8 = concatenate([conv2, up8], axis=3)#拼接通道数 conv8 = Conv2D(128, 3, activation='relu', padding='same', kernel_initializer='he_normal')(merge8) conv8 = Conv2D(128, 3, activation='relu', padding='same', kernel_initializer='he_normal')(conv8) #第四次反卷积 up9 = Conv2D(64, 2, activation='relu', padding='same', kernel_initializer='he_normal')( UpSampling2D(size=(2, 2))(conv8)) # merge9 = merge([conv1, up9], mode='concat', concat_axis=3) #将第一层卷积完毕后的结果conv1与反卷积后的up9进行拼接 merge9 = concatenate([conv1, up9], axis=3)#拼接通道数 conv9 = Conv2D(64, 3, activation='relu', padding='same', kernel_initializer='he_normal')(merge9) conv9 = Conv2D(64, 3, activation='relu', padding='same', kernel_initializer='he_normal')(conv9) conv9 = Conv2D(2, 3, activation='relu', padding='same', kernel_initializer='he_normal')(conv9) #进行一次卷积核为1*1的卷积操作,卷积完毕后通道数变为1,作为输出结果 conv10 = Conv2D(1, 1, activation='sigmoid')(conv9) model = Model(inputs=inputs, outputs=conv10) #keras内置函数,对模型进行编译 model.compile(optimizer=Adam(lr=1e-4), loss='binary_crossentropy', metrics=['accuracy']) # optimizer:优化器 # binary_crossentropy:与sigmoid相对应的损失函数 # metrics:评估模型在训练和测试时的性能的指标 if pretrained_weights: model.load_weights(pretrained_weights) return model
-
 循环神经网络(RNN) 循环神经网络(Recurrent Neural Network,RNN)是一类具有短期记忆能力的神经网络。在循环神经网络中,神经元不但可以接受其它神经元的信息,也可以接受自身的信息,形成具有环路的网络结构。 梯度爆炸和梯度消失 如果从数学的角度来理解,一般结构的循环神经网络中,网络的状态之间是非线性的关系,并且参数 w 在每个时间步共享,这是导致梯度爆炸和梯度消失的根本原因。 无论是梯度消失,还是梯度爆炸,都是技术实践上的bug,而不是理论上的 BUG首先需要明确的是,RNN 中的梯度消失/梯度爆炸和普通的 MLP 或者深层 CNN 中梯度消失/梯度爆炸的含义不一样。MLP/CNN 中不同的层有不同的参数,各是各的梯度;而 RNN 中同样的权重在各个时间步共享,最终的梯度 g=各个时间步的梯度 gt的和。RNN 中总的梯度是不会消失的。即便梯度越传越弱,那也只是远距离的梯度消失,由于近距离的梯度不会消失,所有梯度之和便不会消失。RNN 所谓梯度消失的真正含义是,梯度被近距离梯度主导,导致模型难以学到远距离的依赖关系。梯度爆炸从技术上相比梯度消失更好解决,因此,很少有人大篇幅去论证这个问题。梯度爆炸最常用的解决方案是梯度截断:逐元素的截断参数梯度和截断梯度的范数。第二种方案可以确保截断后的梯度仍然是在正确的梯度方向上。但是实践表明:两种方式的效果相近。因为逐元素的梯度截断时,梯度更新的方向不仅不再是真实梯度方向,甚至也不是 mini-batch 的梯度方向。但是它仍然是一个使得目标值下降的方向。长程依赖问题 虽然简单循环网络理论上可以建立长时间间隔的状态之间的依赖关系,但是由于梯度爆炸或消失问题,实际上只能学习到短期的依赖关系。这样,如果时刻 t的输出yt依赖于时刻k的输入 xk,当间隔t-k比较大时,简单神经网络很难建模这种长距离的依赖关系,称为长程依赖问题(Long-Term Dependencies Problem)。 LSTM 为了改善循环神经网络的长程依赖问题,一种非常好的解决方案是引入门控机制来控制信息的累积速度,包括有选择地加入新的信息和有选择地遗忘之前累积的信息。 长短期记忆(Long Short-Term Memory,LSTM)网络[Gers 等人; Hochreiter 等人,2000; 1997] 是循环神经网络的一个变体,可以有效地解决简单循环神经网络的梯度爆炸或消失问题。 与传统的 RNN 相比,LSTM 依然是基于循环机制,只不过对内部的结果进行了更加精细的设计。LSTM 中梯度的传播有很多条路径,关键在于穿过记忆单元的状态 的路径,其上面只有一些少量的线**互(逐元素乘法和加法),梯度流最稳定,信息在上面流动保持不变会变得容易。 但是其他路径上梯度流与普通 RNN 类似,照样会发生相同的权重矩阵反复连乘,所以依然会爆炸或者消失。由于总的远距离梯度 = 各条路径的远距离梯度之和,即便其他远距离路径梯度消失了,只要保证有一条远距离路径(就是上面说的那条路径)梯度不消失,总的远距离梯度就不会消失(正常梯度 + 消失梯度 = 正常梯度)。因此 LSTM 通过改善一条路径上的梯度问题拯救了总体的远距离梯度。
-
强化学习在高维经济学问题中的应用前面介绍的是深度学习在经济学领域的应用。对比传统的深度学习,深度强化学习能够有效处理高维问题。所以,在一些包含高维动态数据的经济学问题上,深度强化学习表现更加优秀。1、深度强化学习下的股票交易由于缺乏处理高维问题的能力,传统强化学习方法不足以找到最佳策略。下面是深度强化学习的最新研究。有使用深度确定性政策梯度(DDPG)算法作为一种替代方案来探索动态股票市场中的最优策略。算法处理较大的动作状态空间,兼顾了稳定性,消除了样本相关性,提高了数据利用率。也有人设计了一种新的自适应深度确定性强化学习框架(Adaptive DDPG),用于在动态复杂的股票市场中发现最优策略。该模型结合了乐观和悲观的Deep RL(optimistic and pessimistic Deep RL),既依赖于负的预测误差,也依赖于正的预测误差。还有为了分析股票决策机制的多种算法,在深度RL中进行了调查研究。他们基于DQN、Double DQN和Dueling DQN三个经典模型的实验结果表明,其中DQN模型可以获得更好的投资策略。另外,这项研究还应用实证数据对模型进行了验证。专注于使用深度强化学习实现证券交易中的自动振荡,其中他们使用递归卷积神经网络(RCNN)方法从经济新闻中预测股票价值。2、深度强化学习下的投资组合管理 [118]采用了不同的强化学习方法,例如DDPG方法、最近策略优化(PPO)方法和PG方法。这些方法能够获得与连续行动空间中的金融投资组合相关的策略。他们结合中国资产市场对模型在不同环境下的表现进行了比较,结果表明PG模型在股票交易中比其他两种模型更有利。本研究还提出了一种新颖的对抗性训练方法,能够提高训练效率和平均回报。有研究设计了无模型卷积神经网络(model-less RNN),其中输入是来自加密货币交易所的历史资产价格,目的是产生一组投资组合权重。也有研究通过充分利用DPG方法来引入奖励函数,以优化累积收益。模型包含了独立评估器集成拓扑结构( Independent Evaluators topology),在权值分担方面结合了大的神经网络集。另外,为防止梯度损坏,还采用了投资组合矢量存储器(Portfolio Vector Memory)。在自动交易的意义上设计了一种新的基于模型的深度强化学习方案,能够采取行动并做出与全局目标相关的顺序决策。该模型体系结构包括注入预测模块(IPM)、生成性对抗性数据增强模块(DAM)和行为克隆模块(BCM),能够用于处理设计的回溯测试。转自,蒋宝尚,https://www.leiphone.com/category/academic/rFDeS2HfFBnXYN7K.html
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签