-
 一、幻读的定义 幻读是什么 同一事务中,对同一条件进行多次查询,由于在多次查询的过程中 其他事务对数据进行插入或则删除操作,导致获取的数据不一致。就像出现了 幻觉一样。 举一个例子: 事务T1的查询: SELECT * FROM products WHERE price > 100; 返回一组商品记录,这时事务T1还未提交。 事务T2的插入: 在T1查询之后,另一个事务T2插入了一些新的商品,它们的价格也大于100。 事务T1的再次查询: T1再次执行 SELECT * FROM products WHERE price > 100;,此时它返回的结果集比第一次查询更大,因为T2插入的新商品也满足条件。 幻读的产生原因 原因: 1.事务的隔离级别太低了导致 2.对表进行了行的插入和行的删除操作 二、 解决幻读 方案一 提高隔离级别 将事务隔离级别提升到SERIALIZABLE,但是这种方案正如名字一样 串行化,就是让多个事务穿行的执行。这种方式虽然可以解决幻读问 题,但是效率太低了,一般不推荐使用。 方案二 MVCC和next-key lock MVCC的定义: MVCC 是一种并发控制机制,用于在多个并发事务同时读写数据库时 保持数据的一致性和隔离性。它是通过在每个数据行上维护多个版本 的数据来实现的。当一个事务要对数据库中的数据进行修改时, MVCC 会为该事务创建一个数据快照,而不是直接修改实际的数据 行。 通俗一点说,对数据进行修改时,数据库并不会删除以前的数据,而是将数据保存起来,以实现对旧数访问。数据的保存,其实是基于undo log并不是保存真正的数据。至于为什么这么做,第一,通过对数据的undo操作,我们也能拿到数据。第二,这种方式可以为我们节约大量的内存,也不必为了维护以前的数据额外花费其他资源,因为数据库原本就保存了undo log,只需要通过一个字段保存该行undo log的地址。 下图就是MVCC中,数据库维护行MVCC中行数据的多版本维护。每一条数据都有一个回滚指针(DB_ROLL_PTR)用来记录回归日志的地址。 InnoDB实现MVCC: 离不开read view, undo log,隐藏字段这三个属性 名称 作用 结构 read view 开启事务时生成,用来记录当前事务的事务id,判断事务是否对当前事务可见 m_low_limit_id:大于等于这个 ID 的事务均不可见 m_up_limit_id: 小于这个 ID 的事务均可见 m_creator_trx_id:创建该 Read View 的事务ID m_low_limit_no:事务 Number, 小于该 Number 的 Undo Logs 均可以被 Purge m_ids: 创建 Read View 时的活跃事务列表,不包括当前事务 如下图1-3 undo log 当事务不可见时,通过readview和隐藏字段找到可见事务的事务id,并通过undo log生成可见事务的行数据 隐藏字段 InnoDB存储引擎为每行添加的,用来维护行的多个版本数据 DB_TRX_ID(6字节):表示最后一次插入或更新该行的事务 id。 DB_ROLL_PTR(7字节) 回滚指针 ,指向该行的 undo log 。如果该行未被更新,则为空 DB_ROW_ID(6字节) 如果没有设置主键且该表没有唯一非空索引时,InnoDB 会使用该 id 来生成聚簇索引 图1-3 数据可见性算法: 在讲算法之前,我先来梳理一下readview各个字段是如何创建的. 数据库系统首先会找到当前处于活跃事务,并将他们的id记录在m_ids中,然后根据m_ids中的id来生成m_low_limit_id(大于m_ids中最大值+1)和m_up_limit_id(小于m_ids中最小值)。至于m_creator_trx_id字段,在开启事务时,系统就为该事务生成了一个事务id。 如果记录 DB_TRX_ID < m_up_limit_id,那么表明最新修改该行的事务(DB_TRX_ID)在当前事务创建快照之前就提交了,所以该记录行的值对当前事务是可见的。 如果 DB_TRX_ID >= m_low_limit_id,那么表明最新修改该行的事务(DB_TRX_ID)在当前事务创建快照之后才修改该行,所以该记录行的值对当前事务不可见。跳到步骤 5 m_ids 为空,则表明在当前事务创建快照之前,修改该行的事务就已经提交了,所以该记录行的值对当前事务是可见的 如果 m_up_limit_id <= DB_TRX_ID < m_low_limit_id,表明最新修改该行的事务(DB_TRX_ID)在当前事务创建快照的时候可能处于“活动状态”或者“已提交状态”;所以就要对活跃事务列表 m_ids 进行查找(源码中是用的二分查找,因为是有序的) 如果在活跃事务列表 m_ids 中能找到 DB_TRX_ID,表明:① 在当前事务创建快照前,该记录行的值被事务 ID 为 DB_TRX_ID 的事务修改了,但没有提交;或者 ② 在当前事务创建快照后,该记录行的值被事务 ID 为 DB_TRX_ID 的事务修改了。这些情况下,这个记录行的值对当前事务都是不可见的。跳到步骤 5 在活跃事务列表中找不到,则表明“id 为 trx_id 的事务”在修改“该记录行的值”后,在“当前事务”创建快照前就已经提交了,所以记录行对当前事务可见 在该记录行的 DB_ROLL_PTR 指针所指向的 undo log 取出快照记录,用快照记录的 DB_TRX_ID 跳到步骤 1 重新开始判断,直到找到满足的快照版本或返回空 举个例子: 如上图, 1.假设当前处于T4时刻,103事务会生成一个read view,当前的事务id为事务103,此时该事务的m_ids为[101,102],因此m_low_limit_id = 104 ,则 m_up_limit_id = 101,m_creator_trx_id =103 2.根据上面的表格,T4时刻时,103事务查询id=1的所有行(一般幻读是根据相同的条件查出了不一样的结果)。但是此时数据最新的修改者101,因此DB_TRX_ID 为 101。因为m_up_limit_id <= 101 < m_low_limit_id,所以要在 m_ids 列表中查找,发现 DB_TRX_ID 存在列表中,那么这个记录不可见。 3.根据 DB_ROLL_PTR 找到 undo log 中的上一版本记录,上一条记录的 DB_TRX_ID 还是 101,不可见 4.直到找到可见的版本,如果此时行的DB_TRX_ID小于m_up_limit_id,那么就找到了可读的行数据。 如何解决幻读: 回归正题,MVCC分为两种模式,一种是读当前(读取最新的数据),例如: select…for update/lock in share mode、insert、update、delete。另一种是非锁定(不用读取最新的数据),例如普通的select。 对于第二种,读取的并非最新数据,我们通过在事务开始生成一个快照,后面一直使用这个快照,就能解决幻读,不需要额外的操作 对于第一种,由于每次都是读当前,会导致一直生成新的快照。当有行数据插入或则删除时并且在查询范围之内,就会造成幻读的现象。解决办法:行锁+间隙锁。当执行当前读时,会锁定读取到的记录的同时,锁定它们的间隙,防止其它事务在查询范围内插入数据。只要我不让你插入,就不会发生幻读。 ———————————————— 原文链接:https://blog.csdn.net/qq_44644452/article/details/134744829
-
事务特性(ACID) 原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)、持久性(Durability) 概念 脏读 读取了其他事务未提交的数据。未提交意味着这些数据有可能回滚,不插入数据库,也就是不存在的数据。读取数据库不存在的数据,就是脏读。 可重复读 在一个事务内,事务开始和事务结束前不同时刻读取的同一批是一致的,通常针对数据更新操作。 不可重复读 在同一事务内读取的同一批数据可能不一致,受其他事务影响,比如其他事务修改了这批数据并且提交了,通常针对更新操作。 幻读 幻读是针对数据插入操作来说的。比如A事务修改了数据但是还未提交,但是B事务插入了A事务修改前相同的数据,且B事务在A事务之前提交了,这样A事务再去读这批数据,感觉没有更新成功,实际上是B事务插入的数据,感觉出现幻觉。 隔离级别 1.读取未提交(READ UNCOMMITTED) 2.读取已提交(READ COMMITTED) 3.可重复读(REPEATABLE READ) 4.可串行化(SERIALIZABLE) 从上往下,隔离强度逐渐增强,性能逐渐变差 对于MySQL InnoDB 存储引擎的默认支持的隔离级别是 REPEATABLE-READ(可重复读) 设置隔离级别 -- 查看隔离级别 版本5.7.20 之后 show variables like '%iso%' SELECT @@GLOBAL.tx_isolation; SELECT @@SESSION.tx_isolation; -- 设置隔离级别 set [作用域] transaction isolation level [事务隔离级别] -- 其中作用域可以是 SESSION 或者 GLOBAL,GLOBAL 是全局的,而 SESSION 只针对当前回话窗口 -- 隔离级别是 READ UNCOMMITTED、READ COMMITTED、REPEATABLE READ、SERIALIZABLE set global transaction isolation level read committed; -- 设置完成后,只对之后新起的 session 才起作用,对已经启动 session 无效。如果用 shell 客户端那就要重新连接 MySQL,如果用 Navicat 那就要创建新的查询窗口 隔离级别解释 1.读取未提交(READ UNCOMMITTED) 其实就是可以读到其他事务未提交的数据。 启动两个事务,分别为事务A和事务B,在事务A中使用 update 语句,修改 age 的值为10,初始是 1 ,在执行完 update 语句之后,在事务B中查询 user 表,会看到 age 的值已经是 10 了,这时候 事 务A还没有提交,而此时事务B有可能拿着已经修改过的 age=10 去进行其他操作了。在事务B进 行操作的过程中,很有可能事务A由于某些原因,进行了事务回滚操作,那其实事务B得到的就是脏 数据了,拿着脏数据去进行其他的计算,那结果肯定也是有问题的 2.读提交 在事务A中使用 update 语句将 id=1 的记录行 age 字段改为 10。此时,在事务B中使用 select 语句进行查询,我们发现在事务A提交之前,事务B中查询到的记录 age 一直是1,直到事务A提交,此时在事务B中 select 查询,发现 age 的值已经是 10 了。 3.可重复读 B事务读取数据,A事务更新了数据也提交了,A事务再去读取数据还是跟之前数据一样。 这只是针对已有行的更改操作有效,但是对于新插入的行记录,就会出现幻读。 可重复读隔离级别出现幻读 A事务更新数据,在更新完数据之后B事务插入一条与A事务修改之前相同的数据,B事务提交之后,事务A查询数据发现多出一行,而且是A事务自己更新之前的数据。 4.串行化 串行化是4种事务隔离级别中隔离效果最好的,但是效果最差,它将事务的执行变为顺序执行,与其他三个隔离级别相比,它就相当于单线程,后一个事务的执行必须等待前一个事务结束 MySQL 中是如何实现事务隔离的 首先说读未提交,它是性能最好,也可以说它是最野蛮的方式,因为它压根儿就不加锁,所以根本谈不上什么隔离效果,可以理解为没有隔离。 再来说串行化。读的时候加共享锁,也就是其他事务可以并发读,但是不能写。写的时候加排它锁,其他事务不能并发写也不能并发读。 最后说读提交和可重复读。这两种隔离级别是比较复杂的,既要允许一定的并发,又想要兼顾的解决问题。 实现可重复读 MySQL 采用了 MVVC (多版本并发控制) 的方式。 可重复读是在事务开始的时候生成一个当前事务全局性的快照,而读提交则是每次执行语句的时候都重新生成一次快照 并发写问题 A执行 update 操作, update 的时候要对所修改的行加行锁,这个行锁会在提交之后才释放。而在事务A提交之前,事务B也想 update 这行数据,于是申请行锁,但是由于已经被事务A占有,事务B是申请不到的,此时,事务B就会一直处于等待状态,直到事务A提交,事务B才能继续执行,如果事务A的时间太长,那么事务B很有可能出现超时异常 加锁的过程要分有索引和无索引两种情况: 有索引的情况,那么 MySQL 直接就在索引数中找到了这行数据,加上行锁。 无索引的情况,MySQL 无法直接定位到这行数据,会为这张表中所有行加行锁,MySQL 会进行一遍过滤,发现不满足的行就释放锁,最终只留下符合条件的行。虽然最终只为符合条件的行加了锁,但是这一锁一释放的过程对性能也是影响极大的。所以,如果是大表的话,建议合理设计索引,如果真的出现这种情况,那很难保证并发度。 解决幻读 解决幻读用的也是锁,叫做间隙锁,MySQL 把行锁和间隙锁合并在一起,解决了并发写和幻读的问题,这个锁叫做 Next-Key锁。 假设现在表中有两条记录,并且 age 字段已经添加了索引,两条记录 age 的值分别为 10 和 30。 此时,在数据库中会为索引维护一套B+树,用来快速定位行记录。B+索引树是有序的,所以会把这张表的索引分割成几个区间。 分成了3 个区间,(负无穷,10]、(10,30]、(30,正无穷],在这3个区间是可以加间隙锁的。 之后,我用下面的两个事务演示一下加锁过程。 在事务A提交之前,事务B的插入操作只能等待,这就是间隙锁起得作用。当事务A执行update user set name='风筝2号’ where age = 10; 的时候,由于条件 where age = 10 ,数据库不仅在 age =10 的行上添加了行锁,而且在这条记录的两边,也就是(负无穷,10]、(10,30]这两个区间加了间隙锁,从而导致事务B插入操作无法完成,只能等待事务A提交。不仅插入 age = 10 的记录需要等待事务A提交,age<10、10<age<30 的记录页无法完成,而大于等于30的记录则不受影响,这足以解决幻读问题了。 这是有索引的情况,如果 age 不是索引列,那么数据库会为整个表加上间隙锁。所以,如果是没有索引的话,不管 age 是否大于等于30,都要等待事务A提交才可以成功插入。 ———————————————— 原文链接:https://blog.csdn.net/qq_38803590/article/details/129137108
-
 mysql版本是8.0的。opengauss版本是6.0.0的,使用的工具是portal
-
 1.前言一条sql语句到底在执行时经历了什么?探究这个问题是学习mysql的重要步骤,面试时常被问到,也使得学习mysql时也有了知识框架的支撑,明白我们背的知识点到底用在哪里,笔者觉得这一点还是很重要的。注:对一个知识点的总结不仅包含知识点本身,还包含对该知识点的联想,这个联想是在面试时可能被追问的,也可以自己主动说出来(我还知道。。。)加分的。2.知识点MySQL 执行流程是怎样的?首先要知道的是,我们可以把mysql分成两层,server层和数据库引擎层,前者主要是对我们的查询进行处理(主要包括 {连接器},{查询缓存}、{解析器}、{预处理器、优化器、执行器} 等),后者是数据真正存储的地方(从 MySQL 5.5 版本开始, InnoDB 成为了 MySQL 的默认存储引擎)。一条查询的执行流程如下:第一步:通过连接器连接 MySQL 服务1mysql -h$ip -u$user -p[连接器联想1]: 连接经过TCP 三次握手,断开经过四次挥手[连接器联想2]: 如果用户密码都没有问题,连接器就会获取该用户的权限,然后保存起来,后续该用户在此连接里的任何操作,都会基于连接开始时读到的权限进行权限逻辑的判断,意思是管理员修改已登录用户的权限需要等他重新登录才生效[连接器联想3]: 如何查看 MySQL 服务被多少个客户端连接了?show processlist[连接器联想4]: 空闲连接会一直占用着吗?MySQL 定义了空闲连接的最大空闲时长,由 wait_timeout 参数控制的,默认值是 8 小时(28880秒),如果空闲连接超过了这个时间,连接器就会自动将它断开。[连接器联想5]: MySQL 的连接数有限制吗?最大连接数由 max_connections 参数控制,超过这个值,系统就会拒绝接下来的连接请求,并报错提示“Too many connections”。[连接器联想6]: 怎么解决长连接占用内存的问题?MySQL 的连接也跟 HTTP 一样,有短连接和长连接的概念,长连接的好处就是可以减少建立连接和断开连接的过程,但是,使用长连接后可能会占用内存增多,因为 MySQL 在执行查询过程中临时使用内存管理连接对象,这些连接对象资源只有在连接断开时才会释放。有两种解决方式。第一种,定期断开长连接。第二种,客户端主动重置连接。MySQL 5.7 版本实现了 mysql_reset_connection() 函数的接口来重置连接,达到释放内存的效果。这个过程不需要重连和重新做权限验证,但是会将连接恢复到刚刚创建完时的状态。[连接器联想7]: 连接器的工作?与客户端进行 TCP 三次握手建立连接;校验客户端的用户名和密码,如果用户名或密码不对,则会报错;如果用户名和密码都对了,会读取该用户的权限,然后后面的权限逻辑判断都基于此时读取到的权限;第二步:查询缓存连接器得工作完成后,客户端就可以向 MySQL 服务发送 SQL 语句了,MySQL 服务收到 SQL 语句后,就会解析出 SQL 语句的第一个字段,看看是什么类型的语句。如果 SQL 是查询语句(select 语句),MySQL 就会先去查询缓存( Query Cache )里查找缓存数据。但是其实查询缓存挺鸡肋的。对于更新比较频繁的表,查询缓存的命中率很低的,因为只要一个表有更新操作,那么这个表的查询缓存就会被清空。所以,MySQL 8.0 版本直接将server层查询缓存删掉了。第三步:解析SQL在正式执行 SQL 查询语句之前, MySQL 会先对 SQL 语句做解析,这个工作交由「解析器」来完成。解析器会做两件事情:词法分析、 语法分析。[解释器联想1]: 词法分析:MySQL 会根据你输入的字符串识别出关键字出来,例如,SQL语句 select username from userinfo,在分析之后,会得到4个Token,其中有2个Keyword,分别为select和from.[解释器联想2]: 语法分析:根据词法分析的结果,语法解析器会根据语法规则,判断你输入的这个 SQL 语句是否满足 MySQL 语法,如果没问题就会构建出 SQL 语法树,这样方便后面模块获取 SQL 类型、表名、字段名、 where 条件等等。[解释器联想3]: 解如果我们输入的 SQL 语句语法不对,就会在解析器这个阶段报错。(释器的主要作用)[解释器联想4]: 解释器只负责检查语法和构建语法树,但是不会去查表或者字段存不存在。第四步:执行 SQL解析SQL无误后,执行SQL需要经过三个步骤:预处理器、优化器、执行器。预处理器检查 SQL 查询语句中的表或者字段是否存在;将 select * 中的 * 符号,扩展为表上的所有列;优化器优化器主要负责将 SQL 查询语句的执行计划确定下来,比如在表里面有多个索引的时候,优化器会基于查询成本的考虑,来决定选择使用哪个索引。[优化器联想1]: 要想知道优化器选择了哪个索引,我们可以在查询语句最前面加个 explain 命令,这样就会输出这条 SQL 语句的执行计划。explain select * from product where id = 1[优化器联想2]: 一般来讲普通索引查询效率高于主键索引,当索引覆盖时会先考虑普通索引的B+树上查询,这就是执行计划,是优化器决定的。执行器确定了执行计划,接下来 MySQL 就真正开始执行语句了,在执行的过程中,执行器就会和存储引擎交互了,交互是以记录为单位的。主键索引查询 select * from product where id = 1; 让InnoDB引擎通过主键索引B+树搜索id=1的记录。全表扫描 select * from product where name = 'iphone'; 查询条件没有用到索引,触发全表扫描,查询每一条记录判断是否满足条件。索引下推 (MySQL 5.6 推出的查询优化策略)[索引下推联想1]: 索引下推能够减少二级索引在查询时的回表操作,提高查询的效率,因为它将 Server 层部分负责的事情,交给存储引擎层去处理了。select * from t_user where age > 20 and reward = 100000;不使用索引下推(MySQL 5.6 之前的版本)时,定位到 age > 20 的一条记录,获取主键值,然后进行回表操作,将完整的记录返回给 Server 层,Server 层再判断该记录的 reward 是否等于 100000。而使用索引下推后,判断记录的 reward 是否等于 100000 的工作交给了存储引擎层:定位到 age > 20 的第一条记录,存储引擎定位到二级索引后,先不执行回表操作,而是先判断一下该索引中包含的列(reward列)的条件(reward 是否等于 100000)是否成立。如果条件不成立,则直接跳过该二级索引。如果成立,则执行回表操作,将完成记录返回给 Server 层。MySQL 执行流程是怎样的?总结:(总结只是简单总结,也就是被问到时该说的,上面的知识点,是可能被追问时涉及的,或者自己说出来的加分项。)连接器:建立连接,管理连接、校验用户身份;查询缓存:查询语句如果命中查询缓存则直接返回,否则继续往下执行。MySQL 8.0 已删除该模块;解析 SQL,通过解析器对 SQL 查询语句进行词法分析、语法分析,然后构建语法树,方便后续模块读取表名、字段、语句类型;执行 SQL:执行 SQL 共有三个阶段:预处理阶段:检查表或字段是否存在;将 select * 中的 * 符号扩展为表上的所有列。优化阶段:基于查询成本的考虑, 选择查询成本最小的执行计划;执行阶段:根据执行计划执行 SQL 查询语句,从存储引擎读取记录,返回给客户端;
-
背景: 我们对数据库操作时常常有这种需求:如果不存在该记录则新增,存在则更新! 传统的思路:先select判断是否存在,再选择insert或者update,这样的话步骤较多。 为了解决这种需求,mysql提供了两种常用的关键字方法:replace into 与 insert into … on duplicate key update,现在我们测试下这两种方法吧! 一、replace into 测试分析 介绍: replace into 跟 insert 功能类似,不同点在于:replace into 首先尝试插入数据到表中, 1. 如果发现表中已经有此行数据(根据主键或者唯一索引判断)则先删除此行数据,然后插入新的数据。 2. 否则,直接插入新数据。 要注意的是:插入数据的表必须有主键或者是唯一索引!否则的话,replace into 会直接插入数据,这将导致表中出现重复的数据。 准备测试表: CREATE TABLE `customer` ( `id` int(11) NOT NULL AUTO_INCREMENT, `name` varchar(20) DEFAULT NULL, `phone` varchar(20) DEFAULT NULL, `data` varchar(100) DEFAULT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB AUTO_INCREMENT=14 DEFAULT CHARSET=utf8 注:id字段为自增主键 插入基础数据: INSERT INTO customer(NAME,phone,DATA) VALUES("小一","17610111111","1") INSERT INTO customer(NAME,phone,DATA) VALUES("小二","17610111112","2") 测试1: replace into 一条数据(不含主键) REPLACE INTO customer(NAME,phone,DATA) VALUES("小三","17610111113","3") 结论:由于插入数据不包含主键或唯一索引,则判断该条数据不存在,此时效果等同于insert into 测试2: replace into 一条数据(含主键) REPLACE INTO customer(id,NAME,phone,DATA) VALUES(2,"小四","17610111114","4") 注:共2行收到影响,即先删除再新增! 结论: 插入数据中存在已存在主键:id=2,则判断该条数据已存在,故先删除再新增(即更新) 测试3: replace into 的数据中减少一个字段:data REPLACE INTO customer(id,NAME,phone) VALUES(2,"小五","17610111115") 结论: replace into 的数据中如果比原数据少字段,则该字段更新时恢复为默认值(此处默认为NULL)。故可以确定replace into 删除已存在记录时,很彻底,没有做备份,之后直接新增replace into 后面确定的数据,没有值的字段设为默认值。 注:这点就和 insert into … on duplicate key update 不同了! 测试4: insert into 2条数据,看主键id是否有变化 INSERT INTO customer(NAME,phone,DATA) VALUES("小六","17610111116","6") INSERT INTO customer(NAME,phone,DATA) VALUES("小七","17610111117","7") 结论: 虽然第二条记录做了2次 replace into 操作,但后面新增数据时主键id 并没有+1,那问题来了,网上说的主键+1是什么时候发生的呢? 测试5: 我们将name字段设置 unique索引,再replace into 这次语句中没有涉及主键id,为了判断记录存在性,所以我们为name设置了unique索引(此时根据name判断记录是否存在) REPLACE INTO customer(NAME,phone,DATA) VALUES("小七","17610111118","8") 结论: 上一个测试主键没有变化的原因是我们在replace into 的数据中设置了确切的主键(相当于固定住了),而现在我们没有设置主键,故主键自增+1,此处需要注意! 测试6: 为name + phone字段设置 unique联合索引(后面测试都这样设置) 此时是根据 name + phone判断记录存在性! REPLACE INTO customer(NAME,phone,DATA) VALUES("小七","17610111119","9") REPLACE INTO customer(NAME,phone,DATA) VALUES("小七","17610111119","10") 结论: 此时存在,故更新data(9 -> 10),同时主键id也+1 测试7: 在name+phone为联合索引情况下去除phone字段再replace into REPLACE INTO customer(NAME,DATA) VALUES("小七","11") REPLACE INTO customer(NAME,DATA) VALUES("小七","11") 结论: 由于没加phone字段,数据库无法判断存在性,故默认不存在,即新增2条记录,phone默认为NULL。 此处特别说明:在MYSQL中UNIQUE索引将会对null字段失效,故这两条记录能同时存在不报错! 二、insert into … on duplicate key update 测试分析 注:接着上面的测试继续 测试8: INSERT INTO customer(NAME,phone,DATA) VALUES("小八","17610111118","8") ON DUPLICATE KEY UPDATE DATA = "88" 结论:此时根据 name + phone 判断出数据库不存在该记录,故新增,等同于直接 insert into,ON DUPLICATE KEY UPDATE DATA = "88" 无效! 测试9: INSERT INTO customer(NAME,phone,DATA) VALUES("小八","17610111118","9") ON DUPLICATE KEY UPDATE DATA = "99" 结论: 此时判断存在,更新data数据为99,这个没啥问题。但和replace into 不同的是,主键id竟然没有+1,依旧是11… 测试10: 简单insert into,接着上面测试主键+1问题 INSERT INTO customer(NAME,phone,DATA) VALUES("小九","17610111119","9") 结论: 发现这里新增时,主键id才额外+1,这一点确实和replace into 不一样,可以和之前的测试对比看下! 测试11: 继续测试主键+1问题 INSERT INTO customer(id,NAME,phone,DATA) VALUES("13","小九","17610111119","10") ON DUPLICATE KEY UPDATE DATA = "100" INSERT INTO customer(NAME,phone,DATA) VALUES("小十","17610111110","10") 结论: 如果新增数据中设置了确切的主键,则再insert into 时主键并没有额外+1 三、结论 区别 1:(主要) insert .. on deplicate udpate保留了所有字段的旧值,再覆盖然后一起insert进去,而replace into没有保留旧值,直接删除再insert新值。 从底层执行效率上来讲,replace into要比insert .. on deplicate update效率要高,但是在写replace的时候,字段要写全,防止老的字段数据被删除。 区别 2: 两个主键自增的场景有稍许不同,详情见以上测试 ———————————————— 原文链接:https://blog.csdn.net/Abysscarry/article/details/80518278
-
在往表里面插入数据的时候,经常需要:a.先判断数据是否存在于库里面;b.不存在则插入;c.存在则更新一、replace into 前提:数据库里面必须有主键或唯一索引,不然replace into 会直接插入新数据,导致数据表里面有重复数据 执行时先尝试插入数据: a.当数据表里面存在(通过主键或唯一索引来判断)该数据,则先将表里的数据删除,再插入新的数据 b.如果数据表里面不存在该数据,则直接插入数据 replace into是insert into的增强版,语法跟insert iton差不多 replace into table_name(columns)values(values1,values2); replace into table_name(columns) select columns from table_name2 测试数据(该表建立了一个复合的唯一索引user_add): CREATE TABLE `relace_on` ( `id` int(11) unsigned NOT NULL AUTO_INCREMENT, `user_id` int(11) unsigned NOT NULL, `interal` tinyint(3) unsigned NOT NULL, `add_time` date NOT NULL, PRIMARY KEY (`id`), UNIQUE KEY `user_add` (`user_id`,`add_time`) USING BTREE ) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=latin1; 插入测试数据: INSERT INTO relace_on (user_id, interal, add_time) VALUES (1,20,'2016-05-06'), (2,20,'2016-05-06'), (3,20,'2016-05-06'), (1,20,'2016-05-07'), (2,20,'2016-05-07'), (3,20,'2016-05-07') 现在数据库数据: 接下来执行一下replace into语句(存在):replace INTO relace_on(user_id, interal, add_time)values(1,40,'2016-05-06'),(2,60,'2016-05-06'),(3,80,'2016-05-06') 此时sql执行成功,受影响行数为6行(删除三条,插入三条) 对比一下你会发现user_id(1,2,3)的账户在2016-05-06这一天原先都是有数据的,并且id为(1,2,3);现在执行了replace into后,id变成了(7,8,9),并且interal字段的值为执行语句的值,此时replace into语句根据数据表中的user_add这个复合的唯一索引发现在数据表中user_id为(1,2,3)的用户在2016-05-06这天各存在一条记录,这时就把原先的三条数据删除了,重新插入了三条,所以id从1,2,3变成了7,8,9;并且interal的值也变了 接下来执行一下replace into语句(不存在):replace INTO relace_on(user_id, interal, add_time)values(4,40,'2016-05-06'),(5,60,'2016-05-06'),(6,80,'2016-05-06') 此时sql执行成功,受影响行数为3行(插入三条) 对比上图,你会发现原先的数据没变,只是新增了三条数据,同样是2016-05-06这天的,但是user_id是(4,5,6)根据user_add这个复合的唯一索引,这三条数据不存在数据表中,所以直接插入即可 二、on duplicate key update 它也是可以用于更新数据的,跟replace into有点相似,但是on duplicate key update是数据表里面存在该数据就更新,不存在则插入,;而replace into则是存在就删除,再插入,不存在则插入 依旧使用上面现有的数据来测试: 先添加一个字段,用于等下更新多个字段之用:ALTER TABLE `relace_on` ADD COLUMN `copy_interal` tinyint(3) UNSIGNED NOT NULL AFTER `interal`; 语法: 更新单个字段:insert into table_name(columns)values(values1,values2) on duplicate key update column=values(column)或者column=value(1,'zgw') 更新多个字段:insert into table_name(columns)values(values1,values2) on duplicate key update column1=values(column1),column2=values(column2) 执行一条语句(存在):insert into relace_on(user_id, interal,copy_interal, add_time)values(6,100,200,'2016-05-06') on duplicate KEY update interal=values(interal),copy_interal=values(copy_interal) 如图,user_id=6,add_time='2016-05-06'这条数据存在,则更新interal和copy_interal两个字段的值(interal原先为80,copy_interal新增字段默认为0) 再次执行一条语句(不存在):insert into relace_on(user_id, interal,copy_interal, add_time)values(7,100,200,'2016-05-06') on duplicate KEY update interal=values(interal),copy_interal=values(copy_interal)原文链接:https://blog.csdn.net/txqd1989/article/details/83832352
-
ON DUPLICATE KEY UPDATE 子句和 REPLACE INTO 语句都是 MySQL 提供的用于处理数据插入时的冲突解决策略,但它们在处理方式和效果上有着本质的区别: ON DUPLICATE KEY UPDATE 操作流程:当尝试插入一条新记录时,如果该记录的主键或唯一索引与现有记录冲突,ON DUPLICATE KEY UPDATE 子句将触发,并执行更新操作,而不是插入新记录。只有冲突的行会被更新,不会影响到其他行。 数据处理:它允许你指定哪些列需要在冲突发生时进行更新,以及如何更新这些列的值。这意味着你可以只修改部分字段而保留其他字段的原有值。 资源消耗:由于它不涉及记录的删除,所以在处理冲突时相对节省资源。但如果更新涉及大量字段或并发操作,可能会影响性能。 适用场景:适合于需要在插入时检查记录是否存在,并根据情况更新某些字段的场景,如统计计数、用户信息更新等。 REPLACE INTO 操作流程:REPLACE INTO 在尝试插入新记录时,如果发现主键或唯一索引冲突,它会先删除原有的冲突行,然后插入新的记录。这实质上是“删除+插入”的操作。 数据处理:整个记录会被替换,不仅仅是冲突的字段,这意味着如果新记录没有指定某些字段的值,这些字段将使用默认值或NULL(如果没有默认值)。原有的行数据将完全被新数据覆盖。 资源消耗:相比 ON DUPLICATE KEY UPDATE,REPLACE INTO 可能会消耗更多的资源,因为它涉及到删除旧记录和插入新记录两个操作,特别是在处理大表时可能会影响性能。 适用场景:适用于需要确保每个唯一键对应的记录完全替换的场景,例如,当需要确保数据的绝对新鲜性,不关心被替换记录的其他字段值时。 总结: 数据保留性:ON DUPLICATE KEY UPDATE 保留了原有记录中未被更新字段的值,而 REPLACE INTO 则会替换整行数据。 资源和性能:ON DUPLICATE KEY UPDATE 在处理冲突时较为轻量,而 REPLACE INTO 可能会因涉及删除和插入而消耗更多资源。 应用场景:根据是否需要保留原有记录的非冲突字段值以及性能考量,选择合适的操作方式。 ———————————————— 原文链接:https://blog.csdn.net/weixin_72610956/article/details/139604440
-
1、replace into REPLACE INTO 首先判断数据是否存在;如果不存在,则插入;如果已存在则更新(先删除再插入 根据主键或唯一索引判断记录是否已存在,所以插入数据的表必须要有主键或者唯一索引!否则的话,REPLACE INTO 会直接插入数据(相当于INSERT),会导致表中出现重复数据。 如果不写某个字段的值则会使用默认值,如果该字段没有定义默认值则报错。 要使用REPLACE INTO,必须同时拥有表的INSERT和 DELETE权限。 MySQL replace into 有三种形式 1. replace into tbl_name(col_name, ...) values(...) 2. replace into tbl_name(col_name, ...) select ... 3. replace into tbl_name set col_name=value, ... // 唯一索引 ALTER TABLE 表名 ADD UNIQUE KEY `uk_唯一索引名` (`字段名`,`字段名`...); ALTER TABLE user ADD UNIQUE KEY `uk_user_id_type` (`user_id`,`type`); 1.1、主键自增 alter table t_user change id id int(11) not null AUTO_INCREMENT; CREATE TABLE `t_user` ( `id` int(11) NOT NULL AUTO_INCREMENT, `username` varchar(40) NOT NULL, `password` varchar(40) NOT NULL, `sex` varchar(4) NOT NULL, PRIMARY KEY (`id`), UNIQUE KEY `save_unique_index` (`username`,`password`) ) ENGINE=InnoDB AUTO_INCREMENT=5 DEFAULT CHARSET=utf8; 1.2、replace into tbl_name(col_name, ...) values(...) 1. replace into tbl_name(col_name, ...) values(...) -- 修改前的数据 1 Tom 123 男 2 Tom 1234 男 3 Jerry 234 女 4 Tom 12345 男 replace into t_user(username,password) values('Tom','123'); -- 报错,Field 'sex' doesn't have a default value replace into t_user(username,password,sex) values('Tom','123','男'); -- 受影响的行: 2 ,先删除,再插入 -- 修改后的数据 2 Tom 1234 男 3 Jerry 234 女 4 Tom 12345 男 5 Tom 123 男 replace into t_user(username,password,sex) values('Tom','123','女'); -- 受影响的行: 2 -- 修改后的数据 2 Tom 1234 男 3 Jerry 234 女 4 Tom 12345 男 6 Tom 123 女 replace into t_user(username,password,sex) values('Tom','123456','男'); -- 受影响的行: 1 -- 修改后的数据 2 Tom 1234 男 3 Jerry 234 女 4 Tom 12345 男 6 Tom 123 女 7 Tom 123456 男 1.3、replace into tbl_name(col_name, ...) select ... CREATE TABLE `t_user2` ( `id` int(11) NOT NULL AUTO_INCREMENT, `name` varchar(40) NOT NULL, `pwd` varchar(40) NOT NULL, `sex` varchar(4) NOT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB AUTO_INCREMENT=4 DEFAULT CHARSET=utf8; t_user: 2 Tom 1234 男 3 Jerry 234 女 4 Tom 12345 男 6 Tom 123 女 7 Tom 123456 男 t_user2: 1 Tom 123 男 2 Tonny 123 女 3 Jerry 234 女 replace into t_user(username,password,sex) select name,pwd,sex from t_user2 ; -- 受影响的行: 5 -- 修改后,(t_user)6删除,(t_user)8添加,(t_user)9添加,(t_user)3删除,(t_user)10添加 -- (唯一索引,所以‘Tom 123 女’会删除,再插入‘Tom 123 男’) t_user: 2 Tom 1234 男 4 Tom 12345 男 7 Tom 123456 男 8 Tom 123 男 9 Tonny 123 女 10 Jerry 234 女 1.4、replace into tbl_name set col_name=value, ... replace into t_user set username = 'Tommy' ; -- Field 'password' doesn't have a default value replace into t_user set username = 'Tommy' ,password = '1234567'; -- Field 'sex' doesn't have a default value replace into t_user set username = 'Tommy' ,password = '1234567',sex = '男'; -- 受影响的行: 1 -- 修改后 2 Tom 1234 男 4 Tom 12345 男 7 Tom 123456 男 8 Tom 123 男 9 Tonny 123 女 10 Jerry 234 女 11 Tommy 1234567 男 -- 这一行是新加的 replace into t_user set username = 'Tommy' ,password = '1234567',sex = '女'; -- 受影响的行: 2 -- 修改后 2 Tom 1234 男 4 Tom 12345 男 7 Tom 123456 男 8 Tom 123 男 9 Tonny 123 女 10 Jerry 234 女 12 Tommy 1234567 女 -- 把id=11的记录delete后,再insert id=12的记录 2、on duplicate key update on duplicate key update 首先判断数据是否存在;如果不存在,则插入;如果已存在则更新 on duplicate key update 语句根据主键id或唯一键来判断当前插入是否已存在。 记录已存在时,只会更新on duplicate key update之后指定的字段。 如果同时传递了主键和唯一键,以主键为判断存在依据,唯一键字段内容可以被修改。 2.1、创建表 alter table test change id id int(11) not null AUTO_INCREMENT; CREATE TABLE `test` ( `id` int(11) NOT NULL AUTO_INCREMENT, `organ_no` varchar(40) NOT NULL, `branch_no` varchar(40) NOT NULL, `branch_name` varchar(40) NOT NULL, `created_by` varchar(40) NOT NULL, PRIMARY KEY (`id`), UNIQUE KEY `branch_no_index` (`branch_no`) ) ENGINE=InnoDB AUTO_INCREMENT=5 DEFAULT CHARSET=utf8; 主键索引:id 唯一索引: branch_no 1、organ_no, branch_no, branch_name, created_by字段都不相同 2、branch_name, created_by不同 3、唯一索引branch_no不同 4、修改的值包括了唯一索引值branch_no 2.2、执行sql :organ_no, branch_no, branch_name, created_by字段都不相同 INSERT INTO t_bank_organ_copy1 ( organ_no, branch_no, branch_name, created_by ) VALUES ( 1, '3', '浙江分行', '3' ) ON DUPLICATE KEY UPDATE branch_name = '江苏分行'; 因为没有值相同,所以一定添加 2.3、branch_name, created_by与表中数据不同 INSERT INTO t_bank_organ_copy1 ( organ_no, branch_no, branch_name, created_by ) VALUES ( 1, '3', '海南分行', '4' ) ON DUPLICATE KEY UPDATE branch_name = '江苏分行'; 第三条数据从浙江分行改变成了江苏分行 ON DUPLICATE KEY UPDATE 后的值是要修改的值 而这个会根据唯一索引进行查询,其他普通列不做匹配(主键也是做匹配的) 2.4、唯一索引branch_no不同 INSERT INTO t_bank_organ_copy1 ( organ_no, branch_no, branch_name, created_by ) VALUES ( 1, '4', '江苏分行', '3' ) ON DUPLICATE KEY UPDATE branch_name = '海南分行'; 除了唯一索引branch_no不同,其他列都相同 执行后数据库增加一条 2.5、修改的值包括了唯一索引值branch_no INSERT INTO t_bank_organ_copy1 ( organ_no, branch_no, branch_name, created_by ) VALUES ( 1, '4', '江苏分行', '3' ) ON DUPLICATE KEY UPDATE branch_name = '海南分行', branch_no = '8'; 修改branch_no 4为8,并修改branch_name为海南分行 3、oracle merge into merge into 目标表 a using 源表 b on(a.条件字段1=b.条件字段1 and a.条件字段2=b.条件字段2 ……) when matched then update set a.字段=b.字段 --目标表别称a和源表别称b都不要省略 when not matched then insert (a.字段1,a.字段2……)values(b.字段1,b.字段2……) --目标表别称a可省略,源表别称b不可省略 源表b可能是一张表结构不同于a的表,有可能是一张构建相同表结构的临时表,也有可能是我们自己组起来的数据 merge into student a using (select '7' as id from dual) s on (a.id = s.id) when matched then update set a.student_name = '小明二号' when not matched then insert (id, student_name, fk_class) values ('7', '小明', '2') ———————————————— 原文链接:https://blog.csdn.net/qq_41482600/article/details/130388079
-
在MySQL中,ON DUPLICATE KEY UPDATE和REPLACE INTO都是常用的插入或更新表数据的语句。虽然两者实现的功能类似,但它们有着不同的应用场景和行为特征。本文将对这两种语句进行详细解释,并提供相关测试代码。 ON DUPLICATE KEY UPDATE ON DUPLICATE KEY UPDATE语句是MySQL中用于插入或更新记录的一种方式。它的主要作用是,如果尝试将一条记录插入到已存在的唯一索引(如主键、唯一约束等)中,则会执行更新操作,而不是插入新记录。具体来说,当插入数据时,如果发现指定的索引已经存在,则执行UPDATE操作,将新记录的值更新到该索引对应的原有记录上;否则,执行INSERT操作,插入新记录。其基本语法如下: INSERT INTO table (col1, col2, ...) VALUES (val1, val2, ...) ON DUPLICATE KEY UPDATE col1 = val1, col2 = val2, ...; 其中,table是目标表名,col1、col2等是目标列名,val1、val2等是需要插入或更新的值。 为了更好地理解ON DUPLICATE KEY UPDATE语句的工作原理,我们可以通过以下示例代码进行演示。首先,创建一个名为students的表,包含两个列:id和name。其中,id为主键,并设置自增增长。 CREATE TABLE students ( id INT PRIMARY KEY AUTO_INCREMENT, name VARCHAR(255) NOT NULL ); 然后,向该表中插入一些数据: INSERT INTO students (name) VALUES ('Alice'), ('Bob'), ('Charlie'); 这将在students表中插入三条记录,id分别为1、2和3。 接下来,我们使用ON DUPLICATE KEY UPDATE语句插入一条新记录,并执行更新操作。假设需要插入一条记录,表示学生“Bob”改名为“Bobby”。此时,我们可以使用以下SQL语句: INSERT INTO students (id, name) VALUES (2, 'Bobby') ON DUPLICATE KEY UPDATE name = 'Bobby'; 该语句尝试向students表中插入一条记录,其id为2,name为“Bobby”。由于id=2已经存在,因此触发了更新操作,将原有记录中name的值从“Bob”更新为“Bobby”。 如果我们再次执行查询操作,可以看到students表中的记录如下所示: +----+--------+ | id | name | +----+--------+ | 1 | Alice | | 2 | Bobby | | 3 | Charlie| +----+--------+ REPLACE INTO 与ON DUPLICATE KEY UPDATE不同,REPLACE INTO语句是用于替换或插入表数据的语句。它的工作原理是,当尝试向已经存在的唯一索引中插入新记录时,将删除原有记录并插入新记录。具体来说,如果目标表中已经存在一个与要插入的记录相同的唯一索引,则先删除该记录,再插入新记录;否则,直接插入新记录。其基本语法如下: REPLACE INTO table (col1, col2, ...) VALUES (val1, val2, ...); 其中,table是目标表名,col1、col2等是目标列名,val1、val2等是需要插入或更新的值。 为了更好地理解REPLACE INTO语句的工作原理,我们可以继续使用上述示例。假设需要插入一条记录,表示学生“Denise”加入了班级。此时,我们可以使用以下SQL语句: REPLACE INTO students (id, name) VALUES (4, 'Denise'); 该语句尝试向students表中插入一条记录,其id为4,name为“Denise”。由于id=4不存在,因此直接插入新记录。 如果我们再次执行查询操作,可以看到students表中的记录如下所示: +----+--------+ | id | name | +----+--------+ | 1 | Alice | | 2 | Bob | | 3 | Charlie| | 4 | Denise | +----+--------+ 测试用例 为了进一步说明ON DUPLICATE KEY UPDATE和REPLACE INTO的区别和用法,下面提供一个简单的测试用例。 假设我们有一个名为users的表,包含三个列:id、name和age。其中,id为主键。 首先,我们向users表中插入一些数据: INSERT INTO users (id, name, age) VALUES (1, 'Alice', 20), (2, 'Bob', 25), (3, 'Charlie', 30); 接着,我们分别使用ON DUPLICATE KEY UPDATE和REPLACE INTO语句向该表插入或更新数据,并执行查询操作,验证结果是否符合预期。 使用ON DUPLICATE KEY UPDATE插入或更新数据 -- 插入一条新记录 INSERT INTO users (id, name, age) VALUES (4, 'Denise', 35) ON DUPLICATE KEY UPDATE name = 'Denise', age = 35; -- 更新已有记录 INSERT INTO users (id, name, age) VALUES (2, 'Bobby', 30) ON DUPLICATE KEY UPDATE name = 'Bobby', age = 30; -- 查询数据 SELECT * FROM users; 执行以上语句后,查询结果为: +----+--------+-----+ | id | name | age | +----+--------+-----+ | 1 | Alice | 20 | | 2 | Bobby | 30 | | 3 | Charlie| 30 | | 4 | Denise | 35 | +----+--------+-----+ 使用REPLACE INTO插入或更新数据 -- 插入一条新记录 REPLACE INTO users (id, name, age) VALUES (5, 'Emily', 25); -- 更新已有记录 REPLACE INTO users (id, name, age) VALUES (3, 'Charles', 40); -- 查询数据 SELECT * FROM users; 执行以上语句后,查询结果为: +----+--------+-----+ | id | name | age | +----+--------+-----+ | 1 | Alice | 20 | | 2 | Bob | 25 | | 3 | Charles| 40 | | 5 | Emily | 25 | +----+--------+-----+ 通过上述测试用例,我们可以看到ON DUPLICATE KEY UPDATE和REPLACE INTO的不同之处,以及它们在实际应用中的使用场景和注意事项。需要根据具体的业务需求选择合适的语句,以保证数据的正确性和一致性。 ———————————————— 原文链接:https://blog.csdn.net/jam_yin/article/details/130685079
-
概述 在实际应用中,经常碰到导入数据的功能,当导入的数据不存在时则进行添加,有修改时则进行更新。 在刚碰到的时候,一般思路是将其实现分为两块,分别是判断增加,判断更新,后来发现在mysql中有ON DUPLICATE KEY UPDATE一步就可以完成(Mysql中独有的语法)。 SQL写法 在MySQL数据库中,如果在insert语句后面带上ON DUPLICATE KEY UPDATE子句,而要插入的行与表中现有记录的唯一索引或主键(可以是单一字段的唯一索引,也可以是复合字段的唯一索引)中产生重复值,那么就会发生旧行的更新;如果插入的行数据与现有表中记录唯一索引或者主键不重复,则执行新记录插入操作。 通俗点就是数据库中存在某条记录时,执行这个语句会更新,而不存在这条记录时,就会插入。 注意点: 因为这是个插入语句,所以不能加where条件。 如果是插入操作,受到影响行的值为1;如果更新操作,受到影响的行的值为2;如果更新的数据和已有的数据比对一样(就相当于没变,所有值保持不变),受到影响的行的值为0。 该语句是基于唯一索引(单一自动或复合字段的唯一索引)或者主键使用。 比如一个字段a被加上了unique index,并且表中已经存在了一条记录值为1。 下面两个语句会有相同的效果。 insert into table (a,b,c) values (1,2,3) on duplicate key update c = c+1; update table set c = c+1 where a =1; 比如两个字段a,b被加上unique index,并且表中已经存在了一个记录值a = 1, b =2,下面两个语句会有相同的效果。 insert into table (a,b,c) values (1,2,3) on duplicate key update c = c + 1; update table set c = c + 1 where a = 1 and b = 2; ON DUPLICATE KEY UPDATE后面可以放多个字段,用英文逗号分割。 如下面列子所示: insert into table (a,b,c) values (1,2,3),(4,5,6) on duplicate key update c = values(a) + values(b) 表中将更改(增加或修改)两条记录。 在mybatis中进行单个增加或修改sql的写法为: <insert id="insertOrUpdateCameraInfoByOne" paramerType="com.pojo.AreaInfo"> insert into camera_info( cameraId,zone1Id,zone1Name,zone2Id,zone2Name,zone3Id,zone3Name,zone4Id,zone4Name) VALUES( #{cameraId},#{zone1Id},#{zone1Name}, #{zone2Id}, #{zone2Name}, #{zone3Id}, #{zone3Name}, #{zone4Id}, #{zone4Name},) ON DUPLICATE KEY UPDATE cameraId = VALUES(cameraId), zone1Id = VALUES(zone1Id),zone1Name = VALUES(zone1Name), zone2Id = VALUES(zone2Id),zone2Name = VALUES(zone2Name), zone3Id = VALUES(zone3Id),zone3Name = VALUES(zone3Name), zone4Id = VALUES(zone4Id),zone4Name = VALUES(zone4Name) </insert> 在mybaits中进行批量增加或修改的sql为: <insert id="insertOrUpdateCameraInfoByBatch" parameterType="java.util.List"> insert into camera_info( zone1Id,zone1Name,zone2Id,zone2Name,zone3Id,zone3Name,zone4Id,zone4Name, cameraId )VALUES <foreach collection ="list" item="cameraInfo" index= "index" separator =","> ( #{cameraInfo.zone1Id}, #{cameraInfo.zone1Name}, #{cameraInfo.zone2Id}, #{cameraInfo.zone2Name}, #{cameraInfo.zone3Id}, #{cameraInfo.zone3Name}, #{cameraInfo.zone4Id}, #{cameraInfo.zone4Name}, #{cameraInfo.cameraId}, ) </foreach> ON DUPLICATE KEY UPDATE zone1Id = VALUES(zone1Id),zone1Name = VALUES(zone1Name),zone2Id = VALUES(zone2Id), zone2Name = VALUES(zone2Name),zone3Id = VALUES(zone3Id),zone3Name = VALUES(zone3Name), zone4Id = VALUES(zone4Id),zone4Name = VALUES(zone4Name), cameraId = VALUES(cameraId) </insert> values函数 values函数相当于更新需要插入的值,更新外部传入的值(值是本来应该插入的值,也就是入参)。 VALUES(clomn_name):表示更新指定的列,更新列值为外部传入的值。 比如:zone1Id = VALUES(zone1Id),更新zone1Id列的值为#{cameraInfo.zone1Id}。 注意问题 更新的内容中unique key或者primary key最好按照一个来判断是否重复,不然不能保证语句执行正确(有任意一个unique key重复就会走更新);尽量不对存在多个唯一键的talbe使用该语句,避免可能导致数据错乱。 在有可能有并发事物执行的insert语句下不要使用该语句,可能导致产生dead lock。 如果数据表id是自动递增的不建议使用该语句;id不连续,如果前面更新的比较多,新增的下一条会相应跳跃的更大。 该语句是mysql独有的语法,如果可能涉及到其他数据库语言要慎重使用。 主键不连续自增解决方法 源引自:https://www.linuxidc.com/Linux/2018-01/150427.htm 最近项目上需要实现这么一个功能:统计每个人每个软件的使用时长,客户端发过来消息,如果该用户该软件已经存在增更新使用时间,如果没有则新添加一条记录,代码如下: <!-- 批量保存软件使用时长表 --> <update id="saveApp" parameterType="java.util.List"> <foreach collection="appList" item="item" index="index" separator=";"> insert into app_table(userName,app,duration) values(#{userName},#{item.app},#{item.duration}) on duplicate key update duration=duration+#{item.duration} 为了效率用到了on duplicate key update进行自动判断是更新还是新增,一段时间后发现该表的主键id(已设置为连续自增),不是连续的自增,总是跳跃的增加,这样就造成id自增过快,已经快超过最大值了,通过查找资料发现,on duplicate key update有一个特性就是,每次是更新的情况下id也是会自增加1的,比如说现在id最大值的5,然后进行了一次更新操作,再进行一次插入操作时,id的值就变成了7而不是6. 为了解决这个问题,有两种方式,第一种是修改innodb_autoinc_lock_mode中的模式,第二种是将语句修拆分为更新和操作2个动作 第一种方式:innodb_autoinc_lock_mode中有3中模式,0,1和2,mysql5的默认配置是1, 0是每次分配自增id的时候都会锁表. 1只有在bulk insert的时候才会锁表,简单insert的时候只会使用一个light-weight mutex,比0的并发性能高 2.没有仔细看,好像是很多的不保证…不太安全. 数据库默认是1的情况下,就会发生上面的那种现象,每次使用insert into … on duplicate key update 的时候都会把简单自增id增加,不管是发生了insert还是update 由于该代码数据量大,同时需要更新和添加的数据量多,不能使用将0模式,只能将数据库代码拆分成为更新和插入2个步骤,第一步先根据用户名和软件名更新使用时长,代码如下: update app_table set duration=duration+#{duration} where userName=#{userName} and appName=#{appName} 然后根据返回值,如果返回值大于0,说明更新成功不再需要插入数据,如果返回值小于0则需要进行插入该条数据,代码如下: insert into app_table(userName,appName,duration) values(#{userName},#{appName},#{duration}) # 产生dead lock原理 insert ... on duplicate key在执行时,innodb引擎会先判断插入的行是否产生重复key错误,如果存在对该现有的行加上S(共享锁)锁,返回该行数据给mysql,mysql修改完数据后,然后对该记录加上X(排它锁),最后进行update写入。 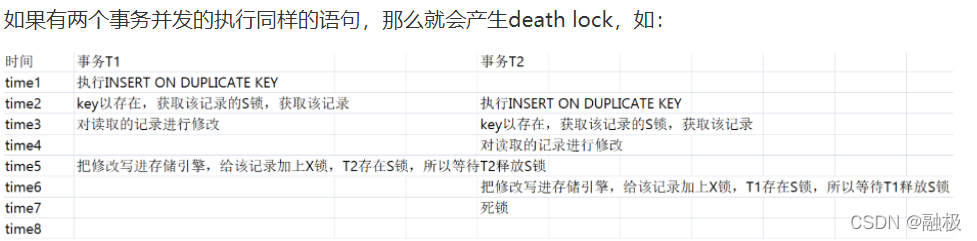 ———————————————— 原文链接:https://blog.csdn.net/tianzhonghaoqing/article/details/122643180
-
一 关键字 on duplicate key update的介绍 1.1 介绍 在MySQL数据库中,如果在insert语句后面带上ON DUPLICATE KEY UPDATE 子句,而要插入的行与表中现有记录的惟一索引或主键中产生重复值,那么就会发生旧行的更新;如果插入的行数据与现有表中记录的唯一索引或者主键不重复,则执行新纪录插入操作。 原理是: 该语法会在插入数据之前判断,如果主键或唯一索引不存在,则插入数据。如果主键或唯一索引存在,则执行更新操作。 需要注意的是,在高并发的场景下使用on duplicate key update语法,可能会存在死锁的问题,所以要根据实际情况酌情使用。 1.2 实操案例 本案例:使用unique索引结合ON DUPLICATE KEY UPDATE语句实现,添加数据确保数据的唯一性,不重复,有则修改,没有则新添加。 1.新建表 id为为主键,name+sex组合成索引 2.执行sql语句 再次执行: 两次执行结果:可以看到实现了"有则修改,无则新添加"的效果 ———————————————— 原文链接:https://blog.csdn.net/u011066470/article/details/88723394
-
1、应用场景 日常开发中,对于一个数据想做到存在即更新,不存在则新增,通常的做法是先查询数据库中是否存在对应的数据,如果存在就使用更新的方法,不存在就使用新增的方法 如果是单个数据,倒也没什么问题,但如果是批量数据的话,会消耗大量的资源来进行查询操作,这样就得不偿失了。 这种情况我们可以使用mysql提供的 on duplicate key update 来进行操作。 2、基础使用语法 2.1 假设此时我们表中没有数据 执行语句(为了展示效果使用用法2) #用法1:使用values来获取值(推荐,因为插入多个的时候可以用) INSERT INTO `test` ( id, name ) VALUES( 1, '晓明' ) ON DUPLICATE KEY UPDATE id = VALUES(id), name = VALUES(name) #用法2:直接使用值 INSERT INTO `user` ( id, name ) VALUES( 1, '晓明') ON DUPLICATE KEY UPDATE id = '123', name = 'xiaoming' 执行结果 2.2 有数据后再次执行 执行相同sql语句,执行结果 这里就是关键:我们可以看到变动为2,此时就是说明原数据进行了更新,更新内容为下面UPDATE中设置的字段值 ,id也可变化,数据库中数据如下 Q:我们再次执行一次这个语句,结果是什么样子呢? A:自然是判断出该表中无此数据,新增一条额外的新数据 sql结果 验证得到结论:其实就是会自动检测是否存在Duplicate entry,如果存在values后面的值就会自动更改,不存在则插入 3、批量插入 执行语句 INSERT INTO test(`id`,`name`,`address`) VALUES('4','修改10','北京'), ('1', '晓明',1) ON DUPLICATE KEY UPDATE name=VALUES(name),address=VALUES(address); sql结果 id为1和id为4的分别被修改和新增,可以同时进行两种操作类型 4、Mybatis中的写法 单独插入 <insert id="insertUser" parameterType="com.test.User"> INSERT INTO user( id, name, gender, birthday, address) VALUES (#{id}, #{name}, #{gender}, #{birthday}, #{address}) ON DUPLICATE KEY UPDATE id = VALUES(id), name = VALUES(name), gender = VALUES(gender) birthday = VALUES(birthday), address = VALUES(address) </insert> 批量插入 <insert id="insertUser" parameterType="java.util.List"> INSERT INTO user( id, name, gender, birthday, address) VALUES <foreach collection="list" item="item" index="index" separator=","> (#{item.id}, #{item.name}, #{item.gender}, #{item.birthday}, #{item.address}) </foreach> ON DUPLICATE KEY UPDATE id = VALUES(id), name = VALUES(name), gender = VALUES(gender) birthday = VALUES(birthday), address = VALUES(address) </insert> 5、情景模拟 插入失败提示如下 ERROR 1062 (23000): Duplicate entry 'value' for key 'PRIMARY' 如果数据库中已有某条数据,以下的两条语句可等同: INSERT INTO tablename (id, data) VALUES (1, 10) ON DUPLICATE KEY UPDATE data=data+10; UPDATE tablename SET data=data+10 WHERE id=1; ———————————————— 原文链接:https://blog.csdn.net/vulgarOr/article/details/128063088
-
INSERT INTO t_mercadolibre_custom_price_sku (sku, site_id, ordersource_id, publish_price, promotion_price,update_time) VALUES ('3003942', 'MLM', 16105, 'profit_30', 'profit_5','2024-03-19 12:02:12')ON DUPLICATE KEY UPDATE sku = VALUES(sku), site_id = VALUES(site_id), ordersource_id = VALUES(ordersource_id); ON DUPLICATE KEY UPDATE 是 MySQL 中的一种功能,用于在插入数据时检测到主键或唯一键冲突时执行更新操作。如果插入的数据中存在与现有记录的主键或唯一键相同的值,MySQL 将执行指定的更新操作而不是抛出错误。 在您的示例中,您插入了一条记录到 t_mercadolibre_custom_price_sku 表中,如果这条记录的 sku(或其他设置为唯一键的字段)已经存在于表中,则会执行更新操作,而不是插入新的记录。更新操作将会将已存在的记录的 sku、site_id 和 ordersource_id 更新为新插入的值。 因此,如果表中已经存在具有相同 sku、site_id 和 ordersource_id 的记录,该记录将会被更新为新的值。 如果没有冲突的唯一键,ON DUPLICATE KEY UPDATE 将不会生效,插入操作会正常进行,而不会触发更新操作。 这种功能可确保数据库中不会出现重复的记录,并且在出现冲突时能够按照指定的方式处理。 ———————————————— 原文链接:https://blog.csdn.net/EaSoNgo111/article/details/136845579
-
在 MySQL 中,DUPLICATE KEY 是用于处理插入数据时遇到唯一键(Unique Key)冲突的情况的一种机制。当向表中插入数据时,如果插入的数据违反了唯一约束(比如唯一索引或主键约束),就会触发 DUPLICATE KEY 错误。 为了处理这种情况,MySQL 提供了 ON DUPLICATE KEY UPDATE 和 ON DUPLICATE KEY IGNORE 这两种选项: 1.ON DUPLICATE KEY UPDATE:如果插入的数据违反了唯一约束,MySQL 将执行更新操作而不是抛出错误。你可以指定更新的字段和值,MySQL 将尝试更新现有行而不是插入新行。如果唯一键冲突,就会执行更新操作,否则会插入新行。 示例: INSERT INTO table_name (column1, column2, ...) VALUES (value1, value2, ...) ON DUPLICATE KEY UPDATE column1=new_value1, column2=new_value2, ...; 2.ON DUPLICATE KEY IGNORE:如果插入的数据违反了唯一约束,MySQL 将忽略该错误,不会执行任何操作。这意味着如果唯一键冲突,MySQL 将跳过该行,不会执行插入或更新操作。 示例: INSERT IGNORE INTO table_name (column1, column2, ...) VALUES (value1, value2, ...); 这些选项可以帮助开发者在插入数据时处理唯一键冲突的情况,使得数据操作更加灵活和可靠。 ———————————————— 原文链接:https://blog.csdn.net/weixin_53390884/article/details/138244079
-
引言一、ON DUPLICATE KEY UPDATE的介绍二、ON DUPLICATE KEY UPDATE的使用2.1、案例一:根据主键id进行更新2.2、案例二:根据唯一索引进行更新(常用)2.3、案例三:没有主键或唯一键字段值相同就插入2.4、案例四:主键与唯一键字段同时存在三、ON DUPLICATE KEY UPDATE的注意事项3.1、on dupdate key update之后val... 文章目录 一、ON DUPLICATE KEY UPDATE的介绍 二、ON DUPLICATE KEY UPDATE的使用 2.1、案例一:根据主键id进行更新 2.2、案例二:根据唯一索引进行更新(常用) 2.3、案例三:没有主键或唯一键字段值相同就插入 2.4、案例四:主键与唯一键字段同时存在 三、ON DUPLICATE KEY UPDATE的注意事项 3.1、on dupdate key update之后values的使用事项 3.2、对values使用判断 3.3、唯一索引大小写敏感问题 四、ON DUPLICATE KEY UPDATE与mybatis联合使用 4.1、写法一:与values()联合使用 4.2、写法二:使用#{} 五、ON DUPLICATE KEY UPDATE的缺点及坑 5.1、ON DUPLICATE KEY UPDATE每次更新导致id不连续 5.2、death lock死锁 有时候由于业务需求,可能需要先去根据某一字段值查询数据库中是否有记录,有则更新,没有则插入。这个时候就可以用到ON DUPLICATE KEY UPDATE这个sql语句了。 以下内容基于本地windows环境mysql:8.0.34进行讲解。 一、ON DUPLICATE KEY UPDATE的介绍 基本用法:ON DUPLICATE KEY UPDATE是一种MySQL的语法,它在插入新数据时,如果遇到唯一键冲突(即已存在相同的唯一键值),则会执行更新操作,而不是抛出异常或忽略该条数据。这个语法可以大大简化我们的代码,减少不必要的判断和查询操作。 用法总结 1:on duplicate key update 语句根据主键id或唯一键来判断当前插入是否已存在。 2:记录已存在时,只会更新on duplicate key update之后指定的字段。 3:如果同时传递了主键和唯一键,以主键为判断存在依据,唯一键字段内容可以被修改。 4:唯一键大小写敏感时,大小写不同的值被认为是两个值,执行插入。参见下文中的大小写敏感问题 二、ON DUPLICATE KEY UPDATE的使用 准备表结构及测试数据, 注意:name是唯一键 drop table if exists tbl_test; create table tbl_test( id int primary key auto_increment, name varchar(30) unique not null, age int comment '年龄', address varchar(50) comment '住址', update_time datetime default null ) comment '测试表'; insert into tbl_test(name,age,address,update_time) values('zhangsan',20,'杭州',now()),('lisi',21,'武汉',now()); 测试数据如下: 在这里插入图片描述 2.1、案例一:根据主键id进行更新 on dupdate key update 语句基本功能是:当表中没有原来记录时,就插入,有的话就更新。 如下sql: insert into tbl_test(id,name,age,address,update_time) values(1,'zhangsan1',201,'杭州1','2024-03-05 15:59:35') on duplicate key update age = values(age), -- 注意:values()括号中的内容是字段名称。比如:在java程序中使用时表字段可能叫user_name, 实体类中是userName,values()里面要填user_name address = values(address), update_time=now(); 在这里插入图片描述 从执行结果可以看出,更新了id为1的age,address两个字段,而name字段没有修改生效。由此我们可以得出两个重要结论: 1:on duplicate key update 语句根据主键id来判断当前插入是否已存在。 2:已存在时,只会更新on duplicate key update之后限定的字段。 2.2、案例二:根据唯一索引进行更新(常用) 根据唯一索引进行更新是生产中比较常用的方式,因为id一般使用的是自增,很少会先把id查询出来,然后根据id进行更新。 如下sql: insert into tbl_test(name,age,address) values('zhangsan',202,'杭州2') on duplicate key update age = values(age), -- 注意:values()括号中的内容是字段名称。比如:在java程序中使用时表字段可能叫user_name, 实体类中是userName,values()里面要填user_name address = values(address), update_time=now(); 在这里插入图片描述 从执行结果看,这次没有传id,但是age,address字段仍然更新了。 由此可以得出另一个结论: 3:on duplicate key update 语句也可以根据唯一键来判断当前插入的记录是否已存在。 2.3、案例三:没有主键或唯一键字段值相同就插入 如下sql: insert into tbl_test(name,age,address) values('zhangsan3',203,'杭州3') on duplicate key update age = values(age), -- 注意:values()括号中的内容是字段名称。比如:在java程序中使用时表字段可能叫user_name, 实体类中是userName,values()里面要填user_name address = values(address), update_time=now(); 在这里插入图片描述 这条执行就比较简单了,没有主键或唯一键字段值相同,即判断当前记录不存在,新插入一条。 注意: 这里我们发现主键id并没有连续,直接从2变成了4,具体原理可见《MySQL数据库设置主键自增、自增主键为什么不能保证连续递增》 2.4、案例四:主键与唯一键字段同时存在 如下sql: insert into tbl_test(id,name,age,address) values(1,'zhangsan4',204,'杭州4') on duplicate key update name = values(name), age = values(age), -- 注意:values()括号中的内容是字段名称。比如:在java程序中使用时表字段可能叫user_name, 实体类中是userName,values()里面要填user_name address = values(address), update_time=now(); 在这里插入图片描述 从上面可以看出,连唯一键name也被修改了。结论: 4:如果传递了主键,是可以修改唯一键字段内容的。 这里要注意,如果这里的name修改为 lisi,zhangsan3 会报唯一键冲突的。可以自行尝试。 三、ON DUPLICATE KEY UPDATE的注意事项 3.1、on dupdate key update之后values的使用事项 如下sql: insert into tbl_test(name,age,address,update_time) values('zhangsan4',205,'杭州5','2024-03-05 00:00:00') on duplicate key update age = age, address = '杭州', update_time=values(update_time); 在这里插入图片描述 on dupdate key update之后没有用values的情况 分为两种情况: 1:如果为如上面的address= “杭州”,则会一直更新为"杭州". 2:如果为如上面的age = age,则age会保持数据库中的值,不会更新。 3:只有当使用了values后,才会更新为上下文中传入的值 3.2、对values使用判断 如下sql insert into tbl_test(id,name,age,address) values(1,'zhangsan',202,'杭州2') on duplicate key update name = ifnull(values(name),name), age = values(age) 达到的效果是,如果传入的name值为null,则不更新。不为null则更新。这里与mybatis配合使用比较好。 3.3、唯一索引大小写敏感问题 思考这么一个问题:如上面name作为唯一索引,当name大小写敏感时且数据库中存储了name=“zhangsan” ,那么再插入name="ZHANGSAN"是更新还是新增? 1):唯一索引大小写不敏感时 设置name字段为唯一索引且大小写不敏感 drop table if exists tbl_test; create table tbl_test( id int primary key auto_increment, name varchar(30) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci unique not null, age int comment '年龄', address varchar(50) comment '住址', update_time datetime default null ) comment '测试表'; insert into tbl_test(name,age,address,update_time) values('zhangsan',20,'杭州',now()); insert into tbl_test(name,age,address,update_time) values('ZHANGSAN',21,'杭州1',now()); 在这里插入图片描述 可以看到当字段为大小写不敏感时zhangsan跟ZHANGSAN被认为是同一个值,不能重复插入。 当数据库中name=zhangsan时且name字段大小写不敏感时,我们看一下name="ZHANGSAN"能否更新成功? insert into tbl_test(name,age,address,update_time) values('ZHANGSAN',22,'杭州2','2024-03-05 00:00:00') on duplicate key update age = values(age), address = values(address), update_time=values(update_time); 在这里插入图片描述 以上结果可以看出,当大小写不敏感时on duplicate key update是可以更新成功的,即认为是同一个值。 2):唯一索引大小写敏感时 设置name字段为唯一索引且大小写敏感 drop table if exists tbl_test; create table tbl_test( id int primary key auto_increment, name varchar(30) CHARACTER SET utf8 COLLATE utf8_bin unique not null, age int comment '年龄', address varchar(50) comment '住址', update_time datetime default null ) comment '测试表'; insert into tbl_test(name,age,address,update_time) values('zhangsan',20,'杭州',now()); insert into tbl_test(name,age,address,update_time) values('ZHANGSAN',21,'杭州1',now()); 在这里插入图片描述 可以看到当字段为大小写敏感时zhangsan跟ZHANGSAN被认为是两个值,插入了两条记录。所以此时用on duplicate key update会执行新增操作 四、ON DUPLICATE KEY UPDATE与mybatis联合使用 4.1、写法一:与values()联合使用 注意:values后面的内容是表字段名称即带下划线,而不是实体类驼峰名称 如下sql: dept_id为主键或唯一索引 <insert id="replaceInto"> INSERT INTO sys_dept( dept_id, parent_id, status, update_time) VALUES <foreach collection="deptList" item="item" separator=","> (#{item.deptId}, #{item.parentId}, #{item.status}, #{item.updateTime}) </foreach> ON DUPLICATE KEY UPDATE parent_id=VALUES(parent_id), status=VALUES(status), update_time=VALUES(update_time) </insert> 4.2、写法二:使用#{} 如下sql: dept_id为主键或唯一索引 <insert id="replaceInto"> INSERT INTO sys_dept( dept_id, parent_id, status, update_time) VALUES <foreach collection="deptList" item="item" separator=","> (#{item.deptId}, #{item.parentId}, #{item.status}, #{item.updateTime}) </foreach> ON DUPLICATE KEY UPDATE <foreach collection="deptList" item="item" separator=","> parent_id = #{item.parentId}, status = #{item.status}, update_time = #{item.updateTime} </foreach> </insert> 五、ON DUPLICATE KEY UPDATE的缺点及坑 5.1、ON DUPLICATE KEY UPDATE每次更新导致id不连续 如下sql: drop table if exists tbl_test; create table tbl_test( id int primary key auto_increment, name varchar(30) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci unique not null, age int comment '年龄', address varchar(50) comment '住址', update_time datetime default null ) comment '测试表'; insert into tbl_test(name,age,address,update_time) values('zhangsan',20,'杭州',now()),('李四',21,'武汉',now()); 在这里插入图片描述 执行on duplicate key update进行更新,然后再插入一条新的数据 insert into tbl_test(name,age,address,update_time) values('zhangsan',22,'杭州2','2024-03-05 00:00:00') on duplicate key update age = values(age), address = values(address), update_time=values(update_time); insert into tbl_test(name,age,address,update_time) values('王五',23,'深圳',now()); 在这里插入图片描述 可以看到id自增值从2直接变成了4,造成了id的不连续。 1.ON DUPLICATE KEY UPDATE每次更新导致id不连续原理: mysql中有个配置值是innodb_autoinc_lock_mode。 innodb_autoinc_lock_mode中有3中模式,0,1和2,mysql5的默认配置是1, 0是每次分配自增id的时候都会锁表. 1只有在bulk insert的时候才会锁表,简单insert的时候只会使用一个light-weight mutex,比0的并发性能高 2.没有仔细看,好像是很多的不保证…不太安全. 数据库默认是1的情况下,就会发生上面的那种现象,每次使用insert into … on duplicate key update 的时候都会把简单自增id增加,不管是发生了insert还是update 5.2、death lock死锁 经常看到网上说ON DUPLICATE KEY UPDATE会导致死锁,确实是存在这个可能的,不过由于目前没有特别好的方案,所以也只能使用这个sql语法了。在执行insert ... on duplicate key语句时,如果不对同一个表同时进行并发的insert或者update,基本不会造成死锁。即insert ... on duplicate key时尽量单线程串行进行新增或更新 insert … on duplicate key 在执行时,innodb引擎会先判断插入的行是否产生重复key错误,如果存在,在对该现有的行加上S(共享锁)锁,如果返回该行数据给mysql,然后mysql执行完duplicate后的update操作,然后对该记录加上X(排他锁),最后进行update写入。 如果有两个事务并发的执行同样的语句,那么就会产生death lock 原文链接:https://openatomworkshop.csdn.net/6645ae6ab12a9d168eb6c9dc.html
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签