-
 >摘要:本篇文章主要讲解Python调用OpenCV实现图像阈值化处理操作,包括二进制阈值化、反二进制阈值化、截断阈值化、反阈值化为0、阈值化为0。 本文分享自华为云社区《[[Python图像处理] 七.图像阈值化处理及算法对比](https://bbs.huaweicloud.com/blogs/293565?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content) 》,作者: eastmount 。 # 一. 阈值化 (注:该部分参考作者的论文《基于苗族服饰的图像锐化和边缘提取技术研究》) 图像的二值化或阈值化(Binarization)旨在提取图像中的目标物体,将背景以及噪声区分开来。通常会设定一个阈值T,通过T将图像的像素划分为两类:大于T的像素群和小于T的像素群。 灰度转换处理后的图像中,每个像素都只有一个灰度值,其大小表示明暗程度。二值化处理可以将图像中的像素划分为两类颜色,常用的二值化算法如公式1所示: 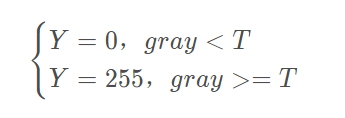 当灰度Gray小于阈值T时,其像素设置为0,表示黑色;当灰度Gray大于或等于阈值T时,其Y值为255,表示白色。 Python OpenCV中提供了阈值函数threshold()实现二值化处理,其公式及参数如下图所示: retval, dst = cv2.threshold(src, thresh, maxval, type) 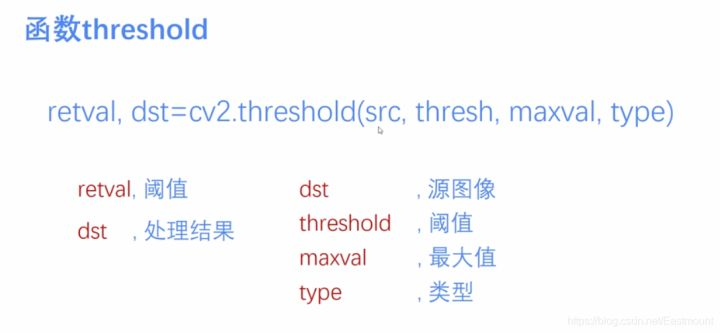 常用的方法如下表所示,其中函数中的参数Gray表示灰度图,参数127表示对像素值进行分类的阈值,参数255表示像素值高于阈值时应该被赋予的新像素值,最后一个参数对应不同的阈值处理方法。 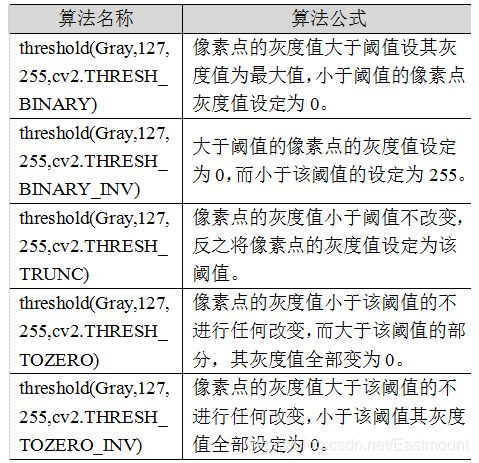 对应OpenCV提供的五张图如下所示,第一张为原图,后面依次为:二进制阈值化、反二进制阈值化、截断阈值化、反阈值化为0、阈值化为0。 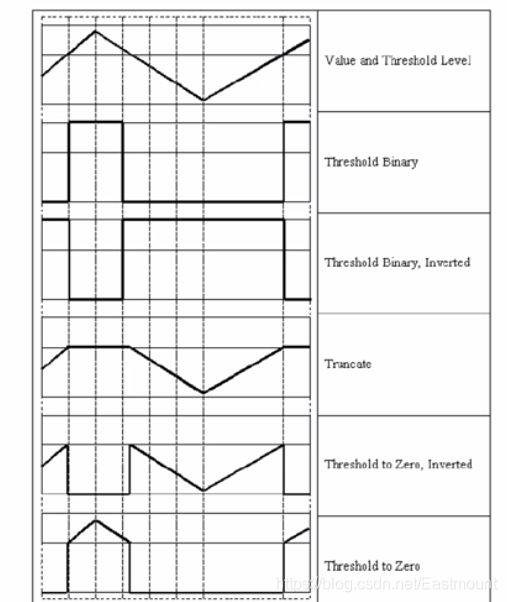 二值化处理广泛应用于各行各业,比如生物学中的细胞图分割、交通领域的车牌设别等。在文化应用领域中,通过二值化处理将所需民族文物图像转换为黑白两色图,从而为后面的图像识别提供更好的支撑作用。下图表示图像经过各种二值化处理算法后的结果,其中“BINARY”是最常见的黑白两色处理。 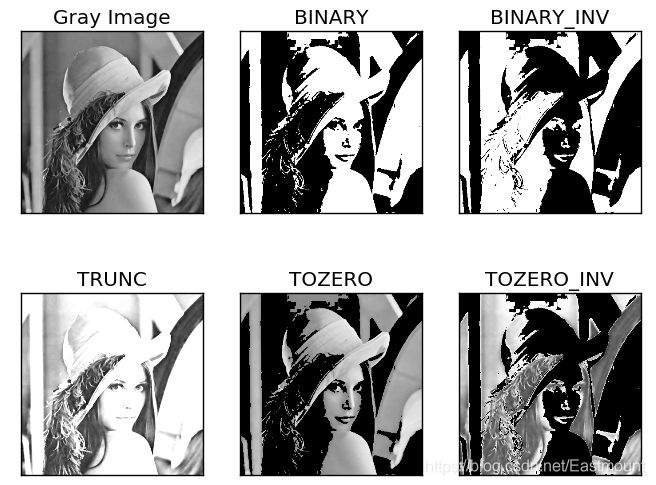 # 二. 二进制阈值化 该方法先要选定一个特定的阈值量,比如127。新的阈值产生规则如下: 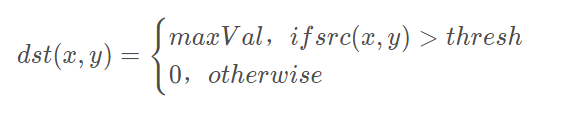 (1) 大于等于127的像素点的灰度值设定为最大值(如8位灰度值最大为255) (2) 灰度值小于127的像素点的灰度值设定为0 例如,163->255,86->0,102->0,201->255。 关键字为 cv2.THRESH_BINARY,完整代码如下: ``` #encoding:utf-8 import cv2 import numpy as np #读取图片 src = cv2.imread('test.jpg') #灰度图像处理 GrayImage = cv2.cvtColor(src,cv2.COLOR_BGR2GRAY) #二进制阈值化处理 r, b = cv2.threshold(GrayImage, 127, 255, cv2.THRESH_BINARY) print r #显示图像 cv2.imshow("src", src) cv2.imshow("result", b) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() ``` 输出为两个返回值,r为127,b为处理结果(大于127设置为255,小于设置为0)。如下图所示: 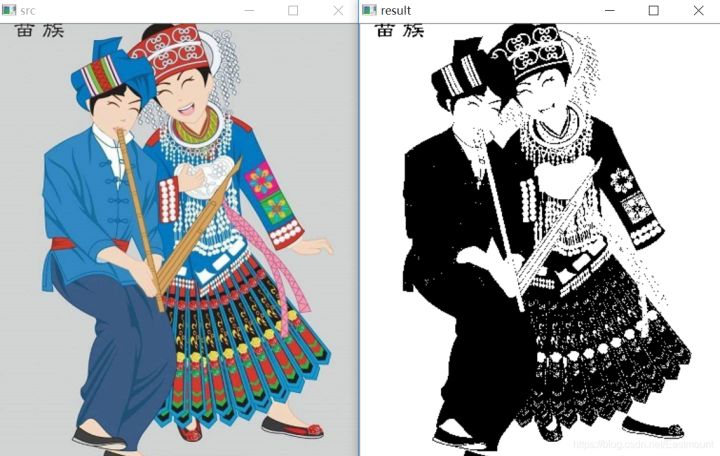 # 三. 反二进制阈值化 该方法与二进制阈值化方法相似,先要选定一个特定的灰度值作为阈值,比如127。新的阈值产生规则如下: 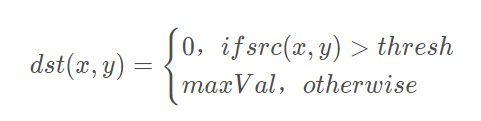 (1) 大于127的像素点的灰度值设定为0(以8位灰度图为例) (2) 小于该阈值的灰度值设定为255 例如,163->0,86->255,102->255,201->0。 关键字为 cv2.THRESH_BINARY_INV,完整代码如下: ``` #encoding:utf-8 import cv2 import numpy as np #读取图片 src = cv2.imread('test.jpg') #灰度图像处理 GrayImage = cv2.cvtColor(src,cv2.COLOR_BGR2GRAY) #反二进制阈值化处理 r, b = cv2.threshold(GrayImage, 127, 255, cv2.THRESH_BINARY_INV) print r #显示图像 cv2.imshow("src", src) cv2.imshow("result", b) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() ``` 输出结果如下图所示: 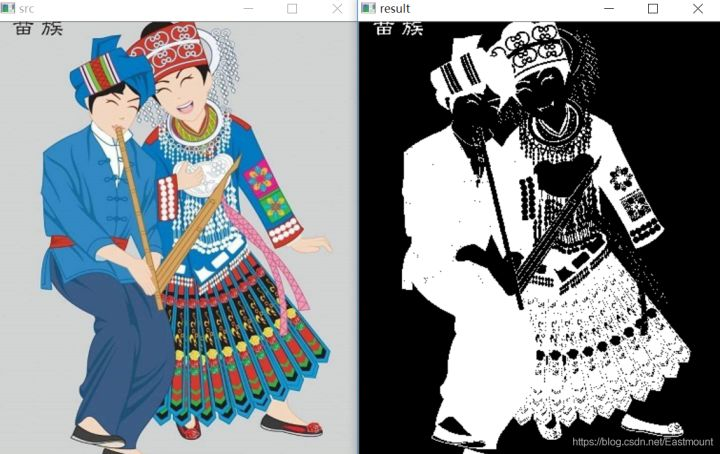 该方法得到的结果正好与二进制阈值化方法相反,亮色元素反而处理为黑色,暗色处理为白色。 # 四. 截断阈值化 该方法需要选定一个阈值,图像中大于该阈值的像素点被设定为该阈值,小于该阈值的保持不变,比如127。新的阈值产生规则如下: 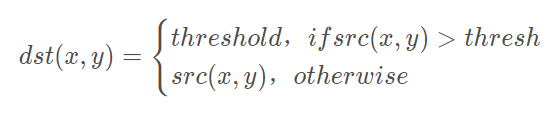 (1) 大于等于127的像素点的灰度值设定为该阈值127 (2) 小于该阈值的灰度值不改变 例如,163->127,86->86,102->102,201->127。 关键字为 cv2.THRESH_TRUNC,完整代码如下: ``` #encoding:utf-8 import cv2 import numpy as np #读取图片 src = cv2.imread('test.jpg') #灰度图像处理 GrayImage = cv2.cvtColor(src,cv2.COLOR_BGR2GRAY) #截断阈值化处理 r, b = cv2.threshold(GrayImage, 127, 255, cv2.THRESH_TRUNC) print r #显示图像 cv2.imshow("src", src) cv2.imshow("result", b) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() ``` 输出结果如下图所示: 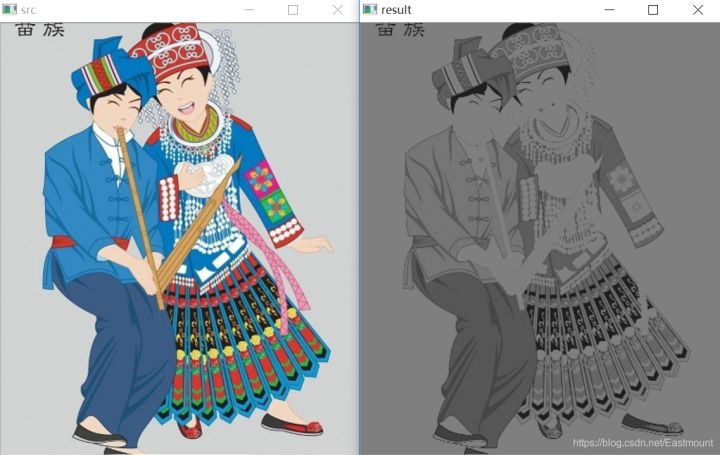 该处理方法相当于把图像中比较亮(大于127,偏向于白色)的像素值处理为阈值。 # 五. 反阈值化为0 该方法先选定一个阈值,比如127,接着对图像的灰度值进行如下处理: 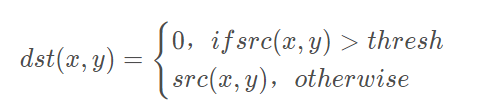 (1) 大于等于阈值127的像素点变为0 (2) 小于该阈值的像素点值保持不变 例如,163->0,86->86,102->102,201->0。 关键字为 cv2.THRESH_TOZERO_INV,完整代码如下: ``` #encoding:utf-8 import cv2 import numpy as np #读取图片 src = cv2.imread('test.jpg') #灰度图像处理 GrayImage = cv2.cvtColor(src,cv2.COLOR_BGR2GRAY) #反阈值化为0处理 r, b = cv2.threshold(GrayImage, 127, 255, cv2.THRESH_TOZERO_INV) print r #显示图像 cv2.imshow("src", src) cv2.imshow("result", b) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() ``` 输出结果如下图所示: 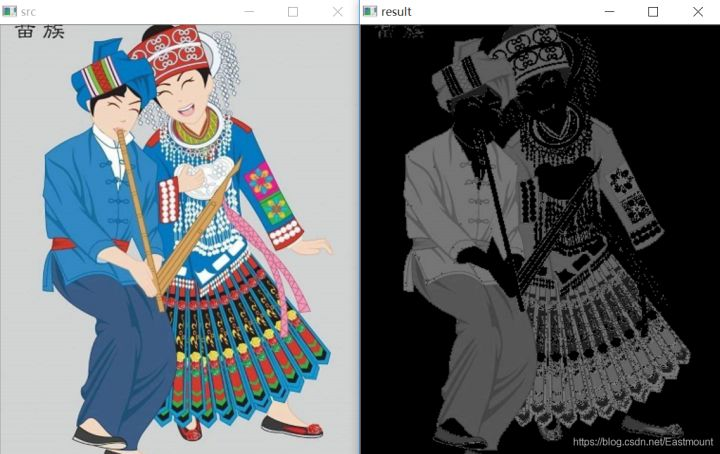 # 六. 阈值化为0 该方法先选定一个阈值,比如127,接着对图像的灰度值进行如下处理: 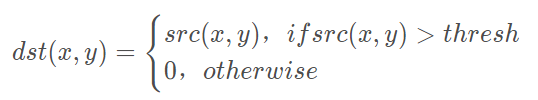 (1) 大于等于阈值127的像素点,值保持不变 (2) 小于该阈值的像素点值设置为0 例如,163->163,86->0,102->0,201->201。 关键字为 cv2.THRESH_TOZERO,完整代码如下: ``` #encoding:utf-8 import cv2 import numpy as np #读取图片 src = cv2.imread('test.jpg') #灰度图像处理 GrayImage = cv2.cvtColor(src,cv2.COLOR_BGR2GRAY) #阈值化为0处理 r, b = cv2.threshold(GrayImage, 127, 255, cv2.THRESH_TOZERO) print r #显示图像 cv2.imshow("src", src) cv2.imshow("result", b) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() ``` 输出结果如下图所示: 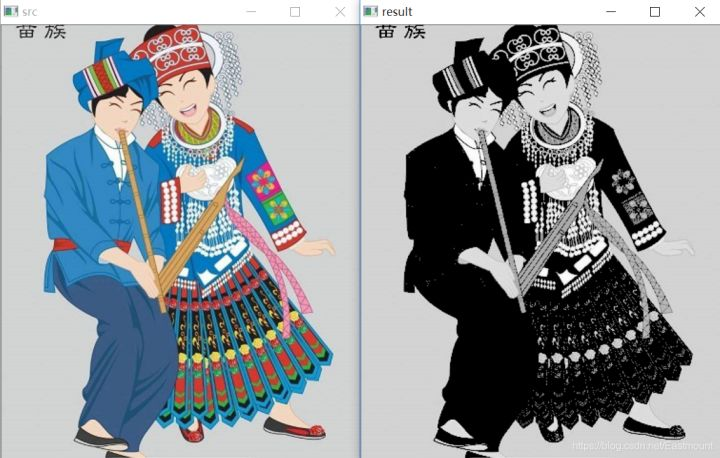 该算法把比较亮的部分不变,比较暗的部分处理为0。 完整五个算法的对比代码如下所示: ``` #encoding:utf-8 import cv2 import numpy as np import matplotlib.pyplot as plt #读取图像 img=cv2.imread('test.jpg') lenna_img = cv2.cvtColor(img,cv2.COLOR_BGR2RGB) GrayImage=cv2.cvtColor(img,cv2.COLOR_BGR2GRAY) #阈值化处理 ret,thresh1=cv2.threshold(GrayImage,127,255,cv2.THRESH_BINARY) ret,thresh2=cv2.threshold(GrayImage,127,255,cv2.THRESH_BINARY_INV) ret,thresh3=cv2.threshold(GrayImage,127,255,cv2.THRESH_TRUNC) ret,thresh4=cv2.threshold(GrayImage,127,255,cv2.THRESH_TOZERO) ret,thresh5=cv2.threshold(GrayImage,127,255,cv2.THRESH_TOZERO_INV) #显示结果 titles = ['Gray Image','BINARY','BINARY_INV','TRUNC','TOZERO','TOZERO_INV'] images = [GrayImage, thresh1, thresh2, thresh3, thresh4, thresh5] for i in xrange(6): plt.subplot(2,3,i+1),plt.imshow(images[i],'gray') plt.title(titles[i]) plt.xticks([]),plt.yticks([]) plt.show() ``` 输出结果如下图所示: 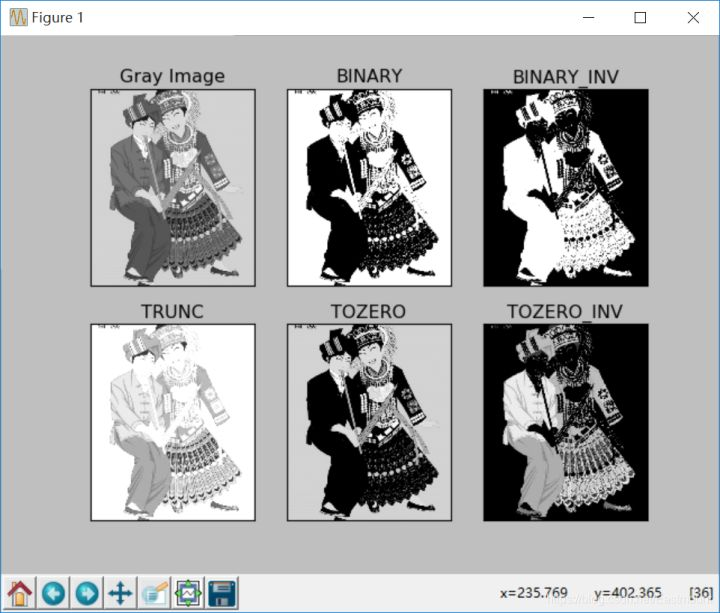 本文摘录自eastmount X华为云开发者社区联合出品的电子书《从零到一 • Python图像处理及识别》。
-
 文章来源于当交通遇上机器学习 ,作者CY1.文章信息论文链接:https://www.mdpi.com/2071-1050/14/9/4930/htm2.摘要针对森林火灾图像中小目标、类火目标和类烟目标的检测,以及不同自然光下的火灾检测,提出了一种改进的Fire-YOLO深度学习算法。Fire-YOLO检测模型从三维扩展了特征提取网络,增强了火灾小目标识别的特征传播,提高了网络性能,减少了模型参数。进一步,通过特征金字塔的提升,得到了性能最好的预测框。与最先进的目标检测网络相比,Fire-YOLO取得了优异的结果,尤其是在火灾和烟雾的小目标检测方面。总体而言,Fire-YOLO检测模型可以有效地处理小火源目标、类火和类烟目标的检测。当输入图像尺寸为416 × 416分辨率时,平均检测时间为0.04 s /帧,可以提供实时的森林火灾检测。此外,文章提出的算法也可以应用于其他复杂情况下的小目标检测。3.简介火灾探测对于保护森林资源、保护人民生命财产至关重要。近年来,随着火灾图像探测成为研究热点,图像探测具有探测时间早、精度高、系统安装灵活、能有效探测大空间复杂建筑结构火灾等优点。一类方法基于火灾发生时的颜色识别,但基于颜色的方法对亮度和阴影非常敏感。因此,这些方法产生的假警报数量很高。随着机器学习的发展,深度学习技术已广泛应用于检测。有学者提出了一种使用微调卷积神经网络(CNN)的早期火灾探测框架,但该模型具有较高的计算成本。有的学者使用深度融合CNN进行烟雾探测,它结合了注意机制、特征级和决策级融合模块。然而,仍有一些小目标未能实现。有的学者使用了一种基于区域的快速卷积神经网络(R-CNN),根据空间特征检测可疑火灾区域(SRoF)和非火灾区域。这可以通过减少错误探测成功地提高火灾探测精度,但探测速度相对较慢。有的学者提出了一种基于YOLO-V3和YOLO-V4的森林烟雾检测算法。与YOLO-V4相比,YOLO-V3的模型更小,更易于部署。在此基础上,文章选择了YOLO-V3模型作为整体算法,并对其进行了改进。提出了对YOLO-V3算法的改进。网络中加入了空心卷积和DenseNet,提高了火灾早期小规模火焰的探测效果。然而,方法存在火焰定位不准确和屏蔽性能差的问题。I-YOLOv3-tiny模型通过网络结构优化、多尺度融合和K-均值聚类来提高检测精度,但检测速度有待提高。通过提高特征图的分辨率,它减少了火灾探测中的误差,但由于计算量的增加,相应的处理时间也增加了。将分类模型和目标检测模型结合用于火灾探测的方法降低了计算成本,提高了探测精度。尽管如此,它不适用于火灾早期小目标的探测场景。有的学者通过将原始网络结构中的两步降采样卷积网络替换为图像双分割和双线性上采样网络,扩大了小目标的特征,提高了小目标的检测精度。虽然这会增加参数的数量,但计算成本也会增加。对于具有实时性要求的火灾探测,仍需进一步改进。这些问题给火灾场景中小目标的检测带来了巨大的挑战。4.模型A. YOLO-V3YOLO- v3是由YOLO和YOLOV2网络演化而来的对象检测模型。与Faster R-CNN相比,YOLO- v3是单级检测算法,这意味着YOLO网络不需要Regional Proposal network (RPN),而是直接检测图像中的目标。这样既考虑了检测速度和检测精度,又减小了模型参数的尺寸。YOLO-V3对每个类别独立使用逻辑回归,取代了DarkENT-19到DarkENT-53的特征提取网络。YOLO-V3几乎与其他目标检测算法一样精确,但速度至少是后者的两倍。YOLO-V3的特征提取网络为Darknet-53。Darknet-53通过不断地使用卷积、标准化、池化等操作,提取输入到YOLO-V3网络的火灾图像的特征,并通过卷积不断地对火灾图像进行特征提取。这种方法广泛应用于其他各种网络模型中,ResNet也通过增加网络的深度来提高网络的精度。虽然可以同时缩放两个或三个维度,但由于深度和宽度之间有一定的关系,需要进行复杂的手动调整,也就是说只能调整深度和宽度才能达到更好的精度。目前,YOLO-V3模型在火灾探测中并未得到广泛应用。B.Fire-YOLOFire-YOLO是一种单阶段检测模型。FireYOLO用于火灾探测的步骤如下所示。首先,网络输入火灾图像分为S×S网格,和检测在每个探测单元格:是否有火焰或者烟雾的中心目标是发现落在S2的网格,网格负责检测目标被检测出来。然后,每个网格预测3个边界框,并给出这些边界框的置信度。置信计算的定义如下。当目标落在网格中时Pγ = 1,否则Pγ = 0。IoU表示预测边界框与真实边界框的重合。置信度反映了网格中是否存在对象以及包含对象时预测边界框的准确性。当多个包围盒同时检测到同一目标时,YOLO网络将使用非最大抑制(Non-Maximum Suppression, NMS)方法选择最佳包围盒。利用卷积神经网络对视频中的火情和烟雾进行分类来检测火情,具有良好的准确率。文章提出的Fire-YOLO模型从深度、宽度和分辨率三个维度考虑,实现了更加均衡的网络架构。Fire-YOLO火灾探测步骤如下图所示。将输入图像划分为S×S网格,每个网格预测三个边界框和置信度分数。然后,使用非最大值抑制方法选择最佳边界框。Effentnet的提出为设计一种标准化的卷积神经网络尺度方法提供了可能。通过平衡网络深度、宽度和分辨率这三个维度,可以在深度、宽度和分辨率这三个维度上实现更均衡的网络架构,而无需复杂的人工调整。由于火灾数据集中大量的检测对象为小火焰和烟雾,这种简单高效的复合尺度变换方法相对于其他的一维尺度变换方法可以进一步提高火灾的检测精度,并能充分节约计算资源。最终,文章使用的改进后的Effentnet比精度相同的卷积神经网络速度更快,参数更少,模型更小,具有明显的优势。提出的Fire-YOLO火灾探测模型网络结构如下图所示。与YOLO-V3中特征提取网络Darknet53中使用的残块不同,Fire-YOLO的特征提取网络使用了一个移动倒瓶颈卷积(MBConv),该卷积由深度卷积和挤压-激活网络(SENet)组成。MBConv块的结构,最重要的是,一个1×1卷积内核用于增加图像的维数,接下来通过切除卷积和SENet反过来,最后用1×1卷积内核来减少图像的维数输出。输入图像经过特征提取网络并上采样后,得到对应的特征图,即图像对应的向量特征矩阵。为了获得小目标的高层特征信息,特征图将经过卷积集处理,卷积集由5个卷积层组成,卷积核交替为1 × 1和3 × 3。然后利用池化层将高维向量扁平化为一维向量,由激活函数进行处理。将这些向量输入到激活函数中,得到相应的分类结果,并选择最有可能的结果作为特征提取网络输出。针对Darknet-53特征提取网络在深度、宽度和分辨率三个维度平衡方面的性能缺陷,文章在文章提出的fire数据集上使用改进的Effecentnet特征提取网络,弥补了Darknet-53在小目标检测方面的性能不足,提高了小目标检测的特征提取能力。对于输入的小目标图像,增强了小目标特征的学习能力,提高了小目标特征提取网络的性能。为了更好地处理小目标图像,Fire-YOLO模型首先将输入图像缩放到416 × 416像素,然后使用Effecentnet从图像中提取特征。经过多层的深度可分卷积、全局平均池化、特征压缩和特征扩展,对深度可分卷积学习到的特征映射进行上采样。通过特征金字塔处理得到不同尺度的预测框。文章提出的Fire-YOLO模型预测了13 × 13、26 × 26、52 × 52三种不同尺度的边界盒。用于小目标检测的深度可分离卷积结合了逐条通道卷积和逐级点卷积两种级别,提取不同粒度的小目标特征。深度可分卷积的结构如下图所示。通过比较YOLO-V3中使用的Darknet-53特征提取网络、快速R-CNN中使用的RPN目标建议网络和Fire YOLO中使用的深度可分离卷积,发现深度可分离卷积在计算复杂度方面具有优异的性能。这种卷积结构加快了模型的训练速度,提高了模型的检测精度。在火灾探测模型的实际应用中,可以加快网络的处理速度,如果计算量较小,可以达到实时图像处理的目的,从而实现火灾危险的实时探测。同时,该模型的硬件要求也降低了,以便于部署。SENet主要由两个阶段组成。第一个阶段是挤压阶段。第二个阶段是激发阶段。在获得挤压的矢量后,使用完全连接的层,并预测每个通道的重要性。随后,将其应用于与初始特征映射相对应的信道,以便小目标的特征信息将被赋予更高的优先级。SENet的结构如下图所示。在深度学习网络模型中,激活函数是一个连续可导的非线性函数,可以拟合非线性关系。激活函数及其导数的形式比较简单,可以加快网络的学习速度。正确使用激活函数对模型的训练和模型对目标预测的准确性都具有重要意义。活化函数的导数不宜过大或过小,最好稳定在1左右。文章提出的模型使用了Swish激活函数,其表达式为:其中β是常数或可训练参数。Swish具有无上界、无下界、光滑、非单调的特点。Swish在深度模式上比ReLU要好。乙状结肠的饱和函数很容易导致梯度的消失,借鉴ReLU的影响,当它是非常大的,它将方法,但当x→∞,函数的一般趋势比ReLU ReLU相似但更复杂。Swish函数可以看作是一个介于线性函数和ReLU函数之间的平滑函数。C. 性能指标文章利用训练后的Fire-YOLO模型对测试图像进行一系列实验,验证算法的性能。评价神经网络模型有效性的相关指标有:precision, recall, F1, AP值。在二元分类问题中,根据真类别和预测类别的组合,样本可分为四种类型:真阳性(TP)、假阳性(FP)、真阴性(TN)和假阴性(FN)。分类结果的混淆矩阵如下表所示。其余指标的公式根据混淆矩阵计算如下:5.实验分析本节介绍训练网络的实验环境、数据集、模型效果评价指标以及实验结果分析。通过一系列不同模型的对比实验,分析了文章提出的新模型的优越性。实验过程中使用了火数据集和小目标数据集。通过fire数据集对目标检测网络的准确性进行了验证和评估,在不同光照条件、类火烟雾目标等复杂环境下具有良好的检测效果;在小目标火力数据集上验证了该检测方法。结果证实,Fire-YOLO更容易检测到较小的目标。Fire-YOLO检测模型接收416 × 416像素图像作为输入,由于GPU性能限制,批处理大小设为8,每个模型训练100 epoch,初始学习速率为10−3,50 epoch后除以10。A. 数据采集实验中使用的数据集是通过采集消防公益平台上的消防图片来构建的。将fire数据集和小目标数据集分别划分为训练集、验证集和测试集,以便在相同的实验设置下对不同的模型进行训练。第一个数据集为火焰数据集,文章使用的图像数据是公共网站上收集的火灾和烟雾图像。这19819张原始图像包括不同天气和光线线下的火焰和烟雾。在对以上数据集图像进行编号后,使用LabelImg工具进行手动标记,包括绘制边框和分类类别。考虑到标签与数据的对应关系,为保证数据集分布均匀,将数据集按70%、20%、10%的比例随机分为训练集、验证集和测试集。为了保证实验环境相同,最终数据集以PASCAL VOC数据集格式存储。为了防止神经网络中过拟合,对于像素区域不清晰的阳性样本不进行标记。完成的数据集如下表所示。第二个数据集为小目标检测数据集,文章自制了370张图像的数据集。数据集的内容都是包含小目标的火焰和烟雾。通过将250 × 250像素的火焰图像嵌入到1850 × 1850像素的图像中,可以使被探测目标在图像中的面积非常小。最后使用LabelImg工具手工标注小目标。B. 算法的比较分析为了验证模型的性能,文章使用火焰和烟雾图像作为训练集。将所提出的模型与YOLO-V3和Faster R-CNN检测方法进行了比较。三种模型在试验过程中的P-R曲线如图5所示。准确率、召回率、F1评分和mAP值如下表所示。基于以上结果,文章提出的Fire-YOLO在检测性能上优于YOLO-V3和Faster R-CNN。Fire-YOLO模型的精度为0.915,F1的值为0.73,mAP的值为0.802,高于其他两个模型,体现了该模型的优越性。同时Fire-YOLO降低了计算成本,节约了资源,更有利于社会的可持续发展。C. 小目标的检测性能在火灾探测过程中,由于摄像机离火源太远,实际的火源位置在捕获的图像中只占很小的区域,这将导致网络模型对火焰和烟雾的探测非常差。通过比较三种不同的目标检测模型在小目标火灾数据集上的准确率、召回率和mAP,可以得出文章提出的Fire-YOLO模型对非常小的目标对象的检测效率优于Faster R-CNN和未改进的YOLO-V3网络。训练于射击小目标数据集的Fire-YOLO对待检测小目标图像在深度、宽度和分辨率三个维度上进行自适应调整,增强了信息之间的交互作用。从而增强了Fire-YOLO提取小目标特征的能力,提高了小目标物体的检测精度。下表给出了三种模型方法对小目标射击数据集评价指标的具体结果。三种不同模型对小目标火力数据集的检测效率差异较大。文章提出的Fire-YOLO模型的准确率和召回率比其他模型更显著。准确率可达75.48%,可实现对小目标的检测。森林火灾的早期及时发现可以大大减少对生态环境的破坏,减少火灾造成的经济损失,促进生态环境的可持续发展。训练后Fire-YOLO网络模型具有良好的火力目标探测效率。文章使用Fire-YOLO模型来检测非常小的火力目标,并将检测结果图形化显示。较小的射击目标是小目标射击数据集中验证数据集中的所有图像。对Fire-YOLO进行了30多个验证插图的验证,最终的图像检测结果如下图所示。Fire-YOLO可以检测到图片中所有的火和烟,而YOLO-V3和Faster R-CNN在检测结果中只能检测到图像中的部分目标。D. 类火和类烟目标的探测性能通过对比模型对丰富的类火和类烟图像的检测性能,可以发现Fire-YOLO对类火和类烟目标具有更好的检测效率。除了Fire-YOLO,其他模型分别将图像中的光和云误判为火和烟。显然,Fire-YOLO对图像纹理特征更加敏感,这是由于在特征提取网络中结合了1 × 1卷积核和SE模块。最后,提高了该模型在探测混淆目标时的鲁棒性。三种模型的类火和类烟检测结果如下图所示。在上述情况下,Fire-YOLO模型大大减少了误检的发生,减少了劳动力消耗,节约了社会资源。E. 模型在不同自然光下的检测性能本节通过对比不同自然光照条件下的多幅火灾图像,测试Fire-YOLO在真实环境中的性能。在实际火灾探测现场,会出现光线不足或光线很强的情况。在这种场景下,会对火灾探测产生一定的影响。使用大尺度feature map对模型进行改进,识别小目标对象,但在弱光条件下存在误判。检测结果如下图所示。通过比较FasterR-CNN、YOLO-V3和Fire-YOLO模型的检测性能,结果表明该模型在不同光照条件下具有良好的性能,对光照变化具有较强的鲁棒性。Fire-YOLO模式的这些优势可以减少火灾对森林的危害,减少温室效应对人类的影响,促进可持续发展文章提出的Fire- YOLO模型在小目标、类火、类烟探测以及不同明度下的火灾探测等方面都取得了令人满意的效果。在实际应用中,该方法不仅具有实时性,而且具有良好的鲁棒性。然而文章检测算法仍然存在检测精度低、检测半遮挡目标具有挑战性的问题。这可能是由于在实际环境中探测火焰时,火灾的可变性和火灾蔓延的复杂性,造成了火灾检查的困境,如下图所示。.
-
 【功能模块】ModelArts产品AI应用服务ID 7bb213cc-d27c-4f25-88db-d15b7a79fd66【操作步骤&问题现象】1、原yolov5 提供了模型集成,但在obs中上传两个模型文件(.pt)后推理错误。模型(pt)的读入是不公开的,无法修改推理文件完成Ensemble Inference。2、官方要求的文件路径如下OBS桶/目录名 |── resnet | ├── model 必选: 固定子目录名称,用于放置模型相关文件 | │ ├── <<自定义Python包>> 可选:用户自有的Python包,在模型推理代码中可以直接引用 | │ ├── resnet50.pth 必选,pytorch模型保存文件,保存为“state_dict”,存有权重变量等信息。 | │ ├──config.json 必选:模型配置文件,文件名称固定为config.json, 只允许放置一个 | │ ├──customize_service.py 必选:模型推理代码,文件名称固定为customize_service.py, 只允许放置一个,customize_service.py依赖的文件可以直接放model目录下3、我的OBS【日志信息】(可选,上传日志内容或者附件)
-
 华为云云享.书库》系列电子书来啦!本系列电子书旨在帮助开发者成长,汇聚华为云内外部专家技术精华制作而成。 本书《从零到一•Python图像处理》是该系列电子书第3部。本书作者杨秀璋,贵州财经大学教师,武汉大学在读博士。长期从事Web数据挖掘、知识图谱、人工智能、网络安全等方向研究,现已出版专著6部,发表论文30余篇,主持课题6项(含1项贵州省优秀自然科学基金),并参与多项国家级课题。近十年在华为云等社区分享原创博客600余篇,开源项目100余个,全网累计阅读量超过1000万人次,粉丝20余万。此书是作者十多年图像处理及识别编程经验的结晶,包含丰富真实的案例及详细的算法原理,采用Python3、OpenCV和Keras等库实现,通过图文结合、代码注释、实例详解的形式娓娓道来。希望这本电子书及开源的代码能帮助读者迅速入门,并让图像处理及识别领域的知识轮廓逐渐清晰。全书包括三部分内容,共48章。第一部分是图像处理基础知识(共10章),详细介绍了图像处理基础、OpenCV入门、几何图形绘制、算数与逻辑运算、几何变换、量化和采样处理等内容。第二部分是图像运算和图像增强(共17章),包括图像点运算、灰度变换、形态学处理、直方图绘制、图像均衡化、平滑锐化等内容。第三部分是图像识别及图像高阶案例(共21章),包括图像分割、傅里叶变换、霍夫变换、图像分类、特效处理、OpenGL、图像去雾等知识,也囊括了经典的文字识别、车牌识别、人脸识别、目标检测、基于深度学习的图像分类、小麦检测、GAN图像生成等案例。本书详细讲解了Python图像处理及识别知识,是市面上为数不多结合实战的图像处理书籍,更是一本计算机视觉的宝典。全书内容通俗易懂,案例丰富,图文并茂,便于读者快速上手,非常适合初学者、技术人员和高校师生学习。同时,作者杨秀璋长期从事相关研究,实践经验丰富,并且乐于分享知识。无论是新手还是经验丰富的技术人员,都希望您能从中获益。扫描下方二维码,回复“云享书库”,快来免费领取这本电子书吧~附:云享书库第2期:年度重磅!华为云2021应用构建技术实践精选集,七大领域400页+云上开发宝典,免费下载!云享书库第1期:【年度重磅】2020华为云社区年度技术精选合集,700页+免费下载!
-
 【赛事资讯】2022年3月26日-- 4月1日✨【品牌赛事】提交倒计时|2022软挑作品提交通道已开启摘要:第八届华为软件精英挑战赛报名截止到3月24日18:00已结束,3月25日9:00作品提交通道已开启。✨【书籍分享】华为云专家10年技术沉淀,684页《从零到一•Python图像处理》独家免费下载摘要:本书作者杨秀璋,贵州财经大学教师,武汉大学在读博士。长期从事Web数据挖掘、知识图谱、人工智能、网络安全等方向研究,现已出版专著6部,发表论文30余篇,主持课题6项(含1项贵州省优秀自然科学基金),并参与多项国家级课题。近十年在华为云等社区分享原创博客600余篇,开源项目100余个,全网累计阅读量超过1000万人次,粉丝20余万。✨【直播预告】华为云大咖带你玩转云原生DevSecOps摘要:本直播为华为云云原生入门级开发者认证人才计划活动第8场直播,本直播将由华为云高级讲师路老师给大家分享敏捷软件开发和DevOps的概念及其关系、持续集成、持续交付、持续部署的概念、华为云HE2E DevOps框架,带你玩转云原生DevSecOps!✨【资产园地】102种常见的昆虫识别模型|识别昆虫, 提高农产品产量, 稳定市场价格摘要:昆虫害虫是影响农产品产量的主要因素之一。 准确识别虫害有助于及时采取预防措施,避免经济损失。这个模型可以预测102种常见的昆虫,包含rice leaf roller,rice leaf caterpillar, paddy stem maggot, asiatic rice borer, yellow rice borer等。输入一个图像,这个模型会预测该图像中昆虫分别属于每个类别的置信度,置信度的取值范围为0到1。✨【技术干货】手把手教您体验ModelArts Notebook摘要:ModelArts 是面向开发者的一站式 AI 平台,为机器学习与深度学习提供海量数据预处理及交互式智能标注、大规模分布式训练、自动化模型生成,及端-边-云模型按需部署能力,帮助用户快速创建和部署模型,管理全周期 AI 工作流。往期回顾:【赛事资讯】2022年3月25日精彩速递-提交倒计时|2022软挑作品提交通道已开启【赛事资讯】2022年3月18日精彩速递-第八届华为软件精英挑战赛火热报名中,超全FAQ来袭!【赛事资讯】2022年3月11日精彩速递-2022华为大学生无线基站Massive MIMO创新大赛正式开启,快来报名参赛吧!【赛事资讯】2022年3月4日精彩速递-官宣!2022年第八届华为软件精英挑战赛正式启动报名
-
《华为云云享.书库》系列电子书来啦!本系列电子书旨在帮助开发者成长,汇聚华为云内外部专家技术精华制作而成。 本书《从零到一•Python图像处理》是该系列电子书第3部。本书作者杨秀璋,贵州财经大学教师,武汉大学在读博士。长期从事Web数据挖掘、知识图谱、人工智能、网络安全等方向研究,现已出版专著6部,发表论文30余篇,主持课题6项(含1项贵州省优秀自然科学基金),并参与多项国家级课题。近十年在华为云等社区分享原创博客600余篇,开源项目100余个,全网累计阅读量超过1000万人次,粉丝20余万。此书是作者十多年图像处理及识别编程经验的结晶,包含丰富真实的案例及详细的算法原理,采用Python3、OpenCV和Keras等库实现,通过图文结合、代码注释、实例详解的形式娓娓道来。希望这本电子书及开源的代码能帮助读者迅速入门,并让图像处理及识别领域的知识轮廓逐渐清晰。全书包括三部分内容,共48章。第一部分是图像处理基础知识(共10章),详细介绍了图像处理基础、OpenCV入门、几何图形绘制、算数与逻辑运算、几何变换、量化和采样处理等内容。第二部分是图像运算和图像增强(共17章),包括图像点运算、灰度变换、形态学处理、直方图绘制、图像均衡化、平滑锐化等内容。第三部分是图像识别及图像高阶案例(共21章),包括图像分割、傅里叶变换、霍夫变换、图像分类、特效处理、OpenGL、图像去雾等知识,也囊括了经典的文字识别、车牌识别、人脸识别、目标检测、基于深度学习的图像分类、小麦检测、GAN图像生成等案例。本书详细讲解了Python图像处理及识别知识,是市面上为数不多结合实战的图像处理书籍,更是一本计算机视觉的宝典。全书内容通俗易懂,案例丰富,图文并茂,便于读者快速上手,非常适合初学者、技术人员和高校师生学习。同时,作者杨秀璋长期从事相关研究,实践经验丰富,并且乐于分享知识。无论是新手还是经验丰富的技术人员,都希望您能从中获益。扫描下方二维码,回复“云享书库”,快来免费领取这本电子书吧~转载自华为云社区云享.书库活动
-
图像识别入门必读,华为云专家10年技术沉淀,684页《从零到一•Python图像处理》独家免费下载 | 云享·书库No.3 技术火炬手 发表于 2022/03/14 18:49:41 1.5w+ 5 3【摘要】 《华为云云享.书库》系列第3部电子书上线啦!《华为云云享.书库》系列电子书来啦!本系列电子书旨在帮助开发者成长,汇聚华为云内外部专家技术精华制作而成。 本书《从零到一•Python图像处理》是该系列电子书第3部。本书作者杨秀璋,贵州财经大学教师,武汉大学在读博士。长期从事Web数据挖掘、知识图谱、人工智能、网络安全等方向研究,现已出版专著6部,发表论文30余篇,主持课题6项(含1项贵州省优秀自然科学基金),并参与多项国家级课题。近十年在华为云等社区分享原创博客600余篇,开源项目100余个,全网累计阅读量超过1000万人次,粉丝20余万。此书是作者十多年图像处理及识别编程经验的结晶,包含丰富真实的案例及详细的算法原理,采用Python3、OpenCV和Keras等库实现,通过图文结合、代码注释、实例详解的形式娓娓道来。希望这本电子书及开源的代码能帮助读者迅速入门,并让图像处理及识别领域的知识轮廓逐渐清晰。全书包括三部分内容,共48章。第一部分是图像处理基础知识(共10章),详细介绍了图像处理基础、OpenCV入门、几何图形绘制、算数与逻辑运算、几何变换、量化和采样处理等内容。第二部分是图像运算和图像增强(共17章),包括图像点运算、灰度变换、形态学处理、直方图绘制、图像均衡化、平滑锐化等内容。第三部分是图像识别及图像高阶案例(共21章),包括图像分割、傅里叶变换、霍夫变换、图像分类、特效处理、OpenGL、图像去雾等知识,也囊括了经典的文字识别、车牌识别、人脸识别、目标检测、基于深度学习的图像分类、小麦检测、GAN图像生成等案例。本书详细讲解了Python图像处理及识别知识,是市面上为数不多结合实战的图像处理书籍,更是一本计算机视觉的宝典。全书内容通俗易懂,案例丰富,图文并茂,便于读者快速上手,非常适合初学者、技术人员和高校师生学习。同时,作者杨秀璋长期从事相关研究,实践经验丰富,并且乐于分享知识。无论是新手还是经验丰富的技术人员,都希望您能从中获益。扫描下方二维码,回复“云享书库”,快来免费领取这本电子书吧~附:云享书库第2期:年度重磅!华为云2021应用构建技术实践精选集,七大领域400页+云上开发宝典,免费下载!云享书库第1期:【年度重磅】2020华为云社区年度技术精选合集,700页+免费下载!
-
本文分享自华为云社区《[[Python从零到壹] 三十六.图像处理基础篇之图像算术与逻辑运算详解](https://bbs.huaweicloud.com/blogs/336336?utm_source=csdn&utm_medium=bbs-ex&utm_campaign=other&utm_content=content)》,作者: eastmount 。 # 一.图像加法运算 图像加法运算主要有两种方法。第一种是调用Numpy库实现,目标图像像素为两张图像的像素之和;第二种是通过OpenCV调用add()函数实现。第二种方法的函数原型如下: - dst = add(src1, src2[, dst[, mask[, dtype]]]) – src1表示第一张图像的像素矩阵 – src2表示第二张图像的像素矩阵 – dst表示输出的图像,必须和输入图像具有相同的大小和通道数 – mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。 – dtype表示输出数组的可选深度 注意,当两幅图像的像素值相加结果小于等于255时,则输出图像直接赋值该结果,如120+48赋值为168;如果相加值大于255,则输出图像的像素结果设置为255,如(255+64) 赋值为255。下面的代码实现了图像加法运算。 #coding:utf-8 # By:Eastmount import cv2 import numpy as np #读取图片 img = cv2.imread("luo.png") #图像各像素加100 m = np.ones(img.shape, dtype="uint8")*100 #OpenCV加法运算 result = cv2.add(img, m) #显示图像 cv2.imshow("original", img) cv2.imshow("result", result) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() 输出如图4-1所示,左边为“小珞珞”的原始图像,右边为像素值增加100像素后的图像,输出图像显示更偏白。  # 二.图像减法运算 图像减法运算主要调用subtract()函数实现,其原型如下所示: - dst = subtract(src1, src2[, dst[, mask[, dtype]]]) – src1表示第一张图像的像素矩阵 – src2表示第二张图像的像素矩阵 – dst表示输出的图像,必须和输入图像具有相同的大小和通道数 – mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。 – dtype表示输出数组的可选深度 具体实现代码如下所示: #coding:utf-8 # By:Eastmount import cv2 import numpy as np #读取图片 img = cv2.imread("luo.png") #图像各像素减50 m = np.ones(img.shape, dtype="uint8")*50 #OpenCV减法运算 result = cv2.subtract(img, m) #显示图像 cv2.imshow("original", img) cv2.imshow("result", result) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() 输出如图4-2所示,左边为原始图像,右边为像素值减少50像素后的图像,输出图像显示更偏暗。  # 三.图像与运算 与运算是计算机中一种基本的逻辑运算方式,符号表示为“&”,其运算规则为: - 0&0=0 - 0&1=0 - 1&0=0 - 1&1=1 图像的与运算是指两张图像(灰度图像或彩色图像均可)的每个像素值进行二进制“与”操作,实现图像裁剪。 - dst = bitwise_and(src1, src2[, dst[, mask]]) – src1表示第一张图像的像素矩阵 – src2表示第二张图像的像素矩阵 – dst表示输出的图像,必须和输入图像具有相同的大小和通道数 – mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。 下面代码是通过图像与运算实现图像剪裁的功能。 #coding:utf-8 # By:Eastmount import cv2 import numpy as np #读取图片 img = cv2.imread("luo.png", cv2.IMREAD_GRAYSCALE) #获取图像宽和高 rows, cols = img.shape[:2] print(rows, cols) #画圆形 circle = np.zeros((rows, cols), dtype="uint8") cv2.circle(circle, (int(rows/2),int(cols/2)), 100, 255, -1) print(circle.shape) print(img.size, circle.size) #OpenCV图像与运算 result = cv2.bitwise_and(img, circle) #显示图像 cv2.imshow("original", img) cv2.imshow("circle", circle) cv2.imshow("result", result) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() 输出如图4-3所示,原始图像与圆形进行与运算之后,提取了其中心轮廓。同时输出图像的形状为377×326。注意,两张图像的大小和类型必须一致。  # 四.图像或运算 逻辑或运算是指如果一个操作数或多个操作数为 true,则逻辑或运算符返回布尔值 true;只有全部操作数为false,结果才是 false。图像的或运算是指两张图像(灰度图像或彩色图像均可)的每个像素值进行二进制“或”操作,实现图像裁剪。其函数原型如下所示: - dst = bitwise_or(src1, src2[, dst[, mask]]) – src1表示第一张图像的像素矩阵 – src2表示第二张图像的像素矩阵 – dst表示输出的图像,必须和输入图像具有相同的大小和通道数 – mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。 下面代码是通过图像或运算实现图像剪裁的功能。 #coding:utf-8 # By:Eastmount import cv2 import numpy as np #读取图片 img = cv2.imread("luo.png", cv2.IMREAD_GRAYSCALE) #获取图像宽和高 rows, cols = img.shape[:2] #画圆形 circle = np.zeros((rows, cols), dtype="uint8") cv2.circle(circle, (int(rows/2),int(cols/2)), 100, 255, -1) #OpenCV图像或运算 result = cv2.bitwise_or(img, circle) #显示图像 cv2.imshow("original", img) cv2.imshow("circle", circle) cv2.imshow("result", result) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() 输出如图4-4所示,原始图像与圆形进行或运算之后,提取了图像除中心原形之外的像素值。  # 五.图像非运算 图像非运算就是图像的像素反色处理,它将原始图像的黑色像素点转换为白色像素点,白色像素点则转换为黑色像素点,其函数原型如下: - dst = bitwise_not(src1, src2[, dst[, mask]]) – src1表示第一张图像的像素矩阵 – src2表示第二张图像的像素矩阵 – dst表示输出的图像,必须和输入图像具有相同的大小和通道数 – mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。 图像非运算的实现代码如下所示。 #coding:utf-8 import cv2 import numpy as np #读取图片 img = cv2.imread("Lena.png", cv2.IMREAD_GRAYSCALE) #OpenCV图像非运算 result = cv2.bitwise_not(img) #显示图像 cv2.imshow("original", img) cv2.imshow("result", result) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() 原始图像非运算之后输出如图4-5所示。  # 六.图像异或运算 逻辑异或运算(xor)是一个数学运算符,数学符号为“⊕”,计算机符号为“xor”,其运算法则为:如果a、b两个值不相同,则异或结果为1;如果a、b两个值相同,异或结果为0。 图像的异或运算是指两张图像(灰度图像或彩色图像均可)的每个像素值进行二进制“异或”操作,实现图像裁剪。其函数原型如下所示: - dst = bitwise_xor(src1, src2[, dst[, mask]]) – src1表示第一张图像的像素矩阵 – src2表示第二张图像的像素矩阵 – dst表示输出的图像,必须和输入图像具有相同的大小和通道数 – mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。 图像异或运算的实现代码如下所示。 #coding:utf-8 # By:Eastmount import cv2 import numpy as np #读取图片 img = cv2.imread("luo.png", cv2.IMREAD_GRAYSCALE) #获取图像宽和高 rows, cols = img.shape[:2] #画圆形 circle = np.zeros((rows, cols), dtype="uint8") cv2.circle(circle, (int(rows/2),int(cols/2)), 100, 255, -1) #OpenCV图像异或运算 result = cv2.bitwise_xor(img, circle) #显示图像 cv2.imshow("original", img) cv2.imshow("circle", circle) cv2.imshow("result", result) #等待显示 cv2.waitKey(0) cv2.destroyAllWindows() 原始图像与圆形进行异或运算之后输出如图4-6所示。  # 七.总结 本文详细介绍了图像处理的算术运算与逻辑运算,包括图像加法、图像减法、图像与运算、图像或运算、图像非运算与图像异或运算,并以“小珞珞”图像为案例进行讲解,希望对您有所帮助。
-
 链接:https://bbs.huaweicloud.com/blogs/336336欢迎大家来到“Python从零到壹”,在这里我将分享约200篇Python系列文章,带大家一起去学习和玩耍,看看Python这个有趣的世界。所有文章都将结合案例、代码和作者的经验讲解,真心想把自己近十年的编程经验分享给大家,希望对您有所帮助,文章中不足之处也请海涵。Python系列整体框架包括基础语法10篇、网络爬虫30篇、可视化分析10篇、机器学习20篇、大数据分析20篇、图像识别30篇、人工智能40篇、Python安全20篇、其他技巧10篇。您的关注、点赞和转发就是对秀璋最大的支持,知识无价人有情,希望我们都能在人生路上开心快乐、共同成长。该系列文章主要讲解Python OpenCV图像处理和图像识别知识,前期主要讲解图像处理基础知识、OpenCV基础用法、常用图像绘制方法、图像几何变换等,中期讲解图像处理的各种运算,包括图像点运算、形态学处理、图像锐化、图像增强、图像平滑等,后期研究图像识别、图像分割、图像分类、图像特效处理以及图像处理相关应用。上一篇文章介绍了如何使用OpenCV绘制各类几何图形,包括cv2.line()、v2.circle()、cv2.rectangle()、cv2.ellipse()、cv2.polylines()、cv2.putText()函数。这篇文章将详细讲解图像算法运算与逻辑运算,包括图像加法、图像减法、图像与运算、图像或运算、图像非运算与图像异或运算。让我们来对比下这些运算在图像中能实现什么样的效果。希望文章对您有所帮助,如果有不足之处,还请海涵。文章目录:一.图像加法运算二.图像减法运算三.图像与运算四.图像或运算五.图像非运算六.图像异或运算七.总结下载地址:https://github.com/eastmountyxz/Python-zero2one前文赏析:第一部分 基础语法[Python从零到壹] 一.为什么我们要学Python及基础语法详解[Python从零到壹] 二.语法基础之条件语句、循环语句和函数[Python从零到壹] 三.语法基础之文件操作、CSV文件读写及面向对象第二部分 网络爬虫[Python从零到壹] 四.网络爬虫之入门基础及正则表达式抓取博客案例[Python从零到壹] 五.网络爬虫之BeautifulSoup基础语法万字详解[Python从零到壹] 六.网络爬虫之BeautifulSoup爬取豆瓣TOP250电影详解[Python从零到壹] 七.网络爬虫之Requests爬取豆瓣电影TOP250及CSV存储[Python从零到壹] 八.数据库之MySQL基础知识及操作万字详解[Python从零到壹] 九.网络爬虫之Selenium基础技术万字详解[Python从零到壹] 十.Selenium爬取在线百科知识万字详解(NLP语料构造必备技能)第三部分 数据分析和机器学习[Python从零到壹] 十一.数据分析之Numpy、Pandas、Matplotlib和Sklearn入门知识万字详解[Python从零到壹] 十二.机器学习之回归分析万字总结[Python从零到壹] 十三.机器学习之聚类分析万字总结全网首发(K-Means、BIRCH、层次聚类、树状聚类)[Python从零到壹] 十四.机器学习之分类算法五万字总结全网首发(决策树、KNN、SVM、分类对比实验) [Python从零到壹] 十五.文本挖掘之数据预处理、Jieba工具和文本聚类万字详解[Python从零到壹] 十六.文本挖掘之词云热点与LDA主题分布分析万字详解[Python从零到壹] 十七.可视化分析之Matplotlib、Pandas、Echarts入门万字详解[Python从零到壹] 十八.可视化分析之Basemap地图包入门详解[Python从零到壹] 十九.可视化分析之热力图和箱图绘制及应用详解[Python从零到壹] 二十.可视化分析之Seaborn绘图万字详解[Python从零到壹] 二十一.可视化分析之Pyechart绘图万字详解[Python从零到壹] 二十二.可视化分析之OpenGL绘图万字详解[Python从零到壹] 二十三.十大机器学习算法之决策树分类分析详解(1)[Python从零到壹] 二十四.十大机器学习算法之KMeans聚类分析详解(2)[Python从零到壹] 二十五.十大机器学习算法之KNN算法及图像分类详解(3)[Python从零到壹] 二十六.十大机器学习算法之朴素贝叶斯算法及文本分类详解(4)[Python从零到壹] 二十七.十大机器学习算法之线性回归算法分析详解(5)[Python从零到壹] 二十八.十大机器学习算法之SVM算法分析详解(6)[Python从零到壹] 二十九.十大机器学习算法之随机森林算法分析详解(7)[Python从零到壹] 三十.十大机器学习算法之逻辑回归算法及恶意请求检测应用详解(8)[Python从零到壹] 三十一.十大机器学习算法之Boosting和AdaBoost应用详解(9)[Python从零到壹] 三十二.十大机器学习算法之层次聚类和树状图聚类应用详解(10)第四部分 Python图像处理基础[Python从零到壹] 三十三.图像处理基础篇之什么是图像处理和OpenCV配置[Python从零到壹] 三十四.OpenCV入门详解——显示读取修改及保存图像[Python从零到壹] 三十五.图像处理基础篇之OpenCV绘制各类几何图形[Python从零到壹] 三十六.图像处理基础篇之图像算术与逻辑运算详解第五部分 Python图像运算和图像增强第六部分 Python图像识别和图像处理经典案例第七部分 NLP与文本挖掘第八部分 人工智能入门知识第九部分 网络攻防与AI安全第十部分 知识图谱构建实战扩展部分 人工智能高级案例一.图像加法运算图像加法运算主要有两种方法。第一种是调用Numpy库实现,目标图像像素为两张图像的像素之和;第二种是通过OpenCV调用add()函数实现。第二种方法的函数原型如下:dst = add(src1, src2[, dst[, mask[, dtype]]])– src1表示第一张图像的像素矩阵– src2表示第二张图像的像素矩阵– dst表示输出的图像,必须和输入图像具有相同的大小和通道数– mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。– dtype表示输出数组的可选深度注意,当两幅图像的像素值相加结果小于等于255时,则输出图像直接赋值该结果,如120+48赋值为168;如果相加值大于255,则输出图像的像素结果设置为255,如(255+64) 赋值为255。下面的代码实现了图像加法运算。输出如图4-1所示,左边为“小珞珞”的原始图像,右边为像素值增加100像素后的图像,输出图像显示更偏白。二.图像减法运算图像减法运算主要调用subtract()函数实现,其原型如下所示:dst = subtract(src1, src2[, dst[, mask[, dtype]]])– src1表示第一张图像的像素矩阵– src2表示第二张图像的像素矩阵– dst表示输出的图像,必须和输入图像具有相同的大小和通道数– mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。– dtype表示输出数组的可选深度具体实现代码如下所示:输出如图4-2所示,左边为原始图像,右边为像素值减少50像素后的图像,输出图像显示更偏暗。三.图像与运算与运算是计算机中一种基本的逻辑运算方式,符号表示为“&”,其运算规则为:0&0=00&1=01&0=01&1=1图像的与运算是指两张图像(灰度图像或彩色图像均可)的每个像素值进行二进制“与”操作,实现图像裁剪。dst = bitwise_and(src1, src2[, dst[, mask]])– src1表示第一张图像的像素矩阵– src2表示第二张图像的像素矩阵– dst表示输出的图像,必须和输入图像具有相同的大小和通道数– mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。下面代码是通过图像与运算实现图像剪裁的功能。输出如图4-3所示,原始图像与圆形进行与运算之后,提取了其中心轮廓。同时输出图像的形状为377×326。注意,两张图像的大小和类型必须一致。四.图像或运算逻辑或运算是指如果一个操作数或多个操作数为 true,则逻辑或运算符返回布尔值 true;只有全部操作数为false,结果才是 false。图像的或运算是指两张图像(灰度图像或彩色图像均可)的每个像素值进行二进制“或”操作,实现图像裁剪。其函数原型如下所示:dst = bitwise_or(src1, src2[, dst[, mask]])– src1表示第一张图像的像素矩阵– src2表示第二张图像的像素矩阵– dst表示输出的图像,必须和输入图像具有相同的大小和通道数– mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。下面代码是通过图像或运算实现图像剪裁的功能。输出如图4-4所示,原始图像与圆形进行或运算之后,提取了图像除中心原形之外的像素值。五.图像非运算图像非运算就是图像的像素反色处理,它将原始图像的黑色像素点转换为白色像素点,白色像素点则转换为黑色像素点,其函数原型如下:dst = bitwise_not(src1, src2[, dst[, mask]])– src1表示第一张图像的像素矩阵– src2表示第二张图像的像素矩阵– dst表示输出的图像,必须和输入图像具有相同的大小和通道数– mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。图像非运算的实现代码如下所示。原始图像非运算之后输出如图4-5所示。六.图像异或运算逻辑异或运算(xor)是一个数学运算符,数学符号为“⊕”,计算机符号为“xor”,其运算法则为:如果a、b两个值不相同,则异或结果为1;如果a、b两个值相同,异或结果为0。图像的异或运算是指两张图像(灰度图像或彩色图像均可)的每个像素值进行二进制“异或”操作,实现图像裁剪。其函数原型如下所示:dst = bitwise_xor(src1, src2[, dst[, mask]])– src1表示第一张图像的像素矩阵– src2表示第二张图像的像素矩阵– dst表示输出的图像,必须和输入图像具有相同的大小和通道数– mask表示可选操作掩码(8位单通道数组),用于指定要更改的输出数组的元素。图像异或运算的实现代码如下所示。原始图像与圆形进行异或运算之后输出如图4-6所示。七.总结本文详细介绍了图像处理的算术运算与逻辑运算,包括图像加法、图像减法、图像与运算、图像或运算、图像非运算与图像异或运算,并以“小珞珞”图像为案例进行讲解,希望对您有所帮助。感谢在求学路上的同行者,不负遇见,勿忘初心。图像处理系列主要包括三部分,分别是:希望能与大家一起在华为云社区共同成长,原文地址:https://blog.csdn.net/Eastmount/article/details/122692101(By:娜璋之家 Eastmount 2022-03-09 夜于武汉)
-
边缘检测相关算法的步骤如下: 1、滤波: 边缘检测算法主要是基于图像强度的一阶和二阶导数,但导数的计算对噪声很敏感,因此必须使用滤波器来改善与噪声有关的边缘检测器的性能。需要指出,大多数滤波器在降低噪声的同时也导致了边缘强度的损失,因此,增强边缘和降低噪声之间需要折中。 2、增强: 增强边缘的基础是确定图像各点邻域强度的变化值。增强算法可以将邻域(或局部)强度值有显著变化的点突显出来。边缘增强一般是通过计算梯度幅值来完成的。 3、检测: 在图像中有许多点的梯度幅值比较大,而这些点在特定的应用领域中并不都是边缘,所以应该用某种方法来确定哪些点是边缘点。最简单的边缘检测判据是梯度幅值阈值判据。 4、定位:如果某一应用场合要求确定边缘位置,则边缘的位置可在子像素分辨率上来估计,边缘的方位也可以被估计出来。 边缘检测是机器视觉检测技术的一种,在边缘检测算法中,前三个步骤用得十分普遍。这是因为大多数场合下,仅仅需要边缘检测器指出边缘出现在图像某一像素点的附近,而没有必要指出边缘的精确位置或方向。 边缘检测的实质是采用某种算法来提取出图像中对象与背景问的交界线。我们将边缘定义为图像中灰度发生急剧变化的区域边界。图像灰度的变化情况可以用图像灰度分布的梯度来反映,因此我们可以用局部图像微分技术来获得边缘检测算子。经典的边缘检测方法,是通过对原始图像中像素的某小邻域构造边缘检测算子来达到检测边缘这一目的的。 边缘检测是主要应用有: 检测芯片针脚是否规则整齐、目标定位以及存在/缺陷检测等。基于边缘检测技术的应用,为行业的高精度检测及尺寸测量提供了强大的技术支持。
-
图像二值化操作 两种方法,全局固定阈值二值化和局部自适应阈值二值化全局固定阈值很容易理解,就是对整幅图像都是用一个统一的阈值来进行二值化;局部自适应阈值则是根据像素的邻域块的像素值分布来确定该像素位置上的二值化阈值。效果:腐蚀操作滤波操作,模糊处理 模糊处理在边沿检测和去噪声方面有较为广泛的应用。OpenCV中提供了4种模糊算法,列举如下:averagemediangaussianbilateral这里我们只列举使用 均值滤波实现图像模糊:
-
 华为云AI论文精读会2021第一期:高效语义分割模型Fast-SCNN分享华为云AI论文精读会2021第二期:d-vector用于说话人变化点检测的论文解析与复现华为云AI论文精读会2021第三期:目标检测模型CrowdDet解读分享华为云AI论文精读会2021第四期:Dynamic RCNN:一种有效提升RCNN系列网络表现的动态训练方法华为云AI论文精读会2021第五期:基于迁移学习的语义分割算法分享华为云AI论文精读会2021第六期:知识蒸馏模型TinyBert解读分享华为云AI论文精读会2021第七期:目标检测算法TSD解耦分类与回归华为云AI论文精读会2021第八期:探讨文字识别中的语言模型华为云AI论文精读会2021第九期:多卡昇腾环境实现MindSpore DenseNet 分类训练华为云AI论文精读会2021第十期:告别互信息:变分蒸馏的跨模态行人重识别华为云AI论文精读会2021第十一期:基于转移的语义Parser分享华为云AI论文精读会2021第十二期:阅读理解模型AoA Reader解读分享华为云AI论文精读会2021第十三期:图像风格处理算法的实操分享华为云AI论文精读会2021第十四期:图像分割模型PointRend解读分享华为云AI论文精读会2021第十五期:M-SQL一种将自然语言转换为SQL语句的多任务表示学习方法华为云AI论文精读会2021第十六期:文档级事件抽取模型Doc2EDAG解读分享华为云AI论文精读会2021第十七期:关系抽取模型LSTM-LSTM-Bias解析与复现华为云AI论文精读会2021第十八期:行人姿态估计经典算法HRNet华为云AI论文精读会2021第十九期:ACGAN-动漫头像生成华为云AI论文精读会2021第二十期:轻量化神经网络MobileNet系列论文精读华为云AI论文精读会2021第二十一期:语音驱动风格可控手势生成华为云AI论文精读会2021第二十二期:可变长度的语音片段情感识别解读分享华为云AI论文精读会2021第二十三期:迁移检测算法DA-Faster-RCNN解读分享华为云AI论文精读会2021第二十四期:图像迁移分类DeepJDOT模型解读分享
-
 2020年是5G商用元年。但是,如果我们在物联网行业内搞一场“2020年最热门通信技术”的评选,5G很可能无法独占冠军。因为,有一匹黑马,在这一年迅速崛起,吸引了整个行业的关注,也成为大众热议的话题。没错,这匹黑马,就是今天这篇文章的主角——LTE Cat.1。根据数据统计,2020年全球LTE Cat.1新增连接数为1500万个。乍一看并不是很多,但它的增长速度极快。行业资讯机构TSR预测,未来几年LTE Cat.1模组会保持3000万台以上的年均出货量。更有专家大胆预测,今年(2021年)就能达到5000万。LTE Cat.1为什么会迅速蹿红?它和其它蜂窝物联网技术相比,有哪些优势?我们现在常说的Cat.1和Cat.1bis,又有什么区别?别急,让我们从头开始说起。▉ LTE Cat.1的发展历程2009年3月,标准组织3GPP发布了Release 8 版本,正式把LTE推到了世人面前。当时,3GPP一共定义了5个终端类别,分别是LTE Cat.1、Cat.2、Cat.3、Cat.4、Cat.5。所谓的Cat,是英文单词“Category”的缩写,意思是“类别、种类”。之所以要搞出这么多UE Category(终端类别),是因为3GPP非常看好物联网市场的发展前景,希望设计出不同速率等级的终端类型,满足物联网不同落地场景的需求。从上图可以看出,LTE Cat.1的上行速率只有大约5Mbps,专门面向对速率要求不高的物联网应用。LTE Cat.1推出之后,并没有获得太多关注。当时,蜂窝物联网的使用场景还不多,用户比较陌生,市场也没有打开。几年后,随着LTE网络覆盖迅速形成规模,厂商们开始重新将视线放到了LTE Cat.1的身上。刚开始的时候,有手机终端厂商针对LTE Cat.1“简配”、低成本的特点,将其用于4G老人智能机。后来,蜂窝物联网应用场景快速增加,LTE Cat.1迎来了机会。2015年4月,第一代智能手表产品正式发售,拉开了价值千亿的可穿戴电子产品市场竞争帷幕。在激烈的市场争夺过程中,可穿戴设备厂商发现,LTE Cat.1并没有办法用于可穿戴设备。原因在于,Cat.1和传统LTE终端一样,设计有两根天线。而可穿戴设备对体积要求很高,必须小而又小,所以无法接受双天线。即便是强行塞入,分集接收效果也会大打折扣。当时,官方具备1Rx(单接收天线)接收规格的终端能力等级,只有Cat.0/Cat.M1/Cat.NB1。但是,这些技术最高只能实现1Mbps的极限吞吐速率,无法满足可穿戴场景的用户体验。于是,设计一种新的适用于可穿戴品类的单天线终端能力等级,就被提上了议事日程。2016年6月至2017年3月,3GPP RAN#73~#75标准全会就该单天线终端能力新等级做了讨论与定义。最终,在2017年3月9日,3GPP Release 13 LTE Cat.1bis核心部分正式冻结,LTE Cat.1bis诞生。除了天线数量之外,LTE Cat.1bis和LTE Cat.1并无太大区别,两者都是上行速率5Mbps,下行10Mbps,链路预算基本一致。这个“bis”,在英文里有“重复、两次、再来一次”的意思。LTE Cat.1bis,既能满足中速人联/物联品类的数据吞吐量需求,又能提供相比传统LTE更优的成本与更小的尺寸。更关键的是,它可以在现有4G接入网几乎零改造的前提下,进行快速部署,大幅削减落地成本。然而,如此完美的LTE Cat.1bis技术,在推出之后的前两年,不仅没有爆发,反而更加沉寂,几乎没有产生实质产业效益。这是为什么呢?原因大概有两个。一方面,是因为LTE Cat.1bis的标准化速度太慢。2018年9月,LTE Cat.1bis才完成合规认证所必要的测试部分(Testing part)冻结,根本没赶上2017年7月的全球首款蜂窝版可穿戴产品上市这波行情。另一方面,R13 Cat.1bis推出之后,业界根本没来得及准备合适的芯片平台。没有芯片,咋推出产品?阴差阳错之下,Cat.1bis最终缺席了原本属于它的可穿戴/中速物联广阔舞台。▉ Cat.1bis的逆袭到了2019年底,情况发生了根本性的变化。之前没有的终端芯片平台,现在有了!2019年11月16日,在第7届中国移动全球合作伙伴大会上,紫光展锐重磅发布了新一代物联网芯片平台——展锐8910DM,这是全球首颗LTE Cat.1bis物联网芯片平台。从功能上来看,展锐8910DM又不仅是一颗LTE Cat.1bis芯片。它采用28nm工艺,具备显著的低功耗优势,支持LTE Cat.1bis和GSM双模,上下行速率分别是5Mbps和10Mbps,拥有高集成度,同时集成了蓝牙通讯和Wi-Fi室内定位,可实现更稳定的连接,支持VoLTE。展锐8910DM的推出,解决了用户在物联网连接中通信、运算、存储、定位等多方面的需求和痛点,引领了行业标准制定和行业生态构建,填补了低功耗窄带物联网与传统宽带物联网之间的蜂窝通信芯片方案空白。芯片平台诞生之后,外部环境也发生了微妙变化,为LTE Cat.1bis的爆发创造了非常有利的条件。什么变化?当然是5G的商用。5G商用,意味着运营商又多了一张网络需要维护,势必增加其网络运维压力。为了减少压力,集中资源建设新网络,运营商会加速2G/3G的退网。2G/3G想要顺利退网,就必须有合适的替代技术,承接海量的中低速物联网终端。NB-IoT是窄带物联网,速度极低,仅可承载部分2G网络物联网终端。“中速率、语音通话、移动连接”的业务需求,自然而然就落在了LTE Cat.1bis 的身上。2020年5月,工信部发布了《关于深入推进移动物联网全面发展的通知》,其中明确指出:“推动2G/3G物联网业务迁移转网,引导新增物联网终端不再使用2G/3G网络,推动存量2G/3G物联网业务向NB-IoT/4G(含Cat.1)/5G网络迁移,建立协同发展的移动物联网综合生态体系。”针对这个协同发展的体系,行业已经形成了普遍共识,那就是物联网连接的“631”结构。所谓“631”,即指:60%的连接通过低速率网络实现,30%的连接通过中速率网络实现,10%的连接通过高速率网络实现。“631”结构LTE Cat.1bis,主要承载的是30%的中速率物联网连接领域。相比于NB-IoT,LTE Cat.1bis速率更高,可以支持标清摄像头、广告屏等应用,也多了移动性的,可以支持共享单车、物流追踪等对移动性有要求的应用。它还支持基本的语音业务,可以用于集群对讲、电话手表等业务。从技术替代趋势来看,NB-IoT将实现对80%以上2G终端的替代,而绝大部分的3G和少部分的2G,将迁移到Cat.1。▉ Cat.1bis的技术革新为了更好地完成自身使命,LTE Cat.1bis一直在进行着技术革新和功能演进。我们还是以紫光展锐的8910DM芯片平台为例。2020年11月,紫光展锐联合中国联通,基于采用8910DM芯片平台的联通雁飞Cat1模组,开展了业界首次Cat.1bis PSM低功耗特性现网规模测试。此前,人们一直以为eDRX/PSM是NB-IoT/eMTC独有的特性。这次测试表明,紫光展锐的Cat.1bis芯片也能够支持扩展非连续接收eDRX和深度睡眠PSM。如此一来,Cat.1bis的功耗表现实现从传统的mA级升级到uA级,大大拓宽了应用领域,可以满足例如智能表计、智能门锁、烟感报警等使用电池供电、对功耗要求苛刻的场景。在覆盖增强方面,8910DM芯片平台也有突破。它已成功实现对R13 coverage enhancement特性的支持,可提供最高15dB的增益。这将非常有利于将Cat.1bis部署于地下车库、地下室、密集城区阴影区等覆盖困难的场所,扩大应用领域。除了性能进一步提升之外,紫光展锐8910DM芯片平台还根据用户使用场景,进行了很多场景专属优化。举例来说,8910DM芯片原本就已支持BLE(蓝牙低功耗)功能,可进行近程设备升级维护和参数配置。如此,8910DM又新增支持了A2DP和HFP等蓝牙媒体协议,让物联网设备也能够进行音乐播放。比如,可以让支付云喇叭同时“变身”成蓝牙音箱、让公网对讲机还能连接蓝牙耳机、让共享两轮出行的路上也能有音乐陪伴。再举个例子,基于8910DM作为主芯片平台的公网对讲机方案,能够完全满足运营商对于公网对讲产品的要求。展锐针对公网对讲机的实网时延和通话音质,进行了大量优化:网络方面,包括支持双卡双待以及实现IP数据包在4G/2G实网下的时延优化;音质方面,通过充分利用芯片的语音处理能力, 对于噪音/回声/啸叫等对讲常见问题进行专项处理。上述这一系列的提升和优化,充分说明了LTE Cat.1bis可以实现功耗、成本、覆盖、功能方面的更完美平衡,给用户带来极致的使用体验。当然,这背后也离不开紫光展锐这样的民族芯片企业,在自主创新技术方面长期坚持不懈的投入。基于这些投入,紫光展锐已经成为国内集成电路设计产业的龙头,全球少数全面掌握2G/3G/4G/5G、Wi-Fi、蓝牙、电视调频、卫星通信等全场景通信技术的企业之一。根据数据显示,紫光展锐目前拥有近5000名员工,其中90%是研发人员,在全球拥有17个技术研发中心。目前,紫光展锐的Cat.1芯片已经实现千万级出货,全国市场占有率超过70%。数十款搭载展锐8910DM芯片的Cat.1bis模组,正在广泛应用于共享经济、金融支付、公网对讲、能源、工业控制等行业场景。▉ 结语2021年,LTE Cat.1bis还将继续火热下去。针对LTE Cat.1bis的生态,将会变得更加成熟。相关的物联网应用,也会越来越多地出现在我们身边。我们有理由相信,随着蜂窝物联网终端连接数的不断增加,“万物智联”的时代将加速向我们走来。整个社会的运作模式将发生根本性的变化,我们的工作效率和生活质量也将迎来难以想象的飞跃。期待这一天的早日到来。翻滚吧,LTE Cat.1bis!
-
2020年是5G商用元年。但是,如果我们在物联网行业内搞一场“2020年最热门通信技术”的评选,5G很可能无法独占冠军。因为,有一匹黑马,在这一年迅速崛起,吸引了整个行业的关注,也成为大众热议的话题。没错,这匹黑马,就是今天这篇文章的主角——LTE Cat.1。根据数据统计,2020年全球LTE Cat.1新增连接数为1500万个。乍一看并不是很多,但它的增长速度极快。行业资讯机构TSR预测,未来几年LTE Cat.1模组会保持3000万台以上的年均出货量。更有专家大胆预测,今年(2021年)就能达到5000万。LTE Cat.1为什么会迅速蹿红?它和其它蜂窝物联网技术相比,有哪些优势?我们现在常说的Cat.1和Cat.1bis,又有什么区别?别急,让我们从头开始说起。▉ LTE Cat.1的发展历程2009年3月,标准组织3GPP发布了Release 8 版本,正式把LTE推到了世人面前。当时,3GPP一共定义了5个终端类别,分别是LTE Cat.1、Cat.2、Cat.3、Cat.4、Cat.5。所谓的Cat,是英文单词“Category”的缩写,意思是“类别、种类”。之所以要搞出这么多UE Category(终端类别),是因为3GPP非常看好物联网市场的发展前景,希望设计出不同速率等级的终端类型,满足物联网不同落地场景的需求。从上图可以看出,LTE Cat.1的上行速率只有大约5Mbps,专门面向对速率要求不高的物联网应用。LTE Cat.1推出之后,并没有获得太多关注。当时,蜂窝物联网的使用场景还不多,用户比较陌生,市场也没有打开。几年后,随着LTE网络覆盖迅速形成规模,厂商们开始重新将视线放到了LTE Cat.1的身上。刚开始的时候,有手机终端厂商针对LTE Cat.1“简配”、低成本的特点,将其用于4G老人智能机。后来,蜂窝物联网应用场景快速增加,LTE Cat.1迎来了机会。2015年4月,第一代智能手表产品正式发售,拉开了价值千亿的可穿戴电子产品市场竞争帷幕。在激烈的市场争夺过程中,可穿戴设备厂商发现,LTE Cat.1并没有办法用于可穿戴设备。原因在于,Cat.1和传统LTE终端一样,设计有两根天线。而可穿戴设备对体积要求很高,必须小而又小,所以无法接受双天线。即便是强行塞入,分集接收效果也会大打折扣。当时,官方具备1Rx(单接收天线)接收规格的终端能力等级,只有Cat.0/Cat.M1/Cat.NB1。但是,这些技术最高只能实现1Mbps的极限吞吐速率,无法满足可穿戴场景的用户体验。于是,设计一种新的适用于可穿戴品类的单天线终端能力等级,就被提上了议事日程。2016年6月至2017年3月,3GPP RAN#73~#75标准全会就该单天线终端能力新等级做了讨论与定义。最终,在2017年3月9日,3GPP Release 13 LTE Cat.1bis核心部分正式冻结,LTE Cat.1bis诞生。除了天线数量之外,LTE Cat.1bis和LTE Cat.1并无太大区别,两者都是上行速率5Mbps,下行10Mbps,链路预算基本一致。这个“bis”,在英文里有“重复、两次、再来一次”的意思。LTE Cat.1bis,既能满足中速人联/物联品类的数据吞吐量需求,又能提供相比传统LTE更优的成本与更小的尺寸。更关键的是,它可以在现有4G接入网几乎零改造的前提下,进行快速部署,大幅削减落地成本。然而,如此完美的LTE Cat.1bis技术,在推出之后的前两年,不仅没有爆发,反而更加沉寂,几乎没有产生实质产业效益。这是为什么呢?原因大概有两个。一方面,是因为LTE Cat.1bis的标准化速度太慢。2018年9月,LTE Cat.1bis才完成合规认证所必要的测试部分(Testing part)冻结,根本没赶上2017年7月的全球首款蜂窝版可穿戴产品上市这波行情。另一方面,R13 Cat.1bis推出之后,业界根本没来得及准备合适的芯片平台。没有芯片,咋推出产品?阴差阳错之下,Cat.1bis最终缺席了原本属于它的可穿戴/中速物联广阔舞台。▉ Cat.1bis的逆袭到了2019年底,情况发生了根本性的变化。之前没有的终端芯片平台,现在有了!2019年11月16日,在第7届中国移动全球合作伙伴大会上,紫光展锐重磅发布了新一代物联网芯片平台——展锐8910DM,这是全球首颗LTE Cat.1bis物联网芯片平台。从功能上来看,展锐8910DM又不仅是一颗LTE Cat.1bis芯片。它采用28nm工艺,具备显著的低功耗优势,支持LTE Cat.1bis和GSM双模,上下行速率分别是5Mbps和10Mbps,拥有高集成度,同时集成了蓝牙通讯和Wi-Fi室内定位,可实现更稳定的连接,支持VoLTE。展锐8910DM的推出,解决了用户在物联网连接中通信、运算、存储、定位等多方面的需求和痛点,引领了行业标准制定和行业生态构建,填补了低功耗窄带物联网与传统宽带物联网之间的蜂窝通信芯片方案空白。芯片平台诞生之后,外部环境也发生了微妙变化,为LTE Cat.1bis的爆发创造了非常有利的条件。什么变化?当然是5G的商用。5G商用,意味着运营商又多了一张网络需要维护,势必增加其网络运维压力。为了减少压力,集中资源建设新网络,运营商会加速2G/3G的退网。2G/3G想要顺利退网,就必须有合适的替代技术,承接海量的中低速物联网终端。NB-IoT是窄带物联网,速度极低,仅可承载部分2G网络物联网终端。“中速率、语音通话、移动连接”的业务需求,自然而然就落在了LTE Cat.1bis 的身上。2020年5月,工信部发布了《关于深入推进移动物联网全面发展的通知》,其中明确指出:“推动2G/3G物联网业务迁移转网,引导新增物联网终端不再使用2G/3G网络,推动存量2G/3G物联网业务向NB-IoT/4G(含Cat.1)/5G网络迁移,建立协同发展的移动物联网综合生态体系。”针对这个协同发展的体系,行业已经形成了普遍共识,那就是物联网连接的“631”结构。所谓“631”,即指:60%的连接通过低速率网络实现,30%的连接通过中速率网络实现,10%的连接通过高速率网络实现。“631”结构LTE Cat.1bis,主要承载的是30%的中速率物联网连接领域。相比于NB-IoT,LTE Cat.1bis速率更高,可以支持标清摄像头、广告屏等应用,也多了移动性的,可以支持共享单车、物流追踪等对移动性有要求的应用。它还支持基本的语音业务,可以用于集群对讲、电话手表等业务。从技术替代趋势来看,NB-IoT将实现对80%以上2G终端的替代,而绝大部分的3G和少部分的2G,将迁移到Cat.1。▉ Cat.1bis的技术革新为了更好地完成自身使命,LTE Cat.1bis一直在进行着技术革新和功能演进。我们还是以紫光展锐的8910DM芯片平台为例。2020年11月,紫光展锐联合中国联通,基于采用8910DM芯片平台的联通雁飞Cat1模组,开展了业界首次Cat.1bis PSM低功耗特性现网规模测试。此前,人们一直以为eDRX/PSM是NB-IoT/eMTC独有的特性。这次测试表明,紫光展锐的Cat.1bis芯片也能够支持扩展非连续接收eDRX和深度睡眠PSM。如此一来,Cat.1bis的功耗表现实现从传统的mA级升级到uA级,大大拓宽了应用领域,可以满足例如智能表计、智能门锁、烟感报警等使用电池供电、对功耗要求苛刻的场景。在覆盖增强方面,8910DM芯片平台也有突破。它已成功实现对R13 coverage enhancement特性的支持,可提供最高15dB的增益。这将非常有利于将Cat.1bis部署于地下车库、地下室、密集城区阴影区等覆盖困难的场所,扩大应用领域。除了性能进一步提升之外,紫光展锐8910DM芯片平台还根据用户使用场景,进行了很多场景专属优化。举例来说,8910DM芯片原本就已支持BLE(蓝牙低功耗)功能,可进行近程设备升级维护和参数配置。如此,8910DM又新增支持了A2DP和HFP等蓝牙媒体协议,让物联网设备也能够进行音乐播放。比如,可以让支付云喇叭同时“变身”成蓝牙音箱、让公网对讲机还能连接蓝牙耳机、让共享两轮出行的路上也能有音乐陪伴。再举个例子,基于8910DM作为主芯片平台的公网对讲机方案,能够完全满足运营商对于公网对讲产品的要求。展锐针对公网对讲机的实网时延和通话音质,进行了大量优化:网络方面,包括支持双卡双待以及实现IP数据包在4G/2G实网下的时延优化;音质方面,通过充分利用芯片的语音处理能力, 对于噪音/回声/啸叫等对讲常见问题进行专项处理。上述这一系列的提升和优化,充分说明了LTE Cat.1bis可以实现功耗、成本、覆盖、功能方面的更完美平衡,给用户带来极致的使用体验。当然,这背后也离不开紫光展锐这样的民族芯片企业,在自主创新技术方面长期坚持不懈的投入。基于这些投入,紫光展锐已经成为国内集成电路设计产业的龙头,全球少数全面掌握2G/3G/4G/5G、Wi-Fi、蓝牙、电视调频、卫星通信等全场景通信技术的企业之一。根据数据显示,紫光展锐目前拥有近5000名员工,其中90%是研发人员,在全球拥有17个技术研发中心。目前,紫光展锐的Cat.1芯片已经实现千万级出货,全国市场占有率超过70%。数十款搭载展锐8910DM芯片的Cat.1bis模组,正在广泛应用于共享经济、金融支付、公网对讲、能源、工业控制等行业场景。▉ 结语2021年,LTE Cat.1bis还将继续火热下去。针对LTE Cat.1bis的生态,将会变得更加成熟。相关的物联网应用,也会越来越多地出现在我们身边。我们有理由相信,随着蜂窝物联网终端连接数的不断增加,“万物智联”的时代将加速向我们走来。整个社会的运作模式将发生根本性的变化,我们的工作效率和生活质量也将迎来难以想象的飞跃。期待这一天的早日到来。翻滚吧,LTE Cat.1bis!
-
作者:历天一【摘要】 基于HiLens Kit已经基本开发完成,可部署到HiLens Kit,模型的选择为基于DarkNet53的YOLOv3模型,权重为基于COCO2014训练的数据集,而车道线的检测是基于OpenCV的传统方法实现的,可通过ModelArts AI Gallery与HiLens Kit全流程端云协同开发部署。先来看看最终视频效果吧(PS:请忽略背景音乐)! 主体流程介绍:(可选,忽略亦可,取决于摄像头质量,对于相机畸变较大的需要先计算相机的畸变矩阵和失真系数,对图片进行校正)图片校正;截取感兴趣区域,仅对包含车道线信息的图像区域进行处理;对感兴趣区域使用透视变换;针对不同颜色的车道线,不同光照条件下的车道线,不同清晰度的车道线,根据不同的颜色空间使用不同的梯度阈值,颜色阈值进行不同的处理。并将每一种处理方式进行融合,得到车道线的二进制图;提取二进制图中属于车道线的像素;对二进制图片的像素进行直方图统计,统计左右两侧的峰值点作为左右车道线的起始点坐标进行曲线拟合;使用二次多项式分别拟合左右车道线的像素点(对于噪声较大的像素点,可以进行滤波处理,或者使用随机采样一致性算法进行曲线拟合);计算车道曲率及车辆相对车道中央的偏离位置;效果显示(可行域显示,曲率和位置显示)。检测驾驶过程中道路中其他车辆状态,显示车辆类别、置信度,并通过YOLOv3进行检测车辆,然后返回的车辆检测框的坐标与当前坐标进行透视变换获取大约的距离作为车辆之间的距离dis。说明:本Demo的主体框架基于HiLens Kit已经基本开发完成,模型的选择为基于DarkNet53的YOLOv3模型,权重为基于COCO2014训练的数据集,而车道线的检测是基于OpenCV的传统方法实现的,所以计算量较大,导致整体速度较慢。关于部署和训练——基于ModelArts 和HiLens Kit的端云协同:考虑到部署,已经测试过部署到HiLens Kit了,对了,也支持在HiLens Stuido运行模拟测试,更推荐在HiLens Studio哦,比较方便,而且不需要硬件支持,只需要在HiLens Kit或HiLens Studio上安装pillow库就行了,关于如何在HiLens Kit和HiLens Studio上安装第三方库,非常简单的哦,可参考:在HiLens Kit上:https://bbs.huaweicloud.com/forum/thread-94316-1-1.html在HiLens Studio上:https://bbs.huaweicloud.com/forum/thread-94317-1-1.html如果想训练或优化,由没有硬件(比如GPU),那么很推荐使用ModelArts了,一站式开发,无缝衔接到HiLens Kit哦,关于ModelArts的介绍可参考:https://www.huaweicloud.com/product/modelarts.html同时也许还能提升下运行速度,这里介绍三种算法,亲测都可以部署到HiLens Kit推理使用哦,就在最新的AI Gallery(原AI市场)中哦,这里除了有算法,还有模型、数据集等等,很丰富,大家可以自己探索一下,同时还可以分享自己的算法给其他开发者,开发者订阅即可创建训练使用,很方便,相比于GitHub,不仅提供了源代码,还提供了用于训练的硬件资源,强大的Tesla V100 32GB版本哦。 (1)YOLOv3_Darknet53,没错,就是著名的YOLOv3,经典的目标检测网络,后续又推出了YOLOv4、YOLOv5(暂称此名吧),AI Gallery也推出了YOLOv5的,不过由于PyTorch框架暂不支持模 型转换,所以暂时放弃了。 关于YOLOv3_Darknet53的使用方法,算法界面介绍很详细,这里就不赘述了,可以参考使用,注意模型转换部分请参考这篇博文中模型转换部分哦:https://bbs.huaweicloud.com/blogs/199870 算法备用链接为:https://marketplace.huaweicloud.com/markets/aihub/modelhub/detail/?id=2d52a07e-ccbd-420f-8999-2ea7b4bdd691 (2)YOLOv3_Resnet18(GPU),如果我们只想做车辆的检测或者为了简化模型,提高速度,可以选用主干网络为Resnet18的YOLOv3,网络更轻量,速度会快一些哦。 同样给上链接:https://marketplace.huaweicloud.com/markets/aihub/modelhub/detail/?id=948196c8-3e7a-4729-850b-069101d6e95c (3)YOLOv3_Resnet18(Ascend 910),和上面(2)版本差异不大,主要改为由GPU换为Ascend 910训练的,大家可自由选择哦。 链接为:https://marketplace.huaweicloud.com/markets/aihub/modelhub/detail/?id=7087008a-7eec-4977-8b66-3a7703e9fd22好了,算法部分解决了,数据怎么办呢?ModelArts的AI Gallery同样想到了,提供了数据集哦,免费订阅,下载到自己的OBS导入就能用了(注意OBS需要一定花费),这里我也提供了开源数据集的5164张人车图片,供大家使用哦,上链接:https://marketplace.huaweicloud.com/markets/aihub/datasets/detail/?content_id=a337272b-6918-4282-83d6-2b15e2a4c716那么数据集和算法都有了,该训练了吧,在ModelArts上可以很好完成,凭借强大的Tesla V100 32GB或Ascend 910可以很快完成哦。上述整体操作流程部分可参考下述博文完成:https://bbs.huaweicloud.com/blogs/199870运行效果:完成执行如视频中所示处理的一帧需要约300ms,也就是FPS约为3,不较慢,需要优化。我觉得还有很大优化空间,比如:(1)预处理和后处理很费时间,真正推理很快,可以从这方面加速,不知道开启多线程是否有提升,应该有吧;(2)应该可以更好发挥专用硬件,记得好像有DVPP和AIPP吧,可以用来做色域转换的操作; (3) YOLOv3的后处理解析比较麻烦,这里用的是COCO的80类,但可以只用person、car两类,或者再加一点,同时nms也比较费时间,如果能用算子实现,融合到om模型中,会提速很多;(4)这里使用的是Python,如果用C++应该会提升一些,执行效率会高很多吧。(5)优化提速要根据硬件性能,对费时的部分做分析,以最大压榨硬件性能,需要做针对性、定制化地优化,我个人理解很浅,希望有熟悉的同学指教。备注:本Demo所用模型、代码均来自开源代码,好像是吴恩达老师的一个课程涉及的项目,但找不到出处了,如果知道的同学,还请在在下方回复指教,谢谢了。本Demo的模型精度以及运行速度不做保证,仅供学习交流使用。其他未尽事宜,还请多多指教。代码会开源的,敬请期待哦,谢谢。来源:华为云社区 https://bbs.huaweicloud.com/blogs/226039
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签